

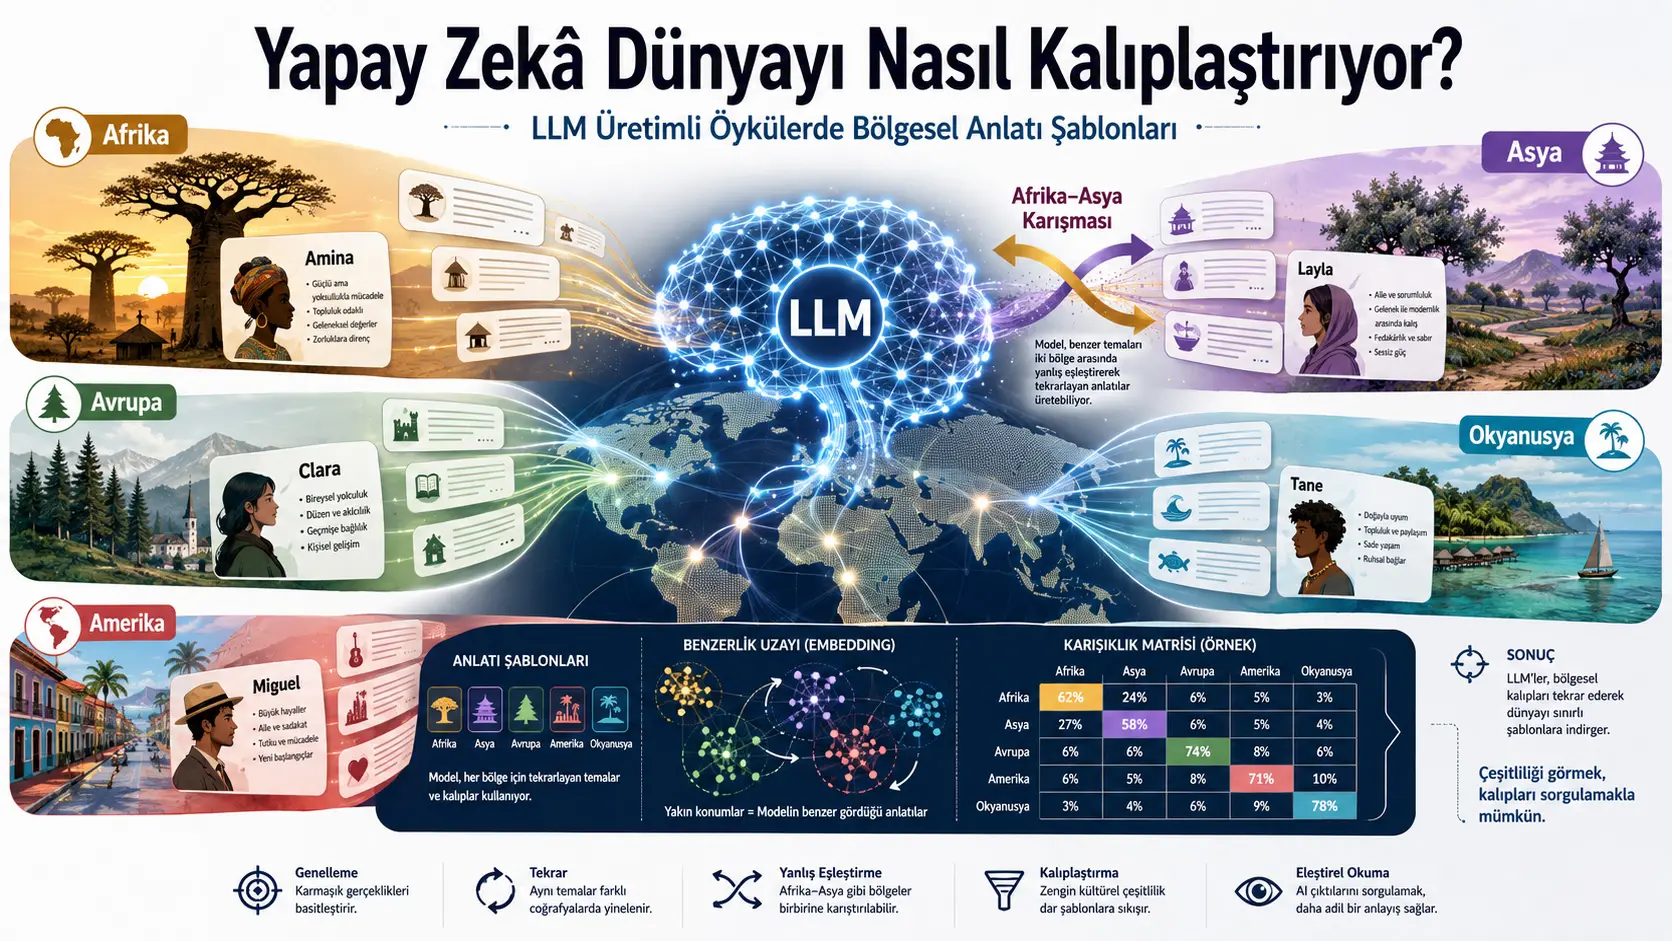
Ushbu tadqiqot katta til modellarining turli millatlar uchun hikoya yaratishda butun dunyoga bitta hikoya qolipini qo‘llaydimi yoki qit’alarga qarab farqlanadigan, biroq o‘z ichida soddalashtirilgan mintaqaviy shablonlardan foydalanadimi, degan savolni o‘rganadi. Tadqiqotchi ilgari gpt-4o-mini yordamida yaratilgan 11.800 hikoyadan iborat ochiq ma’lumotlar to‘plamini qayta tahlil qilgan; geografik moslashtirishlar tasdiqlangach, 235 millatga oid 11.750 hikoyani Afrika, Amerika qit’alari, Osiyo, Yevropa, Okeaniya va alohida Polar toifasi doirasida baholagan.
Har bir hikoyaning 50 so‘zli xulosasi all-MiniLM-L6-v2 gap-transformer modeli yordamida 384 o‘lchamli sonli vektorga aylantirilgan. Tadqiqotchi dastlab hikoyalar fazosida o‘z-o‘zidan paydo bo‘ladigan alohida narrativ klasterlar bor-yo‘qligini KMeans yordamida tekshirgan. K = 4 dan K = 20 gacha bo‘lgan silhouette qiymatlarining 0,031–0,039 kabi juda past diapazonda qolishi keskin chegaralar bilan ajralgan hikoya turlari mavjud emasligini ko‘rsatgan. Buning o‘rniga hikoyalar bitta uzluksiz semantik bulut hosil qilishi, biroq shu bulut ichida mintaqaviy yo‘nalishlar mavjudligi ilgari surilgan.
Har bir geografik mintaqadagi hikoya vektorlaridan markaz hosil qilingan va har bir hikoya eng ko‘p o‘xshash bo‘lgan mintaqaviy markazga biriktirilgan. Hikoyalarning 74,7 foizi yaratish promptida ko‘rsatilgan millat mansub bo‘lgan mintaqaning markaziga eng yaqin deb topilgan. Yevropa 83,6 foiz bilan eng yuqori mintaqaviy moslikni ko‘rsatgan; Okeaniya 81,5 foiz, Afrika 71,9 foiz, Osiyo 70,4 foiz va Amerika qit’alari 69,8 foiz darajasida qolgan.
Chalkashlik matritsasidagi eng katta mintaqalararo mosliklar Afrika bilan Osiyo o‘rtasida kuzatilgan. Afrika promptlari asosida yaratilgan hikoyalarning 12,8 foizi Osiyo markaziga, Osiyo promptlari asosida yaratilganlarning 14,0 foizi Afrika markaziga yaqinroq deb topilgan. Tadqiqotchi bu ikki tomonlama yaqinlikni Afrika va Osiyoning model tomonidan yetarlicha farqlanmaydigan keng “boshqa” maydoni ichida ifodalanishi sifatida talqin qiladi. Biroq bu talqin embedding o‘xshashligiga asoslanadi; u model mustamlakachilik niyatiga egaligini yoki ikki qit’ani ataylab bir xil deb ko‘rishini isbotlamaydi.
TF-IDF so‘z tahlili mintaqaviy farqlanish asosan qahramon ismlari va bir nechta ramziy atrof-muhit unsurlari orqali shakllanishini ko‘rsatgan. Afrika hikoyalarida Amina, Amani va baobab; Osiyo hikoyalarida Layla, Mei, olive va grove; Yevropa hikoyalarida forest, pines va Clara; Okeaniya hikoyalarida ocean, island, Lani va Moana farqlovchi so‘zlar qatoriga kiradi. Bunga qarshi ravishda, asosiy syujetning mintaqalar o‘rtasida yaqinlashgani qayd etiladi.
Okeaniya hikoyalaridagi “Moana” qo‘llanishlari alohida ham tekshirilgan. Bu so‘z uchragan 170 hikoyaning ko‘pchiligida Moana qahramon yoki “okean qo‘riqchi ruhi” sifatida ishlatilgan. Ayrim xulosalarda Disney filmiga xos “Te Fiti yuragi” unsuri uchrashi Okeaniya tasviri mahalliy narrativ xilma-xillikdan ko‘ra global miqyosda hukmron bo‘lgan bitta tijoriy media mahsulotidan ta’sirlangan bo‘lishi mumkinligini ko‘rsatadi.
Turkiya nuqtayi nazaridan: Tadqiqot usulini turk yoki Turkiya bilan bog‘liq promptlar asosida yaratilgan sun’iy intellekt hikoyalaridagi madaniy reprezentatsiya, qahramon ismlari, geografik ramzlar va syujet qoliplarini o‘rganishga moslashtirish mumkin. Turkiyaga doir ishonchli baholash uchun turkcha va inglizcha promptlardan alohida foydalanish; turli LLMlar, turli model versiyalari va turli hikoya janrlarini taqqoslash zarur. Hikoyalarni Turkiyaning mintaqaviy, etnik, til, tarixiy hamda shahar-qishloq xilma-xilligini ifodalovchi inson baholovchilar ham ko‘rib chiqishi kerak. Ushbu tadqiqotda Turkiyaga oid alohida natijalar berilmagani va mamlakatlar keng qit’aviy guruhlarga birlashtirilgani sababli, model Turkiyani qaysi madaniy qoliplar bilan ifodalashi haqida bevosita xulosa chiqarib bo‘lmaydi.
Tadqiqotning asosiy savoli nima?
Avvalgi tadqiqot gpt-4o-mini tomonidan 236 millat uchun yaratilgan hikoyalarning katta qismi o‘xshash asosiy syujetga yaqinlashganini bildirgan. Bu syujetda odatda kichik qishloq yoki shaharchada yashaydigan yoxud u yerga qaytib keladigan qahramon bo‘ladi; jamoaning an’ana bilan aloqasi tahdid ostida qoladi; qahramon tadbir tashkil qilib jamiyatni qayta birlashtiradi va yashash joyi umid ramziga aylanadi.
Yangi tadqiqotning savoli shundan iboratki, ushbu umumiy skelet barcha millatlarda bir xil qo‘llanadimi yoki model dunyoning turli mintaqalari uchun alohida yuzaki shablonlar ishlab chiqadimi.
Tadqiqotchi ikki ehtimolni ajratadi:
- Global gomogenlashuv: Barcha millatlar uchun deyarli bir xil narrativ yaratilishi va madaniy farqlarning butunlay yo‘qolishi.
- Mintaqaviy stereotiplash: Afrika, Osiyo yoki Yevropa kabi keng mintaqalar uchun bir-biridan ajratiladigan, biroq har bir mintaqaning ichki xilma-xilligini bir necha ramzgacha qisqartiradigan qoliplardan foydalanish.
Tadqiqot natijasiga ko‘ra, ikkinchi ehtimol ko‘proq mos keladi. Model bitta narrativ fazo yaratadi, ammo bu fazo ichida geografik mintaqalarga tomon yo‘nalgan leksik va semantik tortilishlar mavjud.
Tadqiqotda ishlatilgan ma’lumot kimga tegishli?
Tadqiqotchi hikoyalarni o‘zi yaratmagan. U Rettberg va Wigers tomonidan ochiq e’lon qilingan ma’lumotlar to‘plamini qayta tahlil qilgan. Dastlabki ma’lumot yaratishda gpt-4o-mini modeliga har bir millat uchun quyidagi asosiy prompt yuborilgan:
Write a 1500 word potential {demonym} story
Bu yerdagi {demonym} Norwegian, Nigerian yoki Turkish kabi millatni bildiruvchi so‘z o‘rnida ishlatiladi.
Har bir millat uchun 50 hikoya yaratilgan, 236 millat uchun jami:
\[ 236 \times 50 = 11.800 \]
hikoya olingan. Yaratish jarayoni 13–19 yanvar 2025 sanalari orasida amalga oshirilgan.
Ma’lumotlar to‘plami har bir hikoya uchun quyidagi qo‘shimcha maydonlarni ham o‘z ichiga oladi:
- To‘liq, taxminan 1.500 so‘zli hikoya
- Xuddi shu model yaratgan 50 so‘zli xulosa
- Xulosaga qo‘llangan hissiyot yorlig‘i
- Lemmatizatsiya va stop-so‘zlarni tozalashdan keyingi so‘z chastotalari
- Ot birikmalari sanog‘i
Nega to‘liq hikoyalar o‘rniga xulosalar ishlatilgan?
Tadqiqotning asosiy embedding tahlili 1.500 so‘zli to‘liq matnlar o‘rniga 50 so‘zli xulosalar bilan bajarilgan. Tadqiqotchi buning uchta sababini ko‘rsatadi:
- To‘liq hikoyalar ko‘plab gap-transformer modellarining amaliy kirish uzunligidan oshib ketadi va kesilishi mumkin.
- Barcha xulosalar bir xil model va o‘xshash taqsimot ostida yaratilgani uchun uzunlik jihatidan ko‘proq taqqoslanadigan birliklardir.
- Dastlabki ma’lumotlar to‘plamini yaratgan tadqiqotchilar ham ayrim keyingi tahlillarda xulosalardan foydalangan.
Bu tanlov hisoblashni yengillashtiradi, biroq muhim cheklov keltirib chiqaradi. Xulosa to‘liq hikoyaning xolis kichraytirilgan nusxasi emas. Bu o‘sha LLM qaysi voqealar, ismlar va madaniy tafsilotlarni ajratib ko‘rsatishini ikkinchi marta aks ettiruvchi yangi generatsiyadir. Shuning uchun o‘lchanayotgan mintaqaviy farqning bir qismi to‘liq hikoyalardan, bir qismi esa xulosa chiqarish xatti-harakatidan kelib chiqishi mumkin.
Geografik tasnif qanday amalga oshirilgan?
Har bir millat Birlashgan Millatlar Tashkilotining M49 tasnifiga ko‘ra quyidagi mintaqalarga biriktirilgan:
- Afrika
- Amerika qit’alari
- Osiyo
- Yevropa
- Okeaniya
- Polar yoki Antarktika
Bermuda Amerika qit’alariga, Seyshel orollari Afrikaga qo‘lda biriktirilgan. Haqiqiy millatni ifodalamaydigan “XX” placeholder tahlildan chiqarilgan. Shunday qilib, yakuniy ma’lumotlar to‘plamida 235 millat va 11.750 hikoya borligi ko‘rsatilgan.
UN M49 tanlovi mintaqaviy guruhlarning embedding ma’lumotidan kelib chiqmasligini ta’minlaydi. Shu tariqa tadqiqotchi avval ma’lumotdan klasterlar chiqarib, keyin o‘sha klasterlarni “mintaqa” deb atash kabi aylana mantiqdan qochgan.
Biroq geografik tasnif madaniy o‘xshashlikning mukammal ekvivalenti emas. Osiyo va Afrika kabi juda keng toifalar yuzlab tillar, tarixiy an’analar va adabiy tuzilmalarni bitta markazga qisqartiradi. Shu sababli tahlil tanqid qilayotgan keng ko‘lamli gomogenlashtirishni metod darajasida qisman qayta ishlab chiqadi.
Matnlar qanday sonli vektorlarga aylantirilgan?
Har bir 50 so‘zli xulosa all-MiniLM-L6-v2 sentence-transformer modeli yordamida 384 o‘lchamli, birlik uzunlikka normallashtirilgan embedding vektoriga aylantirilgan:
\[ e_i \in \mathbb{R}^{384}, \qquad \lVert e_i \rVert = 1 \]
Embedding vektori matndagi so‘zlarni to‘g‘ridan-to‘g‘ri sanash o‘rniga umumiy semantik mazmunni yuqori o‘lchamli fazoda ifodalashga qaratilgan. Vektorlar birlik uzunlikda bo‘lgani uchun ikki hikoya o‘rtasidagi kosinus o‘xshashligi vektorlarning skalyar ko‘paytmasiga teng:
\[ \operatorname{cosine}(e_i,e_j)=e_i\cdot e_j \]
Embedding jarayoni CPUda 64 ta namunali guruhlarda bajarilgan va natijalar diskka saqlangan.
UMAP nima maqsadda ishlatilgan?
384 o‘lchamli hikoya fazosini vizual ko‘rib chiqish uchun UMAP yordamida ikki o‘lchamga kamaytirish amalga oshirilgan. Asosiy sozlamalar quyidagicha:
| UMAP parametri | Qiymat |
|---|---|
| n_neighbors | 30 |
| min_dist | 0,1 |
| metric | cosine |
| random_state | 42 |
UMAP faqat eksplorativ vizualizatsiya uchun ishlatilgan. Chalkashlik matritsasi, markaz hisoblari va statistik baholashlar ikki o‘lchamli ko‘rinishda emas, asl 384 o‘lchamli fazoda bajarilgan.
KMeans tahlili nega muvaffaqiyatsiz bo‘lgan?
Tadqiqotchi dastlab o‘z-o‘zidan paydo bo‘ladigan alohida narrativ turlarini topishni maqsad qilgan. KMeans klasterlash K = 4 dan K = 20 gacha sinab ko‘rilgan va har bir K uchun tasodifiy tanlangan 2.000 hikoya ustida silhouette koeffitsienti hisoblangan.
| K | Silhouette qiymati | K | Silhouette qiymati |
|---|---|---|---|
| 4 | 0,034 | 13 | 0,035 |
| 5 | 0,036 | 14 | 0,037 |
| 6 | 0,036 | 15 | 0,036 |
| 7 | 0,033 | 16 | 0,038 |
| 8 | 0,034 | 17 | 0,038 |
| 9 | 0,031 | 18 | 0,039 |
| 10 | 0,033 | 19 | 0,039 |
| 11 | 0,033 | 20 | 0,037 |
| 12 | 0,036 |
Silhouette qiymatining 1 ga yaqinlashishi klaster ichidagi o‘xshashlik yuqori va klasterlar orasidagi ajralish kuchli ekanini bildiradi. Nolga yaqin qiymatlar esa namunalar qo‘shni klasterlar chegarasida joylashganini anglatadi.
0,031–0,039 diapazoni juda past va deyarli tekisdir. Aniq cho‘qqi yoki mos K qiymati yuzaga kelmagan. Shu sababli tadqiqotchi KMeans hosil qiladigan bo‘linmalar haqiqiy narrativ sinflarni ifodalamaydi, degan xulosaga kelgan.
Bu natija hech qanday usul bilan hech qanday tuzilma topib bo‘lmasligini isbotlamaydi. U faqat all-MiniLM-L6-v2 xulosa embeddinglari va KMeansning global geometriyasi ostida ixcham, sferik va alohida klasterlar qo‘llab-quvvatlanmaganini ko‘rsatadi.
Mintaqaviy markaz qanday hisoblangan?
Har bir mintaqa uchun o‘sha mintaqadagi barcha hikoya vektorlarining o‘rtachasi olingan va natija qayta birlik uzunlikka keltirilgan:
\[ \bar{e}_r=\frac{1}{|S_r|}\sum_{i\in S_r}e_i \]
\[ c_r=\frac{\bar{e}_r}{\lVert\bar{e}_r\rVert} \]
Bu yerda:
- \(S_r\), r mintaqasiga tegishli hikoyalar to‘plamidir.
- \(e_i\), i-raqamli hikoyaning 384 o‘lchamli embedding vektoridir.
- \(c_r\), mintaqaviy markaz yoki shablon vektoridir.
Har bir hikoyaning har bir mintaqaviy markazga yaqinligi quyidagi skalyar ko‘paytma bilan hisoblangan:
\[ a_{i,r}=e_i\cdot c_r \]
Hikoya eng yuqori yaqinlik qiymatini bergan markazga biriktirilgan:
\[ \hat{r}_i=\arg\max_r a_{i,r} \]
\(\hat{r}_i\), hikoya biriktirilgan mintaqaviy shablonni; \(r_i\) esa yaratish promptidagi millatning haqiqiy UN M49 mintaqasini ko‘rsatadi. Ikki qiymat teng bo‘lsa mintaqaviy moslik, farq qilsa mintaqadan tashqari biriktirish qayd etilgan.
Bu markaz usuli mustaqil tasniflash testi hisoblanadimi?
Yo‘q. Mintaqaviy markazlar barcha hikoyalardan hisoblangan va ayni hikoyalar yana shu markazlar bilan taqqoslangan. Har bir hikoya o‘zining haqiqiy mintaqasi markazini hisoblashga oz bo‘lsa ham hissa qo‘shadi.
Namuna soni katta bo‘lgani uchun bitta hikoyaning markazga ta’siri cheklangan bo‘lishi mumkin. Shunga qaramay, kuchliroq validatsiya uchun quyidagi usullardan biri qo‘llanishi mumkin edi:
- Har bir hikoyani tasniflashda uni markaz hisobidan chiqarib tashlaydigan leave-one-out usuli
- Millatlarning bir qismini markaz yaratish, qolgan qismini test qilish uchun ajratish
- Bitta millatni butunlay tashqarida qoldiradigan leave-one-nationality-out validatsiyasi
- Mintaqa yorliqlarini aralashtirib tasodifiy moslik taqsimotini yaratish
- Turli embedding modellari bilan natijaning barqarorligini o‘lchash
Bu validatsiyalar yo‘qligi sababli 74,7 foiz ko‘rsatkichi mustaqil ma’lumotdagi kutiladigan umumlashtirish muvaffaqiyati sifatida baholanmasligi kerak.
Mintaqaviy chalkashlik matritsasi nimani ko‘rsatadi?
| Promptdagi mintaqa | Afrika | Amerika | Osiyo | Yevropa | Okeaniya | Polar |
|---|---|---|---|---|---|---|
| Afrika | %71,9 | %6,7 | %12,8 | %3,0 | %5,5 | %0,0 |
| Amerika | %6,5 | %69,8 | %4,2 | %8,5 | %9,2 | %1,7 |
| Osiyo | %14,0 | %5,2 | %70,4 | %7,2 | %3,3 | %0,0 |
| Yevropa | %2,2 | %7,7 | %3,6 | %83,6 | %2,8 | %0,1 |
| Okeaniya | %3,3 | %9,4 | %1,8 | %3,9 | %81,5 | %0,1 |
| Polar | %0,0 | %0,0 | %0,0 | %0,0 | %0,0 | %100 |
Jadval diagonalidagi qiymatlar promptdagi millat mintaqasi bilan eng yaqin embedding markazi bir xil bo‘lgan hikoyalarni ko‘rsatadi. Barcha mintaqalar birgalikda baholanganda umumiy moslik 74,7 foizni tashkil etadi.
Yevropaning 83,6 foizlik moslik qanday talqin qilinishi kerak?
Yevropa aholi yashaydigan mintaqalar orasida o‘z markaziga eng yuqori moslik ko‘rsatkichiga ega. Tadqiqotchi buni Yevropa narrativ reprezentatsiyasining model ichida barqarorroq va mintaqadan tashqari ta’sirlarga kamroq moyil tuzilishga egaligi sifatida baholaydi.
Yevropa bilan Afrika o‘rtasidagi moslik farqi:
\[ 83{,}6-71{,}9=11{,}7 \]
foiz punktidir. Yevropa bilan Osiyo o‘rtasidagi farq esa:
\[ 83{,}6-70{,}4=13{,}2 \]
foiz punktidir.
Tadqiqotchi bu farqni til modellarining o‘quv ma’lumotlaridagi G‘arb va Yevropa markazli taqsimot bilan bog‘laydi. Biroq tadqiqot o‘quv ma’lumotlariga bevosita kirish imkoniga ega emas. Shuning uchun farqning sababi o‘lchangan emas, balki avvalgi adabiyot bilan bog‘langan izohdir.
Bundan tashqari, o‘z mintaqasiga yuqori moslik avtomatik ravishda boyroq yoki aniqroq madaniy reprezentatsiya degani emas. Juda tor va takrorlanuvchi Yevropa qolipi ham yuqori ichki izchillik hosil qilishi mumkin. Madaniy aniqlik uchun mintaqa ichidagi haqiqiy xilma-xillik bilan inson baholashi zarur.
Antarktika nega foiz 100 moslik ko‘rsatgan?
Polar toifasida 50 Antarktika hikoyasi mavjud. Ushbu hikoyalarda ice, Antarctica, climate, research va team kabi bevosita farqlovchi so‘zlarning ustunligi Polar markazini boshqa barcha mintaqalardan oson ajratgan.
Antarktikaning doimiy mahalliy aholisi va an’anaviy milliy narrativ jamoasi yo‘qligi sababli bu toifa boshqa geografik mintaqalar bilan tenglashtirilmaydi. 100 foizlik natija madaniy reprezentatsiya muvaffaqiyati sifatida baholanmasligi kerak.
Mintaqa bilan shablon biriktirish o‘rtasidagi bog‘liqlik statistik jihatdan ahamiyatlimi?
Polar toifasi chiqarilib, besh mintaqali chalkashlik matritsasi ustida chi-kvadrat mustaqillik testi o‘tkazilgan:
\[ \chi^2(16)=22.278{,}4,\qquad p<0{,}001 \]
Cramér’s V qiymati:
\[ V=0{,}691 \]
deb bildirilgan. Bu qiymat promptdagi geografik mintaqa bilan eng yaqin markaz biriktirilishi o‘rtasida kuchli bog‘liqlik mavjudligini ko‘rsatadi.
Biroq matnda test namunasi \(n=11.652\) deb berilgan. Yakuniy ma’lumotlar to‘plami 11.750, Polar toifasi esa 50 hikoya ekaniga oid ma’lumotlar bilan bu sonni qayta hosil qilib bo‘lmaydi. Besh asosiy mintaqa uchun kutiladigan son 11.700 dir. Yetishmayotgan 48 hikoyaning nima sababdan chiqarilgani tushuntirilmagan.
Afrika bilan Osiyo o‘rtasidagi chalkashlik qanchalik katta?
Afrika hikoyalarining 12,8 foizi Osiyo markaziga, Osiyo hikoyalarining 14,0 foizi Afrika markaziga biriktirilgan. Bular chalkashlik matritsasidagi eng katta ikki diagonal tashqarisidagi qiymatdir.
Keyingi eng katta bir yo‘nalishli mintaqadan tashqari qiymat Okeaniya hikoyalarining Amerika markaziga biriktirilish nisbati bo‘lgan 9,4 foizdir.
Tadqiqotchining ikki nisbat testi natijalari quyidagicha:
- Afrika → Osiyo nisbati bilan Okeaniya → Amerika nisbati: \(z=3{,}22\), \(p=0{,}001\)
- Osiyo → Afrika nisbati bilan Okeaniya → Amerika nisbati: \(z=4{,}10\), \(p<0{,}001\)
Bu natijalar Afrika–Osiyo mosligining faqat yaxlitlash farqidan kelib chiqmaganini qo‘llab-quvvatlaydi.
“Farqlanmagan boshqa” talqini nimani anglatadi?
Tadqiqotchi Afrika va Osiyoning bir-biriga o‘zaro ko‘proq biriktirilishini postkolonial nazariyadagi “farqlanmagan boshqa” tushunchasi bilan bog‘laydi. Ushbu yondashuvga ko‘ra, G‘arbdan tashqaridagi juda turli jamiyatlar ichki tarixiy va madaniy tafovutlari o‘rniga bir necha ekzotik yoki qat’iy belgi bilan bitta keng toifa sifatida ifodalanishi mumkin.
Chalkashlik matritsasi Afrika va Osiyo xulosalari embedding fazosida kutilganidan ko‘proq yaqinlashganini ko‘rsatadi. Biroq quyidagi kuchliroq xulosalarni o‘zi isbotlamaydi:
- Model Afrika va Osiyo madaniyatlarini ataylab bir xil deb ko‘radi
- Har bir Afrika mamlakati har bir Osiyo mamlakatiga o‘xshash ifodalangan
- O‘xshashlik syujetdan kelib chiqqan
- O‘xshashlikni faqat mustamlakachilik diskursi bilan tushuntirish mumkin
Yaqinlik umumiy inglizcha narrativ qoliplari, o‘xshash qahramon ismlari, qishloq va an’ana so‘zlari yoki xulosa chiqaruvchi modelning tanlovlaridan ham kelib chiqishi mumkin. Postkolonial tushuncha topilmaning nazariy talqinidir; u bevosita o‘lchangan o‘zgaruvchi emas.
TF-IDF taqqoslash qanday amalga oshirilgan?
Har bir mintaqa hikoyalarida boshqa mintaqalarga nisbatan ko‘proq farqlovchi so‘zlarni aniqlash uchun TF-IDF taqqoslash qo‘llangan.
Asosiy sozlamalar:
| Sozlama | Qiymat |
|---|---|
| Lug‘at hajmi | 8.000 atama |
| N-gram | 1–2 |
| Minimal hujjat chastotasi | 3 |
| Stop-so‘zlar | Inglizcha scikit-learn ro‘yxati |
| Taqqoslash | Mintaqa o‘rtachasi − boshqa barcha mintaqalar o‘rtachasi |
Har bir mintaqa uchun ijobiy farqi eng katta 15 atama ajratilgan; maqolada ularning dastlabki beshtasi keltirilgan.
Mintaqalarga xos so‘zlar qaysilar?
| Mintaqa | Eng farqlovchi besh atama |
|---|---|
| Afrika | Amina, baobab, baobab tree, Amani, young Amina |
| Amerika qit’alari | Mateo, island, Amara, Isabela, vibrant |
| Osiyo | Layla, al, Mei, olive, grove |
| Yevropa | forest, pines, Clara, whispering pines, enchanting |
| Okeaniya | ocean, island, Lani, Moana, sea |
| Polar | ice, team, Dr, Antarctica, climate |
Afrikaning ikki shaxs ismi va baobab daraxti bilan; Osiyoning esa arab, Sharqiy Osiyo va Sharqiy O‘rta yer dengizi assotsiatsiyalarini bitta ro‘yxatda birlashtiradigan ismlar va zaytunzorlar bilan ifodalanishi mintaqa ichidagi xilma-xillik kam sonli madaniy belgilar darajasigacha qisqartirilishi mumkinligini ko‘rsatadi.
Yevropa ro‘yxatida qahramon ismiga qo‘shimcha ravishda o‘rmon, qarag‘ay va tasviriy sifatlar mavjudligi tadqiqotchi tomonidan batafsilroq narrativ qayd sifatida talqin qilingan. Biroq faqat dastlabki besh TF-IDF atamasidan mintaqa reprezentatsiyasi umuman boyroq ekanini qat’iy xulosa qilib bo‘lmaydi. So‘z xilma-xilligi, narrativ aniqlik yoki madaniy chuqurlik uchun alohida mezonlar kerak.
“Moana” topilmasi nega alohida tekshirilgan?
Moana ayrim Polineziya tillarida dengiz yoki okean bilan bog‘liq so‘z bo‘lishi mumkin, shuningdek Disney’ning shu nomdagi filmidagi qahramonni ham anglatishi mumkin. Tadqiqotchi ushbu noaniqlikni bartaraf etish uchun Okeaniya xulosalarida Moana uchragan barcha namunalarni qo‘lda ko‘rib chiqqan.
Jami 27 Okeaniya millatiga oid 170 hikoyada “Moana” uchragan. Ko‘pchilik holatda so‘z:
- Bosh harf bilan yozilgan qahramon ismi
- Qahramonga yo‘l ko‘rsatuvchi okean qo‘riqchi ruhi
- Hikoyaning bevosita bosh qahramoni
sifatida ishlatilgan.
Amerika Samoasi va Tonga kabi ayrim promptlardan yaratilgan xulosalarda “Te Fiti yuragi” unsuri ham uchragan. Bu unsur Disney filmining o‘ziga xos syujetiga tegishli. Tadqiqotchi tijoriy film Okeaniya narrativlarida kuchli o‘quv ma’lumotlari belgisi yaratgan, degan xulosaga keladi.
Bu topilma tekshirilgan 170 xulosa uchun bevosita matniy dalil taqdim etadi. Shunga qaramay, modelning Okeaniyaga oid barcha reprezentatsiyasi faqat Disney filmidan kelib chiqqan deb bo‘lmaydi.
Topilmalar narrativ tuzilmani o‘lchaydimi yoki yuzaki so‘zlarni?
Tadqiqotdagi eng muhim talqin savollaridan biri shu. Tadqiqotchi natijalarni “mintaqaviy narrativ shablonlar” deb ataydi. Biroq ishlatilgan all-MiniLM embeddinglari quyidagi unsurlarning barchasidan ta’sirlanishi mumkin:
- Qahramon ismlari
- Joy va o‘simlik nomlari
- Manzara tasvirlari
- Hikoyaning asosiy mavzusi
- Voqealar ketma-ketligi
- Hissiy ohang
- Xulosada qaysi tafsilotlar tanlangani
TF-IDF natijasi eng ko‘rinadigan mintaqaviy farq asosan ismlar va ramziy muhit unsurlari ekanini ko‘rsatadi. Shu sababli 74,7 foizlik markaz mosligi haqiqiy syujet farqidan ko‘ra yuzaki madaniy bezakni o‘lchayotgan bo‘lishi mumkin.
Narrativ tuzilmani bevosita sinash uchun quyidagi tahlillar kerak bo‘lishi mumkin edi:
- Qahramon va joy nomlari maskalangandan keyin embedding tahlili
- Manzara va madaniy obyekt so‘zlari olib tashlangandan keyin markaz hisobini takrorlash
- Voqealar tartibi, konflikt, kulminatsiya va yechim qismlarini alohida kodlash
- Inson baholovchilarning tuzilma o‘xshashligi ballari
- Hikoya voqealarini ega–harakat–obyekt zanjirlari bilan ifodalash
- To‘liq hikoya bilan xulosa natijalarini taqqoslash
Tadqiqotning kuchli tomonlari nimalar?
- 11.800 hikoyadan iborat keng va ochiq ma’lumot manbasidan foydalanilgan.
- 235 millat keng geografik qamrovni ta’minlaydi.
- Dastlabki ma’lumot yaratish bilan yangi tahlil hissasi aniq ajratilgan.
- Geografik guruhlar embedding ma’lumotidan emas, tashqaridan belgilangan UN M49 tasnifidan olingan.
- Tahlil asl 384 o‘lchamli fazoda bajarilgan, UMAP faqat vizualizatsiya uchun ishlatilgan.
- KMeansning muvaffaqiyatsiz natijasi yashirilmagan va metodologik topilma sifatida berilgan.
- Chalkashlik matritsasi mintaqaviy mosliklarni batafsil ko‘rsatadi.
- Chi-kvadrat, Cramér’s V va nisbat testlaridan foydalanilgan.
- Embedding tahlili TF-IDF so‘z taqqoslash bilan qo‘llab-quvvatlangan.
- Moana topilmasi avtomatik natija sifatida qoldirilmay, tegishli namunalar qo‘lda tekshirilgan.
- Tahlil kodi va asosiy ma’lumotlar to‘plami uchun ochiq manzillar berilgan.
- Tadqiqotchi o‘z usuli mintaqa kategoriyalarini o‘zi ham gomogenlashtirishi mumkinligini ochiq tan olgan.
Tadqiqotning asosiy cheklovlari nimalar?
- Tadqiqot hakamlar ko‘rigidan o‘tmagan preprintdir.
- Faqat gpt-4o-mini yaratgan hikoyalar tekshirilgan.
- Bitta inglizcha prompt qolipidan foydalanilgan.
- Model versiyasi, generatsiya sozlamalari va vaqt davri o‘zgarsa natijalar ham o‘zgarishi mumkin.
- Tahlil to‘liq hikoyalarga emas, yana o‘sha LLM yaratgan xulosalarga tayanadi.
- Xulosa qilish bosqichi madaniy tafsilotlarni tanlagan yoki kuchaytirgan bo‘lishi mumkin.
- Gap embedding yaqinligi madaniy yoki narrativ o‘xshashlikning bevosita o‘lchovi emas.
- Embedding usuli inson baholashi bilan keng ko‘lamda tasdiqlanmagan.
- Mintaqaviy markazlar va tasnif bir xil ma’lumot ustida hisoblangan.
- Mustaqil test, cross-validation yoki leave-one-out usuli ishlatilmagan.
- Tasodifiy yoki yorliqlari aralashtirilgan taqqoslash bazasi berilmagan.
- Mintaqalar bo‘yicha namuna soni muvozanatining natijalarga ta’siri tekshirilmagan.
- UN M49 geografik sinflari madaniy an’analar bilan bir-biriga aynan mos kelmaydi.
- Afrika, Osiyo va Amerika kabi guruhlar ichki jihatdan haddan tashqari keng.
- Mamlakat, submintaqa, til oilasi yoki tarixiy narrativ an’ana darajasida tahlil o‘tkazilmagan.
- TF-IDF so‘zlarining bir qismi syujet emas, faqat qahramon ismidir.
- Madaniy ismlar maskalangandan keyin natijalar saqlanib qolishi tekshirilmagan.
- KMeansning past silhouette natijasi barcha mumkin bo‘lgan klasterlash usullarini inkor etmaydi.
- “Beshta alohida shablon” iborasi alohida klasterlar topilmagani bilan konseptual taranglik hosil qiladi.
- Afrika–Osiyo yaqinligi syujet, so‘z tanlovi yoki xulosa qilish xatti-harakatining qaysi biriga asoslanganligi ajratilmagan.
- Postkolonial tushunchalar bilan bog‘lanish talqiniy bo‘lib, bevosita o‘lchangan sabab mexanizmi emas.
- Sifat jihatidan validatsiya atigi to‘qqiz hikoyadan iborat kichik namunaga tayanadi.
- Mintaqadan tashqariga biriktirilgan hikoyalarning tizimli yaqin o‘qilishi amalga oshirilmagan.
- Yakuniy ma’lumot soni bilan chi-kvadrat testida berilgan namuna soni o‘rtasida izohlanmagan 48 yozuvlik farq mavjud.
Tadqiqot nimani qo‘llab-quvvatlaydi?
- Tekshirilgan gpt-4o-mini xulosalari geografik mintaqalar bo‘yicha mutlaqo tasodifiy tarqalmaganini qo‘llab-quvvatlaydi.
- Hikoyalarning taxminan to‘rtdan uch qismi o‘z mintaqaviy markaziga yaqinroq ekanini ko‘rsatadi.
- Yevropa va Okeaniya hikoyalari o‘z markazlariga ko‘proq mos kelishini ko‘rsatadi.
- Afrika va Osiyo o‘rtasida boshqa mintaqa juftlariga qaraganda yuqoriroq ikki tomonlama embedding yaqinligi borligini ko‘rsatadi.
- Mintaqaviy farqlanishning muhim qismi shaxs ismlari va ramziy manzara unsurlari orqali qurilganini qo‘llab-quvvatlaydi.
- Okeaniya hikoyalarida Disney’ning Moana narrativiga xos unsurlar takrorlanishini ko‘rsatadi.
- KMeans ostida alohida va ixcham narrativ klasterlar qo‘llab-quvvatlanmaganini ko‘rsatadi.
- Narrativ fazoni keskin kategoriyalardan ko‘ra uzluksiz mintaqaviy tortilishlar bilan tushuntirish ma’qulroq bo‘lishi mumkinligini qo‘llab-quvvatlaydi.
Tadqiqot nimani isbotlamaydi?
- Barcha katta til modellari ayni mintaqaviy qoliplarni yaratishini isbotlamaydi.
- Hozirgi yoki kattaroq model versiyalari ham xuddi shu natijani berishini ko‘rsatmaydi.
- Turkcha yoki boshqa tillarda ham xuddi shu qoliplar paydo bo‘lishini ko‘rsatmaydi.
- Model ongli ravishda madaniy diskriminatsiya qilayotganini isbotlamaydi.
- Afrika va Osiyodagi barcha mamlakatlar bir xil ifodalanishini ko‘rsatmaydi.
- Yuqori mintaqaviy moslik madaniy aniqlik yoki madaniy boylikni anglatishini isbotlamaydi.
- Yevropa hikoyalari haqiqiy Yevropa narrativ an’analarini aniqroq aks ettirishini ko‘rsatmaydi.
- Markaz mosligi syujet tuzilmasidan kelib chiqqanini qat’iy ko‘rsatmaydi.
- 50 so‘zli xulosalar to‘liq hikoyalardagi barcha madaniy mazmunni saqlab qolishini isbotlamaydi.
- Foiz 74,7 ko‘rsatkichi mustaqil yangi ma’lumotlarda takrorlanishini ko‘rsatmaydi.
- Postkolonial nazariya kuzatilgan barcha sonli naqshlarning yagona izohi ekanini isbotlamaydi.
Tadqiqotning usuli va topilmalari
Tadqiqot dizayni
Tadqiqot ilgari e’lon qilingan sun’iy intellekt yaratgan matn ma’lumotlar to‘plamining ikkilamchi hisoblash tahlilidir. Yangi hikoyalar yaratilmagan; mavjud xulosalar embedding, klasterlash, markazga yaqinlik, so‘z taqqoslash va statistik testlar bilan qayta baholangan.
Ma’lumot oqimi
- 236 millatga oid 11.800 hikoyadan iborat ochiq ma’lumotlar to‘plami olingan.
- Haqiqiy millatni o‘z ichiga olmaydigan XX kategoriyasi chiqarilgan.
- 235 millatga oid 11.750 hikoya UN M49 mintaqalariga biriktirilgan.
- Har bir hikoyaning 50 so‘zli xulosasi all-MiniLM-L6-v2 bilan embedding qilingan.
- 384 o‘lchamli vektorlar eksploratsiya maqsadida UMAP bilan ikki o‘lchamga kamaytirilgan.
- KMeans uchun K = 4–20 silhouette tahlili bajarilgan.
- Har bir mintaqaning normallashtirilgan o‘rtacha embedding markazi hisoblangan.
- Har bir hikoya eng yaqin mintaqaviy markazga biriktirilgan.
- Prompt mintaqasi bilan biriktirilgan markaz taqqoslanib chalkashlik matritsasi tuzilgan.
- Mintaqaviy bog‘liqlik chi-kvadrat va Cramér’s V bilan baholangan.
- Afrika–Osiyo nisbatlari ikki nisbatli z testlari bilan taqqoslangan.
- Mintaqalarga xos so‘zlar TF-IDF kontrasti bilan ajratilgan.
- Moana uchragan Okeaniya xulosalari qo‘lda tekshirilgan.
Asosiy ma’lumot va model xususiyatlari
| Element | Tadqiqotda berilgan qiymat |
|---|---|
| Dastlabki hikoya soni | 11.800 |
| Dastlabki millat soni | 236 |
| Har bir millat uchun hikoya | 50 |
| Yakuniy hikoya soni | 11.750 |
| Yakuniy millat soni | 235 |
| Hikoya yaratgan model | gpt-4o-mini |
| Yaratish sanalari | 13–19 yanvar 2025 |
| Tahlil matni | Model yaratgan 50 so‘zli xulosalar |
| Embedding modeli | all-MiniLM-L6-v2 |
| Embedding o‘lchami | 384 |
| KMeans diapazoni | K = 4–20 |
| Silhouette kichik namunasi | 2.000 hikoya |
Asosiy natijalar xulosasi
| Ko‘rsatkich | Natija | Talqin chegarasi |
|---|---|---|
| Umumiy mintaqaviy markaz mosligi | %74,7 | Xuddi shu ma’lumotdan yaratilgan markazlar ustida hisoblangan. |
| Yevropa mosligi | %83,6 | Madaniy aniqlikni bevosita ko‘rsatmaydi. |
| Okeaniya mosligi | %81,5 | Moana kabi kuchli media belgilaridan ta’sirlanishi mumkin. |
| Afrika mosligi | %71,9 | 54 mamlakat bitta markaz ostida birlashtirilgan. |
| Osiyo mosligi | %70,4 | Juda turli submintaqalar bitta markaz ostida birlashtirilgan. |
| Amerika mosligi | %69,8 | Shimoliy, Markaziy va Janubiy Amerika bitta keng guruhda. |
| Afrika → Osiyo | %12,8 | Embedding yaqinligi; bevosita madaniy tenglashtirish o‘lchovi emas. |
| Osiyo → Afrika | %14,0 | Eng yuqori mintaqadan tashqari biriktirish. |
| KMeans silhouette | 0,031–0,039 | Alohida klasterlarni qo‘llab-quvvatlamaydi. |
| Chi-kvadrat | χ²(16) = 22.278,4; p < 0,001 | Matndagi n = 11.652 qiymati ma’lumot jami bilan mos kelmaydi. |
| Cramér’s V | 0,691 | Prompt mintaqasi bilan markaz biriktirilishi o‘rtasida kuchli bog‘liqlik bildirilgan. |
Statistik baholash
Chi-kvadrat testi prompt mintaqasi bilan markaz biriktirilishi mustaqil emas, degan xulosani qo‘llab-quvvatlaydi. Katta namuna sabab p qiymatining juda kichik bo‘lishi kutilishi mumkin; shu bois bog‘liqlik kattaligini ko‘rsatuvchi Cramér’s V qiymati alohida muhim.
Afrika–Osiyo biriktirishlarining keyingi eng katta mintaqadan tashqari nisbat bo‘lgan Okeaniya–Amerika nisbatidan sezilarli darajada yuqori ekani ikki nisbatli z testlari bilan bildirilgan.
Bunga qarshi quyidagi noaniqliklar miqdoriy baholanmagan:
- Markaz vektorlarining namunaviy noaniqligi
- Turli embedding modellarida moslik ko‘rsatkichining o‘zgarishi
- Hikoya yaratishdagi tasodifiylik
- Millatlar o‘rtasidagi nomutanosib madaniy reprezentatsiya
- Xulosa qilish bosqichining ta’siri
- Inson baholovchilar orasidagi moslik
- Mustaqil test to‘plamidagi natija
Takrorlash uchun taqdim etilgan manbalar
- Tahlil kodi GitHubda ochiq ekani bildirilgan.
- Dastlabki hikoya ma’lumotlar to‘plami Dataverse.no da ochiq ekani bildirilgan.
- Embedding modeli va asosiy UMAP sozlamalari tushuntirilgan.
- TF-IDF lug‘at va n-gram sozlamalari berilgan.
Biroq asosiy matnda mintaqa bo‘yicha hikoya sonlari, markaz vektorlari yoki chi-kvadrat testidagi 11.652 namunasiga qanday erishilganini ko‘rsatuvchi ma’lumot tozalash jurnali mavjud emas.
Kelajak tadqiqotlari uchun zarur qadamlar
- To‘liq hikoyalar bilan model yaratgan xulosalarni taqqoslash
- Qahramon va joy nomlarini maskalab tahlilni takrorlash
- Mustaqil test va millat asosidagi cross-validation
- Turli gap-embedding modellarini taqqoslash
- Bir nechta LLM va model versiyasini sinash
- Inglizchadan boshqa prompt va hikoya tillarini baholash
- Mamlakat va submintaqa darajasida batafsilroq tahlil
- Hikoya syujetini inson yoki strukturali narrativ kodlash bilan o‘lchash
- Mintaqadan tashqariga biriktirilgan hikoyalarni tizimli yaqin o‘qish
- Madaniyat mutaxassislari baholari bilan validatsiya
- Turli prompt shakllari stereotiplashni kamaytiradimi, sinash
- Ijodiy yozuvchilarga berilgan sun’iy intellekt takliflarining inson ijodiga ta’sirini o‘rganish
Manba va usul izohi
Tadqiqotning asl nomi: How AI Stereotypes the World: Regional Narrative Templates in LLM-Generated Stories
Muallif: Paarth Singh Rathore.
Mualliflar tartibi: Tadqiqot yakka mualliflikda.
Teng hissa ma’lumoti: Yakka mualliflik sabab teng hissa bayonoti mavjud emas.
Mas’ul muallif: Hujjatda alohida “corresponding author” belgisi yo‘q. Yakka muallifning aloqa e-pochtasi berilgan.
E-pochta: paarthsinghrathore1@gmail.com
Muassasa: Department of Computer Science and Information Systems, BITS Pilani, Pilani, Rajasthan, India.
Rasmiy nashr platformasi: SSRN.
Rasmiy tadqiqot havolasi:SSRN tadqiqot sahifasi
SSRN yuklash sanasi: 31 iyul 2026.
Sahifalar soni: 9.
Nashr yili: 2026.
Jurnal yoki konferensiya: Ushbu versiyada hakamlar ko‘rigidan o‘tgan jurnal, qabul qilingan konferensiya yoki nashr qilingan ma’ruza haqida ma’lumot yo‘q.
Nashriyot va platforma holati: Tadqiqot SSRN preprint platformasida joylashgan. Hakamli jurnal nashriyoti tasdiqlanmagan.
Manba turi: Ochiq sun’iy intellekt hikoya ma’lumotlar to‘plami gap embeddinglari, mintaqaviy markazlar, klasterlash, TF-IDF va statistik testlar yordamida qayta tahlil qilingan hisoblash ijtimoiy fanlari va tabiiy tilni qayta ishlash preprinti.
Hakamlik holati: Tadqiqot hakamlar ko‘rigidan o‘tmagan. Natijalar ushbu cheklov hisobga olingan holda o‘qilishi kerak.
Dastlabki ma’lumot egasi: Tadqiqotda ishlatilgan 11.800 hikoyali ma’lumotlar to‘plami Rettberg va Wigersning avvalgi tadqiqotidan olingan. Paarth Singh Rathore hikoyalarni yaratmagan, mavjud ma’lumotga yangi mintaqaviy tahlil qo‘llagan.
Dastlabki ma’lumot havolasi:Dataverse.no ma’lumot qaydi
Tahlil kodi:GitHub kod ombori
Moliyalashtirish: Asosiy matnda moliyalashtirish bayonoti yo‘q.
Manfaatlar to‘qnashuvi: Asosiy matnda manfaatlar to‘qnashuvi bayonoti yo‘q.
Muallif hissalari: Yakka muallifli tadqiqot uchun alohida CRediT hissa bayonoti berilmagan.
Etika qo‘mitasi: Tadqiqot ochiq sun’iy intellekt yaratgan matn ma’lumotiga tayanadi. Inson ishtirokchisi yoki maxsus shaxsiy ma’lumot ishlatilgani bildirilmagan, alohida etika qo‘mitasi ma’lumoti ham berilmagan.
Asosiy sonli nomuvofiqlik: Matnda yakuniy ma’lumotlar to‘plami 11.750 hikoyadan iboratligi va Polar toifasida 50 hikoya borligi aytiladi. Shunga ko‘ra Polar tashqarisidagi besh mintaqada 11.700 hikoya bo‘lishi kutiladi, biroq chi-kvadrat testi uchun n = 11.652 berilgan. Oradagi 48 yozuv holati tushuntirilmagan.
Ushbu turkcha sharh yuklangan tadqiqotning ma’lumot tavsifi, adabiyot doirasi, 384 o‘lchamli gap embedding usuli, UMAP sozlamalari, KMeans silhouette jadvali, mintaqaviy markaz tenglamalari, chalkashlik matritsasi, chi-kvadrat va z testlari, TF-IDF so‘zlari, Moana namunalarining qo‘lda tekshirilishi, muhokamasi va cheklovlari baholanib tayyorlangan. Tadqiqotda mavjud bo‘lmagan model tajribalari yoki mamlakatga xos natijalar qo‘shilmagan.
Tadqiqot ko‘rib chiqilgan gpt-4o-mini hikoyalari barcha millatlarni mutlaqo bir xil tarzda tasvirlamasligini; umumiy syujet ustida keng mintaqalarga qarab turli ismlar va ramziy atrof-muhit unsurlaridan foydalanishini qo‘llab-quvvatlaydi. Biroq natijalar faqat bitta modelning inglizcha promptlar bilan yaratgan va yana shu model xulosa qilgan matnlariga tayanadi. “Mintaqaviy narrativ shablon” da’vosi mustaqil ma’lumotlar, to‘liq matn tahlili, inson baholashi va madaniy yuzaki so‘zlarni nazorat qiluvchi tajribalar bilan tasdiqlanmaguncha umumiy LLM xususiyati sifatida qabul qilinmasligi kerak.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan