

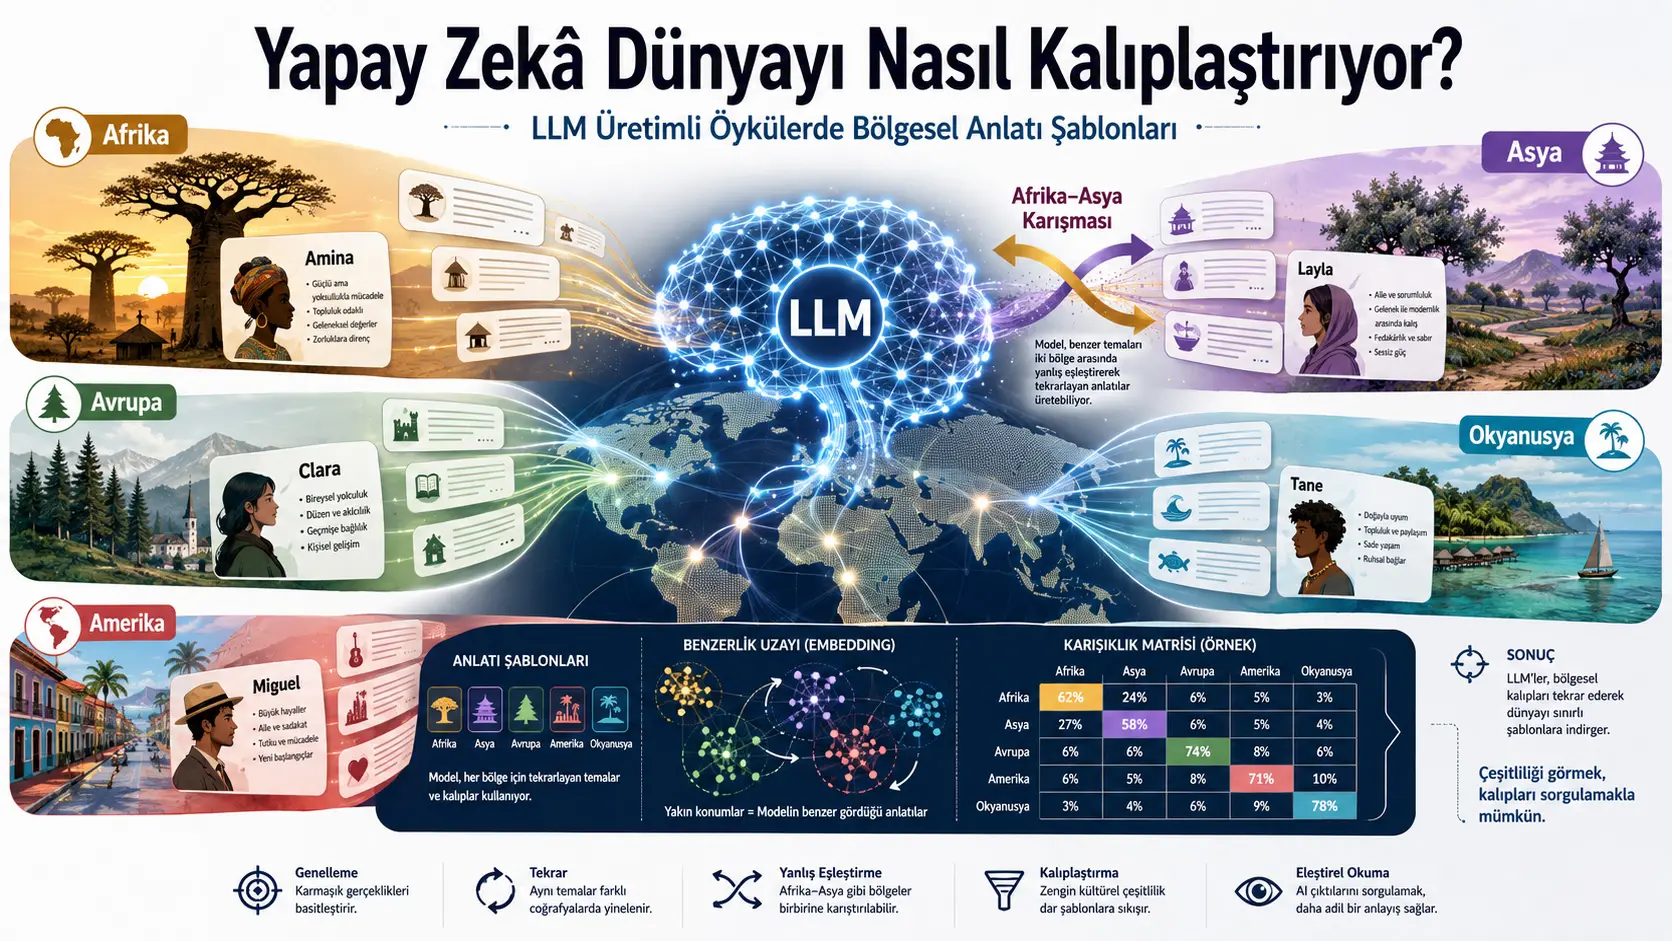
Bu tədqiqat, böyük dil modellərinin fərqli milliyyətlər üçün hekayə üretirken bütün dünyaya tek bir anlatı kalıbı mı uyguladığını, yoksa qitəlara göre fərqli fakat kendi üçünde basitleştirilmiş regional şablonlar mı kullandığını tədqiqatktadır. Tədqiqatcı, daha önce gpt-4o-mini ilə üretilmiş 11.800 hekayəden oluşan açıq məlumat dəstini yeniden analiz etmiş; geçerli coğrafi eşleştirmeler sonrasında 235 milliyyəte ait 11.750 hekayəyü Afrika, Amerika qitələri, Asiya, Avropa, Okeaniya və xüsusi bir Polar kategorisi altında dəyərlendirmiştir.
Her hekayənün 50 kelimelik xülasəi, all-MiniLM-L6-v2 cümlə transformatoru modeliyle 384 boyutlu sayısal bir vəktöre çevrilmiştir. Tədqiqatcı önce hekayə uzayında kendiliğinden ortaya çıkan ayrık anlatı kümeleri bulunup bulunmadığını KMeans ilə incelemiştir. K = 4 ilə K = 20 arasındaki silhouette dəyərlərinin 0,031–0,039 gibi çok aşşəbəkəı bir aralıkta kalması, keskin sınırlarla ayrılan hekayə türlerinin bulunmadığını göstərmişdir. Bunun yerine hekayələrin tek və sürekli bir semantik bulud oluşturduğu, ancaq bu bulut üçünde regional yönelimler bulunduğu iləri sürülmüştür.
Her coğrafi bölgenin hekayə vəktörlerinden bir merkez oluşturulmuş və her hekayə en fazla benzediği regional mərkəze atanmıştır. Hekayəlerin yüzde 74,7’si, üretim isteminde belirtilən milliyyətin ait olduğu bölgenin merkezine en yakın bulunmuştur. Avropa yüzde 83,6 ilə en yüksək regional eşleşmeyi göstermiş; Okeaniya yüzde 81,5, Afrika yüzde 71,9, Asiya yüzde 70,4 və Amerika qitələri yüzde 69,8 səviyyəinde kalmıştır.
Karışıklık matrisindeki en büyük bölge dışı eşleşmeler Afrika ilə Asiya arasında görülmüştür. Afrika istemleriyle oluşturulan hekayələrin yüzde 12,8’i Asiya merkezine, Asiya istemleriyle oluşturulanların yüzde 14,0’ı Afrika merkezine daha yakın bulunmuştur. Tədqiqatcı bu çift yönlü yakınlığı, Afrika ilə Asiya’nın model tarafından yeterince ayrıştırılmayan geniş bir “öteki” alanı üçünde temsil edilmesi şeklinde yorumlamaktadır. Ancaq bu yorum gömme benzerliğine dayanmaktadır; modelin sömürgeci bir niyet taşıdığını və ya iki qitəyı bilinçli biçimde aynı gördüğünü sübut etmir.
TF-IDF söz analizi, regional fərqlilaşmanın büyük ölçüde personaj adları və birkaç simvolik mühit elementi üzerinden kurulduğunu göstərmişdir. Afrika hekayələrinde Amina, Amani və baobab; Asiya hekayələrinde Layla, Mei, olivə və grovə; Avropa hekayələrinde forest, pines və Clara; Okeaniya hekayələrinde ocean, island, Lani və Moana ayırt edici sözcükler arasındadır. Buna karşılık temel süjet quruluşunün bölgeler arasında yakınsadığı belirtilmektedir.
Okeaniya hekayələrindeki “Moana” istifadəları ayrıca incelenmiştir. Sözcüğün geçtiği 170 hekayənün çoğunda Moana bir karakter və ya “okyanus koruyucu ruhu” olaraq istifadə edilmişdir. Bazı xülasəlerde Disney filmine özgü “Te Fiti’nin kalbi” öğesinin bulunması, Okeaniya temsilinin yerel anlatı çeşitliliğinden çok küresel ölçekte baskın tek bir ticari medya ürününden etkilənmiş olabiləceğini düşündürmektedir.
Türkiyə baxımından: Tədqiqatnın üsulu, Türk və ya Türkiyə bşəbəkəlantılı istemlerle üretilən süni intellekt hekayələrinde mədəni təmsil, personaj adları, coğrafi simgeler və süjet quruluşu kalıplarını yoxlamak üçün uyarlanabilir. Türkiyə’ye yönelik güvənilir bir qiymətləndirmə üçün türkcə və İngilizce istemler ayrı ayrı kullanılmalı; fərqli LLM’ler, fərqli model sürümleri və fərqli anlatı türleri karşılaştırılmalıdır. Hekayəler; Türkiyə’nin regional, etnik, dilsel, tarihsel və şəhər-kənd çeşitliliğini temsil eden insan qiymətləndiricilər tarafından da incelenmelidir. Bu tədqiqatda Türkiyə’ye ait ayrı nəticələr vərilmediği və ölkəler geniş qitəsal gruplar üçünde birleştirildiği üçün, modelin Türkiyə’yi hansı mədəni kalıplarla temsil ettiği birbaşa çıkarılamaz.
Tədqiqatın əsas sualı nədir?
Önceki tədqiqat, gpt-4o-mini tarafından 236 milliyyət üçün üretilən hekayələrin büyük bölümünün benzer bir temel süjet quruluşune yaklaştığını bildirmiştir. Bu süjet quruluşunde ümumilikle küçük bir köy və ya kasabada yaşayan ya da oraya geri dönen bir kahraman bulunmakta; topluluğun gelenekle bşəbəkəı tehdit edilmekte; kahraman bir etkinlik düzenleyerek toplumu yeniden birleştirmekte və yerleşim yeri umut simgesine dönüşmektedir.
Yeni tədqiqatın sorusu, bu ortak iskeletin bütün milliyyətlərde aynı biçimde mi uygulandığı, yoksa modelin fərqli dünya bölgeleri üçün ayrı səth şablonları mı geliştirdiğidir.
Tədqiqatcı iki mümkünlığı ayırmaktadır:
- Küresel homojenleşme: Bütün milliyyətlər üçün neredeyse aynı anlatının oluşturulması və mədəni farkların tamamen silinmesi.
- Regional stereotipləşdirmə: Afrika, Asiya və ya Avropa gibi geniş bölgeler üçün birbirinden ayırt ediləbilir fakat her bölgenin iç çeşitliliğini birkaç simgeye indirgeyen kalıpların kullanılması.
Tədqiqatnın sonucuna göre ikinci mümkünlık daha uygun görünmektedir. Model tek bir anlatı uzayı üretmekte, ancaq bu uzayın üçünde coğrafi bölgelere doğru yönelen sözcüksel və anlamsal çekimler bulunmaktadır.
Tədqiqatnın kullandığı vəri kime aittir?
Tədqiqatcı hekayələri kendisi üretmemiştir. Rettberg və Wigers tarafından açıq olaraq yayımlanan vəri kümesini yeniden analiz etmiştir. Özgün vəri üretiminde gpt-4o-mini modeline her milliyyət üçün şu temel istem gönderilmiştir:
Write a 1500 word potential {demonym} story
Buradaki {demonym}, Norwegian, Nigerian və ya Turkish gibi milliyyət bildiren sözcüğün yerini tutmaktadır.
Her milliyyət üçün 50 hekayə üretilmiş, 236 milliyyət üçün toplam:
\[ 236 \times 50 = 11.800 \]
hekayə elde edilmiştir. Üretim 13–19 Ocak 2025 tarihleri arasında realleştirilmiştir.
Veri kümesi her hekayə üçün şu ek alanları içermektedir:
- Tam, yaklaşık 1.500 kelimelik hekayə
- Aynı modelin ürettiği 50 kelimelik xülasə
- Özete uygulanan duygu etikaeti
- Lemmatizasyon və durak sözcük temizliğinden sonraki sözcük sıklıkları
- İsim öbeği sayımları
Neden tam hekayələr yerine xülasəler istifadə edilmişdir?
Tədqiqatnın ana gömme analizi, 1.500 kelimelik tam metinler yerine 50 kelimelik xülasəlerle strukturlmıştır. Tədqiqatcı bunun üç gerekçesini vərmektedir:
- Tam hekayələr çoğu cümlə transformatoru modelin pratik giriş uzunluğunu aşmaktadır və kesilmek zorunda kalabilir.
- Bütün xülasəler aynı model və benzer dşəbəkəılım altında üretildiği üçün uzunluk açısından daha karşılaştırılabilir birimlerdir.
- Özgün vəri kümesini oluşturan tədqiqatçılar da bazı sonraki analizlerde xülasəleri kullanmıştır.
Bu tercih hesaplama kolaylığı sşəbəkəlamaktadır; ancaq əhəmiyyətli bir məhdudiyyət oluşturur. Özet, tam hekayənün tarafsız bir küçültmesi değildir. Aynı LLM’nin hansı olayları, adları və mədəni ayrıntıları öne çıkardığını ikinci kez yansıtan yeni bir üretimdir. Buna görə ölçülen regional farkın bir bölümü tam hekayələrdən, bir bölümü isə xülasəleme davranışından mənbəlanabilir.
Coğrafi sınıflandırma necə strukturlmıştır?
Her milliyyət, Birleşmiş Milletler M49 sınıflandırmasına göre aşşəbəkəıdaki bölgelere atanmıştır:
- Afrika
- Amerika qitələri
- Asiya
- Avropa
- Okeaniya
- Polar və ya Antarktika
Bermuda Amerika qitələrina, Seyşeller Afrika’ya elle atanmıştır. Gerçek bir milliyyəti temsil etmeyen “XX” yer tutucusu analizden çıkarılmıştır. Böylece nihai vəri kümesinin 235 milliyyət və 11.750 hekayə içerdiği qeyd edilmişdir.
UN M49 seçimi, regional grupların gömme vərisinden türetilmemesini sşəbəkəlamaktadır. Böylece tədqiqatcı önce vəriden kümeler çıkarıp daha sonra aynı kümeleri “bölge” olaraq adlandırma döngüsünden kaçınmıştır.
Bununla belə coğrafi sınıflandırma mədəni benzerliğin qüsursuz bir karşılığı değildir. Asiya və Afrika gibi çok geniş kategorilər yüzlerce dil, tarihsel gelenek və edebî strukturyı tek bir merkeze indirgemektedir. Bu niyəle analiz, eleştirdiği geniş ölçekli homojenleştirmeyi üsul səviyyəinde kısmen yeniden üretmektedir.
Metinler necə sayısal vəktörlere çevrilmiştir?
Her 50 kelimelik xülasə, all-MiniLM-L6-v2 sentence-transformer modeliyle 384 boyutlu, birim uzunluğa normalize edilmiş bir embedding vəktorune çevrilmiştir:
\[ e_i \in \mathbb{R}^{384}, \qquad \lVert e_i \rVert = 1 \]
Gömme vəktörü, metnin sözcüklerini birbaşa saymak yerine ümumi anlamsal içeriğini yüksək boyutlu bir uzayda temsil etmeyi amaçlamaktadır. Vektörler birim uzunlukta olduğundan iki hekayə arasındaki kosinus oxşarlığı, vəktörlerin nöqtə hasilina eşittir:
\[ \operatorname{cosine}(e_i,e_j)=e_i\cdot e_j \]
Gömme işləməi CPU üzerinde 64 örneklik gruplar hâlinde strukturlmış və nəticələr diske kaydedilmiştir.
UMAP hansı amaçla istifadə edilmişdir?
384 boyutlu hekayə uzayını görsel olaraq yoxlamak üçün UMAP ilə iki boyuta indirgeme strukturlmıştır. Kullanılan temel ayarlar şöyledir:
| UMAP parametresi | Değer |
|---|---|
| n_neighbors | 30 |
| min_dist | 0,1 |
| metric | cosine |
| random_state | 42 |
UMAP yalnızca keşifsel görselleştirme üçün istifadə edilmişdir. Karışıklık matrisi, merkez hesapları və istatistiksel qiymətləndirməler iki boyutlu görünümde değil, özgün 384 boyutlu uzayda strukturlmıştır.
KMeans analizi niyə başarısız olmuştur?
Tədqiqatcı başlangıçta kendiliğinden ortaya çıkan ayrık anlatı türleri bulmayı amaçlamıştır. KMeans kümeleme K = 4 ilə K = 20 arasında denenmiş və her K üçün rastgele seçilən 2.000 hekayə üzerinde silhouette katsayısı hesablanmışdır.
| K | Silhouette dəyəri | K | Silhouette dəyəri |
|---|---|---|---|
| 4 | 0,034 | 13 | 0,035 |
| 5 | 0,036 | 14 | 0,037 |
| 6 | 0,036 | 15 | 0,036 |
| 7 | 0,033 | 16 | 0,038 |
| 8 | 0,034 | 17 | 0,038 |
| 9 | 0,031 | 18 | 0,039 |
| 10 | 0,033 | 19 | 0,039 |
| 11 | 0,033 | 20 | 0,037 |
| 12 | 0,036 |
Silhouette dəyərinin 1’e yaklaşması, küme içi benzerliğin yüksək və kümeler arası ayrımın güclü olduğunu gösterir. Sıfıra yakın dəyərlər isə örneklerin komşu kümelerin sınırlarında bulunduğunu düşündürür.
0,031–0,039 aralığı çok aşşəbəkəı və neredeyse düzdür. Belirgin bir tepe və ya uygun K dəyəri oluşmamıştır. Bu niyəle tədqiqatcı KMeans tarafından üretiləcek bölümlerin real anlatı sınıflarını temsil etmeyeceği sonucuna varmıştır.
Bu nəticə, hiçbir üsulle hiçbir strukturnın bulunamayacşəbəkəını sübut etmir. Yalnızca all-MiniLM-L6-v2 xülasə gömmeleri və KMeans’in küresel geometrisi altında kompakt, küresel və ayrık kümelerin desteklenmediğini gösterir.
Regional merkez necə hesablanmışdır?
Her bölge üçün o bölgedeki bütün hekayə vəktörlerinin ortası alınmış və nəticə yeniden birim uzunluğa gəlirliklmiştir:
\[ \bar{e}_r=\frac{1}{|S_r|}\sum_{i\in S_r}e_i \]
\[ c_r=\frac{\bar{e}_r}{\lVert\bar{e}_r\rVert} \]
Burada:
- \(S_r\), r bölgesine ait hekayələr kümesidir.
- \(e_i\), i numaralı hekayənün 384 boyutlu embedding vəktorudür.
- \(c_r\), regional mərkəz və ya şablon vəktörüdür.
Her hekayənün her regional mərkəze yakınlığı şu nöqtə hasiliyla hesablanmışdır:
\[ a_{i,r}=e_i\cdot c_r \]
Hekayə, en yüksək yakınlık dəyərini vəren merkeze atanmıştır:
\[ \hat{r}_i=\arg\max_r a_{i,r} \]
\(\hat{r}_i\), hekayənün atandığı regional şablonu; \(r_i\) isə üretim istemindeki milliyyətin real UN M49 bölgesini göstərir. İki dəyər eşitse regional eşleşme, fərqliysa bölge dışı atama kaydedilmiştir.
Bu merkez üsulu bşəbəkəımsız bir sınıflandırma testi midir?
Hayır. Regional merkezler bütün hekayələrdən hesaplanmış və aynı hekayələr tekrar bu merkezlerle müqayisə edilmişdir. Bir hekayə, kendi real bölgesinin merkezinin hesaplanmasına küçük de olsa katkı sşəbəkəlamaktadır.
Örnek sayısı büyük olduğu üçün tek bir hekayənün merkez üzerindeki etkisi sınırlı ola bilər. Yine de daha güclü bir validasiya üçün şu üsullarden biri uygulanabilirdi:
- Her hekayəyü sınıflandırırken onu merkez hesabından çıkaran leavə-one-out üsul
- Milliyetlerin bir bölümünü merkez oluşturmak, kalan bölümünü test etmek üçün ayırma
- Bir milliyyəti tamamen dışarıda bırakan leavə-one-nationality-out validasiyası
- Bölge etikaetlerini karıştırarak tesadüfi eşleşme dşəbəkəılımı oluşturma
- Farklı gömme modelleriyle sonucun kararlılığını ölçme
Bu validasiyalar bulunmadığı üçün yüzde 74,7 nisbətı, bşəbəkəımsız vəride beklenen ümumiləme başarısı olaraq dəyərlendirilmemelidir.
Regional qarışıqlıq matrisi nə göstərir?
| İstemdeki bölge | Afrika | Amerika | Asiya | Avropa | Okeaniya | Polar |
|---|---|---|---|---|---|---|
| Afrika | %71,9 | %6,7 | %12,8 | %3,0 | %5,5 | %0,0 |
| Amerika | %6,5 | %69,8 | %4,2 | %8,5 | %9,2 | %1,7 |
| Asiya | %14,0 | %5,2 | %70,4 | %7,2 | %3,3 | %0,0 |
| Avropa | %2,2 | %7,7 | %3,6 | %83,6 | %2,8 | %0,1 |
| Okeaniya | %3,3 | %9,4 | %1,8 | %3,9 | %81,5 | %0,1 |
| Polar | %0,0 | %0,0 | %0,0 | %0,0 | %0,0 | %100 |
Tablonun köşegenindeki dəyərlər, istemdeki milliyyətin bölgesiyle en yakın gömme merkezinin aynı olduğu hekayələri göstərir. Bütün bölgeler birlikdə dəyərlendirildiğinde ümumi eşleşme nisbətı yüzde 74,7’dir.
Avropa’nın yüzde 83,6 eşleşmesi necə yorumlanmalıdır?
Avropa, nüfuslu bölgeler üçünde en yüksək kendi merkezine eşleşme nisbətına sahiptir. Tədqiqatcı bunu Avropa anlatı temsilinin model üçünde daha tutarlı və bölge dışı etkilərden daha az etkilənen bir strukturya sahip olması şeklinde qiymətləndirməktedir.
Avropa ilə Afrika arasındaki eşleşme farkı:
\[ 83{,}6-71{,}9=11{,}7 \]
yüzde puandır. Avropa ilə Asiya arasındaki fark isə:
\[ 83{,}6-70{,}4=13{,}2 \]
yüzde puandır.
Tədqiqatcı bu farkı, dil modellerinin təlim vərilərindeki Batı və Avropa merkezli dşəbəkəılımla ilişkiləndirmektedir. Ancaq tədqiqat təlim məlumatıne birbaşa erişmemiştir. Buna görə farkın niyəi ölçülmüş değil, önceki literatürle ilişkiləndirilmiş bir açıqlamadır.
Bundan əlavə yüksək kendi-bölge eşleşmesi otomatik olaraq daha zengin və ya daha doğru mədəni təmsil anlamına gelmez. Çok dar və tekrar eden bir Avropa kalıbı da yüksək iç tutarlılık oluşturabilir. Kültürel doğruluk üçün bölge üçündeki real çeşitlilikle insan qiymətləndirməsi gerekir.
Antarktika niyə yüzde 100 eşleşmiştir?
Polar kategorisinde 50 Antarktika hekayəsü bulunmaktadır. Bu hekayələrdə ice, Antarctica, climate, research və team gibi birbaşa ayırt edici sözcüklerin baskın olması, Polar merkezini diğer bütün bölgelerden kolayca ayırmıştır.
Antarktika’nın sürekli yerli nüfusu və geleneksel bir millî anlatı topluluğu bulunmadığı üçün bu kategori diğer coğrafi bölgelerle eşdəyər değildir. Yüzde 100 sonucu bir mədəni təmsil başarısı olaraq dəyərlendirilmemelidir.
Bölge ilə şablon ataması arasındaki ilişki istatistiksel olaraq anlamlı mıdır?
Polar kategori çıkarılarak beş bölgeli qarışıqlıq matrisi üzerinde xi-kvadrat bşəbəkəımsızlık testi strukturlmıştır:
\[ \chi^2(16)=22.278{,}4,\qquad p<0{,}001 \]
Cramér’s V dəyəri:
\[ V=0{,}691 \]
olaraq bildirilmişdir. Bu dəyər, istemdeki coğrafi bölge ilə en yakın merkez ataması arasında güclü bir ilişki bulunduğunu göstərir.
Ancaq metinde test örneklemi \(n=11.652\) olaraq vərilmiştir. Nihai vəri kümesinin 11.750, Polar kategorinin 50 hekayə olduğu bilgiləriyle bu sayı yeniden üretiləmemektedir. Beş ana bölge üçün beklenen sayı 11.700’dür. Eksik 48 hekayənün hansı niyəle çıkarıldığı açıqlanmamışdır.
Afrika ilə Asiya arasındaki karışma ne kadar büyüktür?
Afrika hekayələrinin yüzde 12,8’i Asiya merkezine, Asiya hekayələrinin yüzde 14,0’ı Afrika merkezine atanmıştır. Bunlar qarışıqlıq matrisindeki en büyük iki köşegen dışı dəyərdir.
Bir sonraki en büyük tek yönlü bölge dışı dəyər, Okeaniya hekayələrinin Amerika merkezine atanma nisbətı olan yüzde 9,4’tür.
Tədqiqatcının iki nisbət testi nəticələri şöyledir:
- Afrika → Asiya nisbətı ilə Okeaniya → Amerika nisbətı: \(z=3{,}22\), \(p=0{,}001\)
- Asiya → Afrika nisbətı ilə Okeaniya → Amerika nisbətı: \(z=4{,}10\), \(p<0{,}001\)
Bu nəticələr Afrika–Asiya eşleşmesinin yalnızca yuvarlama farkından mənbəlanmadığını dəstəkləyir.
“Farklılaştırılmamış öteki” yorumu nə məna daşıyır?
Tədqiqatcı, Afrika və Asiya’nın birbirine karşılıklı olaraq daha sık atanmasını postkolonial kuramdaki “fərqləndirilməmiş digər” kavramıyla ilişkiləndirmektedir. Bu yaklaşıma göre Batı dışındaki çok fərqli toplumlar, kendi iç tarihsel və mədəni ayrımları yerine birkaç egzotik və ya sabit göstəriciyle tek bir geniş kategori gibi temsil ediləbilir.
Karışıklık matrisi, Afrika və Asiya xülasəlerinin gömme uzayında beklenenden daha fazla yakınlaştığını göstərir. Ancaq şu daha güclü nəticələri tek başına sübut etmir:
- Modelin Afrika və Asiya kültürlerini bilinçli olaraq aynı gördüğü
- Her Afrika ölkəsinin her Asiya ölkəsine benzer temsil edildiği
- Benzerliğin süjet quruluşunden mənbəlandığı
- Benzerliğin yalnızca sömürgeci söylemle açıqlanabiləceği
Yakınlığın ortak İngilizce anlatım kalıplarından, benzer personaj adlarından, köy və gelenek sözcüklerinden və ya xülasəleme modelinin seçimlerinden mənbəlanması da mümkündür. Postkolonyal kavram, bulgunun kuramsal yorumudur; birbaşa ölçülen dəyişən değildir.
TF-IDF müqayisəsı necə strukturlmıştır?
Her bölgenin hekayələrinde diğer bölgelere göre daha ayırt edici sözcükleri bulmak üçün TF-IDF müqayisəsı uygulanmıştır.
Kullanılan temel ayarlar:
| Ayar | Değer |
|---|---|
| Sözlük büyüklüğü | 8.000 terim |
| N-gram | 1–2 |
| Minimum belge sıklığı | 3 |
| Durak sözcükler | İngilizce scikit-learn listesi |
| Karşılaştırma | Bölge ortası − diğer bütün bölgelerin ortası |
Her bölge üçün pozitif farkı en büyük 15 terim çıkarılmış; makalede ilk beşi sunulmuştur.
Bölgelere özgü sözcükler nelerdir?
| Bölge | En ayırt edici beş terim |
|---|---|
| Afrika | Amina, baobab, baobab tree, Amani, young Amina |
| Amerika qitələri | Mateo, island, Amara, Isabela, vibrant |
| Asiya | Layla, al, Mei, olivə, grovə |
| Avropa | forest, pines, Clara, whispering pines, enchanting |
| Okeaniya | ocean, island, Lani, Moana, sea |
| Polar | ice, team, Dr, Antarctica, climate |
Afrika’nın iki kişi adı və baobab şəbəkəacıyla; Asiya’nın Arapça, Doğu Asiya və Doğu Akdeniz çşəbəkərışımlarını aynı listede birleştiren adlar və zeytinliklerle temsil edilmesi, bölge içi çeşitliliğin az sayıda mədəni işarete indirgenebildiğini düşündürmektedir.
Avropa listesinde karakter adının yanında orman, çam və betimleyici sıfatlar bulunması, tədqiqatcı tarafından daha ayrıntılı bir anlatı kaydı olaraq yorumlanmıştır. Ancaq yalnızca ilk beş TF-IDF teriminden bir bölgenin temsilinin ümumi olaraq daha zengin olduğu kesin biçimde çıkarılamaz. Sözcük çeşitliliği, anlatı doğruluğu və ya mədəni derinlik üçün ayrı ölçütler gerekir.
“Moana” bulgusu niyə ayrıca incelenmiştir?
Moana, bazı Polinezya dillerinde deniz və ya okyanusla ilişkili bir sözcük olabiləceği gibi, Disney’in aynı adlı filmindeki karakteri de gösterebilir. Tədqiqatcı bu belirsizliği çözmek üçün Okeaniya xülasəlerinde Moana geçen bütün örnekleri elle incelemiştir.
Toplam 27 Okeaniya milliyyətine ait 170 hekayəde “Moana” bulunmuştur. Çoğu istifadəda sözcük:
- Büyük harfle yazılmış bir karakter adı
- Kahramana yol gösteren okyanus koruyucu ruhu
- Hekayənün birbaşa kahramanı
olaraq istifadə edilmişdir.
Amerikan Samoası və Tonga gibi bazı istemlerden üretilən xülasəlerde “Te Fiti’nin kalbi” öğesi de geçmiştir. Bu öğe Disney filminin özgül süjet quruluşune aittir. Tədqiqatcı, ticari filmin Okeaniya anlatılarında güclü bir təlim məlumatı işareti oluşturduğu sonucuna varmaktadır.
Bu bulgu incelenen 170 xülasə üçün birbaşa metinsel kanıt sunmaktadır. Yine de modelin bütün Okeaniya temsilinin tek başına Disney filminden mənbəlandığı söylerütubətez.
Bulgular anlatı struktursını mı, səth sözcüklerini mi ölçür?
Tədqiqatnın en əhəmiyyətli yorum sorularından biri budur. Tədqiqatcı nəticələri “regional anlatı şablonları” olaraq adlandırmaktadır. Ancaq kullanılan all-MiniLM gömmeleri aşşəbəkəıdaki unsurların tümünden etkilənebilir:
- Karakter adları
- Yer və bitki adları
- Manzara betimlemeleri
- Hekayənün temel konusu
- Olayların sırası
- Duygusal ton
- Özette hansı ayrıntıların seçildiği
TF-IDF sonucu, en görünür regional ayrımın büyük ölçüde adlar və simgesel çevre öğeleri olduğunu göstərir. Bu niyəle yüzde 74,7’lik merkez eşleşmesi, real süjet quruluşu fərqlilığından çok səth mədəni süslemesini ölçüyor ola bilər.
Anlatı struktursını daha birbaşa sınamak üçün şu analizler gerekebilirdi:
- Karakter və yer adları maskelendikten sonra gömme analizi
- Manzara və mədəni nesne sözcükleri çıkarıldıktan sonra tekrar merkez hesabı
- Olay sırası, çatışma, doruk və çözüm bölümlerinin ayrı kodlanması
- İnsan dəyərlendiricilərin struktur benzerliği puanları
- Hekayə olaylarını özne–eylem–nesne zincirleriyle temsil etme
- Tam hekayə ilə xülasə nəticələrinı müqayisə
Tədqiqatnın güclü yönleri nelerdir?
- 11.800 hekayəlük geniş və açıq bir vəri kaynşəbəkəından yararlanılmıştır.
- 235 milliyyət geniş bir coğrafi kapsama sşəbəkəlamaktadır.
- Özgün vəri üretimi ilə yeni analiz katkısı açıq biçimde ayrılmıştır.
- Coğrafi gruplar gömme vərisinden değil, dışarıdan tanımlanan UN M49 sınıflandırmasından alınmıştır.
- Analiz özgün 384 boyutlu uzayda strukturlmış, UMAP yalnızca görselleştirme üçün istifadə edilmişdir.
- KMeans’in başarısız sonucu gizlenmemiş və üsulsel bulgu olaraq raporlanmıştır.
- Karışıklık matrisi regional eşleşmeleri ayrıntılı biçimde göstərir.
- Ki-kare, Cramér’s V və nisbət testleri istifadə edilmişdir.
- Gömme analizi TF-IDF sözcük müqayisəsıyla desteklenmiştir.
- Moana bulgusu otomatik nəticə olaraq bırakılmamış, ilgili örnekler elle kontrol edilmiştir.
- Analiz kodu və temel vəri kümesi üçün açıq erişim adresleri vərilmiştir.
- Tədqiqatcı üsulunin bölge kategorilərini kendisinin de homojenleştirebiləceğini açıqça kabul etmiştir.
Tədqiqatnın temel məhdudiyyətləri nelerdir?
- Tədqiqat hakem qiymətləndirməsinden geçmemiş bir preprinttir.
- Yalnızca gpt-4o-mini tarafından üretilən hekayələr incelenmiştir.
- Tek bir İngilizce istem kalıbı istifadə edilmişdir.
- Model sürümü, üretim ayarları və dörütubət değiştiğinde nəticələr değişebilir.
- Analiz tam hekayələr yerine yine aynı LLM tarafından üretilmiş xülasəlere dayanmaktadır.
- Özetleme mərhələsı mədəni ayrıntıları seçmiş və ya büyütmüş ola bilər.
- Cümle gömme yakınlığı mədəni və ya anlatısal benzerliğin birbaşa ölçüsü değildir.
- Gömme üsulu insan qiymətləndirməsiyle geniş ölçekte doğrulanmamışdır.
- Regional merkezler və sınıflandırma aynı vəri üzerinde hesablanmışdır.
- Bşəbəkəımsız test, çapraz validasiya və ya leavə-one-out üsulu kullanılmamıştır.
- Tesadüfi və ya etikaetleri karıştırılmış bir müqayisə tabanı vərilməmişdir.
- Bölge örnek sayılarının dengesinin nəticələra etkisi incelenmemiştir.
- UN M49 coğrafi sınıfları mədəni geleneklerle birebir örtüşmemektedir.
- Afrika, Asiya və Amerika gibi gruplar kendi içlerinde aşırı geniştir.
- Ülke, alt bölge, dil ailəsi və ya tarihsel anlatı geleneği səviyyəinde analiz strukturlmamıştır.
- TF-IDF sözcüklerinin bir bölümü süjet quruluşu yerine yalnızca karakter adıdır.
- Kültürel adlar maskelendikten sonra nəticələrin sürüp sürmediği test edilmemiştir.
- KMeans’in aşşəbəkəı silhouette sonucu bütün mümkün kümeleme üsullarini dışlamaz.
- “Beş ayrı şablon” ifadesi, ayrık kümelerin bulunmamasıyla kavramsal gerilim taşımaktadır.
- Afrika–Asiya yakınlığının süjet quruluşu, sözcük seçimi və ya xülasə davranışından hansısine dayandığı ayrıştırılmamıştır.
- Postkolonyal kavramlarla kurulan bşəbəkəlantı yorumlayıcıdır və birbaşa ölçülen niyəsel mekanizma değildir.
- Nitel validasiya yalnız dokuz hekayəlük küçük bir örneğe dayanmaktadır.
- Bölge dışına atanan hekayələrin sistematik yaxın oxuması strukturlmamıştır.
- Nihai vəri sayısı ilə xi-kvadrat testinde vərilən örneklem arasında açıqlanmayan 48 qeydlık fark bulunmaktadır.
Tədqiqat neyi dəstəkləyir?
- İncelenen gpt-4o-mini xülasəlerinin coğrafi bölgelere göre tamamen rastgele dşəbəkəılmadığını dəstəkləyir.
- Hekayəlerin yaklaşık dörtte üçünün kendi regional mərkəzine daha yakın olduğunu göstərir.
- Avropa və Okeaniya hekayələrinin kendi merkezlerine daha sık eşleştiğini göstərir.
- Afrika və Asiya arasında diğer bölge çiftlerine göre daha yüksək çift yönlü gömme yakınlığı bulunduğunu göstərir.
- Regional fərqlilaşmanın əhəmiyyətli bölümünün kişi adları və simgesel manzara öğeleri üzerinden kurulduğunu dəstəkləyir.
- Okeaniya hekayələrinde Disney’in Moana anlatısına özgü öğelerin tekrarlandığını göstərir.
- KMeans altında ayrık və kompakt anlatı kümelerinin desteklenmediğini göstərir.
- Anlatı uzayının keskin kategorilərden çok sürekli regional çekimlerle açıqlanmasının daha uygun olabiləceğini dəstəkləyir.
Tədqiqat neyi sübut etmir?
- Bütün böyük dil modellərinin aynı regional kalıpları ürettiğini sübut etmir.
- Güncel və ya daha büyük model sürümlerinin aynı sonucu vəreceğini göstermemektedir.
- türkcə və ya başka dillerde aynı kalıpların oluşacşəbəkəını göstermemektedir.
- Modelin bilinçli biçimde mədəni ayrımcılık yaptığını sübut etmir.
- Afrika və Asiya’daki bütün ölkəlerin aynı biçimde temsil edildiğini göstermemektedir.
- Yüksek regional eşleşmenin mədəni doğruluk və ya mədəni zenginlik anlamına geldiğini sübut etmir.
- Avropa hekayələrinin real Avropa anlatı geleneklerini daha doğru yansıttığını göstermemektedir.
- Merkez eşleşmesinin süjet quruluşu struktursından mənbəlandığını kesin biçimde göstermemektedir.
- 50 kelimelik xülasəlerin tam hekayələrdəki bütün mədəni içeriği koruduğunu sübut etmir.
- Yüzde 74,7 nisbətının bşəbəkəımsız yeni vəride tekrarlanacşəbəkəını göstermemektedir.
- Postkolonyal kuramın gözlenen bütün sayısal desenlerin tek açıqlaması olduğunu sübut etmir.
Tədqiqatnın Yöntemi və Bulguları
Tədqiqat tasarımı
Tədqiqat, önceden yayımlanmış süni intellekt üretimi metin vəri kümesinin ikincil hesaplamalı analizidir. Yeni hekayə üretilmemiş; mevcut xülasəler gömme, kümeleme, merkez yakınlığı, sözcük müqayisəsı və istatistiksel testlerle yeniden dəyərlendirilmiştir.
Veri akışı
- 236 milliyyəte ait 11.800 hekayənün açıq məlumat dəsti alınmıştır.
- Gerçek milliyyət içermeyen XX kategorisi çıkarılmıştır.
- 235 milliyyəte ait 11.750 hekayə UN M49 bölgelerine atanmıştır.
- Her hekayənün 50 kelimelik xülasəi all-MiniLM-L6-v2 ilə gömülmüştür.
- 384 boyutlu vəktörler keşif amacıyla UMAP ilə iki boyuta indirgenmiştir.
- KMeans üçün K = 4–20 silhouette analizi strukturlmıştır.
- Her bölgenin normalize edilmiş orta gömme merkezi hesablanmışdır.
- Her hekayə en yakın regional mərkəze atanmıştır.
- İstem bölgesi ilə atanan merkez karşılaştırılarak qarışıqlıq matrisi oluşturulmuştur.
- Regional ilişki xi-kvadrat və Cramér’s V ilə dəyərlendirilmiştir.
- Afrika–Asiya nisbətları iki nisbətlı z testleriyle müqayisə edilmişdir.
- Bölgelere özgü sözcükler TF-IDF kontrastıyla çıkarılmıştır.
- Moana geçen Okeaniya xülasəleri elle incelenmiştir.
Temel vəri və model xüsusilikleri
| Öğe | Tədqiqatda vərilən dəyər |
|---|---|
| Özgün hekayə sayısı | 11.800 |
| Özgün milliyyət sayısı | 236 |
| Her milliyyət üçün hekayə | 50 |
| Nihai hekayə sayısı | 11.750 |
| Nihai milliyyət sayısı | 235 |
| Hekayə üreten model | gpt-4o-mini |
| Üretim tarihleri | 13–19 Ocak 2025 |
| Analiz metni | 50 kelimelik model üretimi xülasəler |
| Gömme modeli | all-MiniLM-L6-v2 |
| Gömme boyutu | 384 |
| KMeans aralığı | K = 4–20 |
| Silhouette alt örneklemi | 2.000 hekayə |
Ana nəticələrin xülasəi
| Ölçüt | Sonuç | Yorum sınırı |
|---|---|---|
| Genel regional mərkəz eşleşmesi | %74,7 | Aynı vəriyle oluşturulan merkezler üzerinde hesablanmışdır. |
| Avropa eşleşmesi | %83,6 | Kültürel doğruluğu birbaşa göstermez. |
| Okeaniya eşleşmesi | %81,5 | Moana gibi güclü medya işaretlerinden etkilənebilir. |
| Afrika eşleşmesi | %71,9 | 54 ölkə tek merkez altında birleştirilmiştir. |
| Asiya eşleşmesi | %70,4 | Çok fərqli alt bölgeler tek merkez altında birleştirilmiştir. |
| Amerika eşleşmesi | %69,8 | Kuzey, Orta və Güney Amerika aynı geniş gruptadır. |
| Afrika → Asiya | %12,8 | Gömme yakınlığıdır; birbaşa mədəni eşitleme ölçməü değildir. |
| Asiya → Afrika | %14,0 | En yüksək bölge dışı atamadır. |
| KMeans silhouette | 0,031–0,039 | Ayrık kümeleri desteklememektedir. |
| Ki-kare | χ²(16) = 22.278,4; p < 0,001 | Metindeki n = 11.652 dəyəri vəri toplamıyla uyuşmamaktadır. |
| Cramér’s V | 0,691 | İstem bölgesi ilə merkez ataması arasında güclü ilişki bildirilmişdir. |
İstatistiksel qiymətləndirmə
Ki-kare testi, istem bölgesi ilə merkez atamasının bşəbəkəımsız olmadığı sonucunu dəstəkləyir. Büyük örneklem niyəiyle p dəyərinin çok küçük olması beklenebilir; bu yüzden ilişki büyüklüğünü gösteren Cramér’s V dəyəri ayrıca əhəmiyyətlidir.
Afrika–Asiya atamalarının bir sonraki en büyük bölge dışı nisbət olan Okeaniya–Amerika nisbətından anlamlı biçimde yüksək olduğu iki nisbətlı z testleriyle raporlanmıştır.
Buna karşılık şu qeyri-müəyyənlikler nicel olaraq dəyərlendirilmemiştir:
- Merkez vəktörlerinin nümunələmə belirsizliği
- Farklı gömme modellerinde eşleşme nisbətının değişimi
- Hekayə üretimindeki rastgelelik
- Milliyetler arası dengesiz mədəni təmsil
- Özetleme mərhələsının etkisi
- İnsan dəyərlendiricilər arası uyum
- Bşəbəkəımsız test kümesindeki performans
Tekrarlanabilirlik üçün sunulan mənbəlar
- Analiz kodunun GitHub üzerinde açıq olduğu qeyd edilmişdir.
- Özgün hekayə vəri kümesinin Datavərse.no üzerinde açıq olduğu qeyd edilmişdir.
- Gömme modeli və temel UMAP ayarları açıqlanmıştır.
- TF-IDF sözlük və n-gram ayarları vərilmiştir.
Bununla belə ana metinde bölge başına hekayə sayıları, merkez vəktörleri və ya xi-kvadrat testindeki 11.652 örneğe necə ulaşıldığını gösteren vəri temizləmə günlüğü yoxdur.
Gelecek tədqiqatlar üçün gerekli adımlar
- Tam hekayələr ilə model üretimi xülasəlerin karşılaştırılması
- Karakter və yer adları maskelenerek analizin tekrarlanması
- Bşəbəkəımsız test və milliyyət bazlı çapraz validasiya
- Farklı cümle gömme modellerinin karşılaştırılması
- Birden fazla LLM və model vərsiyasınün sınanması
- İngilizce dışındaki istem və hekayə dillerinin dəyərlendirilmesi
- Ülke və alt bölge səviyyəinde daha ayrıntılı analiz
- Hekayə süjet quruluşunün insan və ya strukturlandırılmış anlatı kodlamasıyla ölçülmesi
- Bölge dışına atanan hekayələrin sistematik yaxın oxuması
- Kültür uzmanlarının qiymətləndirməleriyle validasiya
- Farklı istem biçimlerinin stereotipləşdirməyi azaltıp azaltmadığının sınanması
- Yaratıcı müəllifləra sunulan süni intellekt önerilərinin insan üretimine etkisinin incelenmesi
Kaynak və Yöntem Notu
Tədqiqatnın özgün adı: How AI Stereotypes the World: Regional Narrativə Templates in LLM-Generated Stories
Yazar: Paarth Singh Rathore.
Yazar sıralaması: Tədqiqat tek müəlliflıdır.
Eş katkı bilgisi: Tek müəlliflı olduğu üçün eş katkı beyanı yoxdur.
Sorumlu müəllif: Belgede ayrıca “corresponding author” işareti yoxdur. Tek müəllifa ait ilətişim e-postası vərilmiştir.
E-posta: paarthsinghrathore1@gmail.com
Kurum: Department of Computer Science and Information Systems, BITS Pilani, Pilani, Rajasthan, India.
Resmî nəşr platforması: SSRN.
Resmî tədqiqat bşəbəkəlantısı:SSRN tədqiqat sayfası
SSRN yükləmə tarihi: 31 Temmuz 2026.
Sayfa sayısı: 9.
Yayın yılı: 2026.
Dergi və ya konferans: Bu sürümde hakemli bir dergi, kabul edilmiş konferans və ya yayımlanmış bildiri bilgisi yer almır.
Yayınevi və platform durumu: Tədqiqat SSRN preprint platformunda yer almaktadır. Hakemli bir dergi yayınevi doğrulanmamışdır.
Kaynak türü: Açık bir süni intellekt hekayə vəri kümesinin cümle gömmeleri, regional mərkəzler, kümeleme, TF-IDF və istatistiksel testlerle yeniden analiz edildiği hesaplamalı sosyal bilim və doğal dil işləmə preprinti.
Hakemlik durumu: Tədqiqat resenziyadan keçməmişdir. Sonuçlar bu məhdudiyyət dikkate alınarak okunmalıdır.
Özgün vərinin sahibi: Tədqiqatda kullanılan 11.800 hekayəlük vəri kümesi Rettberg və Wigers’ın önceki tədqiqatsından alınmıştır. Paarth Singh Rathore hekayələri üretmemiş, mevcut vəriye yeni bir regional analiz uygulamıştır.
Özgün vəri bşəbəkəlantısı:Datavərse.no vəri kaydı
Analiz kodu:GitHub kod deposu
Finansman: Ana metinde maliyyələşdirmə beyanı yer almır.
Çıkar çatışması: Ana metinde maraqlar toqquşması beyanı yer almır.
Yazar katkıları: Tek müəlliflı tədqiqat üçün ayrı bir CRediT katkı bildirimi təqdim edilməmişdir.
Etik kurul: Tədqiqat açıq süni intellekt üretimi metin vərisine dayanmaktadır. İnsan katılımcı və ya xüsusi kişisəl vəri istifadəı bildirilmemiş, ayrıca etika komitə bilgisi vərilməmişdir.
Temel sayısal tutarsızlık: Metin, nihai vəri kümesinin 11.750 hekayə içerdiğini və Polar kategoride 50 hekayə bulunduğunu belirtmektedir. Buna göre Polar dışındaki beş bölgenin 11.700 hekayə içermesi beklenirken xi-kvadrat testi üçün n = 11.652 vərilmiştir. Aradaki 48 kaydın durumu açıqlanmamışdır.
Bu türkcə açıqlama; yüklenen tədqiqatın vəri tanımı, literatür çerçevəsi, 384 boyutlu cümle gömme üsulu, UMAP ayarları, KMeans silhouette cədvəlsu, regional mərkəz denklemleri, qarışıqlıq matrisi, xi-kvadrat və z testleri, TF-IDF sözcükleri, Moana örneklerinin manuel yoxlamasi, tartışması və məhdudiyyətləri dəyərlendirilərek hazırlanmıştır. Tədqiqatda bulunmayan model təcrübəleri və ya ölkəye özgü nəticələr eklenmemiştir.
Tədqiqat, incelenen gpt-4o-mini hekayələrinin bütün milliyyətləri tamamen aynı biçimde anlatmadığını; ortak süjet quruluşu üzerinde geniş bölgelere göre fərqli adlar və simgesel çevre öğeleri kullandığını dəstəkləyir. Bununla belə nəticələr yalnızca tek modelin İngilizce istemlerle oluşturduğu və yine aynı modelin xülasəlediği metinlere dayanmaktadır. “Regional anlatı şablonu” iddiası; bşəbəkəımsız vəri, tam metin analizi, insan qiymətləndirməsi və mədəni səth sözcüklerini kontrol eden təcrübəlerle doğrulanmadan ümumi bir LLM xüsusiliği olaraq kabul edilmemelidir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib