

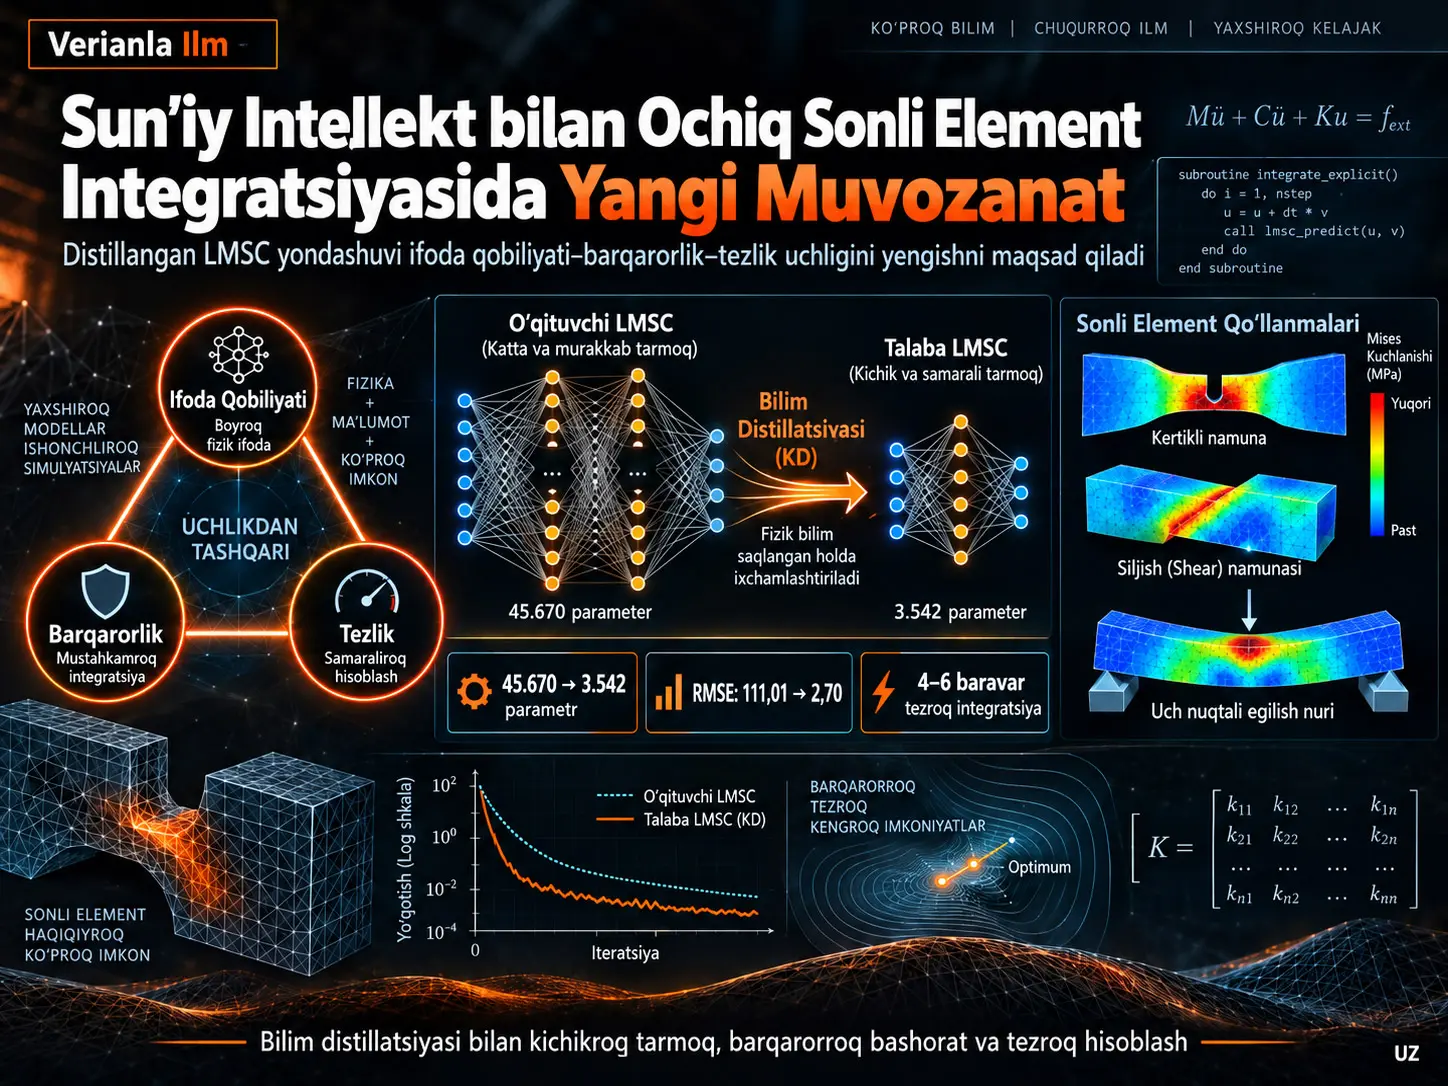
Metall shakllantirish kabi yirik miqyosli ochiq sonli element tahlillarida konstitutiv material modeli har bir vaqt qadamida va juda ko‘p integratsiya nuqtalarida qayta-qayta ishga tushiriladi. Klassik von Mises izotropik qattiqlashish modeli fizik jihatdan ishonchli bo‘lsa-da, bunday uzluksiz baholash sezilarli hisoblash xarajatini keltirib chiqaradi. Neyron tarmoq asosidagi surrogat modellar bu xarajatni kamaytirish salohiyatiga ega; biroq kichik va tez tarmoqlar ochiq integratsiya jarayonida ketma-ket bashorat xatolarining kattalashishi sababli sonli beqarorlik ko‘rsatishi mumkin.
Ushbu tadqiqot mazkur ziddiyatni “Ifoda Qobiliyati–Barqarorlik–Tezlik Uchligi” deb ta’riflaydi va yechim sifatida Linearized Minimal State Cells (LMSC), native Fortran asosidagi Abaqus VUMAT integratsiyasi hamda Knowledge Distillation (KD) usulini birlashtiradi. Katta va yuqori aniqlikdagi LMSC o‘qituvchi modelida 45.670 parametr mavjud bo‘lgan bo‘lsa, ultra-yengil talaba tarmoq 3.542 parametrgacha qisqartirilgan; shu tariqa taxminan 12,89 karra parametr siqilishiga erishilgan.
Biroq tadqiqotning eng muhim natijasi faqat modelni kichraytirish emas. Distillanmagan ixcham tarmoqlar oflayn ma’lumotlar to‘plamida past xato ko‘rsatishi mumkin bo‘lsa-da, ochiq sonli element integratsiyasida kuchlanish xatolarini qadam-baqadam to‘plab, beqarorlashishi mumkin. Masalan, u=6, w=50 konfiguratsiyasining onlayn RMSE qiymati 111,01 gacha ko‘tarilgan bo‘lsa, bilim distillatsiyasidan so‘ng ayni arxitektura uchun RMSE 2,70 gacha tushgan va katastrofik og‘ish bartaraf etilgan.
O‘yiqli cho‘zish, siljish va uch nuqtali egish tahlillarida distillangan talaba modellar etalon Abaqus von Mises yechimiga yaqin kuchlanish maydonlari hamda yuk–siljish egri chiziqlarini hosil qilgan. Native Fortran, BLAS/VML, batch processing va xotira joylashuvini optimallashtirish hisobiga yuqori iteratsiyali tahlillarda eng kichik tarmoq Abaqus’ning ichki modeli bilan o‘xshash, hatto ayrim CPU konfiguratsiyalarida %24 gacha qisqaroq hisoblash vaqtini ta’minlagani xabar qilingan.
Nega neyron tarmoqdan foydalanish avtomatik ravishda tezroq sonli element tahlilini anglatmaydi?
Konstitutiv modelni neyron tarmoq bilan almashtirish nazariy jihatdan matematik integratsiya xarajatini kamaytirishi mumkin; ammo real sonli element dasturida faqat tarmoqning matematik amallar soni muhim emas. Tarmoq og‘irliklarini diskdan o‘qish, Python bilan Fortran o‘rtasida ma’lumot uzatish, tashqi mashinaviy o‘rganish kutubxonalariga murojaatlar va kichik matritsa amallarining samarasiz bajarilishi tarmoqning nazariy ustunligini butunlay yo‘qqa chiqarishi mumkin.
Manbada oldingi LMSC integratsiya yondashuvi ayrim sinovlarda Abaqus’ning ichki fizik modelidan 4–6 baravar sekinroq ishlashi mumkinligi qayd etilgan. Shu sababli mualliflar tezlik muammosini faqat “kichikroq tarmoq” tarzida emas, balki dasturiy arxitektura muammosi sifatida ham ko‘rib chiqadilar.
Ifoda Qobiliyati–Barqarorlik–Tezlik Uchligi Nima?
Tadqiqot ta’rifiga ko‘ra, muvaffaqiyatli konstitutiv surrogat model bir vaqtning o‘zida uchta shartni bajarishi kerak: murakkab kuchlanish–deformatsiya tarixini yetarli aniqlikda ifodalashi, yopiq siklli ochiq integratsiyada kichik sonli xatolarni kattalashtirmasdan barqaror qolishi va fizik konstitutiv model o‘rnini egallashni mazmunli qiladigan darajada tez ishlashi lozim. Katta tarmoqlar ifoda qobiliyati va barqarorlikni ta’minlaydi, ammo sekin; haddan tashqari kichraytirilgan tarmoqlar tez, biroq ifoda sig‘imini yoki onlayn barqarorlikni yo‘qotishi mumkin.
Nega oflayn aniqlik chalg‘itishi mumkin?
Oflayn sinovda tarmoq har bir bashorat qadamida to‘g‘ri fizik tarix ma’lumoti bilan oziqlantiriladi. Ochiq sonli element integratsiyasida esa bir vaqt qadamida tarmoq hosil qilgan ichki holat keyingi qadamga uzatiladi.
Shu sababli kichik xato:
- ichki holat o‘zgaruvchisiga kiradi,
- keyingi bashoratni biroz o‘zgartiradi,
- o‘zgargan bashorat keyingi holatning kirishi bo‘ladi,
- xato qayta oziqlanib kattalashishi mumkin.
Manba buni autoregressive error accumulation deb ta’riflaydi.
Masalan, LMSC_u6_w25 modeli oflayn test loss bo‘yicha ancha yaxshi ko‘rinadi:
Losstest = 9,9 × 10⁻⁵
Biroq Abaqus VUMAT ichidagi onlayn RMSE:
RMSE = 5,10
bo‘ladi.
LMSC_u6_w50 uchun farq ancha kattaroq:
Losstest = 6,17 × 10⁻³
Online RMSE = 111,01
Bu natijalar faqat oflayn MSE yoki validation loss qiymatiga qarab ochiq integratsiya barqarorligini baholab bo‘lmasligini ko‘rsatadi.
Bilim Distillatsiyasi Kichik LMSC Tarmog‘ini Qanday Barqaror Qiladi?
Tadqiqotda bilim distillatsiyasi faqat katta model chiqishini kichik modelga o‘rgatish usuli sifatida qo‘llanmaydi. Talaba tarmoq ham Abaqus’dan olingan haqiqiy kuchlanish qiymatlarini, ham yuqori sig‘imli o‘qituvchi tarmoqning silliqroq va uzluksiz kuchlanish trayektoriyalarini o‘rganadi. Mualliflar ushbu yumshoq nishonlar kichik tarmoqning ichki tasvirlash fazosini silliqroq qilib, ketma-ket xato o‘sishiga qarshi o‘ziga xos topologik tartibga solish hosil qilishini ilgari suradilar.
O‘qituvchi model
Tanlangan o‘qituvchi:
- Holat o‘lchami: u = 10
- Yashirin qatlam kengligi: w = 100
- Chiziqli bo‘lmagan qatlamlar soni: d = 3
- Parametr: 45.670
- Offline test loss: 9,16 × 10⁻⁵
- Online RMSE: 1,79
Bu tarmoq yuqori ifoda qobiliyati va barqarorlikka ega; biroq komponent miqyosida forward pass xarajati yuqori.
Ultra-yengil talaba
LMSC_u6_w25:
- u = 6
- w = 25
- 3.542 parametr
- O‘qituvchiga nisbatan taxminan 12,89× kichikroq
KD’dan so‘ng optimal distillatsiya og‘irligi taxminan α = 0,6 deb xabar qilingan.
w=50 talaba
LMSC_u6_w50 distillatsiyasiz holatda kuchli onlayn og‘ish ko‘rsatgan. Tadqiqotda optimal KD og‘irligi taxminan α = 0,9 sifatida tanlangan.
| Model | Test loss | Online RMSE |
|---|---|---|
| LMSC_u10_w100 o‘qituvchi | 9,16×10⁻⁵ | 1,79 |
| LMSC_u6_w25 | 9,90×10⁻⁵ | 5,10 |
| LMSC-KD_u6_w25_α0.6 | 1,04×10⁻⁴ | 3,94 |
| LMSC_u6_w50 | 6,17×10⁻³ | 111,01 |
| LMSC-KD_u6_w50_α0.9 | 2,8×10⁻⁵ | 2,70 |
Bilim distillatsiyasi yo‘qotishi
Talaba o‘qitishidagi yo‘qotish haqiqiy Abaqus yorliqlari bilan o‘qituvchi tarmoqning yumshoq nishonlarini birgalikda o‘z ichiga oladi:
\[ L_{\mathrm{student}} = \alpha \frac{1}{N} \sum \left\| \hat{y}_{student}-y_{true} \right\|^2 + (1-\alpha) \frac{1}{N} \sum \left\| \hat{y}_{student}-\hat{y}_{teacher} \right\|^2 \]
Birinchi had haqiqiy fizik yorliqlarga moslikni, ikkinchi had esa o‘qituvchining silliqroq konstitutiv trayektoriyasiga moslikni ifodalaydi.
Loss landscape nimani ko‘rsatadi?
Manbadagi 15-rasm va PDF’ning 56-betidagi grafiklar model og‘irliklarining kichik perturbatsiyalari ostidagi loss sirtini ko‘rsatadi.
O‘qituvchi tarmoqda minimum atrofidagi sirt keng va nisbatan simmetrik. Distillanmagan ixcham modellarda esa keskinroq, torroq va assimetrik hududlar ko‘rinadi. KD’dan keyin talaba tarmoqlarning minimum atrofidagi sirt yana tartibliroq holga keladi.
Mualliflar bu keng va silliq minimum tuzilmasini uzluksiz integratsiya vaqtida yuzaga keladigan kichik ichki-holat perturbatsiyalariga nisbatan yuqoriroq chidamlilik bilan bog‘laydilar.
Neyron faollashuvlari nimani ko‘rsatadi?
Manbaning 57-betidagi violin grafiklar tanh faollashuvlarining taqsimotini taqqoslaydi.
O‘qituvchi model taxminan:
−0,709 dan +0,573 gacha
oraliqda ishlaydi.
Distillanmagan u6_w50 tarmog‘i esa minimumda taxminan:
−0,867
qiymatiga yaqinlashadi. Tanh hosilasi:
\[ \frac{d}{dx}\tanh(x)=1-y^2 \]
bo‘lganligi sababli, mualliflar hisobiga ko‘ra ushbu hududda qolgan lokal gradient taxminan %24,8 gacha tushadi.
KD’dan keyin minimal faollashuv taxminan −0,521 ga tortiladi va eng zaif nuqtadagi gradient oqimi taxminan %72,8 gacha ko‘tariladi.
Bunga qarshi ravishda u6_w25 tarmog‘ining muammosi to‘yinganlik emas, faollashuvlarning taxminan −0,298 dan +0,289 gacha bo‘lgan oralig‘ida haddan tashqari siqilishidir. Manba buni “topological stiffness” deb ataydi. KD’dan keyin faollashuv oralig‘i kengayadi va tarmoqning chiziqli bo‘lmagan tasvirlash qobiliyati oshadi.
Native Fortran Integratsiyasi Nega Shunchalik Muhim?
Mashinaviy o‘rganish modelining tez bo‘lishi, agar uni sonli element dasturiga bog‘laydigan qatlam sekin bo‘lsa, yetarli emas. Shu sababli tadqiqotda LMSC forward pass’ining barchasi VUMAT ichida native Fortran yordamida qayta amalga oshirilgan.
Tashqi ML ishga tushirish muhiti yo‘q
Ish jarayonida PyTorch yoki TensorFlow chaqirilmaydi. Tarmoq og‘irliklari simulyatsiya boshida faqat bir marta o‘qiladi va keyin RAM’dagi read-only Fortran MODULE tuzilmasida saqlanadi.
BLAS va VML
Zich matritsa amallari BLAS, tanh va exp kabi funksiyalar esa Intel MKL Vector Mathematical Library yordamida vektorlashtirilgan.
Xotira joylashuvi
Og‘irlik matritsalari Fortran’ning column-major xotira tuzilmasiga mos ravishda oldindan transpozitsiya qilinadi. Maqsad stride-1 kirishini ta’minlab, CPU cache’dan foydalanish va SIMD unumdorligini oshirishdir.
Batch processing
Integratsiya nuqtalari bittadan ishlov berish o‘rniga paketlanadi. Manba misol sifatida:
BATCH_SIZE = 128
qiymatini keltiradi.
Shu tariqa kichik yakka tarmoq chaqiruvlari o‘rniga zich va vektorlashtirish mumkin bo‘lgan matritsa amallari bajariladi.
Tadqiqot Usuli va Natijalari
O‘qitish ma’lumotlarini yaratish
Ma’lumot yaratishda 8 tugunli reduced-integration C3D8R bitta elementdan foydalanilgan.
Training set:
- 10.000 mustaqil deformatsiya yo‘li
Validation set:
- 1.000 mustaqil deformatsiya yo‘li
Har bir yo‘l 125 piecewise-linear segmentdan tuzilgan. Har bir segment 16 mikro qadamga bo‘linib:
125 × 16 = 2.000 mikro deformatsiya orttirmasi
hosil qilingan.
Tasodifiy yo‘llar elastik-plastik chegaraning, qayta yuklashning va yo‘nalish o‘zgarishlarining tez-tez uchrashini ta’minlaydigan tarzda tuzilgan.
Etalon material modeli
Etalon model klassik von Mises oqish sharti bilan Swift izotropik qattiqlashishini birlashtiradi.
Von Mises ekvivalent kuchlanishi:
\[ \bar{\sigma} = \sqrt{\frac{3}{2}\mathbf{s}:\mathbf{s}} \]
Oqish sharti:
\[ f= \bar{\sigma} - \sigma_y(\bar{\varepsilon}^{p}) \leq 0 \]
Swift qattiqlashishi:
\[ \sigma_y = K \left( \varepsilon_0+\bar{\varepsilon}^{p} \right)^n \]
| E | ν | K | ε₀ | n |
|---|---|---|---|---|
| 70.000 MPa | 0,32 | 650 MPa | 0,0001 | 0,07 |
LMSC’ning asosiy xususiyati
LMSC deformatsiya orttirmasining kattaligi bilan yo‘nalishini bir-biridan ajratadi. Shu tariqa o‘zgaruvchan FE vaqt/qadam kattaligining RNN ichki holatiga sun’iy bog‘liqlik hosil qilishi kamaytirilishga harakat qilinadi.
Ichki holat yangilanishi manbada analitik shaklda bajariladi va Forward Euler kabi diskret sonli integratsiya o‘rniga yopiq-form yangilanishidan foydalanish LMSC’ning self-consistency xususiyatining asosidir.
Bitta elementli siklik sinov
Teacher model etalon kuchlanish–deformatsiya sikllarini deyarli ustma-ust tushadigan darajada kuzatgan.
u6_w25 tarmog‘ida distillatsiyadan oldin, ayniqsa elastik-plastik burchaklarda kichik og‘ishlar kuzatiladi.
u6_w50 tarmog‘ida esa uzluksiz sikl ostida amplituda siljishi tobora ortib, makroskopik og‘ishga aylanadi.
KD’dan keyin har ikki tarmoqning kuchlanish sikllari etalon egri chiziqqa yana yaqinlashgan. PDF’ning 42–44-betlaridagi grafiklar bu farqni yaqqol ko‘rsatadi.
O‘yiqli cho‘zish
| Model | Maksimal Mises | Etalondan farq |
|---|---|---|
| Abaqus etalon | 557,2 MPa | — |
| Teacher | 560,5 MPa | +3,3 MPa |
| u6_w25 | 565,7 MPa | +8,5 MPa |
| KD u6_w25 | 558,0 MPa | +0,8 MPa |
| u6_w50 | 644,3 MPa | +87,1 MPa |
| KD u6_w50 | 556,7 MPa | −0,5 MPa |
Siljish sinovi
| Model | Maksimal Mises |
|---|---|
| Etalon | 609,5 MPa |
| Teacher | 607,2 MPa |
| u6_w25 | 611,3 MPa |
| KD u6_w25 | 607,9 MPa |
| u6_w50 | 646,5 MPa |
| KD u6_w50 | 608,5 MPa |
Uch nuqtali egish
| Model | Maksimal Mises |
|---|---|
| Etalon | 598,8 MPa |
| Teacher | 597,3 MPa |
| u6_w25 | 595,4 MPa |
| u6_w50 | 648,0 MPa |
| KD u6_w50 | 597,6 MPa |
Manbaning 45–47-betlaridagi Mises konturlari faqat maksimal qiymatni emas, KD’dan keyin yuqori-kuchlanish polosalarining fazoviy chegaralari ham etalon yechimga yaqinlashganini ko‘rsatadi.
Yuk–siljish xatti-harakati
Etalon modellarning taxminiy pik yuklari:
- O‘yiqli cho‘zish: 2,67 kN.
- Siljish: 1,00 kN.
- Uch nuqtali egish: 30,72 kN.
Distillanmagan u6_w50 tarmog‘i taxminan:
- 3,37 kN,
- 1,09 kN,
- 37,17 kN
piklariga chiqib, uchala sinovda ham ortiqcha bashorat ko‘rsatadi.
KD’dan keyin talaba modellarning yuk–siljish egri chiziqlari etalon va o‘qituvchi egri chiziqlari bilan katta darajada ustma-ust tushadi. Bu xatti-harakat PDF’ning 48–50-betlaridagi uchta grafikda ko‘rinadi.
Hisoblash vaqti
O‘yiqli cho‘zish tahlilida taxminan 1.000.000 iteratsiya uchun optimallashtirilgan u6_w25 modelining manbada berilgan vaqtlari:
| CPU | Abaqus Ref | Optimize LMSC |
|---|---|---|
| 1 | 7.909 s | 6.528 s |
| 2 | 7.485 s | 5.689 s |
| 4 | 5.717 s | 5.488 s |
| 8 | 5.710 s | 5.421 s |
| 16 | 5.674 s | 5.379 s |
Ushbu yuqori-iteratsiyali ssenariyda LMSC barcha CPU konfiguratsiyalarida etalondan tezroq.
Taxminan 100.000 iteratsiyada esa boshlang‘ich va VUMAT chaqiruv xarajatlari kattaroq ulushni tashkil qilgani sababli ustunlik yo‘qolishi mumkin.
Tarmoq kattaligining vaqt xarajati
16 CPU va taxminan 1.000.000 iteratsiyali uch nuqtali egish sinovida manba taxminan:
- Ref: 3.347 s
- u6_w25-opt: 6.796 s
- u10_w100-opt: 15.417 s
deb xabar beradi.
Bu misol muhim bir chegarani ko‘rsatadi: kattaroq va aniqroq tarmoqning konstitutiv aniqligi yuqori bo‘lishi mumkin, biroq haqiqiy FE simulyatsiyasi nuqtai nazaridan katta tezlik jarimasini keltirib chiqarishi mumkin.
Amdahl qonuni va kamayib boruvchi samara
O‘yiqli cho‘zishda 16 CPU’da:
- Teacher: 5.971 s
- Ultra-yengil student: 5.379 s
bo‘lishiga qaramay, tarmoq parametrlari 12,89 baravar farq qiladi.
Buning sababi umumiy FE vaqti faqat konstitutiv modeldan iborat emasligidir. Parallel aloqa, kontakt, kinematik yangilanish va history-variable amallari model kichraygani sari umumiy vaqtda ko‘proq ustunlik qila boshlaydi.
Tadqiqot bevosita qo‘llab-quvvatlaydigan xulosalar
- Native Fortran integratsiyasi oldingi LMSC embedding usullariga nisbatan katta I/O va cross-language xarajatlarini bartaraf etgan.
- Bilim distillatsiyasi kichik LMSC tarmoqlarining onlayn ochiq-FE barqarorligini sezilarli darajada oshirgan.
- Oflayn past loss qiymati onlayn barqarorlikning yetarli ko‘rsatkichi emas.
- KD’dan so‘ng u6_w50 tarmog‘ining onlayn RMSE qiymati 111,01 dan 2,70 gacha tushgan.
- 3.542 parametrli talaba 45.670 parametrli o‘qituvchiga nisbatan taxminan 12,89× kichikroq.
- KD’li modellar cho‘zish, siljish va uch nuqtali egish kuchlanish maydonlarida etalonga yaqin natija bergan.
- Yuqori iteratsiyali ayrim ssenariylarda optimallashtirilgan ultra-yengil model Abaqus’ning ichki Mises modelidan qisqaroq wall-clock vaqtini ta’minlagan.
- Loss landscape va faollashuv taqsimotlari KD’dan keyin ichki tasvirlash geometriyasi o‘zgarganini ko‘rsatadi.
Tadqiqot bevosita qo‘llab-quvvatlamaydigan xulosalar
- Har bir neyron tarmoq konstitutiv modeli bilim distillatsiyasi bilan barqarorlashishi isbotlanmagan.
- KD barcha ochiq sonli element tahlillari uchun matematik barqarorlik kafolatini bermaydi.
- Parametrlar sonining 12,89 baravar kamayishi FE yechimining 12,89 baravar tezlashishini anglatmaydi.
- LMSC barcha iteratsiya sonlarida va barcha komponentlarda Abaqus’ning ichki modelidan tez emas.
- Tadqiqot haqiqiy fizik cho‘zish/siljish/egish tajribalarini tekshiruv ground truth’i sifatida ishlatmaydi; asosiy etalon Abaqus’ning klassik Mises modelidir.
- Anizotropik plastik xatti-harakat, tezlikka bog‘liqlik, shikastlanish yoki sinish ushbu tadqiqotda tekshirilmagan.
- “Topologik tartibga soluvchi” mexanizmi loss-landscape va faollashuv tahlillari bilan qo‘llab-quvvatlangan muallif talqinidir; umumiy matematik teorema emas.
Manba va Usul Haqida Izoh
Asl sarlavha:Breaking the Expressivity-Stability-Speed Trilemma in Explicit FE Integration via Distilled Linearized Minimal State Cells
Mualliflar: Xudong Yang; Yanfeng Yang; Heng Li.
Muassasalar: State Key Laboratory of Solidification Processing, School of Materials Science and Engineering, Northwestern Polytechnical University; Research & Development Institute of Northwestern Polytechnical University in Shenzhen.
Manba turi: Hisoblash mexanikasi / mashinaviy o‘rganish bilan qo‘llab-quvvatlangan konstitutiv modellashtirish preprinti.
Platforma: SSRN.
SSRN ro‘yxat raqami: 7381099.
Taqriz holati: Yuklangan ish har bir sahifada peer review’dan o‘tmaganini qayd etadi.
Etalon konstitutiv model: von Mises (J2) oqish mezoni + Swift izotropik qattiqlashishi.
Etalon sonli element dasturi: Abaqus/Standard ma’lumot yaratish va Abaqus/Explicit VUMAT integratsiyasi.
Asosiy neyron tarmoq: Linearized Minimal State Cells (LMSC).
Asosiy siqish/tartibga solish usuli: Knowledge Distillation.
O‘qituvchi: u=10, d=3, w=100; 45.670 parametr.
Ultra-yengil talaba: u=6, w=25; 3.542 parametr; taxminan 12,89× parametr siqilishi.
Ma’lumotlar to‘plami: 10.000 training va 1.000 validation deformatsiya yo‘li; har bir yo‘l uchun 125 segment va 2.000 mikro orttirma.
Strukturaviy tekshiruvlar: O‘yiqli cho‘zish, lokal siljish va uch nuqtali egish.
Dasturiy ta’minot optimallashtirishlari: Library-free native Fortran, bir martalik parametr yuklash, global read-only weights, BLAS, Intel MKL VML, xotira transpozitsiyasi, stride-1 kirish, batch processing va SIMD.
Ma’lumotlardan foydalanish: Mualliflar ushbu tadqiqotda hisoblangan yoki tahlil qilingan barcha ma’lumotlar maqola ichida mavjudligini bildiradilar.
Moliyalashtirish: National Natural Science Foundation of China hamda turli Shenzhen, Shaanxi va markaziy universitet tadqiqot dasturlari tomonidan qo‘llab-quvvatlangan.
Manfaatlar to‘qnashuvi: Mualliflar raqobat qiluvchi manfaatlar yo‘qligini bildiradilar.
AI’dan foydalanish bayonoti: Mualliflar Gemini 3 Pro’dan grammatika va til oqimini yaxshilash maqsadida foydalanganliklarini; texnik mazmunni o‘zlari tekshirib tahrir qilganliklarini va natijalar uchun javobgarlikni o‘z zimmalariga olishlarini bildiradilar.
Asosiy ilmiy chegara: Tadqiqot fizik ground truth sifatida eksperimental metall namunalaridan o‘lchangan kuchlanish tarixini emas, Abaqus ichidagi von Mises–Swift modelini ishlatadi. Shu sababli ko‘rsatilgan muvaffaqiyat asosan klassik sonli konstitutiv modelni past xarajatli surrogat model bilan qayta hosil qilishdir.
Umumlashtirish chegarasi: Anizotropik oqish, viskoplastiklik va continuum damage mechanics faqat kelajakdagi tadqiqot yo‘nalishlari sifatida tilga olinadi.
Barqarorlik chegarasi: Tadqiqotning “catastrophic autoregressive divergence eliminated” natijasi ko‘rib chiqilgan modellar va yuk yo‘llari uchun eksperimental hisoblash natijasidir; barcha ochiq FE muammolari uchun formal barqarorlik kafolati emas.
Tezlik chegarasi: Tezlik ustunligi iteratsiya soni, tarmoq o‘lchami, CPU soni va muammo turiga bog‘liq. Past iteratsiyali tahlillarda native Abaqus modeli tezroq bo‘lishi mumkin.
Amdahl chegarasi: Tarmoq kichraygani sari konstitutiv inference umumiy hisoblash vaqtining kichikroq qismini tashkil etadi; shu sababli parametr siqilishining wall-clock yutug‘i chiziqli emas.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan