

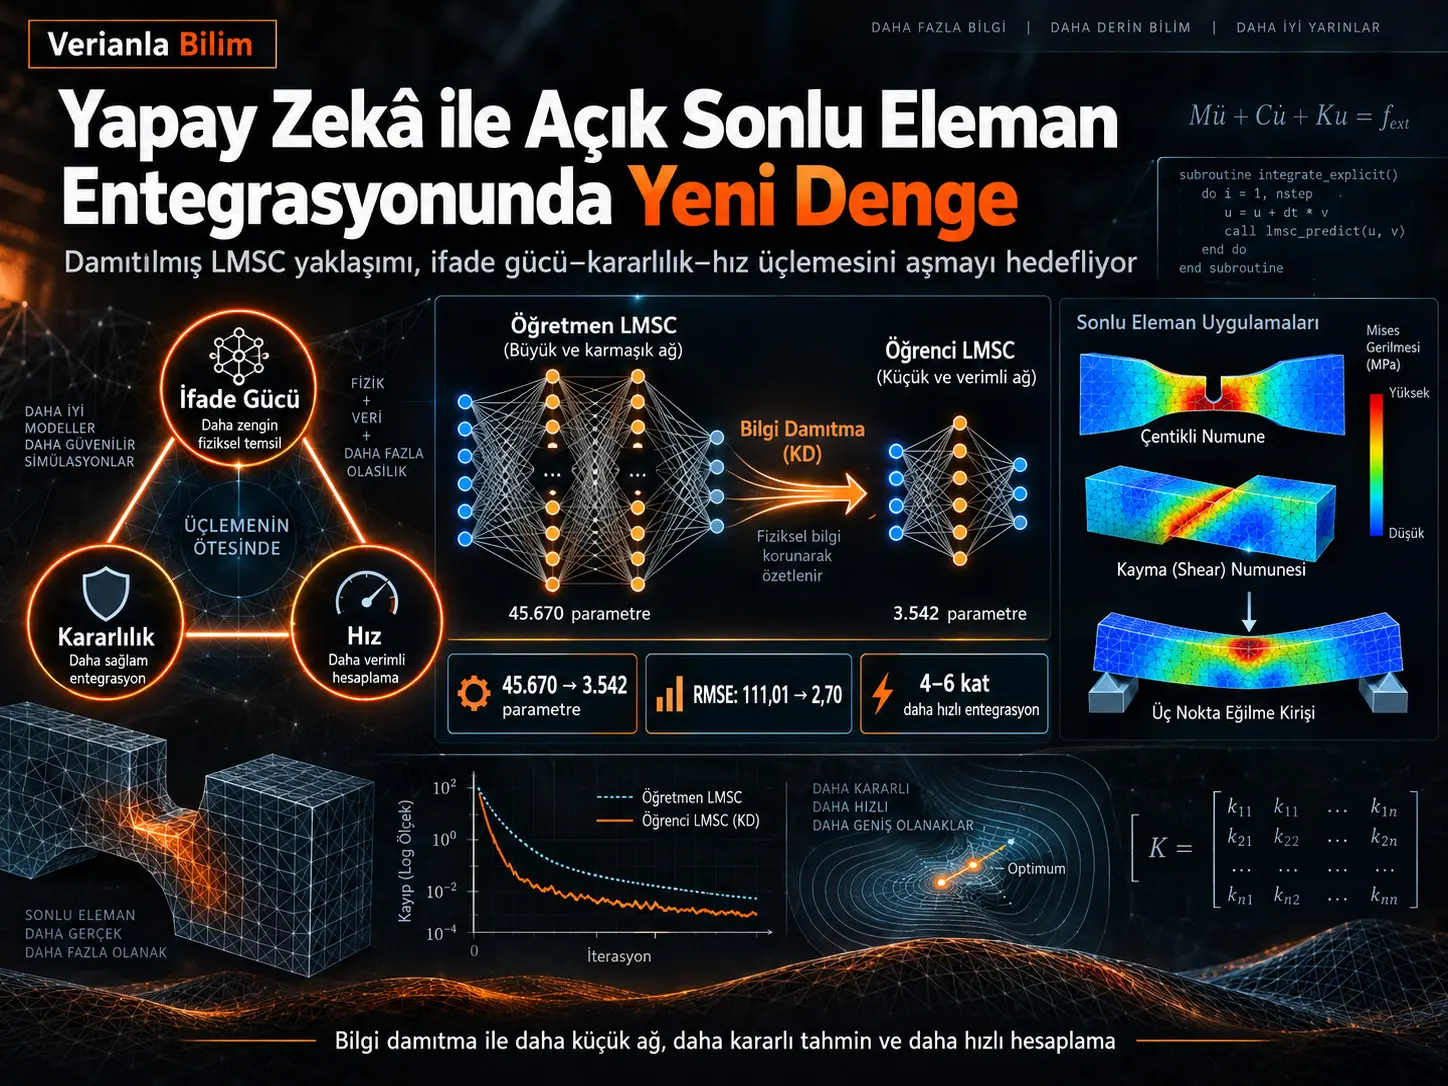
Metal şekillendirme gibi büyük ölçekli açık sonlu eleman analizlerinde konstitutif malzeme modeli her zaman adımında ve çok büyük sayıda entegrasyon noktasında tekrar tekrar çalıştırılır. Klasik von Mises izotropik pekleşme modeli fiziksel açıdan güvenilir olsa da bu sürekli değerlendirme önemli hesaplama maliyeti oluşturur. Sinir ağı tabanlı vekil modeller bu maliyeti azaltma potansiyeline sahiptir; ancak küçük ve hızlı ağlar, açık entegrasyon sırasında ardışık tahmin hatalarının büyümesi nedeniyle sayısal kararsızlık gösterebilir.
Bu çalışma söz konusu çatışmayı “İfade Gücü–Kararlılık–Hız Üçlemi” olarak tanımlamakta ve çözüm için Linearized Minimal State Cells (LMSC), native Fortran tabanlı Abaqus VUMAT entegrasyonu ve Knowledge Distillation (KD) yöntemini birleştirmektedir. Büyük ve yüksek doğruluklu LMSC öğretmen modelde 45.670 parametre bulunurken ultra-hafif öğrenci ağ 3.542 parametreye düşürülmüş; böylece yaklaşık 12,89 kat parametre sıkıştırması elde edilmiştir.
Ancak çalışmanın en önemli sonucu yalnız model küçültme değildir. Damıtılmamış kompakt ağlar çevrimdışı veri setinde düşük hata gösterebilmesine rağmen açık sonlu eleman entegrasyonunda gerilme hatalarını adım adım biriktirerek kararsızlaşabilmektedir. Örneğin u=6, w=50 konfigürasyonunun çevrimiçi RMSE'si 111,01'e çıkarken bilgi damıtma sonrasında aynı mimari için RMSE 2,70'a düşmüş ve katastrofik sapma ortadan kalkmıştır.
Çentikli çekme, kayma ve üç nokta eğme analizlerinde damıtılmış öğrenci modeller, referans Abaqus von Mises çözümüne yakın gerilme alanları ve yük–yer değiştirme eğrileri üretmiştir. Native Fortran, BLAS/VML, batch processing ve bellek yerleşimi optimizasyonlarıyla yüksek iterasyonlu analizlerde en küçük ağın Abaqus'un yerleşik modeliyle benzer hatta bazı CPU konfigürasyonlarında %24'e kadar daha kısa hesaplama süresi sağladığı raporlanmıştır.
Neden sinir ağı kullanmak otomatik olarak daha hızlı sonlu eleman analizi anlamına gelmiyor?
Bir konstitutif modeli sinir ağıyla değiştirmek teorik olarak matematiksel integrasyon maliyetini azaltabilir; ancak gerçek sonlu eleman yazılımında yalnız ağın matematiksel işlem sayısı önemli değildir. Ağ ağırlıklarının diskten okunması, Python ile Fortran arasında veri aktarımı, dış makine öğrenmesi kütüphanelerine yapılan çağrılar ve küçük matris işlemlerinin verimsiz yürütülmesi, ağın teorik avantajını tamamen ortadan kaldırabilir.
Kaynakta önceki LMSC entegrasyon yaklaşımının bazı testlerde Abaqus'un yerleşik fiziksel modelinden 4–6 kat daha yavaş çalışabildiği belirtilmektedir. Bu nedenle yazarlar hız problemini yalnız “daha küçük ağ” biçiminde değil, yazılım mimarisi problemi olarak da ele almaktadır.
İfade Gücü–Kararlılık–Hız Üçlemi Nedir?
Çalışmanın tanımına göre başarılı bir konstitutif vekil model üç koşulu aynı anda sağlamalıdır: karmaşık gerilme–gerinim geçmişini yeterli doğrulukla ifade etmeli, kapalı çevrim açık entegrasyonda küçük sayısal hataları büyütmeden kararlı kalmalı ve fiziksel konstitutif modelin yerine geçmeyi anlamlı kılacak kadar hızlı çalışmalıdır. Büyük ağlar ifade gücü ve kararlılık sağlarken yavaştır; aşırı küçültülmüş ağlar hızlıdır ancak ifade kapasitesini veya çevrimiçi kararlılığı kaybedebilir.
Çevrimdışı doğruluk neden yanıltıcı olabilir?
Çevrimdışı testte ağ her tahmin adımında doğru fiziksel geçmiş bilgisiyle beslenir. Açık sonlu eleman entegrasyonunda ise bir zaman adımında ağın ürettiği iç durum bir sonraki adıma taşınır.
Bu nedenle küçük bir hata:
- iç durum değişkenine girer,
- sonraki tahmini biraz değiştirir,
- değişmiş tahmin bir sonraki durumun girdisi olur,
- hata tekrar beslenerek büyüyebilir.
Kaynak bunu autoregressive error accumulation olarak tanımlamaktadır.
Örneğin LMSC_u6_w25 modeli çevrimdışı test loss açısından oldukça iyi görünür:
Losstest = 9,9 × 10⁻⁵
Ancak Abaqus VUMAT içindeki çevrimiçi RMSE:
RMSE = 5,10
olmaktadır.
LMSC_u6_w50 için fark çok daha büyüktür:
Losstest = 6,17 × 10⁻³
Online RMSE = 111,01
Bu sonuçlar, yalnız çevrimdışı MSE veya validation loss değerine bakarak açık entegrasyon kararlılığının değerlendirilemeyeceğini göstermektedir.
Bilgi Damıtma Küçük LMSC Ağını Nasıl Kararlı Hâle Getiriyor?
Çalışmada bilgi damıtma yalnız büyük bir modelin çıktısını küçük modele öğretme yöntemi olarak kullanılmamaktadır. Öğrenci ağ, hem Abaqus'tan gelen gerçek gerilme değerlerini hem de yüksek kapasiteli öğretmen ağın daha düzgün ve sürekli gerilme yörüngelerini öğrenmektedir. Yazarlar bu yumuşak hedeflerin küçük ağın iç temsil uzayını daha düzgün hâle getirerek ardışık hata büyümesine karşı bir tür topolojik düzenleme oluşturduğunu ileri sürmektedir.
Öğretmen model
Seçilen öğretmen:
- Durum boyutu: u = 10
- Gizli katman genişliği: w = 100
- Doğrusal olmayan katman sayısı: d = 3
- Parametre: 45.670
- Offline test loss: 9,16 × 10⁻⁵
- Online RMSE: 1,79
Bu ağ yüksek ifade gücü ve kararlılığa sahiptir; ancak komponent ölçeğinde ileri geçiş maliyeti yüksektir.
Ultra-hafif öğrenci
LMSC_u6_w25:
- u = 6
- w = 25
- 3.542 parametre
- Öğretmene göre yaklaşık 12,89× daha küçük
KD sonrasında optimal damıtma ağırlığı yaklaşık α = 0,6 olarak raporlanmıştır.
w=50 öğrenci
LMSC_u6_w50 damıtılmadan önce ağır çevrimiçi sapma göstermiştir. Çalışmada optimal KD ağırlığı yaklaşık α = 0,9 seçilmiştir.
| Model | Test loss | Online RMSE |
|---|---|---|
| LMSC_u10_w100 öğretmen | 9,16×10⁻⁵ | 1,79 |
| LMSC_u6_w25 | 9,90×10⁻⁵ | 5,10 |
| LMSC-KD_u6_w25_α0.6 | 1,04×10⁻⁴ | 3,94 |
| LMSC_u6_w50 | 6,17×10⁻³ | 111,01 |
| LMSC-KD_u6_w50_α0.9 | 2,8×10⁻⁵ | 2,70 |
Bilgi damıtma kaybı
Öğrenci eğitimindeki kayıp, gerçek Abaqus etiketleri ile öğretmen ağın yumuşak hedeflerini birlikte içermektedir:
\[ L_{\mathrm{student}} = \alpha \frac{1}{N} \sum \left\| \hat{y}_{student}-y_{true} \right\|^2 + (1-\alpha) \frac{1}{N} \sum \left\| \hat{y}_{student}-\hat{y}_{teacher} \right\|^2 \]
İlk terim gerçek fiziksel etiketlere uyumu, ikinci terim ise öğretmenin daha düzgün konstitutif yörüngesine uyumu temsil eder.
Loss landscape ne gösteriyor?
Kaynak Şekil 15 ve PDF'nin 56. sayfasındaki grafikler model ağırlıklarının küçük perturbasyonları altında loss yüzeyini göstermektedir.
Öğretmen ağda minimum çevresindeki yüzey geniş ve görece simetriktir. Damıtılmamış kompakt modellerde ise daha keskin, dar ve asimetrik bölgeler görülmektedir. KD sonrası öğrenci ağların minimum çevresindeki yüzey yeniden daha düzenli hâle gelmektedir.
Yazarlar bu geniş ve düzgün minimum yapısını, sürekli entegrasyon sırasında oluşan küçük iç-durum perturbasyonlarına karşı daha yüksek dayanıklılıkla ilişkilendirmektedir.
Nöron aktivasyonları ne gösteriyor?
Kaynağın 57. sayfasındaki violin grafikler, tanh aktivasyonlarının dağılımını karşılaştırmaktadır.
Öğretmen model yaklaşık:
−0,709 ile +0,573
aralığında çalışmaktadır.
Damıtılmamış u6_w50 ağı ise minimumda yaklaşık:
−0,867
değerine yaklaşmaktadır. Tanh türevi:
\[ \frac{d}{dx}\tanh(x)=1-y^2 \]
olduğundan yazarların hesabına göre bu bölgede kalan yerel gradient yaklaşık %24,8'e düşmektedir.
KD sonrası minimum aktivasyon yaklaşık −0,521'e çekilmekte ve en zayıf noktadaki gradient akışı yaklaşık %72,8'e yükselmektedir.
Buna karşılık u6_w25 ağının sorunu doygunluk değil, aktivasyonların yaklaşık −0,298 ile +0,289 arasında aşırı sıkışmasıdır. Kaynak bunu “topological stiffness” olarak adlandırmaktadır. KD sonrası aktivasyon aralığı genişlemekte ve ağın doğrusal olmayan temsil kapasitesi artırılmaktadır.
Native Fortran Entegrasyonu Neden Bu Kadar Önemli?
Makine öğrenmesi modelinin hızlı olması, onu sonlu eleman yazılımına bağlayan katman yavaşsa yeterli değildir. Çalışmada bu nedenle LMSC ileri geçişinin tamamı VUMAT içinde native Fortran ile yeniden uygulanmıştır.
Haricî ML çalışma zamanı yok
Çalışma sırasında PyTorch veya TensorFlow çağrısı yapılmaz. Ağ ağırlıkları simülasyon başlangıcında yalnız bir kez okunur ve sonrasında RAM'deki read-only Fortran MODULE yapısında tutulur.
BLAS ve VML
Yoğun matris işlemleri BLAS, tanh ve exp gibi fonksiyonlar ise Intel MKL Vector Mathematical Library kullanılarak vektörleştirilmiştir.
Bellek düzeni
Ağırlık matrisleri Fortran'ın column-major bellek yapısına uygun biçimde önceden transpoze edilmektedir. Amaç stride-1 erişim sağlayarak CPU cache kullanımını ve SIMD performansını artırmaktır.
Batch processing
Entegrasyon noktaları tek tek işlenmek yerine paketlenmektedir. Kaynak örnek olarak:
BATCH_SIZE = 128
değerini vermektedir.
Böylece küçük tekil ağ çağrılarının yerine yoğun ve vektörleştirilebilir matris işlemleri yapılmaktadır.
Çalışmanın Yöntemi ve Bulguları
Eğitim verisinin oluşturulması
Veri üretiminde 8 düğümlü reduced-integration C3D8R tek eleman kullanılmıştır.
Training set:
- 10.000 bağımsız gerinim yolu
Validation set:
- 1.000 bağımsız gerinim yolu
Her yol 125 piecewise-linear segmentten oluşturulmuştur. Her segment 16 mikro adıma ayrılarak:
125 × 16 = 2.000 mikro gerinim artımı
elde edilmiştir.
Rastgele yollar elastik-plastik sınırın, geri yüklemenin ve yön değişimlerinin sık görülmesini sağlayacak biçimde oluşturulmuştur.
Referans malzeme modeli
Referans model klasik von Mises akma koşulu ile Swift izotropik pekleşmesini birleştirir.
Von Mises eşdeğer gerilmesi:
\[ \bar{\sigma} = \sqrt{\frac{3}{2}\mathbf{s}:\mathbf{s}} \]
Akma koşulu:
\[ f= \bar{\sigma} - \sigma_y(\bar{\varepsilon}^{p}) \leq 0 \]
Swift pekleşmesi:
\[ \sigma_y = K \left( \varepsilon_0+\bar{\varepsilon}^{p} \right)^n \]
| E | ν | K | ε₀ | n |
|---|---|---|---|---|
| 70.000 MPa | 0,32 | 650 MPa | 0,0001 | 0,07 |
LMSC'nin temel özelliği
LMSC, gerinim artımının büyüklüğü ile yönünü birbirinden ayırır. Böylece değişken FE zaman/adım büyüklüğünün RNN iç durumuna yapay bağımlılık oluşturması azaltılmaya çalışılır.
İç durum güncellemesi kaynakta analitik formda gerçekleştirilir ve Forward Euler gibi ayrık sayısal entegrasyon yerine kapalı-form güncelleme kullanılması LMSC'nin self-consistency özelliğinin temelidir.
Tek elemanlı çevrimsel test
Teacher model referans gerilme–gerinim çevrimlerini neredeyse çakışacak biçimde takip etmiştir.
u6_w25 ağında damıtma öncesinde özellikle elastik-plastik köşelerde küçük sapmalar görülmektedir.
u6_w50 ağında ise sürekli çevrim altında genlik sürüklenmesi giderek büyümekte ve makroskopik sapmaya dönüşmektedir.
KD sonrası her iki ağın gerilme çevrimleri referans eğriye yeniden yaklaşmıştır. PDF'nin 42–44. sayfalarındaki grafikler bu farkı açık biçimde göstermektedir.
Çentikli çekme
| Model | Maksimum Mises | Referansa fark |
|---|---|---|
| Abaqus referans | 557,2 MPa | — |
| Teacher | 560,5 MPa | +3,3 MPa |
| u6_w25 | 565,7 MPa | +8,5 MPa |
| KD u6_w25 | 558,0 MPa | +0,8 MPa |
| u6_w50 | 644,3 MPa | +87,1 MPa |
| KD u6_w50 | 556,7 MPa | −0,5 MPa |
Kayma testi
| Model | Maksimum Mises |
|---|---|
| Referans | 609,5 MPa |
| Teacher | 607,2 MPa |
| u6_w25 | 611,3 MPa |
| KD u6_w25 | 607,9 MPa |
| u6_w50 | 646,5 MPa |
| KD u6_w50 | 608,5 MPa |
Üç nokta eğme
| Model | Maksimum Mises |
|---|---|
| Referans | 598,8 MPa |
| Teacher | 597,3 MPa |
| u6_w25 | 595,4 MPa |
| u6_w50 | 648,0 MPa |
| KD u6_w50 | 597,6 MPa |
Kaynağın 45–47. sayfalarındaki Mises konturları yalnız maksimum değeri değil, KD sonrası yüksek-gerilme bantlarının mekânsal sınırlarının da referans çözüme yaklaştığını göstermektedir.
Yük–yer değiştirme davranışı
Referans modellerin yaklaşık pik yükleri:
- Çentikli çekme: 2,67 kN.
- Kayma: 1,00 kN.
- Üç nokta eğme: 30,72 kN.
Damıtılmamış u6_w50 ağ yaklaşık:
- 3,37 kN,
- 1,09 kN,
- 37,17 kN
piklerine çıkarak üç testin tümünde aşırı tahmin göstermektedir.
KD sonrası öğrenci modellerin yük–yer değiştirme eğrileri referans ve öğretmen eğrileriyle büyük ölçüde örtüşmektedir. Bu davranış PDF'nin 48–50. sayfalarındaki üç grafik üzerinde görülebilir.
Hesaplama süresi
Çentikli çekme analizinde yaklaşık 1.000.000 iterasyon için optimize edilmiş u6_w25 modelin kaynakta verilen süreleri:
| CPU | Abaqus Ref | Optimize LMSC |
|---|---|---|
| 1 | 7.909 s | 6.528 s |
| 2 | 7.485 s | 5.689 s |
| 4 | 5.717 s | 5.488 s |
| 8 | 5.710 s | 5.421 s |
| 16 | 5.674 s | 5.379 s |
Bu yüksek-iterasyon senaryosunda LMSC bütün CPU konfigürasyonlarında referanstan hızlıdır.
Yaklaşık 100.000 iterasyonda ise başlangıç ve VUMAT çağrı maliyetleri daha büyük oran oluşturduğu için avantaj ortadan kalkabilmektedir.
Ağ büyüklüğünün zaman maliyeti
16 CPU ve yaklaşık 1.000.000 iterasyonlu üç nokta eğme testinde kaynak yaklaşık:
- Ref: 3.347 s
- u6_w25-opt: 6.796 s
- u10_w100-opt: 15.417 s
bildirmektedir.
Bu örnek önemli bir sınırı gösterir: daha büyük ve daha doğru bir ağın konstitutif doğruluğu yüksek olabilir fakat gerçek FE simülasyonu açısından büyük hız cezası oluşturabilir.
Amdahl yasası ve azalan getiri
Çentikli çekmede 16 CPU'da:
- Teacher: 5.971 s
- Ultra-hafif student: 5.379 s
olmasına rağmen ağ parametreleri 12,89 kat farklıdır.
Bunun nedeni toplam FE zamanının yalnız konstitutif modelden oluşmamasıdır. Paralel iletişim, temas, kinematik güncelleme ve history-variable işlemleri model küçüldükçe toplam sürede daha baskın hâle gelmektedir.
Çalışmanın doğrudan desteklediği sonuçlar
- Native Fortran entegrasyonu önceki LMSC embedding yöntemlerine göre büyük I/O ve cross-language maliyetlerini ortadan kaldırmıştır.
- Bilgi damıtma küçük LMSC ağlarının çevrimiçi açık-FE kararlılığını ciddi biçimde artırmıştır.
- Çevrimdışı düşük loss değeri çevrimiçi kararlılığın yeterli göstergesi değildir.
- KD sonrası u6_w50 ağın çevrimiçi RMSE'si 111,01'den 2,70'a düşmüştür.
- 3.542 parametreli öğrenci 45.670 parametreli öğretmene göre yaklaşık 12,89× daha küçüktür.
- KD'li modeller çekme, kayma ve üç nokta eğme gerilme alanlarında referansa yakın sonuç vermiştir.
- Yüksek iterasyonlu bazı senaryolarda optimize ultra-hafif model yerleşik Abaqus Mises modelinden daha kısa wall-clock süresi üretmiştir.
- Loss landscape ve aktivasyon dağılımları KD sonrası iç temsil geometrisinin değiştiğini göstermektedir.
Çalışmanın doğrudan desteklemediği sonuçlar
- Her sinir ağı konstitutif modelinin bilgi damıtmayla kararlı hâle geleceği kanıtlanmamıştır.
- KD bütün açık sonlu eleman analizleri için matematiksel kararlılık garantisi sağlamamaktadır.
- Parametre sayısının 12,89 kat azalması FE çözümünün 12,89 kat hızlandığı anlamına gelmez.
- LMSC bütün iterasyon sayılarında ve bütün komponentlerde Abaqus'un yerleşik modelinden hızlı değildir.
- Çalışma gerçek fiziksel çekme/kayma/eğme deneylerini doğrulama ground truth'u olarak kullanmamaktadır; ana referans Abaqus'un klasik Mises modelidir.
- Anizotropik plastik davranış, hız bağımlılığı, hasar veya kırılma bu çalışmada doğrulanmamıştır.
- “Topolojik düzenleyici” mekanizması loss-landscape ve aktivasyon analizleriyle desteklenen yazar yorumudur; genel matematiksel teorem değildir.
Kaynak ve Yöntem Notu
Özgün başlık:Breaking the Expressivity-Stability-Speed Trilemma in Explicit FE Integration via Distilled Linearized Minimal State Cells
Yazarlar: Xudong Yang; Yanfeng Yang; Heng Li.
Kurumlar: State Key Laboratory of Solidification Processing, School of Materials Science and Engineering, Northwestern Polytechnical University; Research & Development Institute of Northwestern Polytechnical University in Shenzhen.
Kaynak türü: Hesaplamalı mekanik / makine öğrenmesi destekli konstitutif modelleme preprinti.
Platform: SSRN.
SSRN kayıt numarası: 7381099.
Hakemlik durumu: Yüklenen çalışma her sayfada hakem değerlendirmesinden geçmediğini belirtmektedir.
Referans konstitutif model: von Mises (J2) akma kriteri + Swift izotropik pekleşme.
Referans sonlu eleman yazılımı: Abaqus/Standard veri üretimi ve Abaqus/Explicit VUMAT entegrasyonu.
Ana sinir ağı: Linearized Minimal State Cells (LMSC).
Ana sıkıştırma/düzenleme yöntemi: Knowledge Distillation.
Öğretmen: u=10, d=3, w=100; 45.670 parametre.
Ultra-hafif öğrenci: u=6, w=25; 3.542 parametre; yaklaşık 12,89× parametre sıkıştırması.
Veri seti: 10.000 training ve 1.000 validation gerinim yolu; yol başına 125 segment ve 2.000 mikro artım.
Yapısal doğrulamalar: Çentikli çekme, lokal kayma ve üç nokta eğme.
Yazılım optimizasyonları: Library-free native Fortran, tek-sefer parametre yükleme, global read-only weights, BLAS, Intel MKL VML, bellek transpozisyonu, stride-1 erişim, batch processing ve SIMD.
Veri erişimi: Yazarlar bu çalışmada hesaplanan veya analiz edilen bütün verilerin makale içinde bulunduğunu belirtmektedir.
Finansman: National Natural Science Foundation of China ve çeşitli Shenzhen, Shaanxi ve merkezi üniversite araştırma programları tarafından desteklenmiştir.
Çıkar çatışması: Yazarlar rekabet eden çıkar bulunmadığını beyan etmektedir.
AI kullanım beyanı: Yazarlar Gemini 3 Pro'yu dilbilgisi ve dil akışını iyileştirmek amacıyla kullandıklarını; teknik içeriği kendilerinin doğrulayıp düzenlediğini ve sonuçların sorumluluğunu üstlendiklerini belirtmektedir.
Temel bilimsel sınır: Çalışma fiziksel ground truth olarak deneysel metal numunelerden ölçülmüş gerilme geçmişini değil, Abaqus içindeki von Mises–Swift modelini kullanmaktadır. Bu nedenle gösterilen başarı esas olarak klasik sayısal konstitutif modelin düşük maliyetli vekil modelle yeniden üretilmesidir.
Genelleştirme sınırı: Anizotropik akma, viskoplastisite ve continuum damage mechanics yalnız gelecek çalışma alanları olarak anılmaktadır.
Kararlılık sınırı: Çalışmanın “catastrophic autoregressive divergence eliminated” sonucu incelenen modeller ve yük yolları için deneysel hesaplama sonucudur; bütün açık FE problemlerine yönelik formal kararlılık garantisi değildir.
Hız sınırı: Hız avantajı iterasyon sayısı, ağ boyutu, CPU sayısı ve problem türüne bağlıdır. Düşük iterasyonlu analizlerde native Abaqus modeli daha hızlı olabilir.
Amdahl sınırı: Ağ küçüldükçe konstitutif inference toplam hesaplama süresinin daha küçük bölümünü oluşturur; bu nedenle parametre sıkıştırmasının wall-clock kazancı doğrusal değildir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir