

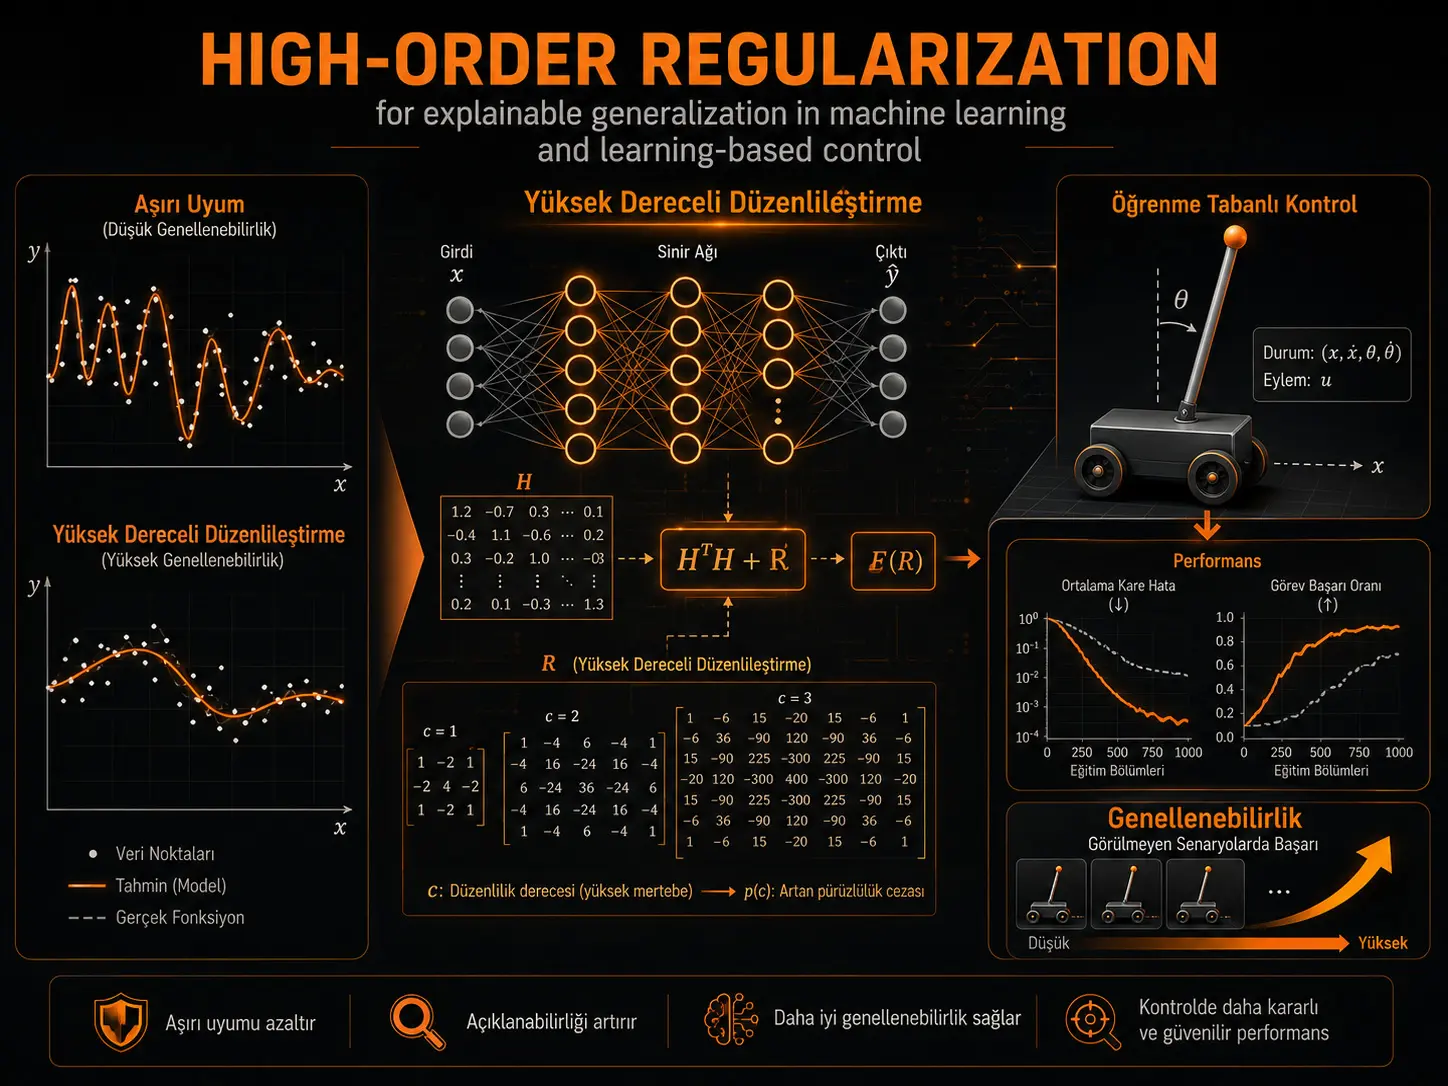
Ushbu tadqiqot neyron tarmoqlarida ortiqcha moslashishni kamaytirish bilan birga, muntazamlashtirish nima sababdan va qanday qilib umumlashtirish qobiliyatini o‘zgartirishini matematik jihatdan tushuntirish maqsadida High-Order Regularization (HR) — Yuqori Tartibli Muntazamlashtirish deb nomlangan usulni taklif qiladi. HR neyron tarmog‘ining oxirgi yashirin qatlamidan chiqishga boruvchi o‘rganiladigan vaznlarni hisoblashni teskari akslantirish muammosi sifatida ko‘radi va \(H^\top H\) axborot matritsasining teskarisini chekli matritsa darajalari qatori bilan yaqinlashtiradi. An’anaviy L2-norma muntazamlashtirish ushbu doirada \(c=0\) bo‘lgan past tartibli maxsus holat sifatida paydo bo‘ladi, amaliyotlarda esa asosan \(c=1\) ishlatiladi. Nazariy qism yaqinlashuvni, hisoblanadigan quyi va yuqori xato chegaralarini hamda muntazamlashtirish matritsasi orqali shart sonini boshqaradigan umumlashtirish mezonini keltirib chiqaradi. Tajribalarda HR Cart-Pole boshqaruvida, IRIS va MNIST tasnifida hamda uchta regressiya muammosida taqqoslangan usullarga nisbatan yuqoriroq mukofot/aniqlik yoki pastroq RMSE qiymatlarini bergan. Biroq tajribalar cheklangan sondagi muammolarda o‘tkazilgan, ma’lumot bo‘linishlari ayniqsa ortiqcha moslashishni rag‘batlantiradigan tarzda tuzilgan va katta zamonaviy chuqur tarmoq arxitekturalarida masshtablanish qobiliyati hali tajribada ko‘rsatilmagan.
Cart-Pole tajribasida vaqt qadami cheklovi olib tashlangan taqqoslashda so‘nggi 50 epizodning o‘rtacha mukofoti Q-network uchun 207,4, EQLM uchun 208,2 va taklif etilgan HR uchun 273,4 deb hisobot qilingan. Mualliflar ushbu natijani Q-network ga nisbatan %31,8 va EQLM ga nisbatan %31,3 yaxshilanish deb ifodalaydi. Biroq HR natijalarida yugurishlararo o‘zgaruvchanlik yuqori; o‘sha jadvalda HR uchun standart og‘ish 323,7 deb berilgan. Shuning uchun yuqori o‘rtacha natija pastroq dispersiyani anglatmaydi.
Standart 200 vaqt qadami chegarasiga ega Cart-Pole tajribasida HR ning so‘nggi 50 epizod mukofoti 175,2, Q-network uchun esa 123,8; AUC qiymatlari mos ravishda \(87,5\times10^3\) va \(71,0\times10^3\) deb berilgan. Mualliflar bularni mos ravishda %41,5 va %23,2 oshish deb baholaydi. Ushbu nazoratli tajribada HR mukofotlarining taqsimoti vaqt qadami cheklanmagan tajribadagidan torroq.
Mashinali o‘rganish tajribalarida ham xuddi shu tendensiya kuzatiladi. IRIS test aniqligi HR bilan %95,0; Dropout bilan %94,2; L2-norma bilan %93,3 va muntazamlashtirishsiz FNN bilan %87,5 ni tashkil etadi. MNIST da faqat 1.000 ta o‘quv tasviri ishlatilganda HR %84,1, Dropout %83,4, L2-norma %82,7 va FNN %59,0 aniqlik bergan. Bu taqqoslashlar tanlangan testlarda HR ning ustunligini ko‘rsatadi; ammo tadqiqot ushbu jadval natijalari uchun takroriy tajriba taqsimoti, ishonch oralig‘i yoki usullar o‘rtasidagi statistik ahamiyat testini bermaydi.
Turkiya nuqtai nazaridan: HR yondashuvi Turkiyadagi mashinali o‘rganish, robototexnika, adaptiv boshqaruv, sanoat avtomatlashtirish yoki cheklangan/og‘ishgan o‘quv ma’lumotlari bilan ishlaydigan qaror tizimlarida o‘rganilishi mumkin bo‘lgan matematik usulni taqdim etadi. Biroq tadqiqotdagi ishlash ko‘rsatkichlarini Turkiyadagi biror real tizimga bevosita ko‘chirib bo‘lmaydi. Mahalliy qo‘llash uchun tegishli ma’lumot taqsimoti, tarmoq arxitekturasi, hisoblash apparati, real vaqt cheklovlari, xavfsizlik talablari va mavjud usullar bilan mustaqil benchmark taqqoslashlari alohida tekshirilishi kerak.
Tadqiqotning asosiy muammosi nima?
Muntazamlashtirish neyron tarmog‘ining o‘quv ma’lumotlariga ortiqcha moslashishining oldini olish va ko‘rilmagan ma’lumotlarda yaxshiroq ishlashini ta’minlash uchun keng qo‘llanadi. L2, L1, dropout, mixup, erta to‘xtatish va shunga o‘xshash usullarning amaliy muvaffaqiyati yaxshi ma’lum bo‘lsa-da, tadqiqot nishonga olgan bo‘shliq muntazamlashtirish dastlabki yechimni matematik jihatdan qanday o‘zgartirishini, qanday og‘ish keltirib chiqarishini va ushbu og‘ish bilan umumlashtirish o‘rtasidagi muvozanatni qanday hisoblash mumkinligini yanada aniq ko‘rsatishdir.
1-rasm ushbu muammoni regressiya va tasnif orqali tasvirlaydi. O‘quv nuqtalariga haddan tashqari egilib moslashadigan murakkab modellar ko‘k, murakkabligi pastroq muntazamlashtirilgan modellar esa qora chiziqlar bilan ko‘rsatiladi. Tasvirning asosiy xabari shuki, o‘quv namunalarini yaxshiroq kuzatadigan model ko‘rilmagan ma’lumot uchun albatta yaxshiroq model bo‘lavermaydi.
Tahlil nega Extreme Learning Machine asosida qurilgan?
Tadqiqot nazariyani aniq hosil qilish uchun Extreme Learning Machine (ELM) arxitekturasidan foydalanadi. ELM bir yashirin qatlamli oldinga yo‘naltirilgan tarmoqdir; kirishdan yashirin qatlamga boruvchi vaznlar va ehtimoliy bias tasodifiy belgilanadi, faqat yashirin qatlamdan chiqishga boruvchi \(\beta\) vaznlari analitik tarzda hisoblanadi.
2-rasmda kirish tugunlari yashirin tugunlarga, yashirin tugunlar esa chiqishlarga bog‘langan ELM arxitekturasi ko‘rsatiladi. Bir \(x_j\) kirish namunasi uchun tarmoq chiqishi:
\[ \sum_{i=1}^{L}\beta_i g_i(x_j) = \sum_{i=1}^{L}\beta_i g_i(w_i\cdot x_j+b_i) = o_j \]
ko‘rinishida ifodalanadi. Bu yerda \(L\) yashirin tugunlar sonini, \(w_i\) tasodifiy kirish vaznlarini, \(b_i\) bias ni, \(g_i\) faollashtirish funksiyasini va \(\beta_i\) o‘rganiladigan chiqish vaznini ifodalaydi.
Asosiy o‘qitish muammosi:
\[ \min_{\beta\in\mathbb{R}^{L\times k}} \left\|H\beta-Y\right\|^2 \]
ko‘rinishida yoziladi. \(H\) yashirin qatlam chiqish matritsasi, \(Y\) esa o‘quv yorlig‘idir. Muntazamlashtirishsiz eng kichik normali eng kichik kvadratlar yechimi Moore–Penrose psevdoteskarisi bilan:
\[ \hat{\beta}=H^\dagger Y \]
ko‘rinishida olinadi.
L2 muntazamlashtirish bu tuzilma ichida qanday ko‘rinadi?
Manbada klassik L2 muntazamlashtirilgan yechim:
\[ \hat{\beta} = \left( H^\top H+\frac{I}{\mu} \right)^\dagger H^\top Y \]
ko‘rinishida beriladi. Ushbu amal yomon shartlangan \(H^\top H\) matritsasini son jihatdan barqarorroq qilishi mumkin; biroq muntazamlashtirish shu bilan birga nazariy optimal yechimga nisbatan baholash og‘ishini ham yaratadi. HR yondashuvi ushbu og‘ishni bevosita taxminiy teskari akslantirish xatosi sifatida aniqlashga harakat qiladi.
Yuqori Tartibli Muntazamlashtirish qanday hosil qilinadi?
HR ning boshlang‘ich nuqtasi:
\[ F(R) := R\left(H^\top H+R\right)^{-1} \]
ta’rifidir. Bu yerda \(R\) tanlanadigan muntazamlashtirish matritsasidir. Tegishli spektral radius sharti ostida:
\[ (I-F(R))^{-1} = \sum_{i=0}^{\infty}F^i(R), \qquad \rho(F(R))<1 \]
matritsa darajalari qatoridan foydalanish mumkin. Cheksiz qator \(c+1\) ta hadadan keyin kesilganda tadqiqot taklif qilgan HR yechimi olinadi:
\[ \hat{\beta}_{hr} = \left(H^\top H+R\right)^{-1} \sum_{i=0}^{c} F^i(R)H^\top Y, \qquad \rho(F(R))<1 \]
\(c\) muntazamlashtirish darajasidir. \(c=0\) va \(R=\bar{\mu}I\) tanlanganda yechim an’anaviy L2-norma muntazamlashtirish shakliga tushadi. \(c\geq1\) bo‘lganda teskari akslantirish bir nechta matritsa-qator hadlari orqali yaqinlashtirilgani uchun tadqiqot buni “high-order” muntazamlashtirish deb ataydi.
Nega L2 HR ning maxsus holati hisoblanadi?
HR da \(c=0\) tanlanganda qator faqat birlik matritsa hadini o‘z ichiga oladi:
\[ \sum_{i=0}^{0}F^i(R)=I \]
va:
\[ \hat{\beta}_{hr} = (H^\top H+R)^{-1}H^\top Y \]
olinadi. \(R=\bar{\mu}I\) tanlovi klassik L2/Tikhonov tipidagi yechimni beradi. Appendix A shuningdek oxirgi yashirin qatlamga qo‘llangan dropout ning kutilayotgan yo‘qotishi:
\[ L(\beta)= \frac{1}{2N}\|y-H\beta\|_2^2+ \frac{1-p}{2pN} \beta^\top \operatorname{diag}(H^\top H) \beta \]
ko‘rinishida norma muntazamlashtirishga aylantirilishi mumkinligini ko‘rsatadi. Ushbu maxsus dropout hosilasida muntazamlashtirish koeffitsienti \((1-p)/p\), dropout shovqinining dispersiyasi bilan bog‘lanadi.
HR yechimining yaqinlashuvi qanday tushuntiriladi?
Tadqiqotda HR xatosi:
\[ e_\beta=\hat{\beta}_{hr}-\beta_{opt} \]
deb aniqlanadi. 1-teorema ko‘rsatilgan musbat aniqlik va spektral radius shartlarida muntazamlashtirish matritsasi nolga yaqinlashganda yoki muntazamlashtirish darajasi cheksizlikka ketganda HR yechim xatosining nolga yaqinlashishini ko‘rsatadi:
\[ \lim_{R\rightarrow O}\|e_\beta\|=0, \qquad \lim_{c\rightarrow+\infty}\|e_\beta\|=0 \]
Bu natija HR qatorini kesish xatosini muntazamlashtirish matritsasi va qator darajasi bilan bevosita bog‘lash imkonini beradi.
Xato nega hisoblanadigan deb qaraladi?
Teskari matritsani yaqinlashtirish xatosi:
\[ F_{ar}(R) = (H^\top H)^{-1} - (H^\top H+R)^{-1} \sum_{i=0}^{c}F^i(R) \]
ko‘rinishida aniqlanadi. Tegishli shartlarda:
\[ F_{ar}(R) = (H^\top H)^{-1}F^{c+1}(R) \]
olinadi. So‘ng tadqiqot HR yechim xatosi uchun quyi va yuqori chegaralarni keltirib chiqaradi:
\[ \frac{1}{1-\lambda_{\min}(F(R))} \left\| (H^\top H+R)^{-1} F^{c+1}(R)H^\top Y \right\| \leq \|e_\beta\| \]
va:
\[ \|e_\beta\| \leq \frac{1}{1-\lambda_{\max}(F(R))} \left\| (H^\top H+R)^{-1} F^{c+1}(R)H^\top Y \right\| \]
ko‘rinishidadir. Shunday qilib, muntazamlashtirish sababli nazariy yechimga nisbatan yuzaga keladigan farq faqat intuitiv jarima hadi emas, tanlangan \(R\) va \(c\) ostida chegaralanishi mumkin bo‘lgan taxminiy teskari olish xatosi sifatida talqin qilinadi.
Muntazamlashtirish nega qisqarish amali sifatida talqin qilinadi?
2-teoremada mos simmetrik musbat yarim aniqlangan \(R\) va musbat aniqlangan \(H^\top H\) shartlari ostida muntazamlashtirish matritsasi \(F_{ar}(R)\) yaqinlashtirish xatosi normasida qisqarish hosil qilishi ko‘rsatiladi. Qisqarish nisbatini ham \(R\), ham muntazamlashtirish darajasi \(c\) belgilaydi.
Ushbu nuqtai nazarda past daraja nazariy optimum va muntazamlashtirilgan yechim o‘rtasida kattaroq masofa hosil qilishi mumkin; ko‘proq qator hadlari esa teskari akslantirish yaqinlashuvini yaxshilaydi. Buning evaziga muntazamlashtirishning yomon shartlanganlikni kamaytirish ta’siri bilan baholash og‘ishi o‘rtasida muvozanat o‘rnatilishi kerak.
“Maksimal umumlashtirish” nimani anglatadi?
Tadqiqot umumlashtirishni barcha mumkin bo‘lgan test taqsimotlarida bevosita o‘lchash o‘rniga \(H^\top H+R\) matritsasining shart soni orqali tavsiflaydi:
\[ \operatorname{Cond}(R) = \|H^\top H+R\| \, \|(H^\top H+R)^{-1}\| \]
Shart sonining kamayishi o‘quv ma’lumotidagi kichik o‘zgarishlarning vazn yechimida haddan tashqari katta o‘zgarishlarga aylanishini kamaytiruvchi yaxshiroq shartlangan muammo deganidir. Tadqiqotning muvozanat mezoni:
\[ \operatorname{Obj}(R) = \|F_{ar}(R)\| \operatorname{Cond}(R) \]
deb aniqlanadi. Ushbu maqsad funksiyasi baholash og‘ishi va yomon shartlanganlikni birgalikda hisobga oladi.
2-taklifda \(H^\top H\) ning xos qiymatlari \(\lambda_i\) bo‘lganda:
\[ \lambda_{R,i} = \max\{\bar{\mu}-\lambda_i,0\} \]
ko‘rinishida tuzilgan muntazamlashtirish matritsasi ko‘rib chiqiladi. Tadqiqotning matematik umumlashtirish mezonida \(\bar{\mu}=\lambda_1\) atrofida shart sonini 1 gacha kamaytirish mumkin. Ushbu “maksimal umumlashtirish” iborasi tadqiqotning shart-soniga asoslangan nazariy ta’rifi doirasidadir; barcha real dunyo taqsimotlarida universal maksimal ishlash kafolati sifatida talqin qilinmasligi kerak.
4-rasm muntazamlashtirishni qanday tushuntiradi?
4-rasm nazariy tushuntirishning vizual xulosasidir. Eng katta doira berilgan o‘quv ma’lumotlari va \(H^\top H\) axborot matritsasi uchun dastlabki tarmoqning mumkin bo‘lgan yechimlarini, markaz esa nazariy optimal yechimni ifodalaydi. Kichikroq doiralar turli \(R\) matritsalari ostida olingan muntazamlashtirilgan yechimlarni ko‘rsatadi. Uzilgan doira radiusi ma’lum \(c\) uchun baholash og‘ishini ifodalaydi.
Rasmning asosiy xabari shuki, kuchliroq muntazamlashtirish avtomatik tarzda yaxshiroq degani emas. Maqsad yechimni barqarorlashtirib, uni nazariy optimumdan ortiqcha uzoqlashtirmaydigan \(R\) va \(c\) kombinatsiyasini topishdir.
Singulyar yoki katta akslantirishlarda HR qanday kengaytiriladi?
Tarmoq masshtabi kattalashganda \(H^\top H\) singulyar bo‘lishi mumkin. Tadqiqot bunday holatda Moore–Penrose psevdoteskarisidan foydalanib umumiy teskari akslantirish yondashuvini kengaytiradi. Yondashuv:
\[ F_{aim}(H,R,c) = (H^\top H+R)^{-1} \sum_{i=0}^{c}F^i(R) \]
bilan aniqlanadi va:
\[ F_{ar}(R) = (H^\top H)^\dagger-F_{aim}(H,R,c) \]
endi umumiy teskari olishning yaqinlashtirish xatosini ifodalaydi. 3-teoremada:
\[ \lim_{c\rightarrow+\infty}F_{ar}(R) = (H^\top H)^\dagger-R^{-1} \]
natijasi beriladi. Manba talqiniga ko‘ra, mos \(R\) tanlovi singulyar akslantirishlarda ham taxminiy teskari olish xatosi va shartlanganlikni birgalikda boshqarishga imkon beradi.
Inkremental HR qanday ishlaydi?
Incremental High-Order Regularization (IHR) yangi mini-batch ma’lumot kelganda butun tarmoqni boshidan o‘qitish o‘rniga mavjud axborot matritsasi va vaznlarni yangilaydi. Asosiy yangilash:
\[ \hat{\beta}_{t+1} = K_{t+1}(c)\hat{\beta}_t + F_{aim,t+1}H_{ic}^{\top}Y_{ic} \]
ko‘rinishidadir. Bu yerda yangi \(H_{ic},Y_{ic}\) mini-batch mavjud modelga qo‘shiladi. Tadqiqot ayniqsa o‘rganishga asoslangan boshqaruvda o‘qitishning dastlabki davrida past sifatli va cheklangan ma’lumotlar keltirib chiqarishi mumkin bo‘lgan ortiqcha moslashishni vaqt o‘tishi bilan kamaytirish kontekstida ushbu inkremental tuzilmani muhokama qiladi.
HR ning “o‘rganish, xotira va unutish” talqini nima?
Mualliflar muntazamlashtirishning o‘qitish boshida yetarli bo‘lmagan yoki og‘ishgan ma’lumot ta’sirini bostirishini adaptiv unutishning bir turi sifatida talqin qiladi. O‘qitish davom etib, ma’lumot sifati va axborot miqdori oshganda muntazamlashtirish ta’sirining o‘zgarishi tizimning yangi ma’lumotni o‘rganishi bilan eski ma’lumotga beradigan vazni o‘rtasidagi bog‘liqlikni tushuntirish uchun ishlatiladi.
Bu ibora neyrobiologik xotira mexanizmining isboti emas; u tadqiqotning matematik muntazamlashtirish xulqiga bergan o‘rganishga asoslangan boshqaruv talqinidir.
Cart-Pole tajribasida nima topildi?
OpenAI Gym Cart-Pole muammosi Q-network, EQLM va HR-EQLM yondashuvini taqqoslash uchun ishlatilgan. Vaqt qadami chegarasi olib tashlangan tajribalarda 50 ta yugurish bo‘yicha so‘nggi 50 epizodning o‘rtacha mukofotlari:
| Usul | So‘nggi 50 epizod o‘rtacha mukofoti | AUC (×10³) |
|---|---|---|
| Q-network | 207,4 (176,2–236,3) | 107,8 (103,8–111,8) |
| EQLM | 208,2 (188,51–224,98) | 97,2 (90,3–103,3) |
| Taklif etilgan HR | 273,4 (166,1–340,3) | 116,3 (86,1–136,8) |
HR o‘rtacha mukofot bo‘yicha eng yuqori qiymatni bergan. Biroq ayni 4-jadvalda standart og‘ish Q-network uchun 108,7, EQLM uchun 66,2 va HR uchun 323,7 deb berilgan. HR ning yuqori o‘rtachasi ayrim yugurishlarda 200 vaqt qadamidan ancha yuqori olingan katta mukofotlar ta’sirida; shuning uchun o‘rtacha oshish bilan birga yugurishlararo o‘zgaruvchanlik ham hisobga olinishi lozim.
200 vaqt qadamli tajribada natija qanday o‘zgaradi?
Standart 200 vaqt qadami cheklovi qo‘llanganda taqqoslash torroq ishlash oralig‘ida o‘tkazilgan:
| Usul | So‘nggi 50 epizod o‘rtacha mukofoti | AUC (×10³) |
|---|---|---|
| Q-network | 123,8 (112,4–135,5) | 71,0 (68,8–73,5) |
| Taklif etilgan HR | 175,2 (169,6–180,9) | 87,5 (84,7–90,5) |
Manba HR ning so‘nggi 50 epizod mukofotida %41,5 va AUC da %23,2 yaxshilanish berganini bildiradi. HR mukofotlarining standart og‘ishi 20,3, Q-network niki esa 41,9.
IRIS va MNIST natijalari nimani ko‘rsatadi?
Tasnif tajribalarida FNN, Dropout, L2-norma va \(c=1\) HR taqqoslangan:
Verianla Live: Muntazamlashtirish usullarining tasnif aniqligi
Taqqoslash tadqiqotning 6-jadvalida berilgan test aniqliklarini ko‘rsatadi. MNIST tajribasi faqat 1.000 ta o‘quv tasviri bilan o‘tkazilgan; shu sababli qiymatlar to‘liq MNIST o‘quv to‘plami bilan olingan standart benchmark qiymatlari sifatida talqin qilinmasligi kerak.
| Ma’lumot to‘plami | FNN | Dropout | L2-norma (c=0) | Taklif etilgan HR (c=1) | Birlik | Manba |
|---|---|---|---|---|---|---|
| IRIS | 87,5 | 94,2 | 93,3 | 95,0 | Test aniqligi (%) | 6-jadval |
| MNIST | 59,0 | 83,4 | 82,7 | 84,1 | Test aniqligi (%) | 6-jadval |
HR har ikki ma’lumot to‘plamida ham eng yuqori test aniqligini bergan. Biroq IRIS da HR bilan Dropout o‘rtasidagi farq 0,8 foiz punkt, MNIST da esa 0,7 foiz punkt. Tadqiqot bu farqlar uchun statistik ahamiyat testi yoki takroriy yugurish ishonch oralig‘ini bermagani sababli, kichik farqlarni umumiy ustunlik sifatida talqin qilish to‘g‘ri emas.
Regressiya tajribalarida nima topildi?
Regressiya vazifalarida past Root Mean Squared Error (RMSE) yaxshiroq ishlashni anglatadi:
| Ma’lumot to‘plami | FNN RMSE | Dropout RMSE | L2-norma RMSE | HR (c=1) RMSE |
|---|---|---|---|---|
| Weather prediction | 4,2274 | 2,1575 | 2,7061 | 2,0888 |
| Power consumption | 0,7488 | 0,7140 | 0,7474 | 0,7096 |
| Appliances energy | 87,7197 | 79,0572 | 79,4058 | 77,3815 |
HR tadqiqotdagi uchala regressiya testida ham eng past RMSE ni bergan. Weather prediction da Dropout bilan HR o‘rtasidagi farq nisbatan kichik, muntazamlashtirishsiz FNN xatosi esa yuqoriroq.
12- va 13-rasmlar nimani ko‘rsatadi?
Appliances Energy tajribasining 12-rasmi vaqt bo‘yicha FNN, L2, HR va Dropout uchun prognoz minus haqiqiy qiymat xatosini ko‘rsatadi. 13-rasm shu xatolarning taqsimotlarini taqqoslaydi. Muntazamlashtirilgan modellarning xato taqsimotlari nol atrofida o‘xshash tarzda zichlashadi.
Regressiya modellarida muntazamlashtirishdan kelib chiqadigan og‘ishni kamaytirish uchun o‘quv ma’lumotidan ajratilgan validatsiya ma’lumotlari yordamida og‘ish tuzatish qo‘llangan. Shu sababli jadvalda berilgan regressiya natijalari faqat xom muntazamlashtirilgan yechimning emas, tadqiqotda belgilangan validatsiya-asosidagi tuzatish jarayonining ham ta’sirini o‘z ichiga oladi.
Tadqiqot qo‘llab-quvvatlaydigan natijalar
- HR matritsa darajalari qatorining kesilgan taxminiy teskari olish shakli sifatida aniq formulalangan.
- L2-norma muntazamlashtirish HR doirasida \(c=0\) maxsus holat sifatida ifodalanishi mumkin.
- Ko‘rsatilgan matritsa shartlarida HR yechimining yaqinlashuvi va hisoblanadigan xato chegaralari nazariy jihatdan hosil qilingan.
- Muntazamlashtirish matritsasi va darajasi taxminiy teskari olish xatosining qisqarish tezligini boshqaradi.
- Tadqiqotning shart-soniga asoslangan ta’rifida \(R\) matritsasining xos qiymat tuzilmasi umumlashtirish mezonini optimallashtirish uchun loyihalanishi mumkin.
- Tanlangan Cart-Pole, tasnif va regressiya tajribalarida \(c=1\) HR hisobot qilingan asosiy ishlash mezonlarida taqqoslangan usullardan yuqoriroq natijalar bergan.
Tadqiqot isbotlamagan yoki hali sinamagan natijalar
- HR ning barcha mashinali o‘rganish vazifalarida L2, Dropout yoki boshqa muntazamlashtirish usullaridan ustunligi ko‘rsatilmagan.
- Shart sonining minimal bo‘lishi barcha real ma’lumot taqsimotlarida maksimal test ishlashini kafolatlamaydi.
- HR ning katta CNN, RNN yoki transformer arxitekturalaridagi masshtablanishi tajribada tasdiqlanmagan.
- Cart-Pole natijalari real robot yoki xavfsizlik-kritik boshqaruv tizimidagi dala tasdiqlovi emas.
- IRIS, MNIST va regressiya jadvalidagi kichik ishlash farqlari uchun statistik ustunlik testi berilmagan.
- MNIST natijasi to‘liq standart o‘quv to‘plami bilan olingan benchmark emas; faqat 1.000 ta o‘quv tasviri ishlatilgan.
- Manbada keltirilgan “tushuntiriluvchanlik” SHAP yoki xususiyat atributsiyasi usuli kabi namuna-asosidagi izoh yaratishdan ko‘ra muntazamlashtirishning matematik ta’sirini tushuntirishga qaratilgan.
Tadqiqot Usuli va Natijalari
Nazariy usul
Tadqiqotning nazariy qismi neyron tarmog‘ining oxirgi yashirin qatlam chiqishini \(H\) akslantirish matritsasi bilan ifodalaydi va o‘rganiladigan chiqish vaznlarini \(\beta\) orqali tahlil qiladi. HR \(H^\top H\) yoki uning Moore–Penrose umumiy teskarisini bevosita ishlatish o‘rniga muntazamlashtirilgan matritsa va kesilgan darajalar qatoridan taxminiy teskari yaratadi.
| Komponent | Manbada ishlatilgan ifoda | Vazifa |
|---|---|---|
| Axborot/akslantirish matritsasi | \(H^\top H\) | O‘quv ma’lumotidan keladigan akslantirish axborotini ifodalaydi. |
| Muntazamlashtirish matritsasi | \(R\) | Shartlanganlik va baholash og‘ishi o‘rtasidagi muvozanatni o‘zgartiradi. |
| Qator matritsasi | \(F(R)=R(H^\top H+R)^{-1}\) | Taxminiy teskari olish darajalar qatorini hosil qiladi. |
| Muntazamlashtirish darajasi | \(c\) | Qatorda saqlanadigan yuqori tartibli hadlar sonini belgilaydi. |
| Taxminiy teskari | \(F_{aim}(H,R,c)\) | Umumiy teskari akslantirishning HR yaqinlashuvidir. |
| Yaqinlashuv qoldig‘i | \(F_{ar}(R)\) | Nazariy teskari bilan HR taxminiy teskarisi o‘rtasidagi farqdir. |
Cart-Pole tajriba tuzilishi
| Tajriba xususiyati | Manbada berilgan qiymat |
|---|---|
| Harakat fazosi | Chap, o‘ng |
| Holat o‘zgaruvchilari | Arava holati, arava tezligi, tayoq burchagi, tayoq burchak tezligi |
| Tayoq burchak chegarasi | (−12°, 12°) tashqarisiga chiqishda tugatish |
| Arava holati chegarasi | (−2,4, 2,4) tashqarisiga chiqishda tugatish |
| Standart maksimal vaqt qadami | 200 |
| Mukofot | Har qadam +1 |
| Boshlang‘ich holat | (−0,05, 0,05) oralig‘ida tasodifiy |
| Jami yugurish | 50 |
Tarmoq giperparametrlari
| Giperparametr | Q-network | ELM / EQLM-HR tuzilmasi |
|---|---|---|
| O‘rganish tezligi | 0,0065 | Qo‘llanmaydi |
| Muntazamlashtirish parametri | Qo‘llanmaydi | 1,827×10−5 |
| Yashirin tugun | 29 | 25 |
| Boshlang‘ich exploration ehtimoli | 0,670 | 0,599 |
| Exploration kamaytirish muddati | 400 epizod | 360 epizod |
| Diskont koeffitsienti | 0,99 | 0,93 |
| Mini-batch | 26 | 2 |
| Target-network yangilash qadami | 70 | 48 |
| Muntazamlashtirish darajasi | Qo‘llanmaydi | EQLM: c=0; HR tajribalari: c=1 |
Tadqiqot Q-network va ELM asosidagi usullarda aynan bir xil tarmoq arxitekturasi yoki barcha bir xil giperparametrlardan foydalanmaydi. HR bilan EQLM taqqoslashida esa manba ayni muntazamlashtirish parametri saqlanganini va asosiy farq HR darajasi ekanini bildiradi.
Mashinali o‘rganish tajriba tuzilishi
Tasnifda IRIS va MNIST; regressiyada Individual Household Electric Power Consumption, Appliances Energy Prediction va ob-havo ma’lumotlari ishlatilgan.
MNIST tajribasida faqat 1.000 ta tasvir, ya’ni manba ifodasi bilan umumiy o‘quv ma’lumotining taxminan %1,7 qismi o‘qitish uchun ishlatilgan. Boshqa ma’lumot to‘plamlarida tadqiqot odatdagi 80/20 bo‘linishning teskarisi bo‘lgan %20 o‘qitish va %80 test bo‘linishidan foydalangan. Mualliflar bu tanlovlar modellarni ortiqcha moslashishga ko‘proq moyil qilib, cheklangan o‘quv ma’lumoti sharoitlarini taqlid qilish uchun qilinganini bildiradi.
Barcha mashinali o‘rganish tajribalarida yashirin tugunlar soni 1.000. FNN larda tasnif uchun bir, regressiya uchun ikki yashirin qatlam ishlatilgan. \(R=\bar{\mu}I\) uchun \(\bar{\mu}=1,0\); Dropout nisbati esa 0,5. Giperparametrlar ma’lumot to‘plamiga xos keng qamrovli optimallashtirish o‘rniga standart boshlang‘ich qiymatlar bilan tanlangani ochiq aytiladi.
Ishlash mezonlari
Tasnifda test aniqligi, regressiyada RMSE ishlatilgan. Cart-Pole tajribasida esa epizod mukofoti va o‘rganish egri chizig‘i ostidagi maydon (AUC) asosiy natija mezonlari. Cart-Pole grafiklarida 50 yugurishning epizod bo‘yicha o‘rtacha mukofoti va %95 ishonch oralig‘i soyali tasma bilan ko‘rsatiladi.
Hisoblash muhiti
Cart-Pole tarmoqlari Intel i7-12700 protsessori, 16 GB xotira va 12 GB RTX 3060 GPU ga ega ish stoli tizimida o‘qitilgan. Manbaga ko‘ra, o‘yinni ishga tushirishni ham hisobga olganda har bir tarmoqni o‘qitish bir soatdan ortiq davom etgan.
5–11-rasmlarning umumiy xabari
Q-network ning gradient-descent asosidagi yangilanishlarida yugurishlar o‘rtasida aniqroq tebranishlar kuzatiladi, EQLM esa barqarorroq o‘rtacha o‘rganish egri chizig‘ini ko‘rsatadi. HR ning vaqt qadami cheklanmagan tajribasida ayrim yugurishlar yuqoriroq mukofotga yetgan va o‘rtacha mukofotni oshirgan. Standart 200 qadamli tajribada HR o‘rganish egri chizig‘i Q-network ga nisbatan yuqoriroq va barqarorroq plato ko‘rsatadi.
10-rasm muntazamlashtirish parametri \(\bar{\mu}\) o‘zgartirilganda ishlash cheksiz ravishda monoton oshmasligini, ma’lum hududdan keyin taxminiy plato yuzaga kelishini ko‘rsatadi. 11-rasm esa exploration ehtimolini kamaytirish muddati o‘zgartirilganda o‘rganish tezligi sezilarli o‘zgarishi mumkinligini ko‘rsatadi. Bu natija ishlash faqat HR formulasiga emas, o‘rganish jarayonidagi exploration sozlamasiga ham bog‘liqligini bildiradi.
Takrorlanish imkoniyati va talqin chegaralari
Tadqiqot asosiy tajriba giperparametrlari va ma’lumot to‘plami manbalarini ochib beradi; biroq maqola ichida mustaqil kod/ma’lumot almashish repozitori ko‘rsatilmagan. Tasnif va regressiya jadvallaridagi yagona ishlash qiymatlari uchun yugurishlar soni, standart og‘ish yoki ishonch oralig‘i berilmagani sababli bu tajribalarda usulning variansini baholab bo‘lmaydi.
Mualliflarning xulosa bo‘limida ham HR ni chuqur ko‘p qatlamli tarmoqlar, convolutional tarmoqlar, attention tuzilmalari, recurrent tarmoqlar va transformer asosidagi modellarga to‘liq integratsiya qilish hali ochiq tadqiqot mavzusi ekani aytiladi. Katta masshtabli muammolarda hisoblash xarajati va sonli barqarorlik ham kelajakda o‘rganilishi lozim bo‘lgan yo‘nalishlar qatorida.
Manba va Usul Izohi
To‘liq original ish nomi: High-order regularization for explainable generalization in machine learning and learning-based control
Mualliflar va tartib: Xinghua Liu; Ming Cao.
Teng hissa/teng birinchi mualliflik: Manbada teng hissa yoki teng birinchi mualliflik bayonoti yo‘q.
Mas’ul/aloqa muallifi: Manba matnida alohida “corresponding author” belgisi ko‘rinmaydi. SSRN ning rasmiy bibliografik qaydi Xinghua Liu ni “Contact Author” sifatida ko‘rsatadi.
Muassasa: Engineering and Technology institute Groningen (ENTEG), University of Groningen, 9747 AG Groningen, the Netherlands.
Manba turi: Matematik usul ishlab chiqish, mashinali o‘rganish tajribalari va o‘rganishga asoslangan boshqaruv tajribasini o‘z ichiga olgan tadqiqot preprinti.
Peer-review holati: Ushbu ish peer-review dan o‘tmagan preprintdir; natijalar ushbu nashr bosqichi hisobga olinib baholanishi kerak.
Platforma: SSRN.
DOI: 10.2139/ssrn.6963250
SSRN nashr sanasi: 18 iyun 2026.
Manba matnidagi sana: “Preprint submitted to XXX June 6, 2026”. Bu yerda “XXX” manbada qoldirilgan joy tutuvchi bo‘lib, haqiqiy jurnal nomi sifatida talqin qilinmagan.
Rasmiy havola: https://ssrn.com/abstract=6963250
DOI havolasi: https://doi.org/10.2139/ssrn.6963250
Jurnal/jild/son/maqola raqami: Ko‘rib chiqilgan versiyada tasdiqlangan peer-review jurnal, jild, son yoki maqola raqami mavjud emas.
Nashriyot: Manba ishning peer-review nashriyoti aniqlanmagan; “XXX” nashriyot yoki jurnal nomi sifatida ishlatilmagan.
Litsenziya: Ko‘rib chiqilgan versiyada Creative Commons yoki unga teng ochiq qayta foydalanish litsenziyasi aniq ko‘rsatilmagan. Shu sababli original rasmlar ushbu Verianla HTML iga aynan ko‘chirib olinmagan.
Moliyalashtirish: Tadqiqot Netherlands Organization for Scientific Research doirasidagi NWO-Vici-19902 va China Scholarship Council tomonidan qisman qo‘llab-quvvatlangan.
Ma’lumot/kod mavjudligi: Manbada alohida ma’lumot yoki kod almashish bayonoti yo‘q. Tajribalarda ishlatilgan ochiq ma’lumot manbalari va OpenAI Gym havolalari adabiyotlar ro‘yxatida keltirilgan.
Manfaatlar to‘qnashuvi: Ko‘rib chiqilgan versiyada alohida manfaatlar to‘qnashuvi bayonoti aniqlanmagan.
CRediT hissalari: Xinghua Liu — Conceptualization, Writing – review & editing, Writing – original draft, Methodology, Validation, Formal analysis. Ming Cao — Writing – review & editing, Validation, Supervision, Funding acquisition.
Generativ sun’iy intellekt bayonoti: Mualliflar ChatGPT dan grammatika va yozuvni tekshirish hamda matn sifatini yaxshilash uchun foydalanganini, keyin mazmunni ko‘rib chiqib tahrir qilganini va ish mazmuni uchun javobgarlikni o‘z zimmasiga olishini bildiradi.
Manba ichidagi nomuvofiqlik 1: 3.7-bo‘lim Algorithm 2 ni taqdim etarkan, taklif etilgan HR uchun muntazamlashtirish darajasi \(c=1\) ekanini bildiradi va Algorithm 2 ning 8-qatori ham aniq \(c=1\) deb beradi. Biroq ayni bo‘limdagi bir jumla Algorithm 2 yangilash jarayonlarida \(c=0\) ni mahkamlab qo‘yishini aytadi. Bu ziddiyat jimlik bilan tuzatilmagan; tajriba jadvallari va algoritmning aniq satri HR ni \(c=1\) deb hisobot qiladi.
Manba ichidagi nomuvofiqlik 2: Asosiy hisoblash murakkabligi muhokamasining bir qismida muntazamlashtirish darajasi uchun \(k\) belgisi ishlatiladi, holbuki tadqiqotning matematik ta’rifi va Appendix D bo‘ylab muntazamlashtirish darajasi \(c\) bilan ko‘rsatiladi va qo‘shimcha murakkablik \(O(cn)\) ko‘rinishida ifodalanadi.
Asosiy ilmiy chegara: Tadqiqotning nazariy umumlashtirish tahlili asosan oxirgi yashirin qatlam akslantirishi va \(H^\top H\) axborot matritsasining shartlanganligiga qurilgan. Tajribaviy tasdiqlash Cart-Pole va tanlangan kichik/o‘rta masshtabli tasnif-regressiya vazifalari bilan cheklangan. Katta zamonaviy chuqur tarmoq arxitekturalarida ishlash, hisoblash xarajati va masshtablanish ushbu ish doirasida tasdiqlanmagan.
Ilmiy mazmun chegarasi: Ushbu Verianla maqolasidagi HR tenglamalari, teoremalar, algoritmlar, ma’lumot bo‘linishlari, giperparametrlar, tajriba natijalari, grafik talqinlari va cheklovlar faqat ko‘rib chiqilgan tadqiqotga asoslangan. Tashqi manbalar faqat bibliografik identifikatsiyani tekshirish uchun ishlatilgan, asosiy ilmiy matnga tashqaridan tajriba yoki yangi ishlash natijasi qo‘shilmagan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan