

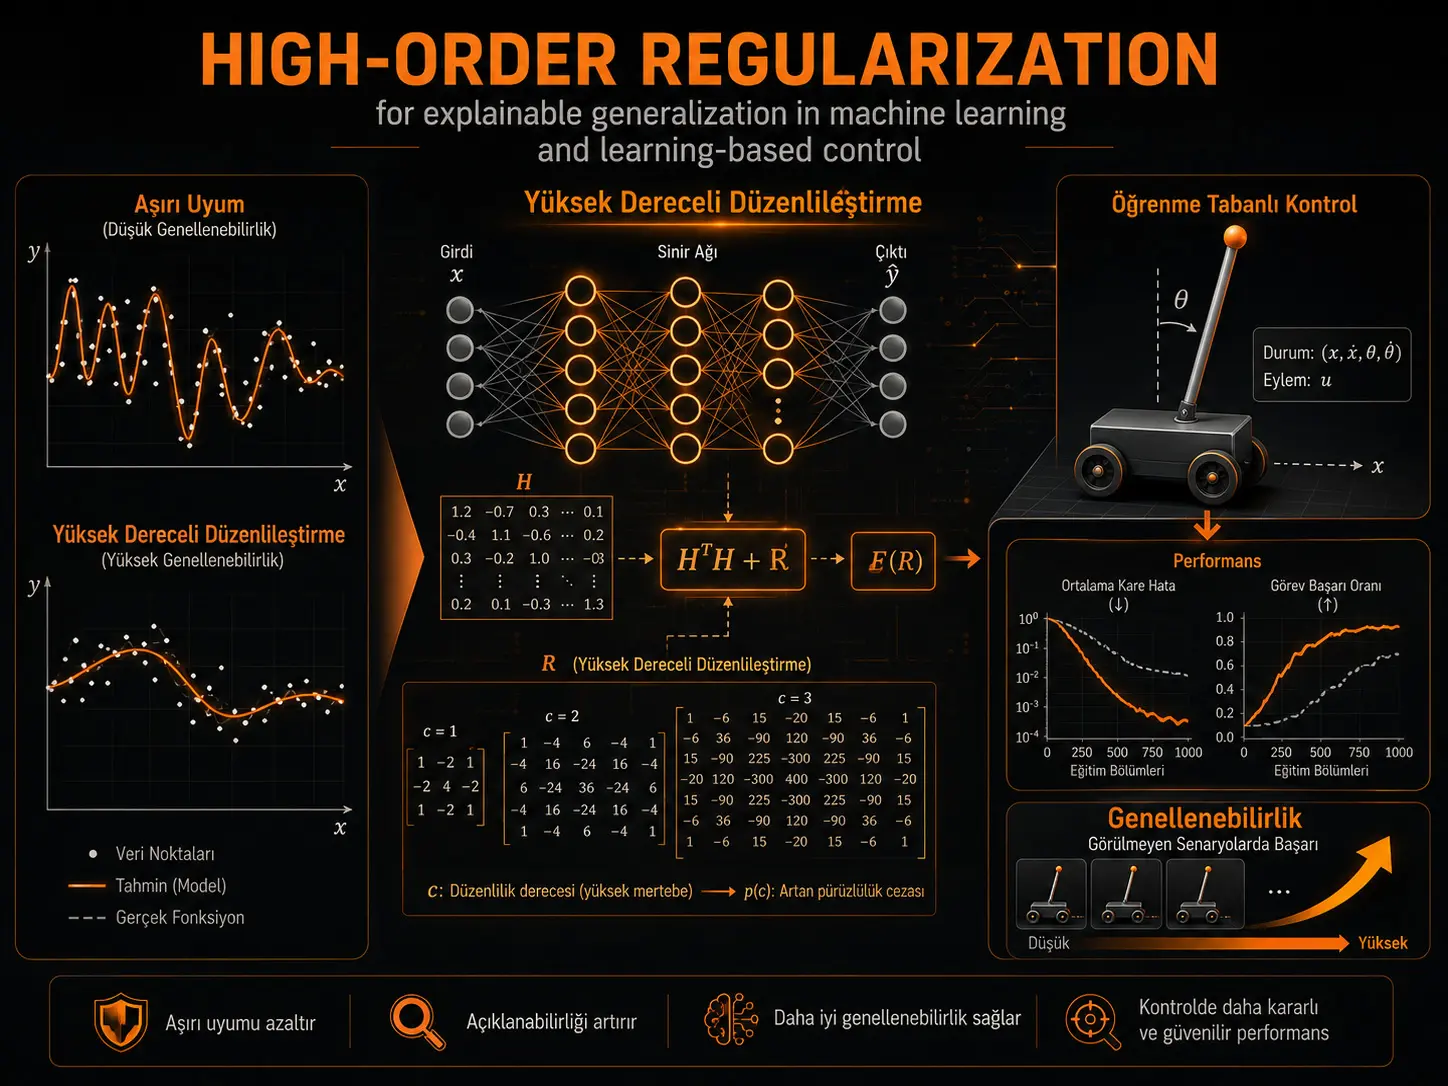
Бул изилдөө нейрон тармактарында ашыкча ылайыкташууну азайтуу менен катар, регуляризация эмне үчүн жана кандайча жалпылануу жөндөмүн өзгөртөрүн математикалык жактан түшүндүрүү максатында High-Order Regularization (HR) — Жогорку Даражадагы Регуляризация аттуу ыкманы сунуштайт. HR нейрон тармагынын акыркы жашыруун катмарынан чыгышка чейинки үйрөнүлүүчү салмактарды эсептөөнү тескери чагылдыруу маселеси катары карайт жана \(H^\top H\) маалымат матрицасынын тескерисин чектелген матрицалык даражалар катары менен жакындатат. Салттуу L2-норма регуляризациясы бул алкакта \(c=0\) болгон төмөн даражадагы өзгөчө учур катары чыгат, ал эми колдонмолордо көбүнчө \(c=1\) пайдаланылат. Теориялык бөлүк жакындашууну, эсептелүүчү төмөнкү жана жогорку ката чектерин жана регуляризация матрицасы аркылуу шарт санын башкарган жалпылануу критерийин чыгарат. Эксперименттерде HR Cart-Pole башкаруусунда, IRIS жана MNIST классификациясында жана үч регрессия маселесинде салыштырылган ыкмаларга караганда жогору сыйлык/тактык же төмөн RMSE көрсөткүчтөрүн берген. Бирок эксперименттер чектелген сандагы маселелерде жүргүзүлгөн, маалымат бөлүштүрүүлөрү атайын ашыкча ылайыкташууну күчөтө тургандай уюштурулган жана чоң заманбап терең тармак архитектураларында масштабдануу жөндөмү азырынча эксперименттик түрдө көрсөтүлгөн эмес.
Cart-Pole экспериментинде убакыт кадамынын чеги алынып салынган салыштырууда акыркы 50 эпизоддун орточо сыйлыгы Q-network үчүн 207,4, EQLM үчүн 208,2 жана сунушталган HR үчүн 273,4 деп берилген. Авторлор муну Q-networkко салыштырмалуу %31,8 жана EQLMге салыштырмалуу %31,3 жакшыртуу катары баяндашат. Бирок HR жыйынтыгында жүрүштөр аралык өзгөрмөлүүлүк жогору; ошол эле таблицада HR үчүн стандарттык четтөө 323,7 деп көрсөтүлгөн. Ошондуктан жогорку орточо көрсөткүч төмөн вариацияны билдирбейт.
Стандарттуу 200 убакыт кадамы чеги бар Cart-Pole экспериментинде HRдин акыркы 50 эпизод сыйлыгы 175,2 болсо, Q-network үчүн 123,8; AUC маанилери тиешелүүлүгүнө жараша \(87,5\times10^3\) жана \(71,0\times10^3\) деп берилген. Авторлор муну тиешелүүлүгүнө жараша %41,5 жана %23,2 өсүш катары баалашат. Бул көзөмөлдөнгөн экспериментте HR сыйлыктарынын бөлүштүрүлүшү чексиз убакыт кадамындагы экспериментке караганда тарыраак.
Машиналык үйрөнүү эксперименттеринде да ушундай тенденция байкалат. IRIS тест тактыгы HR менен %95,0; Dropout менен %94,2; L2-норма менен %93,3 жана регуляризациясыз FNN менен %87,5. MNISTте болгону 1.000 окутуу сүрөтү колдонулганда HR %84,1, Dropout %83,4, L2-норма %82,7 жана FNN %59,0 тактык берген. Бул салыштыруулар тандалган тесттерде HRдин артыкчылыгын көрсөтөт; бирок изилдөө бул таблица жыйынтыктары үчүн кайталанма эксперименттердин бөлүштүрүлүшүн, ишеним интервалын же ыкмалар аралык статистикалык маанилүүлүк тестин бербейт.
Түркия жагынан: HR ыкмасы Түркиядагы машиналык үйрөнүү, робототехника, адаптивдүү башкаруу, өнөр жай автоматташтыруусу же чектелген/бир жактуу окутуу маалыматтары менен иштеген чечим кабыл алуу системаларында изилдене турган математикалык ыкманы сунуштайт. Бирок изилдөөдөгү көрсөткүчтөрдү Түркиядагы кандайдыр бир реалдуу системага түздөн-түз көчүрүүгө болбойт. Жергиликтүү колдонуу үчүн тиешелүү маалымат бөлүштүрүүсү, тармак архитектурасы, эсептөөчү жабдык, реалдуу убакыт чектөөлөрү, коопсуздук талаптары жана учурдагы ыкмалар менен көз карандысыз benchmark салыштыруулары өзүнчө текшерилиши керек.
Изилдөөнүн негизги маселеси эмне?
Регуляризация нейрон тармагынын окутуу маалыматтарына ашыкча ылайыкташуусун алдын алуу жана мурда көрүлбөгөн маалыматтарда жакшыраак иштөөсүн камсыз кылуу үчүн кеңири колдонулат. L2, L1, dropout, mixup, эрте токтотуу жана ушул сыяктуу ыкмалардын практикалык ийгилиги жакшы белгилүү болсо да, изилдөө бутага алган боштук — регуляризация баштапкы чечимди математикалык жактан кантип өзгөртөөрүн, кандай бир жактуулукту жаратарын жана бул бир жактуулук менен жалпылануунун ортосундагы тең салмакты кантип эсептөөгө болорун ачык көрсөтүү.
1-сүрөт бул маселени регрессия жана классификация аркылуу көрсөтөт. Окутуу чекиттерине өтө ийилип ылайыкташкан татаал моделдер көк, татаалдыгы төмөн регуляризацияланган моделдер кара сызыктар менен көрсөтүлөт. Сүрөттүн негизги мааниси — окутуу үлгүлөрүн жакшыраак ээрчиген модель сөзсүз түрдө мурда көрүлбөгөн маалымат үчүн жакшы модель боло бербейт.
Талдоо эмне үчүн Extreme Learning Machine аркылуу курулган?
Изилдөө теорияны так чыгаруу үчүн Extreme Learning Machine (ELM) архитектурасын колдонот. ELM — бир жашыруун катмарлуу алдыга багытталган тармак; кириштен жашыруун катмарга кеткен салмактар жана мүмкүн болгон bias кокустук түрдө берилет, ал эми жашыруун катмардан чыгышка кеткен \(\beta\) салмактары гана аналитикалык түрдө эсептелет.
2-сүрөттө кириш түйүндөрү жашыруун түйүндөргө, жашыруун түйүндөр чыгыштарга туташкан ELM архитектурасы көрсөтүлөт. Бир \(x_j\) кириш үлгүсү үчүн тармактын чыгышы:
\[ \sum_{i=1}^{L}\beta_i g_i(x_j) = \sum_{i=1}^{L}\beta_i g_i(w_i\cdot x_j+b_i) = o_j \]
түрүндө берилет. Бул жерде \(L\) жашыруун түйүндөрдүн санын, \(w_i\) кокустук кириш салмактарын, \(b_i\) biasты, \(g_i\) активдештирүү функциясын жана \(\beta_i\) үйрөнүлүүчү чыгыш салмагын билдирет.
Негизги окутуу маселеси:
\[ \min_{\beta\in\mathbb{R}^{L\times k}} \left\|H\beta-Y\right\|^2 \]
түрүндө жазылат. \(H\) жашыруун катмардын чыгыш матрицасы, \(Y\) болсо окутуу белгиси. Регуляризациясыз эң кичине нормалуу эң кичине квадраттар чечими Moore–Penrose псевдотескери менен:
\[ \hat{\beta}=H^\dagger Y \]
түрүндө алынат.
L2 регуляризациясы бул түзүлүштө кантип көрүнөт?
Булакта классикалык L2 регуляризацияланган чечим:
\[ \hat{\beta} = \left( H^\top H+\frac{I}{\mu} \right)^\dagger H^\top Y \]
түрүндө берилет. Бул операция начар шартталган \(H^\top H\) матрицасын сандык жактан туруктуураак кылышы мүмкүн; бирок регуляризация ошол эле учурда теориялык оптималдуу чечимге салыштырмалуу баалоо бир жактуулугун пайда кылат. HR ыкмасы бул бир жактуулукту түздөн-түз жакындатылган тескери чагылдыруу катасы катары аныктоого аракет кылат.
Жогорку Даражадагы Регуляризация кантип чыгарылат?
HRдин баштапкы чекити:
\[ F(R) := R\left(H^\top H+R\right)^{-1} \]
аныктамасы. Бул жерде \(R\) тандалуучу регуляризация матрицасы. Ылайыктуу спектралдык радиус шарты астында:
\[ (I-F(R))^{-1} = \sum_{i=0}^{\infty}F^i(R), \qquad \rho(F(R))<1 \]
матрицалык даражалар катарын колдонууга болот. Чексиз катар \(c+1\) мүчөдөн кийин кесилгенде сунушталган HR чечими алынат:
\[ \hat{\beta}_{hr} = \left(H^\top H+R\right)^{-1} \sum_{i=0}^{c} F^i(R)H^\top Y, \qquad \rho(F(R))<1 \]
\(c\) — регуляризация даражасы. \(c=0\) жана \(R=\bar{\mu}I\) тандалганда чечим салттуу L2-норма регуляризациясынын формасына түшөт. \(c\geq1\) болгондо тескери чагылдыруу бир нече матрицалык катар мүчөлөрү менен жакындатылгандыктан, изилдөө муну “high-order” регуляризация деп атайт.
L2 эмне үчүн HRдин өзгөчө учуру болуп саналат?
HRде \(c=0\) тандалганда катар бир гана бирдик матрица мүчөсүн камтыйт:
\[ \sum_{i=0}^{0}F^i(R)=I \]
жана:
\[ \hat{\beta}_{hr} = (H^\top H+R)^{-1}H^\top Y \]
алынат. \(R=\bar{\mu}I\) тандоосу классикалык L2/Tikhonov тибиндеги чечимди берет. Appendix A акыркы жашыруун катмарга колдонулган dropoutтун күтүлгөн жоготуусу:
\[ L(\beta)= \frac{1}{2N}\|y-H\beta\|_2^2+ \frac{1-p}{2pN} \beta^\top \operatorname{diag}(H^\top H) \beta \]
түрүндө норма регуляризациясына айландырылышы мүмкүн экенин көрсөтөт. Бул өзгөчө dropout чыгарылышында регуляризация коэффициенти \((1-p)/p\), dropout ызы-чуусунун дисперсиясы менен байланышат.
HR чечиминин жакындашуусу кантип түшүндүрүлөт?
Изилдөөдө HR катасы:
\[ e_\beta=\hat{\beta}_{hr}-\beta_{opt} \]
деп аныкталат. Теорема 1 көрсөтүлгөн оң аныкталгандык жана спектралдык радиус шарттары астында регуляризация матрицасы нөлгө жакындаганда же регуляризация даражасы чексиздикке кеткенде HR чечиминин катасы нөлгө жакындай турганын көрсөтөт:
\[ \lim_{R\rightarrow O}\|e_\beta\|=0, \qquad \lim_{c\rightarrow+\infty}\|e_\beta\|=0 \]
Бул жыйынтык HR катарын кесүү катасын регуляризация матрицасы жана катар даражасы менен түздөн-түз байланыштырууга мүмкүндүк берет.
Ката эмне үчүн эсептелүүчү деп кабыл алынат?
Тескери матрицаны жакындатуу катасы:
\[ F_{ar}(R) = (H^\top H)^{-1} - (H^\top H+R)^{-1} \sum_{i=0}^{c}F^i(R) \]
деп аныкталат. Ылайыктуу шарттарда:
\[ F_{ar}(R) = (H^\top H)^{-1}F^{c+1}(R) \]
алынат. Андан кийин изилдөө HR чечиминин катасы үчүн төмөнкү жана жогорку чектерди чыгарат:
\[ \frac{1}{1-\lambda_{\min}(F(R))} \left\| (H^\top H+R)^{-1} F^{c+1}(R)H^\top Y \right\| \leq \|e_\beta\| \]
жана:
\[ \|e_\beta\| \leq \frac{1}{1-\lambda_{\max}(F(R))} \left\| (H^\top H+R)^{-1} F^{c+1}(R)H^\top Y \right\| \]
түрүндө. Ошентип, регуляризациядан улам теориялык чечимге салыштырмалуу пайда болгон айырма жөн гана интуитивдик жаза мүчөсү эмес, тандалган \(R\) жана \(c\) астында чектелүүчү жакындатылган тескери алуу катасы катары түшүндүрүлөт.
Регуляризация эмне үчүн кыскартуу операциясы катары чечмеленет?
Теорема 2де ылайыктуу симметриялуу оң жарым аныкталган \(R\) жана оң аныкталган \(H^\top H\) шарттары астында регуляризация матрицасы \(F_{ar}(R)\) жакындатуу катасынын нормасында кыскаруу пайда кылары көрсөтүлөт. Кыскаруу катышын \(R\) да, регуляризация даражасы \(c\) да аныктайт.
Бул көз карашта төмөн даража теориялык оптимум менен регуляризацияланган чечимдин ортосунда чоңураак аралык жаратышы мүмкүн; көбүрөөк катар мүчөлөрү тескери чагылдыруу жакындатуусун жакшыртат. Мунун ордуна регуляризациянын начар шартталгандыкты азайтуу таасири менен баалоо бир жактуулугунун ортосунда тең салмак түзүлүшү керек.
“Максималдуу жалпылануу” эмнени билдирет?
Изилдөө жалпыланууну бардык мүмкүн болгон тест бөлүштүрүүлөрүндө түз өлчөөнүн ордуна \(H^\top H+R\) матрицасынын шарт саны аркылуу мүнөздөйт:
\[ \operatorname{Cond}(R) = \|H^\top H+R\| \, \|(H^\top H+R)^{-1}\| \]
Шарт санынын азайышы окутуу маалыматындагы кичине өзгөрүүлөрдүн салмак чечиминде өтө чоң өзгөрүүлөргө айланышын азайткан жакшыраак шартталган маселени билдирет. Изилдөөнүн тең салмак критерийи:
\[ \operatorname{Obj}(R) = \|F_{ar}(R)\| \operatorname{Cond}(R) \]
деп аныкталат. Бул максат функциясы баалоо бир жактуулугун жана начар шартталгандыкты бирге эсепке алат.
Сунуш 2де \(H^\top H\) матрицасынын өздүк маанилери \(\lambda_i\) болгондо:
\[ \lambda_{R,i} = \max\{\bar{\mu}-\lambda_i,0\} \]
түрүндө түзүлгөн регуляризация матрицасы каралат. Изилдөөнүн математикалык жалпылануу критерийинде \(\bar{\mu}=\lambda_1\) айланасында шарт санын 1ге чейин түшүрүүгө болот. Бул “максималдуу жалпылануу” түшүнүгү изилдөөнүн шарт-санына негизделген теориялык аныктамасынын ичинде гана колдонулат; бардык реалдуу дүйнө бөлүштүрүүлөрүндө универсалдуу максималдуу көрсөткүч кепилдиги катары чечмеленбеши керек.
4-сүрөт регуляризацияны кантип түшүндүрөт?
4-сүрөт теориялык түшүндүрмөнүн визуалдык жыйынтыгы. Эң чоң тегерек берилген окутуу маалыматтары жана \(H^\top H\) маалымат матрицасы үчүн баштапкы тармактын мүмкүн болгон чечимдерин, борбор болсо теориялык оптималдуу чечимди көрсөтөт. Кичине тегеректер ар түрдүү \(R\) матрицалары астында алынган регуляризацияланган чечимдерди көрсөтөт. Үзүк тегеректин радиусу белгилүү \(c\) үчүн баалоо бир жактуулугун билдирет.
Сүрөттүн негизги маңызы — күчтүүрөөк регуляризация автоматтык түрдө жакшыраак дегенди билдирбейт. Максат — чечимди туруктуу кылып, аны теориялык оптимумдан керексиз деңгээлде алыстатпаган \(R\) жана \(c\) комбинациясын табуу.
Сингулярдуу же чоң чагылдырууларда HR кантип кеңейтилет?
Тармак масштабы чоңойгондо \(H^\top H\) сингулярдуу болушу мүмкүн. Изилдөө мындай учурда Moore–Penrose псевдотескерисин колдонуп жалпы тескери чагылдыруу ыкмасын кеңейтет. Ыкма:
\[ F_{aim}(H,R,c) = (H^\top H+R)^{-1} \sum_{i=0}^{c}F^i(R) \]
менен аныкталат жана:
\[ F_{ar}(R) = (H^\top H)^\dagger-F_{aim}(H,R,c) \]
эми жалпы тескери алуунун жакындатуу катасын билдирет. Теорема 3тө:
\[ \lim_{c\rightarrow+\infty}F_{ar}(R) = (H^\top H)^\dagger-R^{-1} \]
жыйынтыгы берилет. Булактын түшүндүрмөсү боюнча, ылайыктуу \(R\) тандоо сингулярдуу чагылдырууларда да жакындатылган тескери алуу катасын жана шартталгандыкты бирге башкарууга мүмкүндүк берет.
Инкременттик HR кантип иштейт?
Incremental High-Order Regularization (IHR) жаңы mini-batch маалымат келгенде бүт тармакты башынан окутуунун ордуна учурдагы маалымат матрицасын жана салмактарды жаңыртат. Негизги жаңыртуу:
\[ \hat{\beta}_{t+1} = K_{t+1}(c)\hat{\beta}_t + F_{aim,t+1}H_{ic}^{\top}Y_{ic} \]
түрүндө. Бул жерде жаңы \(H_{ic},Y_{ic}\) mini-batch учурдагы моделге кошулат. Изилдөө айрыкча үйрөнүүгө негизделген башкарууда окутуунун алгачкы мезгилиндеги сапаты төмөн жана чектелген маалыматтар пайда кылышы мүмкүн болгон ашыкча ылайыкташууну убакыт өтүшү менен азайтуу контекстинде бул инкременттик түзүлүштү талкуулайт.
HRдин “үйрөнүү, эс тутум жана унутуу” түшүндүрмөсү эмне?
Авторлор регуляризациянын окутуунун башында жетишсиз же бир жактуу маалыматтын таасирин басаңдатышын адаптивдүү унутуунун бир түрү катары чечмелешет. Окутуу илгерилеп, маалымат сапаты жана маалымат көлөмү көбөйгөндө регуляризациянын таасири өзгөрүшү мүмкүн экени системанын жаңы маалыматты үйрөнүүсү менен эски маалыматка берген салмагынын ортосундагы мамилени түшүндүрүү үчүн колдонулат.
Бул сөз айкашы нейробиологиялык эс тутум механизминин далили эмес; бул изилдөөнүн математикалык регуляризация жүрүм-турумуна берген үйрөнүүгө негизделген башкаруу түшүндүрмөсү.
Cart-Pole экспериментинде эмне табылды?
OpenAI Gym Cart-Pole маселеси Q-network, EQLM жана HR-EQLM ыкмаларын салыштыруу үчүн колдонулган. Убакыт кадамынын чеги алынып салынган эксперименттерде 50 жүрүш боюнча акыркы 50 эпизоддун орточо сыйлыктары:
| Ыкма | Акыркы 50 эпизоддун орточо сыйлыгы | AUC (×10³) |
|---|---|---|
| Q-network | 207,4 (176,2–236,3) | 107,8 (103,8–111,8) |
| EQLM | 208,2 (188,51–224,98) | 97,2 (90,3–103,3) |
| Сунушталган HR | 273,4 (166,1–340,3) | 116,3 (86,1–136,8) |
HR орточо сыйлыкта эң жогорку маанини берген. Бирок ошол эле 4-таблицада стандарттык четтөө Q-network үчүн 108,7, EQLM үчүн 66,2 жана HR үчүн 323,7 деп берилген. HRдин жогорку орточосу айрым жүрүштөрдө 200 убакыт кадамынан кыйла жогору алынган чоң сыйлыктардан таасирленген; ошондуктан орточо өсүш менен бирге жүрүштөр аралык өзгөрмөлүүлүк да эске алынышы керек.
200 убакыт кадамдуу экспериментте жыйынтык кантип өзгөрөт?
Стандарттуу 200 убакыт кадамы чеги колдонулганда салыштыруу тарыраак көрсөткүч диапазонунда жүргүзүлгөн:
| Ыкма | Акыркы 50 эпизоддун орточо сыйлыгы | AUC (×10³) |
|---|---|---|
| Q-network | 123,8 (112,4–135,5) | 71,0 (68,8–73,5) |
| Сунушталган HR | 175,2 (169,6–180,9) | 87,5 (84,7–90,5) |
Булак HR акыркы 50 эпизод сыйлыгында %41,5 жана AUCда %23,2 жакшыртуу бергенин билдирет. HR сыйлыктарынын стандарттык четтөөсү 20,3, Q-networkтики 41,9.
IRIS жана MNIST жыйынтыктары эмнени көрсөтөт?
Классификация эксперименттеринде FNN, Dropout, L2-норма жана \(c=1\) HR салыштырылган:
Verianla Live: Регуляризация ыкмаларынын классификация тактыгы
Салыштыруу изилдөөнүн 6-таблицасында берилген тест тактыктарын көрсөтөт. MNIST эксперименти болгону 1.000 окутуу сүрөтү менен жүргүзүлгөн; ошондуктан маанилер толук MNIST окутуу топтому менен алынган стандарттуу benchmark маанилери катары чечмеленбеши керек.
| Маалымат топтому | FNN | Dropout | L2-норма (c=0) | Сунушталган HR (c=1) | Бирдик | Булак |
|---|---|---|---|---|---|---|
| IRIS | 87,5 | 94,2 | 93,3 | 95,0 | Тест тактыгы (%) | 6-таблица |
| MNIST | 59,0 | 83,4 | 82,7 | 84,1 | Тест тактыгы (%) | 6-таблица |
HR эки маалымат топтомунда тең эң жогорку тест тактыгын берген. Бирок IRISте HR менен Dropoutтун айырмасы 0,8 пайыздык пункт, MNISTте 0,7 пайыздык пункт. Изилдөө бул айырмалар үчүн статистикалык маанилүүлүк тестин же кайталанма жүрүштөрдүн ишеним интервалын бербегендиктен, кичине айырмаларды жалпылануучу артыкчылык катары чечмелөө туура эмес.
Регрессия эксперименттеринде эмне табылды?
Регрессия тапшырмаларында төмөн Root Mean Squared Error (RMSE) жакшыраак көрсөткүчтү билдирет:
| Маалымат топтому | FNN RMSE | Dropout RMSE | L2-норма RMSE | HR (c=1) RMSE |
|---|---|---|---|---|
| Weather prediction | 4,2274 | 2,1575 | 2,7061 | 2,0888 |
| Power consumption | 0,7488 | 0,7140 | 0,7474 | 0,7096 |
| Appliances energy | 87,7197 | 79,0572 | 79,4058 | 77,3815 |
HR изилдөөдөгү үч регрессия тестинин баарында эң төмөн RMSE берген. Weather predictionда Dropout менен HRдин айырмасы салыштырмалуу аз, регуляризациясыз FNNдин катасы болсо жогору.
12 жана 13-сүрөттөр эмнени көрсөтөт?
Appliances Energy экспериментинин 12-сүрөтү убакыт боюнча FNN, L2, HR жана Dropout үчүн божомол минус реалдуу маани катасын көрсөтөт. 13-сүрөт ошол каталардын бөлүштүрүлүшүн салыштырат. Регуляризацияланган моделдердин ката бөлүштүрүүлөрү нөлдүн айланасында окшош түрдө топтолот.
Регрессия моделдеринде регуляризациядан келип чыккан бир жактуулукту азайтуу үчүн окутуу маалыматынан бөлүнгөн текшерүү маалыматтары аркылуу бир жактуулукту оңдоо колдонулган. Ошондуктан таблицадагы регрессия жыйынтыктары чийки регуляризацияланган чечимдин гана эмес, изилдөөдө аныкталган текшерүүгө негизделген оңдоо процессинин да таасирин камтыйт.
Изилдөө колдогон жыйынтыктар
- HR матрицалык даражалар катарынан кесилген жакындатылган тескери алуу формасы катары ачык формулаланган.
- L2-норма регуляризациясы HR алкагында \(c=0\) өзгөчө учуру катары берилет.
- Көрсөтүлгөн матрицалык шарттар астында HR чечиминин жакындашуусу жана эсептелүүчү ката чектери теориялык түрдө чыгарылган.
- Регуляризация матрицасы жана даражасы жакындатылган тескери алуу катасынын кыскаруу ылдамдыгын башкарат.
- Изилдөөнүн шарт-санына негизделген аныктамасында \(R\) матрицасынын өздүк маанилеринин түзүлүшү жалпылануу критерийин оптималдаштыруу үчүн долбоорлонушу мүмкүн.
- Тандалган Cart-Pole, классификация жана регрессия эксперименттеринде \(c=1\) HR билдирилген негизги көрсөткүчтөрдө салыштырылган ыкмалардан жогору жыйынтык берген.
Изилдөө далилдебеген же али сынабаган жыйынтыктар
- HR бардык машиналык үйрөнүү тапшырмаларында L2, Dropout же башка регуляризация ыкмаларынан артык экени көрсөтүлгөн эмес.
- Шарт санынын минимум болушу бардык реалдуу маалымат бөлүштүрүүлөрүндө максималдуу тест көрсөткүчүн кепилдебейт.
- HRдин чоң CNN, RNN же transformer архитектураларында масштабдануусу эксперименттик түрдө ырасталган эмес.
- Cart-Pole жыйынтыктары реалдуу роботто же коопсуздук-критикалык башкаруу системасында талаа текшерүүсү эмес.
- IRIS, MNIST жана регрессия таблицаларындагы кичине айырмалар үчүн статистикалык артыкчылык тести берилген эмес.
- MNIST жыйынтыгы толук стандарттуу окутуу топтому менен алынган benchmark эмес; болгону 1.000 окутуу сүрөтү колдонулган.
- Булакта берилген “түшүндүрмөлүүлүк” SHAP же өзгөчөлүк атрибуциясы сыяктуу үлгү-негизиндеги түшүндүрмө түзүүдөн көрө регуляризациянын математикалык таасирин түшүндүрүүгө багытталган.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Теориялык ыкма
Изилдөөнүн теориялык бөлүгү нейрон тармагынын акыркы жашыруун катмар чыгышын \(H\) чагылдыруу матрицасы менен көрсөтүп, үйрөнүлүүчү чыгыш салмактарын \(\beta\) аркылуу талдайт. HR \(H^\top H\) же анын Moore–Penrose жалпы тескерисин түз колдонбой, регуляризацияланган матрицадан жана кесилген даражалар катарынан жакындатылган тескери түзөт.
| Компонент | Булакта колдонулган туюнтма | Функциясы |
|---|---|---|
| Маалымат/чагылдыруу матрицасы | \(H^\top H\) | Окутуу маалыматынан келген чагылдыруу маалыматын көрсөтөт. |
| Регуляризация матрицасы | \(R\) | Шартталгандык менен баалоо бир жактуулугунун ортосундагы тең салмакты өзгөртөт. |
| Катар матрицасы | \(F(R)=R(H^\top H+R)^{-1}\) | Жакындатылган тескери алуу даражалар катарын түзөт. |
| Регуляризация даражасы | \(c\) | Катарда сактала турган жогорку даражадагы мүчөлөрдүн санын аныктайт. |
| Жакындатылган тескери | \(F_{aim}(H,R,c)\) | Жалпы тескери чагылдыруунун HR жакындатуусу. |
| Жакындатуу калдыгы | \(F_{ar}(R)\) | Теориялык тескери менен HR жакындатылган тескеринин айырмасы. |
Cart-Pole эксперименттик түзүлүшү
| Эксперимент өзгөчөлүгү | Булакта берилген маани |
|---|---|
| Аракет мейкиндиги | Сол, оң |
| Абал өзгөрмөлөрү | Арабанын орду, арабанын ылдамдыгы, таяктын бурчу, таяктын бурчтук ылдамдыгы |
| Таяк бурчунун чеги | (−12°, 12°) чегинен чыкканда токтотуу |
| Арабанын орду чеги | (−2,4, 2,4) чегинен чыкканда токтотуу |
| Стандарттуу максималдуу убакыт кадамы | 200 |
| Сыйлык | Ар бир кадам +1 |
| Баштапкы абал | (−0,05, 0,05) аралыгында кокустук |
| Жалпы жүрүш | 50 |
Тармак гиперпараметрлери
| Гиперпараметр | Q-network | ELM / EQLM-HR түзүлүшү |
|---|---|---|
| Үйрөнүү ылдамдыгы | 0,0065 | Колдонулбайт |
| Регуляризация параметри | Колдонулбайт | 1,827×10−5 |
| Жашыруун түйүн | 29 | 25 |
| Баштапкы exploration ыктымалдыгы | 0,670 | 0,599 |
| Exploration азайтуу мөөнөтү | 400 эпизод | 360 эпизод |
| Дисконт коэффициенти | 0,99 | 0,93 |
| Mini-batch | 26 | 2 |
| Target-network жаңыртуу кадамы | 70 | 48 |
| Регуляризация даражасы | Колдонулбайт | EQLM: c=0; HR эксперименттери: c=1 |
Изилдөө Q-network жана ELM негизиндеги ыкмаларда бирдей тармак архитектурасын же бардык бирдей гиперпараметрлерди колдонбойт. HR менен EQLM салыштыруусунда булак бир эле регуляризация параметри сакталганын жана негизги айырма HR даражасы экенин билдирет.
Машиналык үйрөнүү эксперименттик түзүлүшү
Классификацияда IRIS жана MNIST; регрессияда Individual Household Electric Power Consumption, Appliances Energy Prediction жана аба ырайы маалыматтары колдонулган.
MNIST экспериментинде болгону 1.000 сүрөт, башкача айтканда булактын маалыматы боюнча жалпы окутуу маалыматтарынын болжол менен %1,7 бөлүгү окутуу үчүн колдонулган. Башка маалымат топтомдорунда изилдөө кадимки 80/20 бөлүүнүн тескериси болгон %20 окутуу жана %80 тест бөлүүнү пайдаланган. Авторлор бул тандоолор моделдерди ашыкча ылайыкташууга көбүрөөк жакын кылып, чектелген окутуу маалыматтарынын шарттарын окшоштуруу үчүн жасалганын билдиришет.
Бардык машиналык үйрөнүү эксперименттеринде жашыруун түйүндөрдүн саны 1.000. FNNдерде классификация үчүн бир, регрессия үчүн эки жашыруун катмар колдонулган. \(R=\bar{\mu}I\) үчүн \(\bar{\mu}=1,0\); Dropout катышы 0,5. Гиперпараметрлер маалымат топтомуна атайын кеңири оптималдаштыруунун ордуна стандарттуу баштапкы маанилер менен тандалганы ачык айтылат.
Көрсөткүчтөр
Классификацияда тест тактыгы, регрессияда RMSE колдонулган. Cart-Pole экспериментинде эпизод сыйлыгы жана үйрөнүү ийри сызыгынын алдындагы аянт (AUC) негизги жыйынтык көрсөткүчтөрү. Cart-Pole графиктеринде 50 жүрүштүн эпизод боюнча орточо сыйлыгы жана %95 ишеним интервалы көлөкөлөнгөн тилке менен көрсөтүлөт.
Эсептөө чөйрөсү
Cart-Pole тармактары Intel i7-12700 процессору, 16 GB эс тутум жана 12 GB RTX 3060 GPU бар үстөлдүк системада үйрөтүлгөн. Булак оюнду иштетүүнү кошкондо ар бир тармакты окутуу бир сааттан узакка созулганын билдирет.
5–11-сүрөттөрдүн жалпы мааниси
Q-networkтун gradient-descent негизиндеги жаңыртууларында жүрүштөр арасында көбүрөөк термелүүлөр байкалат, EQLM болсо туруктуураак орточо үйрөнүү ийри сызыгын көрсөтөт. HRдин убакыт кадамы чектелбеген экспериментинде айрым жүрүштөр жогору сыйлыкка жетип, орточо сыйлыкты көтөргөн. Стандарттуу 200 кадамдуу экспериментте HR үйрөнүү ийри сызыгы Q-networkко салыштырмалуу жогору жана туруктуураак плато көрсөтөт.
10-сүрөт регуляризация параметри \(\bar{\mu}\) өзгөргөндө көрсөткүч чексиз монотондуу өсө бербей турганын, белгилүү аймактан кийин болжолдуу плато пайда болорун көрсөтөт. 11-сүрөт exploration ыктымалдыгын азайтуу мөөнөтү өзгөргөндө үйрөнүү ылдамдыгы олуттуу өзгөрүшү мүмкүн экенин көрсөтөт. Бул жыйынтык көрсөткүч HR формуласына гана эмес, үйрөнүү процессиндеги exploration жөндөөлөрүнө да көз каранды экенин айгинелейт.
Кайра өндүрүлүүчүлүк жана түшүндүрмө чектери
Изилдөө негизги эксперимент гиперпараметрлерин жана маалымат топтомдорунун булактарын түшүндүрөт; бирок макала ичинде өзүнчө код/маалымат бөлүшүү репозиторийи көрсөтүлбөйт. Классификация жана регрессия таблицаларындагы жалгыз көрсөткүч маанилери үчүн жүрүштөрдүн саны, стандарттык четтөө же ишеним интервалы берилбегендиктен, бул эксперименттерде ыкманын вариациясын баалоо мүмкүн эмес.
Авторлордун жыйынтык бөлүмүндө да HRди терең көп катмарлуу тармактарга, convolutional тармактарга, attention түзүлүштөрүнө, recurrent тармактарга жана transformer негизиндеги моделдерге толук интеграциялоо азырынча ачык изилдөө маселеси экени айтылат. Чоң масштабдуу маселелерде эсептөө баасы жана сандык туруктуулук да келечекте изилденүүгө тийиш багыттардын катарына кирет.
Булак жана Ыкма Эскертмеси
Толук оригиналдуу иш аталышы: High-order regularization for explainable generalization in machine learning and learning-based control
Авторлор жана ирети: Xinghua Liu; Ming Cao.
Тең салым/тең биринчи авторлук: Булакта тең салым же тең биринчи авторлук жөнүндө билдирүү жок.
Жооптуу/байланыш автору: Булак текстинде өзүнчө “corresponding author” белгиси көрүнбөйт. SSRNдин расмий библиографиялык жазуусу Xinghua Liuну “Contact Author” катары көрсөтөт.
Мекеме: Engineering and Technology institute Groningen (ENTEG), University of Groningen, 9747 AG Groningen, the Netherlands.
Булак түрү: Математикалык ыкма иштеп чыгуу, машиналык үйрөнүү эксперименттери жана үйрөнүүгө негизделген башкаруу экспериментин камтыган изилдөө препринти.
Рецензия статусу: Бул иш рецензиядан өтпөгөн препринт; жыйынтыктар ушул жарыя баскычы эске алынып бааланууга тийиш.
Платформа: SSRN.
DOI: 10.2139/ssrn.6963250
SSRN жарыяланган датасы: 18-июнь 2026.
Булак текстиндеги дата: “Preprint submitted to XXX June 6, 2026”. Бул жердеги “XXX” булакта калтырылган орун толтургуч болуп, реалдуу журнал аталышы катары чечмеленген эмес.
Расмий шилтеме: https://ssrn.com/abstract=6963250
DOI шилтемеси: https://doi.org/10.2139/ssrn.6963250
Журнал/том/сан/макала номери: Каралган версияда тастыкталган рецензияланган журнал, том, сан же макала номери жок.
Басмакана: Булак иштин рецензияланган жарыя басмаканасы аныкталган эмес; “XXX” басмакана же журнал аталышы катары колдонулган эмес.
Лицензия: Каралган версияда Creative Commons же ага тең ачык кайра колдонуу лицензиясы ачык көрсөтүлгөн эмес. Ошондуктан оригиналдуу сүрөттөр бул Verianla HTMLине түз көчүрүлгөн эмес.
Каржылоо: Изилдөө Netherlands Organization for Scientific Research алкагындагы NWO-Vici-19902 жана China Scholarship Council тарабынан жарым-жартылай колдоого алынган.
Маалымат/код жеткиликтүүлүгү: Булакта өзүнчө маалымат же код бөлүшүү билдирүүсү жок. Эксперименттерде колдонулган ачык маалымат булактары жана OpenAI Gym шилтемелери адабият тизмесинде көрсөтүлгөн.
Кызыкчылыктар кагылышы: Каралган версияда өзүнчө кызыкчылыктар кагылышы боюнча билдирүү аныкталган эмес.
CRediT салымдары: Xinghua Liu — Conceptualization, Writing – review & editing, Writing – original draft, Methodology, Validation, Formal analysis. Ming Cao — Writing – review & editing, Validation, Supervision, Funding acquisition.
Генеративдүү жасалма интеллект боюнча билдирүү: Авторлор ChatGPTни грамматика жана жазууну текшерүү, ошондой эле текст сапатын жакшыртуу үчүн колдонгонун, кийин мазмунду карап чыгып түзөткөнүн жана иштин мазмуну үчүн жоопкерчиликти өзүнө аларын билдиришет.
Булак ичиндеги дал келбестик 1: 3.7-бөлүм Algorithm 2ни тааныштырганда сунушталган HR үчүн регуляризация даражасы \(c=1\) экенин айтат жана Algorithm 2нин 8-сапы да ачык \(c=1\) деп берет. Бирок ошол эле бөлүмдөгү бир сүйлөм Algorithm 2нин жаңыртуу процесстеринде \(c=0\) туруктуу деп белгилегенин айтат. Бул карама-каршылык үнсүз оңдолгон эмес; эксперимент таблицалары жана алгоритмдин ачык сабы HRди \(c=1\) деп берет.
Булак ичиндеги дал келбестик 2: Негизги эсептөө татаалдыгы талкуусунун бир бөлүгүндө регуляризация даражасы үчүн \(k\) белгиси колдонулат, ал эми изилдөөнүн математикалык аныктамасында жана Appendix D боюнча регуляризация даражасы \(c\) менен көрсөтүлөт жана кошумча татаалдык \(O(cn)\) түрүндө берилет.
Негизги илимий чек: Изилдөөнүн теориялык жалпылануу талдоосу негизинен акыркы жашыруун катмар чагылдыруусуна жана \(H^\top H\) маалымат матрицасынын шартталгандыгына негизделген. Эксперименттик текшерүү Cart-Pole жана тандалган төмөн/орто масштабдуу классификация-регрессия тапшырмалары менен чектелген. Чоң заманбап терең тармак архитектураларында көрсөткүч, эсептөө баасы жана масштабдануу бул иштин ичинде текшерилген эмес.
Илимий мазмун чеги: Бул Verianla макаласындагы HR теңдемелери, теоремалар, алгоритмдер, маалымат бөлүнүштөрү, гиперпараметрлер, эксперимент жыйынтыктары, график түшүндүрмөлөрү жана чектөөлөр каралган изилдөөгө гана негизделет. Тышкы булактар библиографиялык иденттүүлүктү текшерүү үчүн гана колдонулган, негизги илимий текстке тыштан эксперимент же жаңы көрсөткүч жыйынтыгы кошулган эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген