

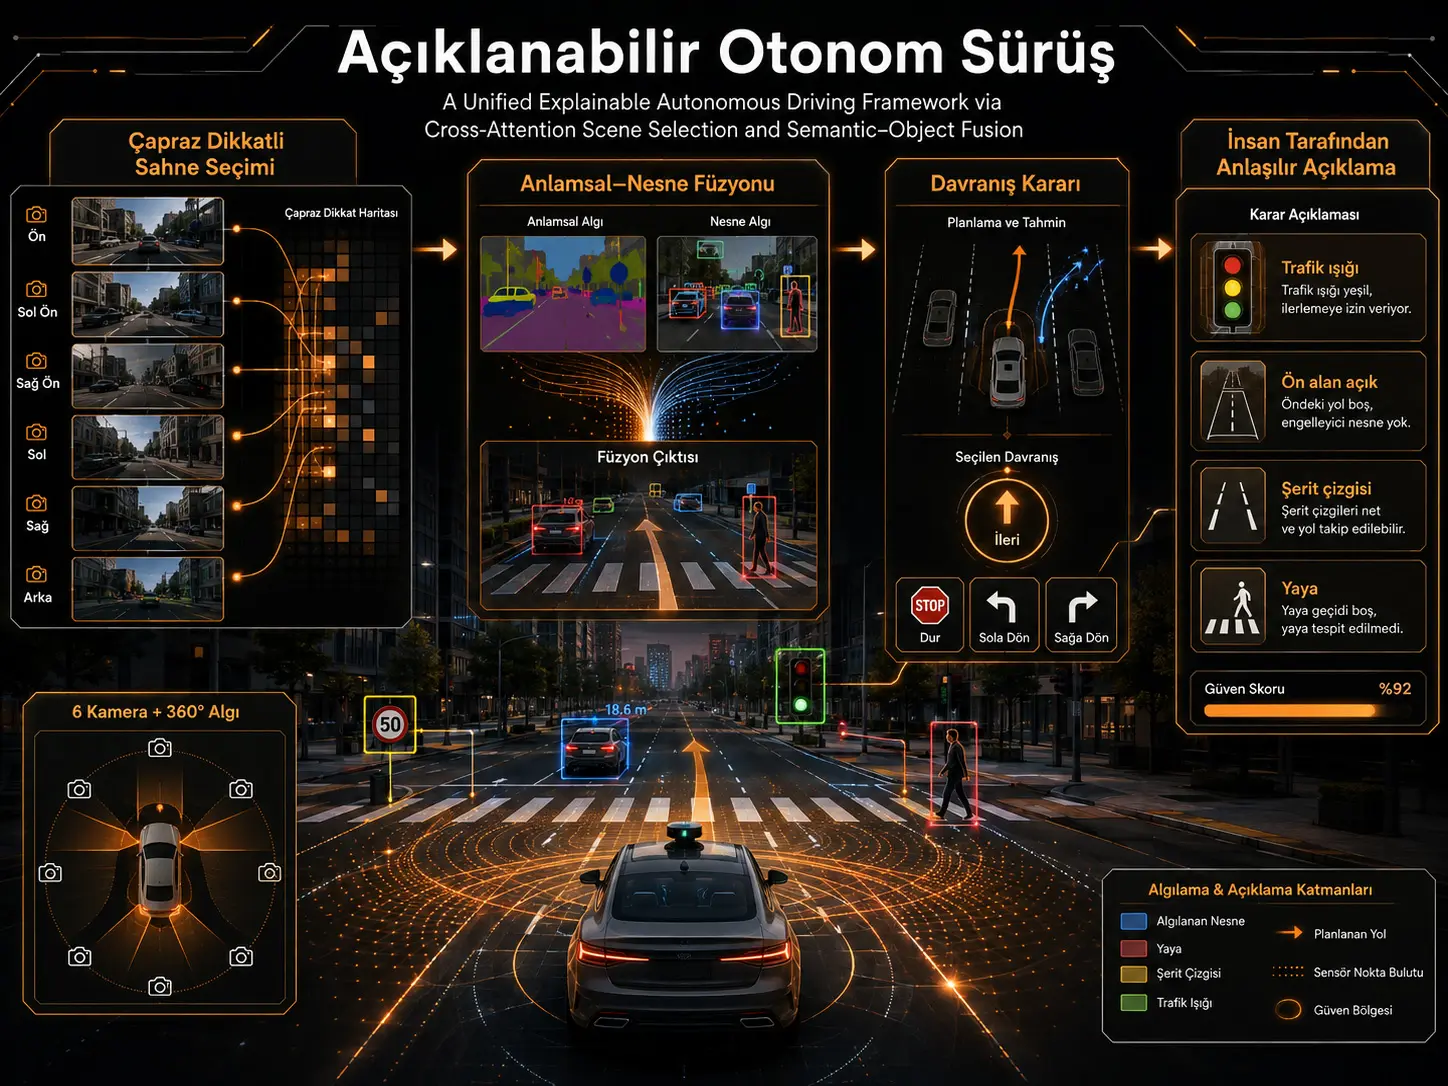
Ushbu tadqiqot avtonom haydash modelining faqat “oldinga yur”, “to‘xta”, “chapga buril” yoki “o‘ngga buril” kabi xatti-harakat qarorlarini ishlab chiqishini emas, balki ayni vizual tasvirdan ushbu qarorlar bilan bog‘liq, inson tushunishi mumkin bo‘lgan sabablarni ham bashorat qilishini maqsad qiladi. CrossAD deb nomlangan tizim Swin Transformer asosidagi umumiy vizual kodlagichni; sahna darajasidagi ma’noni ajratib oladigan Object Selection Module (OSM), sinfdan mustaqil mahalliy obyekt tokenlarini saqlaydigan Object-Token Extractor (OTE) va ushbu ikki turdagi ma’lumotni birlashtiradigan Semantic–Object Fusion (SOF) moduli bilan birlashtiradi. BDD-OIA benchmarkida CrossAD izohlash tomonida \(F1_m=0,417\) va \(F1_{all}=0,584\) bilan taqqoslangan usullar orasida eng yuqori qiymatlarni bildirgan, nu-AD da esa xatti-harakat uchun \(0,848/0,887\), izohlash uchun \(0,909/0,919\) natijalarga erishgan. Biroq natijalar oflayn benchmark baholashlaridir; tizim haqiqiy transport vositasida yopiq siklli haydash xavfsizligi yoki dala ishlashi nuqtayi nazaridan tasdiqlanmagan.
CrossAD ning asosiy arxitektura g‘oyasi “sahna umuman nimani anglatadi” degan ma’lumot bilan “qarorga ta’sir qilishi mumkin bo‘lgan muayyan mahalliy obyekt yoki hududlar qaysilar” degan ma’lumotni bitta tasvirga eritib yuborishdan oldin alohida saqlashdir. OSM yo‘l tasviridagi barcha vizual tokenlar bir xil darajada muhim emas deb hisoblab, ularni ballaydi va eng informativ kichik to‘plamni cross-attention orqali sahna darajasidagi yagona semantik vektorga aylantiradi. OTE esa ayni Swin-T token ketma-ketligidan alohida skorlovchi yordamida sakkizta mahalliy tokenni tanlaydi. Ushbu tokenlar svetofor, oldindagi transport vositasi yoki velosipedchi kabi mazmunli obyektlarga mos kelishi uchun alohida bounding box yoki segmentatsiya yorlig‘i berilmaydi; tanlov xatti-harakat va izohlash vazifalarining umumiy o‘qitish maqsadidan o‘rganiladi.
Xatti-harakat va tushuntirish tarmoqlari tizimda ayni kirishni ishlatsa-da, yakuniy qaror bosqichida ayni xususiyat vektorini o‘qimaydi. Xatti-harakat sarlavhasi OSM dan kelgan semantik vektor bilan OTE dan kelgan mahalliy tokenlarning cross-attention orqali birlashtirilgan tasviridan foydalanadi. Tushuntirish sarlavhasi esa skip connection orqali OSM ning sahna darajasidagi semantik vektoridan bevosita foydalanadi. Tadqiqotchilar ushbu assimetrik yo‘naltirishni xatti-harakat qarori muayyan mahalliy obyektlardan, tushuntirish yorliqlari esa umumiyroq sahna holatidan turli darajalarda foydalanishi fikriga asoslaydi.
Olti kamerali nu-AD foydalanishida kameralarni shunchaki birlashtirish yetarli emas. Tadqiqot ablatsiyasida olti kameraning tokenlarini kamera identifikatorini saqlamasdan o‘rtachalash hatto bitta old kamera ishlatishdan ham past natija bergan. Mualliflar buni old-chap va orqa-chap kabi fazoviy jihatdan o‘xshash, ammo ma’no jihatdan turli ko‘rinishlarni tarmoq ajrata olmasligi bilan bog‘liq deb baholaydi. Shu sababli har bir kameraga faqat 768 o‘lchamli o‘rganiladigan identifikator vektori qo‘shilgan; olti kamera uchun jami qo‘shimcha yuk 4608 parametr bo‘lgan.
Tabiiy til tushuntirish tomonida muhim chegara mavjud. LoRA bilan moslashtirilgan TinyLlama-1.1B kameraning xom tasvirini bevosita o‘qib, erkin asos yaratmaydi. Model CrossAD tomonidan oldindan bashorat qilingan xatti-harakat va izoh yorliqlari bilan shartlanadi. Demak, tadqiqot hosil qilingan gapning tuzilgan qaror chiqishi bilan qanchalik mosligini sinaydi; til modeli qarorning vizual sababini sababiy tarzda kashf etganini ko‘rsatmaydi.
Turkiya nuqtayi nazaridan tadqiqot avtonom transport vositalari izlanishlarida faqat qaror aniqligiga emas, balki model qaysi sahna holatini qarorning sababi sifatida xabar qilayotganiga ham alohida chiqish sifatida qarash mumkinligini ko‘rsatuvchi arxitektura namunasidir. Ammo ushbu benchmark natijalarining Turkiyadagi yo‘l geometriyasi, yo‘l belgilari, haydovchi xatti-harakatlari, ob-havo sharoitlari yoki haqiqiy transport vositasining sensor konfiguratsiyasi uchun amal qilishi mavjud tadqiqotdan kelib chiqmaydi. Bunday foydalanish uchun mahalliy ma’lumotlarda qayta o‘qitish, mustaqil tasdiqlash va haqiqiy transport vositasi sinovlari kerak.
CrossAD qaysi muammoni hal qilishga urinadi?
Avtonom haydashda modelning to‘g‘ri harakatni bashorat qilishi o‘z-o‘zidan model nega aynan shu qarorni berganini ko‘rsatmaydi. Tadqiqot ko‘rib chiqayotgan muammo shu farqdir: ayni model ham haydash xatti-harakatini, ham ushbu xatti-harakat bilan bog‘liq, inson tushunadigan sahna sabablarini birgalikda ishlab chiqara oladimi?
Tadqiqotchilar uchta keng tarqalgan yondashuvning cheklovlaridan kelib chiqadi. Birinchidan, avval obyekt aniqlash yoki segmentatsiya qilib, so‘ng bu chiqishni tabiiy tilga aylantiradigan ko‘p bosqichli tizimlarda dastlabki idrok xatolari keyingi tushuntirishga ko‘chishi mumkin. Ikkinchidan, Grad-CAM ga o‘xshash keyinchalik yaratiladigan ahamiyat xaritalari piksel hududining muhimligini ko‘rsatishi mumkin, ammo “nega muhim” ekanini semantik gap bilan tushuntirmasligi mumkin. Uchinchidan, qaror va tushuntirish alohida tarmoqlardan kelganda, tushuntirish xatti-harakat qarorida ishlatilgan dalil bilan ayni dalilga tayanishi kafolatlanmaydi.
CrossAD shu sababli xatti-harakat bashorati bilan izoh yorliqlarini umumiy Swin-T vizual kodlagichidan ishlab chiqaradi.
Model qaysi xatti-harakatlarni bashorat qiladi?
Har ikki benchmark to‘rtta xatti-harakat yorlig‘idan foydalanadi:
- Forward — oldinga harakat,
- Stop — to‘xtash yoki sekinlashish,
- Left — chapga burilish,
- Right — o‘ngga burilish.
Bu vazifa klassik bitta sinfli tasniflash emas. Bir sahnada bir nechta xatti-harakat yorlig‘i bir vaqtning o‘zida faol bo‘lishi mumkinligi sababli xatti-harakat va izohlash sarlavhalarining ikkisida ham sigmoid aktivatsiyasi ishlatilgan.
BDD-OIA da bundan tashqari 21 ta izoh yorlig‘i, nu-AD da 8 ta izoh yorlig‘i mavjud. BDD-OIA ko‘proq yo‘l belgisi, yo‘l chizig‘i yoki to‘siq kabi konseptual sabablarga; nu-AD esa old, old-chap, orqa-chap kabi atrof hududlarining ochiqligi va svetofor holatiga yo‘naltirilgan fazoviy izohlarga ega.
Vizual kodlagich nima qiladi?
Asosiy vizual kodlagich ImageNet da oldindan o‘qitilgan Swin-T modelidir. 224 × 224 piksel bitta tasvir oxirgi bosqichda 7 × 7 fazoviy xususiyat xaritasiga va undan:
\[ N=49 \]
fazoviy tokenga aylantiriladi. Har tokenning xususiyat o‘lchami:
\[ d=768 \]
deb berilgan.
Shu sababli BDD-OIA da asosiy token ketma-ketligining o‘lchami \(49\times768\), olti kamera ishlatiladigan nu-AD da esa olti kameradan kelgan ketma-ketliklar birlashtirilganda \(294\times768\) bo‘ladi.
Object Selection Module nega kerak?
Haydash tasvirining katta qismi osmon, bino fasadi, bir xil yo‘l yuzasi yoki o‘simliklar kabi qaror uchun har doim bir xil darajada foydali bo‘lmagan vizual hududlarni o‘z ichiga olishi mumkin. OSM ning vazifasi barcha tokenlarni teng og‘irlikda umumlashtirish o‘rniga qaror uchun ko‘proq informativ tokenlarni tanlashdir.
Avval har bir tokenga gorizontal joylashuv ma’lumoti qo‘shiladi. 7 × 7 token panjarasida tokenning gorizontal koordinatasi:
\[ x_j\in[-1,1] \]
ko‘rinishida ifodalanadi va o‘rganiladigan chiziqli o‘zgartirish bilan 768 o‘lchamli token fazosiga ko‘chiriladi:
\[ p_j=W_px_j+b_p \]
\[ \tilde z_j=z_j+p_j \]
Ushbu qo‘shimcha ma’lumotning maqsadi ayniqsa o‘ng/chap yo‘nalishli haydash qarorlarida vizual dalil tasvirning qaysi gorizontal hududidan kelganini saqlashdir.
So‘ng har bir token:
\[ s_j=W_s\tilde z_j+b_s \]
bilan ballanadi va eng yuqori ball olgan tokenlar saqlanadi.
| Ma’lumotlar to‘plami | Boshlang‘ich token soni | OSM saqlaydigan token |
|---|---|---|
| BDD-OIA | 49 | 16 |
| nu-AD | 294 | 64 |
OSM pooled query ta’rifida manba ichidagi farq mavjud
3.3-bo‘limdagi (5)-tenglama cross-attention so‘rovi barcha joylashuv-ma’lumotli token ketma-ketligining o‘rtachasi ekanini bildiradi:
\[ q_{pool} = \frac{1}{N} \sum_{j=1}^{N}\tilde z_j \]
va keyin:
\[ h_{sem} = MHA(q_{pool},Z_{top},Z_{top}) \]
amali bajariladi.
Bunga qarshi, maqolaning Algorithm 1 bo‘limidagi 4-qadam so‘rovni:
qpool ← Mean(Ztop)
deb belgilaydi. Ya’ni bu yerda faqat tanlangan top-K tokenlarning o‘rtachasi ishlatiladi. Ikki ta’rif bir xil emas. Manba haqiqiy amalga oshirishda qaysi biri ishlatilganini ushbu matn doirasida aniq uyg‘unlashtirmagani uchun Verianla maqolasi bu ikki ta’rifdan birini jim tarzda “to‘g‘ri” deb e’lon qilmaydi.
Object-Token Extractor nima qiladi?
OSM sahnaning umumiy semantik xulosasini hosil qilarkan, OTE muayyan mahalliy dalillarning yo‘qolib ketishini oldini olishni maqsad qiladi. Ayni vizual token ketma-ketligi alohida kichik MLP bilan ballanadi:
\[ r_j=g(z_j) \]
va eng yuqori ball olgan:
\[ K_{obj}=8 \]
token tanlanadi.
Tanlangan tokenlar chiziqli qatlam, GELU, dropout va LayerNorm dan o‘tkazilib, yakuniy obyekt-token to‘plamiga aylantiriladi:
\[ O\in\mathbb{R}^{8\times768} \]
Bu yerdagi “object” iborasini klassik obyekt detektori ma’nosida tushunmaslik kerak. Modelda inson tomonidan belgilangan bounding box, sinf nomi yoki segmentatsiya maskasi yo‘q. Tokenlar nimani ifodalashi xatti-harakat va tushuntirish yo‘qotishlaridan end-to-end tarzda o‘rganiladi.
Semantic–Object Fusion qanday ishlaydi?
SOF modulida semantik vektor so‘rov, sakkizta object token esa kalit va qiymat sifatida ishlatiladi:
\[ a=MHA(h_{sem},O,O) \]
So‘ng residual bog‘lanish va LayerNorm qo‘llanadi:
\[ u=LayerNorm(h_{sem}+a) \]
va ikki qatlamli feed-forward network dan keyin:
\[ h_{fuse} = LayerNorm(u+FFN(u)) \]
olinadi.
Ushbu \(h_{fuse}\) vektori xatti-harakat sarlavhasining kirishidir.
Nega xatti-harakat va izohlash sarlavhalari turli xususiyatlarni o‘qiydi?
Xatti-harakat sarlavhasi:
\[ \hat B_i = \sigma(MLP_{beh}(h_{fuse})) \]
bilan, izohlash sarlavhasi esa:
\[ \hat E_i = \sigma(MLP_{int}(h_{sem})) \]
bilan hisoblanadi.
Tadqiqotchilar gipotezasiga ko‘ra, izoh yorliqlari “qizil chiroq bor”, “old hudud ochiq” yoki “o‘ngda to‘g‘ri chiziq bor” kabi sahna darajasidagi xususiyatlarga ko‘proq mos; xatti-harakat qarori esa sahna konteksti bilan birga muayyan mahalliy obyektlardan ham foydalanadi.
Shu sababli izohlash sarlavhasi obyekt füzyonidan o‘tkazilmasdan semantik vektorga bevosita ulanadi.
Obyekt tokenlarining bir-birining nusxasi bo‘lishi qanday oldini olinadi?
OTE ning sakkiz tokeni ayni vizual dalilni qayta-qayta tanlashini kamaytirish uchun diversity regularizer ishlatilgan. Qatorlar bo‘yicha L2 normallashtirilgan token matritsasi \(\tilde O\) uchun:
\[ L_{div} = \left\| \tilde O\tilde O^T-I_{K_{obj}} \right\|_F^2 \]
hisoblanadi.
Umumiy yo‘qotish:
\[ L_{total} = \alpha L_{VB} + \beta L_{des} + \lambda L_{div} \]
va ishlatilgan og‘irliklar:
\[ (\alpha,\beta,\lambda) = (0,5,\ 1,0,\ 0,005) \]
ko‘rinishidadir.
Xatti-harakat yo‘qotishida Forward, Stop, Left va Right uchun sobit sinf og‘irliklari:
\[ [1,0,\ 1,0,\ 2,0,\ 2,0] \]
sifatida ishlatilgan; shu tariqa kamroq ifodalangan burilish sinflariga ko‘proq og‘irlik berilgan.
Olti kamera qanday birlashtiriladi?
nu-AD da olti kameraning har biri Swin-T tomonidan alohida qayta ishlanadi. Har bir kameraga 768 o‘lchamli o‘rganiladigan identifikator embedding qo‘shiladi:
\[ T= Concat( Z^{(1)}+e_1,\ldots,Z^{(6)}+e_6 ) \]
Ushbu usul token o‘lchamini kattalashtirmasdan kamera identifikatorini xususiyatlar ichiga olib kiradi.
Olti kamera uchun qo‘shimcha parametrlar soni:
\[ 6\times768=4608 \]
bo‘lgani uchun vizual tarmoq kattaligiga nisbatan juda kichikdir.
Kamera identifikatori haqiqatan muhim ekani ko‘rsatildimi?
Ablatsiya tadqiqoti bu borada kuchli, ammo to‘liq izolyatsiyalanmagan topilma beradi.
| Variant | Tuzilma | Xatti-harakat F1m | Izoh F1m | Overall xatti-harakat F1 |
|---|---|---|---|---|
| V1 | Bitta old kamera | 0,825 | 0,862 | 0,851 |
| V2 | 6 kamera, token o‘rtachalash | 0,757 | 0,747 | 0,792 |
| V3 | 6 kamera + kamera embedding + cyclic LR | 0,838 | 0,905 | 0,877 |
| V4 | To‘liq model | 0,848 | 0,909 | 0,887 |
Olti kamerani identifikatorsiz birlashtirish V1 ga nisbatan xatti-harakat F1m ni 0,825 dan 0,757 ga, izoh F1m ni 0,862 dan 0,747 ga tushirgan.
V3 da ishlash kuchli tarzda tiklanadi. Biroq V3 bir vaqtning o‘zida uchta o‘zgarishni o‘z ichiga oladi: kamera embedding, cyclic learning-rate va boshqa o‘qitish budjeti. Shu sababli tadqiqotchilar V2→V3 yutug‘ini faqat kamera embedding ga tegishli izolyatsiyalangan sababiy ta’sir sifatida o‘qimaslik kerakligini ochiq aytadi.
Additive kamera embeddingmi yoki concatenationmi?
Alohida taqqoslashda kamera identifikatorini tokenga qo‘shish bilan kamera identifikatorini concatenation + projection orqali berish taqqoslangan.
Additive usul izohlashda \(F1_m=0,909\), concatenation usuli esa \(0,908\) bergan. Ishlash deyarli bir xil bo‘lsa-da, concatenation yondashuvi taxminan 0,59 million qo‘shimcha parametr talab qilgan; additive embedding esa faqat 4608 parametr qo‘shgan.
BDD-OIA natijalari nimani ko‘rsatadi?
| Usul | Xatti-harakat F1m | Xatti-harakat F1all | Izoh F1m | Izoh F1all |
|---|---|---|---|---|
| OIA | 0,718 | 0,734 | 0,208 | 0,422 |
| Inaction | 0,694 | 0,714 | 0,347 | 0,565 |
| NLE-DM | 0,723 | 0,733 | 0,312 | 0,517 |
| Interrelation | 0,701 | 0,722 | 0,335 | 0,537 |
| CrossAD | 0,716 | 0,739 | 0,417 | 0,584 |
CrossAD izohlash tomonida ikkala metrikada ham eng yuqori qiymatni beradi. Xatti-harakat tomonida esa overall F1 eng yuqori bo‘lsa-da, class-mean F1 qiymati NLE-DM dan past.
Chapga burilish nega muammoli?
BDD-OIA o‘qitish ma’lumotlaridagi xatti-harakat taqsimoti:
| Xatti-harakat | Namuna soni | Chastota |
|---|---|---|
| Forward | 8734 | %54,3 |
| Stop | 7277 | %45,2 |
| Left | 1210 | %7,5 |
| Right | 10.660 | %66,3 |
Yorliqlar bir-birini istisno qilmasligini unutmaslik kerak; foizlar yig‘indisining %100 dan oshishi shu sababli xato emas.
CrossAD ning sinf F1 natijalari:
| Sinf | CrossAD F1 |
|---|---|
| Forward | 0,839 |
| Stop | 0,803 |
| Left | 0,580 |
| Right | 0,641 |
Chapga burilish CrossAD ning xatti-harakat o‘rtachasini pasaytiradigan asosiy sinfdir. NLE-DM ayni sinfda 0,651 xabar qiladi.
nu-AD natijalari nimani ko‘rsatadi?
Verianla Live: nu-AD da CrossAD va avvalgi usullar
Jadval tadqiqotning nu-AD test split taqqoslashidagi to‘rtta aggregate F1 metrikasini ko‘rsatadi.
| Usul | Xatti-harakat F1m | Xatti-harakat F1all | Izoh F1m | Izoh F1all |
|---|---|---|---|---|
| OIA | 0,739 | 0,771 | 0,853 | 0,852 |
| NLE-DM | 0,760 | 0,836 | 0,882 | 0,879 |
| VB-CASeg | 0,767 | 0,844 | 0,907 | 0,903 |
| CrossAD | 0,848 | 0,887 | 0,909 | 0,919 |
Verianla Live: Qiymatlar tadqiqotning nu-AD test split taqqoslashidan olingan. Grafik mexanizmi ishlamasa ham ilmiy manba qiymatlari yuqoridagi jadvalda saqlanadi.
nu-AD da CrossAD to‘rtta aggregate o‘lchovning barchasida jadvaldagi eng yuqori qiymatga erishadi. VB-CASeg ga nisbatan xatti-harakat class-mean F1 yutug‘i 0,081; overall xatti-harakat F1 yutug‘i 0,043. Izohlash tomonidagi farq kichikroq: class-mean F1 da 0,002, overall F1 da 0,016.
OSM haqiqatan trafik bilan bog‘liq hududlarga qaraydimi?
Tadqiqotning OSM vizualizatsiyasida 7 × 7 token grid ustidagi attention og‘irliklari kirish tasviri ustiga qo‘yilgan. Namuna sahnada yuqoriroq og‘irliklar yo‘l chiziqlari, yo‘nalish strelkalari va transport vositasining oldinga harakat yo‘lagi ustida jamlangani, chetdagi binolar esa pastroq og‘irlik olgani ko‘rsatiladi.
Ushbu vizual OSM kamida taqdim etilgan misolda vazifa bilan bog‘liq hududlarni ajratib ko‘rsata olishini bildiradi. Biroq bitta attention xaritasi modelning barcha qarorlarining sababiy tushuntirishi sifatida talqin qilinmasligi kerak.
Tabiiy til tushuntirishi qanday hosil qilinadi?
Tizimda tushuntirish ishlab chiqarishning ikki yo‘li mavjud.
Birinchi yo‘l: deterministik qoida mexanizmidir. BDD-OIA uchun 47 ta, nu-AD uchun 18 ta shablon mavjud. Faol xatti-harakat va sabab yorliqlari qoidalar orqali o‘qilib, tekshiriladigan gap hosil qilinadi.
Ikkinchi yo‘l: TinyLlama-1.1B modelining Low-Rank Adaptation bilan moslashtirilgan versiyasidir.
LoRA parametrlari:
- rank \(r=2\),
- masshtab \(\alpha_{LoRA}=64\),
- taxminan 12.300 prompt–completion jufti,
- %90 o‘qitish / %10 validatsiya bo‘linishi.
Prompt bashorat qilingan xatti-harakat va izoh vektorlarini o‘z ichiga oladi. Ya’ni TinyLlama sahna tasvirini bevosita ko‘rmaydi.
Verianla Live: Tasvirdan xatti-harakat va tabiiy til tushuntirishigacha CrossAD zanjiri
Quyidagi jarayon tadqiqot arxitekturasi va inference tavsiflarida berilgan asosiy bosqichlarni umumlashtiradi.
| Bosqich | Amal | Chiqish / maqsad |
|---|---|---|
| 1. Vizual kodlash | Bitta kamera yoki olti kamera tasviri Swin-T bilan fazoviy tokenlarga aylantiriladi. | Umumiy vizual xususiyatlar ketma-ketligi |
| 2. Sahna tanlovi | OSM gorizontal joylashuv ma’lumotini qo‘shadi, tokenlarni ballaydi va top-K sahna tokenlarini tanlaydi. | Qaror uchun muhim sahna kichik to‘plami |
| 3. Semantik xulosa | Cross-attention orqali sahna darajasidagi semantic vector yaratiladi. | hsem |
| 4. Mahalliy token tanlovi | OTE ayni vizual token ketma-ketligidan alohida skorlovchi orqali sakkizta object token tanlaydi. | O ∈ R8×768 |
| 5. Semantic–object fusion | Semantic vector so‘rov, object tokenlar kalit/qiymat sifatida cross-attention bilan birlashtiriladi. | hfuse |
| 6. Xatti-harakat bashorati | Xatti-harakat sarlavhasi fused representation ni o‘qiydi. | Forward / Stop / Left / Right ehtimollari |
| 7. Izoh bashorati | Izoh sarlavhasi semantic vector ni skip connection orqali bevosita o‘qiydi. | Ko‘p yorliqli inson-tushunarli sabablar |
| 8. Til ishlab chiqarish | Bashorat qilingan xatti-harakat va izoh yorliqlari qoida mexanizmi yoki LoRA-TinyLlama ga beriladi. | Tabiiy til asoslantirishi |
Verianla Live: Oqim manba arxitekturasiga asoslanadi. Til generatori xom vizual tokenlardan bevosita foydalanmasligi alohida saqlangan.
Tabiiy til tushuntirishlari qanchalik izchil?
BDD-OIA held-out test to‘plamida \(n=4572\) namuna ustida uchta asosiy nazorat xabar qilingan:
| Nazorat o‘lchovi | Natija |
|---|---|
| Bashorat qilingan xatti-harakatning gapda aytilishi | %99,93 |
| Bashorat ishonchiga oid so‘z ishlatilishi | %99,80 |
| Kamida bitta sahna belgisi bilan moslashish | %92,11 |
Ushbu natijalar til generatori model tomonidan berilgan tuzilgan chiqishlarni katta darajada gapda saqlashini ko‘rsatadi. Biroq ular tushuntirish haqiqiy dunyoda to‘g‘ri ekanini yoki vizual dalilga sababiy bog‘langanini o‘z-o‘zidan ko‘rsatmaydi.
Qaror to‘g‘ri bo‘lganda tushuntirish yaxshiroqmi?
Tadqiqotchilar xatti-harakat vektori to‘liq to‘g‘ri va noto‘g‘ri bashorat qilingan namunalarni alohida baholagan.
| Kichik to‘plam | n | ROUGE-L | Sahna belgisi bilan moslashish |
|---|---|---|---|
| Xatti-harakat bashorati to‘g‘ri | 1111 | 0,8016 | %92,64 |
| Xatti-harakat bashorati noto‘g‘ri | 3461 | 0,6788 | %91,94 |
ROUGE-L farqi:
\[ 0,8016-0,6788=0,1228 \]
deb xabar qilingan.
Bundan tashqari, ayni til generatoriga bashorat qilingan yorliqlar o‘rniga haqiqiy yorliqlar berilganda ROUGE-L:
\[ 0,7087\rightarrow0,9226 \]
ga ko‘tarilib, farq 0,2139 bo‘lgan.
Tadqiqotchilar buni tabiiy til ishlab chiqarish sifati upstream xatti-harakat bashorati aniqligi bilan cheklanishi sifatida talqin qiladi.
Bu “tushuntirish sodiqligi” aynan nimani isbotlaydi?
Tadqiqotning o‘z farqlashi bu yerda ayniqsa muhim. Til generatori tuzilgan bashoratlarga shartlanganligi sababli, xatti-harakat noto‘g‘ri bo‘lganda ham noto‘g‘ri xatti-harakatni izchil tushuntirishi mumkin. Bu til generatorining model qaroriga sodiqligini ko‘rsatishi mumkin; ammo model qarorni haqiqatan to‘g‘ri vizual obyekt sababli berganini isbotlamaydi.
Mualliflar buni ochiqchasiga “decision-level faithfulness to the structured outputs” bilan “causal grounding to the raw visual evidence” orasida ajratadi.
Shu sababli mavjud tadqiqot quyidagi da’voni qo‘llab-quvvatlaydi:
“Til generatori katta darajada CrossAD ning tuzilgan bashoratlariga mos asoslantirish ishlab chiqaradi.”
Ammo quyidagi kuchliroq da’voni qo‘llab-quvvatlamaydi:
“Hosil qilingan gap modelning xom tasvir ustida qaror berishiga sabab bo‘lgan haqiqiy sababiy vizual dalilni isbotlaydi.”
Stress testlarida nima bo‘ldi?
Tadqiqot beshta ssenariy guruhida 15 ta qiyin variantni ko‘rib chiqdi:
- chapga burilish,
- to‘silish/occlusion,
- tungi sharoit,
- murakkab yo‘l belgilari,
- ko‘p obyektli sahnalar.
| Ssenariy | BDD-OIA ishonch | nu-AD ishonch | BDD-OIA entropiya |
|---|---|---|---|
| Chapga burilish | 0,2878 ± 0,0267 | 0,2754 ± 0,0017 | 1,3747 ± 0,0103 |
| Occlusion | 0,2904 ± 0,0131 | 0,2580 ± 0,0014 | 1,3768 ± 0,0054 |
| Tun | 0,3109 ± 0,0160 | 0,2684 ± 0,0005 | 1,3689 ± 0,0063 |
| Murakkab belgilar | 0,2771 ± 0,0000 | 0,2719 ± 0,0000 | 1,3835 ± 0,0000 |
| Ko‘p obyektli | 0,3031 ± 0,0290 | 0,2641 ± 0,0043 | 1,3666 ± 0,0184 |
To‘rtta sinf uchun nazariy maksimal entropiya:
\[ \ln4\approx1,386 \]
bo‘lgani sababli taxminan 1,37 darajadagi qiymatlar ushbu namunalar uchun yuqori noaniqlikni ko‘rsatadi. Manbaning o‘zi bu stress-test natijalarini populyatsion statistika emas, balki qiyin sharoitlarda model xatti-harakatini tashxislovchi natijalar deb ta’riflaydi.
Tadqiqot qo‘llab-quvvatlaydigan natijalar
- Bitta Swin-T vizual kodlagichi orqali xatti-harakat va inson tushunadigan sabab yorliqlari birgalikda bashorat qilingan.
- OSM sahna darajasidagi semantic representation ni top-K token tanlash va cross-attention bilan yaratadi.
- OTE bounding-box yoki segmentatsiya supervision siz sakkizta class-agnostic object token tanlaydi.
- SOF semantic vector bilan object tokenlarni cross-attention orqali birlashtiradi.
- BDD-OIA da CrossAD taqqoslangan usullar orasida eng yuqori ikkita interpretation F1 metrikasini xabar qilgan.
- nu-AD da CrossAD taqqoslangan usullar orasida to‘rtta aggregate xatti-harakat/izohlash F1 metrikasining barchasida eng yuqori natijani xabar qilgan.
- nu-AD da kamera identifikatori saqlanmasdan qilingan olti kamera token o‘rtachalashi ishlashni bitta kameraga nisbatan pasaytirgan.
- Additive kamera embedding yechimi concatenation muqobiliga juda o‘xshash aniqlik bilan ancha kam qo‘shimcha parametr ishlatgan.
- LoRA-TinyLlama ishlab chiqargan tushuntirishlar tuzilgan model chiqishlari bilan yuqori darajada izchil topilgan.
- Noto‘g‘ri xatti-harakat bashoratlarida ROUGE-L pasayishi til ishlab chiqarishi upstream bashorat aniqligi bilan cheklanishini qo‘llab-quvvatlagan.
Tadqiqot qo‘llab-quvvatlamaydigan yoki hali tasdiqlamagan natijalar
- CrossAD haqiqiy transport vositasida yopiq siklli avtonom haydash sinovi bilan tasdiqlanmagan.
- Benchmark F1 qiymatlari haqiqiy yo‘l xavfsizligi ko‘rsatkichi emas.
- Modelning BDD-OIA va nu-AD dan tashqari ma’lumotlar to‘plamida ayni ishlashni ko‘rsatishi isbotlanmagan.
- Turkiya yo‘l va trafik sharoitlariga bevosita umumlashtiriluvchanlik sinovdan o‘tkazilmagan.
- Model uzoq vaqt ketma-ketliklaridan foydalanmaydi; asosiy tuzilma bitta kadr yoki ayni vaqtda olingan kamera tasvirlariga tayangan.
- Object tokenlar nazoratli obyekt yorliqlari bilan nomlanmagan yoki bounding-box darajasida tasdiqlanmagan.
- OSM attention vizualizatsiyasi o‘z-o‘zidan sababiy tushuntirish dalili emas.
- LoRA-TinyLlama xom vizual tokenlarga bevosita shartlanmagani uchun tabiiy til chiqishining vizual sababiy sodiqligi isbotlanmagan.
- V2→V3 ablatsiya farqining barchasini faqat kamera embedding mexanizmiga bog‘lab bo‘lmaydi.
- 27,4 millionlik parametr qiymati muzlatilgan TinyLlama-1.1B asosiy tarmog‘ining barcha parametrlarini ifodalamaydi.
Tadqiqot Usuli va Natijalari
Benchmark ma’lumotlar to‘plamlari
| Ma’lumotlar to‘plami | Manba | Kamera | Xatti-harakat sinfi | Izoh kategoriyasi |
|---|---|---|---|---|
| BDD-OIA | BDD100K | 1 | 4 | 21 |
| nu-AD | nuScenes | 6 | 4 | 8 |
CrossAD asosiy tensor o‘lchamlari
| Komponent | BDD-OIA | nu-AD |
|---|---|---|
| Kirish | 3 × 224 × 224 | 6 × 3 × 224 × 224 |
| Swin-T token ketma-ketligi | 49 × 768 | 294 × 768 |
| OSM tanlagan token | 16 × 768 | 64 × 768 |
| Semantic vector | 768 | 768 |
| Object token | 8 × 768 | 8 × 768 |
| Fused representation | 768 | 768 |
| Xatti-harakat chiqishi | 4 | 4 |
| Izoh chiqishi | 21 | 8 |
O‘qitish muhiti va optimallashtirish
| Parametr | Manbada berilgan sozlama |
|---|---|
| Framework | PyTorch 2.7.1 |
| CUDA | 11.8 |
| GPU | NVIDIA RTX 3080 Ti |
| O‘qitish tasviri | 256 × 256 ga o‘lchamni o‘zgartirish → tasodifiy 224 × 224 crop |
| Inference | Deterministik center crop |
| Optimizer | AdamW |
| Weight decay | 10⁻⁴ |
| Swin-T learning rate | 2 × 10⁻⁶ |
| Vazifa modullari learning rate | 10⁻⁴ |
| Warm-up | 3 epoch linear |
| Precision | bfloat16 mixed precision |
| Gradient clipping | L2 norm 0,5 |
| nu-AD mini-batch | 2 surround-view tuple |
| Gradient accumulation | 8 mini-batch |
| Effektiv batch size | 16 |
Swin-T dastlabki uch epoch davomida muzlatilgan, keyin bosqichma-bosqich ochilgan. BDD-OIA da gorizontal aylantirish ishlatilmagan; chunki bu o‘ng/chap ma’nosini teskarilashi aytiladi. nu-AD da esa kameralar va tegishli yorliqlar birgalikda qayta moslanib, geometrik jihatdan izchil flip qo‘llangan.
Yo‘qotish funksiyasi
Xatti-harakat uchun sinf og‘irlikli binary cross-entropy:
\[ L_{VB} = BCE_{w_B}(\hat B_i,B_i) \]
ishlatilgan.
Izohlash uchun o‘qitish ma’lumotlari chastotalaridan hisoblangan va yuqori chegarada kesilgan musbat sinf og‘irliklari bilan:
\[ L_{des} = BCE_{w+}(\hat E_i,E_i) \]
ishlatilgan.
Obyekt token xilma-xilligi bilan birga yakuniy maqsad:
\[ L_{total} = 0,5L_{VB} + 1,0L_{des} + 0,005L_{div} \]
ko‘rinishidadir.
BDD-OIA asosiy natijalari
| Usul | F1beh m | F1beh all | F1des m | F1des all | Forward | Stop | Left | Right |
|---|---|---|---|---|---|---|---|---|
| Local selector | 0,699 | 0,711 | 0,196 | 0,406 | 0,810 | 0,762 | 0,600 | 0,624 |
| OIA | 0,718 | 0,734 | 0,208 | 0,422 | 0,829 | 0,781 | 0,630 | 0,634 |
| Inaction | 0,694 | 0,714 | 0,347 | 0,565 | 0,800 | 0,747 | 0,612 | 0,619 |
| NLE-DM | 0,723 | 0,733 | 0,312 | 0,517 | 0,827 | 0,760 | 0,651 | 0,653 |
| Interrelation | 0,701 | 0,722 | 0,335 | 0,537 | 0,802 | 0,753 | 0,619 | 0,625 |
| CrossAD | 0,716 | 0,739 | 0,417 | 0,584 | 0,839 | 0,803 | 0,580 | 0,641 |
CrossAD izohlashda kuchli bo‘lsa-da, BDD-OIA xatti-harakat class-mean F1 bo‘yicha jadvaldagi eng yuqori usul emas. Ushbu farq natijalarni talqin qilishda saqlanishi kerak.
nu-AD asosiy natijalari
| Usul | F1beh m | F1beh all | F1des m | F1des all |
|---|---|---|---|---|
| OIA | 0,739 | 0,771 | 0,853 | 0,852 |
| NLE-DM | 0,760 | 0,836 | 0,882 | 0,879 |
| VB-CASeg | 0,767 | 0,844 | 0,907 | 0,903 |
| CrossAD | 0,848 | 0,887 | 0,909 | 0,919 |
nu-AD CrossAD sinf natijalari
| Xatti-harakat | F1 |
|---|---|
| Forward | 0,963 |
| Stop | 0,852 |
| Left | 0,760 |
| Right | 0,818 |
Ko‘p kamerali ablatsiya
| Variant | Kamera | Forward | Stop | Left | Right | F1des m | F1des all | F1beh all |
|---|---|---|---|---|---|---|---|---|
| V1 — bitta kamera | 1 | 0,963 | 0,824 | 0,739 | 0,773 | 0,862 | 0,867 | 0,851 |
| V2 — token o‘rtachalash | 6 | 0,954 | 0,785 | 0,582 | 0,708 | 0,747 | 0,780 | 0,792 |
| V3 — cam embedding + cyclic LR | 6 | 0,958 | 0,837 | 0,752 | 0,805 | 0,905 | 0,917 | 0,877 |
| V4 — to‘liq model | 6 | 0,963 | 0,852 | 0,760 | 0,818 | 0,909 | 0,919 | 0,887 |
V3 bilan V2 o‘rtasidagi taqqoslash faqat kamera embedding ta’sirining sof ablatsiyasi emas; maqolaning o‘zi V3 optimizer schedule va o‘qitish budjeti bo‘yicha ham V2 dan farq qilishini bildiradi.
Samaradorlik taqqoslanishi
| Usul | Parametr | Runtime / tasvir | nu-AD F1beh m | nu-AD F1des all |
|---|---|---|---|---|
| OIA | 21,68 M | 65,63 ms | 0,739 | 0,852 |
| NLE-DM | 41,55 M | 47,10 ms | 0,760 | 0,879 |
| VB-CASeg | 28,11 M | 52,78 ms | 0,767 | 0,903 |
| CrossAD | 27,4 M | 50,9 ms | 0,848 | 0,919 |
Manbaning batafsil murakkablik jadvalida CrossAD vizual tarmog‘i 22,21 M parametr, 17,89 G MAC va 35,78 G FLOP deb xabar qilingan. Ushbu profil nu-AD olti kamerali kirish va batch size 1 uchun tuzilgan.
TinyLLaMA-LoRA moduli uchun 4,51 M soni faqat o‘qitiladigan LoRA adapter parametrlarini ifodalaydi. TinyLlama-1.1B asosiy modeli muzlatilgan; shu sababli 27,4 M qiymati til modelining barcha fizik model parametrlarini o‘z ichiga olgan umumiy tizim kattaligi sifatida talqin qilinmasligi kerak.
Tabiiy til sodiqligi tahlili
| O‘lchov | Kichik to‘plam | Qiymat |
|---|---|---|
| Xatti-harakatning gapda tilga olinishi | Barcha test | %99,93 |
| Ishonch ifodasining ishlatilishi | Barcha test | %99,80 |
| Sahna belgisi bilan moslashish | Barcha test | %92,11 |
| ROUGE-L | Xatti-harakat to‘liq to‘g‘ri, n=1111 | 0,8016 |
| ROUGE-L | Xatti-harakat noto‘g‘ri, n=3461 | 0,6788 |
| ROUGE-L | Bashorat yorliqlari bilan ishlab chiqarish | 0,7087 |
| ROUGE-L | Haqiqiy yorliqlar bilan oracle ishlab chiqarish | 0,9226 |
Bu yerdagi sodiqlik tuzilgan xatti-harakat va izoh yorliqlariga qaratilgan. Tadqiqotning o‘zi ushbu natijalar xom vizual dalilga nisbatan causal faithfulness ta’minlamasligini bildiradi.
Manba ichidagi texnik e’tibor nuqtalari
OSM pooled query: (5)-tenglama barcha position-aware tokenlar o‘rtachasini ishlatadi, Algorithm 1 esa tanlangan \(Z_{top}\) tokenlar o‘rtachasini ishlatadi.
V2–V3 ablatsiyasi: Kamera embedding bilan birga cyclic learning rate va o‘qitish budjeti ham o‘zgargani sababli yutuqni faqat kamera embedding ga sababiy tarzda bog‘lab bo‘lmaydi.
Parametr soni: CrossAD uchun berilgan 27,4 M raqami TinyLlama-1.1B ning barcha muzlatilgan asosiy parametrlarini qamrab olgan umumiy deployed model kattaligi emas.
BDD-OIA F1 terminologiyasi: 0,716 qiymati Table 6 da class-mean behaviour F1; overall behaviour F1 esa 0,739. Keyingi matnda 0,716 “behaviour-prediction accuracy” deb atalgan.
Tushuntirish sodiqligi: Language generator yorliq-shartlidir. Shu sababli qaror-darajasidagi sodiqlik bilan xom vizual dalilga nisbatan sababiy sodiqlikni bir-biridan ajratish kerak.
Manba va Usul Haqida Izoh
To‘liq asl tadqiqot nomi: A Unified Explainable Autonomous Driving Framework via Cross-Attention Scene Selection and Semantic–Object Fusion
Mualliflar: Habib Dhahri, Fahad Alotaibi, Awais Mahmood, Mousa Jari.
Mualliflar tartibi: Manbadagi tartib aynan saqlangan.
Mas’ul muallif: Habib Dhahri.
Teng hissa/teng birinchi muallif: Manbada bunday bayonot yo‘q.
Muassasa: College of Applied Computer Science, King Saud University, Riyadh 11545, Saudi Arabia.
Jurnal: Machines.
Nashriyot: MDPI.
Bibliografik yozuv: Machines 2026, 14, 677.
DOI: 10.3390/machines14060677.
Rasmiy nashr havolasi:https://doi.org/10.3390/machines14060677
Nashr sanasi: 10 June 2026.
Manba turi va taqriz holati: Taqrizli original tadqiqot maqolasidir. Tadqiqot BDD-OIA va nu-AD ochiq benchmark ma’lumotlar to‘plamlarida chuqur o‘rganish modelini ishlab chiqish va baholashga tayangan.
Litsenziya: Creative Commons Attribution (CC BY).
Moliyalashtirish: Tadqiqot King Saud University, Riyadh tomonidan Ongoing Research Funding dasturi doirasida ORF-2026-2100 raqami bilan qo‘llab-quvvatlangan.
Ma’lumot va kod mavjudligi: Tadqiqotda BDD-OIA va nu-AD ochiq benchmarklari ishlatilgan. Mualliflar stratified subset manifest, sampling scriptlari, o‘qitish kodi, rule-engine shablonlari va baholash scriptlari GitHub orqali taqdim etilganini; LoRA bilan moslashtirilgan TinyLlama checkpoint qabuldan keyin e’lon qilinishini bildirgan.
Manfaatlar to‘qnashuvi: Mualliflar manfaatlar to‘qnashuvi yo‘qligini bildirgan.
Muallif hissalari: Habib Dhahri va Fahad Alotaibi konseptualizatsiyada; Habib Dhahri, Awais Mahmood va Mousa Jari metodologiyada; Habib Dhahri dasturiy ta’minotda; to‘rt muallif validatsiyada; Habib Dhahri formal tahlil va ma’lumotlarni boshqarishda; Habib Dhahri va Mousa Jari tadqiqotda; Fahad Alotaibi va Awais Mahmood resurslarda; Habib Dhahri birinchi qoralama va vizualizatsiyada; Fahad Alotaibi, Awais Mahmood va Mousa Jari ko‘rib chiqish/tahrirlashda; Awais Mahmood va Mousa Jari nazoratda; Fahad Alotaibi loyiha boshqaruvi va moliyalashtirishni olishda ishtirok etgan.
Ushbu Verianla maqolasidagi arxitektura, tensor o‘lchamlari, yo‘qotish funksiyalari, o‘qitish sozlamalari, benchmark natijalari, ablatsiyalar, samaradorlik qiymatlari, tabiiy til tushuntirish natijalari, stress testlari va cheklovlar ko‘rib chiqilgan manba tadqiqotga asoslangan. Bibliografik identifikatsiyani tasdiqlashdan tashqari tashqi manbalardan yangi ilmiy model natijasi yoki ishlash da’vosi qo‘shilmagan.
Asosiy metodologik chegara: Tadqiqot BDD-OIA va nu-AD benchmarklarida oflayn model baholashini taqdim etadi. Haqiqiy transport vositasida yopiq siklli haydash, dala sinovi, uzoq muddatli foydalanish, xavfsizlik sertifikatsiyasi yoki turli mamlakat va trafik taqsimotlarida mustaqil tasdiqlash o‘tkazilmagan. Model asosan statik tasvir/kamera kadrlaridan foydalanadi va uzoq muddatli temporal reasoning mavjud arxitekturaning asosiy qismi emas.
Tushuntiriluvchanlik chegarasi: LoRA-TinyLlama tushuntirish generatori xom vizual tokenlarga bevosita shartlanmaydi; bashorat qilingan xatti-harakat va izoh yorliqlaridan tushuntirish yaratadi. Shu sababli tadqiqot tuzilgan qarorlarga nisbatan decision-level faithfulness topilmasini beradi; xom vizual dalilga nisbatan causal faithfulness dalilini bermaydi.
OSM manba ichki nomuvofiqlik izohi: 3.3-bo‘lim (5)-tenglama pooled query ni barcha position-aware tokenlarning o‘rtachasi sifatida belgilaydi, Algorithm 1 ning 4-qadami esa faqat tanlangan top-K tokenlar o‘rtachasidan foydalanadi. Manba ikki ta’rifni yagona yakuniy amalga oshirish sifatida uyg‘unlashtirmaydi.
Ablatsiya chegarasi: V2 va V3 orasidagi o‘zgarish faqat kamera embedding emas; cyclic learning-rate schedule va o‘qitish budjeti ham o‘zgaradi. Manba shu sababli V2→V3 yutug‘ini camera embedding ning yolg‘iz sababiy ta’siri sifatida baholamaydi.
Model kattaligi izohi: Samaradorlik jadvalidagi CrossAD 27,4 M qiymati bilan TinyLLaMA-LoRA uchun berilgan 4,51 M qiymati muzlatilgan taxminan 1,1 milliard parametrli TinyLlama asosiy tarmog‘ining barcha parametrlarini ifodalamaydi. 4,51 M faqat o‘qitiladigan LoRA adapter parametrlaridir.
F1 terminologiyasi izohi: BDD-OIA Table 6 da CrossAD ning behaviour mean F1 qiymati 0,716, overall behaviour F1 qiymati 0,739. Keyingi tabiiy til tushuntirishi muhokamasida 0,716 qiymati “behaviour-prediction accuracy” tarzida atalgan. Verianla maqolasida ikki o‘lchov alohida saqlangan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan