

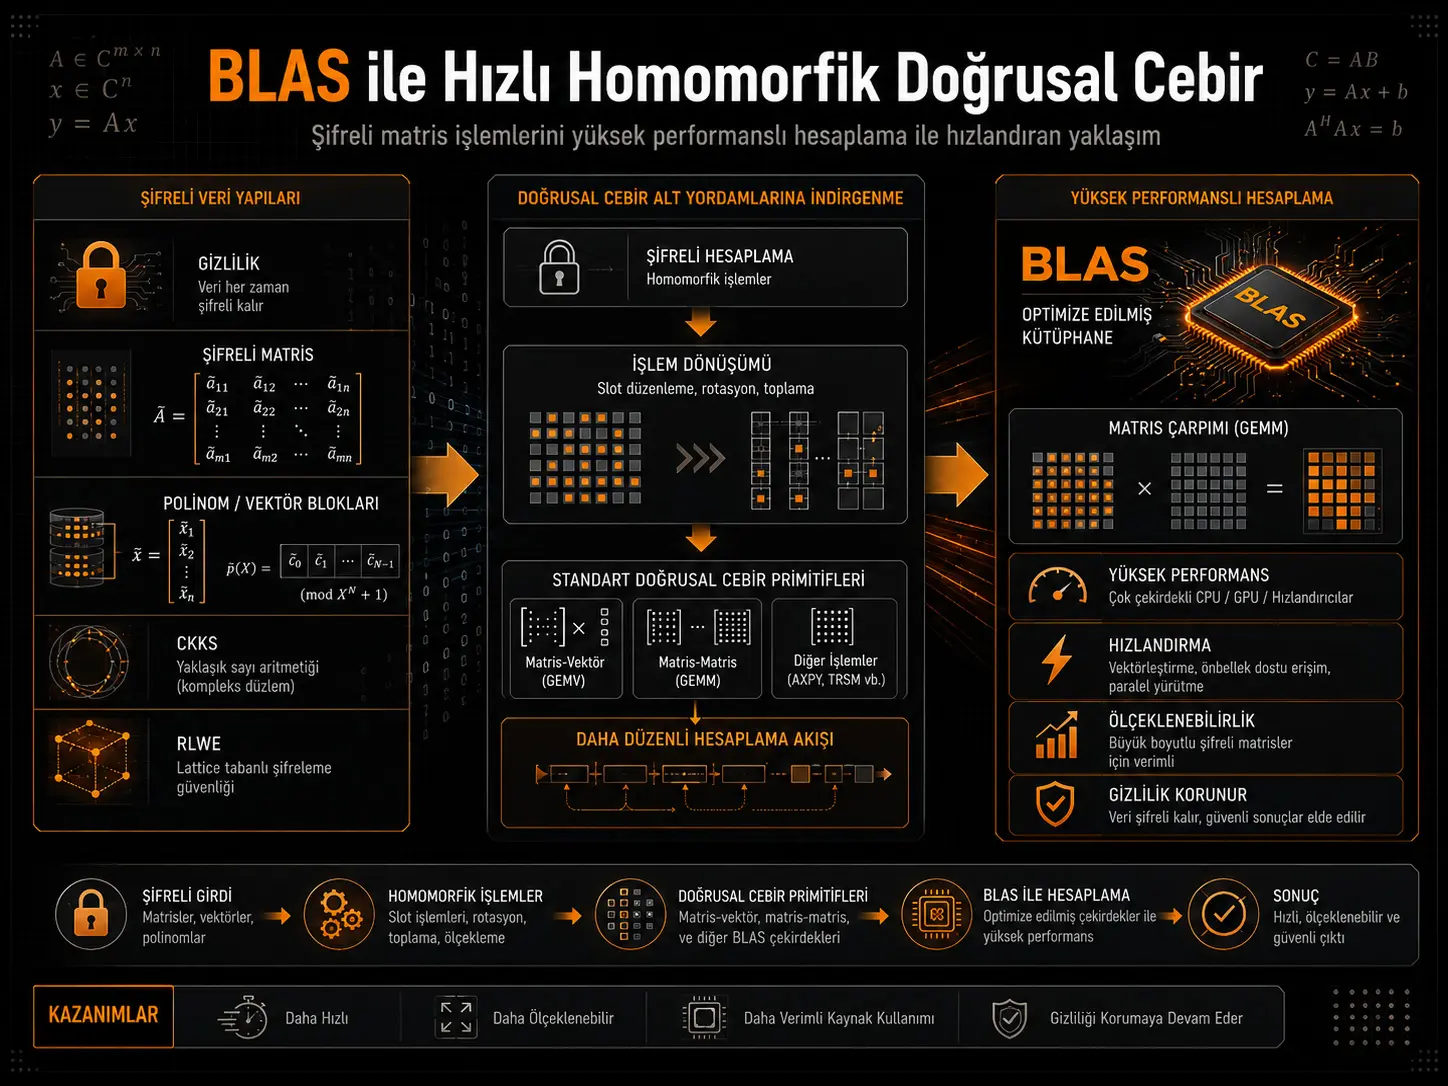
Tadqiqot gomomorfik shifrlash ostida bajariladigan katta ko‘lamli matritsa-vektor va matritsa-matritsa amallarini bevosita murakkab shifrlangan operatsiyalar ketma-ketligi sifatida bajarish o‘rniga yuqori unumli ochiq matnli chiziqli algebra hisoblariga keltirishni maqsad qiladi. Ish markazida taxminiy haqiqiy son arifmetikasini qo‘llab-quvvatlaydigan CKKS to‘liq gomomorfik shifrlash tizimi hamda o‘nlab yillar davomida optimallashtirilgan BLAS (Basic Linear Algebra Subroutines) kutubxonalari o‘rtasidagi bog‘lanish turadi. Mualliflar RLWE, MLWE, shared-a va RGSW asosidagi turli shifrlash shakllari yordamida plaintext–ciphertext, ciphertext–plaintext va ciphertext–ciphertext matritsa amallarining muhim qismini standart matritsa ko‘paytirishlariga aylantiradigan algoritmlar ishlab chiqqanlar. HEaaN va OpenBLAS bilan o‘tkazilgan tajribalarda mualliflar ayrim katta kvadrat matritsa ssenariylarida CKKS asosidagi shifrlangan matritsa ko‘paytirishining ikki aniqlikli floating-point ochiq matn matritsa ko‘paytirishiga nisbatan hisoblash yo‘qotishini taxminan 4–12 marta darajasigacha tushirish mumkinligini bildiradilar. Bu nisbat muayyan algoritm, o‘lcham, shifrlash shakli va oldindan hisoblash shartlariga tegishli; barcha gomomorfik hisoblashlar uchun umumiy nisbat emas.
Ishning asosiy g‘oyasi shifrlangan ma’lumotni yechib BLAS-ga berish emas. Ma’lumot shifrlangan holda qoladi. Tadqiqotchilar RLWE asosidagi shifrlangan matritsa tuzilmasini algebraik tarzda qayta ifodalab, shifrlangan matritsa ko‘paytirishining katta qismini shifrlangan xabarning o‘ziga kira olmasdan standart sonli matritsa ko‘paytirishlariga aylantiradilar. Shunday qilib BLAS-ning CPU va GPU arxitekturalari uchun yillar davomida optimallashtirilgan xotira murojaati va hisoblash tartiblaridan foydalanish ko‘zlanadi.
Taklif qilingan doirada plaintext–ciphertext matritsa ko‘paytirishi ayrim hollarda ikki standart plaintext matritsa ko‘paytirishiga, oldindan hisoblash mumkin bo‘lsa onlayn bosqichda bitta plaintext matritsa ko‘paytirishigacha keltiriladi. Katta kvadrat ciphertext–ciphertext matritsa ko‘paytirishi to‘rt modular plaintext matritsa ko‘paytirishi va shifrlangan matritsa transpozitsiyalariga ajratilgan. Umumiyroq RGSW asosidagi metod turli o‘lcham va shifrlash shakllarini qo‘llab-quvvatlagani uchun yuqoriroq doimiy xarajatga ega.
Tajribalar HEaaN, OpenBLAS 0.3.26 va bitta oqimli Intel Xeon Gold 6342 2,80 GHz protsessori ustida bajarilgan; vaqtlar 10 marta ishga tushirishning o‘rtachasi sifatida berilgan. Parametrlar lattice estimator baholashiga ko‘ra taxminan 128 bit xavfsizlikni ta’minlaydigan qilib tanlangan. Shu bois natijalar gomomorfik chiziqli algebrani amaliy jihatdan tezlashtirish mumkinligini ko‘rsatadi; ammo ularni to‘g‘ridan-to‘g‘ri ko‘p yadroli CPU, GPU yoki uchdan-uchgacha maxfiylikni saqlovchi katta til modeli unumdorligi sifatida talqin qilmaslik kerak.
Turkiya/O‘zbekiston nuqtayi nazaridan baholash: Tadqiqot kriptografiya, ma’lumot maxfiyligi, xavfsiz bulut hisoblashlari va maxfiylikni saqlovchi sun’iy intellekt bilan ishlaydigan ilmiy va muhandislik guruhlari uchun muhim metodni ko‘rsatadi. Katta matritsa amallarini mavjud BLAS ekotizimiga keltirish maxsus gomomorfik apparat ishlab chiqishdan oldin mavjud CPU/GPU chiziqli algebra infratuzilmasidan foydalanish mumkinligini ko‘rsatadi. Biroq ish muayyan davlat ma’lumot markazi, amaliyot yoki me’yoriy muhitni sinamaydi; shuning uchun bevosita milliy infratuzilma unumdorligi yoki joriy etish xarajati xulosasi chiqarilmasligi kerak.
Gomomorfik shifrlash nima uchun muhim?
Oddiy shifrlashda ma’lumot ustida amal bajarish uchun ko‘pincha uni avval ochish kerak bo‘ladi. Gomomorfik shifrlashning maqsadi esa server ma’lumotning ochiq ko‘rinishini ko‘rmasdan shifrlangan ma’lumot ustida hisoblash bajarishidir. Hisob yakunlangach natija ham shifrlangan holda foydalanuvchiga qaytadi va uni faqat mos kalitga ega tomon ochishi mumkin.
Bu xususiyat xom ma’lumotni hisoblash serveriga berishni istamaydigan holatlar uchun muhim. Tadqiqot maxfiylikni saqlovchi AI inference, private information retrieval, taxminiy vektor qidirish, federativ asosiy komponentlar tahlili va katta til modellarining xususiy baholanishini misol sifatida keltiradi.
Matritsa ko‘paytirishi nega tor bo‘g‘in bo‘ladi?
Zamonaviy mashinali o‘rganish va ilmiy hisoblash tizimlarining katta qismi matritsa-vektor va matritsa-matritsa ko‘paytirishlariga tayanadi. Ochiq matn muhitida bu amallar juda yetuk BLAS kutubxonalari orqali bajariladi. RLWE asosidagi gomomorfik shifrlashda esa bitta ciphertext bitta sonni emas, ko‘p qiymatlarni birga tashuvchi polinom tuzilmasini o‘z ichiga oladi.
Shifrlangan ma’lumotni ushbu tuzilma ichida qayta joylashtirish uchun key-switching, gomomorfik avtomorfizm va shunga o‘xshash amallar kerak bo‘lishi mumkin. Mualliflar avvalgi ko‘plab usullarda ayniqsa key-switching soni amaliy bajarilish vaqtini ustun egallashi va murakkab xotira murojaati tartiblari optimallashtirishni qiyinlashtirishini ta’kidlaydi.
Shu sabab asosiy savol quyidagicha: Shifrlangan matritsa ko‘paytirishining katta hisoblash qismini, shifrni ochmasdan, standart ochiq matnli chiziqli algebra muammosiga aylantirish mumkinmi?
BLAS nima va bu ishda nima uchun ishlatiladi?
BLAS — Basic Linear Algebra Subroutines qisqartmasi. U matritsa-vektor va matritsa-matritsa ko‘paytirishi kabi asosiy chiziqli algebra amallari uchun standart dasturlash interfeyslarini belgilaydi. Ishda ayniqsa ikki aniqlikli umumiy matritsa ko‘paytirishi dgemm va matritsa-vektor ko‘paytirishi dgemv rutinlari ishlatiladi.
BLAS-ning qiymati faqat tez kod bo‘lishida emas. U CPU keshlar, vektor buyruqlar, parallelizm va GPU arxitekturalari uchun uzoq yillar optimallashtirilgan. Gomomorfik amallar imkon qadar BLAS chaqiruvlariga aylantirilsa, bu optimallashtirish tajribasidan bevosita foydalaniladi.
CKKS nima uchun tanlangan?
Ish CKKS gomomorfik shifrlash tizimiga e’tibor qaratadi. CKKS taxminiy haqiqiy va kompleks son arifmetikasini qo‘llab-quvvatlaydi hamda SIMD-ga o‘xshash parallel ma’lumot ishlash imkonini beradi. Bu xususiyatlar sonli chiziqli algebra va AI ilovalari bilan tabiiy mos keladi.
CKKS taxminiy tizim bo‘lgani uchun hisoblangan qiymatlar mutlaqo xatosiz butun son arifmetikasi sifatida qaralmasligi kerak. Mualliflar uch xato manbasini ajratadi: boshlang‘ich ma’lumotni kodlash xatosi, RLWE shifrlashidan kelgan kriptografik xato va rescaling/key-switching kabi gomomorfik amallar keltirgan qo‘shimcha xato.
RLWE ciphertext qanday ifodalanadi?
Asosiy RLWE ciphertext ishda taxminan quyidagicha beriladi:
\[ a\cdot sk+b\approx m\pmod q \]
Bu yerda \(a\) va \(b\) ciphertextning ikki polinom komponenti, \(sk\) maxfiy kalit, \(m\) shifrlangan xabar, \(q\) ciphertext moduli. Taxminiy tenglik CKKS kodlash va gomomorfik amal xatolari mavjudligini bildiradi.
Muammoli qadam bu polinom munosabatini matritsa munosabati sifatida qayta yozishdir. Matritsa ustunlari shifrlanganda tuzilma umumiy holda \[ S^{*}A+B\approx \Delta M\pmod q \] ko‘rinishida yoziladi. Bu yerda \(M\) haqiqiy xabar matritsasi, \(\Delta\) CKKS scale faktori, \(S^{*}\) maxfiy kalitning struktur matritsa ko‘rinishi, \(A\) va \(B\) esa ciphertext komponentlaridan hosil qilingan matritsalar.
Plaintext–ciphertext matritsa ko‘paytirishi qanday soddalashadi?
Shifrlangan \(M\) matrisi \[ S^{*}A+B\approx \Delta M \] shaklida, ochiq matn \(U\) matrisi ma’lum bo‘lsa, har ikki tomon o‘ngdan \(U\) ga ko‘paytiriladi:
\[ S^{*}(AU)+(BU)\approx \Delta(MU) \]
Shu bilan asosiy gomomorfik \(M\cdot U\) amali ko‘p jihatdan ikki standart matritsa ko‘paytirishiga, ya’ni \(A\cdot U\) va \(B\cdot U\) hisoblariga aylanadi. Bu matritsalar foydalanuvchi xabarining ochiq holati emas, ciphertextning algebraik komponentlaridir.
Shared-a shakli nimani beradi?
RLWE ciphertext \((a,b)\) jufti sifatida qaralganda mualliflar bir nechta ciphertext bir xil \(a\) komponentini ulashadigan shared-a shaklidan foydalanadi. Katta matritsalarda bu yondashuv \(A\) matritsasi o‘lchamini kamaytirib, qimmat matritsa ko‘paytirish qismidagi amal sonini pasaytiradi.
\(2^{14}\times2^{14}\times2^{14}\) CP-MM misolida shared-s ishlatilsa taxminan 400 soniya kutilgani, structured-S shared-a bilan vaqt 176 soniya bo‘lgani bildiriladi. Taxminan 60 soniyalik format konvertatsiya xarajati qo‘shilsa ham shared-a yondashuvi sezilarli foyda beradi.
Kichik matritsalarda nega MLWE ishlatiladi?
Matritsa o‘lchami RLWE halqa darajasi \(N\) dan kichik bo‘lsa, standart RLWE packing samarasizlashishi mumkin. Mualliflar bu holda Module Learning With Errors (MLWE) shaklidan foydalanadi. Shunday qilib doira \(d=N\) holatiga bog‘lanib qolmaydi; \(d<N\), \(d=N\) va \(d>N\) uchun turli, lekin umumiy matritsa tenglamalari bilan ifodalanadigan shifrlash shakllari ishlatiladi.
Oldindan hisoblash mumkin bo‘lsa nima o‘zgaradi?
Ochiq matn matrisi, masalan AI modelining doimiy vazn matritsasi, ko‘p marta ishlatilsa offline oldindan hisoblash taklif etiladi. Structured-A shared-a yondashuvida onlayn CP-MM \[ A^{*}S+B\approx \Delta M \] munosabatidan \[ A^{*}(SU)+BU\approx \Delta(MU) \] ko‘rinishiga o‘tadi. \(S\cdot U\) bilan bog‘liq kalit amallari oldindan tayyorlansa, onlayn bosqichda faqat \(B\cdot U\) matritsa ko‘paytirishi qolishi mumkin. Bu foyda faqat bir xil ochiq matn matrisi takroran ishlatiladigan holatlarda o‘zini oqlaydi.
Shifrlangan matritsa transpozitsiyasi nega yangi muammo?
Ochiq matritsada transpozitsiya oddiy ma’lumot qayta joylashtirishidir. Shifrlangan matritsada esa satr asosidagi shifrlashdan ustun asosidagi shifrlashga o‘tish gomomorfik avtomorfizmlar va key-switching talab qiladi. Mualliflar Ciphertext Matrix Transpose (C-MT) algoritmini ishlab chiqadi; \(N\times N\) ciphertext matritsa uchun asimptotik xarajat \[ \widetilde{O}(N^2) \] modular arifmetik amaldir. Tweak divide-and-conquer yondashuvi bevosita usulning \(O(N^3)\) xarajatini quasi-quadratic darajaga tushiradi.
Transpozitsiyaning tajriba vaqti qanday?
| Matritsa / halqa o‘lchami N | Shifrlangan matritsa transpozitsiyasi vaqti |
|---|---|
| 212 | 5,60 s |
| 213 | 25,4 s |
| 214 | 117 s |
Qiymatlar o‘lcham kattalashganda quasi-quadratic o‘sishga mosdir. Shunga qaramay CC-MM natijalarida transpozitsiya nazariy jihatdan matritsa ko‘paytirishidan past murakkablikka ega bo‘lsa ham sinov o‘lchamlarida vaqtning muhim qismini tashkil qiladi.
Nega “lightweight” transpozitsiya ishlab chiqildi?
Dastlabki C-MT yondashuvi \(N\) avtomorfizm uchun \(N\) switching key talab qiladi va kalitlar umumiy hajmi katta bo‘lishi mumkin. Shu sabab faqat uchta switching key ishlatadigan yengil metod ishlab chiqilgan. Bunda bitta avtomorfizm kaliti bajarilish vaqtida yangilanib turli o‘zgartirishlar uchun qayta ishlatiladi; asimptotik murakkablik \(\widetilde{O}(N^2)\) bo‘lib qoladi.
Ciphertext–ciphertext matritsa ko‘paytirishi qanday keltiriladi?
Ikkala matritsa ham shifrlangan bo‘lsa, muammo plaintext–ciphertext holatidan qiyinroq. Algorithm 8 ikki RLWE ciphertext matritsani mos satr va ustun formatlariga o‘tkazib, ko‘paytirishni to‘rt standart modular plaintext matritsa ko‘paytirishiga ajratadi. Katta kvadrat \(N\times N\) matritsalar uchun natija 4 ta Mod-PP-MM, 3 ta C-MT, \(\widetilde{O}(N^2)\) qo‘shimcha amal, relinearization va rescalingdan iborat.
RGSW asosidagi umumiy metod nimani beradi?
RLWE asosidagi Algorithm 8 katta kvadrat matritsalarda samarali, ammo o‘lcham moslashuvchanligi cheklangan. Umumiy foydalanish uchun RGSW-ga o‘xshash matritsa shifrlash shakli kengaytiriladi. Yondashuv RGSW × RLWE tashqi ko‘paytmasini matritsa-vektor darajasiga olib chiqadi va turli halqa darajalari, o‘lchamlar hamda RLWE/MLWE/shared-a shakllaridagi ma’lumotlarni birga ishlashga imkon beradi.
Umumiy CC-Mv algoritmining asosiy amali \[ a'= \left\lfloor \frac{A_1a+A_0b}{p} \right\rceil \] va \[ b'= \left\lfloor \frac{B_1a+B_0b}{p} \right\rceil \] ko‘rinishidadir. Yordamchi \(p\) moduli shifrlash xatolarining matritsa ko‘paytirishda nazoratsiz kattalashishini cheklash uchun ishlatiladi.
Xato va aniqlik qanday ko‘riladi?
CKKS taxminiy hisoblashni bajargani uchun faqat vaqt emas, natija aniqligi ham muhim. Algorithm 9 uchun xato yuqori chegarasi chiqariladi va mos scaling bilan kutiladigan aniqlik yo‘qotishi matritsa o‘lchamiga logarifmik bog‘liq bo‘lishi mumkinligi ko‘rsatiladi. Tajribalarda Algorithm 6 taxminan 13,4–14,0 bit, Algorithm 8 taxminan 8,3–9,1 bit, RGSW asosidagi Algorithm 9 taxminan 17,2–17,5 bit aniqlik beradi. Bu farq modul byudjeti, key-switching soni va ayrim hisoblarning kattaroq \(pq\) modulida bajarilishi bilan bog‘liq.
Modular matritsa ko‘paytirishi BLAS-ga qanday aylantiriladi?
Nazariy keltirish modular plaintext matritsa ko‘paytirishiga yetadi. Standart BLAS esa ikki aniqlikli floating-point arifmetikasidan foydalanadi. Mualliflar uch strategiyani ishlab chiqadi.
Strategiya 1: Sonlarni bo‘laklarga ajratish
IEEE-754 double arifmetikasida \(2^{53}\) dan kichik butun sonlar aniq ifodalanishi sababli katta butun sonlar kichik bloklarga bo‘linadi, har blok BLAS bilan aniq ko‘paytiriladi va natija birlashtiriladi.
Strategiya 2: Truncation
CKKS taxminiy tizim bo‘lgani uchun ayrim hollarda ciphertextning past ahamiyatli bitlari tashlab yuboriladi va yuqori ahamiyatli qism double arifmetikada ishlanadi. Bu tezroq, ammo nazoratli qo‘shimcha sonli xato keltiradi.
Strategiya 3: Modulus switching va CRT
Ciphertext moduli kichik modullar ko‘paytmasiga o‘tkaziladi, har kichik modulda matritsa ko‘paytirishi BLAS-ga keltiriladi va natija Xitoy qoldiqlar teoremasi (CRT) bilan qayta birlashtiriladi.
Ishning sun’iy intellekt bilan aloqasi nima?
Transformer arxitekturalarida attention va feed-forward qatlamlari katta matritsa ko‘paytirishlarini o‘z ichiga oladi. Maxfiylikni saqlovchi inference holatida model vaznlari ochiq matn, foydalanuvchi kirishi yoki aktivatsiyasi shifrlangan bo‘lishi mumkin. Shunda CP-MM bevosita muhim bo‘ladi. Ish GPT, BERT, LLaMA kabi oilalarni misol qilib muhokama qiladi; biroq uchdan-uchgacha GPT, BERT yoki LLaMA modeli ishga tushirilmagan.
Tadqiqot qo‘llab-quvvatlaydigan natijalar
- CKKS/RLWE asosidagi ayrim katta shifrlangan chiziqli algebra amallari standart plaintext matritsa ko‘paytirishlariga keltiriladi.
- CP-MM mos shifrlash shaklida ikki Mod-PP-MM-ga, oldindan hisoblash bo‘lsa onlayn bosqichda bitta PP-MM-ga keltiriladi.
- Katta kvadrat CC-MM to‘rt Mod-PP-MM va uch tez shifrlangan transpozitsiyaga ajratiladi.
- Yangi C-MT algoritmi \(\widetilde{O}(N^2)\) arifmetik murakkablikka ega.
- Shared-a shakli katta matritsalarda hisoblash xarajatini kamaytiradi.
- RGSW yondashuvi kengroq matritsa o‘lchami va shifrlash formati kombinatsiyalarini qo‘llab-quvvatlaydi.
- BLAS-dan foydalanish homomorfik matritsa hisoblarini mavjud yuqori unumli chiziqli algebra infratuzilmasiga bog‘laydi.
- Ayrim katta kvadrat matritsa ssenariylarida homomorfik va double-precision ochiq matritsa ko‘paytirishi orasidagi farq taxminan 4–12 marta darajasigacha tushirilgani bildiriladi.
Tadqiqot qo‘llab-quvvatlamaydigan yoki sinamagan natijalar
- Har bir gomomorfik amal plaintext hisobdan faqat 4–12 marta sekin degan xulosa chiqarilmaydi.
- Barcha matritsa o‘lchamlarida bir xil tezlashuv ko‘rsatilmagan.
- GPU ustida tajriba vaqt o‘lchovi berilmagan.
- Ko‘p oqimli BLAS asosiy jadval natijasi sifatida berilmagan; taqqoslashlar bitta oqimli CPU muhitida.
- Uchdan-uchgacha xususiy LLM inference vaqti o‘lchanmagan.
- Real sog‘liqni saqlash, moliya yoki smart-contract ilovasida dala baholashi yo‘q.
- Algorithm 8 yoki Algorithm 9 barcha ilovalar uchun universal eng yaxshi tanlov ekanligi ko‘rsatilmagan.
Tadqiqot metodi va natijalari
Asosiy algoritmik keltirishlar
| Vazifa | Asosiy yondashuv | Plaintext chiziqli algebra keltirishi | Muhim shart / izoh |
|---|---|---|---|
| CP-MM / CP-Mv | RLWE, shared-a yoki MLWE | 1 yoki 2 PP-MM / PP-Mv | O‘lcham va oldindan hisoblashga bog‘liq |
| Oldindan hisoblangan CP-MM | Structured-A shared-a | Onlayn bosqichda 1 PP-MM | Ochiq matritsa oldindan ma’lum va qayta ishlatilishi kerak |
| PC-MM | C-MT + CP-MM + C-MT | CP-MM keltirishiga tayangan | Kvadrat matritsalarda qo‘llanadi |
| CC-MM Algorithm 8 | RLWE + C-MT | 4 Mod-PP-MM | Katta kvadrat matritsalar uchun |
| CC-Mv / umumiy CC-MM | RGSW × RLWE tashqi ko‘paytma | Bir nechta Mod-PP-Mv/MM | Moslashuvchanroq; doimiy xarajat yuqoriroq |
Verianla Live: Shifrlangan matritsa amali BLAS-ga qanday keltiriladi?
Bu jarayon ishning umumiy hisoblash fikrini ko‘rsatadi. Shifrlangan ma’lumot hech qachon foydalanuvchi xabari sifatida ochiq matnga yechilmaydi; BLAS ishlaydigan tuzilmalar homomorfik ciphertextning algebraik komponentlaridan hosil qilingan matritsalardir.
| Bosqich | Amal | Ilmiy ma’nosi |
|---|---|---|
| 1 | CKKS/RLWE shifrlangan matritsa | Xabar matritsasi ciphertext komponentlari ichida saqlanadi. |
| 2 | Matritsa ko‘rinishida qayta ifodalash | Shifrlash munosabati S* A + B ≈ ΔM ko‘rinishiga o‘tadi. |
| 3 | Mos ciphertext formati | O‘lchamga ko‘ra RLWE, shared-a, MLWE yoki RGSW ishlatiladi. |
| 4 | Gomomorfik muammoni keltirish | Shifrlangan MM/Mv standart modular plaintext MM/Mv amallariga ajratiladi. |
| 5 | Modular amalni BLAS-ga aylantirish | Bo‘laklash, truncation yoki modulus switching + CRT qo‘llanadi. |
| 6 | OpenBLAS dgemm / dgemv | Hisobning katta qismi yuqori unumli standart chiziqli algebra rutinlarida bajariladi. |
| 7 | Rescale / Relin / format o‘zgartirish | Natija mos CKKS ciphertext formati va scale qiymatiga keltiriladi. |
| 8 | Shifrlangan natija | Natija keyingi FHE amallarida ishlatilishi uchun shifrlangan holda qoladi. |
Tajriba muhiti
| Tajriba komponenti | Ishlatilgan tuzilma |
|---|---|
| Gomomorfik shifrlash kutubxonasi | HEaaN |
| BLAS implementatsiyasi | OpenBLAS 0.3.26 |
| CPU | Intel Xeon Gold 6342 @ 2,80 GHz |
| Oqim | 1 |
| Takror | Har vaqt 10 ishga tushirishning o‘rtachasi |
| Xavfsizlik maqsadi | Lattice estimator bo‘yicha taxminan 128 bit |
| Kirish matritsalari | Elementlari [−1, 1] intervalida mustaqil uniform tanlangan matritsalar |
Algorithm 6: plaintext–ciphertext matritsa ko‘paytirishi
Algorithm 6 tajribalarida A komponenti Strategy 1 bilan uchta floating-point PP-MM chaqiruviga, B komponenti Strategy 2 bilan bitta PP-MM chaqiruviga keltirilgan. Rescaling vaqti e’tiborsiz darajada deb topilgani uchun Tablo 9 faqat Mod-PP-MM hisoblarini beradi.
| O‘lcham d1 × d2 × d3 | A komponenti (s) | B komponenti (s) | Jami (s) | Eng yomon aniqlik (bit) |
|---|---|---|---|---|
| 212 × 212 × 1 | 0,178 | 0,249 | 0,427 | 13,5 |
| 212 × 212 × 26 | 0,253 | 0,270 | 0,523 | 13,5 |
| 212 × 212 × 212 | 5,00 | 1,78 | 6,78 | 13,4 |
| 213 × 213 × 1 | 0,402 | 1,20 | 1,60 | 13,8 |
| 213 × 213 × 27 | 0,699 | 1,42 | 2,12 | 13,6 |
| 213 × 213 × 213 | 19,1 | 13,3 | 32,4 | 13,7 |
| 214 × 214 × 1 | 0,914 | 6,19 | 7,10 | 14,0 |
| 214 × 214 × 27 | 1,45 | 6,74 | 8,19 | 13,5 |
| 214 × 214 × 214 | 73,7 | 102 | 176 | 13,5 |
Algorithm 8: katta kvadrat ciphertext–ciphertext matritsa ko‘paytirishi
Verianla Live: Algorithm 8 ish vaqti matritsa kattalashganda qanday o‘zgaradi?
Ma’lumotlar Tablo 10 natijalaridir. Vaqtlar bitta oqimli Intel Xeon Gold 6342 ustida 10 ishga tushirishning o‘rtachasi.
| Kvadrat matritsa o‘lchami | Transpozitsiya (s) | Mod-PP-MM (s) | Relinearization (s) | Rescale (s) | Jami (s) | Aniqlik (bit) |
|---|---|---|---|---|---|---|
| 2^12 × 2^12 | 16,8 | 22,1 | 1,17 | 1,07 | 41,2 | 9,1 |
| 2^13 × 2^13 | 73,6 | 162 | 5,17 | 4,81 | 245 | 8,8 |
| 2^14 × 2^14 | 352 | 1300 | 24,0 | 21,0 | 1710 | 8,3 |
Algorithm 9: RGSW asosidagi umumiy yondashuv
| O‘lcham d1 × d2 × d3 | Halqa darajasi | Mod-PP-MM vaqti (s) | Eng yomon aniqlik (bit) |
|---|---|---|---|
| 212 × 212 × 1 | 212 | 0,882 | 17,5 |
| 212 × 212 × 26 | 212 | 1,44 | 17,4 |
| 212 × 212 × 212 | 212 | 42,6 | 17,4 |
| 213 × 213 × 1 | 213 | 4,35 | 17,2 |
| 213 × 213 × 26 | 213 | 6,47 | 17,3 |
| 213 × 213 × 213 | 213 | 291 | 17,3 |
| 214 × 214 × 1 | 213 | 10,5 | 17,4 |
| 214 × 214 × 27 | 213 | 19,0 | 17,4 |
| 214 × 214 × 214 | 213 | 1270 | 17,4 |
Algorithm 8 va Algorithm 9 taqqoslanganda nima ko‘rinadi?
Kvadrat \(2^{14}\) matritsa tajribasida Algorithm 8 ning Mod-PP-MM qismi taxminan 1300 soniya, Algorithm 9 ning mos qismi taxminan 1270 soniyadir. Mualliflar buni shared-a tufayli Algorithm 9 turli o‘lchamdagi BLAS chaqiruvlariga ajralishi bilan izohlaydi. Ammo Algorithm 9 ning umumiyligi bepul emas: RGSW formatini tayyorlash va konvertatsiyalar ayniqsa kichik chiqishli matritsa-vektor masalalarida muhim xarajat bo‘lishi mumkin.
4–12 marta da’vosi qanday o‘qilishi kerak?
Maqola xulosasidagi asosiy performans xabari ayrim katta kvadrat matritsa holatlarida CKKS asosidagi shifrlangan matritsa ko‘paytirishi bilan ikki aniqlikli floating-point matritsa ko‘paytirishi orasidagi samaradorlik farqi taxminan 4–12 marta darajasigacha tushirilishi mumkinligidir. Bu barcha gomomorfik dasturlar, format konvertatsiyalari, bootstrapping bosqichlari yoki uchdan-uchgacha AI modellari plaintext hisoblashga nisbatan faqat 4–12 marta sekin degani emas.
Tadqiqotning kuchli tomonlari
- Nazariy algoritm va haqiqiy HEaaN/OpenBLAS implementatsiyasini birlashtiradi.
- Turli halqa o‘lchamlari uchun shifrlash formatlari ishlab chiqadi.
- Shifrlangan hisobni BLAS kabi pishgan hisoblash infratuzilmasiga bog‘laydi.
- Xato tahlili va hisoblash murakkabligini birga ko‘radi.
- Shifrlangan transpozitsiya uchun quasi-quadratic algoritm beradi.
- Xavfsizlik, aniqlik va vaqtni birga hisobot qiladi.
Asosiy metodologik cheklovlar
- Asosiy tajribalar bitta oqimli Intel Xeon CPU da bajarilgan.
- GPU vaqtlari berilmagan.
- Test matritsalari real ilova ma’lumotidan emas, [−1,1] uniform taqsimotidan olingan.
- Ish uchdan-uchgacha transformer yoki LLM inference benchmarki emas.
- Format konvertatsiyasi ayrim Mv va kichik \(d_3\) masalalarida asosiy hisobga yaqin xarajatga ega bo‘lishi mumkin.
- Oldindan hisoblashning foydasi faqat bir xil plaintext matritsa qayta ishlatilganda amortizatsiya qilinadi.
Manba va metod eslatmasi
To‘liq asl ish nomi: Fast Homomorphic Linear Algebra with BLAS
Mualliflar: Youngjin Bae, Jung Hee Cheon, Guillaume Hanrot, Jai Hyun Park va Damien Stehlé.
Mas’ul muallif: Jai Hyun Park.
Muassasalar: CryptoLab Inc., Seoul, Republic of Korea; Seoul National University, Seoul, Republic of Korea; CryptoLab Inc., Lyon, France.
Rasmiy jurnal: Journal of Cryptology.
Nashriyot: Springer Nature.
Bibliografik ma’lumot: Journal of Cryptology, 2026, jild 39, maqola 25; Volume 39, Issue 3.
DOI:10.1007/s00145-026-09580-x
Rasmiy nashr sanasi: 12 may 2026.
Yuklangan versiya: arXiv:2503.16080v2 [cs.CR], 27 aprel 2026.
Manba turi va hakamlik holati: Yuklangan fayl arXiv muallif versiyasi, ammo ish Journal of Cryptology jurnalida rasmiy maqola sifatida chop etilgan.
Litsenziya/mualliflik huquqi: Yuklangan versiyada CC BY kabi ochiq qayta foydalanish litsenziyasi ko‘rsatilmagan; shu sabab Verianla matnida original figuralar aynan ko‘chirilmagan.
Implementatsiya: Algorithm 2, 4, 6, 8 va 9 qismlari HEaaN ustida amalga oshirilgan; plaintext chiziqli algebra uchun OpenBLAS 0.3.26 ishlatilgan.
Tajriba chegarasi: Vaqt o‘lchovlari Intel Xeon Gold 6342 2,80 GHz protsessorda bitta oqim bilan olingan va har biri 10 ishga tushirishning o‘rtachasi. GPU natijasi yo‘q.
Xavfsizlik chegarasi: Parametrlar lattice estimator bo‘yicha taxminan 128 bit xavfsizlikni qo‘llaydi; boshqa CKKS parametrlarini alohida baholash kerak.
Aniqlik chegarasi: CKKS taxminiy gomomorfik shifrlash bo‘lgani uchun natijalar exact arithmetic sifatida qaralmasligi kerak.
Performans chegarasi: 4–12 marta farq muayyan katta kvadrat matritsa va BLAS keltirish shartlariga tegishli; barcha FHE dasturlariga yoki uchdan-uchgacha AI modellariga kengaytirilmaydi.
Ilmiy mazmun chegarasi: Bu Verianla maqolasidagi texnik topilmalar, algoritmlar, vaqtlar, aniqlik qiymatlari va qo‘llash sharhlari ko‘rib chiqilgan ishga asoslangan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan