

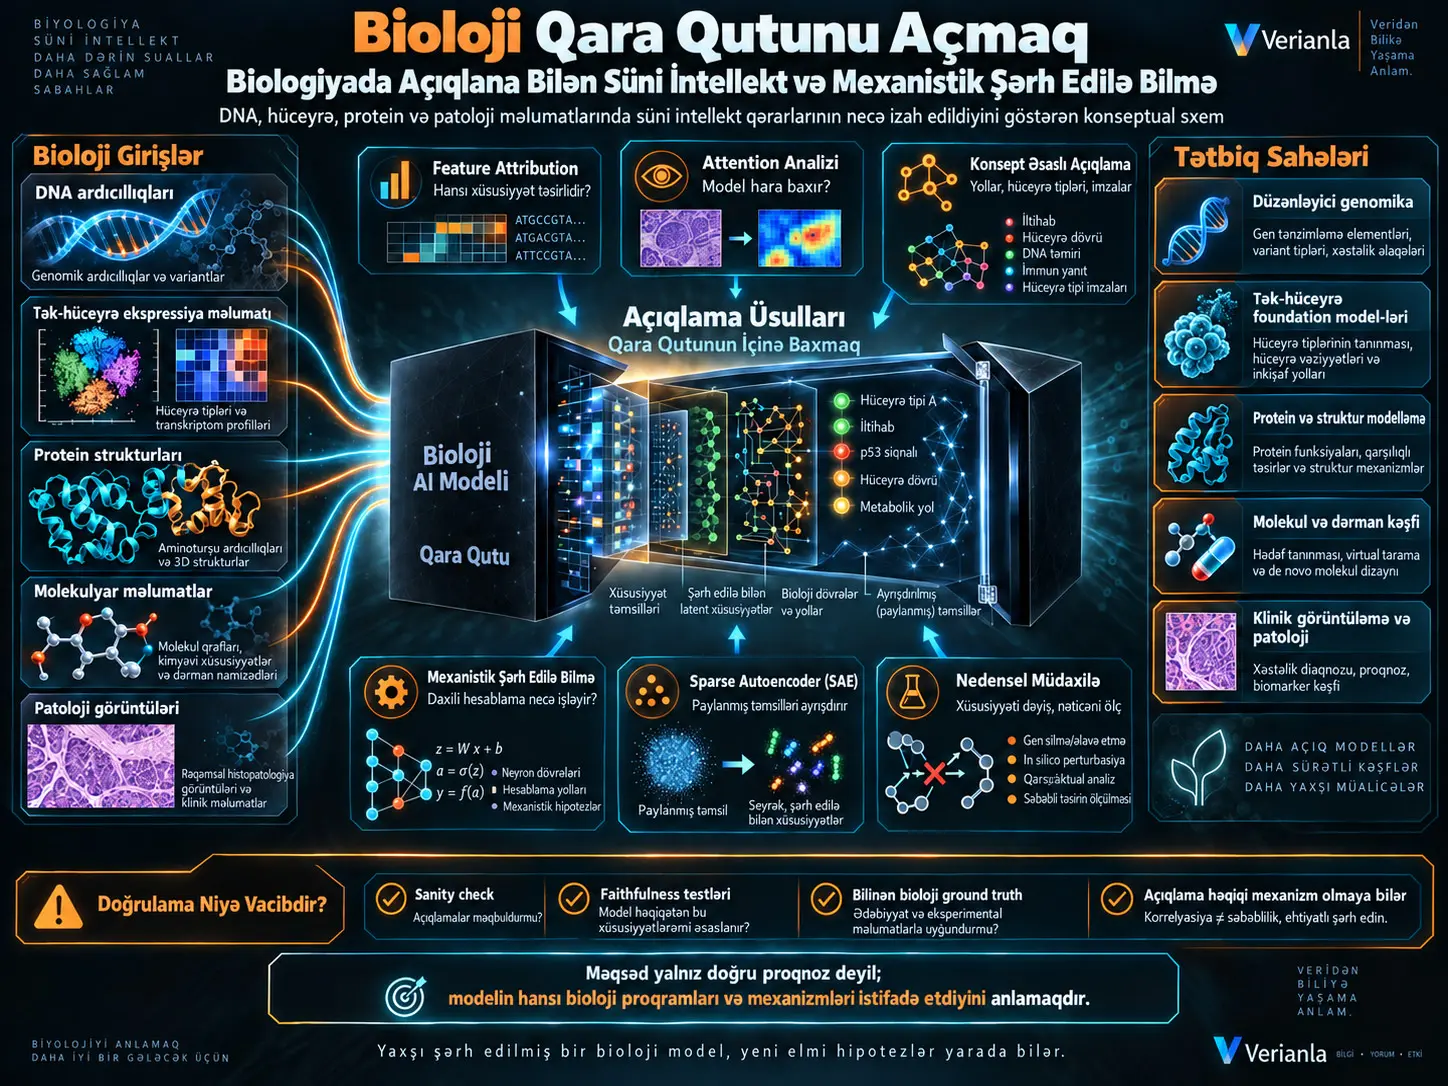
Açıqlana bilən süni intellekt (Explainable Artificial Intelligence, XAI), süni intellekt modelinin proqnoz və ya qərarlarının hansı girişlərə, anlayışlara və ya daxili hesablamalara əsaslandığını insanlar tərəfindən araşdırıla bilən hala gətirməyə çalışan üsullar toplusudur. Olivia Denvisin survey işi biologiyada istifadə olunan izah üsullarını feature attribution, attention analizi, concept-based explanation və mechanistic interpretability oxları üzrə; tətbiqləri isə genomika, tək-hüceyrə foundation modelləri, protein modelləşdirməsi, dərman kəşfi və biotibbi görüntüləmə sahələrində təsnif edir. Survey-nin əsas vurğusu ondan ibarətdir ki, bioloji süni intellekt tədqiqatları yalnız düzgün proqnoz verən modellərdən, modelin daxilində hansı bioloji proqramların və hesablama mexanizmlərinin yarandığını araşdıran yanaşmalara doğru irəliləyir.
Bu dəyişiklikdə sparse autoencoder-lər (SAE) xüsusilə önəm qazanmışdır. SAE-lər böyük süni neyron şəbəkələrinin bir-birinə qarışmış daxili təmsillərini daha seyrək və şərh edilə bilən xüsusiyyətlərə ayırmağı hədəfləyir. Survey bu üsulun dil modellərindən bioloji foundation modellərinə daşınmasının; hüceyrə tipi, gen proqramı və ya histoloji quruluş kimi bioloji anlayışların paylanmış embedding-lər içindən ayrışdırılmasına yönələn yeni bir tədqiqat xətti yaratdığını önə çıxarır.
İş eyni zamanda mühüm bir xəbərdarlıq edir: izahın vizual baxımdan inandırıcı olması onun həqiqətən modelin qərar mexanizmini təmsil etdiyi anlamına gəlmir. Attention xəritələri, saliency map-ləri və ya feature attribution dəyərləri modeldən asılı olmayan örüntülər, girişin öz həndəsəsi və ya korrelyasiyalar səbəbilə yanıltıcı ola bilər. Buna görə bioloji XAI-nin məqsədi yalnız izah yaratmaq deyil, izahın model davranışına həqiqətən bağlı olduğunu faithfulness testləri, sanity check-lər və mümkün olduqda müdaxilə təcrübələri ilə doğrulamaqdır.
Niyə biologiyada süni intellektin qara qutu olması xüsusi problemdir?
Bir çox mühəndislik tətbiqində modelin məqsədi düzgün qərar vermək ola bilər. Biologiyada isə model çox vaxt birbaşa elmi anlama vasitəsidir. Bioloq yalnız bir DNA ardıcıllığının tənzimləyici olduğunu öyrənmək istəmir; hansı nukleotidlərin təsirli olduğunu, hansı motivin transkripsiya faktorunun bağlanmasını yönəltdiyini və gen ifadəsinin hansı mexanizm vasitəsilə dəyişdiyini də bilmək istəyir.
Eyni vəziyyət proteinlər, hüceyrələr və molekullar üçün də keçərlidir. Protein modeli düzgün quruluşu proqnozlaşdıra bilər; lakin hansı amin turşusu əlaqələrinin modeli bu quruluşa apardığı ayrıca elmi sualdır. Tək-hüceyrə modeli hüceyrə tipini düzgün təsnif edə bilər; ancaq qərarın həqiqətən bioloji gen proqramına, yoxsa texniki batch effektinə əsaslandığı bilinmirsə, model elmi baxımdan yanıltıcı ola bilər.
Survey buna görə biologiyada açıqlana bilmənin yalnız etibar və ya istifadəçi təcrübəsi məsələsi olmadığını, birbaşa elmi hipotez yaradılması ilə əlaqəli olduğunu müdafiə edir.
Biologiyada Açıqlana Bilən Süni İntellekt Nə Etməyə Çalışır?
Bioloji XAI model çıxışının hansı bioloji girişlərlə, təmsil olunan anlayışlarla və ya daxili hesablama prosesləri ilə əlaqəli olduğunu müəyyənləşdirərək proqnozu bioloji baxımdan mənalandırıla bilən izaha çevirməyə çalışır; lakin belə bir izahın elmi dəyər daşıması üçün onun model davranışına həqiqətən faithful olduğu ayrıca doğrulanmalıdır.
Intrinsic və post-hoc izah
Survey iki əsas yanaşmanı bir-birindən ayırır. Intrinsic interpretability, modelin öz quruluşunun anlaşılan olmasıdır. Seyrək xətti modellər, qısa qərar siyahıları və ya bioloji cəhətdən mənalandırılmış latent dəyişənlərə sahib arxitekturalar buna nümunə ola bilər.
Post-hoc explanation isə mürəkkəb və birbaşa oxunmayan model öyrədildikdən sonra onun davranışını izah etmək üçün əlavə üsullardan istifadə edir. SHAP, Integrated Gradients və ya Grad-CAM kimi üsullar bu sinfə daxildir.
Post-hoc yanaşma güclü modellərin araşdırılmasını mümkün edir; lakin izah modelin özü deyil, model haqqında sonradan hesablanan obyektdir. Buna görə izahın modelin real qərar məntiqinə sadiq olub-olmadığı ayrıca sınanmalıdır.
Local və global izah
Bir local explanation, tək bir model çıxışına fokuslanır. Məsələn, müəyyən DNA ardıcıllığının niyə enhancer kimi təsnif edildiyini və ya müəyyən hüceyrənin niyə T hüceyrəsi kimi tanındığını izah etməyə çalışır.
Global explanation isə modelin ümumi davranışını araşdırır. Məsələn, genom boyunca modelin davamlı olaraq hansı motivlərdən istifadə etdiyi və ya protein modeli daxilində müəyyən attention head-lərin ümumilikdə hansı struktur əlaqələrini təmsil etdiyi araşdırıla bilər.
Feature attribution
Feature-attribution üsulları model çıxışındakı dəyişikliyin hansı giriş xüsusiyyətləri ilə əlaqəli olduğunu ballandırmağa çalışır. Biologiya baxımından bu yanaşma xüsusilə təbiidir; çünki giriş xüsusiyyətlərinin özləri çox vaxt fiziki və ya bioloji vahidlərdir:
- DNA modelində nukleotid,
- tək-hüceyrə modelində gen,
- protein modelində amin turşusu qalığı,
- molekul modelində atom və ya rabitə,
- histopatologiya modelində piksel və ya görüntü bölgəsi.
Survey-nin nəzərdən keçirdiyi əsas feature-attribution üsulları LIME, SHAP, Integrated Gradients, DeepLIFT, Layer-wise Relevance Propagation və Grad-CAM-dir.
| Üsul ailəsi | Əsas sual | Tipik çıxış | Bioloji istifadə forması |
|---|---|---|---|
| LIME | Bu tək proqnozun ətrafında hansı xüsusiyyətlər təsirlidir? | Yerli surrogate model | Müəyyən nümunənin xüsusiyyət töhfələri |
| SHAP | Hər xüsusiyyətin proqnoza marjinal töhfəsi nədir? | Shapley əsaslı əhəmiyyət dəyərləri | Gen, klinik xüsusiyyət və ya molekulyar xüsusiyyət atribusiyası |
| Integrated Gradients | Girişdən çıxışa gradient boyunca hansı xüsusiyyətlər töhfə verir? | Giriş üzrə attribution | Nukleotid, amin turşusu və ya görüntü pikseli əhəmiyyət xəritəsi |
| DeepLIFT | Aktivləşmə referansa görə necə dəyişir? | Töhfə balları | Xüsusilə genomik motiv analizi |
| Grad-CAM | Görüntünün hansı bölgələri sinif balını dəstəkləyir? | İstilik xəritəsi | Histopatologiya və tibbi görüntüləmə |
| TCAV | Model insan tərəfindən müəyyənləşdirilmiş anlayışa həssasdırmı? | Concept activation istiqaməti | Yolak, hüceyrə tipi və ya bioloji imza analizi |
| Sparse Autoencoder | Paylanmış daxili təmsillər hansı seyrək xüsusiyyətlərə ayrıla bilər? | Şərh edilə bilən latent xüsusiyyətlər | Foundation model daxilində hüceyrə tipi və ya toxuma proqramlarının ayrışdırılması |
Niyə Attention Çəkiləri Təkbaşına İzah Sayılmır?
Attention çəkiləri modelin müəyyən tokenlər arasında hansı məlumat yollarına ağırlıq verdiyini göstərə bilər, lakin eyni model çıxışının fərqli attention paylanmaları ilə yaradıla bilməsi səbəbilə yüksək attention dəyəri təkbaşına səbəbli və ya faithful izah deyil; buna görə biologiyada attention xəritələri doğrulanmalı hipotezlər kimi qəbul edilməlidir.
Bu fərq protein modelləri baxımından xüsusilə vacibdir. Protein ardıcıllığındakı tokenlər amin turşularını təmsil etdikdə bir attention head-in müəyyən qalıqlara yüksək ağırlıq verməsi bioloji baxımdan cəlbedici görüntü yarada bilər. Lakin bunun həqiqətən bağlanma interfeysi, təmas bölgəsi və ya funksional motiv mənasına gəldiyi yalnız müstəqil struktur məlumatla müqayisə edilərək göstərilə bilər.
Survey protein dil modellərinə dair işlərdə müəyyən attention head-lərin struktur təmaslar, bağlanma bölgələri və post-translational modification bölgələri ilə əlaqəsinin kəmiyyət müqayisələri vasitəsilə araşdırıldığını nümunə kimi göstərir. Əsas metodoloji dərs attention vizuallaşdırmasının nəticə deyil, başlanğıc nöqtəsi olmasıdır.
Anlayış-əsaslı izahlar
Tək nukleotid və ya gen səviyyəsindəki attribution bioloqun düşündüyü anlayış miqyasından daha aşağı ola bilər. Tədqiqatçı çox vaxt “hansı gen?” əvəzinə “hansı yolak?”, “hansı hüceyrə proqramı?” və ya “hansı bioloji proses?” sualını verir.
Concept-based üsullar model aktivləşmələrinin insan tərəfindən müəyyənləşdirilmiş yüksək səviyyəli anlayışlarla əlaqəsini araşdırmağı hədəfləyir. Survey-nin nəzərdən keçirdiyi Testing with Concept Activation Vectors (TCAV), müəyyən anlayış üçün aktivləşmə fəzasında istiqamət öyrənir və model proqnozlarının bu istiqamətə həssaslığını ölçür.
Biologiya bu yanaşma üçün zəngin sahə təqdim edir; çünki gen setləri, hüceyrə tipi imzaları, molekulyar yolaklar və funksional ontologiyalar insanlar tərəfindən əvvəlcədən müəyyənləşdirilmiş anlayış lüğətləri yaradır.
Mekanistik Şərh Edilə Bilmə Feature Attribution-dan Necə Fərqlənir?
Feature attribution proqnozun hansı girişlərlə əlaqəli olduğunu soruşduğu halda mechanistic interpretability modelin daxili aktivləşmələri və çəkiləri içində hansı xüsusiyyətlərin təmsil edildiyini, bu xüsusiyyətlərin hansı bağlantılar üzərindən birləşdiyini və müəyyən çıxışı yaratmaq üçün hansı hesablama dövrələrinin işlədiyini çözməyə çalışır.
Buna görə mexanistik şərh edilə bilmə modeli kənardan sorğulamaq əvəzinə onun daxili quruluşunu tərs mühəndislik obyektinə çevirir. Məqsəd yalnız “bu gen vacibdir” demək deyil, modelin müəyyən hüceyrə proqramını hansı latent təmsildə kodladığını və bu təmsilin sonrakı qatlarda hansı hesablamaya təsir etdiyini müəyyənləşdirməkdir.
Superposition problemi
Müasir neyron şəbəkələrində tək nöronun yalnız bir insan-anlamlı xüsusiyyəti təmsil etdiyi fərziyyəsi çox vaxt keçərli deyil. Şəbəkə malik olduğu fiziki nöron sayından daha çox xüsusiyyəti üst-üstə düşən istiqamətlərdə kodlaya bilər. Survey bu vəziyyəti superposition anlayışı ilə izah edir.
Nəticədə tək nöron bir neçə anlayışla əlaqəli ola bilər və birbaşa “bu nöron T hüceyrəsini təmsil edir” şəklində şərhlər yanıltıcı ola bilər.
Sparse Autoencoder Bioloji Foundation Modellərində Nə Təmin Edir?
Sparse autoencoder sıx və üst-üstə düşən model aktivləşmələrini daha geniş, lakin seyrək aktivləşən xüsusiyyət lüğətinə ayırmağa çalışaraq ayrı-ayrı latent xüsusiyyətlərin müəyyən hüceyrə tipləri, gen proqramları və ya histoloji quruluşlar kimi bioloji anlayışlarla uyğunlaşdırılmasını asanlaşdırır.
SAE yanaşmasında modelin öz parametrləri əvəzinə müəyyən ara qat aktivləşmələri analiz edilir. Autoencoder bu aktivləşmələri daha yüksək ölçülü feature dictionary üzərindən yenidən qurmağı öyrənir; sparsity məhdudiyyəti eyni nümunədə yalnız az sayda xüsusiyyətin güclü aktivləşməsini təşviq edir.
Survey-nin xüsusilə vurğuladığı inkişaf bu üsulun böyük dil modeli şərh edilə bilməsindən bioloji foundation modellərinə daşınmasıdır. Mənbə patoloji foundation modellərində histoloji quruluşlarla və tək-hüceyrə foundation model təmsillərində hüceyrə tipi proqramları ilə əlaqələndirilə bilən sparse xüsusiyyətlərin bildirildiyi işləri müzakirə edir.
Bunun elmi əhəmiyyəti yalnız latent xüsusiyyətlərə ad vermək deyil. Əgər müəyyən SAE xüsusiyyəti aktivləşdirilərək və ya basdırılaraq model çıxışı sistematik şəkildə dəyişdirilə bilirsə, izah korrelyasiyadan müdaxilə səviyyəsinə yaxınlaşır.
Tənzimləyici genomika
Genomika XAI-nin biologiyada erkən istifadə olunduğu sahələrdən biridir. DNA ardıcıllıqları birbaşa model girişi olduqda hər nukleotid və ya motiv üzərində attribution hesablaması aparmaq mümkündür.
Survey DeepBind, DeepSEA, Basset, ExPecto, BPNet və Enformer kimi model ailələrini bu inkişaf xətti daxilində müzakirə edir. Xüsusilə base-resolution modellərlə DeepLIFT və motiv kəşfi üsullarının birləşdirilməsi yalnız məlum motivlərin yenidən tapılmasını deyil, motivlərin birlikdə necə təşkil olunduğuna dair hipotezlərin yaradılmasını da mümkün etmişdir.
Tək-hüceyrə foundation modelləri
Geneformer, scGPT, scFoundation və Universal Cell Embeddings kimi modellər milyonlarla hüceyrədən öyrənilmiş paylanmış təmsillər yaradır. Bu embedding-lər hüceyrə tipi təsnifatı və perturbation prediction kimi downstream tapşırıqlarda istifadə oluna bilər; lakin embedding ölçüsünün bioloji olaraq nəyi təmsil etdiyi çox vaxt birbaşa məlum deyil.
Survey-yə görə mexanistik şərh edilə bilmənin biologiyaya daşınmasının ən aydın nümunələrindən biri bu sahədir. Sparse dictionary learning ilə latent xüsusiyyətlərin hüceyrə tipi və gene-set proqramları ilə uyğunlaşdırılması foundation model-in daxili təmsilini bioloqların istifadə etdiyi anlayış lüğətinə yaxınlaşdırır.
Lakin bir xüsusiyyətlə gene-set arasındakı korrelyasiya təkbaşına mexanistik nəticə deyil. Survey xüsusilə müəyyən latent xüsusiyyətlərə müdaxilə edilərək model davranışının dəyişib-dəyişmədiyinin sınanmasını daha güclü sübut standartı kimi önə çıxarır.
Protein modelləri
Protein dil modelləri yüz milyonlarla protein ardıcıllığından struktur və funksional təmsillər öyrənə bilər. Protein tokenlərinin birbaşa amin turşusu qalıqlarına uyğun gəlməsi şərh edilə bilmə baxımından xüsusi üstünlük verir.
Attention head-lərin təmas nöqtələri, bağlanma bölgələri və ya post-translational modification mövqeləri ilə uyğun gəlib-gəlmədiyi birbaşa struktur annotasiyalarla müqayisə edilə bilər. Bu xüsusiyyət protein modellərini mechanistic interpretability və sparse dictionary üsulları üçün güclü hədəfə çevirir.
Molekul və dərman kəşfi
Graph neural network-lər molekulları atom və rabitələrdən ibarət qraflar kimi emal edir. Molekulun aktivliyini izah etmək çox vaxt hansı altqrafın və ya kimyəvi qrupun proqnoza töhfə verdiyini müəyyənləşdirmək deməkdir.
Survey GNNExplainer kimi üsulların proqnozu mümkün qədər qoruyan kiçik molekulyar altqraf tapmağa çalışdığını açıqlayır. Beləliklə izah yalnız əhəmiyyət balı olmaqdan çıxıb kimyaçının araşdıra biləcəyi molekulyar motivə çevrilə bilər.
Klinik görüntüləmə və rəqəmsal patologiya
Histopatologiya və digər biotibbi görüntülərdə Grad-CAM və saliency əsaslı üsullar təsnifat qərarına təsir edən görüntü sahələrini işarələmək üçün geniş istifadə olunur.
Lakin bu sahə XAI-nin ən kritik riskini də açıq göstərir: şiş təsnifləndiricisi real histoloji xüsusiyyət əvəzinə skaner artefaktını, xəstəxana işarəsini və ya görüntüləmə protokolunu istifadə edə bilər. Vizual izah bu cür shortcut-ları aşkarlamağa kömək edə bilər; amma pis dizayn edilmiş izah üsulu eyni artefaktı bioloji siqnal kimi də göstərə bilər.
İşin Üsulu və Nəticələri
Bu iş hansı növ üsuldan istifadə etmişdir?
İş yeni eksperimental model hazırlamır. Müəllif mövcud XAI və mechanistic interpretability ədəbiyyatını konseptual taksonomiya altında birləşdirir. Survey iki müstəqil oxdan istifadə edir:
- Üsul oxu: feature attribution, attention analysis, concept-based explanation və mechanistic interpretability.
- Tətbiq oxu: genomika, tək-hüceyrə/foundation modelləri, proteinlər, molekul və dərman kəşfi, klinik görüntüləmə və patologiya.
| Sahə | Model girişi / təmsili | Tipik şərh edilə bilmə sualı | Doğrulama imkanı |
|---|---|---|---|
| Tənzimləyici genomika | DNA ardıcıllığı | Hansı nukleotid və ya motiv çıxışa təsir edir? | Məlum motivlər, bağlanma və tənzimləyici təcrübələr |
| Tək-hüceyrə biologiyası | Gen ifadəsi / hüceyrə embedding-i | Hansı gen proqramı və ya hüceyrə vəziyyəti təmsil olunur? | Gene-set, hüceyrə tipi annotasiyası və perturbation |
| Protein modelləri | Amin turşusu ardıcıllığı / internal representation | Model hansı struktur və ya funksional əlaqəni kodlayır? | Protein strukturları, təmas və bağlanma bölgələri |
| Molekul və dərman kəşfi | Atom-rabitə qrafı | Hansı alt-struktur aktivlik proqnozunu yönəldir? | Kimyəvi təcrübələr və struktur-aktivlik əlaqəsi |
| Rəqəmsal patologiya | Görüntü | Model hansı toxuma bölgələrinə əsaslanır? | Patologiya annotasiyası və klinik doğrulama |
İzahın düzgün olduğunu necə anlayırıq?
Survey-nin ən güclü metodoloji mesajlarından biri izahın ayrıca qiymətləndirilməli olmasıdır. Modelin proqnozu düzgün olsa belə, izahı yanlış ola bilər.
Mənbə üç əsas doğrulama yanaşmasını önə çıxarır:
- Sanity check: Model çəkiləri və ya etiketlər təsadüfiləşdirildikdə izah da dəyişirmi?
- Faithfulness testi: Vacib olduğu iddia edilən xüsusiyyət silindikdə və ya dəyişdirildikdə model çıxışı həqiqətən təsirlənirmi?
- Bioloji ground truth müqayisəsi: Attribution və ya model xüsusiyyəti məlum motiv, bağlanma bölgəsi, pathway və ya hüceyrə tipi annotasiyası ilə uyğun gəlirmi?
Bu yoxlamaların məqsədi izahın insan gözünə mənalı görünməsini deyil, modelin real hesablaması ilə əlaqəsini sınamaqdır.
Niyə Səbəbli Müdaxilə Daha Güclü İzah Testidir?
Səbəbli müdaxilə model daxilində müəyyən latent xüsusiyyət və ya dövrə nəzarətli şəkildə azaldıldıqda və ya gücləndirildikdə çıxışdakı dəyişikliyi ölçdüyü üçün yalnız korrelyasiyanı göstərməkdən daha güclüdür; bu yanaşma biologiyadakı perturbation təcrübəsinin məntiqini süni neyron şəbəkəsinin daxili təmsillərinə tətbiq edir.
Latent feature müəyyən hüceyrə tipi ilə korrelyasiya göstərirsə, bu təkbaşına həmin feature-ın model qərarında zəruri olduğunu sübut etmir. Xüsusiyyət söndürüldükdə hüceyrə təsnifatı və ya başqa downstream davranış sistematik şəkildə dəyişirsə, mexanistik əlaqə üçün daha güclü sübut əldə edilir.
Survey bu interventionist standartı biologiyanın eksperimental mədəniyyəti ilə xüsusilə uyğun hesab edir.
Açıq problem: bioloji ground truth natamamdır
XAI-nin biologiyadakı əsas paradokslarından biri budur: izahın düzgün olub-olmadığını yoxlamaq üçün bioloji reallığa ehtiyac var; lakin araşdırılan mexanizmin özü çox vaxt hələ tam məlum deyil.
Genom modeli naməlum bölgəni vacib göstərdikdə iki izah mümkündür:
- model həqiqətən yeni bioloji tənzimləyici elementi aşkarlamışdır;
- model verilənlər dəstindəki artefakta əsaslanır.
Yalnız attribution xəritəsinə baxaraq bu iki ehtimalı ayırmaq mümkün deyil. Yeni bioloji təcrübə və ya müstəqil doğrulama tələb oluna bilər.
Açıq problem: foundation model miqyası
Bioloji foundation modelləri böyüdükcə hər nöron və ya circuit-in insan tərəfindən ayrıca analiz edilməsi mümkün olmur. Sparse dictionary learning bu problemi qismən avtomatlaşdırmağı vəd edir; lakin survey dictionary size seçimi, tək bioloji anlayışın bir neçə sparse feature-a parçalanması və xüsusiyyətlərin circuit səviyyəsində bir-birinə bağlanması kimi problemlərin hələ həll edilmədiyini vurğulayır.
Interpretability by design
Mənbənin tədqiqat gündəmindəki başqa istiqamət modeli öyrətdikdən sonra izah etmək əvəzinə onu əvvəldən bioloji baxımdan mənalandırıla bilən latent quruluşlarla dizayn etməkdir.
Məsələn, latent dəyişənlər birbaşa pathway, hüceyrə tipi və ya biofiziki kəmiyyətlərlə məhdudlaşdırıla bilsə, post-hoc izaha ehtiyac azala bilər. Lakin bunun model dəqiqliyinə və ümumiləşdirməsinə necə təsir etdiyi ayrıca araşdırılmalıdır.
İşin dəstəklədiyi nəticələr
Survey-nin dəstəklədiyi: Bioloji XAI ədəbiyyatı sadə feature attribution-dan daha yüksək səviyyəli konseptual və mexanistik analizlərə doğru genişlənir. Sparse autoencoder və circuit analysis kimi üsulların bioloji foundation modellərinə tətbiq edilməyə başlanması model daxilindəki təmsilləri bioloji anlayışlarla əlaqələndirmək üçün yeni imkanlar açır. Bununla belə explanation faithfulness müstəqil şəkildə sınanmalıdır.
İşin dəstəkləmədiyi nəticələr
Survey-nin dəstəkləmədiyi: Hər attention map-in bioloji mexanizmi təmsil etdiyi, hər saliency map-in etibarlı olduğu, sparse autoencoder feature-larının avtomatik olaraq real bioloji varlıqlara uyğun gəldiyi və ya mechanistic interpretability-nin mövcud halıyla bioloji foundation modellərini tam həll etdiyi nəticəsinə gəlmək olmaz.
Bundan əlavə survey yeni bioloji mexanizmləri öz təcrübələri ilə kəşf etmir və istinad etdiyi bütün işlərin nəticələrini yenidən istehsal etmir.
Mənbə və Üsul Qeydi
Orijinal iş: Opening the Biological Black Box: A Survey of Explainable and Mechanistic Interpretability Methods for AI in Biology.
Müəllif: Olivia Denvis.
Affiliasiya: Independent Researcher.
Mənbə növü: Survey / SSRN preprint.
İşin tarixi: 15 iyun 2026.
SSRN yayım tarixi: 23 iyun 2026.
SSRN Abstract ID: 6968318.
DOI: 10.2139/ssrn.6968318.
Rəyçilik statusu: Mənbə rəyli jurnal məqaləsi kimi deyil, preprint kimi yayımlanmışdır.
Nəşr lisenziyası / hüquq statusu: SSRN qeydi açıq Creative Commons təkrar istifadə lisenziyası göstərmir və qorunan materialın icazəsiz təkrar istifadəsinə icazə verilmədiyini bildirir. Buna görə Verianla mətni mənbə ifadələrinin yenidən yayımı deyil; ədəbiyyat survey-sində bildirilən elmi anlayışların müstəqil öyrədici sintezidir.
Yeni təcrübə/veri: İş yeni bioloji təcrübə, verilənlər dəsti və ya benchmark yaratmır. Ədəbiyyatdakı XAI və mechanistic interpretability işlərini təsnif edir və qiymətləndirir.
Əsas metodoloji məhdudiyyət: Survey-nin ötürdüyü nəticələrin eksperimental sübutu müvafiq ilkin işlərdədir. Üsul və ya tətbiq üzrə ətraflı performans qiymətləndirməsi üçün orijinal istinada qayıdılmalıdır.
Əsas epistemik məhdudiyyət: Biologiyada ground truth qismən və mübahisəli ola bilər. Buna görə model izahının məlum biologiya ilə uyğun gəlməməsi həmişə izahın yanlış olduğunu; uyğun gəlməsi də avtomatik olaraq səbəbli mexanizm olduğunu göstərmir.
İstinad əhatəsi: Survey 44 iş üzərindən klassik XAI, bioloji deep learning tətbiqləri, foundation modelləri, mechanistic interpretability və explanation-validation ədəbiyyatını bir araya gətirir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib