

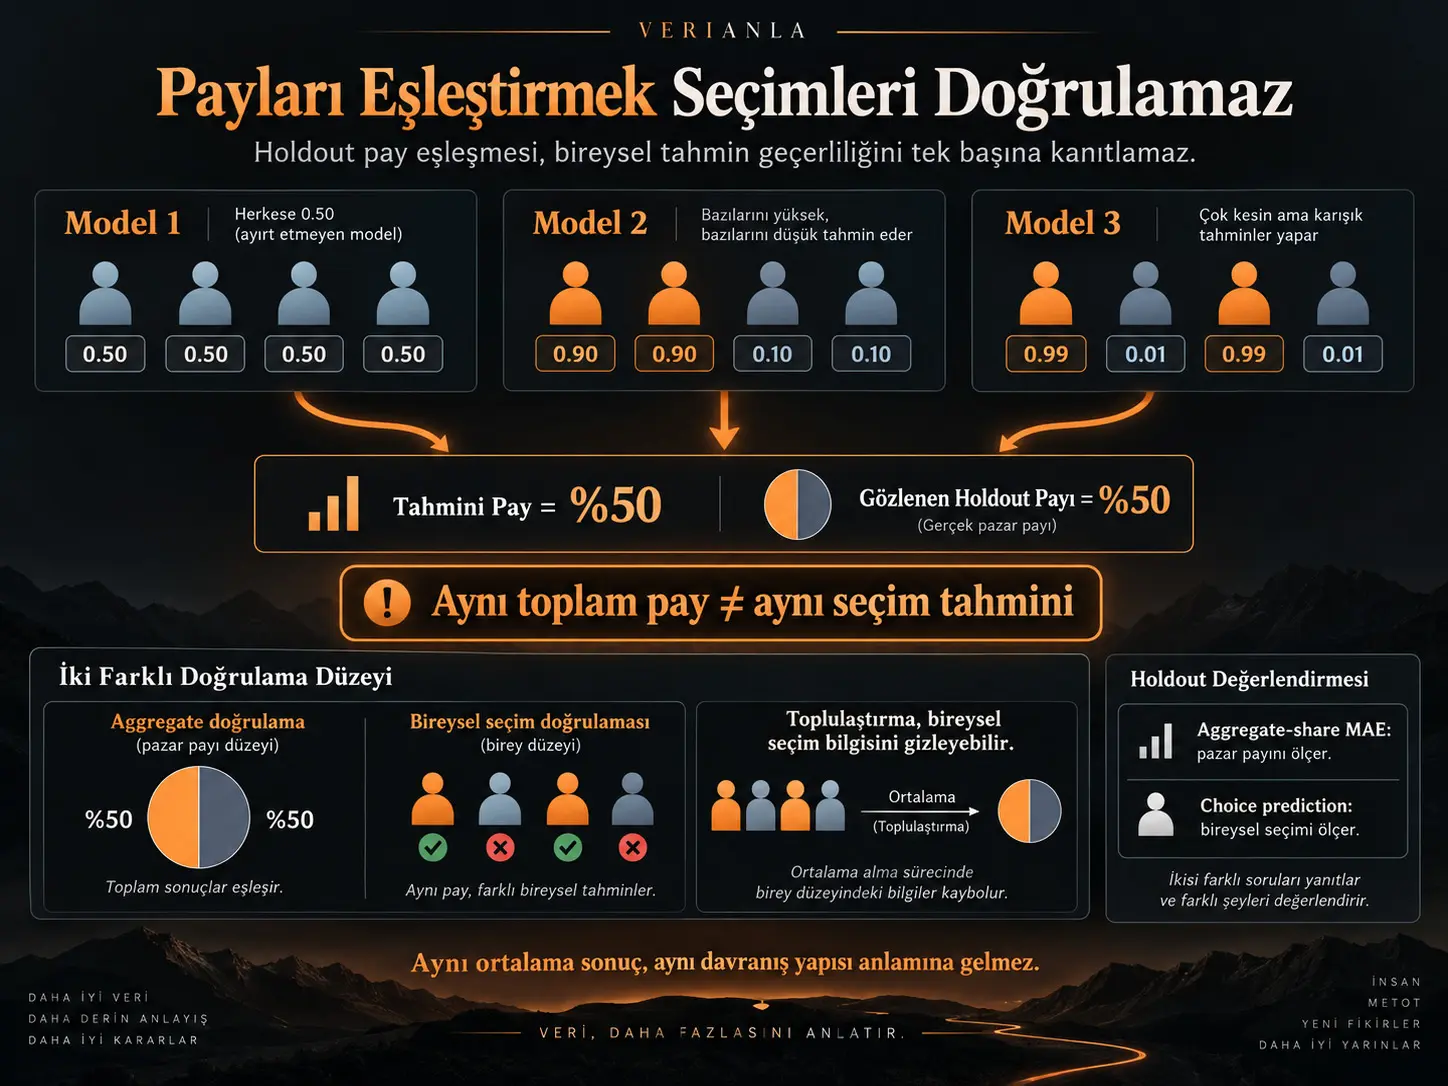
Aggregate-share mean absolute error (aggregate-share MAE), bir ayrık seçim modelinin tahmin ettiği toplam alternatif payları ile holdout örnekleminde gözlenen toplam paylar arasındaki ortalama mutlak farkı ölçen bir toplulaştırılmış hata metriğidir. Jake Lee'nin çalışması, bu metriğin pazar payı tahmini için geçerli bir ölçüt olabileceğini kabul etmekle birlikte, bireysel seçimlerin dışsal tahmin geçerliliğini tek başına kanıtlamak için yeterli olmadığını savunmaktadır. Bunun temel nedeni, birbirinden çok farklı bireysel seçim olasılığı örüntülerinin aynı ortalama pazar payını üretebilmesidir. Tahminler önce ortalanıp daha sonra holdout paylarıyla karşılaştırıldığında, modelin hangi birey için hangi seçimi ne ölçüde doğru tahmin ettiği bilgisi kaybolur. Dolayısıyla düşük aggregate-share MAE, modelin yeni veride aggregate payları iyi yeniden üretmiş olduğunu gösterebilir; ancak bundan otomatik olarak modelin bireysel seçim davranışını dışsal veride daha iyi tahmin ettiği sonucu çıkarılamaz.
Çalışmanın merkezindeki örnek son derece basittir. Yüz kişilik bağımsız bir holdout örnekleminde 50 kişi A'yı, 50 kişi B'yi seçerse gözlenen paylar %50–%50'dir. Model 1 de %50–%50 öngördüğünde aggregate MAE sıfır olur. Model 2 %60–%40 öngörürse aggregate MAE 10 yüzde puanıdır. Toplulaştırılmış karşılaştırmaya göre Model 1 açık biçimde kazanır. Ancak Model 1'in %50 A payı tahmini bütün bireylere \(0.50\) olasılık vermekten de, bireylerin yarısına yaklaşık \(0.90\) ve diğer yarısına \(0.10\) vermekten de oluşabilir. Bu modeller aggregate düzeyde aynı sonucu üretirken birey düzeyinde tamamen farklı seçim yapıları temsil eder.
Yazarın iddiası yalnız MAE formülüne yönelik değildir. Tahminler önce aggregate paylara indirgendikten sonra uygulanan MAD, MSE, RMSE veya başka bir hata fonksiyonu aynı temel bilgi kaybıyla karşı karşıyadır. Sorun ölçüm formülünden önce gerçekleşmektedir: değerlendirmenin seviyesi bireysel seçimlerden aggregate ortalamalara düşürülmüştür.
Makale aynı zamanda önemli bir sınır koymaktadır. Eğer araştırmanın gerçek tahmin hedefi aggregate pazar payıysa, aggregate-share doğrulaması meşrudur. Ancak bu kanıt yalnız test edilen piyasa durumları ve bu durumlarda gerçekten bulunan değişim aralığı hakkında çıkarım sağlar. Fiyat, ürün konfigürasyonu veya rekabet koşulları değiştiğinde pazar tepkisinin tahmin edilmesi hedefleniyorsa, doğrulama durumlarının bu tür anlamlı değişimleri içermesi gerekir.
Holdout doğrulamasının temel görevi nedir?
Bir model eğitim veya tahmin parametrelerini oluşturmak için kullanılan veriye çok iyi uyum sağlayabilir ve buna rağmen yeni verilerde daha kötü performans gösterebilir. Model esnekliği arttıkça tahmin sistemi yalnız gerçek ve genellenebilir davranış yapısını değil, tahmin verisine özgü rastlantısal örüntüleri de öğrenebilir. Bu durum aşırı uyum, yani overfitting problemidir.
Holdout doğrulamasının temel işlevi bu nedenle yalnız bir hata metriği üretmek değildir. Holdout, modelin eğitim verisinde görünen üstünlüğünün gerçekten yeni veriye taşınıp taşınmadığını sınayan koruyucu bir mekanizmadır. Modelin kendisini oluşturmakta kullanılmayan veriler üzerinde görünür avantaj başarısız olabiliyorsa, eğitim verisindeki üstünlüğün genellenebilir olduğuna ilişkin güven zayıflar.
Kaynak, holdout verisinin ayrı bir örneklem bölünmesinden veya tamamen ayrı toplanmış bir doğrulama örnekleminden gelebileceğini belirtir. Ana koşul, “out-of-sample” olarak sunulan verinin doğrulaması gereken sonucu üretmekte kullanılmamış olmasıdır.
Aggregate-Share MAE Dışsal Tahmin Geçerliliğini Kanıtlar mı?
Hayır; bireysel seçimlerin dışsal tahmin geçerliliği iddiası açısından aggregate-share MAE tek başına yeterli değildir. Aggregate-share MAE, modelin ortalama tahmin edilen payının holdout örneklemindeki ortalama gerçekleşen paya ne kadar yakın olduğunu gösterir; fakat aynı aggregate payı üreten farklı bireysel tahmin örüntülerini birbirinden ayıramadığı için modelin yeni veride seçimleri gerçekten daha iyi tahmin edip etmediğini belirleyemez.
Bu sonuçta “holdout verisinin dışsal olup olmaması” ile “kullanılan doğrulama ölçütünün hangi bilgiyi test ettiği” birbirinden ayrılmalıdır. Bir örneklem tamamen bağımsız ve dışsal olabilir, ancak model tahminleri önce aggregate paya indirgeniyorsa değerlendirme yine yalnız aggregate düzeyde bilgi taşır.
Yeni veri kullanmak, değerlendirme kriterinin kaybettiği bireysel bilgiyi geri getirmez. Bu nedenle kaynak, yalnız aggregate-share karşılaştırmasına dayanılarak bireysel seçimler için karşılaştırmalı external predictive validity sonucu kurulmasını geçersiz çıkarım olarak nitelendirmektedir.
Literatürdeki önceki uyarılar
Çalışma, problemi tamamen yeni keşfedilmiş bir olgu olarak sunmamaktadır. Yazar, farklı doğrulama seviyelerinin farklı model sıralamaları üretebildiğini gösteren önceki ayrık seçim literatürünü bir araya getirmektedir.
- Hagerty'nin 1986 çalışması, bireysel tercih tahmini ile pazar payı tahmininin farklı hedefler olduğunu ve model karmaşıklığını farklı biçimde ödüllendirebileceğini göstermiştir.
- Huber ve çalışma arkadaşlarının 1993 araştırması, bireysel tahmin ile aggregate-share MAE ölçümlerinin performans sıralamasında farklı sonuçlar verebildiğini raporlamıştır.
- Allenby, Arora ve Ginter 1995'te aggregate first-choice share ölçütlerinin predictive fit kanıtı olarak kullanılmasında dikkatli olunması gerektiğini vurgulamıştır.
- Moore, Gray-Lee ve Louviere 1998'de bireysel ve aggregate düzey doğrulamalar arasında yalnız zayıf karşılık bulduklarını bildirmiştir.
- Kaynak, Sablotny-Wackershauser ve arkadaşlarının 2024 çalışmasını aggregate share MAE'nin ayrı doğrulama örnekleminde kullanılmaya devam ettiğinin güncel örneği olarak ele almaktadır.
Jake Lee'nin katkısı, yazarın kendi anlatımına göre bu parçaları tek bir çıkarım kuralı altında birleştirmektir: aggregate share performansı ile choice-level tahmin performansının farklılaşabileceği zaten bilinmektedir; bunun sonucu olarak aggregate-share MAE'nin bireysel seçimler için dışsal tahmin geçerliliğinin yeterli karşılaştırmalı kanıtı sayılamayacağı açıkça belirtilmelidir.
Basit holdout örneği
Kaynak problemi görünür kılmak için yüz kişiden oluşan basit bir ikili seçim örneği kullanmaktadır. Holdout örneklemindeki 100 kişinin tamamı aynı A/B seçim durumuyla karşılaşmaktadır.
| Ölçüt | Gözlenen holdout | Model 1 | Model 2 |
|---|---|---|---|
| A'yı seçme payı | 50% | 50% | 60% |
| B'yi seçme payı | 50% | 50% | 40% |
| Aggregate MAE | - | 0 | 10 yüzde puanı |
Aggregate değerlendirmeye göre Model 1 kusursuz görünmektedir. A ve B için gözlenen %50–%50 dağılımını aynen üretir ve aggregate MAE sıfırdır.
Ancak %50 ortalamanın altında hangi bireysel tahminlerin bulunduğu aggregate sonuçtan anlaşılamaz. Model bütün bireyler için A olasılığını \(0.50\) tahmin etmiş olabilir. Başka bir model popülasyonun yarısına \(0.90\), diğer yarısına \(0.10\) vermiş olabilir. Her iki yapı da ortalamada %50 A payına ulaşabilir.
Dolayısıyla “Model 1 aggregate payları doğru tahmin etti” önermesi ile “Model 1 bireylerin seçim davranışlarını doğru öğrendi” önermesi aynı değildir.
Toplulaştırma Tahmin Bilgisinin Hangi Bölümünü Kaybettirir?
Toplulaştırma, modelin her birey için ürettiği seçim olasılığı ile o bireyin veya eşleştirilebilir gözlemin gerçekleşen seçimi arasındaki yapıyı tek bir ortalamaya indirger. Aynı ortalamaya sahip çok sayıda farklı tahmin vektörü aggregate ölçüt açısından özdeş hale geldiği için, modelin heterojen seçim davranışını doğru öğrenip öğrenmediği bilgisi aggregate pay karşılaştırmasından çıkarılamaz.
Kaynak, ikili seçim durumunda modelin tahmini aggregate payını şu biçimde tanımlar:
\[ \bar{p}=\frac{1}{N}\sum_{i=1}^{N}p_i \]
Burada \(p_i\), modelin \(i\). modellenen kişi için ilgili alternatife atadığı seçim olasılığıdır; \(N\) ise tahminleri aggregate paya dönüştürmekte kullanılan model nüfusundaki gözlem sayısıdır.
Holdout örnekleminde gözlenen gerçekleşmiş seçim payı ise:
\[ \bar{y}=\frac{1}{M}\sum_{k=1}^{M}y_k \]
biçiminde ifade edilir. Burada \(y_k\), holdout örneklemindeki \(k\). gözlemin gerçekleşmiş ikili seçim göstergesidir ve \(M\) holdout örneklem büyüklüğüdür.
Kaynağın özellikle dikkat çektiği nokta, bu iki ortalamanın aynı bireylerin verilerinden oluşmasının zorunlu olmamasıdır. Tahmin popülasyonu ile holdout örneklemi farklı katılımcılardan oluşabilir ve örneklem büyüklükleri de farklı olabilir. Aggregate doğrulama yalnız ortaya çıkan ortalamaları karşılaştırır.
Aynı %50 payı üreten farklı tahmin vektörleri
Kaynağın verdiği üç örnek tahmin vektörü şunlardır:
\[ (0.5,\;0.5,\;0.5,\;0.5) \]
\[ (0.9,\;0.9,\;0.1,\;0.1) \]
\[ (0.99,\;0.01,\;0.99,\;0.01) \]
Üç vektörün de aritmetik ortalaması \(0.50\)'dir. Buna rağmen temsil ettikleri seçim yapıları birbirinden belirgin biçimde farklıdır.
| Tahmin vektörü | Aggregate A payı | Birey düzeyindeki yapı |
|---|---|---|
| (0.5, 0.5, 0.5, 0.5) | 50% | Her birey için tam belirsizlik |
| (0.9, 0.9, 0.1, 0.1) | 50% | İki birey A'ya, iki birey B'ye güçlü biçimde yönelmiş tahminler |
| (0.99, 0.01, 0.99, 0.01) | 50% | Bireyler arasında neredeyse deterministik fakat farklı yönlerde tahminler |
Holdout yalnız %50 A ve %50 B aggregate payı üzerinden değerlendiriliyorsa üç tahmin de aynı aggregate skorunu alabilir. Aggregate karşılaştırmanın hangi modelin gerçek bireysel seçim yapısına daha yakın olduğunu söyleyememesinin nedeni budur.
Sorun neden yalnız MAE değildir?
Kaynak, tartışmayı MAE ile başlatmasına rağmen mantığın MAE'ye özgü olmadığını özellikle belirtir. Model tahminleri önce aggregate paya indirgendikten sonra MAD, MSE, RMSE veya başka bir hata fonksiyonunun uygulanması temel sorunu ortadan kaldırmaz.
Çünkü bilgi kaybı hata formülü uygulanmadan önce gerçekleşmiştir. Bireysel \(p_i\) değerlerinin hangi gerçekleşen seçimlerle ilişkili olduğu bilgisi tek bir \(\bar p\) değerine indirgenmiştir. Sonraki matematiksel işlem kaybedilmiş bu bağlantıyı yeniden oluşturamaz.
Başka bir ifadeyle sorun “MAE yanlış formüldür” değildir. Sorun, daha geniş bir choice-level predictive-validity iddiasını değerlendirmek amacıyla aggregate seviyede puanlama yapılmasıdır.
Daha Fazla Holdout Görevi Kullanmak Sorunu Çözer mi?
Her holdout görevi yine önce aggregate paya indirgeniyorsa yalnız görev sayısını artırmak temel sorunu çözmez. Beş, on veya on beş ayrı holdout durumunda aggregate pay hatalarını hesaplamak daha fazla aggregate karşılaştırma üretir; ancak bireysel tahminler ile gerçekleşen seçimler arasındaki ilişki her görevde yine agregasyon öncesinde kayboluyorsa bu işlem choice-level external predictive validity testine dönüşmez.
Kaynak burada önemli bir ikinci durumu ayırmaktadır. Holdout görevlerinin farklı fiyatlar, ürün özellikleri veya rekabet koşulları gibi anlamlı piyasa durumu değişimleri içerdiği bir tasarım, aggregate piyasa tepkisinin tahmini bakımından gerçekten bilgi sağlayabilir.
Dolayısıyla sorun “çok sayıda holdout hiçbir işe yaramaz” değildir. Doğrulama durumlarının hangi varyasyonu taşıdığı ve araştırmacının hangi iddiayı test etmek istediği belirleyicidir.
Piyasa durumundaki değişimin test edilmesi
Kaynak, piyasa durumunun \(X_0\)'dan \(X_1\)'e değiştiği bir örneği şu biçimde ifade eder:
\[ X_0 \rightarrow X_1 \]
Belirli bir alternatif için modelin tahmin ettiği pay değişimi:
\[ \Delta \hat{S} = \hat{S}(X_1)-\hat{S}(X_0) \]
olarak gösterilir.
Gerçekte gözlenen pay değişimi ise:
\[ \Delta S = S(X_1)-S(X_0) \]
şeklindedir.
Model piyasa tepkisini doğru izliyorsa amaçlanan ilişki:
\[ \Delta \hat{S}\approx\Delta S \]
biçiminde düşünülebilir.
Yazar burada pay değişiminin mutlaka doğrudan ayrı bir hata metriğiyle puanlanması gerektiğini söylememektedir. Temel nokta, doğrulama tasarımının modelin daha sonra tahmin etmesi beklenecek koşullarda gerçek varyasyon içermesidir.
Fiyat değişimine tepki örneği
Örneğin bir ayrık seçim modeli gelecekte fiyat değişimlerinin pazar payına etkisini tahmin etmek için kullanılacaksa, yalnız aynı veya çok benzer fiyat yapısına sahip birkaç holdout görevinde aggregate pay seviyelerinin doğru çıkması sınırlı bilgi sağlar.
Daha güçlü aggregate doğrulama, farklı ve anlamlı fiyat durumlarında modelin pazar payı hareketlerini gerçekten takip edip edemediğini sınayabilir. Aynı mantık ürün konfigürasyonu, rekabet ortamı veya choice state'in başka önemli bileşenleri için de geçerlidir.
Ancak bu yine aggregate response validation olarak yorumlanmalıdır. Bireysel choice prediction hakkında daha geniş bir iddia kurmak için değerlendirme seviyesinin buna uygun olması gerekir.
Holdout verisinin gerçekten dışsal olması neden yine de yeterli değildir?
Bağımsız holdout verisi kullanmak gerekli bir metodolojik korumadır; fakat kaynağın tezine göre tek başına yeterli değildir. Doğrulama verisinin model eğitiminden tamamen ayrı olması, kullanılan metrik bireysel choice prediction hakkında gerekli bilgiyi korumuyorsa bu metriği otomatik olarak daha geniş tahmin geçerliliği kanıtına dönüştürmez.
Yazarın ifadesinin mantığı şöyledir:
- Verinin dışsal olması, overfit kontrolü için gerekli bir koşuldur.
- Ancak ölçütün modelin hangi iddiasını sınadığı ayrıca değerlendirilmelidir.
- Aggregate-share error yalnız aggregate-share agreement'i doğrudan sınar.
- Choice-level predictive validity ise tahmin edilen seçim ile gerçekleşen seçim arasındaki ilişkinin korunmasını gerektirir.
Model 1'in aggregate düzeyde kazanması neyi kanıtlar?
Basit örnekte Model 1'in Model 2'den daha düşük aggregate MAE elde etmesi meşru ve açık bir sonucu destekler: Model 1 o holdout durumundaki aggregate pazar paylarını Model 2'den daha yakından yeniden üretmiştir.
Kaynağın karşı çıktığı adım bundan sonrasıdır. Aynı sonuçtan “Model 1 dışsal veride bireysel seçimleri daha iyi tahmin etmektedir” sonucuna geçildiğinde kanıt seviyesinin izin verdiğinden daha geniş bir iddia kurulmuş olur.
Bu nedenle makalenin başlığındaki “Matching the Shares Does Not Validate the Choices” ifadesi aggregate tahminin değersiz olduğu anlamına gelmez. Bir ölçütün desteklediği iddia ile ondan çıkarılan daha geniş iddia arasındaki sınırı ifade eder.
Aşırı uyum neden tam olarak çözülemiyor?
Bir model daha esnek olduğu için tahmin verisinde davranış örüntüsünü daha iyi temsil ediyor görünebilir. Holdout aggregate payını da diğer modele göre daha iyi eşleştirebilir. Bu sonuç iki farklı açıklamayla uyumludur:
- Ek model yapısı gerçekten genellenebilir seçim davranışını daha iyi öğrenmiştir.
- Ek model yapısı bireysel düzeyde doğru olmayan, fakat ortalaması holdout pazar payına denk gelen başka bir tahmin örüntüsü üretmiştir.
Aggregate pay karşılaştırması bu iki açıklamayı birbirinden ayıramaz. Dolayısıyla tek dışsal test aggregate-share error ise, modelin görünür üstünlüğünün gerçekten estimation verisi dışına taşındığı konusunda choice-level iddia bakımından overfit olasılığı tam olarak çözülmemiş kalır.
Çalışmanın Yöntemi ve Bulguları
Araştırma problemi
Çalışmanın temel metodolojik sorusu, ayrık seçim modellerinin karşılaştırılmasında holdout pazar paylarının MAE veya benzer bir aggregate hata ölçüsüyle eşleştirilmesinin, bireysel seçimler için dışsal tahmin geçerliliği iddiasını gerçekten destekleyip desteklemediğidir.
Araştırma yaklaşımı
Çalışma yeni katılımcılar üzerinde bir tercih deneyi yürütmemektedir. Yazar bunun yerine:
- holdout validation'ın metodolojik işlevini tanımlamakta,
- önceki choice-model literatüründeki bireysel ve aggregate doğrulama farklılıklarını bir araya getirmekte,
- basit bir matematiksel karşı örnek kullanmakta,
- aggregation işleminin bilgi kaybını formel olarak göstermekte,
- daha fazla holdout görevinin neden otomatik çözüm olmadığını tartışmakta,
- aggregate pazar tahmini için daha dar fakat meşru doğrulama iddiasının sınırlarını belirlemektedir.
Kaynağın temel iddiası
Makalenin kendi ifadesiyle temel kural şudur:
Aggregate-share MAE, bireysel seçimler için dışsal tahmin geçerliliğinin yeterli karşılaştırmalı kanıtı olarak kullanılamaz.
Buradaki “yeterli” kelimesi kritiktir. Kaynak aggregate-share MAE'nin hiçbir bilgi taşımadığını söylememektedir. Ölçüt, aggregate pazar payı tahmininin başarısı hakkında bilgi taşır. Sorun, bu dar bilginin choice-level external predictive validity iddiasını tek başına kuracak kadar geniş yorumlanmasıdır.
Bireysel Seçimlerin Dışsal Tahmin Geçerliliği Nasıl Test Edilmelidir?
Kaynağa göre bireysel seçim tahminleri için dışsal tahmin geçerliliği iddiası kurulacaksa, değerlendirme modelin tahminleri ile modelin tahmin oluşturmakta kullanmadığı yeni veride gerçekleşen seçimler arasındaki ilişkiyi korumalıdır. Tahminler ve gerçekleşen seçimler puanlama öncesinde ayrı aggregate paylara indirgenirse bu ilişki kaybolduğu için test daha dar bir aggregate-share validation haline gelir.
Çalışma burada tek bir zorunlu alternatif scoring rule önermemektedir. Ana metodolojik şart, değerlendirme tasarımının iddia edilen prediction target ile uyumlu olmasıdır.
Başka bir ifadeyle:
| İddia edilen hedef | Doğrulamanın koruması gereken bilgi |
|---|---|
| Aggregate pazar payını tahmin etmek | Tahmin edilen ve gözlenen aggregate paylar; test edilen piyasa durumlarındaki anlamlı varyasyon |
| Bireysel seçimleri tahmin etmek | Modelin birey/gözlem düzeyindeki tahminleri ile gerçekleşen seçimler arasındaki ilişki |
| Piyasa değişimine aggregate tepkiyi tahmin etmek | Fiyat, ürün yapısı veya rekabet koşulları gibi anlamlı state değişimleri ve bunlara eşlik eden pazar tepkisi |
Aggregate pay doğrulamasının meşru kullanım alanı
Çalışmanın önemli sınır cümlelerinden biri, aggregate-share prediction'ın meşru bir predictive target olduğudur. Bir işletme veya araştırmacı gerçekten belirli pazar durumlarında toplam alternatif paylarını tahmin etmeyi amaçlıyorsa, holdout aggregate share comparison doğrudan ilgili bir test olabilir.
Ancak bu kanıtın genellenebilirliği test edilen durumların kapsamıyla sınırlıdır. Doğrulama yalnız tek bir product configuration veya birbirine çok benzeyen choice state'leri kapsıyorsa, çok farklı fiyat veya rekabet koşullarına ilişkin performans sonucu kendiliğinden kurulamaz.
Birden fazla anlamlı piyasa durumu neden daha değerlidir?
Modelin gerçek kullanım alanı piyasa koşullarındaki değişimlere tepkiyi tahmin etmekse doğrulama setinin de bu değişimleri içermesi gerekir. Kaynak bu nedenle “daha fazla holdout” ile “daha fazla anlamlı varyasyon” kavramlarının aynı olmadığını göstermektedir.
On beş holdout görevinin tamamı çok benzer piyasa durumlarını temsil edebilir. Buna karşılık daha az sayıda fakat fiyat, özellik veya rakip yapısı açısından anlamlı değişimler içeren durumlar aggregate response prediction hakkında daha doğrudan bilgi verebilir.
Çalışmanın desteklediği sonuçlar
- Aggregate-share MAE, aggregate pazar paylarının holdout verisine yakınlığını değerlendirebilir.
- Farklı bireysel tahmin vektörleri aynı aggregate pazar payını üretebilir.
- Bu nedenle aggregate pay eşleşmesi tek başına bireysel seçim tahminlerinin dışsal geçerliliğini belirleyemez.
- Tahminleri aggregate paya indirdikten sonra MAE yerine MSE, RMSE veya başka bir hata metriği kullanmak kaybedilmiş bireysel bilgiyi geri getirmez.
- Aynı aggregate doğrulamayı daha fazla holdout görevinde tekrarlamak değerlendirme seviyesini değiştirmez.
- Aggregate pazar tahmini gerçek araştırma hedefiyse aggregate doğrulama meşrudur.
- Aggregate doğrulamanın daha geniş piyasa tepkisi açısından değeri, test edilen choice state'lerin daha sonra tahmin edilmek istenen koşullardaki anlamlı varyasyonu ne kadar kapsadığına bağlıdır.
Çalışmanın desteklemediği sonuçlar
- Aggregate-share MAE'nin genel olarak “kötü” veya kullanılamaz bir metrik olduğu sonucu çıkarılmamalıdır.
- Aggregate pazar payı tahmininin bilimsel veya ticari açıdan değersiz olduğu ileri sürülmemektedir.
- Her aggregate doğrulamanın geçersiz olduğu söylenmemektedir.
- Kaynak, bireysel tahmin doğrulaması için tek bir zorunlu alternatif metrik belirlememektedir.
- Daha fazla holdout görevinin hiçbir zaman yararlı olmadığı ileri sürülmemektedir; sorun görevlerin yalnız aynı aggregate seviyede değerlendirilmesidir.
- Model 1'in aggregate payları iyi tahmin etmesinin yanlış olduğu söylenmemektedir; yalnız bundan choice-level predictive validity sonucuna geçilemeyeceği savunulmaktadır.
- Makale yeni bir modelin hangi koşullarda mutlak olarak en iyi olduğunu ampirik biçimde göstermemektedir.
Yöntemsel güçlü yön
Çalışmanın güçlü tarafı, karmaşık bir model doğrulama problemini basit bir bilgi-kaybı argümanına indirgemesidir. Aynı ortalamayı veren farklı tahmin vektörlerinin varlığı, aggregate scoring'in hangi bilgiyi değerlendiremediğini doğrudan görünür hale getirir.
Ayrıca makale “istatistik yeni veride hesaplandıysa otomatik olarak external predictive validity sağlar” varsayımını sorgulamaktadır. Verinin bağımsızlığı ile değerlendirme ölçütünün hedefle uyumluluğunu ayrı metodolojik koşullar olarak ele almaktadır.
Çalışmanın kapsam sınırları
Kaynak yedi sayfalık metodolojik bir argümandır ve yeni geniş ölçekli simülasyon, Monte Carlo analizi veya gerçek piyasa tahmin karşılaştırması sunmamaktadır. Merkezi sonuç matematiksel bilgi kaybı mantığı, basit örnek ve önceki literatürdeki bireysel/aggregate ayrışma bulgularının sentezine dayanmaktadır.
Dolayısıyla çalışma, aggregate-share MAE kullanan her geçmiş çalışmanın diğer bütün sonuçlarını geçersiz ilan eden bir meta-analiz olarak okunmamalıdır. Eleştiri, söz konusu aggregate kriterin choice-level comparative external predictive validity için yeterli kanıt olarak kullanıldığı çıkarıma yöneliktir.
Kaynak ve Yöntem Notu
Özgün başlık: Matching the Shares Does Not Validate the Choices
Özgün alt başlık: Why Matching Holdout Shares Is Not Sufficient Evidence of Predictive Validity
Yazar: Jake Lee
Kurum: Red Analytics, Inc.
PDF tarihi: August 2026
SSRN Date Written: 18 Ağustos 2026
SSRN Posted: 19 Ağustos 2026
SSRN çalışma numarası: 7309578
DOI: 10.2139/ssrn.7309578
Kaynak türü: Ayrık seçim modellemesi ve model doğrulaması üzerine metodolojik çalışma / SSRN preprinti.
Hakemlik durumu: Hakemli dergi yayını olduğu gösterilmemektedir; preprint olarak değerlendirilmelidir.
Lisans: SSRN metadata'sında Creative Commons Attribution 4.0 International belirtilmektedir.
Finansman: SSRN kaydına göre araştırma dış finansman almamıştır.
Çıkar çatışması: SSRN kaydına göre yazar rakip/çatışan çıkar bulunmadığını beyan etmektedir.
Etik: SSRN açıklamasına göre çalışma yeni insan katılımcıları, tanımlanabilir kişisel veri veya yeni veri toplama içermediğinden etik kurul onayı gerektirmemiştir.
Araştırma türü: Kavramsal ve matematiksel metodoloji analizi; önceki ayrık seçim doğrulama literatürünün sentezi.
Merkezi tahmin kavramları: holdout validation, out-of-sample prediction, external predictive validity, aggregate-share prediction, individual choice prediction ve mean absolute error.
Temel matematiksel mekanizma: Bireysel model tahminlerinin \(\bar p\) aggregate tahminine, gerçekleşmiş holdout seçimlerinin ise \(\bar y\) aggregate gözleme indirgenmesi; farklı bireysel tahmin vektörlerinin aynı \(\bar p\) değerini üretebilmesi.
Ana yorum sınırı: Makale aggregate pazar payı doğrulamasını reddetmemektedir. İtiraz, aggregate-share error'ın bireysel seçimler için daha geniş external predictive validity iddiasının tek başına yeterli kanıtı olarak kullanılmasına yöneliktir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir