

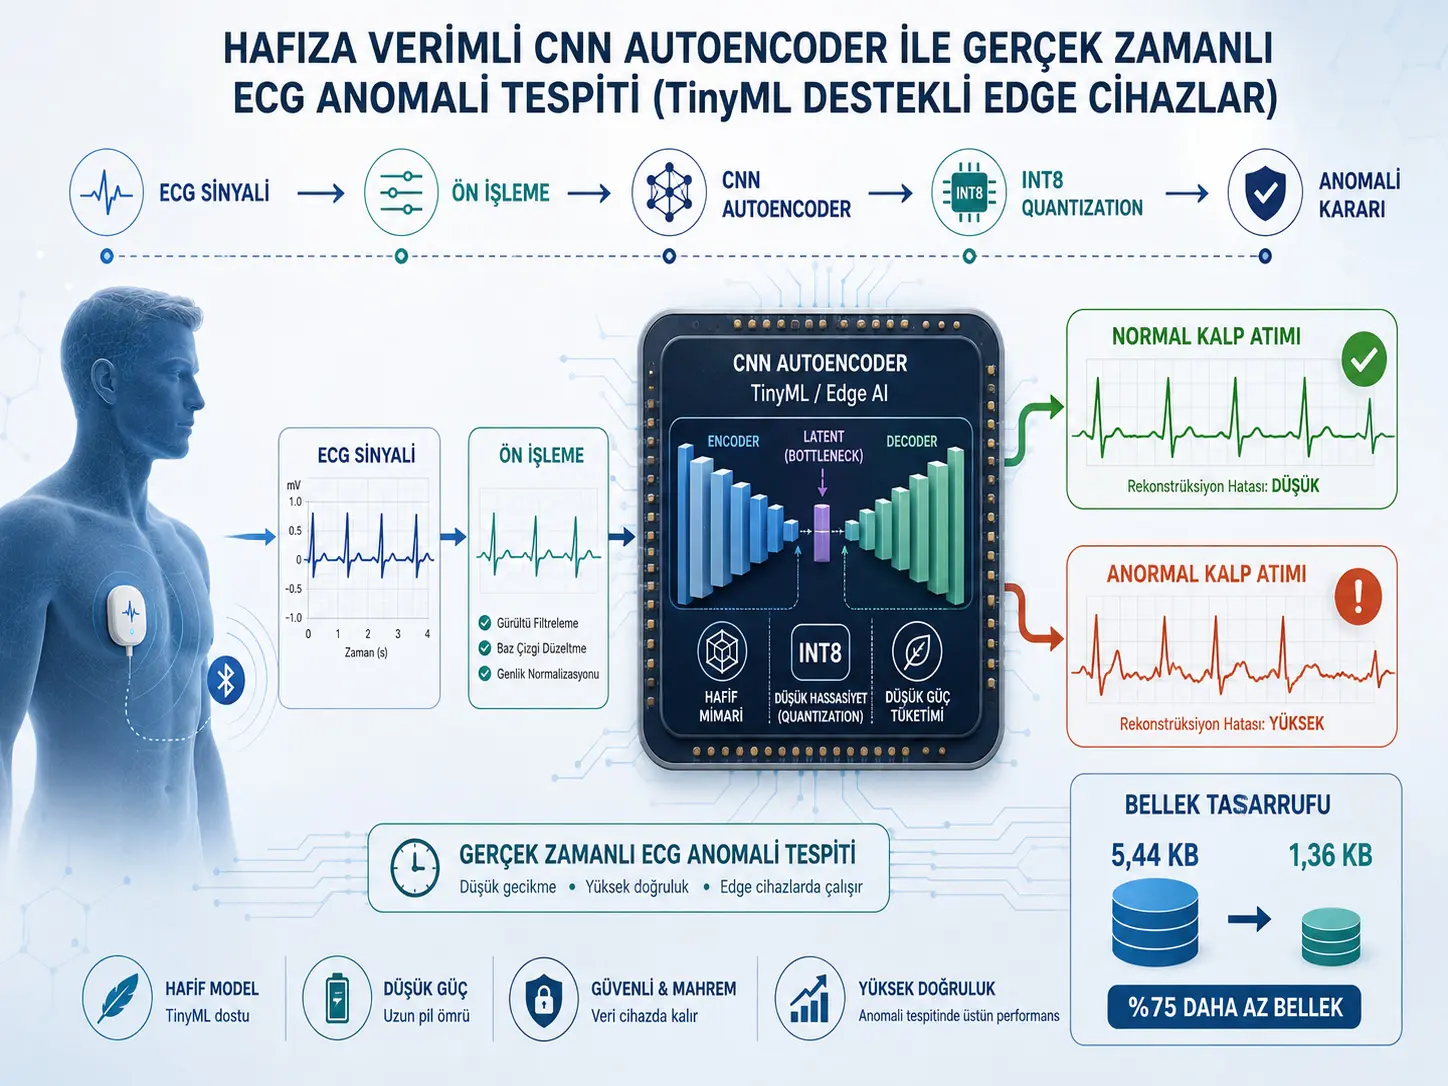
Bu araştırma, elektrokardiyografi (ECG) sinyallerindeki normal dışı kalp atımlarını büyük bir sunucuya sürekli veri göndermeden, kaynakları sınırlı edge veya TinyML sınıfı cihazlarda tespit edebilecek kadar küçük bir yapay zekâ modeli oluşturmayı amaçlamaktadır. Araştırmacılar bu amaçla yalnız normal ECG atımlarıyla eğitilen tek boyutlu bir convolutional autoencoder geliştirmiş ve modelin normal bir kalp atımını ne kadar iyi yeniden oluşturabildiğini anomaly score olarak kullanmıştır. Normalden farklı ECG morfolojileri daha yüksek reconstruction error ürettiğinde, hata önceden belirlenen eşikten yüksekse örnek anomalili olarak sınıflandırılmaktadır.
Kullanılan ECG Heartbeat Categorization veri seti PTB Diagnostic ECG Database'den türetilmiştir ve kaynakta toplam 14.552 kalp atımı bulunduğu belirtilmektedir: 4046 normal ve 10.506 abnormal ECG beat. Her kalp atımı R-tepesi çevresinde hizalanmış 187 zaman örneğiyle temsil edilmektedir. CNN autoencoder yalnız normal örneklerle one-class biçiminde eğitilmiş; abnormal atımlar eğitim sırasında kullanılmayıp test amacıyla saklanmıştır.
Model yalnız 1393 parametreye sahiptir. Kaynak hesaplamasına göre parametrelerin FP32 olarak tutulması yaklaşık 5,44 KB, INT8'e quantize edilmesi ise yaklaşık 1,36 KB gerektirmektedir. Böylece parametre saklama belleğinde yaklaşık %75 azalma elde edilmektedir. Ancak bu değer toplam TinyML uygulama belleği değildir; aktivasyonlar, çalışma buffer'ları, yazılım kodu ve runtime overhead bu hesaplamaya dahil edilmemiştir.
FP32 model için çalışmada %83,12 accuracy, %85,88 precision, %91,47 recall ve %88,67 F1-score raporlanmıştır. INT8 modelde threshold yeniden ayarlandıktan sonra accuracy %82,19, precision %83,66, recall %93,61 ve F1-score %88,36 olarak bildirilmiştir. Dolayısıyla parametre belleğinin dörtte bire düşmesine karşılık F1-score'daki raporlanan düşüş yalnız 0,31 yüzde puanıdır.
Kaynak confusion matrix'lerinde önemli bir etiketleme sorunu bulunmaktadır. Veri seti metinde 4046 normal ve 10.506 abnormal beat olarak açıklanırken FP32 ve INT8 confusion matrix'lerinde 4046 örnek içeren satır “Abnormal”, 10.506 örnek içeren satır “Normal” olarak etiketlenmiştir. Sınıf isimleri veri seti açıklamasına göre ters yorumlandığında raporlanan metriklerin büyük bölümü matrislerden yeniden üretilebilmektedir. FP32 precision için ise matristen yaklaşık %86,03 elde edilirken kaynak %85,88 bildirmektedir.
Çalışmanın TinyML açısından en önemli sınırlaması gerçek mikrodenetleyici deployment'ının yapılmamış olmasıdır. INT8 quantization, threshold ayarlama ve inference değerlendirmesi MATLAB/CPU ortamında yazılım olarak gerçekleştirilmiştir. Bu nedenle araştırma modelin düşük parametre belleğine ve quantization sonrası korunabilen anomaly-detection performansına ilişkin kanıt sunmaktadır; belirli bir MCU üzerinde gerçek latency, enerji tüketimi veya uçtan uca sağlık sistemi performansı göstermemektedir.
Türkiye açısından yorum: Bu çalışma Türkiye'deki klinik ECG kayıtları veya hasta popülasyonu üzerinde gerçekleştirilmemiştir. Yöntem, taşınabilir sağlık izleme ve evde bakım cihazlarının tasarımı açısından Türkiye'de de teknik olarak değerlendirilebilir; ancak gerçek kullanım öncesinde yerel hasta grupları, farklı ECG cihazları, gürültü koşulları ve farklı kardiyak patolojilerle bağımsız klinik doğrulama gerekir. Ayrıca araştırmadaki sistem yalnız “normal / anormal” ayrımı yapmaktadır; aritmi türünü teşhis etmemektedir. Bu nedenle sonuçlar klinik tanı cihazı performansı olarak yorumlanmamalıdır.
Araştırmanın temel problemi nedir?
Sürekli ECG izleme, normal kalp ritminden sapmaların erken fark edilmesinde önemli olabilir. Ancak ECG verisinin sürekli olarak merkezi bir sunucuya gönderilmesi haberleşme yükü, gecikme, enerji tüketimi ve mahremiyet açısından dezavantaj yaratabilir. Öte yandan büyük CNN, LSTM veya Transformer modellerini düşük güçlü mikrodenetleyiciler üzerinde çalıştırmak da bellek ve hesaplama sınırları nedeniyle güçtür.
Çalışmanın yaklaşımı bu iki problemi birlikte ele almaktadır: mümkün olduğunca küçük bir autoencoder oluşturmak ve daha sonra model ağırlıklarını 32 bit kayan noktadan 8 bit integer gösterime indirerek parametre belleğini küçültmek.
Sistem nasıl çalışıyor?
ECG'den edge anomaly kararına kadar işlem zinciri
| Aşama | İşlem | Kaynak |
|---|---|---|
| 1. ECG girdisi | Her kalp atımı R-tepesi çevresinde hizalanmış 187 zaman örneğiyle temsil edilir. | Bölüm 2.2 |
| 2. Normalizasyon | Her ECG beat sıfır ortalama ve birim standart sapmaya normalize edilir. | Eşitlik 1 |
| 3. CNN Autoencoder | Model normal ECG morfolojisini encoder–bottleneck–decoder üzerinden yeniden oluşturmaya çalışır. | Şekil 2 / Bölüm 2.4 |
| 4. Reconstruction error | Orijinal ECG ile reconstructed ECG arasındaki MSE anomaly score olarak hesaplanır. | Eşitlik 3 |
| 5. Threshold | Hata eşikten yüksekse anomaly, düşük veya eşitse normal sınıfı verilir. | Eşitlik 6 |
| 6. INT8 quantization | FP32 ağırlıklar simetrik INT8 gösterime dönüştürülür ve threshold yeniden optimize edilir. | Bölüm 2.5–2.8 |
| 7. Edge/TinyML hedefi | Küçük modelin kaynakları sınırlı cihazlarda yerel anomaly screening için kullanılabilmesi hedeflenir. | Şekil 1 / Tartışma |
Verianla Live: Süreç, çalışmanın Şekil 1–3 ve yöntem bölümünden oluşturulmuştur. Kaynakta bulunmayan yeni model veya klinik karar aşaması eklenmemiştir.
Veri seti nasıl hazırlanmış?
Kaynak ECG sinyallerini Kaggle ECG Heartbeat Categorization veri setinden almaktadır. Bu veri setinin PTB Diagnostic ECG Database'den türetildiği belirtilmiştir.
Her örnek tek bir heartbeat cycle'dır ve:
- R-tepesi çevresinde merkezlenmiştir,
- 187 zaman-domain örneği içerir,
- normal veya abnormal olarak ayrılmıştır.
Kaynakta toplam veri:
| Sınıf | ECG beat sayısı |
|---|---|
| Normal | 4046 |
| Abnormal | 10.506 |
| Toplam | 14.552 |
Autoencoder yalnız normal ECG beat'leriyle eğitilmektedir. Bu nedenle model belirli aritmi sınıflarını öğrenmeye değil, “normal kalp atımı nasıl görünür?” sorusuna cevap veren bir representation oluşturmaya çalışır.
Her ECG beat neden ayrı normalize ediliyor?
Kaynak amplitüd farklılıklarının etkisini azaltmak için her örneği kendi ortalaması ve standart sapmasıyla normalize etmektedir:
\[ \tilde{x}_i= \frac{x_i-\mu_x}{\sigma_x} \]
Bu işlem sonucunda her beat yaklaşık sıfır ortalama ve birim varyans ölçeğine getirilir.
Burada önemli yorum sınırı şudur: per-sample normalization modelin ECG morfolojisini incelemesini kolaylaştırabilir, ancak mutlak amplitüd bilgisinin bir bölümünü de normalize eder. Çalışma bu preprocessing seçiminin farklı klinik senaryolara etkisini ayrıca karşılaştırmamaktadır.
CNN Autoencoder'ın yapısı ne kadar küçük?
Model 187×1×1 boyutundaki ECG girdisini encoder–decoder yapısıyla işlemektedir.
Kaynak Şekil 2 ve yöntem bölümüne göre:
- encoder tarafında 8 filtreli 3×1 convolution,
- ReLU aktivasyonu,
- 16 birimlik bottleneck/dense katmanı,
- decoder tarafında dense + reshape,
- 3×1 transposed convolution
kullanılmaktadır.
Toplam eğitilebilir parametre sayısı yalnız:
1393
olarak verilmiştir.
Model nasıl eğitilmiş?
| Parametre | Kaynak değeri |
|---|---|
| Training precision | FP32 |
| Epoch | 40 |
| Optimizer | Adam |
| Learning rate | 1 × 10⁻³ |
| Batch size | 256 |
| Loss | MSE |
| Threshold search | 2000 aday değer üzerinde grid search |
| Training veri sınıfı | Yalnız normal ECG |
Kaynak, normal bir CPU üzerinde training'in yaklaşık 3–4 dakika sürdüğünü belirtmektedir. Ancak kullanılan işlemcinin modeli ve diğer benchmark koşulları verilmediği için bu süre başka donanımlara genellenemez.
Reconstruction error nasıl hesaplanıyor?
Autoencoder tarafından reconstructed edilen beat:
\[ \hat{x}_i=f_{\theta}(x_i) \]
olarak tanımlanır.
Her beat'in reconstruction error değeri:
\[ e_i= \frac{1}{H} \sum_{j=1}^{H} (x_{i,j}-\hat{x}_{i,j})^2 \]
ile hesaplanır. Burada \(H=187\)'dir.
Model yalnız normal ECG biçimlerini gördüğü için araştırmanın temel varsayımı, normal beat'leri düşük hata ile; farklı morfolojiye sahip abnormal beat'leri ise daha yüksek reconstruction error ile yeniden oluşturacağıdır.
Anomaly kararı nasıl veriliyor?
Kaynak FP32 model için sabit threshold değerini:
\[ \tau=3.55993\times10^{-4} \]
olarak vermektedir.
Sınıflandırma:
\[ Label_i= \begin{cases} 1,& e_i>\tau \quad \text{anormal}\\ 0,& e_i\leq\tau \quad \text{normal} \end{cases} \]
şeklindedir.
Threshold değeri F1-score'u en yüksek yapan adayın seçilmesiyle belirlenmiştir. Bu yaklaşım anomaly score'un kendisini değiştirmez; yalnız normal/anormal karar sınırını belirler.
FP32'den INT8'e geçiş nasıl yapılıyor?
Quantization işlemi eğitim bittikten sonra uygulanmaktadır. Kaynak her katmandaki maksimum mutlak ağırlığı kullanarak ölçek faktörü hesaplamaktadır:
\[ s= \frac{\max(|W|)}{127} \]
Ardından ağırlık:
\[ \omega_q= round \left( \frac{127}{\max(|\omega|)} \omega \right) \]
ile −127 ile +127 arasındaki INT8 gösterime dönüştürülmektedir.
Kaynakta quantization sonrası reconstruction error dağılımının bir miktar değiştiği açıkça görülmektedir. Bu nedenle FP32 threshold'unu olduğu gibi INT8 modelde kullanmak yerine ayrı bir threshold optimize edilmiştir:
\[ \tau_q= \arg\max_{\tau}F1(\tau) \]
Şekil 6 başlığında INT8 için seçilen “best-th” yaklaşık 0,0005052 olarak gösterilmektedir.
Neden threshold yeniden ayarlanıyor?
INT8 quantization ağırlıkları daha az bit ile temsil ettiği için reconstructed sinyalde küçük sayısal değişiklikler oluşturabilir. Bu değişiklikler anomaly detection'ın kullandığı reconstruction-error dağılımını kaydırabilir.
Kaynak, FP32 threshold'unun INT8'e doğrudan uygulanması halinde false-positive sayısının arttığını; INT8'e özel threshold optimizasyonunun bu etkiyi azalttığını belirtmektedir.
Bu sonuç, model ağırlıklarının yalnız küçültülmesinin yeterli olmadığını; anomaly threshold'unun quantization sonrasında tekrar kalibre edilmesinin önemli olduğunu göstermektedir.
Parametre belleği gerçekten ne kadar azalıyor?
Kaynağın memory hesabı:
\[ Memory=N_p\times b \]
şeklindedir.
1393 parametre × 4 byte yaklaşık 5,44 KiB; 1393 parametre × 1 byte yaklaşık 1,36 KiB yapmaktadır. Dolayısıyla parametre belleği tam olarak dörtte bire iner.
Önemli teknik ayrım: Bu hesap yalnız model ağırlıklarını kapsar. Gerçek TinyML uygulamasında activation tensor'ları, input/output buffer'ları, quantization scale değerleri, firmware, inference engine ve stack/heap de bellek tüketir. Çalışma bunların toplamını ölçmemektedir.
FP32 sonuçları ne?
| Metrik | Kaynakta raporlanan değer |
|---|---|
| Accuracy | 83,12% |
| Precision | 85,88% |
| Recall | 91,47% |
| F1-score | 88,67% |
| ROC AUC | 0,8327 |
Şekil 7'de FP32 ROC eğrisinin AUC değeri 0,8327 olarak açıkça gösterilmektedir.
INT8 sonuçları ne?
| Metrik | FP32 | INT8 | Değişim |
|---|---|---|---|
| Accuracy | 83,12% | 82,19% | −0,93 yüzde puanı |
| Precision | 85,88% | 83,66% | −2,22 yüzde puanı |
| Recall | 91,47% | 93,61% | +2,14 yüzde puanı |
| F1-score | 88,67% | 88,36% | −0,31 yüzde puanı |
| Parametre belleği | 5,44 KB | 1,36 KB | −75% |
INT8 modeli accuracy ve precision açısından bir miktar düşerken recall artmıştır. Bu nedenle yalnız accuracy'ye bakarak quantization etkisini değerlendirmek yeterli değildir.
Confusion matrix'lerde ne sorun var?
Kaynağın veri seti tanımı şu sınıf dağılımını verir:
4046 normal + 10.506 abnormal = 14.552 beat.
Ancak FP32 Şekil 4'te görülen matris şöyledir:
| Şekilde “Abnormal” | Şekilde “Normal” | |
|---|---|---|
| Şekilde “Abnormal” | 2486 | 1560 |
| Şekilde “Normal” | 896 | 9610 |
Üst satır toplamı:
\[ 2486+1560=4046 \]
alt satır toplamı:
\[ 896+9610=10506 \]
olmaktadır. Bunlar veri setinde sırasıyla normal ve abnormal sayılarıdır. Dolayısıyla confusion matrix'in sınıf isimleri veri seti açıklamasına göre ters görünmektedir.
Aynı desen INT8 Şekil 6'da da tekrar etmektedir:
| Şekilde “Abnormal” | Şekilde “Normal” | |
|---|---|---|
| Şekilde “Abnormal” | 2125 | 1921 |
| Şekilde “Normal” | 671 | 9835 |
Burada da:
\[ 2125+1921=4046 \]
ve:
\[ 671+9835=10506 \]
olmaktadır.
Bu nedenle en tutarlı yorum, confusion matrix eksenlerindeki Normal/Abnormal isimlerinin birbirinin yerine yazılmış olmasıdır.
Matrislerden metrikler yeniden üretilebiliyor mu?
FP32 matrix'i veri setindeki gerçek sınıf sayılarına göre yeniden yorumlandığında abnormal detection için:
\[ Precision= \frac{9610}{9610+1560} \approx86,03\% \]
\[ Recall= \frac{9610}{9610+896} \approx91,47\% \]
\[ F1\approx88,67\% \]
\[ Accuracy= \frac{2486+9610}{14552} \approx83,12\% \]
elde edilmektedir.
Accuracy, recall ve F1 kaynakla uyuşmaktadır; ancak kaynak precision değerini %85,88 vermektedir. Matris üzerinden yaklaşık %86,03 bulunmaktadır. Fark yaklaşık 0,15 yüzde puanıdır.
INT8 confusion matrix'te aynı yeniden yorumlama:
\[ Precision\approx83,66\% \]
\[ Recall\approx93,61\% \]
\[ F1\approx88,36\% \]
\[ Accuracy\approx82,19\% \]
sonuçlarını verir ve bunlar kaynakta raporlanan değerlerle uyumludur.
QRS morfolojisi gerçekten korunuyor mu?
Kaynak, FP32 ve INT8 reconstructed ECG şekilleri ile reconstruction-error dağılımlarının birbirine yakın olduğunu ve özellikle QRS kompleksinin temel yapısının korunduğunu yorumlamaktadır. Quantization sonrasında bazı yüksek enerjili bölgelerin biraz daha yumuşak göründüğü belirtilmektedir.
Ancak burada “klinik olarak anlamlı bütün ECG özelliklerinin kayıpsız korunduğu” şeklinde daha güçlü bir sonuç çıkarılamaz. Çalışma kardiyologlar tarafından yapılmış morfolojik kör değerlendirme, klinik equivalence testi veya çok merkezli diagnostik validasyon sunmamaktadır.
Gerçek TinyML donanımında çalıştırıldı mı?
Hayır. Çalışma bunu açık biçimde sınırlamaktadır. Quantization pipeline MATLAB R2025a'nın dlquantizer yaklaşımıyla ve CPU üzerinde yürütülmüştür.
Kaynak şu aşamaların yazılımda gerçekleştirildiğini açıklamaktadır:
- FP32 inference,
- INT8 approximation,
- threshold optimization,
- metric evaluation.
Mikrodenetleyici veya accelerator hardware kullanılmamıştır.
Dolayısıyla “TinyML-enabled edge device” bu çalışmada doğrudan test edilen cihaz değil, modelin hedef deployment sınıfıdır.
INT8 gerçekten integer-only inference mı?
Kaynak, INT8'in gelecekte integer-only inference için uygun olduğunu tartışmaktadır. Ancak deneysel pipeline'da quantized değerlerin gerektiğinde FP32 approximation'a dequantize edildiği belirtilmektedir.
Bu nedenle çalışmanın ölçtüğü şey gerçek MCU üzerinde tamamen integer arithmetic kullanan bir inference pipeline'ının performansı değildir. Integer-only inference, mimarinin potansiyel deployment avantajı olarak sunulmaktadır.
Diğer ECG modellerinden daha iyi mi?
Kaynak literatürdeki farklı çalışmalarla şu karşılaştırmayı vermektedir:
| Model | Dataset | Accuracy | F1 | Model boyutu |
|---|---|---|---|---|
| Bu çalışma — CAE FP32 | PTB | 83,12% | 88,67% | 5,44 KB |
| Bu çalışma — CAE INT8 | PTB | 82,19% | 88,36% | 1,36 KB |
| Transformer tabanlı çalışma | MIT-BIH | 89,5% | 92,3% | Belirtilmemiş |
| ECG-AAE | CMUH | 93,58% | 93,25% | Belirtilmemiş |
| Large-scale multilabel CNN | Özel büyük veri seti | 86,7% exact-match | 91,3% | Belirtilmemiş |
| CNN Autoencoder | PTB | 78% | 77% macro | Belirtilmemiş |
Kaynak doğru biçimde bu tablonun doğrudan benchmark olmadığını belirtmektedir. Dataset, görev, preprocessing ve değerlendirme metrikleri farklıdır. Özellikle 86,7% “Exact Match Ratio” ile normal binary accuracy aynı metrik değildir.
One-class yaklaşımın avantajı ne?
Kalp anormallikleri çok çeşitli olabilir ve her olası abnormal morfolojiyi etiketlemek güçtür. One-class model yalnız normal ritmi öğrenir ve normalden sapmayı anomaly olarak değerlendirir.
Bunun avantajı yeni veya az görülen abnormal pattern'lerin teorik olarak model tarafından “normal değil” şeklinde işaretlenebilmesidir.
Dezavantajı ise abnormal beat'in hangi aritmi sınıfına ait olduğunu söylememesidir. Çalışmanın modeli:
“Bu beat normalden farklı mı?”
sorusuna cevap vermeye çalışır; fakat:
“Bu hangi aritmi?”
sorusuna cevap vermez.
Tıbbi açıdan false negative neden önemli?
Araştırmacılar anomaly screening sisteminde bir abnormal kalp atımını normal olarak kaçırmanın false positive üretmekten daha kritik olabileceğini belirtmektedir. Bu nedenle recall/sensitivity önemlidir.
INT8 modelde kaynak recall değerinin %91,47'den %93,61'e yükselmesi bu açıdan olumlu görünmektedir; ancak değerler yalnız kullanılan PTB-türevi test veri setine aittir ve klinik sensitivity olarak genellenemez.
Çalışmanın desteklediği sonuçlar
- 1393 parametreli kompakt CNN autoencoder ECG reconstruction-based anomaly detection için uygulanmıştır.
- Model yalnız normal ECG beat'leriyle one-class biçiminde eğitilmiştir.
- FP32 modelde kaynak %83,12 accuracy ve %88,67 F1-score raporlamaktadır.
- INT8 quantization sonrasında parametre saklama belleği yaklaşık 5,44 KB'den 1,36 KB'ye düşmektedir.
- INT8 modelde F1-score %88,36 olarak korunmuştur.
- Quantization sonrası reconstruction-error dağılımındaki değişiklik nedeniyle threshold'un yeniden optimize edilmesi performansı iyileştirmiştir.
- Çalışmanın mimarisi parametre boyutu açısından TinyML sınıfı uygulamalar için oldukça küçüktür.
Çalışmanın desteklemediği veya test etmediği sonuçlar
- Model gerçek mikrodenetleyici üzerinde test edilmemiştir.
- Gerçek MCU inference latency ölçülmemiştir.
- Gerçek cihaz güç veya enerji tüketimi ölçülmemiştir.
- 1,36 KB değeri toplam sistem RAM veya Flash ihtiyacı değildir.
- Model belirli aritmi türlerini teşhis etmemektedir.
- Gerçek hasta başında prospektif klinik doğrulama yapılmamıştır.
- Modelin farklı demografi, hastane, ECG cihazı ve sampling koşullarında aynı performansı vereceği gösterilmemiştir.
- INT8 değerlendirmesi gerçek integer-only MCU inference benchmark'ı değildir.
- Literatür Tablo 1 farklı dataset ve görevlerden oluştuğu için doğrudan state-of-the-art üstünlük kanıtlamamaktadır.
Çalışmanın Yöntemi ve Bulguları
Veri ve preprocessing
| Parametre | Değer |
|---|---|
| Veri kaynağı | ECG Heartbeat Categorization / PTB Diagnostic ECG Database türevi |
| Toplam beat | 14.552 |
| Normal | 4046 |
| Abnormal | 10.506 |
| Beat uzunluğu | 187 zaman örneği |
| Normalizasyon | Her örnek için zero mean / unit variance |
| Training | Yalnız normal beat |
CNN-AE parametreleri
| Özellik | Değer |
|---|---|
| Toplam parametre | 1393 |
| Encoder filtre | 8 |
| Kernel | 3 × 1 |
| Aktivasyon | ReLU |
| Bottleneck | 16 |
| Epoch | 40 |
| Batch size | 256 |
| Learning rate | 1 × 10⁻³ |
| Optimizer | Adam |
| Loss | MSE |
Kaynak içi batch/MSE notasyonu
Bölüm 2.4 model training için batch size değerini 256 olarak vermektedir. Ancak Eşitlik (4)'ün hemen altında:
“M denotes the number of training samples = 128”
ifadesi yer almaktadır.
Kaynak bunun 128 örneklik başka bir mini-batch, loss hesaplama alt kümesi veya editoryal kalıntı olup olmadığını açıklamamaktadır. Bu nedenle Verianla 128 ile 256 arasındaki farkı sessizce düzeltmemektedir.
FP32–INT8 karşılaştırması
| Özellik | FP32 | INT8 |
|---|---|---|
| Accuracy | 83,12% | 82,19% |
| Precision | 85,88% | 83,66% |
| Recall | 91,47% | 93,61% |
| F1 | 88,67% | 88,36% |
| Parametre belleği | 5,44 KB | 1,36 KB |
| Parametre hassasiyeti | 32 bit | 8 bit |
Temel kalite kontrol bulguları
| Kontrol | Kaynak | Verianla değerlendirmesi |
|---|---|---|
| FP32 confusion matrix sınıf sayıları | 4046 ve 10.506 | Eksen sınıf isimleri veri seti tanımıyla ters görünüyor |
| INT8 confusion matrix sınıf sayıları | 4046 ve 10.506 | Aynı ters etiketleme tekrar ediyor |
| FP32 accuracy | 83,12% | Matristen yeniden üretilebiliyor |
| FP32 recall | 91,47% | Etiketler düzeltilerek matristen yeniden üretilebiliyor |
| FP32 F1 | 88,67% | Etiketler düzeltilerek matristen yeniden üretilebiliyor |
| FP32 precision | 85,88% | Matristen yaklaşık 86,03%; küçük uyuşmazlık var |
| INT8 metrikleri | 82,19 / 83,66 / 93,61 / 88,36% | Etiketler düzeltilerek matrix ile uyumlu |
Şekil numaralandırma notu
Kaynak Bölüm 3.1'de ROC curve için “Figure 6” ifadesini kullanmaktadır; ancak Şekil 6 INT8 confusion matrix'tir ve FP32 ROC curve gerçekte Şekil 7'dir. Bölüm 3.2'de ise INT8 ROC için Şekil 7'ye atıf yapılmaktadır; FP32–INT8 ROC karşılaştırması Şekil 8'de yer almaktadır. Bu editoryal figure-reference karışıklığı bilimsel sonucu değiştirmese de kaynakta bulunmaktadır.
En önemli mühendislik sonucu
Çalışmanın asıl gücü en yüksek anomaly-detection accuracy'yi elde etmek değildir. Kaynakta daha yüksek doğruluk bildiren başka modeller de bulunmaktadır. Buradaki mühendislik sonucu, yalnız 1393 parametreli bir autoencoder'ın parametre belleğinin INT8 ile yaklaşık 1,36 KB düzeyine indirilebilmesi ve F1-score'un kaynak deneyinde yaklaşık %88 düzeyinde korunabilmesidir.
Bu nedenle çalışma “en iyi ECG teşhis modeli” olarak değil, model boyutu–anomali tespit performansı–edge uygulanabilirliği arasındaki bir mühendislik uzlaşması olarak değerlendirilmelidir.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: Memory-Efficient CNN Autoencoder for Real-Time ECG Anomaly Detection on TinyML-Enabled Edge Devices
Yazarlar ve sıraları: Krishnaprasath Suryanarayanan; Ramanamurthy Gajula.
Sorumlu yazar: Ramanamurthy Gajula.
Eş katkı/eş birinci yazar: Kaynakta belirtilmemiştir.
Kurum: Department of Electronics and Communication Engineering, Alliance School of Applied Engineering, Alliance University, Bangalore 562106, India.
Dergi: Future Internet
Yayınevi: MDPI, Basel, Switzerland
Cilt / sayı / makale: 18 / 6 / 286
Alınma tarihi: 11 Nisan 2026
Revizyon tarihi: 14 Mayıs 2026
Kabul tarihi: 15 Mayıs 2026
Yayın tarihi: 27 Mayıs 2026
DOI: 10.3390/fi18060286
Resmî yayın bağlantısı:https://doi.org/10.3390/fi18060286
Kaynak türü: Araştırma makalesi; ECG anomaly detection, one-class CNN autoencoder ve yazılım tabanlı INT8 quantization değerlendirmesi.
Hakemlik durumu: Hakemli dergide yayımlanmış çalışmadır.
Lisans: Creative Commons Attribution (CC BY).
Finansman: Araştırma dış finansman almamıştır.
Veri erişilebilirliği: Kullanılan ECG verileri kamuya açık ECG Heartbeat Categorization Dataset'ten alınmıştır; kaynak bu veri setinin PTB Diagnostic ECG Database'den türetildiğini belirtmektedir. Çalışmada yeni veri seti oluşturulmamıştır.
Yazar katkıları: Kaynak beyanına göre kavramsallaştırma Krishnaprasath Suryanarayanan ve Ramanamurthy Gajula; metodoloji, yazılım, doğrulama, formal analiz, araştırma, kaynaklar ve özgün taslak Krishnaprasath Suryanarayanan; görselleştirme iki yazar; denetim Ramanamurthy Gajula tarafından gerçekleştirilmiştir.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını beyan etmektedir.
Donanım doğrulaması: Yapılmamıştır. Kaynak Bölüm 2.8'de FP32 inference, INT8 approximation, threshold optimization ve metric evaluation işlemlerinin MATLAB tabanlı CPU ortamında tamamen yazılım olarak gerçekleştirildiğini ve microcontroller/accelerator hardware gerekmediğini açıkça belirtmektedir. Dolayısıyla çalışma gerçek TinyML cihaz benchmark'ı değildir.
Bellek değerlendirmesi: 5,44 KB ve 1,36 KB değerleri 1393 model parametresinin sırasıyla 4 byte ve 1 byte olarak saklanmasına dayalı teorik parameter-storage hesabıdır. Gerçek cihazın toplam Flash/RAM ihtiyacını temsil etmez.
Kaynak içi tutarsızlık 1 — confusion matrix sınıf etiketleri: Veri seti açıklamasında 4046 normal ve 10.506 abnormal ECG beat olduğu yazılıdır. FP32 ve INT8 confusion matrix'lerinde 4046 örnek içeren satır “Abnormal”, 10.506 örnek içeren satır “Normal” olarak etiketlenmiştir. İki şeklin aynı şekilde ters etiketlenmiş olması sistematik bir sınıf-label sorunu olduğunu düşündürmektedir.
Kaynak içi tutarsızlık 2 — FP32 precision: Confusion matrix sınıfları veri setindeki sayılara göre düzeltilerek yeniden hesaplandığında FP32 precision yaklaşık %86,03'tür. Kaynak %85,88 bildirmektedir. Accuracy, recall ve F1 matrisle uyumludur.
Kaynak içi tutarsızlık 3 — batch/MSE örnek sayısı: Bölüm 2.4 training batch size değerini 256 olarak verirken Eşitlik (4)'ün altında M'nin training sample sayısı olarak 128 olduğu yazmaktadır. Aradaki fark kaynakta açıklanmamıştır.
Kaynak içi tutarsızlık 4 — şekil atıfları: Bölüm 3.1 FP32 ROC curve için Şekil 6'ya, Bölüm 3.2 INT8 ROC için Şekil 7'ye yönlendirmektedir. Gerçekte Şekil 6 INT8 confusion matrix, Şekil 7 FP32 ROC, Şekil 8 ise FP32–INT8 ROC karşılaştırmasıdır.
Performans sınırı: Kaynağın “real-time” ve “low-power” değerlendirmeleri modelin küçüklüğü ve potansiyel TinyML deployment kabiliyetine dayanmaktadır. Çalışma gerçek cihazda measured latency, watt/mW güç tüketimi veya enerji/inference ölçümü sunmamaktadır.
Klinik sınır: Model binary anomaly screening gerçekleştirmektedir ve belirli arrhythmia türünü sınıflandırmamaktadır. Kullanılan sonuçlar retrospektif veri seti/model değerlendirmesidir; gerçek hasta başında prospektif tanısal performans çalışması değildir.
Bu Verianla açıklamasındaki bilimsel yöntem, sayısal sonuçlar, confusion matrix kalite kontrolü, model yapısı, quantization mekanizması ve sınırlılıklar incelenen çalışmaya dayanmaktadır. Dış doğrulama yalnız bibliyografik yayın kimliğinin teyidi amacıyla kullanılmış; kaynağa dışarıdan yeni klinik performans değeri veya ECG tanı sonucu eklenmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir