

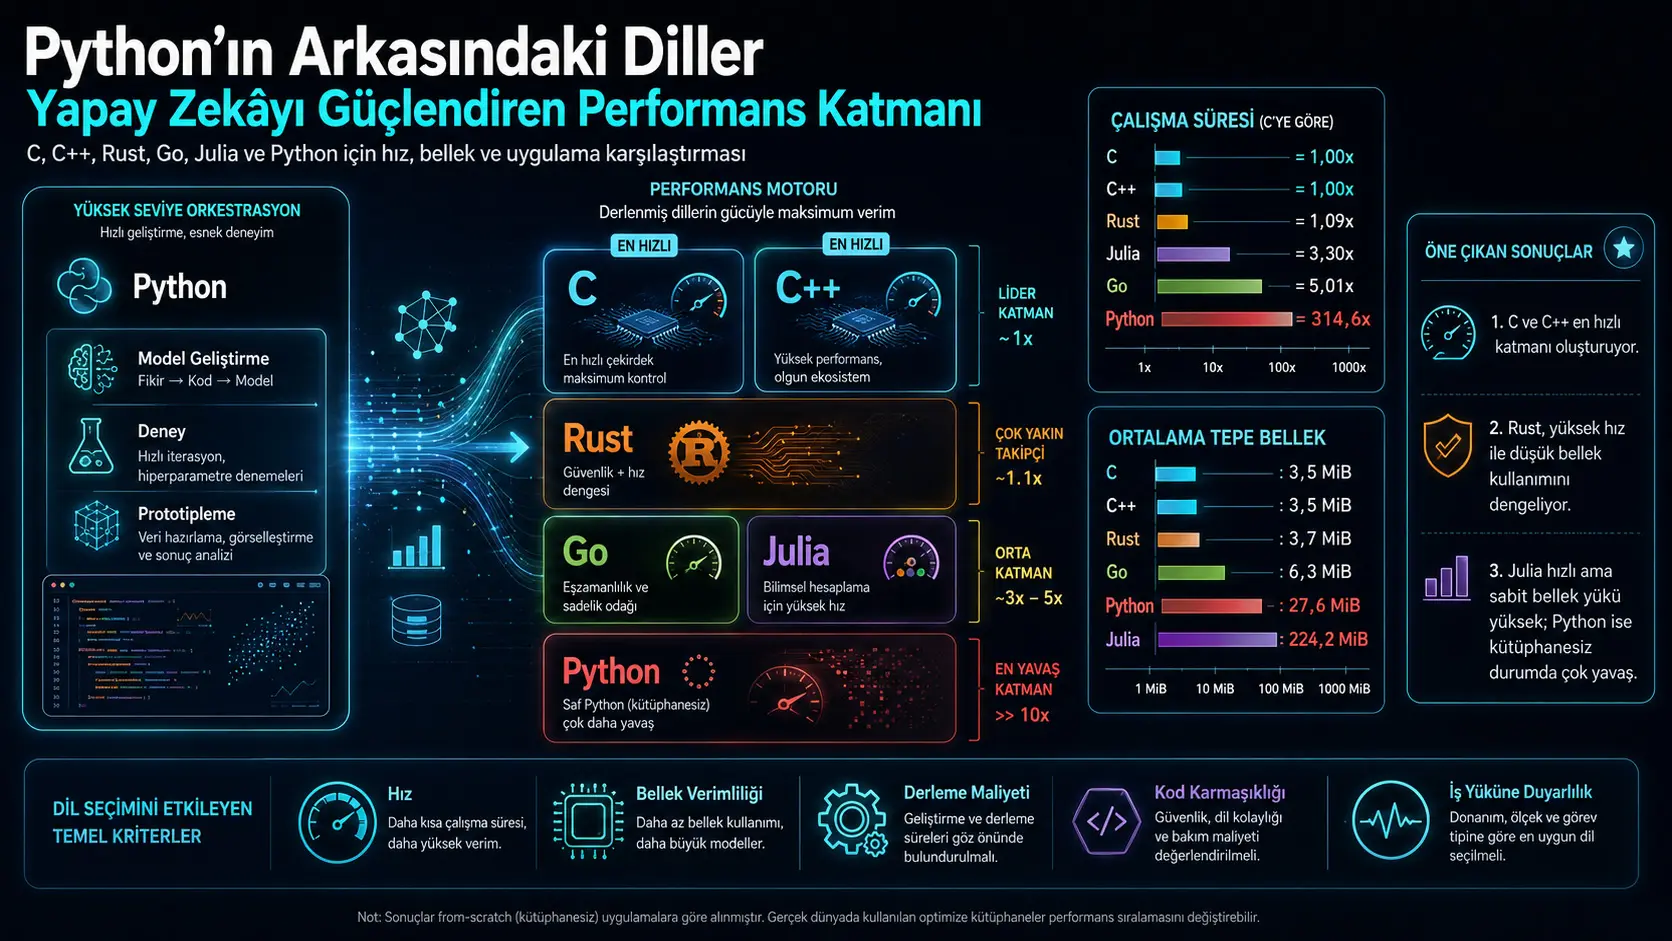
Ин таҳқиқот k-means, k-nearest neighbors, multilayer perceptron, genetic algorithm ва Mamdani fuzzy-inference system-ро дар Python, C, C++, Rust, Go ва Julia бе истифодаи external numerical library аз сифр implemented карда, execution time, peak memory consumption, executable file size, lines of code ва compilation time-ро муқоиса кардааст. Дар experiments рӯи Apple M1 Pro, C ва C++ тақрибан дар як speed level қарор гирифтанд, Rust бошад дар geometric mean аз C %9 сусттар буд. Julia execution time-и 3,30 маротиба C, Go 5,01 маротиба ва Python 314,6 маротиба C нишон дод. Аммо азбаски results ба single hardware ва operating system, small classical AI algorithms ва library-free implementations такя мекунанд, онҳоро мустақим ба modern GPU models ё real Python applications бо NumPy ва PyTorch generalize кардан мумкин нест.
Memory results аз execution-time ranking picture-и дигар нишон доданд. C, C++ ва Rust дар ҳамаи tests зери 6 MiB монданд, дар ҳоле ки Go average 6,3 MiB, Python 27,6 MiB ва Julia 224,2 MiB peak resident memory истифода карданд. High value-и Julia runtime ва just-in-time compilation overhead-ро инъикос мекунад, ки аз test data largely independent менамояд. Ҳамчунин нишон дода шуд, ки language ranking аз workload вобаста аст: slowdown-и Go нисбат ба C дар k-NN тақрибан 2,6 маротиба буд, аммо дар k-means test ба тақрибан 8 маротиба расид.
Аз нигоҳи Туркия: Findings барои teams-и Туркия, ки AI infrastructure, embedded systems, industrial automation, robotics, local inference services ва resource-constrained edge devices таҳия мекунанд, муҳиманд. Таҳқиқот нишон медиҳад, ки вақте algorithm бояд мустақим ва бе library implemented шавад, интихоби language метавонад дар time ва memory фарқи калон эҷод кунад. Пеш аз technology decision дар Туркия, ҳамин benchmarks бояд дар target x86-64 ё ARM processors, Linux ва Windows environments, real datasets, local ё enterprise software stack ва дар ҳолати зарурӣ GPU acceleration такрор шаванд. Аз study наметавон хулоса кард, ки C++ ё Rust дар ҳамаи AI projects-и Туркия ҳатман best choice ҳастанд ё Python дар real applications садҳо маротиба суст кор мекунад.
Саволи асосии таҳқиқот чист?
Таҳқиқот меомӯзад, ки AI developer ҳангоми дастрас набудани ready-made library кадом programming language-ро интихоб кунад. Чунин ҳолат метавонад вақте рух диҳад, ки барои algorithm ҳанӯз library implementation вуҷуд надорад, target device resource-constrained аст ё basic components-и new AI infrastructure таҳия мешаванд.
Starting point-и study он аст, ки language-и visible дар AI application ва language-и иҷрои heavy computation аксар вақт як нестанд. Гарчанде Python барои experiment design, data flow ва model calls истифода шавад, NumPy, PyTorch ва similar frameworks performance-critical computations-ро аксаран ба compiled native code медиҳанд. Аз ин рӯ, speed-и library-е, ки аз Python истифода мешавад, танҳо speed-и Python interpreter-ро represent намекунад.
Researchers барои бартараф кардани ин confusion ҳамаи algorithms-ро дар Python, C, C++, Rust, Go ва Julia бе external machine-learning ё numerical-computing libraries аз сифр implemented карданд. Ҳадаф ин буд, ки observed differences то ҳадди имкон аз language implementations, compilers ва runtime systems бароянд, на аз third-party libraries.
Кадом gap дар literature ҳадаф қарор гирифтааст?
Programming languages қаблан аз рӯи execution time, energy consumption, memory use ва code-development cost comparison шудаанд. Аммо traditional language benchmarks аксаран general-purpose workloads мисли sorting, recursion, tree processing ё small numerical kernels истифода мекунанд. Ин workloads метавонад iterative optimization, dense floating-point computation, population-based search ва rule-based inference patterns-и AI algorithms-ро ҳамзамон represent накунанд.
Аз тарафи дигар, бисёр language comparisons дар AI context ready-made highly optimized libraries истифода мекунанд. Дар test-е, ки Python ва Julia program ҳамон native numerical kernel-ро call мекунанд, measured time метавонад бештар underlying C, C++, Rust ё GPU implementation-ро чен кунад, на high-level language-ро. Study ҳадаф дошт gap байни ин ду comparison type-ро бо library-free ва algorithmically matched implementations пур кунад.
Кадом languages ва toolchains муқоиса шуданд?
| Programming language | Compiler ё runtime | Setting used in study | Execution model |
|---|---|---|---|
| Python | CPython 3.14.3 | Additional flag истифода нашудааст. | Interpreted runtime |
| C | Apple Clang 17.0.0 | -O3 -march=native | Ahead-of-time compiled native code |
| C++ | Apple Clang 17.0.0 | -O3 -march=native -std=c++17 | Ahead-of-time compiled native code |
| Rust | rustc 1.93.0 | opt-level=3, lto=true, codegen-units=1 | Ahead-of-time compiled native code |
| Go | gc 1.26.3 | Default go build | Ahead-of-time compiled, managed runtime |
| Julia | Julia 1.9.2 | Default JIT settings | Just-in-time compilation |
Experiments дар MacBook бо Apple M1 Pro processor, six performance ва two efficiency cores, 16 GB unified memory ва macOS иҷро шуданд. SIMD intrinsics, manual vectorization ва external numerical libraries истифода нашуданд.
Чаро five AI algorithms интихоб шуданд?
Algorithms на барои represent кардани state-of-the-art modern AI models, балки барои controlled ва reproducible testing-и different computational patterns интихоб шуданд. Five algorithms areas-и data mining, instance-based learning, neural-network training, evolutionary computation ва fuzzy logic-ро фаро мегиранд.
| Algorithm | Represented area | Main experimental parameters | Compute-heavy characteristic |
|---|---|---|---|
| k-means | Data mining | 100.000 points, 4 dimensions, 10 clusters, 1.000 fixed iterations | Dense distance calculation ва iterative center update |
| k-NN | Machine learning | 50.000 training points, 10.000 queries, 8 dimensions, k=15, 3 classes | Distance, comparison ва indexing |
| MLP | Neural networks | 16→64→4 architecture, 10.000 samples, 150 epochs, learning rate 0,01 | Dense floating-point operations ва backpropagation |
| Genetic algorithm | Computational intelligence | 30 dimensions, 5.000 individuals, 1.200 generations, tournament size 3 | Branching, population-based search ва random operations |
| Mamdani system | Fuzzy systems | 2 inputs, 3 membership functions per input, 9 rules, 2 million inferences | Rule evaluation, min–max operations ва centroid calculation |
Ҳисобкунии яксон байни languages чӣ гуна таъмин шуд?
Researchers дар ҳамаи languages same algorithm specifications, initial conditions, tie-breaking rules ва stopping criteria истифода карданд. Барои matching random inputs дар ҳар language same 64-bit linear congruential generator implemented шуд.
\[ s_{i+1} = (a s_i + c) \bmod 2^{64} \]
Дар ин equation si 64-bit internal state дар i-th step; a multiplier ва c increment constant-ро нишон медиҳад. Дар study:
- a = 6364136223846793005
- c = 1442695040888963407
- initial seed s0 = 42
муайян шудааст.
\[ u_i = \frac{s_i \gg 33}{2^{31}} \]
Operation-и >> 33 дар ин ҷо маънои right shift кардани 64-bit state ба 33 bit дорад. Integer-и ҳосилшуда ба 231 тақсим шуда, dimensionless pseudo-random number сохта мешавад. Consumption-и numbers дар same order дар ҳар language matched experimental inputs-ро таъмин кард.
Барои пешгирӣ аз differences байни math libraries-и languages, transcendental functions мисли square root, exponential, logarithm ва cosine хориҷ шуданд. Дар k-NN ва k-means tests squared Euclidean distance ба ҷои square root истифода шуд. Дар MLP ба ҷои sigmoid ё softmax ReLU ва mean squared error истифода гардид. Дар genetic algorithm, polynomial Rosenbrock function ба ҷои cosine-containing Rastrigin function интихоб шуд.
Ҳар program integer ва floating-point output fingerprint тавлид кард. Integer fingerprints дар six languages exactly matched шуданд, floating-point summaries то six decimal places identical буданд. Азбаски compilers метавонанд fused multiply-add истифода кунанд, study нишон намедиҳад, ки ҳамаи intermediate floating-point results absolutely bitwise identical ҳастанд.
Time ва memory чӣ гуна чен шуданд?
Ҳар language–algorithm pair пас аз three warm-up runs ten times measured шуд. Wall-clock time бо hyperfine, peak resident memory use бошад бо /usr/bin/time -l ва ru_maxrss дар macOS муайян шуд. Standard output ба /dev/null redirected шуд, аммо барои пешгирӣ аз dead-code elimination programs fingerprint-ҳоро ҳамоно ҳисоб ва print карданд.
Ғайр аз runtime ва memory, compiled file size, total lines of code across five implementations ва cold compile time пас аз cache cleanup низ measured шуданд. Slowdown ratios дар different algorithms пас аз normalization нисбат ба C бо geometric mean combine шуданд.
Runtime results чиро нишон медиҳанд?
Fastest performance tier аз C, C++ ва Rust иборат буд. Differences байни C ва C++ дар ҳамаи five tests зери %2 монданд. C++ дар k-means, k-NN, MLP ва genetic algorithm tests бо margin-и хурд пеш буд, C бошад дар fuzzy-inference test lower time дод. Geometric-mean slowdown ratio-и Rust нисбат ба C 1,09 буд.
| Language | k-means (s) | k-NN (s) | MLP (s) | Genetic algorithm (s) | Fuzzy system (s) | Geometric ratio relative to C |
|---|---|---|---|---|---|---|
| C | 0,717 | 0,748 | 0,678 | 0,728 | 0,369 | 1,00 |
| C++ | 0,706 | 0,746 | 0,675 | 0,722 | 0,372 | 1,00 |
| Rust | 0,769 | 0,861 | 0,774 | 0,772 | 0,375 | 1,09 |
| Julia | 3,062 | 2,200 | 3,113 | 1,074 | 1,698 | 3,30 |
| Go | 5,710 | 1,969 | 4,174 | 2,688 | 2,451 | 5,01 |
| Python | 332,0 | 261,2 | 220,4 | 108,7 | 144,7 | 314,6 |
Logarithmic graph дар page 9 three performance tiers-ро visually clearly ҷудо мекунад. Bars-и C, C++ ва Rust дар lower section-и graph хеле наздиканд, Julia ва Go дар middle region ҳастанд. Python bars дар ҳамаи algorithms аз other languages хеле баландтаранд.
Difference-и Python relative to C аз algorithm вобаста буд. Lowest ratio дар branching-heavy genetic algorithm тақрибан 149 times ва highest ratio дар arithmetic-intensive k-means test тақрибан 463 times буд. Ин result нишон медиҳад, ки Python дар ҳамаи workloads бо як fixed ratio slow нест.
Result-и 315 times барои Python чӣ гуна interpretation шавад?
Value-и 314,6 times маънои онро надорад, ки ҳамаи AI applications written in Python аз C ҳамин қадар slower ҳастанд. Study Python code-ро бе NumPy, PyTorch, Numba, Cython, JAX ё other native computing library, бо explicit loops ва scalar operations иҷро кардааст.
Main advantage-и Python дар real AI development software ecosystem-и васеъ аст, ки numerical operations-ро ба optimized native kernels интиқол медиҳад. Result-и study нишон медиҳад, ки вақте Python аз ин libraries маҳрум мешавад, language-level interpretation cost равшан мегардад. Result нишон намедиҳад, ки model trained with PyTorch аз same C++ model 315 times slower мешавад.
Кадом language дар memory use фарқ кард?
C ва C++ average 3,5 MiB ва Rust 3,7 MiB peak resident memory истифода карданд. Average-и Go 6,3 MiB, Python 27,6 MiB ва Julia 224,2 MiB measured шуд.
| Language | k-means (MiB) | k-NN (MiB) | MLP (MiB) | Genetic algorithm (MiB) | Fuzzy system (MiB) | Average (MiB) |
|---|---|---|---|---|---|---|
| C | 4,7 | 5,1 | 2,8 | 3,6 | 1,2 | 3,5 |
| C++ | 4,8 | 5,2 | 2,8 | 3,6 | 1,3 | 3,5 |
| Rust | 5,2 | 5,4 | 2,9 | 3,7 | 1,3 | 3,7 |
| Go | 8,1 | 8,4 | 5,3 | 6,1 | 3,8 | 6,3 |
| Python | 37,6 | 38,1 | 24,2 | 23,2 | 14,7 | 27,6 |
| Julia | 228,7 | 216,2 | 234,3 | 225,3 | 216,5 | 224,2 |
Дар logarithmic memory graph дар page 11 bars-и Julia дар ҳамаи workloads тақрибан same height ва clearly above other languages мебошанд. Ин observation interpretation-ро support мекунад, ки Julia барои JIT compiler ва runtime fixed startup cost дорад. Дар long-running ва large-data applications relative importance-и ин fixed cost метавонад кам шавад; аммо дар small short-lived tasks ё low-memory devices муҳим бошад.
Оё code length воқеан productivity-ро measure мекунад?
Total lines of code дар five algorithms барои C++ 397, барои C ва Python 406, Rust 474, Julia 514 ва Go 541 report шудаанд. Он ки Python аз C shorter нест, яке аз notable findings-и study мебошад.
Аммо lines of code ба development time, maintainability, defect rate, readability ё developer experience баробар нест. Study actual time-и сарфкардаи developers барои writing algorithms ё debugging cost-ро measure накардааст. Аз ин рӯ, line count танҳо limited implementation-complexity indicator мебошад.
| Language | Executable file size | Total lines of code | Cold compile time |
|---|---|---|---|
| C | 33,6 KB | 406 | 0,93 сония |
| C++ | 33,7 KB | 397 | 1,13 сония |
| Rust | 373,1 KB | 474 | 8,73 сония |
| Go | 2.509,4 KB | 541 | 3,30 сония |
| Python | Not applicable | 406 | Not applicable |
| Julia | Not applicable | 514 | Not applicable |
Longer compile time-и Rust бояд якҷоя бо aggressive optimization settings мисли link-time optimization ва single code-generation unit дар study арзёбӣ шавад. File-и Go бо size-и тақрибан 2,5 MB бошад ба дохил шудани runtime ва garbage collector ба executable вобаста дониста шудааст.
Radar graph дар page 12 чиро нишон медиҳад?
Radar graph speed, memory, binary file size, compilation ва lines-of-code metrics-ро normalize мекунад, то higher value better бошад. Lines-и C ва C++ тақрибан пурра overlap мекунанд. Rust дар speed ва memory axes ба ин ду language наздик мешавад, аммо дар compilation ва file-size axes қафо мемонад.
Julia ва Python дар lines-of-code axis то андозае беҳтар менамоянд, аммо дар runtime ва memory axes lower values мегиранд. Бо вуҷуди ин, normalization-и heterogeneous metrics дар single graph маънои онро надорад, ки як language барои ҳамаи projects generally superior аст. Кадом axis барои project муҳимтар аст, separately муайян карда мешавад.
Чаро language ranking аз workload вобаста тағйир меёбад?
Slowdown ratio-и Go relative to C дар k-NN тақрибан 2,6 times ва дар k-means test тақрибан 8 times мебошад. k-means, MLP ва fuzzy-inference tests dense floating-point computation ва reductions доранд, дар ҳоле ки k-NN бештар comparison ва indexing-heavy аст. Compiler optimizations, bounds checks, memory layout ва runtime behavior метавонанд ба ин operation types differently таъсир кунанд.
Julia strongest relative result-ашро дар genetic algorithm дод. Researchers инро ба branching-heavy structure-и genetic algorithm нисбат медиҳанд, ки баъзе advantages-и aggressively optimized systems languages-ро кам мекунад. Ин explanation ҳамчун reasonable interpretation пешниҳод шудааст, вале бо hardware counters ё low-level processor profiles directly tested нашудааст.
Кадом conclusions аз study supported мебошанд?
- Дар library-free classical AI algorithms written from scratch, C ва C++ strongest tier дар runtime ва memory буданд.
- Rust зери optimization settings-и истифодашуда дар geometric mean аз C %9 қафо буд ва similar memory consumption нишон дод.
- Julia дар runtime дар аксари tests аз Go faster буд, аммо fixed memory overhead-и хеле баланд дошт.
- Relative performance-и Go вобаста ба computational structure-и algorithm noticeably тағйир ёфт.
- Python ҳангоми иҷро бо explicit loops бе optimized native libraries аз other languages хеле slower result дод.
- Language choice бояд на танҳо бо runtime, балки бо memory, file size, compile time, safety ва target runtime environment якҷоя арзёбӣ шавад.
Таҳқиқот чиро исбот намекунад?
- Исбот намекунад, ки ҳамаи AI applications developed in Python аз C 315 times slower ҳастанд.
- Real performance-и PyTorch, TensorFlow, NumPy, JAX ё GPU libraries-ро comparison намекунад.
- Нишон намедиҳад, ки C++ ё Rust дар ҳамаи hardware, operating systems ва algorithms best language мебошанд.
- Исбот намекунад, ки lines of code actual development time ё programmer productivity-ро represent мекунанд.
- Energy consumption, parallel scalability, GPU performance, network latency ё distributed-system behavior-ро measure намекунад.
- Computational structure-и modern transformer, large language model ё large-scale deep-learning training-ро directly represent намекунад.
Нуқтаҳои қавии таҳқиқот кадоманд?
- Same five algorithms дар six languages аз сифр implemented шуданд.
- Inputs бо common pseudo-random number generator matched шуданд.
- Initialization, tie-breaking ва stopping rules clearly defined шуданд.
- Computational equivalence бо output fingerprints checked шуд.
- Ҳар timing measurement бо three warm-ups ва ten measurement runs иҷро шуд.
- Ғайр аз runtime, memory, file size, lines of code ва compilation cost низ evaluated шуданд.
- Five algorithms бо different computational patterns истифода шуда, workload-dependent variation нишон дода шуд.
Маҳдудиятҳои асосии таҳқиқот кадоманд?
Ҳама measurements дар single Apple M1 Pro computer ва macOS анҷом шуданд. Guarantee нест, ки same code дар x86-64 processors, Linux ё Windows, other compilers ва different memory architectures same ratios медиҳад.
Julia measurements startup ва JIT compilation cost-ро дар бар мегиранд. Дар short tests ин cost метавонад қисми муҳими total time бошад; дар long-running applications бошад дар байни many operations amortize мешавад. Аз ин рӯ, Julia results барои persistent service ва one-shot command-line task маънои яксон надоранд.
Exclusion-и external libraries, SIMD, manual vectorization ва GPU study-и basic language execution model-ро осон кард, аммо representativeness барои real AI software-ро кам кард. Дар modern systems heavy matrix operations одатан дар BLAS, CUDA, Metal ё other native kernels иҷро мешаванд.
Барои numerical matching transcendental functions мисли exponential, logarithm, square root ва trigonometric functions хориҷ шуданд, ки баъзе important operation types-и real machine-learning workloads-ро outside scope гузошт. MLP model низ бояд ҳамчун controlled dense-compute kernel арзёбӣ шавад, на ҳамчун modern deep network.
Усул ва бозёфтҳои таҳқиқот
Technical summary-и experimental setup
| Experimental component | Applied method | Interpretation limit |
|---|---|---|
| Hardware | Apple M1 Pro, 6 performance ва 2 efficiency cores, 16 GB unified memory | Other processor architectures test нашудаанд. |
| Operating system | macOS | Linux ва Windows results нестанд. |
| Implementation approach | From scratch дар six languages ва бе external numerical libraries | Speed-и real AI frameworks-ро represent намекунад. |
| Randomness | 64-bit LCG, initial seed 42 | Different generators дар real applications comparison нашудаанд. |
| Numerical operations | Basic IEEE 754 addition, subtraction, multiplication, division ва min–max operations | Transcendental functions intentionally excluded шуданд. |
| Timing | 3 warm-ups followed by 10 measurement runs | Very long-running service behavior омӯхта нашудааст. |
| Memory measurement | Peak resident-set size via ru_maxrss | Total allocation ё energy consumption measure нашудааст. |
| Stability | Relative standard deviation зери %4 дар all language–test pairs | Confidence interval ё p-value барои most comparisons дода нашудааст. |
Three main performance tiers
- High-performance tier: C, C++ ва Rust. C ва C++ practically same level, Rust geometric mean %9 behind.
- Middle tier: Julia ва Go. Julia runtime-и 3,30 times C ва Go 5,01 times C нишон дод.
- Interpreter tier: Library-free Python geometric-mean time-и 314,6 times C расид.
Speed ва memory together
C ва C++ lowest values дар ҳам runtime ва ҳам memory доданд. Rust бо very small memory difference ба онҳо наздик монд. Julia дар many tests аз Go faster буд, аммо fixed memory overhead-и тақрибан 224 MiB дошт, дар ҳоле ки Go зери 10 MiB монд. Аз ин рӯ, choice байни Julia ва Go танҳо аз рӯи speed карда намешавад.
Дар resource-constrained short-lived edge application fixed runtime cost-и Julia метавонад муҳим бошад. Барои long-running service бо many computations same cost дар байни operations amortize мешавад. Гарчанде Go larger executable file тавлид кунад, runtime memory use аз Julia ва Python пасттар монд.
Practical framework барои implementation-language choice аз study
| Project priority | Evaluation supported by study | Important limitation |
|---|---|---|
| Lowest runtime | C ва C++ strongest results доданд. | Safety, maintenance ва development cost measure нашудаанд. |
| Memory safety near native speed | Rust average %9 behind C ва similar memory level аст. | Compile time longer аст. |
| High-level numerical code with JIT | Julia дар most workloads аз Go faster аст. | Fixed memory cost-и тақрибан 224 MiB дорад. |
| Low runtime memory ва easy distribution | Go аз Julia ва Python less memory истифода кардааст. | Slowdown дар arithmetic-intensive tests high буд. |
| Ready AI ecosystem | Study value-и Python ecosystem-ро indirectly нишон медиҳад. | Ready libraries intentionally excluded шуданд. |
Тарзи дурусти истифодаи results
Study universal ranking барои “best AI language” пешниҳод намекунад. Results controlled comparison-и library-free classical algorithms дар single-core ё limited-parallel CPU implementations мебошанд. Ҳангоми language choice actual algorithm, target processor, memory limit, operating system, safety requirement, team experience, libraries used ва expected program lifetime бояд together арзёбӣ шаванд.
Ёддошти манбаъ ва усул
Номи пурраи аслии таҳқиқот: Behind Python: The Languages That Power AI
Муаллифон: Juan P. Licona-Luque, Beatriz A. Bosques-Palomo, Nezih Nieto-Gutiérrez, Gustavo de los Ríos-Alatorre ва Luis A. Muñoz-Ubando
Тартиби муаллифон: Рӯйхати боло original author order-и study-ро нигоҳ медорад.
Co-first-author information: Equal contribution ё co-first-authorship information вуҷуд надорад.
Corresponding-author information: Study explicit corresponding-author statement надорад. arXiv submission аз ҷониби Juan P. Licona-Luque анҷом шудааст; ин information ҳамчун corresponding authorship interpretation нашудааст.
Institution: Tecnológico de Monterrey, Monterrey, Nuevo León, Мексика
Journal: Study дар journal published нашудааст.
Original publisher: Original journal publisher information нест.
Publication platform: arXiv
arXiv identifier: arXiv:2606.18141 [cs.PL]
Publication year: 2026
Source type: Preprint бо controlled experimental performance benchmarking
Peer-review status: Ин study preprint аст ва peer-reviewed буданаш verify нашудааст; results бояд бо ҳамин limitation хонда шаванд.
Official link:arXiv study page
Ин мақолаи тоҷикӣ бо review-и full text, formula, tables ва graphs-и uploaded 17-page study омода шудааст. Performance values, memory consumption, toolchains ва algorithm parameters танҳо аз information-и дар study reported гирифта шудаанд. External sources танҳо барои bibliographic verification-и title, authors, DOI, platform, date ва publication status истифода шудаанд.
Main limitations-и study single hardware ва operating system, exclusion-и external libraries ва GPU, дохил кардани Julia startup ва JIT cost ба measurements, набудани modern deep-learning kernels ва ин ки lines of code direct measure-и development productivity нест мебошанд. Ин results набояд ҳамчун general performance comparison-и modern AI frameworks, large language models ё GPU training interpretation шаванд.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд