

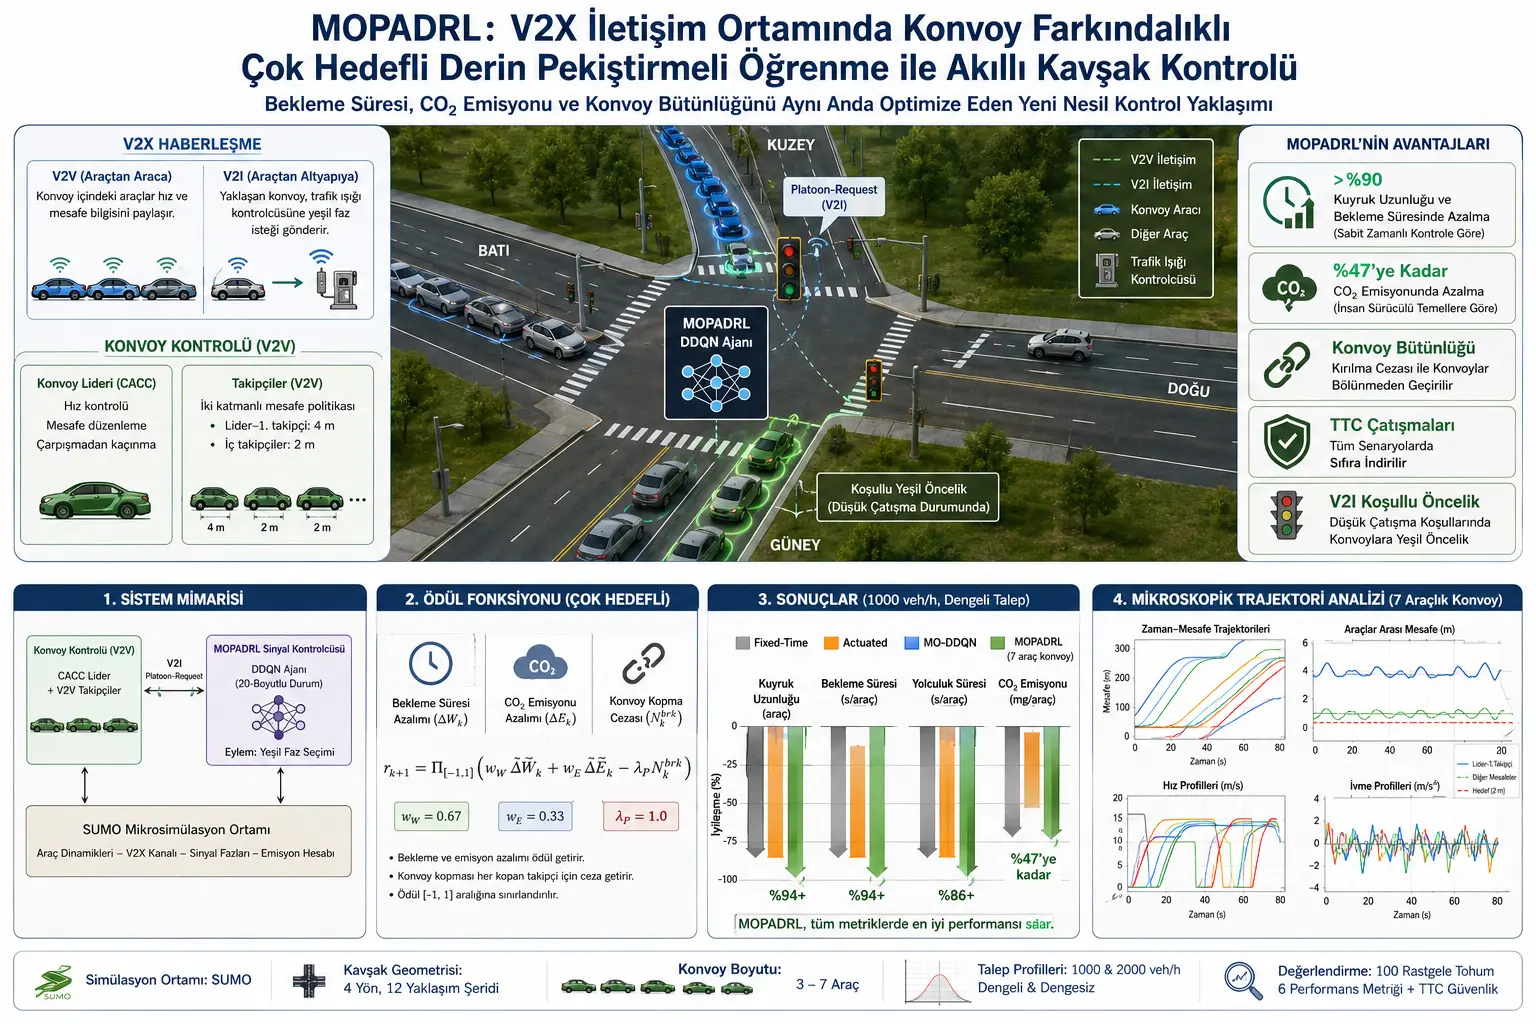
Чорроҳаҳои сигналии дохилишаҳрӣ яке аз муҳимтарин нуқтаҳои гиреҳии низоми нақлиёт мебошанд. Воситаҳои нақлиёт аз самтҳои гуногун ба чорроҳа меоянд, ба чап мегарданд, рост ҳаракат мекунанд, ба рост мегарданд ва ҳамаи ин ҳаракатҳо бо чароғҳои роҳнамо танзим мешаванд. Низомҳои анъанавии идоракунии сигналҳо кӯшиш мекунанд, ки ҳаракатҳои бо ҳам бархӯрдкунандаро ҷудо карда, бехатариро таъмин намоянд; аммо афзоиши шумораи воситаҳои нақлиёт, тағйирёбии талабот, навбатҳои соатҳои серодам, вақти интизорӣ, масрафи сӯзишворӣ, партоби CO2 ва хатари садама ин низомҳоро ҳарчи бештар зери фишор қарор медиҳанд.
Таҳқиқот ин мушкилро аз се ҷиҳат баррасӣ мекунад. Якум, мушкили сербандӣ мебошад. Ҳар қадар воситаҳои нақлиёт дар чароғаки сурх интизор шаванд, навбат пайдо мешавад, иқтидори чорроҳа кам мегардад ва вақти сафар меафзояд. Дуюм, таъсири экологӣ мебошад. Ҳаракатҳои исту-ҳаракат ва интизории нолозим партобро ба ҳар воситаи нақлиёт зиёд мекунанд. Сеюм, бехатарӣ мебошад. Хусусан ҳангоми наздик шудан ба чорроҳа, таваққуфи ногаҳонӣ, пайравии аз ҳад наздик ва хатогиҳои ронандагони инсонӣ метавонанд вақти то бархӯрдро кам карда, хатари муноқишаро зиёд намоянд.
Ҷиҳати навоваронаи ин таҳқиқот дар он аст, ки идоракунии сигнал на танҳо аз рӯи воситаҳои нақлиёти алоҳида, балки дар доираи корвонҳои воситаҳои нақлиёт, яъне сохторҳои platoon, баррасӣ мешавад. Воситаҳои нақлиёти автоматӣ ва пайвастшуда метавонанд тавассути алоқаи V2V бо фосилаҳои хеле мунтазам ҳаракат кунанд. Аммо агар чароғаки роҳнамо ин корвонро аз миёна ҷудо кунад, мошинҳои пешин гузашта метавонанд, дар ҳоле ки мошинҳои ақибмонда дар чароғаки сурх мемонанд. Ин ҳолат на танҳо якпорчагии корвонро вайрон мекунад; балки интизории паси хат, аз нав суръат гирифтан, партоби иловагӣ ва ташаккули навбати навро ҳам ба вуҷуд меорад. Аз ин рӯ, таҳқиқот ба чунин савол ҷавоб меҷӯяд: Оё идоракунандаи чароғаки роҳнамо метавонад ҳам вақти интизорӣ, ҳам партоби CO2 ва ҳам ҷудошавии корвонҳои воситаҳои нақлиёти автоматиро дар як вақт кам кунад?
Чаро ин мушкил муҳим аст?
Яке аз бузургтарин мушкилот дар низомҳои нақлиёти интеллектуалӣ ба ҳам вобаста будани ҳадафҳои гуногун мебошад. Агар идоракунандаи ҳаракат танҳо барои кам кардани вақти интизорӣ кӯшиш кунад, метавонад ба баъзе самтҳо сабзи дарозтар дода, дар кӯтоҳмуддат натиҷаи хуб ба даст орад. Аммо ин approach метавонад корвонҳои аз самти дигар омадаро ҷудо кунад, партобро зиёд намояд ё аз ҷиҳати бехатарӣ мавҷҳои номатлуби исту-ҳаракат эҷод кунад. Танҳо кам кардани партоб низ кофӣ нест; зеро агар дар чорроҳа навбатҳои дароз пайдо шаванд, низом дар амал ноком мегардад. Танҳо нигоҳ доштани корвон низ кофӣ нест; зеро дар самтҳои дигар интизории беадолатона ва сербандӣ ба вуҷуд омада метавонад.
Аз ин рӯ, таҳқиқот идоракунии чорроҳаро ҳамчун масъалаи бисёрҳадафа месозад. Модели MOPADRL се ҳадафро якбора ба назар мегирад:
- Самаранокии ҳаракат: Кам кардани вақти интизорӣ ва навбатҳо,
- Таъсири экологӣ: Паст кардани партоби CO2,
- Якпорчагии корвон: Ҷарима кардани ҷудошавии корвон аз сабаби чароғаки сурх.
Ин approach нишон медиҳад, ки дар шаҳрҳои оянда, ки воситаҳои нақлиёти пайвастшуда ва автоматӣ маъмул мегарданд, чорроҳаҳоро дигар танҳо бо нақшаҳои собити чароғ идора кардан мумкин нест. Чорроҳа бояд на танҳо шумораи воситаҳои нақлиёти омадаистодаро, балки сохтор, ҳолати алоқа, муносибатҳои корвонӣ ва фосилаи наздикшавии онҳоро низ дарк кунад.
Холигии адабиёт дар чист?
Таҳқиқот камбудии муҳими корҳои қаблиро равшан нишон медиҳад. Дар бораи идоракунии чароғҳои роҳнамо бо deep reinforcement learning таҳқиқоти зиёде мавҷуданд. Дар бораи platoon-ҳои воситаҳои нақлиёти автоматӣ низ адабиёти васеъ вуҷуд дорад. Аммо корҳое, ки ин ду соҳаро якҷо баррасӣ мекунанд, маҳдуданд.
Баъзе таҳқиқоти мавҷуда дар идоракунии чароғҳо single-objective optimization истифода мекунанд; масалан, танҳо ба кам кардани delay ё waiting time тамаркуз мекунанд. Баъзе корҳои дигар, ҳатто агар platoon-ҳоро ба назар гиранд ҳам, рафтори корвонро бо microscopic V2V/V2I communication ба таври муфассал model намекунанд ва ба simulation add-on-ҳои тайёр ё assumptions-и бештар макроскопӣ такя мекунанд. Ҳамчунин таъсири систематикии platoon size ба performance-и чорроҳа дар аксари таҳқиқот ба таври муфассал санҷида нашудааст.
Ин таҳқиқот мекӯшад ин холигиро бо се саҳми асосӣ пур кунад:
- Як DDQN signal controller-и platoon-aware ва multi-objective таҳия мекунад.
- Модели microscopic platoon-following-и ба V2V communication асосёфтаро месозад ва онро дар time domain аз ҷиҳати бехатарӣ ва string stability validate мекунад.
- Platoon size-ро аз 3 то 7 vehicles тағйир дода, optimal platoon size-ро дар balanced ва unbalanced demand scenarios меомӯзад.
Архитектураи MOPADRL чӣ гуна кор мекунад?
Архитектураи низом аз се қабат иборат аст. Қабати аввал platoon control мебошад. Дар ин ҷо platoon leader бо CACC, яъне Cooperative Adaptive Cruise Control model, ҳаракат мекунад. Platoon followers бошанд бо follower-control law-и V2V-based, ки researchers пешниҳод кардаанд, аз speed, acceleration ва platoon-state information-и leader истифода мебаранд.
Қабати дуюм MOPADRL signal controller мебошад. Ин controller як Double Deep Q-Network, яъне DDQN agent, аст. Agent ҳолати ҳаракат дар чорроҳа, active signal phase ва approaching platoon information-ро мушоҳида карда, қарор медиҳад, ки кадом green phase дода шавад.
Қабати сеюм SUMO microscopic traffic simulation environment мебошад. Vehicle movement, signal phases, V2X communication channel, emission calculations ва evaluation metrics дар ҳамин муҳит иҷро мешаванд. System diagram-и study нишон медиҳад, ки platoon control ва signal controller ҳамчун ҷузъҳои ҷудо не, балки дар як simulation loop бо ҳам communication мекунанд.
Чаро V2V ва V2I communication ҳар кадом муҳиманд?
V2V communication имкон медиҳад, ки vehicles дар дохили platoon бо фосилаи бехатар ва мунтазам нисбат ба якдигар ҳаракат кунанд. Speed, acceleration ва platoon state-и leader ба followers интиқол дода мешавад. Ҳамин тавр followers на танҳо vehicle-и дар пешашон бударо мебинанд, балки ҳолати leader-ро ҳам медонанд. Ин хусусан барои ҳаракати platoon бе oscillation ҳангоми sudden braking ва re-acceleration муҳим аст.
V2I communication бошад байни platoon ва traffic light ташкил мешавад. Platoon-и наздикшаванда метавонад ба intersection controller як Platoon-Request, яъне дархости сабзи корвон, фиристад. Аммо study ин дархостро unconditional қабул намекунад. Green priority танҳо дар low-conflict conditions дода мешавад. Бо ин роҳ низом кӯшиш мекунад, ки барои гузаронидани як platoon дар самтҳои дигар queue ё conflict-и ҷиддӣ эҷод накунад.
Ин distinction хеле муҳим аст. Агар танҳо V2V бошад, vehicles байни худ мунтазам ҳаракат мекунанд, аммо traffic light метавонад онҳоро боз ҳам ҷудо кунад. Агар танҳо V2I бошад, traffic light метавонад platoon priority диҳад, аммо microscopic following behavior-и vehicles шояд ба қадри кофӣ safe ва stable набошад. MOPADRL ин ду communication mode-ро якҷо истифода карда, ҳам intra-platoon movement ва ҳам intersection-level signal decision-ро coordinate мекунад.
Модели IDM барои vehicles-и ронандаи инсонӣ
Дар study барои human-driven vehicles модели Intelligent Driver Model, яъне IDM, истифода шудааст. IDM як continuous-time car-following model аст, ки acceleration-и vehicle-ро ҳам аз рӯи наздик шудан ба target speed ва ҳам аз рӯи spacing бо vehicle-и пешина ҳисоб мекунад. Basic IDM acceleration formula чунин аст:
\[ a=a_0\left[1-\left(\frac{v}{v_0}\right)^\delta-\left(\frac{s^*(v,\Delta v)}{s}\right)^2\right] \]
Дар ин ҷо a acceleration-и vehicle, a0 maximum acceleration, v current speed, v0 desired speed, δ acceleration exponent, s actual distance to leading vehicle ва s*(v, Δv) desired dynamic following distance-ро ифода мекунад.
Desired dynamic distance чунин дода шудааст:
\[ s^*(v,\Delta v)=s_0+\max\left[0, vT+\frac{v\Delta v}{2\sqrt{a_0b}}\right] \]
Дар ин ҷо s0 standstill distance, T desired time headway, Δv relative speed ва b comfortable deceleration-ро ифода мекунад. Маънои оддии formula ин аст: ҳар қадар vehicle тезтар ҳаракат кунад ё closure rate ба vehicle-и пешина бештар шавад, safe distance калонтар мешавад. Vehicle behavior дар human-driven scenarios бо ҳамин model represented шудааст.
Модели CACC барои leader-и vehicle-и автоматӣ
Platoon leaders бо Cooperative Adaptive Cruise Control, яъне CACC, идора мешаванд. Дар ин model vehicle дар speed control, gap regulation, gap closing ва collision avoidance regimes-и гуногун ҳаракат мекунад. Дар speed-control regime acceleration command чунин дода шудааст:
\[ a_{i,k+1}=k_4(v_d-v_{i,k}) \]
Дар ин ҷо a_i,k+1 acceleration-и vehicle i дар next time step, vd desired speed, vi,k current speed ва k4 control gain мебошад. Агар vehicle зери target speed бошад positive acceleration, агар болотар бошад negative acceleration тавлид мешавад.
Дар gap-regulation regime speed update чунин ифода шудааст:
\[ v_{i,k+1}=v_{i,k}+k_5e_{i,k}+k_6\dot{e}_{i,k} \]
Дар ин ҷо e_i,k spacing error, ė_i,k rate of change of this error, k5 ва k6 control gains мебошанд. Error derivative чунин define мешавад:
\[ \dot{e}_{i,k}=v_{i-1,k}-v_{i,k}-t_da_{i,k} \]
Ин expression speed difference байни follower ва vehicle ahead, инчунин own acceleration state-ро ба назар мегирад. Ҳадаф нигоҳ доштани safe spacing ҳангоми ҳаракати vehicles ҳамчун platoon мебошад.
V2V-based follower control ва two-layer spacing policy
Яке аз original contributions-и study V2V-based control structure барои platoon followers мебошад. Як platoon чунин define мешавад:
\[ \mathcal{P}_k=\{v_{k,0},v_{k,1},...,v_{k,N_k}\} \]
Дар ин ҷо v_k,0 platoon leader, v_k,i follower i ва N_k number of followers in platoon-ро ифода мекунад. Longitudinal state-и follower чунин аст:
\[ \mathbf{x}_{k,i}(t)=(p_{k,i}(t),v_{k,i}(t)) \]
Дар ин ҷо p bumper position ва v speed мебошад. Bumper-to-bumper distance байни ду vehicle чунин аст:
\[ g_{k,i}(t)=p_{k,i-1}(t)-p_{k,i}(t)-L_{k,i-1} \]
Дар ин ҷо g_k,i spacing байни follower ва immediate predecessor ва L_k,i-1 length-и vehicle ahead-ро ифода мекунад. Vehicle length дар study 5 m гирифта шудааст.
Leader дар ҳар simulation step ба followers triple-и зеринро broadcast мекунад:
\[ \mathcal{B}(t)=(v_0(t),a_0(t),\sigma_{\mathcal{P}}(t)) \]
Дар ин ҷо v0 leader speed, a0 leader acceleration ва σP platoon-status flag мебошад. Ин flag нишон медиҳад, ки platoon completed, stopped at red ё disrupted аст.
Муҳимтарин engineering detail он аст, ки байни leader ва first follower communication delay-и як time step, яъне 0,1 seconds, қабул шудааст. Барои internal followers effective delay zero гирифта шудааст. Аз ҳамин сабаб spacing policy two-layer тарҳрезӣ шудааст:
\[ g_i^*= \begin{cases} g_{LF}^*=4.0\,m, & i=1\\ g_{II}^*=2.0\,m, & i\geq 2 \end{cases} \]
Дар ин ҷо gLF* target gap between leader and first follower ва gII* target gap between internal followers-ро ифода мекунад. Барои first follower 4 m, барои internal followers 2 m target шудаанд. Сабаб он аст, ки leader information ба first follower бо 0,1 seconds delay мерасад. Internal followers same leader broadcast-ро дар same step истифода мебаранд, бинобар ин shorter spacing кофӣ ҳисоб шудааст.
Тарҳи 4 m / 2 m spacing чӣ гуна асоснок шудааст?
Дар study two-layer spacing policy на танҳо heuristically интихоб шудааст, балки analytically derive шудааст. Дар worst-case scenario leader аз speed-и 13,89 m/s emergency brake мекунад. Азбаски first follower command-и leader-ро 0,1 seconds дер мегирад, дар ин period бо previous speed идома медиҳад. Closure distance чунин ҳисоб мешавад:
\[ \Delta_{close}=v^\circ\tau=13.89\times0.1=1.389\,m \]
Дар ин ҷо Δclose closure distance, v° cruise speed ва τ communication delay мебошад. Safety floor 2 m гирифта шудааст. Дар чунин ҳолат target leader-first-follower gap бояд inequality-и зеринро қонеъ кунад:
\[ g_{LF}^*-\Delta_{close}\geq g_{min} \]
Ин чунин маъно медиҳад:
\[ g_{LF}^*\geq g_{min}+v^\circ\tau=3.389\,m \]
Study 4 m интихоб карда, additional safety margin-и 0,611 m мегузорад. Ин design дар microscopic trajectory analysis validate шудааст. Observed minimum leader-first-follower gap дар red phase 2,61 m ва analytical prediction 2,611 m мебошад. Ин very close agreement нишон медиҳад, ки spacing design дар simulation тавре интизор буд, кор кардааст.
Масъалаи signal control чӣ гуна ҳамчун MDP сохта шудааст?
Дар study traffic-light control ҳамчун Markov Decision Process, яъне MDP, model шудааст. Basic structure чунин ифода мешавад:
\[ \mathcal{M}=(\mathcal{S},\mathcal{A},\mathcal{T},r,\gamma) \]
Дар ин ҷо S state space, A action space, T transition kernel, r reward function ва γ discount factor-ро ифода мекунад. Traffic-light controller дар ҳар decision moment current state-ро observe мекунад, як green phase интихоб мекунад ва дар натиҷа аз рӯи queue, waiting, emission ва platoon integrity reward мегирад.
Ҳадафи agent омӯхтани policy мебошад, ки expected discounted cumulative reward-ро maximize мекунад:
\[ J(\pi)=\mathbb{E}_{\pi}\left[\sum_{k=0}^{\infty}\gamma^kr_{k+1}\right] \]
Дар ин ҷо π control policy ва J(π) expected total performance-и policy-ро ифода мекунанд. Ба забони оддӣ, agent кӯшиш мекунад на танҳо immediate signal decision, балки impact-и ин decision ба future queues ва platoons-ро ҳам омӯзад.
Чаро DDQN истифода шудааст?
Дар study Double Deep Q-Network, яъне DDQN, ҳамчун signal-control agent истифода шудааст. DDQN барои кам кардани tendency-и classical DQN ба overestimate кардани action values, action selection ва action evaluation-ро ҷудо мекунад. Дар study ду neural network истифода мешавад: online network ва target network.
Temporal-difference target чунин дода шудааст:
\[ y_k=r_{k+1}+\gamma(1-d_{k+1})Q_{\theta^-}\left(s_{k+1},\arg\max_{a'}Q_\theta(s_{k+1},a')\right) \]
Дар ин ҷо yk learning target, rk+1 reward, γ weight of future rewards, d terminal-state flag, Qθ online network ва Qθ− target network мебошанд.
Loss function Bellman mean squared error мебошад:
\[ \mathcal{L}(\theta)=\mathbb{E}\left[\left(Q_\theta(s_k,a_k)-y_k\right)^2\right] \]
Маънои ин formula чунин аст: neural network value-и selected action-ро estimate мекунад; баъд prediction бо target-и аз reward ва future expected value сохташуда наздик карда мешавад. Дар traffic-light control ин маънои омӯзиши саволи “ин phase-ро интихоб кардан дар long term барои queues, waiting, emission ва platoon integrity хуб аст ё не?”-ро дорад.
MOPADRL state vector: Controller чиро мебинад?
State vector-и MOPADRL 20-dimensional буда, аз се block иборат аст:
\[ s_k=[\mathbf{p}_k\|\boldsymbol{\phi}_k\|\boldsymbol{\psi}_k]\in[0,1]^{20} \]
Дар ин ҷо p_k lane-pressure block, φ_k active phase information ва ψ_k platoon-detection block мебошанд. Lane pressure total ва stopped vehicle counts дар 12 approach lanes-ро дар бар мегирад. Active-phase block current green phase-ро нишон медиҳад. Platoon sensor block барои ҳар phase нишон медиҳад, ки оё дар lanes served by that phase platoon vehicle within 50 m of stop line вуҷуд дорад ё не.
Lane-pressure feature чунин define мешавад:
\[ p_l(k)=\min\left\{1,\frac{2n_l^{stop}(k)+n_l(k)}{100}\right\} \]
Дар ин ҷо nl total number of vehicles in lane ва nstop_l number of stopped vehicles мебошанд. Ба назар мерасад, stopped vehicles бо weight-и дукарата ҳисоб мешаванд, зеро онҳо на танҳо current density, балки accumulated delay-ро ҳам ифода мекунанд.
Platoon sensor чунин кор мекунад: Агар ягон vehicle аз active platoon дар lane-и served by a specific phase дар 50 m ё камтар аз stop line бошад, platoon presence барои он phase ҳамчун 1 coded мешавад. Ин seemingly small additional information agent-ро аз platoon-blind шудан нигоҳ медорад.
Multi-objective reward function: Waiting, emission ва platoon break
Яке аз муҳимтарин components-и MOPADRL reward function мебошад. Reward танҳо аз waiting time ҳисоб намешавад; waiting time, CO2 emission ва platoon break якҷо ба назар гирифта мешаванд.
Аввал waiting-time ва emission differences барои ҳар decision period ҳисоб мешаванд:
\[ \Delta W_k=W(k-1)-W(k) \]
\[ \Delta E_k=E(k-1)-E(k) \]
Дар ин ҷо ΔW improvement in waiting time ва ΔE emission reduction-ро ифода мекунанд. Агар values positive бошанд, system нисбат ба previous period беҳтар шудааст.
Final reward function чунин аст:
\[ r_{k+1}=\Pi_{[-1,1]}\left(w_W\widetilde{\Delta W}_k+w_E\widetilde{\Delta E}_k-\lambda_PN_k^{brk}\right) \]
Дар ин ҷо wW = 0,67 weight-и waiting time, wE = 0,33 weight-и emission, λP = 1,0 weight-и platoon-break penalty ва Nbrk number of follower vehicles separated from platoon in that period мебошанд. Π[-1,1] reward-ро байни -1 ва 1 clip мекунад.
Ин formula main idea-и study-ро хеле хуб нишон медиҳад. Agent waiting time-ро reduce кунад, reward мегирад. Emission-ро reduce кунад, reward мегирад. Аммо агар platoon-ро бо red light break кунад, penalty мегирад. Ҳамин тавр system аз policies, ки “intersection-ро зуд clear кунад, аммо platoons-ро ҷудо кунад” ва дар long term bad outcomes диҳанд, дур карда мешавад.
V2I Platoon-Request mechanism чӣ гуна маҳдуд шудааст?
Дар MOPADRL approaching platoons метавонанд ба traffic light green-phase request фиристанд. Аммо request randomly ё unconditionally accepted намешавад. Study се condition define мекунад:
- Platoon leader бояд дар range-и 10–50 m аз stop line бошад ё аз 10 m наздиктар буда, stopped бошад.
- Дар conflicting direction дар 150 m дигар platoon набошад.
- Дар unserved conflicting lanes platoon stopped vehicles набошанд.
Ҳадафи conditions ин аст, ки green priority танҳо дар low-conflict situations дода шавад. Ҳамин тавр control one platoon-ро гузаронда, other directions-ро unfairly ё dangerously suppress намекунад. Ин design V2I priority-ро practical ва balanced нигоҳ медорад.
Муҳити таҷриба: SUMO microsimulation
Ҳама experiments дар SUMO, яъне Simulation of Urban MObility, гузаронда шудаанд. Test network як isolated four-leg signalized intersection мебошад. Ҳар approach се incoming lanes ва ду outgoing lanes дорад. Lane arrangement: one left-turn lane, one through-only lane ва one through+right lane. Speed limit 50 km/s, яъне тақрибан 13,89 m/s мебошад. Follower vehicles танҳо вақте gap closing лозим бошад, catch-up speed cap-и 60 km/s, яъне тақрибан 16,67 m/s доранд.
Vehicle arrivals дар 0–3600 seconds бо Weibull distribution тавлид шудаанд. Ин distribution peak-hour-like profile медиҳад: gradual increase дар beginning, dense peak in middle ва decline at end. Study demand levels 1000 vehicles/hour ва 2000 vehicles/hour, balanced ва unbalanced directional distributions ва platoon sizes from 3–7 vehicles-ро test мекунад.
Evaluation бо 100 paired random seeds анҷом шудааст. Ин муҳим аст, зеро results на ба як random simulation, балки ба comparison across variable traffic arrivals асос меёбанд.
Controller-ҳои муқоисашуда
Study панҷ signal controller-ро муқоиса мекунад:
- Fixed-Time: Fixed signal plan, ки traffic state-ро ба назар намегирад.
- Actuated: Classical detector-based control, ки green-ро мувофиқи arriving vehicles extend карда метавонад.
- MO-DDQN: Multi-objective, аммо platoon-unaware DDQN-based learning controller.
- MOPADRL-WV2I: Platoon awareness ва platoon-break penalty дорад, вале V2I green-request mechanism надорад.
- MOPADRL: Proposed model, ки platoon awareness, platoon-break penalty ва conditional V2I Platoon-Request mechanism-ро якҷо истифода мекунад.
Ин comparison муҳим аст, зеро на танҳо whether MOPADRL works, балки contribution-и each component-ро ҳам ҷудо мекунад. Difference байни MOPADRL-WV2I ва MOPADRL contribution-и V2I priority mechanism-ро нишон медиҳад. Difference байни MO-DDQN ва MOPADRL бошад combined effect-и platoon awareness, break penalty ва V2I structure-ро нишон медиҳад.
Evaluation metrics
Performance бо six main metrics чен шудааст:
- Average queue length,
- Average number of vehicles in network,
- Average waiting time per vehicle,
- Average travel time per vehicle,
- Average CO2 emission per vehicle,
- Number of broken platoons.
Барои safety, Time-to-Collision conflict count ҳам истифода шудааст. Ин metric ҳисоб мекунад, ки агар vehicles бо current speeds идома диҳанд, то collision чӣ қадар time мемонад. Threshold барои automated vehicles 0,5 seconds ва барои human-driven vehicle pairs 1,5 seconds гирифта шудааст.
Phase 1: Platoon size ва controller comparison
Дар first evaluation stage, дар demand-и 1000 vehicles/hour platoon sizes 3, 4, 5, 6 ва 7 test шудаанд. Дар balanced demand MOPADRL дар тамоми platoon sizes best controller аз рӯи efficiency metrics буд. Дар seven-vehicle platoon average queue length 0,53 vehicles, average waiting time 1,95 seconds/vehicle, average travel time 111,51 seconds/vehicle ва average CO2 emission 117.021 mg/vehicle report шудааст.
Нисбат ба Fixed-Time control, ин results тақрибан 94 фоиз reduction дар queue length ва waiting time доранд. Нисбат ба Actuated controller reduction тақрибан 86 фоиз мебошад. Ин нишон медиҳад, ки MOPADRL на танҳо classic fixed plan, балки demand-responsive actuated control-ро ҳам substantially outperform кардааст.
Дар balanced demand best MOPADRL configuration seven-vehicle platoon мебошад. Аммо дар unbalanced demand optimum ба six-vehicle platoon shift кардааст. Ин finding муҳим аст: Best platoon size fixed value нест, балки demand pattern dependent мебошад. Дар unbalanced demand, вақте north-south corridor dominant аст, six-vehicle platoon ба limited green window беҳтар fit мешавад.
Оё platoon integrity ба efficiency зарар мерасонад?
Яке аз striking findings ин аст, ки platoon-integrity penalty ба efficiency зарар нарасонидааст. At first glance, вақте model барои “break platoon” penalty мегирад, метавон гумон кард, ки waiting ё queue decisions worse мешаванд, зеро system барои нигоҳ доштани platoon баъзе vehicles-ро бештар wait мекунад.
Аммо results баръакс мебошанд. MOPADRL нисбат ба platoon-unaware MO-DDQN дар every platoon size ва every efficiency metric better result додааст. Queue length 10–69 фоиз, waiting time 10–65 фоиз, travel time 1,0–4,4 фоиз ва CO2 emission 1,3–6,6 фоиз improved шудаанд; broken platoon count ҳам 30–99 фоиз reduced шудааст.
Сабаб structural аст. Вақте platoon at red split мешавад, rear vehicles wait мекунанд, later re-accelerate мекунанд, queue месозанд ва emission-ро зиёд мекунанд. Therefore preserving platoon не танҳо integrity, балки waiting ва emission objectives-ро ҳам support мекунад. Ба забони study, objectives competitors нестанд; дар right reward structure онҳо complementary мебошанд.
Contribution-и V2I priority чист?
Comparison байни MOPADRL ва MOPADRL-WV2I effect-и V2I Platoon-Request mechanism-ро ҷудо мекунад. Ҳар ду model same state vector ва same reward function доранд; only difference ин аст, ки MOPADRL метавонад approaching platoon-ро дар low-conflict conditions green priority диҳад.
Дар balanced demand V2I priority queue length-ро 28–53 фоиз, waiting time-ро 23–53 фоиз, travel time-ро 1,9–4,3 фоиз ва CO2 emission-ро 3,0–5,9 фоиз reduce кардааст. Аммо additional effect ба broken platoon count limited аст, зеро platoon-break penalty already in many cases breakages-ро near zero кардааст. Ин result нишон медиҳад, ки main contribution-и V2I mechanism “faster passage of platoons” аст; preventing platoon breakage бошад reward penalty already strongly handles.
Phase 2: Human-driven environment vs V2X platoon environment
Дар second evaluation stage human-driven environment ва fully V2X-supported platoon environment compare шудаанд. Human-driven baseline scenarios Actuated ва MO-DDQN истифода мекунанд. V2X environment proposed MOPADRL ва optimum platoon sizes from Phase 1-ро истифода мекунад: seven vehicles for balanced demand ва six vehicles for unbalanced demand.
Се demand scenario санҷида шудааст:
- 1000 vehicles/hour balanced demand,
- 2000 vehicles/hour balanced demand,
- 2000 vehicles/hour unbalanced demand.
MOPADRL дар every scenario ва every metric best average value produced кардааст. Нисбат ба strongest human-driven learning baseline MO-DDQN, average queue length 73–75 фоиз ва waiting time 67–75 фоиз reduced шудаанд. Нисбат ба Actuated controller reductions even larger мебошанд: queue length ва waiting time тақрибан 82–89 фоиз ва 80–87 фоиз.
Барои CO2, travel time ва average number of vehicles in network biggest difference дар 2000 vehicles/hour balanced demand observed шудааст. Ин муҳим аст, зеро same total demand unbalanced бошад classic ё learning controllers метавонанд dominant corridor-ро longer green дода баъзе efficiency gains гиранд. Balanced high demand tougher operating point аст: ҳар direction busy аст ва green allocation complexтар. Interpretation-и study ин аст, ки V2X advantage танҳо бо raw demand scale намешавад, балки operating difficulty-ро ҳам reflect мекунад.
Safety result: Чаро TTC conflicts zero шуданд?
Most striking safety result ин аст, ки MOPADRL дар all demand scenarios Time-to-Collision-based conflict count-ро zero кардааст. Дар human-driven baseline systems TTC conflicts бо increasing demand markedly rise кардаанд. Дар V2X platoon environment бошад conflicts recorded нашудаанд.
Сабаб ин аст, ки V2V-based CACC structure closure-rate oscillations within platoon-ро reduce мекунад. Leader speed ва acceleration information ба followers мерасад; followers ба braking/acceleration behavior-и leader very quickly adapt мешаванд. Two-layer spacing policy махсусан 0,1-second delay between leader and first follower-ро absorb мекунад. Therefore kinematic conditions leading to rear-end conflict in platoon formed нашудаанд.
Ин ҷо caution лозим аст: Study намегӯяд, ки “in real world no crash happens.” Results simulation environment, assumed reliable V2V communication ва specific traffic scenarios мебошанд. Аммо finding нишон медиҳад, ки reliable V2X communication ва correct spacing control метавонанд following conflicts on intersection approach-ро substantially reduce кунанд.
Phase 3: Microscopic trajectory analysis
Third evaluation stage барои understanding whether system-level improvements consistent at vehicle level анҷом шудааст. One seven-vehicle V2X platoon through approach, stop at red, discharge ва restart cycle at 0,1-second steps tracked шудааст.
Time-distance trajectories нишон медиҳанд, ки platoon vehicles at red together stop, at green together move ва cross without splitting. Дар same cycle second platoon ҳам one platoon length behind stopped шудааст. Ин нишон медиҳад, ки model regular behavior not only at single-vehicle level, but across successive platoons produce карда метавонад.
Дар spacing analysis mean leader-first-follower gap 3,73 ± 0,48 m ва mean internal-follower gap 2,002 ± 0,020 m мебошад. Most critical value minimum leader-first-follower gap in red phase: 2,61 m. Analytical calculation 2,611 m predicts, therefore result microscopic validation of design мебошад.
Дар speed synchronization velocity difference байни internal follower pairs practically zero at numerical precision аст. Highest transient leader-first-follower speed difference due to 0,1-second delay 0,55 m/s report шудааст. String stability ratio 1,00 аст; яъне acceleration-deceleration disturbance along platoon amplify нашудааст. Ин нишон медиҳад, ки platoon not only close-spaced, but stable movement нигоҳ доштааст.
Аҳамияти study аз гузашта, имрӯз ва оянда
Дар гузашта traffic-light control mainly fixed-time plans, local actuated rules ё optimization based only on vehicle counts истифода мекард. Later reinforcement-learning models ба intersection control ворид шуданд, аммо many assumed human-driven environment ё automated platoons-ро limited integrate карданд.
Today study нишон медиҳад, ки intersection control ба new stage меравад. Акнун intersection на танҳо “which direction has more vehicles?” мепурсад, балки “which direction has approaching automated platoon, what happens to waiting/emission if it splits, is there queue in conflicting direction, can green priority be safely granted?”-ро якҷо answer мекунад.
Future-wise, models like MOPADRL метавонанд with widespread connected and automated vehicles signal control-ро more coordinated кунанд. Study shows especially under high demand and symmetrically loaded congested intersections V2X coordination can bring large gains. Аммо real deployment needs study of mixed traffic, varying automated-vehicle penetration, communication delay, packet loss, multi-intersection corridors ва different intersection geometries.
Таъсир ба ҳаёти ҳаррӯза чӣ буда метавонад?
Ба everyday life тарҷума карда, study нишон медиҳад, ки traffic lights метавонанд дар оянда passive second-counting systems не, балки active controllers шаванд, ки approaching vehicle groups-ро мефаҳманд ва бо онҳо communication мекунанд. Vehicles метавонанд ҳамчун platoon ба intersection наздик шаванд, traffic light онҳоро detect кунад, дар suitable conditions green priority диҳад ва platoon-ро бе split гузаронад.
Ин метавонад short waiting for drivers, lower queues for cities, lower CO2 for environment ва fewer following conflicts for safety диҳад. Аммо benefits дар simulation ва under fully V2X-supported vehicle assumption ба даст омадаанд. Real life human-driven vehicles, pedestrians, cyclists, bus stops, emergency vehicles, communication outages ва heterogeneous driving behavior дорад.
Ҷиҳатҳои қавии study
Strength-и аввал ин аст, ки platoon awareness танҳо conceptual нест. Platoon information ба state vector илова шудааст, platoon break explicitly penalized in reward ва conditional priority бо V2I Platoon-Request дода шудааст.
Strength-и дуюм microscopic validation of car-following model мебошад. Study танҳо system averages не, балки vehicle-by-vehicle spacing, speed ва acceleration behavior-и one platoon-ро санҷидааст. Analytical 2,611 m prediction дар simulation ҳамчун 2,61 m validated шудааст, ки design random result нест.
Strength-и сеюм ablation-like comparison of controllers мебошад. Fixed-Time, Actuated, MO-DDQN, MOPADRL-WV2I ва MOPADRL comparisons имкон медиҳанд contribution-и learning, platoon awareness, platoon-break penalty ва V2I priority separately interpreted шаванд.
Маҳдудиятҳои study
Study several limitations-ро openly states. First, experiments дар one isolated signalized intersection иҷро шудаанд. Real urban traffic intersections usually corridor/network interactions доранд. Decision at one intersection next intersections’ queues ва green-wave pattern-ро affect мекунад.
Second, study homogeneous V2X penetration assume мекунад. Яъне дар V2X environment all vehicles ҳамчун cooperative platoons ҳаракат мекунанд. Real world mixed human-driven, connected ва fully automated vehicles for a long transition period хоҳад дошт. Mixed traffic метавонад model performance-ро тағйир диҳад.
Third, V2V communication channel reliable assumed шудааст. Real deployment delay, packet loss, sensor error, localization error ё cybersecurity issues дошта метавонад. Study 0,1-second leader-first-follower delay-ро account мекунад, аммо more variable/degraded communication needs future analysis.
Fourth, model trained on single demand distribution. Different cities, driving cultures, intersection geometries, pedestrian crossings, bus lanes, emergency priorities ва bicycle traffic need retesting.
Study чӣ мегӯяд ва чӣ намегӯяд?
Study нишон медиҳад, ки MOPADRL дар SUMO simulation, under specific intersection geometry ва demand scenarios, Fixed-Time, Actuated ва platoon-blind learning controllers-ро outperform мекунад. Он инчунин нишон медиҳад, ки V2V-based platoon model дар tested conditions intra-platoon following conflicts-ро zero намуда, platoon stability-ро нигоҳ доштааст.
Study намегӯяд, ки model ready for direct deployment in real cities аст. Field test пешниҳод намекунад. Mixed-traffic penetration ratios-ро detailed study намекунад. Multi-intersection network control-ро ҳал намекунад. Communication failures ё packet loss robustness-ро comprehensively test намекунад. Therefore results бояд strong simulation evidence ҳисоб шаванд, not final field-success or safety guarantee.
Усул ва Натиҷаҳои Таҳқиқот
Хулосаи усул
- Problem definition: Signalized-intersection control якҷо бо V2X-supported automated-vehicle platoons баррасӣ шудааст.
- Vehicle model: Human-driven vehicles with IDM, platoon leaders with CACC, followers with proposed V2V-based follower law modeled шудаанд.
- Platoon spacing policy: 4 m leader-first-follower ва 2 m internal-followers target gap analytical justified from communication delay.
- Signal-control model: Intersection control as MDP formulated ва DDQN-based MOPADRL agent trained шудааст.
- State vector: 12-dimensional lane pressure, 4-dimensional active phase coding ва 4-dimensional platoon-sensor block combined into 20-dimensional state vector.
- Reward function: Reduction in waiting time, CO2 emission ва platoon-break penalty combined шудаанд.
- V2I mechanism: Approaching platoons under low-conflict conditions could request green phase.
- Simulation: SUMO isolated four-leg signalized intersection tested with different demands and 3–7 vehicle platoon sizes.
- Comparison: Fixed-Time, Actuated, MO-DDQN, MOPADRL-WV2I ва MOPADRL compared over 100 paired random seeds.
Формулаҳои асосӣ ва маънои онҳо
| Formula | Чиро шарҳ медиҳад? |
|---|---|
| [ a=a_0[1-(v/v_0)^\delta-(s^*/s)^2] ] | Acceleration behavior-и human-driven vehicles based on speed and following distance. |
| [ \mathcal{M}=(\mathcal{S},\mathcal{A},\mathcal{T},r,\gamma) ] | Traffic-light control problem-ро ҳамчун Markov decision process месозад. |
| [ s_k=[\mathbf{p}_k\|\boldsymbol{\phi}_k\|\boldsymbol{\psi}_k] ] | Traffic pressure, current phase ва platoon presence information seen by MOPADRL-ро combine мекунад. |
| [ r_{k+1}=\Pi_{[-1,1]}(w_W\widetilde{\Delta W}_k+w_E\widetilde{\Delta E}_k-\lambda_PN_k^{brk}) ] | Waiting time, CO2 emission ва platoon break-ро дар same reward structure combine мекунад. |
| [ \Delta_{close}=v^\circ\tau=13.89\times0.1=1.389\,m ] | Closure distance due to leader-first-follower communication delay-ро ҳисоб мекунад. |
| [ g_{LF}^*\geq g_{min}+v^\circ\tau=3.389\,m ] | Чаро 4 m target gap барои first follower safety margin медиҳад, нишон медиҳад. |
Натиҷаҳои ададӣ
| Finding | Result |
|---|---|
| Best MOPADRL platoon size at balanced 1000 vehicles/hour | 7 vehicles |
| Best MOPADRL platoon size at unbalanced 1000 vehicles/hour | 6 vehicles |
| Average queue length for MOPADRL with 7-vehicle platoon under balanced demand | 0,53 vehicles |
| Average waiting time for MOPADRL with 7-vehicle platoon under balanced demand | 1,95 s/vehicle |
| Average travel time for MOPADRL with 7-vehicle platoon under balanced demand | 111,51 s/vehicle |
| CO2 emission for MOPADRL with 7-vehicle platoon under balanced demand | 117.021 mg/vehicle |
| Queue and waiting reduction vs Fixed-Time | Approximately %94 |
| Queue and waiting reduction vs Actuated | Approximately %86 |
| MOPADRL queue improvement vs MO-DDQN | %10–69 range |
| MOPADRL waiting-time improvement vs MO-DDQN | %10–65 range |
| Broken-platoon reduction vs MO-DDQN | %30–99 range |
| V2I contribution to queue reduction | %28–53 range |
| V2I contribution to waiting reduction | %23–53 range |
| TTC conflicts in V2X environment | 0 in all demand scenarios |
| Minimum leader-first-follower red-phase gap in microscopic analysis | 2,61 m; analytical prediction 2,611 m |
| Mean internal-follower gap | 2,002 ± 0,020 m |
| String-stability ratio | 1,00 |
Маънои main figures and graphs
System-architecture diagram нишон медиҳад, ки MOPADRL only a signal-control algorithm нест. Platoon control, V2V follower controller, V2I platoon request, DDQN-based signal controller ва SUMO microsimulation environment in one framework connected шудаанд. Ин маънои joint control of vehicle level and intersection level-ро дорад.
Intersection-geometry figure four-leg isolated signalized intersection with three incoming lanes per approach нишон медиҳад. Ин муҳим аст, зеро model not city-network, but controlled single-intersection experiment-ро test мекунад.
Weibull-distributed demand graphs нишон медиҳанд, ки arrivals uniform нестанд, балки peak-hour-like over time rise and fall мекунанд. Balanced demand directions more symmetric loaded, unbalanced demand certain corridors denser мебошанд. Ин helps explain why optimum platoon size shifts from 7 to 6.
Percentage-improvement graphs show large consistent gains against Fixed-Time and Actuated. Against learning but less platoon-aware MO-DDQN, difference especially in queue and waiting time evident аст. Ин main contribution-и MOPADRL-ро as timing platoons correctly and reducing unnecessary stop-go нишон медиҳад.
Per-seed distribution graphs нишон медиҳанд, ки MOPADRL results not only lower on average, but tightly distributed over random seeds. TTC graph zero conflicts for MOPADRL visualizes safety effect of V2V platoon control in simulation.
Microscopic time-distance trajectories show platoon stopping together at red, moving together at green and crossing unbroken. Gap graph leader-first-follower reaches 2,61 m at red but stays above 2 m safety floor; internal followers maintain 2 m target very stably. Stop-and-go graphs show braking/acceleration disturbance does not amplify through platoon.
Натиҷаи техникӣ
Success-и MOPADRL аз one component не, балки joint operation-и four components меояд: DDQN learning-based signal control, platoon-visible state vector, reward combining waiting-emission-platoon break, ва low-conflict conditional V2I green priority. Ин structure preserving platoon-ро luxury objective не, балки direct control signal for improving traffic efficiency and emissions мекунад.
Ёддошт оид ба Манбаъ ва Усул
Ин мақола дар асоси таҳқиқоти Amir Hossein Karbasi ва Hao Yang бо унвони “MOPADRL: Multi-Objective Platoon-Aware Deep Reinforcement Learning Model for Signalized Intersection Control under V2X Communication” таҳия шудааст. Authors affiliated with McMaster University, Department of Civil Engineering мебошанд.
Source text preprint research paper on SSRN submitted to Elsevier мебошад. Азбаски text explicitly мегӯяд “This preprint research paper has not been peer reviewed”, study peer reviewed нашудааст. Therefore results should be read as technically detailed but unreviewed preprint findings, not finally validated peer-reviewed evidence.
Ин content based on study model, formulas, simulation setup, tables, graphs and results таҳия шудааст. Field deployment, commercial success, guaranteed real-city safety ё regulatory compliance claims not in study илова нашудаанд.
Method SUMO microscopic traffic simulation, DDQN-based deep reinforcement learning, V2V-based CACC platoon control ва conditional V2I Platoon-Request mechanism истифода мекунад. Experiments дар isolated four-leg signalized intersection with different demand scenarios and 3–7 vehicle platoon sizes иҷро шудаанд.
Study has important limitations. Analysis limited to one isolated intersection; multi-intersection corridor/network coordination not studied. V2X penetration homogeneous assumed; mixed human-driven and automated traffic not deeply analyzed. V2V communication assumed reliable; packet loss, variable delay and communication failures not comprehensively tested. Model trained on single demand distribution. Therefore findings need support from further studies in different traffic networks and realistic mixed traffic conditions.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд