

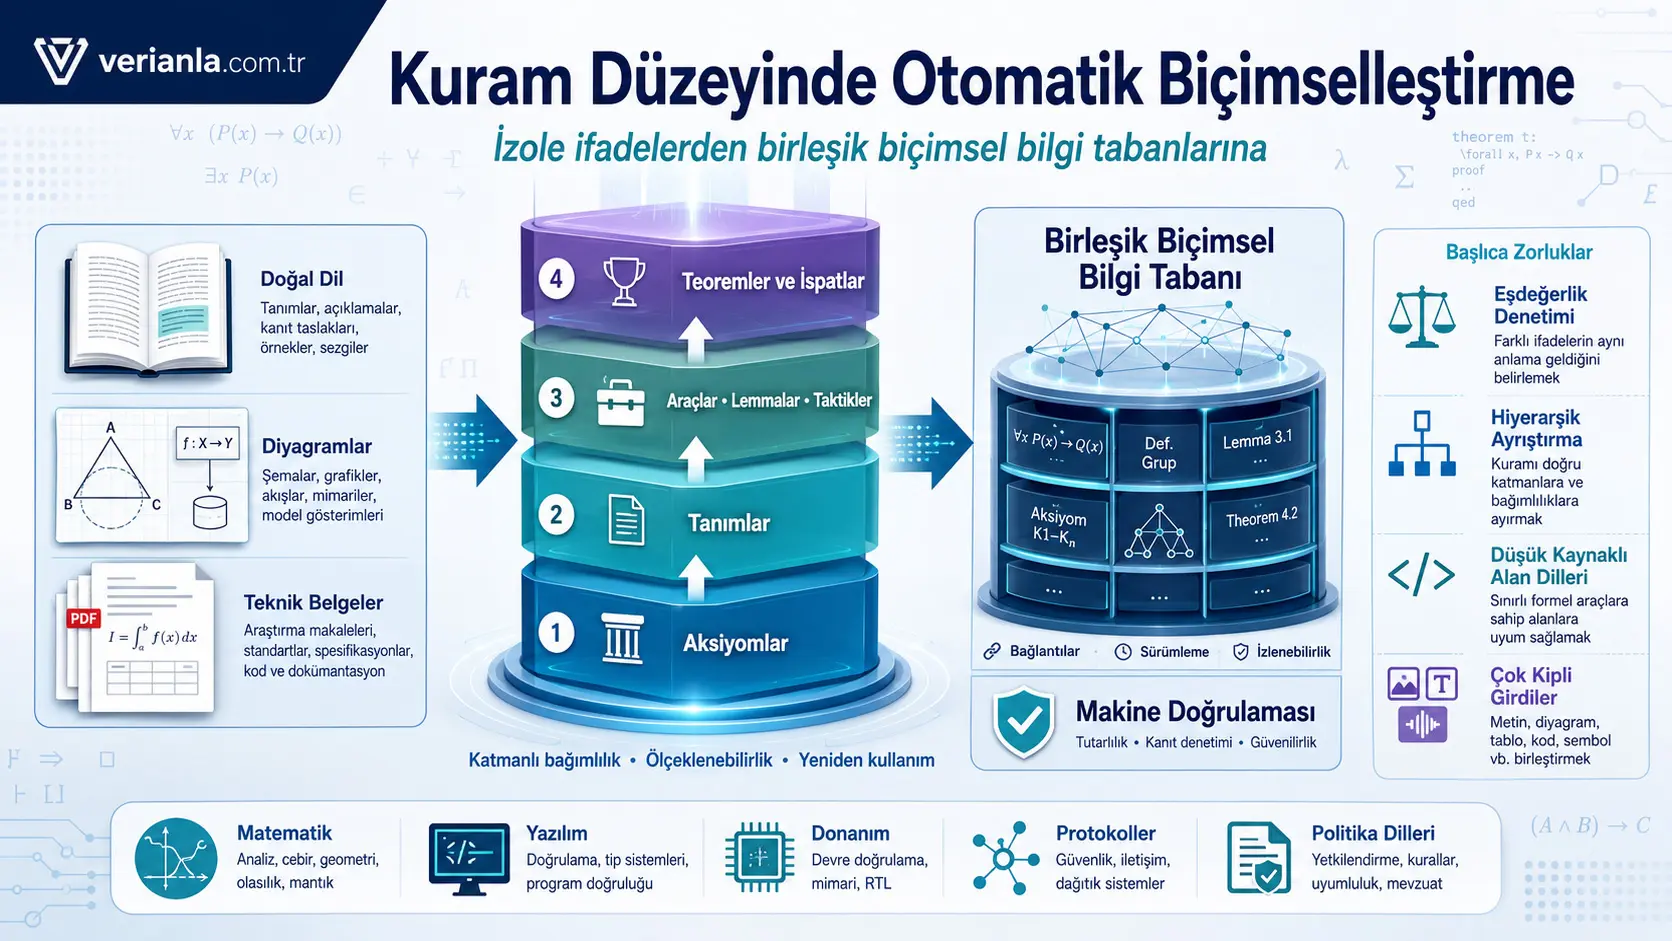
Bu çalışma, doğal dilde ifade edilen matematiksel, bilimsel ve teknik bilgilerin yalnızca tek tek teoremler veya önermeler düzeyinde değil, bütün bir kuramın bağımlılıklarıyla birlikte makine tarafından doğrulanabilir biçime dönüştürülmesi gerektiğini savunmaktadır. Yazarlar yeni bir deneysel sistem geliştirmek yerine matematik, bilim, yazılım ve donanım doğrulamasındaki mevcut projeleri, otomatik biçimselleştirme literatürünü ve alanın değerlendirme sorunlarını inceleyen bir pozisyon makalesi sunmuştur. Temel sav, hedef bir teoremi biçimselleştirebilmek için önce aksiyomların, tanımların, gösterimlerin, yardımcı önermelerin, ispat taktiklerinin ve bunlar arasındaki bağımlılıkların tutarlı bir kütüphane hâlinde kurulması gerektiğidir. Bununla birlikte çalışma, önerdiği kuram düzeyindeki yaklaşımı uçtan uca uygulayan yeni bir sistem, veri seti veya deneysel doğrulama sunmamaktadır.
Makale, mevcut otomatik biçimselleştirme çalışmalarının çoğunun olgun biçimsel kütüphanelerin zaten bulunduğunu varsaydığını vurgulamaktadır. Örneğin Lean ortamındaki Mathlib, pek çok tanımı ve yardımcı teoremi önceden sağladığı için bir hedef önermenin çevrilmesi görece yönetilebilir görünmektedir. Ancak sayısal analiz, belirli mühendislik alanları, özel güvenlik politikaları veya kuruma özgü alan dilleri gibi yeterli biçimsel altyapının bulunmadığı alanlarda asıl sorun, tek bir önermeyi çevirmek değil, önermenin anlamlı olmasını sağlayan bütün kuramsal bağlamı oluşturmaktır.
Yazarlar kuram düzeyinde otomatik biçimselleştirmenin önünde dört ana sorun belirlemektedir: biçimselleştirmelerin anlam bakımından eşdeğer olup olmadığını güvenilir biçimde denetlemek, büyük metinleri hiyerarşik bağımlılık yapılarına ayırmak ve yeniden kullanılabilir soyutlamalar öğrenmek, Lean dışındaki düşük kaynaklı alan dillerine uyum sağlamak ve metin, matematiksel gösterim, zamanlama diyagramı, şema veya serbest biçimli görüntü gibi çok kipli girdileri birlikte yorumlamak. Çözüm için ise kuram düzeyinde değerlendirme ölçütleri, dar bir kütüphaneye aşırı uyarlanmış modeller yerine genel amaçlı modeller ve farklı biçimsel diller arasında köprü kurabilecek ortak bir ara gösterim önermektedir.
Otomatik biçimselleştirme nedir?
Otomatik biçimselleştirme (autoformalization), doğal dilde veya yarı biçimsel gösterimlerle aktarılan bir bilginin, bir ispat asistanı ya da biçimsel doğrulayıcı tarafından denetlenebilecek biçimsel bir dile çevrilmesidir. Bu çeviri yalnızca cümlelerin sözdizimsel olarak yeniden yazılması değildir. Üretilen biçimsel ifadenin, özgün metindeki anlamı, varsayımları, niceleyicileri, istisnaları ve bağımlılıkları koruması gerekir.
Makale iki temel alt görevi birbirinden ayırmaktadır:
- İfade otomatik biçimselleştirmesi: Doğal dildeki teorem, varsayım veya iddianın biçimsel bir bildirim hâline getirilmesidir.
- İspat otomatik biçimselleştirmesi: Belirli bir doğal dil ispatının mantıksal yapısını koruyarak makine tarafından denetlenebilir bir ispat betiğine dönüştürülmesidir.
Ek B’de vurgulanan önemli ayrım, ispat otomatik biçimselleştirmesinin genel teorem ispatıyla aynı olmadığıdır. Biçimsel teorem ispatlayıcı, hedef önermeyi doğrulayan herhangi bir geçerli ispatı bulmaya çalışabilir. İspat otomatik biçimselleştirmesi ise özgün doğal dil ispatındaki belirli düşünce akışına sadık kalmak zorundadır. Aynı teorem için iki farklı biçimsel ispat doğru olabilir; ancak bunlardan yalnızca biri çevrilen özgün argümanın mantıksal yapısını temsil ediyor olabilir.
Kuram düzeyinde otomatik biçimselleştirme neyi değiştirmektedir?
Yazarların tanımına göre kuram düzeyinde otomatik biçimselleştirme, belirli bir kapsam içindeki aksiyomların, tanımların, gösterimlerin, örneklerin, yardımcı önermelerin, teoremlerin, ispatların, taktiklerin ve bunlar arasındaki bütün bağımlılıkların tutarlı bir biçimsel kütüphane olarak oluşturulmasıdır. Bu yaklaşım, birbirinden kopuk hedef ifadeleri çevirmek yerine, hedef ifadelerin üzerinde durduğu bilgi mimarisini kurmayı amaçlamaktadır.
Şekil 2’deki “Kuram Düzeyinde Otomatik Biçimselleştirme Kulesi”, Öklid geometrisi üzerinden dört katmanlı bir yapı göstermektedir:
| Katman | İçerik | İşlevi | Öklid geometrisi örneği |
|---|---|---|---|
| Katman 0 | Aksiyomatik tanımlar | Kuramın en temel nesnelerini ve ilişkilerini tanımlar. | Nokta ve doğru gibi ilkel türler; aynı tarafta bulunma veya iki nokta arasında olma gibi ilkel ilişkiler |
| Katman 1 | Türetilmiş tanımlar | İlkel kavramları birleştirerek daha karmaşık matematiksel nesneler oluşturur. | Açı gibi tümevarımsal tanımlar; üçgen oluşturma gibi bileşik ilişkiler |
| Katman 2 | Araçlar | Sonraki ifadelerin okunmasını ve ispat edilmesini kolaylaştırır. | Gösterimler, yardımcı önermeler ve ispat taktikleri |
| Katman 3 | Hedefler | Kurulan altyapı üzerinde asıl teorem ve ispatların ifade edilmesini sağlar. | Pisagor teoremi ve benzeri hedef teoremler |
Makalede aktarılan sonuca göre mevcut en iyi yöntemlerden biri, alt katmanların insanlar tarafından önceden biçimselleştirildiği kabulü altında Katman 3’teki ifadelerde %71,4 başarıya ulaşmaktadır. Buna karşılık yazarlar, mevcut yöntemlerin Katman 0–2 arasındaki bütün altyapıyı baştan otomatik olarak kurmayı henüz hedeflemediğini belirtmektedir. Bu nedenle %71,4 değeri, bütün bir kuramın otomatik biçimselleştirilme oranı olarak yorumlanmamalıdır.
Neden tek bir teoremi çevirmek yeterli değildir?
Tek bir hedef teorem, biçimsel ortamda göründüğünden çok daha geniş bir altyapıya dayanır. Bir teoremin içinde geçen her nesnenin türü, her ilişkinin anlamı, kullanılacak gösterimler, yardımcı sonuçlar ve ispat adımları önceden tanımlanmış olmalıdır. Doğal dilde uzmanların örtük bıraktığı birçok bilgi, biçimsel sistemde açıkça belirtilmek zorundadır.
Örneğin bir matematikçi “kare” kavramının dikdörtgen ve eşkenar dörtgen özellikleriyle bağlantısını bağlamdan anlayabilir. Bir biçimsel sistemde ise bu ilişkiyi sağlayan tanımların veya teoremlerin kütüphanede bulunması gerekir. Benzer biçimde bir donanım mühendisi, bir sinyalin “sonraki çevrimden itibaren kararlı kalması” gerektiğini zamanlama diyagramından anlayabilir; ancak biçimsel özellikte “sonraki çevrim” operatörünün açıkça yazılması gerekir.
Otomatik biçimselleştirme neden önemlidir?
Sinirsel teorem ispatlayıcılar için veri üretimi
Sinirsel teorem ispatlama sistemlerinin gelişimi, büyük ve güvenilir biçimsel veri kümelerine bağlıdır. Doğal dildeki matematiksel metinlerin ve ispatların biçimsel karşılıklarının üretilmesi, doğal dil ile biçimsel dil arasında paralel eğitim verisi oluşturabilir. İfade biçimselleştirmesi yeni hedefler üretirken ispat biçimselleştirmesi doğrudan denetlenebilir ispat adımları sağlar.
Teorik ve mühendislik doğrulamasını hızlandırma
Biçimsel doğrulama projeleri, yalnızca nihai teoremi veya sistemi kontrol etmez; tanımlar, ara sonuçlar ve teknik altyapıdan oluşan geniş bir kütüphane kurar. Tablo 1’de matematik, bilim, yazılım ve donanımdan seçilen projelerin önemli zaman ve uzman emeği gerektirdiği gösterilmiştir:
| Alan | Biçimselleştirme projesi | Doğrulama aracı | Başlangıç | Bildirilen süre veya durum |
|---|---|---|---|---|
| Matematik | Dört Renk Teoremi | Coq | 2000 | 5 yıl |
| Matematik | Kepler Varsayımı | HOL Light | 2003 | 11 yıl |
| Matematik | Tek Derece Teoremi | Coq | 2006 | 6 yıl |
| Matematik | Liquid Tensor Experiment | Lean | 2020 | 1,5 yıl |
| Bilim | Kimyasal fizik biçimselleştirmesi | Lean | 2022 | 1 yıl |
| Bilim | Uygulamalı kısmi diferansiyel denklemler | HOL Light | 2022 | Devam ediyor |
| Yazılım | CompCert | Coq | 2005 | Devam ediyor |
| Yazılım | CertiKOS | Coq | 2010 | Devam ediyor |
| Yazılım | Vellvm | Coq | 2012 | Devam ediyor |
| Donanım | ISA-Formal | Verilog model denetleyicileri | 2011 | 5 yıl |
| Donanım | CORE-V-Verif | UVM | 2019 | Devam ediyor |
Tablonun ana mesajı, biçimsel doğrulamadaki baskın maliyetin çoğu zaman tek bir ispatı bulmak değil, hedefin kurulabileceği bütün tanım ve yardımcı sonuç ağını oluşturmaktır. Makale, insan eliyle asal sayı teoreminin biçimselleştirilmesinin yaklaşık 1,5 yıl sürdüğünü; yapay zekâ destekli nicel bir iyileştirmenin ise üç haftada biçimselleştirildiğini örnek olarak aktarmaktadır. Ancak bu iki çalışmanın kapsamları aynı değildir ve süreler doğrudan eşdeğer proje ölçütleri gibi karşılaştırılmamalıdır.
Doğal dil muhakemesini temellendirme ve yönlendirme
Büyük dil modellerinin doğal dilde ürettiği akıl yürütmeler tutarsız öncüller, olmayan varsayımlar veya atlanan adımlar içerebilir. Biçimsel bir denetleyici, yanlış türde tanımları, çelişkileri veya doğrulanamayan adımları belirleyebilir. Makalenin kullandığı ayrımla “temellendirme”, geçersiz adımları elemek; “yönlendirme” ise denetleyici geri bildirimini modelin kendi çıktısını düzeltmesi için kullanmaktır.
Aynı yarar insanlar için de geçerlidir. Doğal dildeki ispatlar rutin görülen adımları atlayabilir, hassas sınır durumlarını yeterince açıklamayabilir veya gereksiz varsayımlar taşıyabilir. Biçimselleştirme, bu eksikleri görünür kılabilir. Bununla birlikte makale, biçimsel doğrulamanın doğal dil muhakemesinin yerini tamamen almasını değil, onu tamamlamasını savunmaktadır.
Genel muhakeme yeteneklerine katkı
Yazarlar, biçimsel denetleyiciden alınan doğrulanabilir geri bildirimin matematik dışındaki muhakeme görevlerine de aktarılabilecek davranışlar kazandırabileceğini tartışmaktadır. Buradaki sav, matematiksel biçimselleştirme eğitiminin otomatik olarak genel zekâ oluşturduğunun kanıtlandığı anlamına gelmez. Makale, farklı muhakeme alanları arasındaki performans ilişkilerini ve doğrulanabilir ödüllerle yapılan eğitim çalışmalarını, araştırma yönünü destekleyen işaretler olarak kullanmaktadır.
Gerçek biçimselleştirme projeleri neden kuram düzeyindedir?
Kepler varsayımı tek bir matematiksel iddia olmasına rağmen biçimsel doğrulaması, yüzlerce tanımın ve yardımcı önermenin oluşturulmasını gerektirmiştir. Liquid Tensor Experiment gibi projelerde de hedef teoremin ifade edilebilmesi için yoğunlaştırılmış matematiğin önemli bölümleri önce Lean ortamında kurulmuştur. Bu örnekler, gerçek projelerin “bir cümleyi başka bir dile çevirme” işi olmadığını göstermektedir.
Yazarların ikinci gerekçesi, ifade düzeyindeki yöntemlerin olgun kütüphanelere bağımlı olmasıdır. Lean Mathlib gibi kaynaklar cebir, analiz, sayı teorisi ve çeşitli temel matematik alanlarında büyük miktarda insan tarafından yazılmış altyapı sunmaktadır. Bir alan Mathlib içinde yeterince temsil edilmiyorsa hedef ifadeyi çevirmekten önce eksik tanımların ve yardımcı teoremlerin kurulması gerekir.
Üçüncü gerekçe, teorik keşfin yeni soyutlamalara dayanmasıdır. Grup, halka ve cisim gibi cebirsel yapılar veya kategori teorisindeki morfizma merkezli yaklaşım, daha önce ayrı görünen bilgi parçalarını ortak bir yapı altında toplamıştır. Makale, gelecekte büyük biçimsel bilgi tabanlarının yeniden düzenlenerek farklı alanlardaki ortak yapıların bulunabileceğini ve yeni soyutlamaların teorik keşfi kolaylaştırabileceğini ileri sürmektedir. Bu, çalışmada uygulanmış veya deneysel olarak gösterilmiş bir sonuç değil, uzun vadeli araştırma vizyonudur.
Alternatif görüşler ve yazarların karşılıkları
“Doğal dil muhakemesi yeterlidir” görüşü
Doğal dil, özel bir sözdizimi gerektirmediği ve çok daha geniş eğitim verisine sahip olduğu için esnektir. Güçlü modeller zor matematik sorularını doğal dilde çözebilmektedir. Yazarlar buna karşılık biçimsel yöntemlerin üç tamamlayıcı üstünlüğünü öne çıkarmaktadır: makine tarafından denetlenebilir geri bildirim, büyük ekiplerde her ayrıntıyı yeniden okumadan modüler güven ve yalnızca öğrenmeyle değil aramayla da ölçeklenebilme.
“Öncelik teorem ispatına verilmelidir” görüşü
Teorem ispatı, verilen biçimsel hedef için geçerli bir ispat arar. Ancak hedef önermenin ve sistem özelliklerinin önce biçimsel olarak yazılması gerekir. Donanım doğrulamasında örneğin model denetleyicileri özellikleri sınayabilecek olgunluğa sahip olsa da hangi özelliğin kontrol edileceğinin doğru biçimde ifade edilmesi temel darboğaz olabilir. Yazarların ifadesiyle otomatik biçimselleştirme, teorem ispatlayıcının üzerinde çalışacağı anlamlı hedefleri üretmektedir.
“İfade düzeyindeki yöntemleri geliştirmek daha gerçekçidir” görüşü
İfade düzeyindeki yöntemlerin ölçülebilir veri kümeleri ve başarılı örnekleri bulunmaktadır. Bazı insan–yapay zekâ ortaklıklarında uzmanlar önce ince ayrıntılı bir “taslak” veya bağımlılık grafiği hazırlamakta, model de yardımcı önermeleri sırayla biçimselleştirmektedir. Yazarlar bu yaklaşımı “yarı kuram düzeyinde” olarak değerlendirmektedir; çünkü bağımlılık yapısını üretme işi hâlâ uzmanlara bırakılmakta ve temel tanımlar çoğunlukla Mathlib’den alınmaktadır.
Birinci açık sorun: Eşdeğerlik nasıl denetlenebilir?
Otomatik biçimselleştirmede yalnızca üretilen kodun derlenmesi yeterli değildir. Biçimsel ifade geçerli olabilir ancak doğal dildeki özgün anlamdan farklı bir şeyi temsil edebilir. Bu nedenle temel değerlendirme sorusu, iki ifadenin aynı anlamı taşıyıp taşımadığıdır.
Güvenilir referans verinin yetersizliği
Makalede aktarılan denetimlere göre ProofNet veri kümesindeki 371 problemin 118’inde insan kaynaklı biçimselleştirme hatası bulunmuş ve düzeltilmiştir; bu oran %31,8’dir. PutnamBench’te ise yayımlanmasından sonra 672 Lean biçimselleştirmesinin en az 58’inde hata düzeltilmiş, bildirilen hata oranı %8,6 olmuştur. Yazarlar ayrıca tanım biçimselleştirmesine özel veri kümelerinin 56 Wikipedia ve 30 arXiv tanımıyla sınırlı kaldığını; ProofFlowBench’in ise ispatlarla birlikte 184 lisans düzeyi ifade içerdiğini belirtmektedir. Makalenin hazırlandığı aşamada bütün bir kuramı değerlendiren bir ölçüt bulunmadığı ifade edilmiştir.
Sözdizimsel eşitlik, mantıksal eşdeğerlik ve bağlam sorunu
Aşağıdaki iki ifade aynı matematiksel içeriği taşır:
\[ \forall n \in \mathbb{N},\; P(n) \]
\[ \neg \exists n \in \mathbb{N},\; \neg P(n) \]
Burada n doğal sayıyı, P ise doğal sayılar üzerinde tanımlı bir özelliği göstermektedir. İlk ifade “bütün doğal sayılar P özelliğine sahiptir”, ikincisi ise “P özelliğine sahip olmayan hiçbir doğal sayı yoktur” anlamına gelir. Sözdizimleri farklı olduğu için tam metin eşleştirmesi bunları aynı kabul etmez; ancak mantıksal olarak eşdeğerdirler.
Buna karşılık aşağıdaki eşdeğerlik yalnızca mantıksal yapıdan değil, Öklid geometrisindeki tanım ve teoremlerden kaynaklanır:
\[ \mathrm{rectangle}(a) \land \mathrm{rhombus}(a) \]
\[ \mathrm{square}(a) \]
a, incelenen geometrik nesnedir. Bir nesnenin hem dikdörtgen hem eşkenar dörtgen olması, uygun geometri kuramında onun kare olmasını sağlar. Ancak “dikdörtgen”, “eşkenar dörtgen” ve “kare” yalnızca anlamı verilmemiş keyfî mantıksal ilişkiler olarak ele alınırsa bu sonuç çıkmaz. Eşdeğerliği değerlendirmek için hangi arka plan kuramının kullanılacağı belirlenmelidir.
Tanımsal eşdeğerlik neden tek başına yeterli değildir?
Lean gibi ispat asistanları tanımları açarak bazı ifadeleri doğrudan sadeleştirebilir. Ancak doğal sayı toplamasının özyinelemeli tanım yönü nedeniyle aşağıdaki ifadeler aynı biçimde indirgenmeyebilir:
[ m + 0 ]
[ 0 + m ]
m doğal sayıdır ve fiziksel bir birim taşımaz. İlk ifade tanım gereği doğrudan m değerine indirgenebilirken ikinci ifade soyut değişken üzerinde takılabilir. İkinci eşitliğin kurulması için toplamanın değişme özelliği gibi ispatlanmış yardımcı sonuçlara başvurmak gerekir.
Sınırsız önerme eşdeğerliğinin tehlikesi
Arka plan kuramında doğru olan her iki önermenin eşdeğer kabul edilmesi de güvenilir değildir. Bu yaklaşım, “1 + 1 = 2” ile Fermat’nın Son Teoremi gibi içerik bakımından tamamen farklı iki doğru önermeyi eşdeğer sayabilir. Makalede incelenen BEq+ denetleyicisi, küresel bağlamı ve genel ispat aramasını sınırlandırarak %98,0 kesinlik ve %48,3 duyarlılık elde etmektedir. Saf tanımsal eşdeğerliğin değerleri ise %100 kesinlik ve %30,9 duyarlılık olarak verilmiştir.
Bununla birlikte aşağıdaki iki farklı doğru özelliğin iki yönlü koşulu, otomasyon taktikleri her iki tarafı da bağımsız olarak kolayca ispatladığında yanlış bir eşdeğerlik izlenimi oluşturabilir:
\[ (n \cdot 1 = n) \leftrightarrow (n + 0 = n) \]
Her iki önerme doğal sayılar için doğru olsa da biri çarpmanın, diğeri toplamanın birim elemanıyla ilgilidir. Biçimselleştirilen özgün anlam açısından aynı özellik değildirler.
Eşdeğerliğin öznel sınırı
Makalenin en dikkat çekici örneklerinden biri aşağıdaki integraldir:
\[ \int_{0}^{1} 2x^3 \ln(x^2+1)\,dx > 0 \]
Toplamanın değişme özelliği kullanılarak yazılan şu biçim çoğu okuyucu için açıkça aynıdır:
\[ \int_{0}^{1} 2x^3 \ln(1+x^2)\,dx > 0 \]
İntegralin değeri hesaplandığında sonuç şu ifadeye de indirgenebilir:
\[ \frac{1}{4} > 0 \]
x, 0 ile 1 arasında değişen boyutsuz matematiksel integrasyon değişkenidir; örnek fiziksel bir ölçüm değildir. İlk iki ifade yüzeysel olarak birbirine çok benzerken üçüncü ifade, ancak integrasyon işlemi yapıldığında aynı sonucu verir. Bir değerlendirme sistemi ne kadar hesaplama yapmalıdır? Makalenin savına göre eşdeğerliğin algılanan derecesi, değerlendiricinin bilgi ve hesaplama kapasitesine göre değişmektedir.
Sınır durumu şu cebirsel özdeşlikle daha açık hâle gelmektedir:
\[ (x-1)^2 + 2x = x^2 + 1 \]
Bu eşitliği hızlıca fark eden bir kişi için integrallerin eşdeğerliği açıktır; başka bir değerlendirici için açılım ve sadeleştirme gerekir. Dolayısıyla her eşdeğerlik denetleyicisi, izin vereceği hesaplama ve arka plan bilgisi için bir eşik seçmek zorundadır.
İkinci açık sorun: Hiyerarşik ayrıştırma ve soyutlama öğrenimi
Uzun bir ders kitabını biçimselleştirmek, metni birbirinden bağımsız cümlelere ayırmaktan daha fazlasını gerektirir. Sistem hangi tanımın önce gelmesi gerektiğini, hangi teoremin hangi yardımcı sonuçlara dayandığını ve hangi kavramların tekrar kullanılabilir bir soyutlama altında birleştirilebileceğini belirlemelidir.
Teorem ispatında alt hedeflere ayırma yöntemleri önemli ilerleme göstermiştir. Makalede DeepSeek-Prover-V2’nin miniF2F üzerinde %88,9, BFS-Prover-V2’nin ise %95,1 başarı bildirdiği aktarılmaktadır. Ancak bu sistemler genellikle tek bir hedef ispatı alt hedeflere ayırmaktadır. Kuram düzeyindeki görev ise onlarca ana teorem ve derin biçimde iç içe geçmiş bağımlılık içeren bütün ders kitaplarının veya teknik belgelerin yapılandırılmasını gerektirir.
Soyutlama öğreniminin iki ayrı görevi vardır:
- Tanım biçimselleştirmesi: Metin içindeki tekrar eden kavramları bulup yeniden kullanılabilir biçimsel tanımlara dönüştürmek.
- Bilgi sıkıştırma: Mevcut büyük biçimsel kütüphanelerde ortak yapıları keşfederek daha kısa, modüler ve genel soyutlamalar üretmek.
Yazarlar, doğal dil külliyatından kavram çıkarılması aşamasında genel amaçlı dil modeli ajanlarının; biçimsel bir kütüphane oluştuktan sonra ise ortak kod yapılarını inceleyen sembolik yöntemlerin daha uygun olabileceğini savunmaktadır. Bununla birlikte mevcut çalışmaların çoğu bileşik matematiksel ilişkilerle sınırlıdır; aksiyomatik veya algoritmik tanımların otomatik kurulması büyük ölçüde çözülmemiştir.
Üçüncü açık sorun: Lean dışındaki düşük kaynaklı alan dilleri
Gerçek dünyadaki biçimsel doğrulama yalnızca Lean ile yapılmamaktadır. Kurumlar kısıt çözme, protokol doğrulama, donanım özellikleri, statik güvenlik analizi ve erişim politikaları için özel alan dilleri kullanmaktadır. Bu dillerin çoğunda doğal dil–biçimsel dil eşleşmesi içeren büyük veri kümeleri bulunmamaktadır.
Otomatik teorem ispatlayıcı dilleri
SMT çözücüleri SMT-LIB, birinci dereceden teorem ispatlayıcılar ise TPTP gibi biçimleri kullanır. Şekil 3, bir listedeki öğeleri düşürme işlemi için şu özelliğin doğal dilden biçimsel dile çevrilmesini göstermektedir:
\[ \forall x,w,L,\; \mathrm{drop}(w,\mathrm{drop}(x,L)) = \mathrm{drop}(x+w,L) \]
Burada L listeyi, x ve w ise listenin başından kaldırılan öğe sayılarını temsil eder; fiziksel birimleri yoktur. İfade, önce x ve sonra w öğe kaldırmanın, toplam x+w öğeyi tek adımda kaldırmaya eşdeğer olduğunu belirtir. Tons of Inductive Problems veri kümesinde biçimsel ifadeler bulunmasına rağmen bunların doğal dil karşılıklarının bulunmaması, paralel veri üretimini zorlaştırmaktadır.
Dağıtık protokol doğrulama dilleri
Ivy ve PVerifier gibi diller, dağıtık protokollerin bütün erişilebilir durumlarda güvenlik özelliklerini koruyup korumadığını inceler. Şekil 4’te Chang–Roberts lider seçimi protokolünün doğal dil açıklaması; halka topolojisi, başlangıç lideri, düğüm kimlikleri ve mesaj gönderme eylemleriyle birlikte biçimsel bir modele çevrilmektedir. IvyBench’in yalnızca 54 biçimselleştirilmiş protokol ispatı içermesi, bu alandaki veri kıtlığını göstermektedir.
Donanım doğrulama dilleri
Donanım özellikleri SystemVerilog Assertions gibi dillerle zaman içindeki sinyal davranışları üzerinden ifade edilebilir. Şekil 5’te metinsel tasarım belgesiyle zamanlama diyagramının birlikte okunması gerekmektedir. Belgedeki “kaynak kontrol bilgisi kararlı kalır” ifadesi, kararlılığın bir sonraki saat çevriminden itibaren geçerli olduğunu yalnızca zamanlama diyagramı açığa çıkarmaktadır.
Şekildeki biçimsel özellik şu yapıya sahiptir:
(VALID && !READY) |-> ##1 $stable(INFO)
VALID bilginin geçerli olduğunu, READY alıcının kabul etmeye hazır olduğunu, INFO kontrol bilgisini, ##1 ise bir sonraki çevrimi gösterir. Metin ve diyagram birlikte yorumlanmadan ##1 zaman ilişkisi gözden kaçabilir. Bu örnek, doğru otomatik biçimselleştirmenin yalnızca metin işleme değil, kipler arası muhakeme gerektirdiğini göstermektedir.
Bildirimsel programlama dilleri
Ek A’da SQL, Cypher, CodeQL ve Cedar gibi bildirimsel dillerin otomatik biçimselleştirme kapsamına neden girdiği açıklanmaktadır. Bu diller “nasıl hesaplanacağını” değil, “hangi koşulun sağlanması gerektiğini” bildirir. Doğal dildeki bir gereksinimin Cedar politikasına çevrilmesi, yeni bir algoritma tasarlamaktan çok mevcut anlamı biçimsel sınırlara aktarmaktır.
Buna karşılık Python veya C++ gibi zorunlu programlama dillerine yapılan çeviri; veri yapısı, kontrol akışı, algoritma ve güvenlik tercihi gibi özgün metinde bulunmayan uygulama ayrıntıları ekler. Makale bu nedenle zorunlu program sentezini anlam koruyan bir çeviri değil, üretici bir görev olarak sınıflandırmaktadır.
Bildirimsel diller için aktarılan örnek sonuçlar şunlardır:
| Alan veya veri kümesi | Kapsam | Bildirilen sonuç | Yorum sınırı |
|---|---|---|---|
| Text2Cypher | 44.387 doğal dil–sorgu çifti | GPT-4o için %33 tam eşleşme; ince ayar olmadan %31 | Tam eşleşme, anlam bakımından eşdeğer fakat sözdizimi farklı sorguları kaçırabilir. |
| CodeQL ile güvenlik açığı sorgusu üretimi | 176 CVE ve 111 Java projesi | Claude Code için %10; araç geri bildirimi ve erişim destekli ajan yapısıyla %53,4 | Sonuçlar belirli görev, proje ve değerlendirme düzenine aittir. |
| IvyBench | Dağıtık protokol doğrulaması | 54 biçimselleştirilmiş protokol ispatı | Bu sayı model başarımı değil, veri kümesinin sınırlı kapsamıdır. |
Şekil 6’da HIPAA düzenlemelerindeki hasta erişimi, kişisel temsilciler ve küçükler hakkındaki ayrı hükümlerin ortak Cedar değişkenleri ve koşullarıyla birlikte biçimselleştirilmesi gösterilmektedir. Yüzlerce sayfalık hukuk metninde hükümler, istisnalar ve çapraz atıflar birbirine bağlıdır. Paragraf düzeyindeki tekil örneklerin başarılı olması, bütün düzenlemenin tutarlı biçimde çevrildiği anlamına gelmez.
Dördüncü açık sorun: Metnin ötesinde çok kipli girdiler
Makale gerçek biçimselleştirme görevlerinde dört girdi türü belirlemektedir:
- Doğal dil açıklamaları ve teknik belgeler
- Matematiksel gösterimler veya mevcut biçimsel diller
- Zamanlama diyagramları, şemalar, durum makineleri ve akış çizimleri
- Geometrik çizimler veya kullanıcı arayüzü örnekleri gibi serbest biçimli görüntüler
Geometride noktaların aradalığı veya doğruların kesişmesi bir çizimde doğal biçimde görülürken metinde ayrıntılı tanımlama gerektirebilir. Donanımda zamanlama diyagramları, protokollerde durum makineleri ve yazılımda arayüz örnekleri biçimsel içeriğin önemli bir bölümünü taşıyabilir. Kuram düzeyindeki sistemin bu kaynaklar arasındaki çelişkileri belirlemesi, örtük varsayımları açığa çıkarması ve hepsini tek bir tutarlı gösterimde birleştirmesi gerekir.
Öneri 1: Güvenilir kuram düzeyi değerlendirme ölçütleri
Yazarların önerdiği ideal kuram düzeyi değerlendirme düzeni üç koşulu sağlamalıdır:
- Yalnızca hedef ifadeleri değil, arka plan kuramının tanım ve bağımlılıklarını da kapsamalıdır.
- Eşdeğerlik denetleyicisinin uzman değerlendirmelerine göre kesinliği ve duyarlılığı raporlanmalıdır.
- Modelin sınandığı arka plan kuramının eğitim verisinde bulunması engellenmeli veya açıkça denetlenmelidir.
Kısa vadede uygun veri kümelerinin kurulması, orta vadede yapay zekâ yardımlı ve yardımsız biçimselleştirme sürelerinin uzman emeğiyle birlikte karşılaştırılması, uzun vadede ise ortak ara gösterimin doğrudan biçimselleştirmeye göre gerçekten avantaj sağlayıp sağlamadığının ölçülmesi önerilmektedir.
Öneri 2: Dar uzman modeller yerine genel amaçlı modeller
Makalede aktarılan örneğe göre Goedel-Formalizer-V2-32B, Mathlib dışındaki LeanEuclidPlus veri kümesinde %0,0 başarı gösterirken aynı model ailesinin temel Qwen3-32B modeli %20,6 elde etmiştir. Yazarlar bu örneği, tek bir kütüphanenin kalıplarına yoğun biçimde ince ayar yapılan sistemlerin alan dışına genelleşememe tehlikesi olarak yorumlamaktadır.
Önerilen yaklaşım, birden fazla biçimsel dil ve alandan veriyle eğitilen genel amaçlı modelleri; denetleyici geri bildirimi, bağımlılık erişimi, yinelemeli düzeltme ve çıkarım zamanında arama gibi yöntemlerle desteklemektir. Buradaki “genel amaçlılık”, yalnızca model mimarisini değil, eğitim veri karışımını, ödül tasarımını ve değerlendirme kapsamını da içermektedir.
Öneri 3: Ortak bir ara gösterim
Şekil 7, doğal dil, biçimsel dil, diyagram ve görüntünün önce ortak bir ara gösterime çevrildiği; daha sonra bu gösterimin farklı alan dillerine doğrulanabilir biçimde aktarıldığı bir mimari sunmaktadır. Aynı şekil, genel amaçlı çok kipli model ajanlarını ve güvenilir eşdeğerlik denetleyicisine sahip kuram düzeyi ölçütleri de bu akışın parçaları olarak göstermektedir.
Ortak ara gösterimin üç tasarım koşulu vardır:
- İfade gücü: Birbirinden farklı alan dillerinin anlamlarını temsil edebilmelidir.
- Doğrulanabilirlik: Ara gösterimin kendi içinde tür denetimi ve ispat denetimi yapılabilmelidir.
- Gömülebilirlik: Hedef alan dilleri ara gösterim içine yeterince derin biçimde gömülebilmeli ve dönüşüm doğrulanabilmelidir.
Yazarlar Lean’i bağımlı tür kuramı, yerleşik tür denetleyicisi ve üst programlama olanakları nedeniyle doğal bir aday olarak göstermektedir. Ancak bu öneri, Lean’in bütün alan dilleri için en uygun ortak gösterim olduğunun deneysel olarak kanıtlandığı anlamına gelmez. Özellikle donanım zamanlaması, hukuk politikaları, protokol durumları ve özel kurumsal diller için ifade gücü ile pratik kullanılabilirliğin ayrıca değerlendirilmesi gerekir.
Çalışmanın desteklediği sonuçlar
- Gerçek biçimsel doğrulama projeleri, hedef ifadelerin çevrilmesinden çok daha geniş tanım ve yardımcı sonuç altyapıları gerektirmektedir.
- Mevcut ifade düzeyi yöntemleri çoğu zaman insan tarafından hazırlanmış biçimsel kütüphanelere ve bağımlılık taslaklarına dayanmaktadır.
- Eşdeğerlik değerlendirmesi, yalnızca sözdizimsel eşleşmeyle çözülemeyen ve arka plan kuramına bağlı bir sorundur.
- Düşük kaynaklı alan dilleri ve çok kipli teknik belgeler, Lean merkezli matematik veri kümelerinden farklı güçlükler taşımaktadır.
- Kuram düzeyi veri kümeleri, genel amaçlı modeller ve ortak ara gösterim araştırılması gereken somut yönlerdir.
Çalışmanın kanıtlamadığı veya test etmediği sonuçlar
- Makale çalışan bir uçtan uca kuram düzeyi otomatik biçimselleştirme sistemi sunmamaktadır.
- Önerilen ortak ara gösterimin doğrudan çeviriden daha başarılı olduğu deneysel olarak gösterilmemiştir.
- Lean’in bütün matematiksel, hukuki, yazılımsal ve donanımsal alanlar için evrensel ara dil olduğu kanıtlanmamıştır.
- Kuram düzeyinde otomatik biçimselleştirmenin yeni matematiksel keşifleri otomatik olarak üreteceği gösterilmemiştir.
- Aktarılan model başarıları farklı veri kümeleri ve değerlendirme ölçütleri kullanıldığı için tek bir ortak sıralama gibi yorumlanamaz.
- Biçimsel doğrulama doğal dil muhakemesindeki bütün belirsizlikleri veya semantik uyumsuzlukları kendiliğinden ortadan kaldırmaz.
Geçmiş, bugün ve gelecek açısından anlamı
Geçmişteki büyük biçimselleştirme projeleri, makine denetimli bilginin güvenilirliğini göstermiş ancak yıllar süren uzman emeği gerektirmiştir. Bugün büyük dil modelleri doğal dil ile biçimsel diller arasında çeviri, bağımlılık bulma ve ispat onarımı gibi görevleri kısmen otomatikleştirebilmektedir. Makalenin katkısı, araştırma hedefini tekil başarı oranlarından bütün bilgi mimarisinin kurulmasına doğru genişletmesidir.
Gelecekte bu yaklaşım başarılı olursa matematiksel ders kitapları, teknik standartlar, güvenlik politikaları, dağıtık sistem protokolleri ve donanım tasarım belgeleri daha denetlenebilir biçimsel kütüphanelere dönüştürülebilir. Bu olasılık; yazılım ve donanım güvenilirliği, kritik sistemlerin doğrulanması, matematiksel bilgi yönetimi ve yapay zekâ muhakemesinin denetlenebilirliği açısından önem taşımaktadır. Ancak gerçek uygulama için ölçeklenebilirlik, anlam sadakati, veri sızıntısı, çok kipli yorumlama ve uzman denetimi sorunlarının çözülmesi gerekmektedir.
Çalışmanın Yöntemi ve Bulguları
Çalışma tasarımı
Bu çalışma deneysel araştırma, klinik çalışma, simülasyon deneyi veya yeni model karşılaştırması değildir. ICML Position Paper Track için hazırlanmış bir pozisyon makalesidir. Yöntem; mevcut otomatik biçimselleştirme literatürünün kavramsal olarak sınıflandırılması, farklı alanlardaki biçimsel doğrulama projelerinin karşılaştırılması, alternatif görüşlerin tartışılması, açık sorunların belirlenmesi ve araştırma önerilerinin geliştirilmesine dayanmaktadır.
| Yöntemsel bileşen | Çalışmada nasıl uygulanmıştır? |
|---|---|
| Kavramsal tanımlama | Kuram düzeyinde otomatik biçimselleştirme; aksiyom, tanım, gösterim, örnek, yardımcı önerme, teorem, ispat, taktik ve bağımlılıkların bütüncül kütüphane olarak oluşturulması şeklinde tanımlanmıştır. |
| Alanlar arası örnekleme | Matematik, bilim, yazılım ve donanımdan temsilî biçimsel doğrulama projeleri karşılaştırılmıştır. |
| Alternatif görüş analizi | Doğal dil muhakemesi, teorem ispatı ve ifade düzeyi biçimselleştirmeye öncelik veren üç yaklaşım tartışılmıştır. |
| Açık sorun analizi | Eşdeğerlik denetimi, hiyerarşik ayrıştırma ve soyutlama, düşük kaynaklı alan dilleri ve çok kipli girdiler olmak üzere dört sorun belirlenmiştir. |
| Çözüm önerileri | Kuram düzeyi ölçütler, genel amaçlı modeller ve ortak ara gösterim olmak üzere üç araştırma yönü sunulmuştur. |
| Ek kavramsal ayrımlar | Bildirimsel ve zorunlu program sentezi ile ispat otomatik biçimselleştirmesi ve genel teorem ispatı birbirinden ayrılmıştır. |
Veri, örneklem ve istatistiksel analiz
- Yeni bir deneysel veri seti oluşturulmamıştır.
- İnsan katılımcı, hasta, hayvan, hücre, fiziksel numune veya kontrol grubu bulunmamaktadır.
- Model eğitimi, doğrulama ve test ayrımı yapılmamıştır.
- Yeni bir algoritma eğitilmemiş veya çalıştırılmamıştır.
- İstatistiksel hipotez testi, p değeri, güven aralığı veya anlamlılık eşiği raporlanmamıştır.
- Sayısal sonuçlar, makalede incelenen önceki çalışmaların ve veri kümelerinin bildirilen sonuçlarıdır.
Temel nicel göstergeler
| Gösterge | Bildirilen değer | Çalışmadaki anlamı |
|---|---|---|
| Katman 3 ifade biçimselleştirmesi | %71,4 | Alt katmanların insanlar tarafından hazırlandığı durumda bildirilen başarıdır; bütün kuram başarımı değildir. |
| ProofNet insan biçimselleştirme hataları | 118/371, %31,8 | Referans biçimselleştirmelerin de hatalı olabileceğini göstermektedir. |
| PutnamBench’te düzeltilen hatalar | En az 58/672, %8,6 | Uzman tarafından yazılmış biçimsel referanslarda kalite denetimi gereksinimini göstermektedir. |
| BEq+ eşdeğerlik denetleyicisi | %98,0 kesinlik, %48,3 duyarlılık | Yüksek kesinliğe karşın kapsama alanının sınırlı kaldığını göstermektedir. |
| Saf tanımsal eşdeğerlik | %100 kesinlik, %30,9 duyarlılık | Yanlış pozitif üretmemeye karşılık birçok geçerli eşdeğerliği kaçırmaktadır. |
| DeepSeek-Prover-V2, miniF2F | %88,9 | Tekil ispatları alt hedeflere ayırmadaki ilerlemeye örnektir. |
| BFS-Prover-V2, miniF2F | %95,1 | Çok ajanlı alt hedef aramasının bildirilen başarımıdır; kuram düzeyi ders kitabı ayrıştırması değildir. |
| Goedel-Formalizer-V2-32B, LeanEuclidPlus | %0,0 | Dar ince ayarın alan dışı genelleme sorununa örnek olarak verilmiştir. |
| Qwen3-32B, LeanEuclidPlus | %20,6 | Aynı örnekte temel genel amaçlı modelin daha yüksek sonuç verdiği aktarılmıştır. |
| Text2Cypher | 44.387 çift; %33 tam eşleşme | Düşük kaynaklı ve şemaya bağlı alan dillerindeki bileşimsel zorluğu göstermektedir. |
| CodeQL güvenlik sorgusu üretimi | %10 ve ajan desteğiyle %53,4 | Güvenlik ve program analizi bilgisini birlikte gerektiren görevin zorluğunu göstermektedir. |
Şekillerin yöntemsel mesajı
- Şekil 1: Makalenin dört parçalı argümanını; önem, alternatif görüşler, açık sorunlar ve çözüm çağrısı olarak özetlemektedir.
- Şekil 2: Aksiyomlardan hedef ispatlara uzanan dört katmanlı kuramsal bağımlılık yapısını göstermektedir.
- Şekil 3: Liste işlemi hakkındaki doğal dil ifadesinin SMT benzeri biçimsel yapıya çevrilmesini göstermektedir.
- Şekil 4: Halka topolojisindeki lider seçimi protokolünün aksiyomlar, ilişkiler ve eylemlerle modellenmesini göstermektedir.
- Şekil 5: Donanım özelliğinin doğru çevrilebilmesi için metin ile zamanlama diyagramının birlikte okunması gerektiğini göstermektedir.
- Şekil 6: Farklı HIPAA hükümlerinin ortak koşullar aracılığıyla tek bir Cedar politika yapısında birleştirilmesini göstermektedir.
- Şekil 7: Çok kipli girdilerden ortak ara gösterime, oradan farklı alan dillerine doğrulanabilir dönüşüm önerisini özetlemektedir.
Ana bulgu ve yorum sınırı
Çalışmanın ana sonucu deneysel bir performans değeri değil, araştırma gündemine ilişkin bir savdır: otomatik biçimselleştirmenin gerçek dünyada ölçeklenebilmesi için hedef tekil ifadelerden bütün kuramların oluşturulmasına geçilmelidir. Yazarlar, mevcut yöntemlerin tanım, bağımlılık, gösterim ve yardımcı ispat altyapısını çoğunlukla insanlara veya olgun kütüphanelere bıraktığını göstermektedir.
Bu sonuç, kuram düzeyindeki sistemlerin bugün kullanıma hazır olduğu anlamına gelmez. Makalenin önerileri; güvenilir ölçütlerin, genel amaçlı modellerin ve ortak ara gösterimin gelecekte geliştirilip sınanması gereken araştırma yönleridir.
Kaynak ve Yöntem Notu
- Çalışmanın tam özgün adı: Theory-Level Autoformalization: From Isolated Statements to Unified Formal Knowledge Bases
- Yazarlar ve sıraları: Marcus J. Min; Mike He; Zhaoyu Li; Zixuan Yi; Sharad Malik; Aarti Gupta; Xujie Si; Osbert Bastani
- Eş birinci yazar veya eş katkı: PDF’de eş katkı ya da eş birinci yazarlık bilgisi belirtilmemiştir.
- Yazışma için listelenen yazarlar: Marcus J. Min, Mike He, Sharad Malik, Aarti Gupta, Xujie Si ve Osbert Bastani
- Kurumlar: University of Pennsylvania; Princeton University; University of Toronto
- Kaynak türü: Hakemli konferans pozisyon makalesi
- Konferans: 43rd International Conference on Machine Learning, ICML 2026
- Sunum/kabul türü: Position Paper Track, Spotlight
- Yayın serisi: Proceedings of Machine Learning Research, PMLR 306
- Özgün yayınevi: Proceedings of Machine Learning Research
- Konferans yeri ve yılı: Seul, Güney Kore, 2026
- Hakemlik durumu: ICML 2026 Position Paper Track kapsamında değerlendirilmiş ve Spotlight olarak kabul edilmiştir. Makale ayrıca anonim hakemlere teşekkür etmektedir.
- Nihai konferans yayını DOI’si: Yüklenen PDF’de PMLR yayınına ait ayrı bir DOI bilgisi yer almamaktadır.
- arXiv kimliği: arXiv:2607.13292
- arXiv DataCite DOI’si: 10.48550/arXiv.2607.13292; arXiv sayfasında kayıt bekliyor biçiminde gösterilmektedir. Bu tanımlayıcı, PMLR konferans yayınına ait ayrı bir DOI olarak sunulmamalıdır.
- Resmî veya doğrulanmış kayıtlar:OpenReview çalışma kaydı, arXiv çalışma kaydı, SSRN çalışma kaydı
Bu Verianla makalesi, yüklenen 16 sayfalık çalışma baştan sona incelenerek hazırlanmıştır. Ana metinle birlikte Tablo 1, Şekil 1–7, matematiksel eşdeğerlik örnekleri, kaynakça ve bildirimsel program sentezi ile ispat otomatik biçimselleştirmesine ilişkin ek bölümler değerlendirilmiştir. PDF dışından herhangi bir bilimsel bulgu, yöntem başarımı veya deneysel sonuç eklenmemiştir. Dış kaynaklar yalnızca yazar sırası, yayın platformu, Spotlight durumu ve arXiv kimliği gibi bibliyografik bilgileri doğrulamak için kullanılmıştır.
Çalışmanın temel sınırlılığı, uygulanan ve deneysel olarak değerlendirilen yeni bir kuram düzeyi sistem sunmamasıdır. Önerilen üç yönün başarısı henüz karşılaştırmalı deneylerle gösterilmemiştir. İncelenen projeler ve veri kümeleri farklı alan, kapsam ve ölçütlere sahip olduğundan bildirilen başarı oranları doğrudan birbirleriyle sıralama amacıyla karşılaştırılmamalıdır. Ortak ara gösterimin uygulanabilirliği, eşdeğerlik denetiminin kabul edilebilir sınırı, uzman emeğinin ne ölçüde azalacağı ve çok kipli belgelerde anlam sadakatinin nasıl korunacağı açık araştırma soruları olarak kalmaktadır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir