

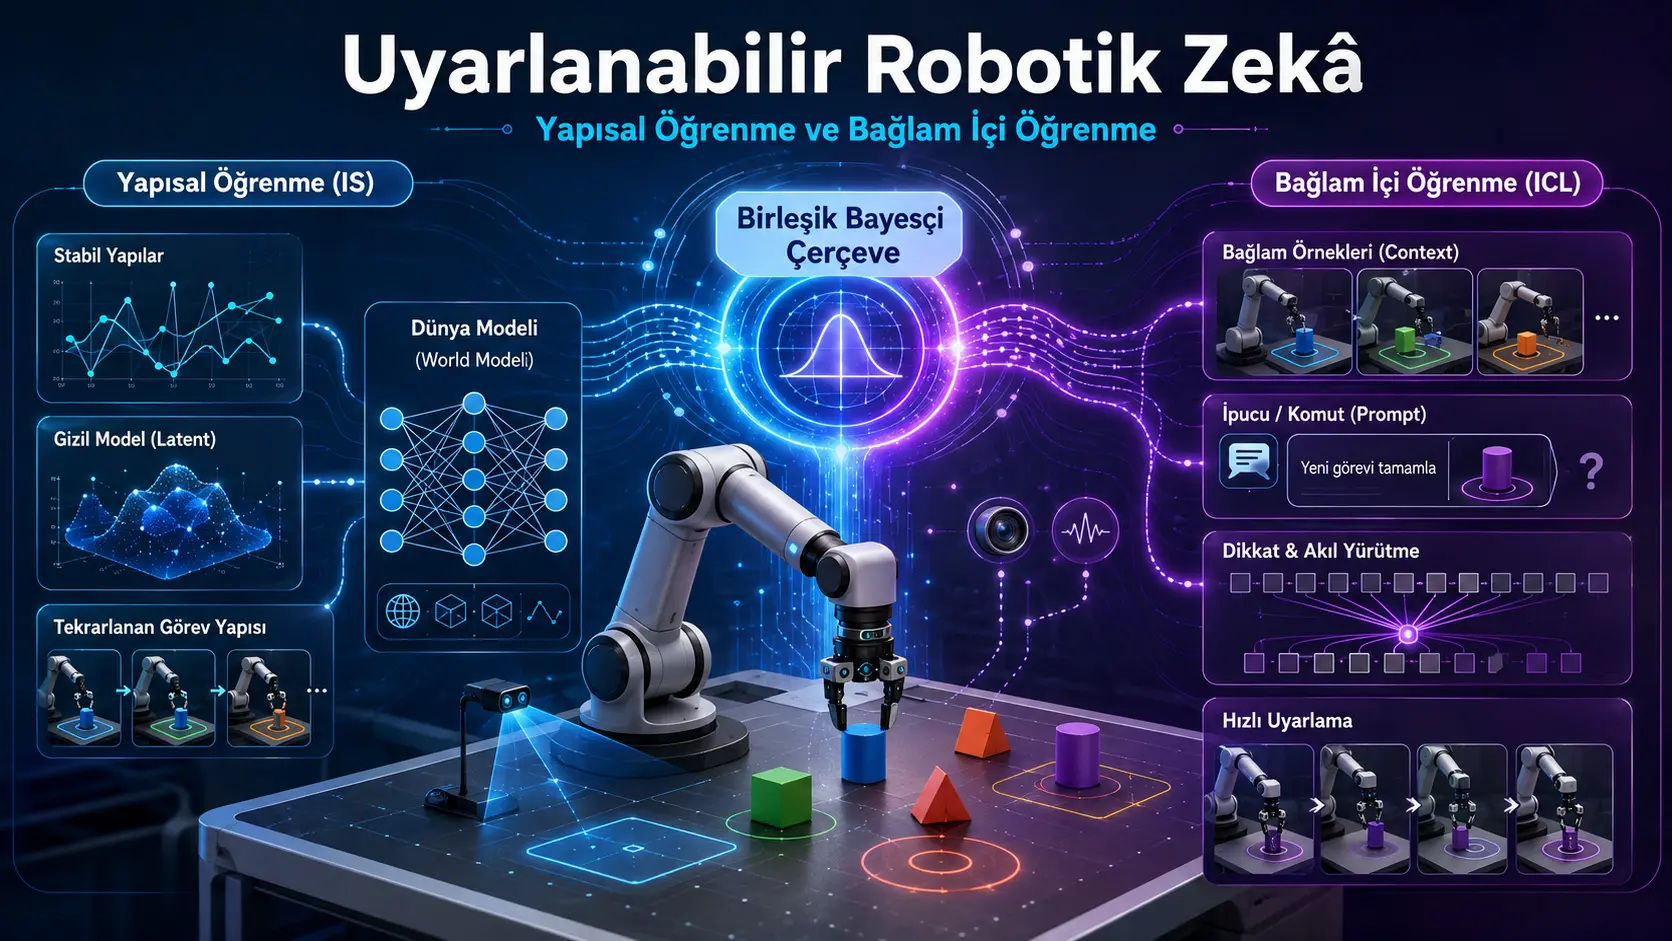
Utafiti huu unalinganisha mifumo miwili tofauti ya kujifunza katika uwezo wa roboti kuzoea hali zinazobadilika za ulimwengu halisi: Inferred-Structure Learning (IS), ambayo huingiza kanuni za kudumu za kimuundo zinazojirudia kati ya uzoefu mbalimbali ndani ya vigezo vya modeli, na In-Context Learning (ICL), ambayo hutoa kwa haraka sheria ya kazi ya sasa kutoka kwa mifano iliyopo bila kubadilisha vigezo vya modeli. Watafiti walilinganisha wakala wa IS unaotegemea MAML na wakala mdogo wa ICL unaotegemea transformer kwa kutumia data zilezile za support na query; na wakaendeleza mfumo wa Bayes wa ngazi mbalimbali unaotabiri kuwa IS itakuwa bora katika mabadiliko ya kimuundo, huku ICL ikiwa bora katika sheria za kimuktadha zinazobadilika kabisa katika kila episode. Katika majaribio kumi na mawili yaliyodhibitiwa, data sanisi na data ya kiwango cha roboti ziliunga mkono kwa nguvu ukamilishano huu; katika uchunguzi 2.400 halisi wa proprioceptive uliokusanywa kutoka kwa roboti Niryo Ned3 Pro, IS ilizidi ICL kwa kiasi kikubwa chini ya mabadiliko ya kimuundo. Hata hivyo, lebo za madarasa katika jaribio la roboti halisi zilitolewa kwa njia sanisi, mafanikio ya roboti katika kazi halisi ya kimwili ya closed-loop hayakupimwa, na ubora wa kimuktadha wa ICL katika data halisi haukufikia umuhimu wa kitakwimu.
Hitimisho kuu la utafiti ni kwamba IS na ICL si mbinu pinzani zinazochukua nafasi ya nyingine. IS huhamisha miundo ya kimwili na ya kisababishi inayojirudia katika uzoefu au kazi nyingi kwenda kwenye vigezo vya kudumu; ICL hutafsiri kwa haraka mifano mipya, maagizo au ulinganifu wa malengo uliotolewa wakati wa kazi moja. Kwa hiyo, watafiti wanapendekeza usanifu wa utambuzi wa roboti wa tabaka tatu unaojumuisha modeli ya kudumu ya ulimwengu, moduli iliyogandishwa ya hoja za kimuktadha, na utaratibu wa gate uliojifunza unaochanganya matokeo mawili kulingana na hali.
Inamaanisha nini kwa Uturuki?
Nchini Uturuki, roboti zinazotumiwa katika magari, vifaa vya nyumbani, ulinzi, lojistiki, teknolojia za kilimo na mistari ya uzalishaji inayobadilika hukutana na vigezo kama uzito wa bidhaa, msuguano, uchakavu wa vifaa, mpangilio wa sehemu ya kazi na malengo ya uzalishaji. Utafiti huu unatoa kanuni ya kimawazo ya usanifu inayopendekeza kusimamia mabadiliko yanayojirudia katika muundo wa kimwili kwa modeli ya muda mrefu ya kimuundo, huku maagizo yanayobadilika kwa zamu au oda yakisimamiwa kwa utoaji hitimisho wa ndani ya muktadha.
Ili kutumika Uturuki, ni lazima kwenda zaidi ya majaribio sanisi ya uainishaji. Majaribio ya closed-loop yanahitajika kwa maagizo ya lugha asilia ya Kituruki, mipangilio ya vihisi katika mistari ya uzalishaji ya ndani, chapa tofauti za roboti, mabadiliko halisi ya mzigo na msuguano, viwango vya usalama na vipimo vya mafanikio ya kazi za kimwili. Matokeo ya utafiti hayathibitishi kwamba usanifu uliopendekezwa utafanikiwa moja kwa moja katika mifumo ya roboti nchini Uturuki; yanatoa nadharia tete ya uhandisi inayoweza kujaribiwa kuhusu ni utaratibu gani wa urekebishaji unaopaswa kupewa kipaumbele katika aina gani ya mabadiliko.
Swali kuu la utafiti ni lipi?
Roboti inayofanya kazi katika ulimwengu halisi inaweza kukutana na aina mbili tofauti za kutokuwa na uhakika. Katika aina ya kwanza, muundo wa kudumu au unaojirudia wa mazingira hubadilika: uzito wa mzigo, msuguano wa kiungo, mahusiano ya vihisi, jiometri ya eneo la kazi au tabia ya kimwili ya kitu inaweza kutofautiana. Katika aina ya pili, muundo wa kimwili hubaki uleule lakini maana ya kazi ya sasa hubadilika: opereta anaweza kutoa sheria mpya ya kupanga, ulinganifu wa rangi na malengo unaweza kupewa upya, au kitu kilekile kinaweza kupewa lengo tofauti.
Swali kuu la watafiti ni hili: je, roboti inapaswa kujibu mabadiliko haya yote kwa utaratibu mmoja wa urekebishaji, au inapaswa kutumia kwa pamoja kujifunza kwa kimuundo kwa muda mrefu na utoaji hitimisho wa kimuktadha kwa muda mfupi?
Nadharia tete ya utafiti iko wazi:
- Katika mabadiliko ya kimuundo, kwa kuwa kuna mpangilio wa pamoja unaojirudia kati ya episodes, IS inapaswa kuwa bora.
- Katika mabadiliko ya kimuktadha, kwa kuwa sheria ya kila episode lazima isomwe upya kutoka kwa mifano iliyopo, ICL inapaswa kuwa bora.
- Katika hali mseto, mfumo mseto unaopima uzito wa matokeo ya mifumo yote miwili kulingana na mazingira unapaswa kufaa zaidi kuliko mawakala wanaotumiwa peke yao.
Inferred-Structure Learning ni nini?
Inferred-Structure Learning haitumiki katika utafiti kama jina la algorithimu moja iliyosanifishwa, bali kama dhana ya juu inayojumuisha mbinu zinazoingiza kanuni za kimuundo zilizofichika ndani ya vigezo vya modeli. Meta-learning, world models, variational autoencoders, reinforcement learning yenye latent variables na representation learning zinachukuliwa kuwa mifano tofauti ya utaratibu huu wa pamoja.
Uhusiano msingi wa kizalishaji kati ya data inayoonekana \(x\) na muundo uliofichika \(z\) ni huu:
\[ p(x)=\int p(x\mid z)p(z)\,dz \]
Hapa:
- \(x\) ni data inayoonekana kama picha, sentensi, hali ya roboti au trajectory ya mwendo.
- \(z\) ni kigezo kisichoonekana moja kwa moja kama hali ya kimwili, familia ya kazi, mpangilio wa mazingira au muundo wa kisababishi.
- \(p(z)\) ni usambazaji prior juu ya miundo inayowezekana iliyofichika.
- \(p(x\mid z)\) ni uwezekano wa kuona data chini ya muundo fulani uliofichika.
Vigezo vinavyoweza kujifunzwa \(\theta\) vinapoongezwa, modeli huwa:
\[ p_{\theta}(x)=\int p_{\theta}(x\mid z)p(z)\,dz \]
Lengo ni kujifunza vigezo vinavyoeleza vyema zaidi data inayoonekana:
\[ \theta^{*}=\arg\max_{\theta}\mathbb{E}_{p_{data}(x)}[\log p_{\theta}(x)] \]
Kwa sababu kuhesabu usambazaji halisi wa posterior huwa vigumu katika hali nyingi, modeli ya makadirio ya utoaji hitimisho inayoitwa \(q_{\phi}(z\mid x)\) hutumiwa. Evidence Lower Bound (ELBO) hutolewa kama ifuatavyo:
\[ \mathcal{L}(\theta,\phi)=\mathbb{E}_{q_{\phi}(z\mid x)}[\log p_{\theta}(x\mid z)]-D_{KL}(q_{\phi}(z\mid x)\parallel p(z)) \]
Sehemu ya kwanza inaonyesha jinsi modeli inavyoweza kujenga upya au kueleza data vizuri, huku sehemu ya pili, ambayo ni Kullback-Leibler divergence, ikiwakilisha regularization inayozuia nafasi iliyofichika iliyojifunza kusogea mbali kupita kiasi kutoka kwa usambazaji prior. Sifa kuu ya IS ni kwamba maarifa ya kudumu huingizwa katika vigezo vya modeli na representations zilizofichika.
In-Context Learning ni nini?
In-Context Learning ni uwezo wa modeli iliyofunzwa awali kutoa sheria ya muda ya kazi kwa kutumia tu mifano katika mlolongo wa sasa wa ingizo, bila kubadilisha vigezo vya modeli. Vigezo vya modeli \(\theta\) hubaki vilevile. Muktadha wa mifano \(k\) unapofafanuliwa kama:
\[ C=\{(x_i,y_i)\}_{i=1}^{k} \]
utabiri wa query mpya huwa:
\[ \hat{y}_{k+1}=f_{\theta}(x_{k+1},C) \]
Urekebishaji hutokea si kwa gradient update, bali kupitia utaratibu wa self-attention wa transformer:
\[ h_i=Attention(Q_i,K_C,V_C) \]
\(Q_i\) hubeba query ya sasa, \(K_C\) key representations za mifano ya muktadha, na \(V_C\) taarifa inayochukuliwa kutoka kwa mifano hiyo. Modeli huamua ni mifano ipi ya muktadha inayohusiana na query ya sasa kupitia attention weights.
Kwa mtazamo wa Bayes, mchakato huu unaelezwa kama makadirio ya usambazaji wa muda wa posterior juu ya kigezo cha kazi \(\phi\):
\[ p(y\mid x,C)\approx\int p_{\theta}(y\mid x,\phi)q(\phi\mid C)\,d\phi \]
Muktadha unapoondolewa, urekebishaji huu pia hupotea. Kwa hiyo ICL ni ya haraka na haihitaji parameter update; lakini yenyewe haibadilishi maarifa mapya ya kimuundo kuwa kumbukumbu ya kudumu.
Ni tofauti zipi kuu kati ya IS na ICL?
| Sifa | Inferred-Structure Learning | In-Context Learning |
|---|---|---|
| Muda wa urekebishaji | Training na meta-learning kati ya episodes | Wakati wa inference, ndani ya muktadha wa sasa |
| Kipengele kinachobadilika | Modeli au vigezo vya kazi vilivyorekebishwa | Activations za muda na attention representations za modeli |
| Kudumu kwa maarifa | Hudumu katika vigezo au muundo uliofichika | Hupotea dirisha la muktadha linapoondolewa |
| Mabadiliko ambako ina nguvu | Mabadiliko ya kimwili, ya kisababishi au ya kimuundo yanayojirudia | Maagizo mapya, ulinganifu wa malengo na sheria za kazi ndani ya episode |
| Mbinu wakilishi | Wakala wa meta-learning unaotegemea MAML | Transformer iliyogandishwa |
| Kikomo kikuu | Inahitaji parameter update na data inayofaa ya mafunzo ya kimuundo | Haizalishi kujifunza kwa kimuundo kwa kudumu na ni nyeti kwa ukubwa wa muktadha |
Mfumo mmoja wa Bayes unaunganishwaje?
Utafiti unaeleza njia hizi mbili kama vipengele vya mchakato mmoja wa hierarchical inference katika vipimo tofauti vya muda:
\[ p(y\mid x,D)=\int p_{\theta}(y\mid x,\phi)q_{\theta}(\phi\mid D)\,d\phi \]
\(D\) inaweza kuwakilisha data ya mafunzo ya muda mrefu kwa IS, au mifano ya muktadha wa muda mfupi kwa ICL. IS huunda prior ya kudumu na uwezo wa representation ya kimuundo, huku ICL ikitumia prior hii haraka kwenye mifano ya kazi ya sasa.
Nadharia ya kwanza: IS hukaribia katika hali gani?
Nadharia ya kwanza inaeleza kasi ambayo meta-parameters za wakala wa IS unaotegemea MAML zinaweza kukaribia chini ya structural noise. Inachukuliwa kwamba structural deviation kwa episode imewekewa kikomo na \(\varepsilon\), loss function ni \(L\)-Lipschitz na \(\mu\)-strongly convex.
Kikomo katika maandishi makuu ni:
\[ \|\theta_T-\theta^{*}\|\leq(1-\eta\mu)^T\|\theta_0-\theta^{*}\|+\frac{\eta L\varepsilon}{\mu} \]
Hapa:
- \(\theta_T\) ni vigezo baada ya meta-updates \(T\).
- \(\theta^{*}\) ni meta-initialization bora kwa familia ya kazi.
- \(\eta\) ni learning rate.
- \(\mu\) ni strongly convex coefficient.
- \(L\) ni smoothness au Lipschitz coefficient.
- \(\varepsilon\) ni kikomo cha juu cha structural noise kati ya episodes.
Sehemu ya kwanza hupungua kwa kijiometri kulingana na idadi ya updates. Sehemu ya pili inawakilisha error floor ambayo haiwezi kupunguzwa hadi sifuri kutokana na structural noise. Hata hivyo, uendeshaji wa geometric series katika ushahidi wa ziada hutoa \(L\varepsilon/\mu\), wakati usemi mkuu wa nadharia una \(\eta L\varepsilon/\mu\). Toleo lililochunguzwa halitoi maelezo thabiti ya kihisabati kuhusu tofauti hii.
Nadharia ya pili: ICL hubadilikaje muktadha unapokua?
Nadharia ya pili inaweka kikomo kwa expected regret ya wakala wa ICL anayepokea mifano \(k\) ya muktadha ikilinganishwa na oracle inayojua kazi mapema:
\[ \mathbb{E}[R_{ICL}(k)]\leq\mathcal{O}\left(\frac{d\log M}{k}\right) \]
\(d\) ni ukubwa wa ingizo; \(M\) ni idadi ya kazi au label mappings zinazowezekana; na \(k\) ni idadi ya mifano ya muktadha. Chini ya dhana kwamba modeli inakaribia Bayesian inference kwa usahihi wa kutosha, regret inatarajiwa kupungua takriban kwa kiwango cha \(1/k\) kadiri muktadha unavyoongezeka.
Katika jaribio la context scaling, thamani ya \(k\) ilibadilishwa kuwa 4, 8, 12, 16, 24, 32 na 48. Katika hali ya mabadiliko ya kimuktadha, accuracy ya ICL iliongezeka kwa mfululizo kadiri ukubwa wa muktadha ulivyoongezeka. Katika hali ya kimuundo pia, mifano zaidi iliisaidia ICL, lakini ilibaki nyuma ya wakala wa IS unaotumia structural prior iliyojifunza kati ya episodes.
Nadharia ya tatu: Wakala mseto unapaswa kuipa kila mbinu uzito gani?
Chini ya dhana kwamba IS na ICL hutoa taarifa zilizo conditionally independent kuhusu kazi, mixing coefficient bora hutolewa kama:
\[ \alpha^{*}=\frac{I(z;D_{meta})}{I(z;D_{meta})+I(\phi;C)} \]
\(I(z;D_{meta})\) inawakilisha mutual information kati ya latent structure ya IS na meta-training data; \(I(\phi;C)\) inawakilisha mutual information kati ya temporary task variable ya ICL na muktadha.
- Ikiwa taarifa ya kimuundo inatawala, \(\alpha^{*}\) hukaribia 1 na uzito wa IS huongezeka.
- Ikiwa taarifa ya kimuktadha inatawala, \(\alpha^{*}\) hukaribia 0 na uzito wa ICL huongezeka.
Ikiwa conditional independence haitimizwi, matokeo ya closed-form yanaweza kutotumika. Katika hali hiyo, watafiti walitumia learned gating network inayokadiria \(\alpha\) kwa kila episode kwa kutumia summaries za support set kama mean, variance na class entropy.
Mfano wa matumizi ya roboti unaeleza nini?
Watafiti wanatumia mfano wa collaborative robot arm inayohamisha vitu vya rangi kwenye malengo tofauti juu ya meza ya pamoja. Katika mazingira ya kiwanda, uzito wa kitu, msuguano na kasi ya conveyor vinaweza kubadilika. Katika jikoni, mazingira ya kimwili yanaweza kubaki yale yale lakini object-target mapping ikabadilika kwa sababu ya recipe. Katika kituo cha kufungasha, hali za kimwili na maana za malengo zinaweza kubadilika pamoja.
Wakala wa IS hujifunza latent variable \(z_t\) inayowakilisha physical regime au workspace:
\[ p_{\theta}(s_{t+1}\mid s_t,a_t,z_t) \]
Policy pia huwekwa kwa masharti ya hali ya sasa na muundo uliotolewa:
\[ \pi_{\theta}(a_t\mid s_t,z_t)=\frac{\exp(Q_{\theta}(s_t,a_t,z_t)/\tau)}{\sum_{a'}\exp(Q_{\theta}(s_t,a',z_t)/\tau)} \]
\(\tau\) ni temperature coefficient inayobainisha kiwango cha randomness katika action distribution. Wakala wa ICL, kwa upande mwingine, hutoa mapping ya muda kama “kitu chekundu kwenda lengo A, kitu cha buluu kwenda lengo C” kutoka kwa hatua chache za mfano; na hutabiri lengo la kitu kipya bila kubadilisha vigezo vya modeli.
Pipeline ya majaribio iliundwaje?
Kielelezo 2 katika ukurasa wa 10 kinaonyesha pipeline ya jaribio katika hatua nne:
- Wakala wa IS unaotegemea MAML ulifundishwa kwa episodes 1.500 za meta-training, huku transformer ya ICL ikifundishwa kwa kazi 50.000 za random classification.
- Mawakala walijaribiwa katika mazingira ya mabadiliko ya kimuundo na kimuktadha.
- Katika kila evaluation episode, mifano ileile 24 ya support na mifano 120 ya query ilitolewa kwa mawakala wote wawili.
- Paired t-test, Cohen’s \(d\) effect size, bootstrap confidence interval na Bonferroni correction zilitumika.
Kielelezo 3 katika ukurasa wa 11 kinaonyesha kwa kulinganisha kwamba wakala wa IS hubadilisha vigezo vyake kwa gradient steps tano kwenye support set, wakati wakala wa ICL hutumia attention kwenye mfululizo wa muktadha akiwa na vigezo vilivyogandishwa.
Mabadiliko ya kimuundo na kimuktadha yalitenganishwaje?
Katika mabadiliko ya kimuundo, kuna base matrix isiyobadilika inayoshirikiwa na episodes zote:
\[ W_{ep}=W_{base}+\varepsilon,\qquad \varepsilon\sim\mathcal{N}(0,\sigma_{shift}^{2}I) \]
Katika mazingira haya, kila kazi ni toleo lenye noise la muundo uleule wa msingi. MAML inaweza meta-learn muundo wa \(W_{base}\) kati ya episodes.
Katika mabadiliko ya kimuktadha:
\[ W_{ep}\sim\mathcal{N}(0,I) \]
matrix mpya kabisa hutengenezwa kwa kila episode. Kwa sababu hakuna msingi wa pamoja, prior ya IS kati ya episodes haina manufaa; ICL husoma mapping ya episode kutoka kwa mifano ya sasa ya support.
Kielelezo 4 katika ukurasa wa 13 kinaonyesha tofauti hii kwa paneli za bluu za kimuundo na nyekundu za kimuktadha. Katika Kielelezo 5 cha ukurasa huo huo, accuracy ya IS katika mazingira ya kimuundo iko karibu 0,80, huku accuracy ya ICL ikiwa karibu 0,58. Katika Kielelezo 6, matokeo hubadilika katika mazingira ya kimuktadha na mean accuracy ya ICL huwa juu kuliko IS.
Nini kilifanywa katika jaribio la roboti halisi?
Roboti ya mhimili sita Niryo Ned3 Pro ilisogezwa kwenye nafasi za Cartesian za nasibu ndani ya workspace iliyowekewa mipaka:
- \(x\): mita 0,144-0,385
- \(y\): mita -0,253 hadi 0,253
- \(z\): mita 0,050-0,100
Katika kila nafasi, vector ya uchunguzi ya dimensions 21 ilirekodiwa:
- Pembe 6 za joint — kwa radian
- Coordinates 3 za end-effector — kwa mita
- Nafasi ya relative ya pande tatu ya vitu 4 dhidi ya end-effector — jumla ya thamani 12, kwa mita
Katika hatua ya pilot, vipimo 640 vilikusanywa kutoka episodes 80 zenye observations nane kila moja; katika hatua kamili, vipimo 2.400 vilikusanywa kutoka episodes 200 zenye observations kumi na mbili kila moja. Jaribio kamili lilijumuisha takriban saa 3,3 za uendeshaji wa roboti, huku episodes 120 zikitumiwa kwa training na 80 kwa evaluation.
Class labels hazikutokana na matokeo halisi ya grasping, contact au kufikia lengo. Madarasa manne ya lengo yaliwekwa kwa linear projection ifuatayo:
\[ y=\arg\max(X_{real}W) \]
Katika hali ya kimuundo:
\[ W_i=W_{base}+\varepsilon_i,\qquad \varepsilon_i\sim\mathcal{N}(0,\sigma^{2}I),\quad \sigma=0{,}3 \]
na katika hali ya kimuktadha:
\[ W_i\sim\mathcal{N}(0,0{,}25I) \]
zilitumika. Muundo huu unajaribu ikiwa noise ya sensor halisi na correlations za kinematics zinavuruga utofauti wa IS-ICL. Lakini si jaribio la kimwili la closed-loop linaloonyesha kwamba roboti ilisogea kweli hadi lengo lililotabiriwa na kulifikia kwa mafanikio.
Matokeo makuu ya utafiti ni yapi?
Katika jaribio la msingi la sanisi, chini ya mabadiliko ya kimuundo, mean accuracy ya wakala wa IS ilikuwa 0,795 na ya wakala wa ICL ilikuwa 0,578. Tofauti ilikuwa kubwa sana: \(d=3{,}57\) na \(p=3{,}1\times10^{-115}\).
Katika mabadiliko ya kimuktadha, ICL ilifikia mean accuracy ya 0,641 huku IS ikibaki 0,561. Effect size iliripotiwa kuwa \(d=-0{,}99\), na corrected significance value ilikuwa \(p=2{,}9\times10^{-31}\). Effect size hasi inaonyesha tofauti inayopendelea ICL.
Katika simulation ya kiwango cha roboti yenye dimensions 19, ubora wa kimuundo uliongezeka zaidi; IS ilionyesha accuracy ya 0,822 na ICL 0,514. Katika hali ya kimuktadha, ICL ilipata accuracy ya 0,623 na IS 0,548.
Katika data ya roboti halisi, kwa hali ya kimuundo IS ilifikia mean accuracy ya 0,794 na ICL 0,613. Matokeo ya paired test yaliripotiwa kuwa \(t(79)=5{,}22\), \(p=1{,}42\times10^{-6}\), \(d=0{,}587\). Huu ni ubora wa IS wa ukubwa wa kati na wenye umuhimu.
Katika hali ya kimuktadha ya data halisi, ICL ilionyesha accuracy ya 0,675 na IS 0,609. Ingawa mwelekeo ulikuwa kwa upande wa ICL, tofauti haikuwa muhimu: \(t(79)=-1{,}58\), \(p=0{,}117\), \(d=-0{,}178\).
Kudhoofika kwa matokeo ya kimuktadha ya roboti halisi kulielezwaje?
Watafiti wanapendekeza sababu tatu:
- Katika jaribio la roboti halisi, idadi ya muktadha ilikuwa \(k=8\), wakati katika jaribio la msingi la sanisi ilikuwa \(k=24\). Mifano michache hutoa taarifa chache kwa ICL kutatua mapping mpya.
- Pembe za joints, nafasi ya end-effector na relative object positions zina uhusiano wa kinematics. Correlation inaweza kupunguza kiasi cha taarifa huru kinachobebwa na kila mfano wa muktadha.
- Z-score normalization iliyotumiwa kusawazisha scales za radian na mita inaweza kubana separation kati ya madarasa.
Katika separate synthetic control ambapo ukubwa wa muktadha ulipunguzwa hadi nane, contextual effect size ya ICL ilishuka kutoka \(-0{,}99\) hadi \(-0{,}41\), lakini iliendelea kuwa muhimu. Matokeo haya yanaunga mkono athari ya idadi ya muktadha. Kupungua zaidi katika data halisi kulihusishwa na sensor noise, correlation na normalization.
Wakala mseto ulionyesha nini?
Class logits za IS na ICL ziliunganishwa kwa kanuni hii:
\[ \hat{y}=\arg\max_c[\alpha\,\ell_{IS}(c)+(1-\alpha)\,\ell_{ICL}(c)] \]
\(\alpha=1\) inamaanisha IS safi, na \(\alpha=0\) ICL safi. Katika Kielelezo 12 kwenye ukurasa wa 15, accuracy inaongezeka kadiri \(\alpha\) inavyoongezeka chini ya mabadiliko ya kimuundo, lakini hupungua katika mabadiliko ya kimuktadha. Gating network ndogo inayotabiri \(\alpha\) kutoka kwa takwimu za support set ilichagua weights karibu na IS safi au ICL safi kulingana na aina ya episode.
Matokeo haya yanaonyesha kwamba mchanganyiko mmoja usiobadilika si bora katika hali zote. Roboti inahitaji kwanza kutathmini ikiwa mabadiliko ni ya kudumu na ya kimuundo au ya muda na ya kimuktadha.
Usanifu wa utambuzi wa tabaka tatu uliundwaje?
Kielelezo 17 katika ukurasa wa 22 kinaonyesha usanifu wa kimawazo uliopendekezwa na watafiti lakini ambao haukutekelezwa end-to-end:
- Structural World Model: Hujifunza representation iliyofichika \(z_t\) kutoka kwa picha za RGB-D, joint position, force-torque na hali ya mazingira. Kwa slow meta-updates hukusanya dynamics za mazingira, object affordances na mahusiano ya kudumu.
- Contextual Reasoning Module: Vision-language transformer iliyogandishwa hutumia structural prefix \(z_t\) na muktadha wa sasa kutafsiri maagizo mapya, mapendeleo ya mtumiaji na mifano ya kazi bila parameter update.
- Decision and Control Module: Huunganisha structural na contextual policies kwa learned gate \(\alpha_t\).
Combined policy inaelezwa kimawazo kama:
\[ \pi(a_t\mid s_t,C_t)=\int\pi_{\theta}(a_t\mid s_t,z_t)\,q(z_t\mid D)\,q(\phi\mid C_t)\,dz_t\,d\phi \]
IS hufanya kazi kama long-term memory, huku ICL ikifanya kazi kama working memory. Hata hivyo, mfumo huu wa tabaka tatu haukutekelezwa na kulinganishwa end-to-end kwenye roboti halisi katika utafiti; ni pendekezo la usanifu lililotokana na findings za majaribio.
Matokeo yanayoungwa mkono na utafiti
- Katika majaribio yaliyodhibitiwa yenye muundo wa pamoja unaojirudia wa kazi, IS inayotegemea MAML ilikuwa na mafanikio makubwa zaidi kuliko transformer inayotegemea muktadha.
- Katika hali sanisi ambapo task mapping hubadilika kabisa katika kila episode, ICL ilikuwa bora kuliko IS.
- Mafanikio ya ICL huongezeka kadiri idadi ya mifano ya muktadha inavyoongezeka.
- Ubora wa kimuundo wa IS ulihamishwa kutoka data sanisi ya dimensions 12 kwenda data ya kiwango cha roboti ya dimensions 19 na data halisi ya proprioceptive ya dimensions 21.
- Katika jaribio la nonlinear classification pia, mwelekeo wa ubora ulidumishwa.
- Katika random initializations tano tofauti, mwelekeo wa effects za sanisi za kimuundo na kimuktadha ulibaki thabiti.
- Learned gating network iliweza kuchagua weights tofauti za IS-ICL katika hali za kimuundo na kimuktadha.
Matokeo ambayo utafiti haujathibitisha
- Mfumo uliopendekezwa haujaonyesha mafanikio ya closed-loop grasping, placing au kufikia lengo kwenye roboti halisi.
- Haijathibitishwa kwamba synthetic linear class labels zinawakilisha ugumu wote wa natural robotic tasks.
- Ubora wa kimuktadha wa ICL katika data ya roboti halisi haujathibitishwa kitakwimu.
- Matokeo hayawakilishi tabia ya algorithimu zote za IS au ICL; MAML pekee na transformer ndogo yenye takriban vigezo 415-417 elfu ndizo zilizolinganishwa.
- Usanifu mseto wa utambuzi wa tabaka tatu haukutekelezwa end-to-end wala kujaribiwa kwenye roboti halisi.
- Dhana za strongly convex na zinazofanana katika mipaka ya kinadharia hazijathibitishwa kikamilifu katika mifumo halisi, nonlinear ya roboti.
- Utafiti hauthibitishi kwamba mifumo ya ICL katika kiwango cha large language model itaonyesha effect sizes zilezile.
- Long-term online learning, usalama, catastrophic forgetting na gharama ya computation hazikupimwa moja kwa moja.
Mbinu na Matokeo ya Utafiti
Usanifu wa mawakala na hali za mafunzo
| Kipengele | Muundo na mafunzo | Urekebishaji wakati wa tathmini |
|---|---|---|
| Wakala wa IS | ReLU MLP ya tabaka mbili yenye units 64-64; first-order MAML; episodes 1.500 za meta-training | Hatua 5 za inner-loop gradient kwenye support set; inner learning rate 0,05 |
| Wakala wa ICL | Tabaka 2 za transformer, attention heads 4, \(d_{model}=128\); pretraining katika kazi 50.000 za random | Vigezo vinagandishwa; mifano ya support hutumiwa kama context tokens |
| Hybrid gate | MLP ndogo inayopokea mean, variance na class entropy ya support set; mafunzo katika episodes 500 mseto | Hutoa mixing coefficient \(0\leq\alpha\leq1\) kwa kila episode |
Outer loop ya wakala wa IS ilifundishwa kwa Adam na learning rate 0,003, huku wakala wa ICL akifundishwa kwa Adam na learning rate \(10^{-3}\). Kazi za msingi za sanisi zilikuwa na input ya dimensions 12, madarasa manne, mifano 24 ya support na mifano 120 ya query.
Upeo wa majaribio kumi na mawili
| Jaribio | Swali la utafiti | Matokeo kuu |
|---|---|---|
| 1. Ulinganisho wa msingi | Je, IS na ICL hutofautiana katika aina tofauti za mabadiliko? | IS bora katika kimuundo, ICL bora katika kimuktadha |
| 2. Ukubwa wa mabadiliko | Je, ubora unadumu structural noise inapoongezeka? | IS ilidumisha accuracy ya juu zaidi |
| 3. Context scaling | Idadi ya mifano ya muktadha inaathirije ICL? | Accuracy ya ICL iliongezeka kwa mfululizo pamoja na muktadha |
| 4. Ugumu wa kazi | Nini hutokea idadi ya madarasa na features inapoongezeka? | Faida ya IS iliongezeka katika hali ya kimuundo |
| 5. Ustahimilivu wa noise | Mifumo hutendaje chini ya measurement noise? | Mawakala wote walidhoofika; ubora wao katika hali zinazofaa ulidumishwa |
| 6. Hybrid ablation | Je, matokeo ya IS na ICL yanaweza kuunganishwa? | Learned gate ilichagua uzito unaofaa kulingana na hali |
| 7. Robot-scale simulation | Je, matokeo yanaendelea katika uchunguzi wa roboti wa dimensions 19? | Mielekeo yote miwili ya ubora ilidumishwa |
| 8. Data ya roboti halisi | Je, sensor noise na correlation halisi huharibu tofauti? | Ubora wa kimuundo wa IS ni muhimu; mwelekeo wa kimuktadha wa ICL si muhimu |
| 9. \(k=8\) control | Je, muktadha mdogo wa jaribio halisi unaeleza athari? | Contextual effect size ya ICL ilipungua pia katika data sanisi |
| 10. Nonlinear task | Je, ukamilishano ni maalum kwa mipaka ya linear? | Mielekeo ya effect ilidumishwa katika kazi nonlinear |
| 11. Alternative methods | Je, classifiers rahisi hutoa matokeo sawa? | IS bora katika kimuundo; Ridge karibu na ICL katika kimuktadha |
| 12. Multi-seed | Je, matokeo yanategemea random initialization? | Mielekeo na ukubwa wa effect thabiti katika seeds tano |
Matokeo makuu ya nambari
| Jaribio na hali | Accuracy ya IS | Accuracy ya ICL | Thamani ya Cohen \(d\) | Tafsiri |
|---|---|---|---|---|
| Sanisi ya msingi — kimuundo | 0,795 | 0,578 | +3,57 | Ubora mkubwa sana wa IS |
| Sanisi ya msingi — kimuktadha | 0,561 | 0,641 | -0,99 | Ubora mkubwa wa ICL |
| Robot-scale — kimuundo | 0,822 | 0,514 | +5,18 | Ubora mkubwa sana wa IS |
| Robot-scale — kimuktadha | 0,548 | 0,623 | -0,96 | Ubora mkubwa wa ICL |
| Roboti halisi pilot — kimuundo | 0,733 | 0,640 | +0,47 | Kwa upande wa IS; \(p=0{,}032\) |
| Roboti halisi full — kimuundo | 0,794 | 0,613 | +0,587 | Kwa upande wa IS; \(p=1{,}42\times10^{-6}\) |
| Roboti halisi full — kimuktadha | 0,609 | 0,675 | -0,178 | Mwelekeo wa ICL unadumishwa; \(p=0{,}117\) |
| Nonlinear — kimuundo | 0,694 | 0,528 | +2,52 | Ubora wa IS unaendelea katika kazi nonlinear |
| Nonlinear — kimuktadha | 0,583 | 0,619 | -0,58 | Ubora wa ICL unaendelea katika kazi nonlinear |
Ulinganisho na mbinu mbadala
| Mbinu | Structural accuracy | Contextual accuracy |
|---|---|---|
| IS — MAML | 0,793 | 0,547 |
| ICL — Transformer | 0,579 | 0,628 |
| Ridge regression | 0,603 | 0,638 |
| \(k\)-nearest neighbor | 0,483 | 0,556 |
| MLP inayofundishwa kutoka sifuri katika kila episode | 0,424 | 0,529 |
Ni muhimu kwamba Ridge regression ilionyesha accuracy iliyo juu kidogo kuliko ICL katika linear contextual task. Matokeo haya yanaonyesha kwamba ubora wa kimuktadha wa ICL haumaanishi kuwa ndiyo classifier bora katika kila hali. Ulinganisho mkuu wa utafiti ni tofauti ya utaratibu kati ya parameter learning across episodes na contextual inference within an episode.
Multi-seed na uchambuzi wa kitakwimu
Katika random initializations tano, mean Cohen’s \(d\) ya kimuundo iliripotiwa kuwa \(3{,}65\pm0{,}24\), na ya kimuktadha \(-0{,}99\pm0{,}05\). Katika ulinganisho wa msingi, paired t-tests katika episodes 200 kwa kila hali, bootstrap asilimia 95 confidence intervals yenye resamples 10.000 na Bonferroni correction zilitumika.
Katika jaribio kamili la roboti halisi, maandishi makuu na Jedwali 5 yanaeleza wazi kwamba evaluation episodes 80 za kipekee zilitumika. Hata hivyo, Kielelezo 14 katika ukurasa wa 19 kinaonyesha evaluation episodes 300 zilizoresampled na thamani tofauti za accuracy. Kielelezo hiki na maandishi makuu haviwakilishi toleo lilelile la jaribio; wakati wa kutafsiri matokeo, episodes 80 za kipekee katika maandishi makuu zinapaswa kutumika kama msingi.
Nguvu za utafiti
- Unalinganisha IS na ICL kwa njia iliyodhibitiwa kwa kutumia data zilezile za support na query.
- Unatenganisha wazi kimahesabu mabadiliko ya kimuundo na kimuktadha.
- Unafanya controls za ziada kwa ukubwa wa muktadha, noise, ugumu wa kazi, nonlinear boundaries na random initializations.
- Unaripoti effect size, paired test, confidence interval na multiple-comparison correction.
- Unafanya uthibitishaji wa hatua kwa hatua kutoka data sanisi hadi data ya kihisi ya roboti halisi.
- Katika jaribio la roboti halisi, unatoa support na query episodes zilezile kwa mawakala wote wawili na hivyo kuunda ulinganisho wa haki.
- Unakubali wazi katika matokeo na vikwazo kwamba contextual result katika data halisi si muhimu.
Vikwazo na kutofautiana ndani ya maandishi
- Utafiti ni preprint ambayo haijapitiwa na rika.
- Labels katika data ya roboti halisi zilitolewa kutoka synthetic linear projection, si natural physical task outcome.
- Closed-loop robot motion, kufikia lengo, grasping au placing success havikutathminiwa.
- Tofauti ya ICL katika hali ya kimuktadha ya roboti halisi si muhimu.
- Kauli ya jumla \(p<0{,}001\), \(d>0{,}9\) katika Abstract na Highlights haijumuishi contextual result ya roboti halisi.
- Kielelezo 14 kinaonyesha episodes 300 zilizoresampled kutoka pipeline ya zamani au tofauti, huku maandishi makuu yakiripoti episodes 80 za kipekee.
- Thamani za correlation zimeandikwa kama 0,299 na 0,303 ndani ya maandishi; threshold ya high correlation imeandikwa kwa namna mbili, 0,5 na 0,8.
- Kuna kutofautiana kwa coefficient \(\eta\) kati ya main bound ya Nadharia ya kwanza na error floor katika ushahidi wa ziada.
- Matokeo ya kinadharia yanategemea dhana kali kama strongly convex, smoothness, approximate Bayesian inference na conditional independence.
- IS imewakilishwa na MAML pekee na ICL na transformer ndogo; world model, large language model au Decision Transformer hazijajaribiwa.
- Kazi nyingi ni classification; sequential decision making na partial observability hazijajaribiwa moja kwa moja.
- Usanifu uliopendekezwa wa tabaka tatu ni wa kimawazo na haujathibitishwa end-to-end kwenye roboti.
Maelezo ya Chanzo na Mbinu
Kichwa kamili cha asili cha utafiti: Inferred-Structure and In-Context Learning: A Unified Bayesian Framework for Adaptive Robotic Intelligence in Real-world Settings
Waandishi: Khashayar Ghamati; Abolfazl Zaraki.
Mpangilio wa waandishi: Khashayar Ghamati ni mwandishi wa kwanza, Abolfazl Zaraki ni mwandishi wa pili.
Mwandishi mwenza wa kwanza: Hakuna taarifa ya equal contribution au co-first authorship katika toleo lililochunguzwa.
Mwandishi anayewajibika: Khashayar Ghamati. Alama ya nyota na barua pepe ya mawasiliano katika maandishi zinaonyesha mwandishi anayewajibika.
Uhusiano wa kitaasisi: School of Physics, Engineering and Computer Science (SPECS), Robotics Research Group, University of Hertfordshire, College Lane, Hatfield, AL10 9AB, United Kingdom.
ORCID: Khashayar Ghamati — 0009-0002-6416-3127; Abolfazl Zaraki — 0000-0001-6204-7865.
Jarida: Jina la jarida lililopitiwa na rika halipo katika toleo lililochunguzwa. Footer ina kauli “Preprint submitted to Elsevier” pekee; haijaelezwa ni jarida gani lililotumiwa.
Mchapishaji: Hakuna taarifa iliyokamilika ya mchapishaji wa asili. SSRN ni jukwaa la preprint na halipaswi kuchukuliwa kama mchapishaji wa mwisho wa jarida.
Jukwaa la uchapishaji: SSRN.
Mwaka wa uchapishaji: 2026.
Aina ya chanzo: Preprint ya utafiti wa uhandisi inayojumuisha theoretical modelling, controlled synthetic experiments, robot-scale data analysis na real proprioceptive robot data.
Hali ya mapitio ya rika: Utafiti huu ni preprint na haujapitiwa na rika. Matokeo yanapaswa kusomwa kwa kuzingatia kikomo hiki.
Chanzo rasmi:Rekodi rasmi ya utafiti wa SSRN.
Maelezo ya toleo: Rekodi ya zamani ya SSRN yenye nambari 6487278 pia imeorodheshwa kwa kichwa kilekile. Toleo lililochunguzwa linaelekeza wazi kwenye rekodi 7193870; uhusiano kati ya rekodi hizi mbili haujaelezwa katika maandishi.
Tamko la data na msimbo: Watafiti wanaeleza kwamba nyenzo za ziada, source code, trained models na experiment data zinapatikana kwenye ukurasa wa mradi wa utafiti. Tamko hili lipo katika preprint iliyochunguzwa; upatikanaji kamili wa faili zote haukuthibitishwa kando kiufundi wakati makala hii iliandaliwa.
Maelezo haya ya Kituruki yaliandaliwa baada ya kuchunguza maandishi ya utafiti wa kurasa 27, expressions za kihisabati, majedwali, experiment graphs, picha za roboti na additional theorem proofs. Hakuna matokeo mapya ya jaribio au madai ya mafanikio kutoka nje ya utafiti yaliyoongezwa kwenye maudhui ya kisayansi. Uthibitishaji wa nje ulitumika tu kwa ukaguzi wa bibliografia wa waandishi, taasisi, DOI, rekodi ya SSRN na hali ya uchapishaji.
Sehemu ya roboti halisi ya utafiti inalinganisha mifumo ya kujifunza kwenye physical sensor data; haionyeshi kwamba roboti ilikamilisha closed-loop real reaching, grasping au placing task. Usanifu uliopendekezwa wa tabaka tatu wa IS-ICL pia si final robotic system iliyotekelezwa kwa majaribio, bali ni conceptual design proposal iliyotokana na findings.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *