

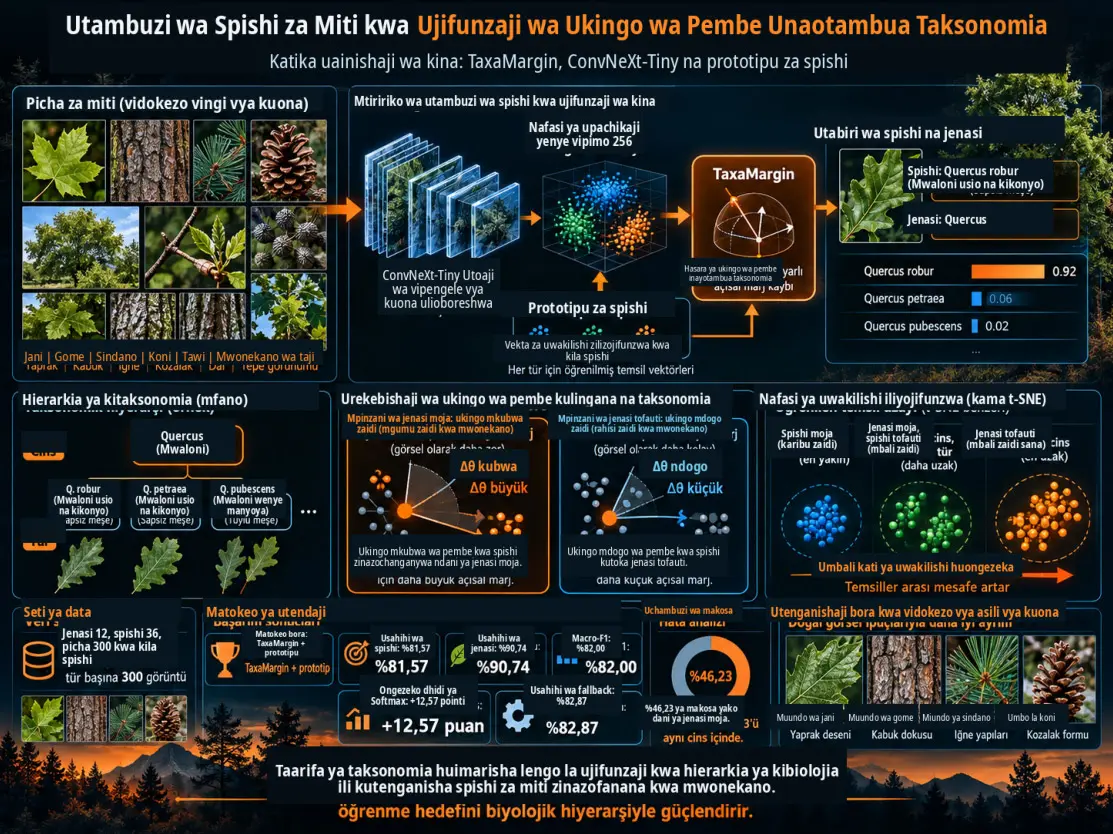
TaxaMargin ni mbinu ya uainishaji wa ujifunzaji wa kina inayoweka taksonomia ya kibiolojia moja kwa moja ndani ya lengo la ujifunzaji wakati wa kutofautisha spishi za miti zinazofanana kwa mwonekano, na kurekebisha uainishaji wa ukingo wa pembe wa mtindo wa ArcFace kulingana na uhusiano wa kitaksonomia. Katika utafiti, seti ya data yenye uwiano ya picha za RGB iliundwa kwa jenasi 12 zenye jumla ya spishi 36 za miti kwa kutumia vyanzo vya GBIF na iNaturalist; uti wa mgongo wa ConvNeXt-Tiny uliokuwa umefunzwa awali kwa ImageNet ulifanyiwa fine-tuning ili kuzalisha vekta za uwakilishi zenye vipimo 256 zilizofanyiwa L2-normalization. TaxaMargin ilitumia ukingo mkubwa zaidi wa pembe pale mpinzani mwenye nguvu zaidi aliyekosewa na picha alipokuwa wa jenasi ileile na spishi sahihi; prototipu za wastani unaosogea katika kiwango cha spishi ziliendelea kupanga nafasi ya uwakilishi. Mfumo kamili wa TaxaMargin + prototipu ulipata usahihi wa spishi wa %81,57, usahihi wa jenasi wa %90,74 na macro-F1 ya %82,00; ukiongeza vipimo hivi kwa pointi za asilimia 12,57, 11,74 na 15,20 mtawalia ikilinganishwa na usanidi wa kawaida wa softmax.
Wazo kuu la utafiti ni kwamba si makosa yote katika uainishaji wa kibiolojia yana maana sawa. Kuchanganya spishi moja ya mwaloni na spishi nyingine ya mwaloni ni kosa lililo karibu zaidi kitaksonomia kuliko kuichanganya na spishi kutoka jenasi tofauti kabisa. TaxaMargin hutumia taarifa hii ya kihierarkia wakati wa mafunzo ili kulenga utenganishaji wenye nguvu zaidi katika nafasi ya uwakilishi hasa kati ya spishi za jenasi moja ambazo pia zinafanana kwa mwonekano.
Matokeo yanaonyesha kuwa mbinu hiyo iliboresha uainishaji katika viwango vya spishi na jenasi katika seti ya data iliyochunguzwa. Hata hivyo, utafiti unategemea mgawanyo wa mafunzo/uthibitishaji/majaribio wa seti moja tu ya data yenye uwiano; matokeo haya hayamaanishi kwamba utendaji uleule umehakikishwa kwa spishi zote za miti, maeneo yote ya kijiografia au matumizi halisi ya shambani. Zaidi ya hayo, uhakika wa modeli hauendani kila wakati na usahihi, na chanzo pia kimeripoti uainishaji usio sahihi uliofanywa kwa uhakika wa juu.
Kwa nini ni vigumu kutofautisha spishi za miti kutoka kwenye picha?
Utambuzi wa spishi za miti ni muhimu kwa ufuatiliaji wa bioanuwai, utafiti wa ikolojia, usimamizi wa misitu, upangaji wa uhifadhi na tathmini ya miti ya mijini. Hata hivyo, picha moja ya RGB iliyopatikana shambani inaweza isionyeshe kwa wakati mmoja miundo yote inayohitajika kwa utambuzi wa kibotania. Picha inaweza kuonyesha tu jani, gome la shina, tawi, ua, tunda, koni au mwonekano wa taji.
Spishi ileile inaweza kuonekana tofauti sana kulingana na umri, msimu, hatua ya ukuaji, hali ya afya, mwanga, pembe ya kamera na mazingira. Kinyume chake, spishi za karibu zilizo ndani ya jenasi moja zinaweza kufanana sana katika umbo la jani, muundo wa gome au namna ya matawi. Hivyo, changamoto mbili hutokea kwa wakati mmoja: tofauti za mwonekano ndani ya spishi zinaweza kuwa kubwa huku tofauti kati ya spishi zikiwa ndogo sana.
Kwa Nini Ujifunzaji Unaotambua Taksonomia Unatumika?
Ujifunzaji unaotambua taksonomia huingiza uhusiano wa spishi–jenasi katika tatizo la ujifunzaji badala ya kuzichukulia spishi kama madarasa yaliyo huru kabisa; katika utafiti huu, ukingo mkubwa zaidi wa pembe ulitumika kwa spishi pinzani ngumu za jenasi ileile ili kuiwekea modeli shinikizo kubwa zaidi la kutenganisha tofauti ndogo zaidi za kibiolojia.
Uundaji wa seti ya data
Picha zilikusanywa hasa kutoka majukwaa ya GBIF na iNaturalist. Faili zilizoharibika, picha zilizorudiwa na sampuli zisizokuwa na taarifa ya kutosha ya kuona ziliondolewa. Kisha, kwa kila spishi, picha 300 zilichaguliwa kwa idadi ya kudumu na usawa wa idadi ya madarasa ukahakikishwa.
Seti ya mwisho ya data ina muundo wa jenasi 12 × spishi 3 katika kila jenasi = spishi 36.
| Jenasi | Spishi zilizojumuishwa katika utafiti |
|---|---|
| Abies | Abies alba, Abies concolor, Abies nordmanniana |
| Acer | Acer campestre, Acer platanoides, Acer pseudoplatanus |
| Betula | Betula nana, Betula pendula, Betula pubescens |
| Fraxinus | Fraxinus angustifolia, Fraxinus excelsior, Fraxinus ornus |
| Juniperus | Juniperus communis, Juniperus oxycedrus, Juniperus sabina |
| Picea | Picea abies, Picea pungens, Picea sitchensis |
| Pinus | Pinus mugo, Pinus nigra, Pinus sylvestris |
| Populus | Populus alba, Populus nigra, Populus tremula |
| Quercus | Quercus cerris, Quercus petraea, Quercus robur |
| Salix | Salix alba, Salix caprea, Salix fragilis |
| Tilia | Tilia cordata, Tilia platyphyllos, Tilia tomentosa |
| Ulmus | Ulmus glabra, Ulmus laevis, Ulmus minor |
Kila picha ina lebo ya spishi na lebo ya jenasi. Lengo kuu ni uainishaji wa spishi; lebo ya jenasi hutumiwa kuunda ukingo wa kitaksonomia na kupima utendaji katika kiwango cha jenasi. Data iligawanywa kwa nasibu katika sehemu ndogo za %70 mafunzo, %20 uthibitishaji na %10 majaribio.
Uchakataji wa awali wa picha na uongezaji wa data
Picha zote zilibadilishwa kuwa ukubwa wa pikseli 320 × 320 kabla ya kuingizwa kwenye modeli. Katika hatua ya mafunzo, operesheni za uongezaji wa data kwa nasibu zilitumika ili kuifanya modeli iwe thabiti zaidi dhidi ya mabadiliko katika picha za shambani.
| Operesheni | Mpangilio uliotolewa katika chanzo |
|---|---|
| Random resized crop | Kiwango 0,65–1,0 |
| Kugeuza kwa mlalo | Uwezekano 0,5 |
| Kugeuza kwa wima | Uwezekano 0,15 |
| Kuzungusha | Hadi ±20 digrii |
| Mabadiliko ya rangi | Mabadiliko ya mwangaza, utofautishaji, ushiba na toni |
| Kuweka katika kijivu | Kwa uwezekano mdogo |
| Random erasing | Kwa uwezekano mdogo |
| Normalization | Kwa thamani za mafunzo ya awali ya ImageNet |
Katika hatua za uthibitishaji na majaribio, uongezaji wa data kwa nasibu haukutumika na uchakataji wa awali wa kideterministiki ulitumika. Hivyo, ilizuiwa matokeo ya tathmini kuathiriwa na mabadiliko ya picha ya nasibu.
Kichimbaji cha vipengele cha ConvNeXt-Tiny
Kwa uchimbaji wa vipengele vya picha, ConvNeXt-Tiny iliyofunzwa awali kwa ImageNet ilitumika. Modeli ilitekelezwa kupitia maktaba ya timm PyTorch na kufunzwa upya kwenye seti ya data ya spishi za miti.
Safu ya awali ya uainishaji ya ConvNeXt-Tiny iliondolewa na kubadilishwa na kichwa kipya cha projection chenye safu zilizounganishwa kikamilifu, uamilishaji wa GELU na dropout. Kichwa hiki hubadilisha kila picha kuwa vekta ya vipengele yenye vipimo 256.
Vekta ya vipengele kisha hunormalishwa kwa norma ya L2 na kuwakilishwa kwenye hipersfera ya kitengo.
Mlinganyo (1):
\[ z_i=\frac{u_i}{\|u_i\|_2}, \qquad \bar{w}_k=\frac{w_k}{\|w_k\|_2}, \qquad c_{ik}=z_i^{\top}\bar{w}_k=\cos(\theta_{ik}) \]
Hapa \(u_i\) inaonyesha vekta ghafi ya vipengele yenye vipimo 256 kwa picha \(i\); \(z_i\) uwakilishi wa picha ulionormalishwa; \(w_k\) uzani wa kiainishaji kwa spishi \(k\); na \(c_{ik}\) ufanano wa kosini kati ya picha na uwakilishi wa darasa. Kigezo cha kiwango cha logit za uainishaji kimetolewa katika chanzo kama \(s=30,0\).
TaxaMargin ni Nini na Inatofautianaje na ArcFace?
TaxaMargin ni kichwa cha uainishaji kinachodumisha kanuni ya ukingo wa pembe wa ArcFace katika nafasi ya uwakilishi iliyonormalishwa, lakini badala ya kuweka ukingo kuwa thabiti, hubadilisha ukingo kulingana na kama mpinzani mwenye nguvu zaidi asiye sahihi yuko katika jenasi ileile na spishi sahihi au la; ukingo wa 0,30 hutumiwa kwa mpinzani wa jenasi ileile na ukingo wa 0,18 kwa mpinzani wa jenasi tofauti.
Kupata darasa lisilo sahihi lililo gumu zaidi
Katika kila sampuli ya mafunzo, kwanza hutafutwa mpinzani anayefanana zaidi na uwakilishi wa picha miongoni mwa spishi zisizo darasa sahihi. Maandishi ya chanzo yanafafanua hili kama “spishi isiyo sahihi yenye ufanano wa kosini wa juu zaidi”.
Dokezo la Chanzo kuhusu Mlinganyo (2): Katika upangaji wa kihisabati wa PDF, opereta ya uteuzi inaonekana kukosekana. Kwa hiyo, alama inayokosekana haikamilishwi kwa niaba ya chanzo. Ufafanuzi wa kialgorithimu unaotumiwa ni kuchagua spishi yenye ufanano wa kosini wa juu zaidi miongoni mwa spishi zote isipokuwa spishi sahihi kama hasi iliyo gumu zaidi.
Uteuzi huu ulitekelezwa wakati wa mafunzo kama operesheni isiyobeba gradient.
Uteuzi wa ukingo wa kitaksonomia
Mlinganyo (3):
\[ m_i= \begin{cases} m_{\mathrm{intra}}, & g(h_i)=g(y_i)\\ m_{\mathrm{inter}}, & g(h_i)\neq g(y_i) \end{cases} \]
Hapa \(g(\cdot)\) inaonyesha jenasi ambayo spishi inahusiana nayo; \(h_i\) mpinzani asiye sahihi aliye gumu zaidi; na \(y_i\) spishi sahihi.
Thamani zilizotumiwa katika chanzo:
\[ m_{\mathrm{intra}}=0,30, \qquad m_{\mathrm{inter}}=0,18 \]
Yaani, ikiwa mpinzani mwenye nguvu zaidi wa modeli yuko katika jenasi ileile na spishi sahihi, ukingo mkubwa zaidi hutumika. Lengo ni kujifunza utenganishaji wenye nguvu zaidi, kwa mfano, kati ya spishi mbili zilizo karibu za Salix au spishi mbili zilizo karibu za Ulmus.
Kufungua ukingo hatua kwa hatua katika epoch tatu za kwanza
Mlinganyo (4):
\[ m_i^{(e)}=\alpha_e m_i, \qquad \alpha_e=\min\left(1,\frac{e}{E_m}\right), \qquad E_m=3 \]
Katika epoch ya kwanza, theluthi moja ya ukingo lengwa hutumika; katika epoch ya pili, theluthi mbili; na kuanzia epoch ya tatu, ukingo wote hutumika. Warm-up hii ilitumika ili optimishaji uende kwa uthabiti zaidi katika hatua za mwanzo za mafunzo.
Mabadiliko ya pembe ya darasa sahihi
Mlinganyo (5):
\[ \phi_i= \cos\left(\theta_{iy_i}+m_i^{(e)}\right) = c_{iy_i}\cos\left(m_i^{(e)}\right) - \sqrt{1-c_{iy_i}^{2}} \sin\left(m_i^{(e)}\right) \]
Operesheni hii hubadilisha tu thamani ya kosini ya darasa sahihi. Kwa kufanya iwe vigumu zaidi kufikia eneo la uamuzi la darasa sahihi, uwakilishi huhimizwa kuoanika kwa nguvu zaidi na kituo cha darasa lake na kujitenga kwa uwazi zaidi na wapinzani.
Mlinganyo (6):
\[ \ell_{ik}^{TM}= \begin{cases} s\phi_i, & k=y_i\\ s c_{ik}, & k\neq y_i \end{cases}, \qquad s=30,0 \]
Mabadiliko ya TaxaMargin hutumika tu wakati wa mafunzo; kwa sababu kuhesabu ukingo kunahitaji lebo halisi ya spishi. Wakati wa uthibitishaji na majaribio, logit za kosini zilizonormalishwa hutumika. Kwa hivyo, jukumu la TaxaMargin si kutumia kanuni mpya ya uamuzi wakati wa inference, bali kuunda jiometri ya nafasi ya uwakilishi wakati wa mafunzo.
Ujifunzaji wa prototipu ya spishi
Utafiti pia huhifadhi vekta ya prototipu kwa kila spishi. Prototipu ni kituo cha rejea kinachosogea cha spishi husika katika nafasi ya uwakilishi iliyojifunzwa. Lengo ni kupanga uwakilishi unaotokana na majani, magome, matawi au mwonekano mbalimbali wa mazingira wa spishi ileile karibu na muundo thabiti zaidi wa darasa.
Katika usasishaji wa prototipu, momentum ya wastani unaosogea wa eksponensheli:
\[ \mu=0,90 \]
ilitumika.
Usasishaji wa prototipu unaodhibitiwa na uhakika
Si kila picha inaruhusiwa kusasisha prototipu. Baada ya hatua ya optimishaji, upitishaji wa pili wa mbele hufanywa bila kutumia ukingo wa pembe na uwezekano uliotolewa kwa spishi sahihi huhesabiwa.
Mlinganyo (7):
\[ q_i= \left[ \operatorname{softmax} \left(\ell_i^{F,0}\right) \right]_{y_i} \]
Usasishaji hufanywa tu ikiwa:
\[ q_i\ge\tau_p, \qquad \tau_p=0,35 \]
Hapa \(q_i\) si uwezekano wa juu zaidi ambao modeli imetoa kwa darasa lolote, bali hasa uwezekano uliotolewa kwa spishi halisi.
Mlinganyo (8):
\[ p_c^{new}= \begin{cases} z_i, & \text{prototip henüz başlatılmamışsa}\\[4pt] \dfrac{\mu p_c^{old}+(1-\mu)z_i} {\|\mu p_c^{old}+(1-\mu)z_i\|_2}, & \text{diğer durumda} \end{cases} \]
\[ \mu=0,90 \]
Kwa sababu ya normalization, prototipu pia hubaki kwenye hipersfera ileile ya kitengo pamoja na uwakilishi wa picha na uzani wa kiainishaji.
Logit za ufanano wa prototipu
Mlinganyo (9):
\[ \ell_{ik}^{P} = s z_i^{\top}\bar{p}_k, \qquad \bar{p}_k= \frac{p_k}{\|p_k\|_2}, \qquad s=30,0 \]
Hivyo, tawi la prototipu huzalisha ishara ya pili ya utabiri kutoka kwenye ufanano wa pembe/kosini wa picha na kila prototipu ya spishi.
Katika uthibitishaji, majaribio na hesabu ya uhakika wa prototipu, logit za kiainishaji na prototipu huunganishwa:
Mlinganyo (10):
\[ \ell_{ik}^{F} = \ell_{ik}^{C} + \lambda_p\ell_{ik}^{P}, \qquad \lambda_p=0,10 \]
Hapa \(\ell_{ik}^{C}=s c_{ik}\) ni logit ya kiainishaji cha kosini isiyo na ukingo.
Warm-up ya hasara ya prototipu
Mlinganyo (11):
\[ \beta_e= \min\left(1,\frac{e}{E_p}\right), \qquad E_p=3 \]
Mlinganyo (12):
\[ \mathcal{L} = \mathcal{L}_{TM} + \beta_e\lambda_p\mathcal{L}_{P}, \qquad \lambda_p=0,10 \]
\(\mathcal{L}_{TM}\) inaonyesha hasara ya cross-entropy iliyohesabiwa kutoka logit za TaxaMargin; \(\mathcal{L}_{P}\) inaonyesha hasara ya ziada ya cross-entropy iliyohesabiwa kutoka logit za prototipu ya spishi.
Mbinu hizi mbili zina majukumu tofauti: TaxaMargin huongeza utenganishaji kati ya madarasa ya spishi tofauti, hasa wapinzani wagumu wa jenasi ileile; huku ujifunzaji wa prototipu ukisaidia mpangilio na mshikamano ndani ya darasa wa picha tofauti za spishi ileile.
Mkakati wa mafunzo
| Mpangilio | Thamani ya chanzo |
|---|---|
| Optimizer | AdamW |
| Weight decay | 0,05 |
| Kiwango cha ujifunzaji cha ConvNeXt-Tiny | 1,5 × 10⁻⁴ |
| Kiwango cha ujifunzaji cha projection + kiainishaji | 1,5 × 10⁻³ |
| Ratiba ya kiwango cha ujifunzaji | Cosine annealing |
| Epoch ya juu zaidi | 30 |
| Early stopping | Ikiwa usahihi wa uthibitishaji hauboreki kwa epoch 7 |
| Gradient clipping | Norma ya juu zaidi 1,0 |
| Kipengele cha oversampling cha darasa gumu | 1,8 |
| Momentum ya prototipu | 0,90 |
| Kizingiti cha uhakika wa prototipu | 0,35 |
| Kiwango cha angular logit | 30,0 |
| Ukingo wa intra-genus wa TaxaMargin | 0,30 |
| Ukingo wa inter-genus wa TaxaMargin | 0,18 |
Weighted random sampler ilitumika katika mini-batch za mafunzo ili kuongeza uwakilishi wa mara kwa mara wa spishi. Spishi zilizotambuliwa kuwa ngumu katika uchunguzi wa awali zilifanyiwa oversampling lengwa kwa kipengele cha 1,8 katika seti ya mafunzo pekee. Seti za uthibitishaji na majaribio hazikuathiriwa na mkakati huu wa sampuli.
Itifaki ya tathmini
Utendaji haukupimwa kwa usahihi wa jumla pekee. Usahihi wa spishi, usahihi wa jenasi, macro precision, macro recall, macro-F1, weighted precision/recall/F1, alama za kila spishi na wastani wa F1 kwa jenasi zilihesabiwa.
Pia usanidi tano unaodhibitiwa ulilinganishwa:
- Softmax ya kawaida
- ArcFace
- ArcFace + prototipu ya spishi
- TaxaMargin
- TaxaMargin + prototipu ya spishi
Usanidi wote ulitumia mgawanyo uleule wa data, uti wa mgongo, itifaki ya mafunzo na vipimo vya tathmini; hivyo, ulinganisho wa ablation ulitengenezwa kuchunguza moja kwa moja mchango wa vipengele vikuu.
Uchanganuzi wa kitaksonomia wa nafasi ya uwakilishi
Umbali wa kosini kati ya uwakilishi wa majaribio wenye vipimo 256 uliyonormalishwa uligawanywa katika makundi matatu:
- Picha mbili za spishi ileile
- Spishi mbili tofauti ndani ya jenasi ileile
- Picha za jenasi tofauti
Pia, centroid ilihesabiwa kwa spishi 36 na taswira ya pande mbili ya Multidimensional Scaling (MDS) iliundwa kutoka umbali wa kosini kati ya centroid hizo. MDS ilitumika kwa ukaguzi wa kuona pekee; ulinganisho wa umbali wa kiasi ulifanywa katika nafasi ya asili ya uwakilishi yenye vipimo vingi.
Mbinu na Matokeo ya Utafiti
Matokeo ya ablation
| Usanidi | Usahihi wa spishi (%) | Usahihi wa jenasi (%) | Macro-F1 (%) |
|---|---|---|---|
| Softmax | 69,00 | 79,00 | 66,80 |
| ArcFace | 74,36 | 83,15 | 73,12 |
| ArcFace + prototipu | 74,94 | 84,83 | 74,05 |
| TaxaMargin | 78,89 | 87,96 | 78,71 |
| TaxaMargin + prototipu | 81,57 | 90,74 | 82,00 |
Jedwali hili linaonyesha mambo mawili tofauti. Kwanza, ArcFace ya kawaida ilitoa uboreshaji dhahiri juu ya softmax. Pili, kuongezwa kwa ukingo wa kitaksonomia kulileta faida ya ziada juu ya ArcFace. Ingawa ongezeko lililotolewa na ujifunzaji wa prototipu lilikuwa dogo lilipoongezwa kwa ArcFace, faida kubwa zaidi ya kukamilishana ilionekana ilipounganishwa na TaxaMargin.
Tofauti ya usanidi kamili dhidi ya softmax:
| Kipimo | Softmax | TaxaMargin + prototipu | Ongezeko |
|---|---|---|---|
| Usahihi wa spishi | %69,00 | %81,57 | +12,57 pointi za asilimia |
| Usahihi wa jenasi | %79,00 | %90,74 | +11,74 pointi za asilimia |
| Macro-F1 | %66,80 | %82,00 | +15,20 pointi za asilimia |
Utendaji katika kiwango cha spishi na jenasi
Thamani zote za macro na weighted precision, recall na F1 ziko karibu na kiwango cha 0,82. Kwa baadhi ya spishi utendaji ni wa juu sana: F1 ya Abies concolor ni 1,00; kwa Tilia tomentosa na Juniperus sabina imeripotiwa kuwa 0,95.
Wastani wa juu zaidi wa F1 kwa jenasi ni Juniperus: 0,89; ukifuatiwa na Pinus: 0,85, Quercus: 0,84 na Abies: 0,83. Wastani wa chini zaidi umeonekana kwa Tilia: 0,78 na Ulmus: 0,78.
Chanzo kinasema kwamba baadhi ya spishi kama Populus tremula, Betula pubescens na Tilia cordata zilikuwa ngumu zaidi kuainisha.
Je, Nafasi ya Uwakilishi Iliyojifunzwa Inaonyesha Kweli Muundo wa Kitaksonomia?
Ndiyo, katika data ya majaribio iliyochunguzwa, umbali wa wastani wa kosini huongezeka kutoka 0,214 kwa picha za spishi ileile, hadi 0,645 kwa spishi tofauti za jenasi ileile, na 0,763 kwa jenasi tofauti; hata hivyo, kuingiliana kwa sehemu kwa baadhi ya jenasi katika taswira ya MDS kunaonyesha kuwa utenganishaji wa kitaksonomia si kamili katika makundi yote.
| Uhusiano wa kitaksonomia | Umbali wa wastani wa kosini | Mediani |
|---|---|---|
| Spishi ileile | 0,214 | 0,048 |
| Jenasi ileile, spishi tofauti | 0,645 | 0,694 |
| Jenasi tofauti | 0,763 | 0,755 |
Mpangilio huu unaonyesha kwamba uwakilishi wa spishi ileile uko karibu zaidi; spishi ndani ya jenasi ileile zimetenganishwa kwa kiwango cha kati; na jenasi tofauti kwa wastani ziko mbali zaidi. Hata hivyo, kuingiliana kwa baadhi ya jenasi katikati ya ramani ya MDS hakupaswi kufasiriwa kuwa nafasi ya uwakilishi imetengeneza upya taksonomia ya kibiolojia kwa ukamilifu.
Je, makosa ni ya nasibu au yameundwa kitaksonomia?
Katika makosa ya kiwango cha spishi, %46,23 yalikuwa kwa spishi nyingine ya jenasi ileile, na %53,77 yalikuwa kwa spishi ya jenasi tofauti. Hivyo, karibu nusu ya makosa yote ya spishi yamejikita kati ya ndugu wa karibu kitaksonomia.
Katika uchanganuzi wa ubora wa chanzo, baadhi ya jozi za kuchanganywa zinazojirudia ni:
- Salix alba ↔ Salix fragilis
- Ulmus glabra ↔ Ulmus laevis
- Abies alba ↔ Abies nordmanniana
Mifano hii inaonyesha kwamba baadhi ya makosa hutokea zaidi kati ya spishi zinazofanana kwa mwonekano na zilizo karibu kibiolojia kuliko kuruka kwa modeli kwenda kwenye spishi isiyohusiana kabisa.
Kwa Nini Modeli Hurudi kwenye Kiwango cha Jenasi Ikiwa Haina Uhakika?
Utaratibu wa confidence-based fallback hurudisha taarifa pana zaidi ya jenasi badala ya kutoa jina mahususi la spishi ikiwa uhakika wa juu zaidi wa utabiri katika kiwango cha spishi uko chini ya kizingiti fulani; katika chanzo, kwa kizingiti cha 0,95, njia hii ilitoa usahihi wa fallback wa %82,87 na kuhamisha %6,67 ya utabiri hadi kiwango cha jenasi.
Lengo la njia hii si “kutoa utabiri zaidi”, bali kuepuka kutoa uhakika kupita kiasi wakati ushahidi wa kuona hautoshi katika kiwango cha spishi. Katika matumizi ya ikolojia ya shambani, taarifa sahihi ya jenasi inaweza kuwa na manufaa zaidi kuliko jina la spishi lisilo sahihi.
Hata hivyo, chanzo hakilinganishi alama ya uhakika na kutokuwa na uhakika wa kweli wa kitakwimu. Uainishaji usio sahihi wenye uhakika wa juu pia umeonekana. Kwa hiyo, kizingiti cha fallback ni kanuni ya kiutendaji; si kipimo cha kutokuwa na uhakika kilichokalibishwa.
Kikomo cha ujifunzaji wa prototipu
Kila spishi inawakilishwa na vekta moja tu ya prototipu. Hata hivyo, spishi ileile ya mti inaweza kuwa na hali nyingi tofauti za kuona katika jani, gome, koni, ua, mmea mchanga, mmea mzima, misimu tofauti na mitazamo tofauti ya kamera. Kwa hiyo, chanzo kinajadili matumizi ya prototipu ndogo nyingi kwa kila spishi kama mwelekeo unaowezekana wa uboreshaji wa baadaye.
Vivyo hivyo, TaxaMargin hutumia taksonomia tu kupitia mgawanyiko wa jenasi ileile / jenasi tofauti. Uanachama wa familia, umbali wa kifilojenetiki au ufanano wa hatua kwa hatua wa sifa za spishi haujaingizwa moja kwa moja kwenye ukingo.
Matokeo yanayoungwa mkono na utafiti
- Ukingo wa pembe unaotambua taksonomia ulitoa utendaji wa juu zaidi wa spishi, jenasi na macro-F1 kuliko ArcFace ya kawaida katika seti ya data iliyochunguzwa.
- Ujifunzaji wa prototipu ya spishi ulileta ongezeko la ziada la utendaji ulipotumiwa pamoja na TaxaMargin.
- Katika nafasi ya embedding iliyojifunzwa, umbali wa kosini unaoongezeka ulionekana kati ya jozi za spishi ileile, jenasi ileile na jenasi tofauti.
- Sehemu muhimu ya uainishaji usio sahihi ilitokea kati ya spishi zilizo karibu kitaksonomia.
- Utaratibu wa kurudi kutoka utabiri wa spishi hadi utabiri wa jenasi unaweza kutoa matokeo ya tahadhari zaidi kwa sampuli zenye uhakika mdogo.
Matokeo yasiyoungwa mkono na utafiti
- Haijaonyeshwa kwamba modeli itatoa usahihi wa %81,57 kwa spishi zote za miti duniani.
- Matokeo hayajawasilishwa kama uthibitishaji wa nje katika bara huru, nchi, bustani ya mimea au seti mpya ya data ya shambani.
- Uhakika wa juu wa modeli si dhamana ya usahihi wa kibiolojia.
- Makundi ya kuona kwenye grafu ya MDS si kipimo cha moja kwa moja cha uhusiano wa kifilojenetiki.
- Modeli hujifunza kutokana na picha pekee; mfumo wa utambuzi uliounganishwa na DNA, usambazaji wa kijiografia, rekodi za fenolojia au uchunguzi wa mtaalamu wa botania haujajaribiwa.
- Uwakilishi wa spishi kwa prototipu moja hauthibitishi kwamba unawakilisha kikamilifu utofauti wote wa kuona wa misimu na ngazi za viungo.
- Hierarkia ya kiwango cha jenasi haimodeli familia na viwango vya juu zaidi vya taksonomia ya kibiolojia.
Maana ya kisayansi
Mchango mkuu wa utafiti si kupata tu usahihi wa juu zaidi wa uainishaji. Utafiti unapendekeza mbinu inayohamisha muundo wa kihierarkia wa uainishaji wa kibiolojia kwenda kwenye jiometri ya mafunzo ya modeli ya akili bandia.
Kwa kiainishaji cha kawaida, madarasa mawili yasiyo sahihi ni lebo mbili tofauti tu. Kwa TaxaMargin, “mpinzani wa jenasi ileile” na “mpinzani wa jenasi tofauti” hazichukuliwi kuwa na ugumu sawa. Modeli inalazimishwa kujifunza utenganishaji mkubwa zaidi wa pembe kati ya spishi zilizo karibu kibiolojia na zinazochanganyika kwa urahisi kwa mwonekano.
Njia hii ni muhimu hasa kwa picha za bioanuwai; kwa sababu katika picha halisi za shambani, viungo bainifu vya spishi havionekani kila wakati. Kujua katika kiwango gani cha kitaksonomia makosa ya modeli hutokea kunaweza kutoa maelezo zaidi kuliko kipimo rahisi cha sahihi/siyo sahihi.
Hata hivyo, utafiti huu pia unaonyesha kwamba kuongeza taarifa za kitaksonomia hakuondoi kutokuwa na uhakika wote. Spishi za jenasi ileile bado huchanganywa kwa kiasi kikubwa, baadhi ya utabiri usio sahihi hufanywa kwa uhakika wa juu, na ubora wa ushahidi wa kuona hutofautiana kati ya picha. Kwa hiyo, TaxaMargin si mfumo uliothibitishwa kuchukua nafasi ya utambuzi wa mtaalamu wa botania; ni mbinu inayolenga kufanya lengo la ujifunzaji la modeli za utambuzi wa spishi kwa picha lilingane zaidi na muundo wa kibiolojia.
Maelezo ya Chanzo na Mbinu
Utafiti asili: Improving Fine-Grained Tree Species Recognition with Taxonomy-Aware Angular-Margin Learning
Waandishi: Mohamed Islam KESKES, Mihai Daniel Niţă
Mwandishi anayewajibika: Mihai Daniel Niţă amewekewa alama ya nyota kwenye ukurasa wa kichwa wa chanzo.
Taasisi: Department of Forest Engineering, Forest Management Planning and Terrestrial Measurements, Faculty of Silviculture and Forest Engineering, Transilvania University of Brasov, Brașov, Romania.
Aina ya chanzo: Makala ya utafiti ya preprint.
Jukwaa: SSRN.
SSRN Abstract ID: 7317101.
Hali ya mapitio ya wenzao: Haijapitia mapitio ya wenzao; PDF inaeleza hili kwenye kila ukurasa kwa maneno “Preprint not peer reviewed”.
DOI: PDF ya chanzo haina taarifa wazi ya DOI na, kwa kuwa ukurasa rasmi wa rekodi wa SSRN haukuweza kupatikana kwa kuaminika wakati wa uthibitishaji wa bibliografia wa sasa, DOI haijakisiwa.
Tarehe kamili ya kuchapishwa/kupakiwa: PDF ya chanzo haina tarehe wazi ya bibliografia; tarehe isiyoweza kuthibitishwa haijaongezwa.
Leseni: Hakuna Creative Commons iliyo wazi au leseni nyingine ya matumizi tena inayoonekana katika PDF ya chanzo. Kwa hiyo, picha, foto na miundo asili ya vielelezo vya chanzo hazijachukuliwa kuwa zenye leseni huria.
Chanzo cha data: Hasa picha za RGB za bioanuwai zilizochapishwa kwenye majukwaa ya GBIF na iNaturalist.
Seti ya data: jenasi 12, spishi 36, picha 300 kwa kila spishi; %70 mafunzo, %20 uthibitishaji, %10 majaribio.
Modeli: ImageNet-pretrained ConvNeXt-Tiny + uwakilishi wa vipimo 256 uliyo L2-normalized + kiainishaji cha TaxaMargin + prototipu za spishi za EMA zinazodhibitiwa na uhakika.
Vigezo vikuu vya mafunzo: AdamW, weight decay 0,05; kiwango cha ujifunzaji cha uti wa mgongo 1,5 × 10⁻⁴; vichwa vipya 1,5 × 10⁻³; cosine annealing; upeo wa epoch 30; early stopping kwa patience ya epoch 7; norma ya gradient clipping 1,0.
Vikwazo vikuu: Prototipu moja ya spishi, mgawanyiko wa kitaksonomia wa jenasi-ileile/jenasi-tofauti pekee, tofauti za ushahidi wa kuona zinazotokana na picha za umma zisizo sare, na uhakika wa modeli kutokuwa dhamana ya usahihi.
Dokezo la kiufundi ndani ya chanzo: Katika upangaji wa kihisabati uliochapishwa wa Mlinganyo (2), opereta ya kuchagua darasa hasi lililo gumu zaidi inaonekana kukosekana; maelezo ya maandishi yako wazi kama “spishi yenye ufanano wa kosini wa juu zaidi isipokuwa darasa sahihi”. Pia, uorodheshaji wa sehemu ya mbinu unaruka kutoka 2.5 hadi 2.7. Verianla haijaandika upya kimya kimya sehemu hizi kwa niaba ya chanzo.
Dokezo la matumizi ya picha: Pipeline ya chanzo, picha za spishi, majedwali ya utendaji, ramani ya MDS na confusion matrices hazipaswi kunakiliwa moja kwa moja. Ikihitajika kwa Verianla, michoro na skimu huru zinapaswa kuundwa kutoka mwanzo kwa kutumia tu thamani za ukweli zilizoripotiwa na mahusiano ya mbinu.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *