

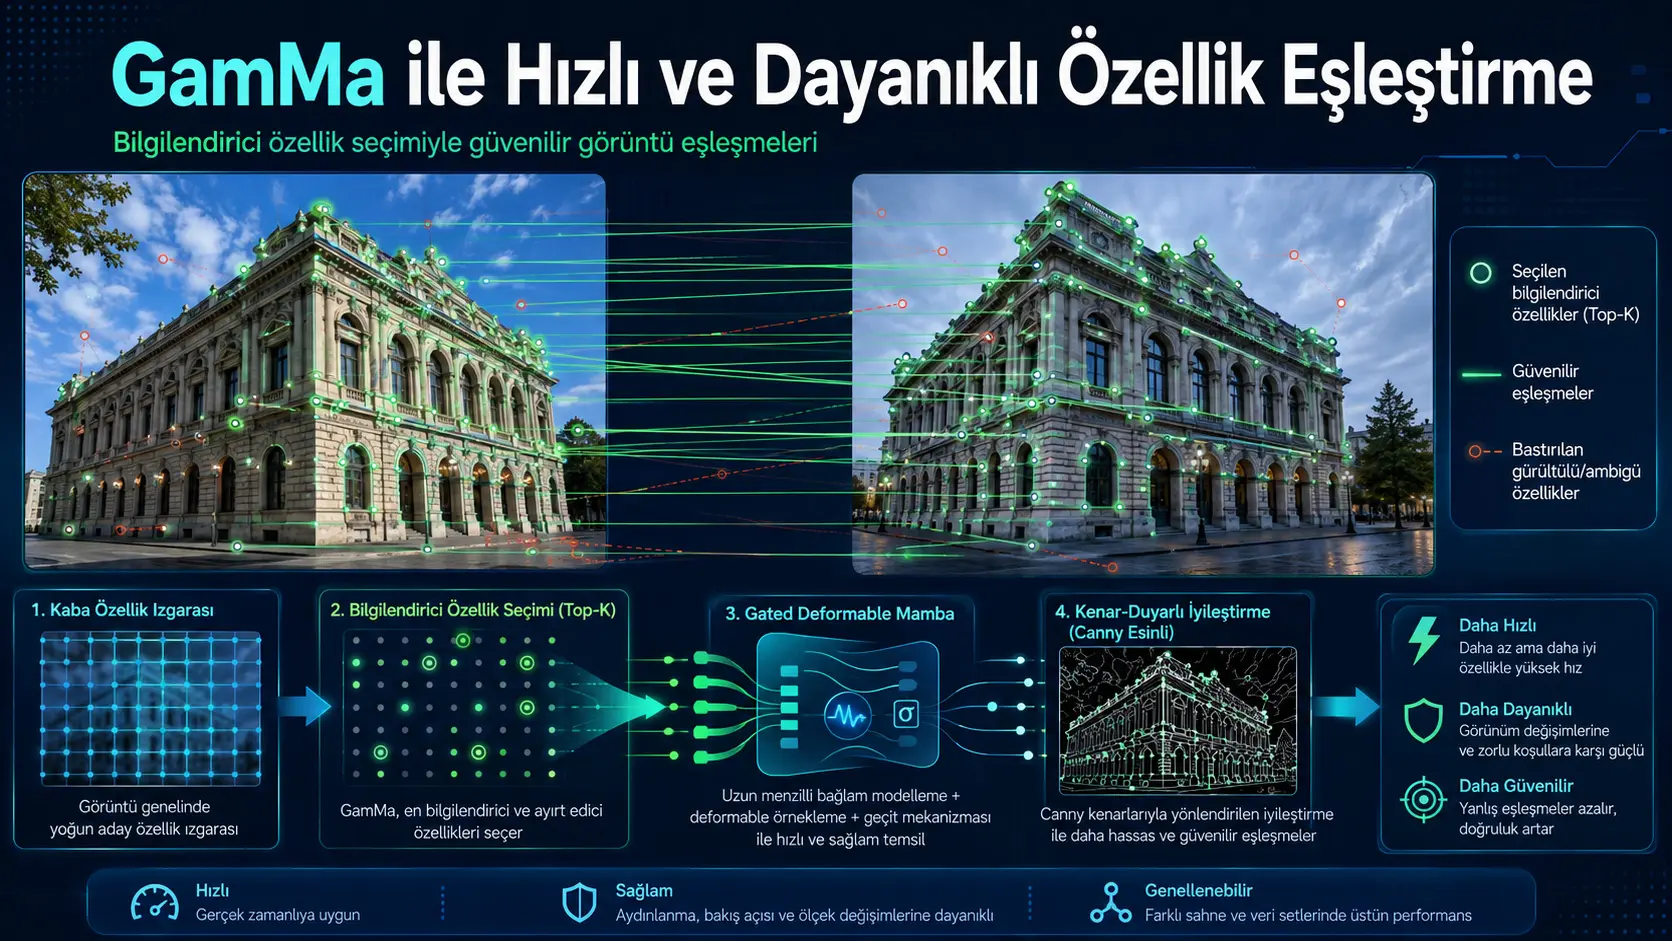
Utafiti huu umetengeneza modeli nyepesi ya ulinganishaji wa vipengele nusu-mnene iitwayo GamMa ili kupata uwiano wa kuaminika kati ya picha mbili zilizopigwa kutoka pembe, hali za mwanga au mazingira tofauti. Badala ya kuchakata vipengele vyote vya picha kwa namna sawa, modeli huchagua maeneo yanayoonekana kuaminika zaidi kwa ulinganishaji kabla ya uundaji wa mfuatano unaotegemea Mamba. Kwa kusudi hili, usanifu wa Gated Deformable Mamba wenye vipengele vya Gated Deformable Scanning, Joint Mamba na Gated Deformable Merge umetumiwa. GamMa ilifikia thamani za AUC za 65,2, 78,1 na 87,0 kwa mtiririko huo katika vizingiti vya 5°, 10° na 20° kwenye jaribio la MegaDepth; ikiwa na vigezo milioni 5,7, 202,5 GFLOP na muda wa utekelezaji uliopimwa wa 37,9 ms, ilitoa matokeo ya juu zaidi miongoni mwa mbinu nusu-mnene. Modeli pia ilitoa matokeo ya juu kuliko modeli msingi ya JamMa ilipohamishwa bila fine-tuning kwenda HPatches na ScanNet, ingawa ilikuwa imefunzwa kwenye MegaDepth pekee. Hata hivyo, utafiti haujapitia mapitio ya kitaalamu; orodha yake ya marejeo haijakamilika, baadhi ya tofauti za nambari hazilingani kati ya maandishi na majedwali, na hakuna mkengeuko wa kawaida au muda wa kujiamini uliotolewa kwa marudio mengi ya mafunzo katika majaribio.
Wazo kuu la GamMa ni kwamba si kila seli katika picha ina thamani sawa kwa ulinganishaji. Pembe za majengo, mipaka ya vitu na tekstua bainifu hutoa vidokezo vya kijiometri vinavyoaminika, ilhali anga, kuta tupu, mifumo inayojirudia au maeneo yaliyofifia yanaweza kuunda mwingiliano usio sahihi. Gated Index Network hupanga nafasi za vipengele kwa namna inayoweza kujifunza kabla ya ulinganishaji na katika mpangilio chaguo-msingi huchagua nusu yake. Vipengele vilivyochaguliwa huundwa kwa blok za Mamba na baadaye kurejeshwa kwenye ramani zao asilia za vipengele za pande mbili. Canny edge loss inalenga, hasa katika mazingira ya ndani yenye tekstua dhaifu, kuelekeza ulinganishaji kwenye miundo thabiti zaidi ya kijiometri kama makutano ya kuta, mipaka ya vitu na pembe.
Tathmini kwa mtazamo wa Uturuki: Mbinu ya GamMa inaweza kuchunguzwa nchini Uturuki katika uchoraji ramani kwa ndege zisizo na rubani, uwekaji nafasi wa roboti zinazojiendesha, uhalisia ulioboreshwa, uwekaji kumbukumbu wa pande tatu wa urithi wa kitamaduni, ulinganishaji wa picha za satelaiti na angani, kulinganisha miundo baada ya majanga na mifumo ya ukaguzi wa kuona viwandani. Kabla ya matumizi, modeli inapaswa kujaribiwa tena kwenye miundo ya mijini ya Uturuki, maeneo ya vijijini, mazingira ya ndani yenye mwanga mdogo, majengo yaliyoharibiwa baada ya tetemeko, façades zinazorudiwa na aina mbalimbali za kamera. Kwa matumizi ya wakati halisi, muda wa utekelezaji na matumizi ya kumbukumbu vinapaswa kupimwa pia kwenye GPU zilizopachikwa, vichakataji vya simu na vifaa vya ukingoni vyenye nguvu ndogo. Kwa kuwa utafiti hauwasilishi seti ya data iliyokusanywa Uturuki, mfumo wa ndani unaojiendesha, jaribio la uwanjani la kiutendaji au uthibitishaji wa usalama, kiwango cha mafanikio au uaminifu wa uwanjani unaohusu Uturuki hauwezi kutolewa moja kwa moja.
Ulinganishaji wa vipengele vya ndani ni nini?
Ulinganishaji wa vipengele vya ndani ni tatizo la kutafuta sehemu inayolingana ya nukta ileile ya kimwili au muundo katika picha mbili tofauti. Pembe ya jengo, ukingo wa dirisha, mstari wa barabara au mpaka wa kitu unaweza kuonekana kwa mizani, pembe na mwanga tofauti katika picha mbili, lakini mfumo sahihi wa ulinganishaji unapaswa kuweza kuunganisha nukta hizi.
Uwiano huu ni ingizo msingi katika matumizi yafuatayo:
- Uwekaji nafasi wa kuona na ukokotoaji wa pose ya kamera,
- Uwekaji nafasi na uchoraji ramani wa wakati mmoja (SLAM),
- Utengenezaji wa modeli ya pande tatu kwa Structure-from-Motion,
- Ujenzi upya wa picha nyingi,
- Ulinganishaji wa picha na ukadiriaji wa homography,
- Ufuatiliaji wa mwendo katika roboti na mifumo inayojiendesha.
Kutengeneza idadi kubwa ya uwiano kati ya picha mbili pekee haitoshi. Uwiano usio sahihi unaweza kuvuruga ukadiriaji wa mzunguko wa kamera, uhamisho na jiometri ya pande tatu. Kwa hiyo, kiasi cha uwiano, usahihi wa kijiometri, ustahimilivu na gharama ya kukokotoa vinapaswa kutathminiwa pamoja.
Tofauti kati ya ulinganishaji sparse, nusu-mnene na mnene
Mbinu sparse kwanza hugundua pembe au nukta za kuvutia, kisha hulinganisha descriptors zinazohusiana na nukta hizo. Gharama zao za kukokotoa ni ndogo kwa kiasi; hata hivyo, katika maeneo kama kuta zisizo na tekstua au mifumo inayojirudia, huenda zisitoe keypoints za kutosha na thabiti.
Mbinu mnene hukadiria uwiano kwa karibu kila pikseli au eneo dogo la picha. Mbinu hizi zinaweza kuwa imara katika mabadiliko makubwa ya mwonekano, lakini zinahitaji vigezo zaidi, kumbukumbu zaidi na ukokotoaji zaidi.
Mbinu nusu-mnene hulenga kusawazisha ustahimilivu wa ulinganishaji mnene na ufanisi wa kukokotoa wa ulinganishaji sparse. GamMa imo katika kundi hili.
Kwa nini Mamba imetumiwa badala ya Transformer?
Vilinganishi vinavyotegemea Transformer vinaweza kuunda uhusiano wa masafa marefu kati ya maeneo tofauti ya picha kwa utaratibu wa self-attention. Hata hivyo, gharama ya kukokotoa ya self-attention ya kawaida huongezeka kwa mraba wa idadi ya token zinazochakatwa. Kwa kuwa idadi ya token ni kubwa kwenye ramani za vipengele nusu-mnene, gharama hii inaweza kuwa muhimu.
Miundo ya Mamba hutoa mbadala wa gharama ndogo kwa kuchakata mifuatano mirefu kwa uundaji wa state-space unaokua takribani kwa mstari. Mbinu ya awali iitwayo JamMa iliibadilisha Mamba kwa ulinganishaji wa vipengele nusu-mnene. Hoja ya kuanzia ya utafiti ni kwamba JamMa huchakata nafasi zote za vipengele kwa usawa katika mpangilio wa skanningi uliowekwa.
Tatizo la mbinu ya skanningi iliyowekwa ni nini?
Si kila eneo la picha lina ishara ya kuaminika ya ulinganishaji. Maeneo yafuatayo yanaweza kuwa na matatizo hasa:
- Nyuso tambarare na zisizo na tekstua,
- Safu zinazofanana za madirisha au matofali,
- Anga na mandhari ya rangi moja,
- Maeneo yenye ukungu wa mwendo,
- Maeneo yasiyoingiliana kati ya picha mbili,
- Nyuso ambazo mwonekano wake hubadilika sana kulingana na pembe ya kutazama.
Katika skanningi iliyowekwa, maeneo haya pia hushiriki katika uundaji wa mfuatano kwa kiwango sawa na pembe na mipaka ya kuaminika. Hivyo, vipengele visivyo na uhakika vinaweza kuingiliana na maeneo ya mbali na kuongeza kelele kwenye ishara ya ulinganishaji. Kielelezo 1 kinaonyesha mifano ambapo JamMa ilitengeneza ulinganishaji mwingi usio sahihi katika mazingira ya ndani ya ScanNet. Mistari ya kijani inawakilisha ulinganishaji chanya, na mistari myekundu ulinganishaji hasi.
Usanifu wa jumla wa GamMa
Usanifu katika Kielelezo 2 una hatua nne kuu:
- Uchimbaji wa vipengele vya ndani,
- Uteuzi na uundaji wa vipengele vya kiwango cha coarse kwa Gated Deformable Mamba,
- Ulinganishaji fine katika madirisha ya ndani,
- Mafunzo ya nafasi za vipengele kwa usimamizi wa kingo wa Canny.
Picha mbili \(I_A\) na \(I_B\) hutumiwa kama ingizo. Backbone ya ConvNeXtV2-N hutoa vipengele katika maazimio mawili:
- Vipengele coarse vya chaneli 256 katika \(1/8\) ya azimio la ingizo,
- Vipengele fine vya chaneli 64 katika \(1/2\) ya azimio la ingizo.
Backbone ya ConvNeXtV2 ina takribani vigezo milioni 0,65. Modeli kamili ya GamMa imeorodheshwa kwenye jedwali ikiwa na vigezo milioni 5,7.
Kipengele chenye taarifa kinafafanuliwaje?
Utafiti unaeleza kiwango cha taarifa cha nafasi ya kipengele kwa vipengele vitatu vya kimawazo:
\[ S_i = \alpha S_i^{struct} + \beta S_i^{distinct} + \gamma S_i^{consistency}. \]
Hapa:
- \(S_i^{struct}\), huwakilisha umaarufu wa kimuundo kama ukingo, pembe au tekstua;
- \(S_i^{distinct}\), huwakilisha uwezo wa kipengele kutofautishwa na maeneo yanayokizunguka;
- \(S_i^{consistency}\), huwakilisha uthabiti wa mwitikio wa ulinganishaji kati ya picha mbili
.
Thamani hizi tatu hazihesabiwi moja moja kwa vitendo. Gated Index Network hujifunza end-to-end ni maeneo gani yana manufaa chini ya usimamizi unaotokana na matching loss. Mlinganyo ni mfumo wa kinadharia unaoeleza dhana ya informativeness inayolengwa na modeli.
Gated Deformable Scanning hufanyaje kazi?
Ramani za vipengele coarse zina umbo:
\[ \mathbf{x}\in\mathbb{R}^{2\times H\times W\times C} \]
. Kipimo cha kwanza kinaonyesha jozi ya picha, \(H\) na \(W\) vipimo vya anga, na \(C\) idadi ya chaneli.
Katika skanningi ya kawaida, seli za picha hupangwa kwa mpangilio wa raster uliowekwa kutoka juu kushoto hadi chini kulia. GamMa hutengeneza offset inayoweza kujifunza kwa kila nafasi:
\[ \Delta t\in\mathbb{R}^{2\times H\times W\times1}. \]
Indeksi ya awali ya skanningi \(t_i\), hunormishwa katika safu \([-1,1]\). Offset inayotabiriwa na mtandao pia hufungwa kwenye safu hiyo hiyo kwa kazi ya `tanh`:
\[ t_D=t_i+\Delta t. \]
Nafasi hupangwa kulingana na thamani za \(t_D\) na ni vipengele \(K\) tu vya daraja la juu vinavyohifadhiwa. Katika mpangilio chaguo-msingi:
\[ K=\frac{H\times W}{2}. \]
Kwa maneno mengine, nusu ya nafasi coarse za vipengele huingizwa katika uundaji wa mfuatano wa Mamba. Lengo si kuchagua tu maeneo yenye uanzishaji wa juu zaidi, bali pia kukandamiza maeneo yasiyo thabiti kati ya picha mbili, yanayojirudia au yasiyo na uhakika kijiometri.
Muundo wa Gated Index Network
Gated Index Network hupitisha vipengele katika matawi mawili sambamba ya depthwise-separable convolution. Tawi moja hutoa mwitikio wa kimuundo wa ndani moja kwa moja, wakati jingine hutumia GroupNorm na GELU kuunda moduli inayojibadilisha.
Matokeo ya matawi mawili huzidishwa kwa kipengele:
\[ F_g=F_1\odot GELU(GN(F_2)). \]
Katika mchakato huu wa gating, lengo ni kuimarisha miitikio inayoungwa mkono na matawi yote mawili na kukandamiza miitikio dhaifu au isiyolingana. Offset ya mwisho huzalishwa na convolution ya \(1\times1\):
\[ \Delta t=Conv_{1\times1}(F_g). \]
Nafasi zilizochaguliwa katika Kielelezo 9 zimejikusanya kwenye façades za majengo, mipaka ya kuba na miundo ya usanifu yenye maelezo mengi, huku zikiwa chache zaidi katika maeneo sawa kama anga. Hata hivyo, kichwa cha Kielelezo 9 kimetaja kimakosa ulinganisho wa Canny loss.
Tatizo la derivative katika operesheni ya kupanga
Kupanga vipengele kwa namna ya kawaida si differentiable. Kwa hiyo, gradient inayopita katika kupanga haiwezi kuhamishwa moja kwa moja kwenye indeksi ya deformation.
Watafiti walitumia gradient ya kukadiria kwa kuchukua wastani wa gradient katika kipimo cha mfuatano wa mwisho wa picha na kuirudisha kwenye indeksi ya deformation. Mbinu hii huwezesha mafunzo; hata hivyo, si derivative halisi ya operesheni ya kupanga. Hakuna ulinganisho wa mbinu hii na mbinu nyingine za ukadiriaji wa gradient wala uchanganuzi wa makosa uliotolewa.
Joint Mamba na kuunganisha tena vipengele
Vipengele vilivyochaguliwa hubadilishwa kuwa mifuatano myembamba ya upande mmoja. Joint Mamba huunda uhusiano wa masafa marefu kati ya vipengele vinavyotoka kwenye picha mbili. Katika utekelezaji, mfuatano wa mwelekeo minne na blok nne za Mamba zilizopangwa juu ya nyingine hutumiwa.
Gated Deformable Merge hurejesha vipengele vilivyochakatwa kwenye nafasi zao za awali zenye azimio \(1/8\) kwa kutumia indeksi za kinyume. Kupitisha vipengele vilivyochaguliwa pekee kwenye Mamba kunaweza kupunguza mwingiliano wa moja kwa moja kati ya maeneo yasiyochaguliwa au mifuatano tofauti. Ili kupunguza upungufu huu, kitengo cha ziada cha gated merge kilichoundwa na convolution za kawaida kimetumiwa:
\[ \sigma=GELU(Conv_3(F_{in})), \]
\[ F_{out}=Conv_3\left(\sigma\cdot Conv_3(F_{in})\right). \]
Ulinganishaji wa kiwango fine
Baada ya ulinganishaji coarse, madirisha ya vipengele vya azimio la juu hukatwa karibu na nafasi zilizotabiriwa. Ulinganishaji fine wa kiwango cha subpixel hufanywa ndani ya madirisha haya.
Hatua coarse hupata uwiano unaowezekana katika picha nzima, wakati hatua fine hufanya nafasi kuwa sahihi zaidi ndani ya dirisha dogo la ndani. Hivyo, usahihi wa nafasi hujaribiwa kuongezwa bila kufanya uchakataji mnene wa azimio la juu katika picha nzima.
Kwa nini Canny edge loss imeongezwa?
Katika mandhari yenye tekstua dhaifu, maeneo mapana kama uso wa ukuta au meza hayatoi taarifa ya kuona inayotofautisha. Kinyume chake, mipaka ya vitu, miunganiko ya kuta na pembe zinaweza kutoa miundo ya kijiometri iliyo thabiti zaidi hata pembe ya kutazama inapobadilika.
Mtiririko wa mafunzo wa Canny edge loss ni kama ifuatavyo:
- Picha ya ingizo hupunguzwa hadi azimio la ulinganishaji fine kwa bilinear interpolation.
- Ugunduzi wa kingo wa Canny hutumika kwenye picha iliyopunguzwa.
- Dirisha la ukingo hukatwa karibu na nafasi coarse ya ulinganishaji.
- Nafasi ya ukingo katika dirisha huchaguliwa kwa operesheni ya `argmax` ya pande mbili.
- Tofauti ya L1 kati ya nafasi fine iliyotabiriwa na nafasi lengwa inayotegemea ukingo huhesabiwa.
\[ L_{canny}= \frac{1}{N} \sum_{i=1}^{N} \left\| p_{idx}^{(i)}-p_{idx}^{gt,(i)} \right\|_1. \]
Loss hii haithibitishi kwamba nukta ya kweli ya ulinganishaji lazima iwe kwenye ukingo. Ni regularizer msaidizi unaoelekeza ulinganishaji wakati wa mafunzo kwenye miundo inayochukuliwa kuwa thabiti kijiometri.
Loss ya jumla ya mafunzo
Modeli imefunzwa kwa vipengele vinne vya loss:
- Focal loss ya ulinganishaji coarse \(L_c\),
- Focal loss ya ulinganishaji fine \(L_f\),
- Canny edge loss \(L_{canny}\),
- Loss ya jiometri ya epipolar ya subpixel \(L_s\).
Loss ya subpixel hutumia umbali wa epipolar wa ulinganifu kupitia nukta mbili za picha zilizonormishwa na essential matrix \(E\), badala ya fundamental matrix:
\[ L_s= \frac{1}{|M_f|} \sum_{(x,y)\in M_f} \frac{(x^{\top}Ey)^2} {(Ey)_1^2+(Ey)_2^2+(E^{\top}x)_1^2+(E^{\top}x)_2^2}. \]
Loss ya jumla imefafanuliwa kama:
\[ L_{total} = \lambda_cL_c+ \lambda_fL_f+ \lambda_{canny}L_{canny}+ \lambda_sL_s \]
. Coefficients ni:
- \(\lambda_c=1\),
- \(\lambda_f=1\),
- \(\lambda_{canny}=0{,}5\),
- \(\lambda_s=10^4\)
. Imeelezwa kuwa uzito mkubwa umetumiwa kwa sababu thamani ghafi ya loss ya subpixel ni takribani \(10^{-4}\) au ndogo zaidi.
Mpangilio wa mafunzo
| Mpangilio | Thamani |
|---|---|
| Seti ya data ya mafunzo | MegaDepth |
| Muda wa mafunzo | Vipindi 60 |
| Uboreshaji | AdamW |
| Kiwango cha awali cha kujifunza | 2 × 10⁻⁴ |
| Ratiba ya kiwango cha kujifunza | Kupungua kwa kosaini na kipindi kimoja cha linear warm-up |
| Ukubwa wa batch | 8 |
| Picha ya mafunzo | 832 × 832, kubadilisha ukubwa na padding |
| Vigezo vya Focal loss | α = 0,25; γ = 2 |
| Vizingiti vya Canny | 0,1 na 0,2 |
| Blok za Mamba | 4 |
| Uwiano wa vipengele vilivyochaguliwa | K = 1/2 |
| Maunzi | GPU mbili za NVIDIA A100 |
| Fine-tuning katika majaribio ya baina ya domain | Haikufanywa |
Matokeo ya MegaDepth
MegaDepth inajumuisha picha za nje zenye mabadiliko makubwa ya pembe ya kutazama, mwanga na mifumo ya usanifu inayojirudia. Utafiti ulijaribu jozi 1.500 za picha kutoka mandhari za Sacré-Cœur na St. Peter’s Square na kukokotoa pose ya kamera kwa LO-RANSAC.
| Mbinu | Vigezo | GFLOP | Muda | AUC@5° | AUC@10° | AUC@20° |
|---|---|---|---|---|---|---|
| JamMa | 5,7 M | 202,9 | 37,2 ms | 64,1 | 77,4 | 86,5 |
| GamMa | 5,7 M | 202,5 | 37,9 ms | 65,2 | 78,1 | 87,0 |
| DKM, mnene | 72,3 M | 1424,5 | 369,2 ms | 67,3 | 79,7 | 88,1 |
| RoMa, mnene | 111,3 M | 2014,3 | 549,9 ms | 68,5 | 80,6 | 88,8 |
GamMa ilipata faida za AUC za 1,1, 0,7 na 0,5 dhidi ya JamMa ikiwa na idadi ileile ya vigezo na gharama inayofanana ya kukokotoa. Muda wa utekelezaji ni 0,7 ms mrefu kuliko JamMa; kwa hiyo haiwezi kusemwa kwamba GamMa ni ya haraka kuliko JamMa. Faida yake ni kutoa usahihi wa juu kwa kasi na ukubwa unaofanana.
Vilinganishi mnene vilitoa AUC ya juu zaidi. Hata hivyo, DKM ina muda wa utekelezaji uliopimwa wa takribani mara 7,7 mrefu zaidi na RoMa takribani mara 10,5 mrefu zaidi, pamoja na vigezo vingi zaidi.
Ujenzi upya wa mitazamo mingi wa Aachen
Aachen v1.1 ni seti ya data ya uwekaji nafasi wa kuona wa nje yenye mabadiliko ya mchana-usiku na pembe ya kutazama. Vigezo vitatu vilitumika katika utafiti:
- mtl: Urefu wastani wa trace ya kipengele; thamani ya juu inapendelewa.
- mre: Kosa wastani la reprojection; thamani ya chini inapendelewa.
- mopi: Idadi wastani ya observations kwa picha; inaonyesha kiasi cha ulinganishaji.
| Mbinu | mtl | mre | mopi |
|---|---|---|---|
| LoFTR | 5,11 | 1,24 | 4432 |
| JamMa | 4,48 | 1,19 | 3050 |
| GamMa, bila Canny loss | 4,43 | 1,14 | 2796 |
| GamMa | 5,16 | 1,13 | 2765 |
GamMa ilitoa trace wastani ndefu zaidi na kosa la chini zaidi la reprojection. Idadi ya ulinganishaji kwa picha ni ndogo kuliko LoFTR na ASpanFormer. Tafsiri ya utafiti ni kwamba modeli huhifadhi ulinganishaji mchache lakini ulio thabiti zaidi kijiometri badala ya idadi kubwa ya ulinganishaji.
Kuondoa Canny loss kulipunguza thamani ya mtl kutoka 5,16 hadi 4,43. Matokeo haya yanaashiria kwamba usimamizi wa kingo unaweza kuchangia mwendelezo wa trace katika picha nyingi.
Ulinganisho wa skanningi iliyowekwa na deformable
| Mpangilio | AUC@5° | AUC@10° | AUC@20° |
|---|---|---|---|
| Skanningi iliyowekwa | 62,6 | 76,2 | 86,1 |
| Bila Gated Index Network | 63,2 | 76,5 | 86,0 |
| Gated Deformable Scanning | 65,2 | 78,1 | 87,0 |
Gated deformable scanning ilipata faida za 2,6, 1,9 na 0,9 pointi kwa mtiririko huo katika vizingiti vya 5°, 10° na 20° ikilinganishwa na skanningi iliyowekwa. Ingawa aya ya makala imetoa tofauti ya mwisho kama 1,9, jedwali linaonyesha 0,9.
Katika Kielelezo 7, skanningi deformable ilitoa mwitikio ulio wazi zaidi kwenye mipaka ya majengo na mwitikio mdogo wa kufanana kwenye mandhari ya nyuma. Miitikio ya skanningi iliyowekwa inaonekana kusambaa zaidi. Ugunduzi huu wa kuona unaunga mkono tafsiri kwamba utaratibu wa uteuzi unasisitiza foreground na mipaka ya kimuundo; hata hivyo, ramani za kufanana pekee si ushahidi wa kisababishi.
Ni vipengele vingapi vinapaswa kuchaguliwa?
| Uwiano wa vipengele vilivyohifadhiwa | AUC@5° | Muda |
|---|---|---|
| Vyote, K = 1 | 64,6 | 40,5 ms |
| Nusu, K = 1/2 | 65,2 | 37,9 ms |
| Robo, K = 1/4 | 63,9 | 36,7 ms |
| Moja ya nane, K = 1/8 | 61,1 | 35,9 ms |
Kuchakata vipengele vyote hakukutoa usahihi wa juu zaidi. Kuchagua nusu ya vipengele kuliongeza AUC kwa pointi 0,6 na kupunguza muda kwa 2,6 ms. Kinyume chake, uchujaji mkali zaidi ulisababisha kupotea kwa ushahidi muhimu wa ulinganishaji. K = 1/8 ilipoteza pointi 4,1 za AUC dhidi ya K = 1/2 kwa faida ya ziada ya kasi ya 2 ms pekee.
Athari ya Canny edge loss
Katika matokeo ya MegaDepth, athari ya Canny loss ni ndogo:
| Mpangilio | AUC@5° | AUC@10° | AUC@20° |
|---|---|---|---|
| Bila Canny loss | 65,1 | 78,1 | 87,1 |
| Kwa Canny loss | 65,2 | 78,1 | 87,0 |
Kuna ongezeko la pointi 0,1 katika kizingiti cha 5°, hakuna mabadiliko katika 10°, na upungufu wa pointi 0,1 katika 20°. Kwa hiyo, jedwali la MegaDepth halionyeshi kwamba Canny loss inaongeza kwa kiasi kikubwa usahihi wa jumla.
Katika mazingira ya ndani yenye tekstua dhaifu ya ScanNet, matokeo yanaonekana wazi zaidi:
| Mpangilio | AUC@5° | AUC@10° | AUC@20° |
|---|---|---|---|
| Bila Canny loss | 20,1 | 37,9 | 54,0 |
| Kwa Canny loss | 21,0 | 38,4 | 54,4 |
Faida ni pointi 0,9, 0,5 na 0,4 kwa mtiririko huo. Kielelezo 8 kinaonyesha kwamba ulinganishaji unaosimamiwa na Canny umejikusanya kwa mpangilio zaidi kwenye makutano ya kuta za ndani na mipaka ya vitu.
Matokeo ya ujumlishaji wa baina ya domain kwenye HPatches
Katika jaribio la HPatches, modeli zote zilifunzwa kwenye MegaDepth na hazikufanyiwa fine-tuning kwa HPatches. Ulinganishaji 1.000 wenye alama za juu zaidi ulitumiwa kwa kila mbinu.
| Mbinu | AUC@3 pikseli | AUC@5 pikseli | AUC@10 pikseli |
|---|---|---|---|
| JamMa | 61,8 | 71,5 | 81,2 |
| GamMa | 65,5 | 75,4 | 84,3 |
| LoFTR | 65,9 | 75,6 | 84,6 |
| ASpanFormer | 66,3 | 76,3 | 85,3 |
| ELoFTR | 66,5 | 76,4 | 85,5 |
GamMa iliizidi JamMa kwa pointi 3,7, 3,9 na 3,1. Maandishi chanzo yanaandika pointi 4,9 katika kizingiti cha kati; kwa mujibu wa jedwali, tofauti sahihi ya kihesabu ni 3,9.
GamMa iko nyuma kidogo ya LoFTR, ASpanFormer na ELoFTR zinazotegemea Transformer. Kwa hiyo, matokeo ya HPatches yanaunga mkono uhamishaji ulioboreshwa baina ya domain dhidi ya JamMa, si dai la kuwa mbinu bora zaidi kwa ujumla.
Matokeo ya ujumlishaji wa baina ya domain kwenye ScanNet
Kwenye ScanNet, modeli zilifunzwa kwenye MegaDepth pekee na kujaribiwa moja kwa moja kwenye jozi 1.500 za picha za ndani.
| Mbinu | AUC@5° | AUC@10° | AUC@20° |
|---|---|---|---|
| JamMa | 18,5 | 35,6 | 51,3 |
| GamMa | 21,0 | 38,4 | 54,4 |
| ASpanFormer | 22,3 | 39,3 | 55,3 |
GamMa ilipata pointi 2,5, 2,8 na 3,1 dhidi ya JamMa. Kielelezo 10 kinaonyesha kwamba GamMa inatengeneza ulinganishaji chanya zaidi, lakini idadi ya ulinganishaji usio sahihi pia inaongezeka. Hivyo, ustahimilivu wa modeli baina ya domain umeongezeka, lakini makosa hayajatoweka kabisa.
Uteuzi wa backbone
| Backbone | AUC@5° | AUC@10° | AUC@20° |
|---|---|---|---|
| DINOv3, uzito umefungwa | 63,9 | 77,2 | 86,1 |
| DINOv3, imefanyiwa fine-tuning | 65,1 | 77,9 | 87,0 |
| GELAN | 65,3 | 78,0 | 87,1 |
| ConvNeXtV2 | 65,2 | 78,1 | 87,0 |
Matokeo yanaonyesha kwamba backbone tatu zinazoweza kufunzwa ziko karibu sana. GELAN hutoa ubora mdogo sana katika vizingiti vya 5° na 20°, huku ConvNeXtV2 ikitoa matokeo ya juu zaidi katika 10°. Watafiti walichagua ConvNeXtV2 nyepesi yenye vigezo milioni 0,65 kwa sababu ya ufanisi.
Nguvu za utafiti
- Uteuzi wa vipengele umechukuliwa kama kipengele wazi cha usanifu kabla ya uundaji wa mfuatano.
- Modeli ilitoa matokeo ya juu ya MegaDepth kuliko JamMa ikiwa na idadi ileile ya vigezo.
- Uwiano wa vipengele vilivyochaguliwa umechunguzwa kando kwa usahihi na muda wa utekelezaji.
- Skanningi iliyowekwa na deformable zimelinganishwa kwa nambari na kwa kuona.
- Athari ya Canny loss kwenye seti za data zenye tekstua nyingi na tekstua dhaifu imetenganishwa.
- Mbali na MegaDepth, majaribio ya baina ya domain yalifanywa kwenye HPatches, ScanNet na Aachen.
- Vigezo, GFLOP na muda wa utekelezaji vimetolewa pamoja na vipimo vya usahihi.
- Usawazishaji wa mopi–mtl–mre kati ya kiasi cha data na ubora wa ulinganishaji umejadiliwa.
- Imeonyeshwa wazi kwamba modeli hutumia ukokotoaji mdogo kuliko vilinganishi mnene.
Vikwazo vya utafiti
- Utafiti haujapitia mapitio ya kitaalamu.
- Manukuu ndani ya maandishi yanaonekana kama `[?]` na hakuna orodha ya marejeo.
- Baadhi ya tofauti katika HPatches na ablation ya skanningi zimehesabiwa vibaya.
- Matokeo yanategemea mafunzo moja au idadi isiyoeleweka ya mafunzo; hakuna mkengeuko wa kawaida wala muda wa kujiamini.
- Itifaki ya kipimo cha muda wa utekelezaji, mzunguko wa warm-up, ukubwa wa batch na matumizi ya kumbukumbu havijaelezwa.
- Hakuna ulinganisho wa gradient ya kukadiria iliyotumiwa kwa operesheni ya kupanga na mbinu mbadala.
- Uhusiano wa maeneo yaliyochaguliwa na Gated Index Network na usahihi halisi wa kijiometri haujapimwa kwa jaribio la uaminifu lililo na lebo za moja kwa moja.
- Canny loss haikutoa uboreshaji thabiti kwenye MegaDepth.
- Katika ScanNet, idadi ya ulinganishaji usio sahihi iliongezeka pamoja na idadi ya ulinganishaji chanya.
- Katika HPatches, ilibaki nyuma ya baadhi ya mbinu nusu-mnene zinazotegemea Transformer.
- Mbinu mnene za DKM na RoMa zilitoa usahihi wa juu zaidi kwenye MegaDepth.
- Hakuna jaribio tofauti linalodhibitiwa kwa motion blur, occlusion kubwa na mabadiliko makubwa sana ya pembe ya kutazama.
- Hakuna jaribio la vifaa vya simu, vilivyopachikwa au vya nguvu ndogo lililofanywa.
- Imeelezwa kwamba code itachapishwa, lakini hakuna kifurushi cha uzalishaji upya kilichotolewa katika toleo hili.
- Waandishi wameripoti kwamba hawana ruhusa ya kushiriki data iliyotumiwa.
Utafiti unaunga mkono nini?
- Kuchakata vipengele coarse vyote kwa namna sawa huenda kusitoe usawazishaji bora wa usahihi–kasi.
- Kuchagua nusu ya vipengele kwa namna inayoweza kujifunza kunaweza kutoa matokeo bora kuliko kuchakata vipengele vyote.
- Gated Deformable Scanning inaweza kuboresha utendaji wa MegaDepth ikilinganishwa na skanningi iliyowekwa.
- Vipengele vilivyochaguliwa hujikusanya kwenye mipaka ya usanifu na maeneo ya foreground yenye tekstua nyingi.
- Usimamizi wa ziada unaotegemea Canny unaweza kuongeza uthabiti wa ulinganishaji katika mazingira ya ndani yenye tekstua dhaifu.
- GamMa inaonyesha uhamishaji wa zero-shot ulio imara zaidi kuliko JamMa kwenye HPatches na ScanNet.
- GamMa inaweza kutoa usahihi wa ushindani kwa gharama ndogo ya kukokotoa kuliko vilinganishi mnene.
Utafiti hauthibitishi nini?
- Haithibitishi kwamba GamMa ni sahihi zaidi kuliko mbinu zote za ulinganishaji wa vipengele vya ndani.
- Hauonyeshi kwamba ni ya haraka kuliko JamMa.
- Haithibitishi kwamba kingo za Canny ni nafasi sahihi zaidi za ulinganishaji katika kila mandhari.
- Hauonyeshi kwamba uwiano uliochaguliwa wa asilimia 50 ni bora kwa ulimwengu wote wa seti za data na maazimio.
- Hauthibitishi utendaji wa wakati halisi kwenye mifumo ya simu au iliyopachikwa.
- Hauwasilishi mafanikio ya uwanjani ya end-to-end kwenye roboti, gari au ndege isiyo na rubani.
- Hauhakikishi uaminifu katika occlusion kali na mabadiliko makubwa sana ya pembe ya kutazama.
- Hauonyeshi kwamba ulinganishaji unaozalishwa pekee unatosha katika mifumo inayojiendesha yenye umuhimu wa usalama.
- Hautoi kiwango cha mafanikio kilichothibitishwa kwa picha au mifumo ya ndani ya Uturuki.
Ni kazi gani za baadaye zinahitajika?
- Mafunzo yanapaswa kufanywa kwa mbegu nyingi nasibu na wastani pamoja na mkengeuko wa kawaida kuripotiwa.
- Muda wa utekelezaji, kumbukumbu na matumizi ya nishati yanapaswa kupimwa kwenye GPU, CPU na vifaa vya ukingoni tofauti.
- Calibration ya uteuzi wa vipengele na uaminifu halisi wa ulinganishaji wa nukta zilizochaguliwa unapaswa kuchunguzwa.
- Differentiable sorting au mbinu tofauti za ukadiriaji wa top-K zinapaswa kulinganishwa.
- Majaribio tofauti yanapaswa kufanywa kwa pembe kubwa ya kutazama, occlusion, motion blur na mabadiliko ya msimu.
- Majaribio ya real-time SLAM yanapaswa kufanywa kwenye roboti za simu, magari na ndege zisizo na rubani.
- Mabadiliko ya domain ya ndani kama miji ya Uturuki, miundo ya kihistoria na picha za baada ya majanga yanapaswa kujaribiwa.
- Source code, usanidi wa mafunzo, uzito wa modeli na scripts za uzalishaji upya zinapaswa kuchapishwa.
- Orodha ya marejeo iliyokosekana na kutolingana kwa nambari kati ya maandishi na jedwali kunapaswa kusahihishwa katika toleo lililopitiwa kitaalamu.
Mbinu na Matokeo ya Utafiti
Muhtasari wa kiufundi wa mbinu
| Kipengele | Mbinu iliyotumika |
|---|---|
| Kazi msingi | Ulinganishaji nusu-mnene wa vipengele vya ndani kati ya picha mbili |
| Backbone ya vipengele | ConvNeXtV2-N |
| Azimio la vipengele coarse | 1/8 ya azimio la ingizo, chaneli 256 |
| Azimio la vipengele fine | 1/2 ya azimio la ingizo, chaneli 64 |
| Ubunifu mkuu | Gated Deformable Mamba |
| Uteuzi wa vipengele | Offset ya indeksi inayoweza kujifunza, kupanga na uteuzi wa top-K |
| K chaguo-msingi | Nusu ya nafasi coarse za vipengele |
| Uundaji wa mfuatano | Blok nne za Mamba zilizopangwa na mifuatano yenye mwelekeo |
| Kuunganisha tena | Uindeksishaji wa kinyume na kitengo cha gated convolution |
| Ulinganishaji fine | Dirisha la vipengele vya ndani karibu na utabiri coarse |
| Usimamizi wa ziada wa kijiometri | Loss ya nafasi ya L1 inayotegemea kingo za Canny |
| Usimamizi wa subpixel | Umbali wa epipolar wa ulinganifu |
| Mafunzo | MegaDepth, vipindi 60, AdamW |
| Jaribio la baina ya domain | HPatches na ScanNet; bila fine-tuning |
| Jaribio la mitazamo mingi | Aachen v1.1 na HLoc |
| Ukubwa wa modeli | Vigezo milioni 5,7 |
| Ukokotoaji | 202,5 GFLOP |
| Muda uliopimwa | 37,9 ms |
Matokeo makuu ya kulinganisha
| Jaribio | Matokeo ya GamMa | Ulinganisho msingi | Tafsiri |
|---|---|---|---|
| MegaDepth | 65,2 / 78,1 / 87,0 | JamMa: 64,1 / 77,4 / 86,5 | Usahihi wa juu kwa gharama inayofanana |
| HPatches | 65,5 / 75,4 / 84,3 | JamMa: 61,8 / 71,5 / 81,2 | Faida ya baina ya domain; nyuma ya baadhi ya modeli za Transformer |
| ScanNet | 21,0 / 38,4 / 54,4 | JamMa: 18,5 / 35,6 / 51,3 | Ustahimilivu mkubwa katika domain shift ya ndani |
| Aachen | mtl 5,16; mre 1,13 | JamMa: 4,48; 1,19 | Trace ndefu na kosa la chini la reprojection |
Mitambo mikuu iliyoonyeshwa na ablations
- Kubadilisha skanningi iliyowekwa na gated deformable scanning kulitoa mojawapo ya faida kubwa zaidi za kipengele kimoja.
- Gated Index Network ilipoondolewa, AUC@5° ilishuka kutoka 65,2 hadi 63,2.
- Kuchagua nusu ya vipengele badala ya vyote kuliboresha usahihi na muda wa utekelezaji.
- Kuhifadhi robo au moja ya nane tu ya vipengele kulisababisha hasara ndogo katika muda wa kukokotoa lakini hasara kubwa zaidi katika usahihi.
- Canny loss ilitoa mchango mdogo katika MegaDepth yenye tekstua nyingi, lakini mchango wazi zaidi katika ScanNet yenye tekstua dhaifu na jaribio la mitazamo mingi la Aachen.
- Athari ya uchaguzi wa backbone haikuwa kubwa kama uteuzi wa vipengele unaoweza kujifunza.
Maana ya kisayansi ya vielelezo
| Kielelezo | Maudhui yaliyoonyeshwa | Kazi ya kisayansi |
|---|---|---|
| Muhtasari wa grafiki | Uchimbaji wa vipengele, skanningi teule, Mamba, ulinganishaji fine na Canny loss | Kuonyesha pipeline ya GamMa katika mchoro mmoja |
| Kielelezo 1 | Ulinganishaji wa JamMa kwenye ScanNet | Kuonyesha tatizo la ulinganishaji usio sahihi katika domain shift |
| Kielelezo 2 | Usanifu wa jumla wa GamMa | Kueleza mtiririko teule wa Mamba kupitia hatua coarse na fine |
| Kielelezo 3 | Gated Deformable Scanning | Kuonyesha mchakato wa kuchagua nafasi na kuunda mfuatano |
| Kielelezo 4 | Gated Index Network | Kueleza matawi mawili ya convolution na mwingiliano wa gating |
| Kielelezo 5 | Canny Edge Loss | Kuonyesha jinsi target ya ukingo inavyotengenezwa |
| Kielelezo 6 | Ulinganishaji wa LoFTR, JamMa na GamMa | Kutoa ulinganisho wa kimaelezo kwenye MegaDepth |
| Kielelezo 7 | Ramani za joto za skanningi iliyowekwa na deformable | Kuonyesha mkusanyiko wa miitikio ya foreground na mipaka |
| Kielelezo 8 | Nafasi za ulinganishaji kwa na bila Canny loss | Kuonyesha athari ya usimamizi wa kingo katika mandhari yenye tekstua dhaifu |
| Kielelezo 9 | Nafasi K za vipengele vilivyochaguliwa | Kuonyesha kuwa uteuzi hujikusanya katika maeneo ya usanifu na tekstua nyingi |
| Kielelezo 10 | Matokeo ya ScanNet ya JamMa na GamMa | Kuonyesha tofauti ya ujumlishaji wa baina ya domain bila fine-tuning |
Maelezo muhimu kwa uzalishaji upya
- Picha zinapaswa kuwekwa katika ukubwa wa 832 × 832 wakati wa mafunzo.
- Chaneli za vipengele coarse na fine ni 256 na 64 kwa mtiririko huo.
- Blok nne za Mamba na usanidi wa K = 1/2 hutumiwa.
- Vizingiti vya chini na juu vya Canny ni 0,1 na 0,2.
- Kwa Focal loss, α = 0,25 na γ = 2.
- Loss ya subpixel imepewa uzito wa coefficient 104.
- Mafunzo yalifanywa kwa vipindi 60, AdamW, kiwango cha awali cha kujifunza 2 × 10⁻⁴ na batch size 8.
- Katika ulinganisho wa HPatches, ulinganishaji 1.000 wa juu zaidi tu ulitumika kwa kila mbinu.
- Katika majaribio ya MegaDepth na ScanNet, jozi 1.500 za picha zilitathminiwa.
- Ili kuzalisha upya matokeo, orodha ya marejeo iliyokosekana, code, uzito wa modeli na mbegu nasibu zinahitajika.
Tafsiri ya kiufundi ya matokeo
Matokeo ya GamMa yanaonyesha kwamba katika ulinganishaji nusu-mnene wa picha, ubora wa taarifa unaweza kuwa muhimu zaidi kuliko kiasi cha taarifa. Kuingiza vipengele coarse vyote kwenye mfuatano kuliongeza muda na kupunguza usahihi. Kuchagua nusu ya vipengele kulipunguza mwingiliano wenye kelele huku kukihifadhi sehemu kubwa ya ushahidi muhimu wa kijiometri.
Faida kuu ya modeli ni kuboresha ustahimilivu wa JamMa baina ya domain bila kuongeza kwa kiasi kikubwa idadi ya vigezo au mzigo wa kukokotoa. Ingawa faida ya MegaDepth ni ndogo kwa kiasi, tofauti kubwa zaidi katika HPatches na ScanNet zinaashiria kwamba skanningi teule inaweza kuwa na thamani zaidi wakati domain za mafunzo na majaribio zinapotofautiana.
Manufaa ya Canny edge loss yanategemea mandhari. Katika mazingira ya nje yenye tekstua nyingi mchango ulikuwa mdogo sana, huku katika mazingira ya ndani mipaka ya kijiometri ilitoa taarifa ya ziada. Hali hii inaonyesha kwamba regularizer zinazotegemea kingo si zana za ulimwengu wote bali zinategemea hali.
Maelezo ya Chanzo na Mbinu
Jina kamili la asili la utafiti: GamMa: Selecting Informative Features for Fast and Robust Local Feature Matching
Waandishi: Jianhao Xu, Xiangtao Fan, Hongdeng Jian, Chen Xu, Weijia Bei, Qifeng Ge na Ruijie Han.
Mpangilio wa waandishi: Umehifadhiwa kama ulivyotolewa katika chanzo.
Mwandishi mwenza wa kwanza: Hakuna tamko la mchango sawa au uandishi mwenza wa kwanza.
Mwandishi wa mawasiliano: Hongdeng Jian.
Anwani ya barua pepe ya mwandishi wa mawasiliano: jianhd@radi.ac.cn
Anwani nyingine za mawasiliano: xujianhao22@mails.ucas.ac.cn; fanxt@radi.ac.cn; xuchen@aircas.ac.cn; beiweijia21@mails.ucas.ac.cn; geqifeng21@mails.ucas.ac.cn; hanruijie23@mails.ucas.ac.cn.
Taasisi 1: Key Laboratory of Digital Earth Science, Aerospace Information Research Institute, Chinese Academy of Sciences, Beijing 100094, China.
Taasisi 2: International Research Center of Big Data for Sustainable Development Goals, Beijing 100094, China.
Taasisi 3: University of Chinese Academy of Sciences, Beijing 100094, China.
Kiungo rasmi cha chanzo:Ukurasa rasmi wa rekodi ya SSRN
Jukwaa la uchapishaji: SSRN.
Mwaka wa uchapishaji: 2026.
Tarehe iliyotolewa katika maandishi: 25 Juni 2026.
Jarida lengwa: Toleo lililopakiwa lina usemi “Preprint submitted to Pattern Recognition”.
Hali ya jarida na mchapishaji: Hakuna taarifa katika chanzo hiki inayoonyesha kwamba utafiti umekubaliwa na Pattern Recognition au kwamba toleo la jarida lililopitiwa kitaalamu limechapishwa. Kwa hiyo hauwezi kuwasilishwa kama chapisho la jarida lililopitiwa kitaalamu.
Aina ya chanzo: Makala ya utafiti ya preprint inayotengeneza usanifu mpya wa mtandao wa neva kwa ulinganishaji nusu-mnene wa vipengele vya ndani katika computer vision na kuujaribu kwenye seti nne za data.
Hali ya mapitio: Utafiti haujapitia mapitio ya kitaalamu.
Michango ya Jianhao Xu: Uundaji wa dhana, mbinu, uchanganuzi rasmi, usimamizi wa data, uandishi wa rasimu ya awali na utafiti.
Michango ya Xiangtao Fan: Uundaji wa dhana, usimamizi, mapitio na uhariri, uthibitishaji na upatikanaji wa ufadhili.
Michango ya Hongdeng Jian: Uthibitishaji, mapitio na uhariri pamoja na mbinu.
Michango ya Chen Xu: Utoaji wa rasilimali, mapitio na uhariri pamoja na upatikanaji wa ufadhili.
Michango ya Weijia Bei: Mbinu.
Michango ya Qifeng Ge: Programu na uoneshaji.
Michango ya Ruijie Han: Usimamizi wa data.
Ufadhili: Provincial Special Funding for the Construction of Chenzhou National Sustainable Development Agenda Innovation Demonstration Zone, No. 2023sfq69.
Mgongano wa maslahi: Waandishi wametangaza kwamba hakuna maslahi ya kifedha yanayojulikana au uhusiano binafsi ambao ungeweza kuathiri utafiti.
Ufikiaji wa data: Waandishi wameeleza kwamba hawana ruhusa ya kushiriki data.
Ufikiaji wa code: Maandishi yanaeleza kwamba code itachapishwa katika repository ya GitHub. Katika toleo lililopakiwa hakuna toleo lililofungwa la programu, uzito wa modeli au kifurushi cha uzalishaji upya kilichotolewa.
Tatizo la marejeo: Manukuu katika maandishi yanaonekana kama `[?]` na hakuna sehemu ya marejeo. Hali hii inazuia uthibitishaji wa vyanzo asilia vya mbinu zilizotangulia, seti za data na programu zilizotumiwa.
Onyo la ulinganifu wa nambari: Katika HPatches, faida ya kizingiti cha kati ni 3,9 kwenye jedwali lakini imeandikwa 4,9 kwenye maandishi. Faida ya AUC@20° ya Gated Deformable Scanning ni 0,9 kwenye jedwali lakini imetolewa kama 1,9 kwenye maandishi.
Onyo la ulinganifu wa kuona: Maelezo ya Kielelezo 9 yanasema kwamba yanalinganisha usambazaji wa vipengele kwa na bila Canny loss; hata hivyo, kielelezo kinaonyesha tu nafasi K zilizochaguliwa na Gated Index Network.
Kikomo cha tafsiri: GamMa ilitoa matokeo ya juu zaidi miongoni mwa mbinu nusu-mnene kwenye MegaDepth, lakini ilitoa AUC ya chini kuliko DKM na RoMa mnene. Kwenye HPatches ilibaki nyuma kidogo ya LoFTR, ASpanFormer na ELoFTR. Kwa hiyo, utafiti hauthibitishi ubora wa jumla na usio na masharti wa kilinganishi bora zaidi.
Maudhui haya ya Kituruki yameandaliwa kwa kutegemea tu maandishi, milinganyo, majedwali, michoro ya usanifu, vielelezo vya ulinganishaji na matokeo ya majaribio ya utafiti uliopakiwa. Hakuna dai la mafanikio ya uwanjani, utendaji wa bidhaa ya kibiashara, usalama wa mfumo unaojiendesha au usahihi unaohusu Uturuki ambalo halipo katika utafiti lililoongezwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *