

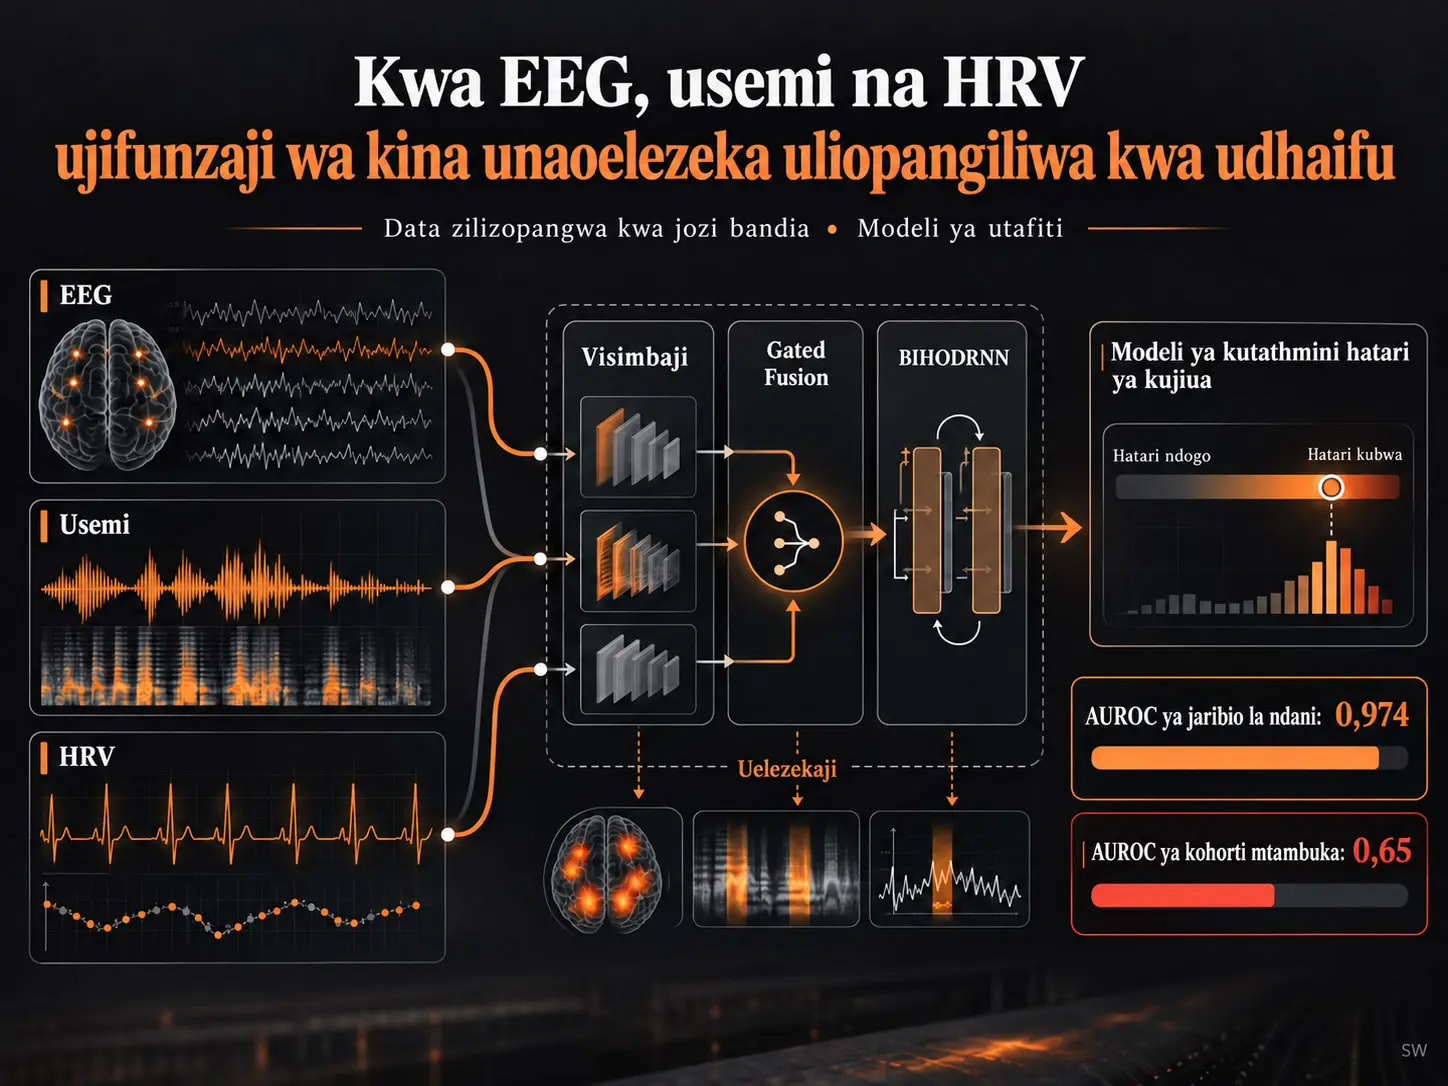
Ujifunzaji wa kina wa namna nyingi uliopangiliwa kwa udhaifu ni mbinu ya ujifunzaji wa mashine inayojaribu kuunganisha kwa majaribio vyanzo tofauti vya data ambavyo havikukusanywa kwa wakati mmoja kutoka kwa mtu yuleyule, ndani ya nafasi ya pamoja ya uwakilishi. Utafiti huu unachukua data za elektroensefalografia (EEG), akustiki ya usemi na ubadilifu wa mapigo ya moyo (heart rate variability, HRV) kutoka makundi matatu huru na kuziunganisha kwa jozi bandia ili kutengeneza mfumo wa ujifunzaji wa kina unaoelezeka kwa ajili ya uainishaji wa hatari ya kujiua. Modeli inaunganisha visimbaji maalumu kwa kila modaliti, utaratibu wa gated fusion unaojirekebisha kulingana na maudhui, mtandao wa neva wa kina unaojirudia wa pande mbili na mpangilio wa juu wa daraja la pili (BIHODRNN), hasara saidizi ya uundaji upya na zana za uelezekaji zinazotegemea SHAP.
Modeli ya modaliti tatu ilitoa katika seti ya ndani ya majaribio usahihi wa %96,80, unyeti wa %95,40, umahususi wa %97,20 na 0,974 AUROC. Hata hivyo, katika tathmini baina ya makundi AUROC ilishuka hadi 0,65; modeli tofauti iliyotabiri data ilitoka katika kundi gani ilipata takriban 0,98 AUROC. Kwa hiyo, utendaji wa juu wa ndani hauwezi kufasiriwa kama modeli ya kliniki ya hatari ya kujiua inayoweza kujumlishwa. Mchango mkuu wa utafiti si alama ya juu ya uainishaji, bali ni kupendekeza mfumo wa utafiti pamoja na vipimo vya uchunguzi vinavyoweza kufichua utendaji unaopotosha katika data zilizopangwa kwa jozi bandia.
Ujifunzaji wa Multimodal wa Jozi Bandia ni Nini?
Ujifunzaji wa multimodal wa jozi bandia ni mbinu ya majaribio ya ujumuishaji wa data inayotegemea kuunda ulinganishaji wa takriban kwa kutumia sifa za kidemografia au lebo wakati modaliti tofauti kama EEG, usemi na HRV hazijakusanywa kutoka kwa mshiriki yuleyule. Kwa kuwa ulinganishaji katika utafiti huu haukufanywa katika kiwango halisi cha mhusika, muundo uliopatikana si seti halisi ya data ya multimodal, na ongezeko la utendaji kati ya modaliti haliwezi kufasiriwa kama ushahidi wa ukamilishanaji halisi wa kibayolojia.
Tatizo kuu la utafiti
Tathmini ya hatari ya kujiua kwa kawaida hutumia mbinu kama mizani ya kujiripoti na mahojiano ya kliniki. Makala inaeleza kuwa kuchunguza data za kifiziolojia na kitabia zenye vipimo vingi kwa ujifunzaji wa mashine kuna thamani ya utafiti katika eneo hili; EEG huwakilisha shughuli za mfumo mkuu wa neva, akustiki ya usemi sifa zinazohusiana na kujieleza na utambuzi, na HRV kazi ya mfumo wa neva wa kujiendesha.
Changamoto kuu ni kutokuwepo kwa seti kubwa ya data ambamo ishara hizi tatu zimekusanywa kutoka kwa watu wale wale na kwa itifaki ileile. Kwa hiyo watafiti waliunganisha kwa jozi bandia data kutoka makundi huru tofauti. Lengo la utafiti si kuonyesha kwamba muundo huu wa data unatengeneza modeli halali kliniki, bali kuchunguza ni kwa kiwango gani alama kubwa za majaribio ya ndani zinaweza kutokana na artefakti wakati vyanzo hivi visivyo sawia vinaunganishwa.
Vyanzo vitatu vya data
| Chanzo cha data | Mshiriki | Hatari chanya | Hatari hasi | Modaliti |
|---|---|---|---|---|
| EMBARC | 2.758 | 1.234 | 1.524 | EEG |
| Kopasi ya usemi | 104 | 48 | 56 | Usemi |
| UK Biobank | 15.768 | 3.842 | 11.926 | HRV |
| Data ya majaribio iliyounganishwa | 2.758 | 1.234 | 1.524 | EEG + usemi + HRV zilizopangwa kwa jozi bandia |
Idadi ya watu 2.758 katika seti iliyounganishwa ya data imechukuliwa kutoka kundi la EEG. Idadi hii haimaanishi kwamba washiriki wote 2.758 wana data za EEG, usemi na HRV kwa pamoja.
Jozi bandia ziliundwaje?
Kwanza data iligawanywa katika seti za mafunzo, uthibitishaji na majaribio katika kiwango cha mhusika. Kisha kwa kila mshiriki wa EEG, rekodi inayolingana kwa kundi la umri, jinsia na lebo ya hatari ilitafutwa katika makundi ya usemi na HRV. Ikiwa kulikuwa na zaidi ya rekodi moja inayofaa, moja ilichaguliwa kwa nasibu; ikiwa ulinganishaji haukupatikana, modaliti husika ilichukuliwa kuwa haipo.
Utaratibu huu hautoi ulinganifu wa wakati au wa kibayolojia. Modaliti zilichakatwa kama mfuatano tofauti na zikaunganishwa tu katika kiwango cha embedding. Watafiti walijaribu kupunguza hatari ya kuvuja kwa data moja kwa moja kwa kufanya ulinganishaji baada ya mgawanyo wa data.
Kwa nini kutokuwa sawa kwa lebo ni muhimu?
Katika kundi la EEG, darasa la hatari chanya lilifafanuliwa kwa Beck Scale for Suicide Ideation (BSS) kama BSS ≥ 6. Kwa upande wa HRV wa UK Biobank, lebo ilitegemea wazo au jaribio la kujiua lililoripotiwa na mhusika mwenyewe ndani ya miezi 12 iliyopita. Thamani zisizo wazi kama BSS 4–5 ziliondolewa upande wa EEG.
Kwa hiyo modeli inaweza kujifunza si tu tofauti za kifiziolojia bali pia itifaki tofauti za uwekaji lebo za makundi. Hali hii ni kichanganyaji muhimu hasa kwa uwezo wa kujumlisha kati ya makundi.
Uchakataji wa awali wa EEG na vipengele
Ishara za EEG zilirekodiwa kwa mfumo wa g.USBamp kwa kiwango cha uchukuaji sampuli cha 256 Hz; elektrodi F3, F4, Cz, P3, P4, T3, T4 na O2 zilitumika. Ishara ghafi zilichakatwa kwa kichujio cha kupitisha bendi cha 1–45 Hz, usafishaji wa artefakti ukafanywa kwa Fast-ICA na ishara zikagawanywa katika epoki za sekunde 4 zenye mwingiliano wa sekunde 2.
Chanzo kinaripoti nguvu ya spektra kamili na ya jamaa, asymmetry ya alfa, entropia ya uhamishaji wa ishara na vipengele vya wavelet. Hata hivyo, ukubwa wa jumla katika jedwali la vipengele haulingani kikamilifu na ukubwa wa ingizo la EEG ulioripotiwa katika usanifu wa modeli; kutokulingana huku ndani ya chanzo kunaelezwa kando hapa chini.
Uandaaji wa ishara za usemi
Data ya usemi ilipatikana kutoka mahojiano yaliyopangwa na washiriki 104. Sauti ilirekodiwa kwa 44,1 kHz na ubora wa 16-bit; upunguzaji wa kelele kwa Non-Negative Matrix Factorization ulitumika, kisha ikagawanywa katika madirisha ya sekunde 10. Ili kuongeza sampuli za mafunzo, madirisha yenye mwingiliano kwa msogeo wa sekunde 5 yalitumika.
Vipengele vya usemi vinajumuisha viambajengo vya prosodi kama marudio ya msingi, nishati, jitter, shimmer na kasi ya usemi; MFCC, vigawo vya tofauti vya kwanza na vya pili na bendi ndogo za msongamano wa nguvu ya spektra. Vigezo vya usanifishaji vilihesabiwa kutoka data ya mafunzo pekee na kutumika kwa seti za uthibitishaji/majaribio.
Vipengele vya HRV
Kwa HRV, badala ya rekodi binafsi za UK Biobank, vipengele vya muhtasari vilivyojumlishwa na kugawanywa kwa tabaka kulingana na kundi la umri, jinsia na lebo ya hatari vilitumika. Vipengele vinajumuisha SDNN, RMSSD na pNN50 katika kikoa cha wakati; VLF, LF, HF na uwiano LF/HF katika kikoa cha masafa; pamoja na viambajengo vya tone-entropy na sample entropy.
Viambajengo vya HRV vyenye usambazaji uliopinda, kwa mfano uwiano LF/HF, vilifanyiwa urekebishaji wa z-score baada ya mabadiliko ya log.
Uoanishaji wa makundi ulifanywa kwa kiwango gani?
Ingawa urekebishaji maalumu kwa modaliti ulitumika, hakuna marekebisho ya wazi ya batch-effect kama ComBat yaliyotumika. Watafiti wanaeleza kuwa makundi hutofautiana kimsingi katika vifaa, itifaki na muundo wa kidemografia; kwa hiyo marekebisho makali yanaweza kuunda artefakti mpya. Matokeo yake, ishara za mabaki maalumu kwa seti ya data zinaweza kutumiwa na modeli.
Mgawanyo wa mafunzo, uthibitishaji na majaribio
Data iliyounganishwa iligawanywa katika kiwango cha mhusika kuwa %70 mafunzo, %10 uthibitishaji na %20 majaribio. Ililenga kuhakikisha kwamba hakuna mshiriki anayejitokeza katika zaidi ya sehemu moja. Uongezaji wa data ulitumika tu baada ya mgawanyo na kwa data ya mafunzo pekee. Uthibitishaji mtambuka wa mikunjo mitano ulitumika kwenye seti ya mafunzo kwa ajili ya upangaji wa hyperparameter.
BIHODRNN Hufanya Nini Katika Modeli Hii?
Bidirectional High-Order Deep Recurrent Neural Network (BIHODRNN) ni mtandao wa neva unaojirudia wa pande mbili na mpangilio wa juu ambapo kila hali iliyofichwa huunganishwa si tu na hatua ya wakati iliyotangulia na inayofuata, bali pia na hatua nyingi za wakati zilizopita na zijazo kupitia uzani tofauti za kujirudia. Katika utafiti, tabaka mbili zilizofichwa na kujirudia kwa daraja la pili zilitumika kwa lengo la kuiga utegemezi wa muda mrefu zaidi katika EEG na usemi.
Visimbaji maalumu kwa modaliti
Kwa EEG, chanzo kinaonyesha ingizo la umbo \(I_{EEG} \in R^{T \times 128}\), na safu ya Conv1D yenye vichujio 64 na ukubwa wa kernel wa 3 pamoja na max-pooling ilitumika. Kwa usemi, ingizo la umbo \(I_{speech} \in R^{T \times 156}\) hupitia Conv1D na pooling zinazofanana. Ingizo la HRV limefafanuliwa kama \(I_{HRV} \in R^{1 \times 32}\) na kuchakatwa kwa tabaka mbili zilizounganishwa kikamilifu zenye vitengo 64 na 32.
Embedding za modaliti kisha zinaprojektiwa katika nafasi ya pamoja ya uwakilishi yenye vipimo 256.
Gated fusion inayojirekebisha kwa maudhui
Kwa kila modaliti, kwanza huhesabiwa alama ya ufaafu:
\[ s_m = v_m^{\top}H_m \]
Hapa \(H_m\) ni embedding ya modaliti \(m\) katika nafasi ya pamoja ya uwakilishi; \(v_m\) ni vekta ya projeksheni inayojifunzwa wakati wa mafunzo.
Uzani wa modaliti husawazishwa kwa softmax:
\[ \alpha_m = \frac{\exp(s_m)}{\sum_k \exp(s_k)} \]
Uwakilishi uliounganishwa:
\[ H_{fused} = \sum_m \alpha_m H_m \]
Muundo huu hurekebisha kwa nguvu mchango wa jamaa wa modaliti ili \(\sum_m \alpha_m = 1\). Katika uchambuzi wa ndani wa utafiti, uzani wa wastani ulikuwa 0,52 kwa EEG, 0,31 kwa usemi na 0,17 kwa HRV.
Chanzo kinasema kuwa kuweka embedding ya modaliti inayokosekana kuwa sifuri husababisha uzani wa softmax pia kuwa sifuri. Hata hivyo, mlinganyo wa softmax uliotolewa peke yake hauhakikishi hili kihisabati; masking ya ziada inahitajika kwa uzani wa sifuri. Nyenzo ya ziada inataja mkakati wa masking lakini mlinganyo mkuu hauonyeshi maski waziwazi.
Mlinganyo wa hali iliyofichwa wa BIHODRNN
Kwa safu \(l\) na hatua ya wakati \(t_n\), mlinganyo wa hali iliyofichwa uliotolewa katika chanzo ni:
\[ H^l(t_n)=\phi\left( V^{l,F}H^{l-1}(t_n) +\sum_{m=1}^{M}V_m^{l,RB}H^l(t_{n-m}) +\sum_{m=1}^{M}V_m^{l,RF}H^l(t_{n+m}) +b^l \right) \]
\(H^0(t_n)=H_{fused}(t_n)\) ni ingizo la modeli. \(\phi\) ni uamilishaji wa tanh. \(V^{l,F}\) huwakilisha matriki ya uzani wa feed-forward kutoka safu iliyotangulia, \(V_m^{l,RB}\) uzani wa kujirudia wa hatua za wakati zilizopita, \(V_m^{l,RF}\) uzani wa kujirudia wa hatua za wakati zijazo, na \(b^l\) vekta ya bias.
Katika RNN ya kawaida ya pande mbili kujirudia huwa kwa daraja la kwanza, lakini katika BIHODRNN \(M>1\) inaweza kuchaguliwa. Katika utafiti \(M=1,2,3\) zilijaribiwa; \(M=2\) ilichaguliwa kwa sababu iliongeza AUROC ya uthibitishaji kwa 0,012 ikilinganishwa na \(M=1\), huku \(M=3\) ikitoa faida ya ziada ya 0,003 pekee lakini ikiongeza idadi ya vigezo kwa takriban %50.
Pato la modeli
Pato la hatua ya wakati katika safu ya juu iliyofichwa limefafanuliwa katika chanzo kama:
\[ O(t_n)=\sum_{j=1}^{N_L}V_{1,j}^{L,F}H_j^L(t_n) \]
Pato la mfuatano kisha hupitishwa kwenye safu ya dropout yenye \(p=0,5\) na kwenye kiainishaji cha softmax chenye madarasa mawili.
Hasara saidizi ya uundaji upya
Ili kuhimiza embedding ya kila modaliti kuhifadhi taarifa ya modaliti asilia, decoder tofauti hutumika:
\[ L_{aux}= \sum_{m \in \{EEG,\,speech,\,HRV\}} \left\|I_m-Decoder_m(H_m)\right\|_2^2 \]
Tabaka za deconvolution zilitumika katika decoder za EEG na usemi; upande wa HRV tabaka zilizounganishwa kikamilifu zilitumika. Uzani wa hasara saidizi ni \(\lambda=0,1\).
Lengo kuu la mafunzo:
\[ L=L_{BCE}+\lambda L_{aux} \]
limewasilishwa kwa namna hiyo. Katika uwasilishaji wa kina wa algoriti ya mafunzo, pia huongezwa neno la regularization \(L_{reg}\).
Mbinu na Matokeo ya Utafiti
Mipangilio ya mafunzo ya modeli
| Kigezo | Thamani |
|---|---|
| Optimizer | Adam |
| Learning rate | 10-4 |
| Adam β1 / β2 | 0,9 / 0,999 |
| Batch size | 64 |
| Epoch ya juu zaidi | 200 |
| Early stopping patience | 20 |
| Dropout | 0,5 |
| L2 weight decay | 10-4 |
| Gradient clipping | Norm 1,0 |
| Auxiliary loss λ | 0,1 |
| Uanzishaji | Xavier uniform |
| Uzani wa darasa | Kinyume cha marudio ya darasa |
| Framework | PyTorch 1.13 |
| CUDA | 11.7 |
| GPU | NVIDIA A100 |
Utendaji wa majaribio ya ndani kwa modaliti
| Modeli | Usahihi (%) | Unyeti (%) | Umahususi (%) | F1 (%) | AUROC | %95 KI |
|---|---|---|---|---|---|---|
| EEG | 91,20 | 89,40 | 92,80 | 90,20 | 0,941 | 0,932–0,950 |
| Usemi | 85,60 | 83,20 | 87,80 | 84,40 | 0,892 | 0,875–0,909 |
| HRV | 79,40 | 76,80 | 81,90 | 78,20 | 0,843 | 0,821–0,865 |
| EEG + Usemi | 93,80 | 92,10 | 95,40 | 93,00 | 0,958 | 0,949–0,967 |
| EEG + HRV | 92,60 | 91,00 | 94,10 | 91,80 | 0,949 | 0,938–0,960 |
| Usemi + HRV | 88,40 | 86,50 | 90,20 | 87,60 | 0,912 | 0,898–0,926 |
| EEG + Usemi + HRV | 96,80 | 95,40 | 97,20 | 96,10 | 0,974 | 0,968–0,980 |
Vipindi vya kujiamini vya %95 vilihesabiwa kwa sampuli upya za bootstrap 1.000. Jaribio la DeLong lilitumika kwa tofauti za AUROC. Chanzo kinaripoti p<0,05 kwa jozi isipokuwa ulinganisho wa EEG+Usemi na EEG+HRV; kwa ulinganisho huo kinatoa p=0,06. Hata hivyo, watafiti wanasisitiza kwamba sampuli zilizopangwa kwa jozi bandia zinaweza kukiuka dhana ya uhuru na vipindi hivi vya kujiamini vinaweza kutoa taswira ya upotoshaji ya uthabiti.
Matriki ya mkanganyiko
Katika matriki ya mkanganyiko ya majaribio ya ndani ya modeli iliyounganishwa, 498 true positive, 24 false negative, 15 false positive na 523 true negative ziliripotiwa. Jumla ya sampuli za majaribio ni 1.060. Thamani hizi zinaendana na unyeti wa %95,4, umahususi wa %97,2 na usahihi wa %96,8 ulioripotiwa katika chanzo.
Matokeo ya SHAP na uelezekaji
Katika uchambuzi wa SHAP, chanzo kinaonyesha nguvu ya high-gamma katika F4 na Cz, MFCC-2, uwiano LF/HF na nguvu ya Fz theta miongoni mwa vipengele vyenye ushawishi mkubwa. Jitter, RMSSD, asymmetry ya alfa, MFCC-5 na SDNN pia ziko katika nafasi za juu.
Uthabiti wa maelezo ya SHAP ulipimwa kwa kuongeza kelele ndogo ya Gauss na uhusiano wa 0,89 ± 0,04 uliripotiwa kati ya viwango vya umuhimu vya awali na vilivyopotoshwa. Kwa jaribio la Faithfulness, uhusiano wa Spearman kati ya umuhimu wa kipengele na kushuka kwa AUROC wakati kipengele kilipofanyiwa permutation ulipatikana kuwa \(\rho=0,78\), p<0,001.
Vipengele muhimu zaidi vya SHAP vilipoondolewa, AUROC ilishuka kutoka 0,974 hadi 0,952. Hata hivyo, utafiti haudai kwamba vipengele hivi ni biomarker za kisababishi au zilizothibitishwa kliniki; matokeo yanakubaliwa tu kama maelezo ya tabia ya modeli.
Ukalibishaji na ustahimilivu wa kelele
Katika data ya ndani, Expected Calibration Error (ECE) iliripotiwa kuwa 0,032. Thamani za ECE kwa kila kundi ni 0,028 kwa EEG, 0,035 kwa usemi na 0,040 kwa HRV. Hata hivyo, ukalibishaji haukuthibitishwa kando chini ya mabadiliko ya kundi.
Katika jaribio la ustahimilivu kwa kelele ya Gauss, modeli iliyounganishwa ilidumisha usahihi wa zaidi ya %93 katika kiwango cha 10 dB SNR. Jaribio hili haliwakilishi artefakti zote za maisha halisi; artefakti ya EEG inayotokana na mwendo, kelele ya mazingira ya usemi au miundo kama ECG baseline wander haikujaribiwa kando.
Je, AUROC ya Juu ya Ndani Inamaanisha Mafanikio ya Kliniki?
Hapana. AUROC ya 0,974 inaonyesha utendaji katika data ya ndani ya majaribio iliyopangwa kwa jozi bandia pekee; kushuka kwa AUROC hadi 0,65 inapohamishwa kwenye makundi huru na uwezo wa kutabiri utambulisho wa kundi kwa takriban 0,98 AUROC kunaonyesha kuwa modeli inatumia sana mifumo maalumu kwa kundi. Kwa hiyo utafiti hauwasilishi modeli yake kama chombo kilichothibitishwa kliniki kwa tathmini ya hatari ya kujiua.
Uwezo wa kujumlisha baina ya makundi
| Makundi ya mafunzo | Kundi la majaribio | AUROC | %95 KI |
|---|---|---|---|
| EEG + Usemi | HRV | 0,65 | 0,62–0,68 |
| EEG + HRV | Usemi | 0,71 | 0,68–0,74 |
| Usemi + HRV | EEG | 0,73 | 0,70–0,76 |
AUROC ya chini zaidi ya 0,65 ni upotevu mkubwa wa utendaji ikilinganishwa na 0,974 katika majaribio ya ndani. Tathmini ya domain-adversarial pia ilitoa takriban 0,65 AUROC.
Kwa nini utambulisho wa kundi ni udhibiti muhimu?
Jaribio la uainishaji wa kundi lililotabiri sampuli ilitoka katika seti gani ya data kwa kutumia vipengele vilevile vya modeli lilipata takriban 0,98 AUROC. Matokeo haya yanaonyesha kuwa vyanzo vya data vya EEG, usemi na HRV ni tofauti kiasi kwamba modeli inaweza kuvitofautisha kwa urahisi.
Kwa hiyo, utendaji wa juu wa ndani wa modeli iliyounganishwa hauonyeshi kwamba imejifunza mifumo ya kibayolojia inayohusiana na hatari ya kujiua pekee. Tofauti za makundi kama vifaa, kiwango cha uchukuaji sampuli, demografia, itifaki ya ukusanyaji data na ufafanuzi wa lebo zinaweza kuchangia uainishaji.
Mabadiliko ya usambazaji
Uchambuzi wa Maximum Mean Discrepancy (MMD) ulitoa 0,84 kwa EEG–usemi, 0,91 kwa EEG–HRV na 0,79 kwa usemi–HRV. Katika uonyeshaji wa t-SNE pia iliripotiwa kuwa makundi yaliunda klasta tofauti. Umbali wa Wasserstein ulikuwa kati ya 2,34 na 4,87.
Chanzo kinataja vifaa vya ukusanyaji data, kiwango cha uchukuaji sampuli na tofauti za kidemografia miongoni mwa sababu za domain shift hii.
Udhibiti hasi ulionyesha nini?
| Uchambuzi | AUROC | %95 KI | Tafsiri ya chanzo |
|---|---|---|---|
| Jozi za nasibu | 0,525 | 0,498–0,552 | Haina tofauti kubwa na bahati; p=0,41 |
| Kuchanganya lebo | 0,502 | 0,478–0,526 | Hakuna ujifunzaji kutoka lebo za nasibu |
| Modeli asilia iliyounganishwa | 0,974 | 0,968–0,980 | Ishara yenye nguvu katika data ya ndani |
Udhibiti huu unaonyesha kwamba utendaji wa ndani haujatokana tu na jozi za nasibu au artefakti ya lebo za nasibu. Hata hivyo, majaribio ya uainishaji wa kundi na makundi mtambuka yanaendelea kuonyesha kwamba sehemu muhimu ya ishara iliyojifunzwa inaweza kuwa maalumu kwa seti ya data. Kwa hiyo udhibiti hasi hauthibitishi kuwepo kwa biomarker ya kliniki inayoweza kujumlishwa.
Utafiti wa ablation
| Lahaja ya modeli | AUROC | Δ AUROC |
|---|---|---|
| Modeli kamili | 0,974 | – |
| Bila gated fusion | 0,961 | -0,013 |
| Bila BIHODRNN | 0,944 | -0,030 |
| Bila SHAP | 0,973 | -0,001 |
| Bila hasara saidizi | 0,968 | -0,006 |
| Bila uongezaji wa data | 0,965 | -0,009 |
Kuondoa BIHODRNN kulisababisha upotevu mkubwa zaidi wa AUROC wa usanifu. Gated fusion ilitoa mchango mdogo lakini unaopimika. Majaribio ya ablation yalirudiwa kwa seed tano tofauti za nasibu na mikengeuko ya kawaida ya AUROC iliripotiwa kuwa chini ya 0,005. Katika ulinganisho isipokuwa kuondoa SHAP, p<0,05; SHAP ilipoondolewa p=0,32 iliripotiwa. Waandishi wanasisitiza kwamba thamani hizi za p zinatokana na majaribio yanayorudiwa kwenye seti ileile ya data na hazitatui tatizo la jozi bandia.
Tabaka za hatari si vizingiti vya kliniki
Kwa madhumuni ya tathmini ya majaribio, uwezekano wa modeli uligawanywa katika makundi matatu: thamani chini ya 0,33 ziliwekwa kama hatari ndogo, 0,33–0,67 kama ya kati na zaidi ya 0,67 kama hatari kubwa. Vizingiti hivi vilitokana na percentiles za seti ya uthibitishaji na havipendekezwi kwa matumizi ya kliniki. Chanzo kinaeleza wazi kwamba ukalibishaji upya utahitajika katika matumizi yoyote ya maisha halisi.
Kutokulingana ndani ya chanzo kunakoathiri uwezo wa kurudia matokeo
| Mada | Hali inayoonekana katika chanzo | Tafsiri ya Verianla |
|---|---|---|
| Ukubwa wa vipengele vya EEG | Majedwali ya vipengele yanatoa jumla ya vipengele 164; ingizo la usanifu linaonyeshwa kama 128. | Hatua ya kupunguza/kuchagua vipimo haijaelezwa wazi. |
| Ukubwa wa vipengele vya usemi | Majedwali ya vipengele yanatoa jumla ya vipengele 200; ingizo la usanifu linaonyeshwa kama 156. | Haijaelezwa kama ukubwa wa MFCC ulitumika badala ya ingizo lote. |
| Elektrodi za EEG | F3, F4, Cz, P3, P4, T3, T4, O2 zimeorodheshwa; katika matokeo ya SHAP Theta Fz inaripotiwa. | Jinsi Fz ilivyopatikana haijaelezwa katika chanzo. |
| Softmax ya modaliti inayokosekana | Inasemekana embedding ya sifuri hutoa uzani wa softmax wa sifuri. | Katika mlinganyo uliotolewa, hili halitokei kihisabati bila maski. |
| Idadi ya vigezo vya BIHODRNN | Vigezo 525.312 vinaripotiwa. | Maelezo ya kihesabu kwa vipimo vya matriki vilivyotolewa katika maandishi hayawezi kuzalisha wazi jumla hii. |
| Vipindi vya kujiamini vya ROC | Baadhi ya vipindi vya kujiamini vya %95 katika mchoro wa ROC na Jedwali 6 vinatofautiana. | Jedwali linapaswa kupewa kipaumbele kama chanzo cha thamani sahihi. |
Hitimisho zinazoungwa mkono na utafiti
Utafiti unaunga mkono kwamba data zisizo sawia za EEG, usemi na HRV zinaweza kuchakatwa katika mtiririko mmoja wa majaribio wa ujifunzaji wa kina; vipengele vya gated fusion, BIHODRNN na hasara saidizi vinatoa mchango unaopimika kwa utendaji wa data ya ndani; na pia kwamba uchambuzi wa makundi mtambuka, uainishaji wa kundi, negative-control na mabadiliko ya usambazaji ni muhimu katika kufichua utendaji wa ndani unaopotosha.
Hitimisho ambazo utafiti hauungi mkono
Utafiti hauonyeshi kwamba modeli inatabiri kwa kuaminika hatari ya kujiua kliniki, kwamba inafanya fusion halisi ya multimodal, kwamba vipengele vya SHAP ni biomarker za kisababishi, kwamba mfumo unaweza kujumlishwa katika hospitali na jamii tofauti, kwamba algoriti ni ya haki, au kwamba vizingiti vilivyoripotiwa vinaweza kutumiwa kwa maamuzi ya kliniki.
Kikomo cha maadili na usalama
Utafiti haukukusanya data mpya za wagonjwa na haukufanya uingiliaji wa kliniki. Inaripotiwa kwamba tafiti za chanzo zilizotumika zilipata idhini ya maadili na ridhaa yenye taarifa; katika uchambuzi wa sasa zilitumika data zisizotambulisha watu au zilizojumlishwa. Waandishi wanaeleza wazi kwamba modeli haipaswi kutumiwa kwa uchunguzi, maamuzi ya matibabu au tathmini ya hatari ya kujiua ya mtu binafsi katika maisha halisi.
Mahitaji ya utafiti wa baadaye
Kipaumbele cha juu cha waandishi ni seti halisi ya data ya multimodal iliyooanishwa kwa mhusika ambapo EEG, usemi na HRV hukusanywa kutoka washiriki wale wale kwa lebo za kliniki zinazofanana. Pia inapendekezwa uthibitishaji wa nje huru na wa vituo vingi, domain adaptation na uoanishaji, tafiti za mbele za muda mrefu, seti kubwa zaidi za data ya usemi, ukaguzi rasmi wa fairness, uelezekaji uliotathminiwa na wataalamu, ukalibishaji na uchaguzi wa vizingiti wenye msingi wa kliniki, ustahimilivu kwa artefakti za maisha halisi, na uchunguzi wa kimfumo wa hali za modaliti zinazokosekana.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: Explainable Weakly-Aligned Deep Learning for Suicide Risk Assessment Using Pseudo-Paired EEG, Speech, and HRV Data.
Waandishi: Fatemeh Charoosaei na Fatemeh Rajabi.
Mwandishi wa mawasiliano: Fatemeh Charoosaei.
Uhusiano wa taasisi katika PDF: Fatemeh Charoosaei — Department of Computer Engineering, Yazd University, Yazd, Iran. Fatemeh Rajabi — Department of Medical Sciences, Isfahan University of Medical Sciences, Isfahan, Iran.
Tofauti ya uhusiano wa taasisi wa bibliografia: Rekodi ya sasa ya SSRN inamhusisha Fatemeh Rajabi na Manchester Metropolitan University. Tofauti hii kati ya PDF na rekodi ya SSRN inapaswa kuhifadhiwa kama ilivyo katika chanzo.
Jukwaa: SSRN.
Nambari ya rekodi ya SSRN: 7331268.
DOI: 10.2139/ssrn.7331268.
Tarehe ya kuwasilisha: 27 Agosti 2026.
Aina ya chanzo: Preprint ya utafiti wa mbinu za ujifunzaji wa kina; uchambuzi wa nyuma wa data za sekondari na proof-of-concept.
Hali ya mapitio ya rika: Haijapitia mapitio ya rika.
Leseni: PDF ya chanzo na rekodi ya SSRN iliyothibitishwa hazionyeshi leseni ya wazi ya Creative Commons au leseni sawia ya matumizi tena.
Ufadhili: Waandishi waliripoti kwamba hakuna ufadhili uliopokelewa kwa utafiti.
Mgongano wa maslahi: Waandishi walitangaza kwamba hakuna maslahi yanayoshindana.
Maadili: Utafiti unatumia data zilizokusanywa awali na zisizotambulisha watu. Inaripotiwa kwamba vyanzo vya awali vya data vilipata idhini ya maadili na ridhaa yenye taarifa; kwa uchambuzi wa sasa, idhini ya ziada ya kamati ya maadili haikuhitajika.
Vyanzo vya data: Data ya EMBARC EEG kupitia NIMH Data Archive; taarifa ya UK Biobank HRV katika umbo la vipengele vya muhtasari vilivyojumlishwa; na kopasi ya usemi ya MODMA imeripotiwa kupatikana kwa matumizi ya utafiti kwa utaratibu ulioelezwa katika chanzo.
Michango ya waandishi: Fatemeh Charoosaei — uundaji wa dhana, mbinu, programu, uchambuzi rasmi, rasimu ya kwanza na uonyeshaji. Fatemeh Rajabi — uthibitishaji, uchunguzi, uratibu wa data na mapitio/uhariri.
Vipengele vikuu vya modeli: Visimbaji maalumu kwa modaliti, uwakilishi wa pamoja wa vipimo 256, softmax gated fusion inayojirekebisha kwa maudhui, BIHODRNN ya tabaka mbili na daraja la pili, dropout, kiainishaji cha softmax na reconstruction decoder saidizi maalumu kwa modaliti.
Vipimo vikuu vya tathmini: Accuracy, sensitivity, specificity, F1-score, AUROC, vipindi vya kujiamini vya %95 na Expected Calibration Error.
Mbinu kuu za takwimu: Vipindi vya kujiamini vya bootstrap vya marudio 1.000, ulinganisho wa DeLong AUROC, uendeshaji unaorudiwa na paired t-test katika majaribio ya ablation, na uhusiano wa Spearman katika uchambuzi wa SHAP faithfulness.
Kikomo kikuu cha kimetodolojia: EEG, usemi na HRV hazikutoka kwa watu wale wale. Kwa sababu ya muundo wa jozi bandia, utofauti wa makundi na ufafanuzi tofauti wa lebo za hatari, haijaonyeshwa kwamba modeli imejifunza kazi halisi ya pamoja ya hatari ya kujiua.
Kikomo cha kliniki: Modeli haijapitia uthibitishaji wa nje, uthibitishaji wa mbele, matumizi halisi ya kliniki au tathmini ya udhibiti. Chanzo kinasema wazi kwamba modeli haipaswi kutumiwa kwa kufanya maamuzi ya kliniki au kutabiri hatari ya mtu binafsi.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *