

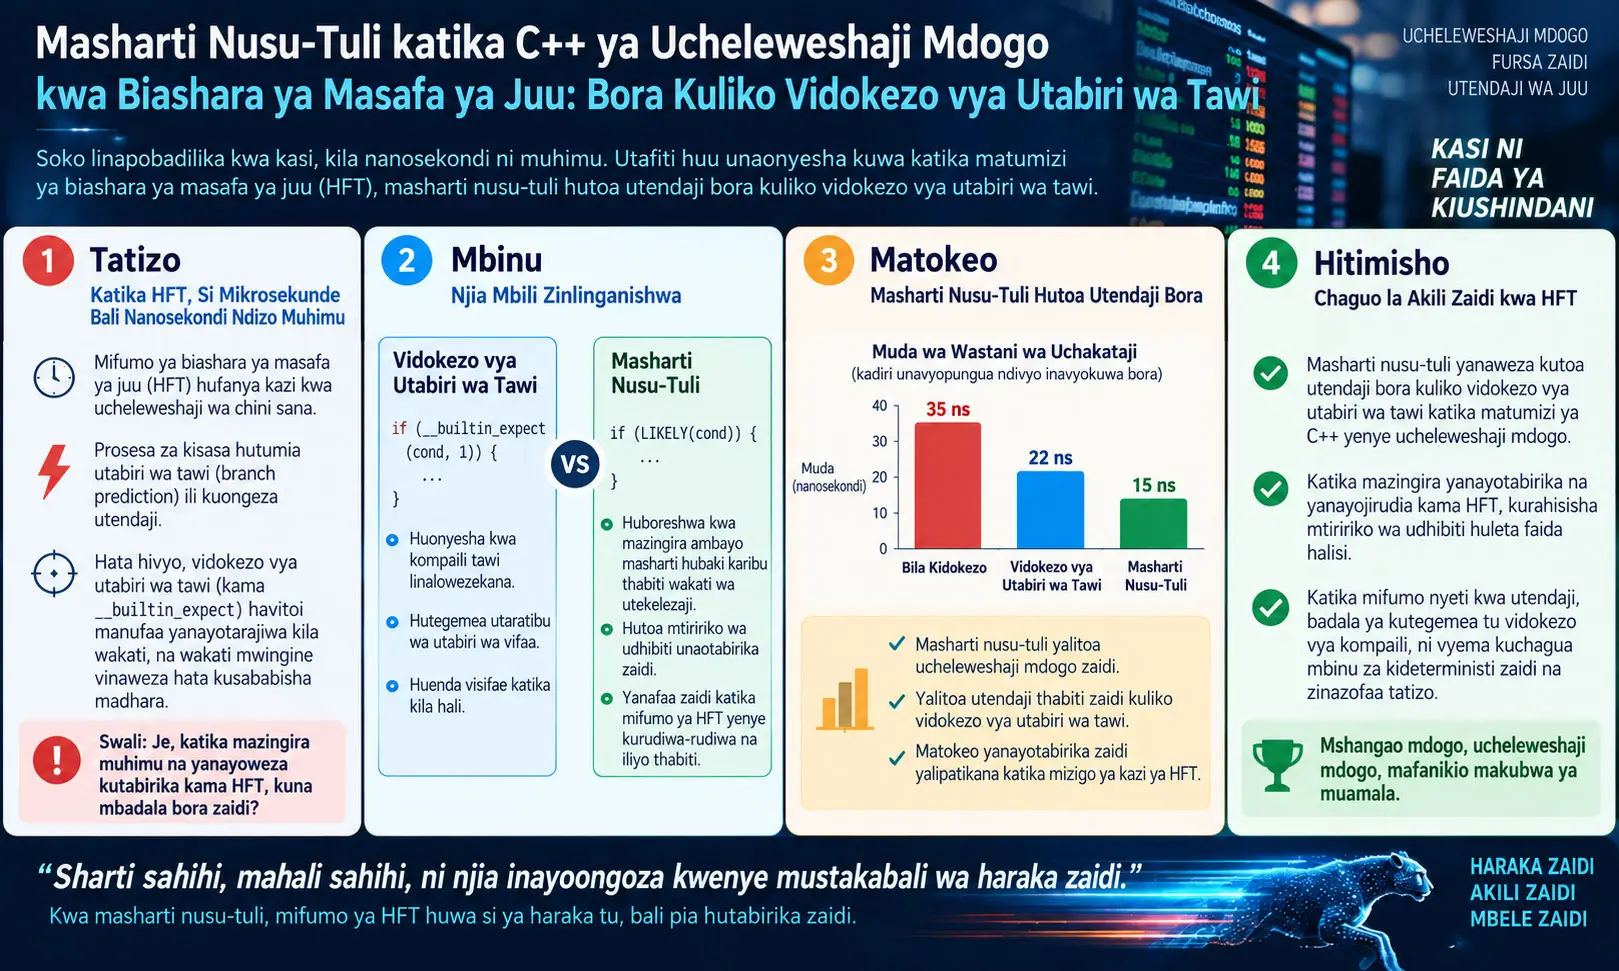
Sharti nusu-tuli (semi-static condition) ni muundo wa mtiririko wa udhibiti wa C++ unaobadilisha lengo la mruko wa relatif katika msimbo wa mashine wa faili tekelezi inayoendelea kufanya kazi, ili kubadilisha mwelekeo wa utekelezaji unaochaguliwa wakati wa uendeshaji bila kuhitaji tathmini ya kawaida ya tawi lenye sharti katika njia ya msimbo nyeti kwa ucheleweshaji. Mbinu iliyotengenezwa na Paul Alexander Bilokon, Maximilian Lucuta na Erez Shermer inalenga kuhamisha tathmini ghali ya sharti na operesheni ya kubadilisha msimbo wa mashine kwenda kwenye njia isiyo muhimu sana kwa utendaji, huku ikiufanya mwito wa branch kwenye njia muhimu kuwa mruko wa relatif wenye gharama inayokaribia mwito wa moja kwa moja wa function.
Wazo kuu la utafiti ni kwamba, badala ya kujaribu kufanya vichakataji vya kisasa vitabiri matawi yenye masharti kwa usahihi zaidi kila mara, katika baadhi ya hali za matumizi tawi lenye sharti ambalo lingehitaji kutabiriwa linaondolewa kabisa kwenye njia muhimu ya utekelezaji. Kwa hili, operesheni ya set_direction huamua mapema ni function ipi itakayotekelezwa na huandika offset ya mruko wa relatif ya 32-bit inayolingana ndani ya msimbo unaoendelea kufanya kazi; baadaye, mwito wa branch huelekea kwenye lengo hilo bila kutathmini sharti tena.
Katika microbenchmark zilizofanywa kwenye Intel Core i7-10700, gharama ya median ya mwito wa moja kwa moja wa function ilipimwa kuwa mizunguko 9 ya CPU, median ya mwito wa nusu-tuli wa branch kuwa mizunguko 10, na mkengeuko sanifu wa zote mbili kuwa mzunguko 1. Katika jaribio la njia moto yenye pande mbili inayofanana na HFT, yenye hali za nasibu na ngumu kutabiri, bila cache warming tawi la kawaida lenye sharti lilionyesha median ya mizunguko 75 na mkengeuko sanifu wa mizunguko 10, wakati masharti nusu-tuli yalionyesha median ya mizunguko 63 na mkengeuko sanifu wa mizunguko 3. Kwa cache warming, thamani zilikuwa 68±8 na 62±2 mizunguko mtawalia.
Faida hii si ya masharti yote. Kubadilisha msimbo wa mashine unaoendelea kutekelezwa kunaweza kuchochea taratibu za self-modifying code (SMC). Katika jaribio ambapo msimbo uliobadilishwa ulitekelezwa mara moja baada ya mabadiliko ya assembly, athari za SMC machine clear ziliongeza muda wa utekelezaji kwa takriban mara 30–40 na adhabu za ziada za takriban mizunguko 100 zikaonekana. Kwa hiyo, mbinu hii haifai kwa loops zinazobana ambapo mwelekeo wa branch hubadilishwa mara kwa mara na kisha kutekelezwa mara moja. Mfano wa matumizi unaopendekezwa na utafiti ni kuhamisha operesheni ghali ya set_direction kwenda kwenye njia “baridi” na kutumia operesheni ya bei nafuu ya branch kwenye njia “moto” nyeti kwa ucheleweshaji.
Sharti Nusu-Tuli Ni Nini?
Sharti nusu-tuli ni muundo wa kimfumo wa mtiririko wa udhibiti unaotenganisha tathmini ya sharti na utekelezaji wa tawi la msimbo lililochaguliwa kuwa operesheni mbili tofauti kwa muda, kisha kulita tawi lililochaguliwa kupitia mruko wa relatif wa msimbo wa mashine. Sehemu ya “tuli” ni kwamba lengo huwa tayari limeamuliwa wakati wa mwito muhimu wa branch; sehemu ya “nusu” ni kwamba programu inaweza kubadilisha tena lengo hilo wakati wa uendeshaji kwa kutumia set_direction.
Kimantiki, usemi wa kawaida wa masharti katika C++ hufanya hivi: kichakataji husoma sharti, hufanya ulinganisho, hufika kwenye amri ya mruko wenye sharti, na branch predictor hutabiri ni njia ipi itafuata. Ikiwa utabiri ni sahihi gharama huwa ndogo; ikiwa si sahihi, maelekezo yaliyopakuliwa kwa ubashiri na kuchakatwa kwa sehemu yanaweza kulazimika kusafishwa.
Katika mbinu ya nusu-tuli, sharti hutathminiwa kabla ya njia muhimu kuanza. Programu huamua ni function ipi itakuwa lengo na hubadilisha, kwenye entry point ya branch, sehemu ya displacement ya amri ya relatif ya jmp. Tukio muhimu linapotokea, sharti halisomwi tena; mtiririko wa udhibiti hupelekwa moja kwa moja kwenye function iliyochaguliwa mapema.
Kwa nini branch predictor ya kawaida haikuonekana kutosha?
Branch predictor za kisasa zinaweza kutabiri matawi mengi kwa usahihi wa juu sana. Utafiti huu unaangazia hasa matawi yasiyo na uhusiano mkubwa na historia, yanayotegemea data ya ingizo, au yanayotekelezwa mara chache kiasi kwamba hayatengenezi historia ya kutosha. Tatizo hili ni muhimu katika mifumo ya ucheleweshaji mdogo kama HFT, kwa sababu njia muhimu inaweza isiendeshe kila wakati, lakini inapotekelezwa inapaswa kuwa na ucheleweshaji mdogo na unaotabirika kadiri iwezekanavyo.
Sifa za C++20 za [[likely]] na [[unlikely]] hazitatui tatizo hili kwa kutuma amri ya moja kwa moja kwa branch predictor ya hardware kwamba “tabiri tawi hili.” Kama ilivyoelezwa katika chanzo, compiler hutumia taarifa hii kubadilisha mpangilio wa msimbo na muundo wa assembly wa njia moto/baridi zinazowezekana. Ikiwa usambazaji wa hali wakati wa uendeshaji hubadilika baadaye, chaguo hili la wakati wa compilation halisasishwi kwa njia ya dynamic.
Masharti Nusu-Tuli Hutofautianaje na Utabiri wa Tawi?
Masharti nusu-tuli hayajaribu kuboresha ubashiri wa matokeo ya tawi lenye sharti; badala yake, hubadilisha amri ya tawi lenye sharti kwenye njia muhimu kuwa mruko wa moja kwa moja wa relatif ambao mwelekeo wake unaweza kubadilishwa na programmer. Hivyo, makosa ya kawaida ya utabiri wa tawi lenye sharti yanayotatuliwa katika hatua ya execute hubadilishwa na marekebisho ya lengo ya BTB/BAC ambayo yanaweza kujitokeza mapema zaidi wakati lengo linapobadilishwa.
Muundo wa BranchChanger
Katika prototype, abstraction kuu ni class ya BranchChanger. Class hupokea anwani mbili za function mwanzoni. set_direction(condition) huamua ni lengo lipi litakuwa active kulingana na sharti la wakati wa uendeshaji; branch(...) huenda kwenye lengo lililochaguliwa.
Aina za argument na return za function hupatikana kupitia template deduction. Hivyo signature ya entry point ya branch hulinganishwa na calling convention ya function lengwa. Chanzo kinaeleza tatizo la awali la register shift lililotokana na function ya kawaida ya member kuunda pointer ya siri ya this, na katika prototype ya msingi kuchagua kuifanya method ya branch kuwa static.
Offset ya mruko wa relatif
Katika taratibu za relatif za jmp/call kwenye usanifu wa x86, anwani lengwa haikodishwi moja kwa moja kama anwani kamili, bali kama displacement inayohusiana na nafasi ya sasa ya instruction. Uhusiano wa msingi unaotumiwa katika chanzo ni huu:
Jump Offset ni umbali wa relatif utakaoandikwa kwenye amri ya mashine. Target Address ni anwani ya kuingia ya function ya if/else itakayotekelezwa. Entry Point ni sehemu ya kuingia ya branch inayobadilishwa; Size of Instruction ni urefu wa amri ya mruko wa relatif. Katika utekelezaji wa x86, kazi hutumia opcode ya baiti moja ya e9 ikifuatiwa na sehemu ya displacement ya baiti nne.
Hisabati hii inaonyesha kwa nini tabia ya branch si suala la kubadilisha Boolean variable pekee. Programu hubadilisha msimbo halisi wa mashine kwa kuzingatia nafasi ya executable code segment, anwani ya function lengwa na urefu wa instruction.
Msimbo unaoendelea kufanya kazi hubadilishwaje?
Maelekezo ya mashine kwa kawaida hupatikana katika executable/text pages za virtual address space na huwa zimefungwa dhidi ya uandishi. Prototype hutafuta page husika kutoka kwenye anwani ya function ya branch wakati wa uendeshaji, hubadilisha ruhusa za page kwa kutumia Linux mprotect, na kuifanya displacement ya mruko wa relatif iweze kuandikwa.
Kwa sababu ya Address Space Layout Randomization (ASLR), anwani halisi ya runtime ya executable code haichukuliwi kuwa ya kudumu mapema. Kwa hiyo, address resolution na page alignment hufanywa wakati programu inaendelea kufanya kazi.
Kwa Nini Branch-Changing na Branch-Taking Hutenganishwa?
Operesheni hizo mbili hutenganishwa kwa sababu kubadilisha mwelekeo wa branch ni operesheni ghali kiasi inayohitaji kuandika kwenye executable memory inayotumika, ilhali branch-taking, ikiwa hali imeandaliwa vizuri, inaweza kupunguzwa hadi gharama ya mruko mfupi wa relatif unaoongezwa kwenye mwito wa moja kwa moja wa function. Mkakati wa uboreshaji wa chanzo ni kuamortize operesheni ghali kwenye msimbo usio nyeti kwa ucheleweshaji na kuacha operesheni nafuu pekee kwenye njia muhimu.
Adhabu ya self-modifying code
Ingawa vichakataji vinaunga mkono kubadilisha msimbo unaotekelezwa, instruction cache, pipeline na hali zinazohusiana za speculation zinaweza kutolingana na maelekezo yaliyobadilishwa. Majaribio katika chanzo yameonyesha kwamba kuandika baiti nne kwenye executable memory peke yake si ghali zaidi kwa kiasi kikubwa kuliko operesheni ya baiti nne ya memcpy kwenye memory ya kawaida: katika hali zote mbili median ilikuwa karibu mizunguko 9 na mkengeuko sanifu mzunguko 1.
Gharama kubwa ilitokea wakati instruction iliyobadilishwa ilitekelezwa baada ya muda mfupi sana. Katika hali hii, kichakataji kinaweza kuunda machine clear baada ya kugundua self-modifying code; katika jaribio la chanzo tabia hii ilifikia takriban clears mbili kwa iteration, ikaongeza muda wa utekelezaji kwa takriban mara 30–40, na athari ya SMC ikaonekana kuongeza gharama ya karibu mizunguko 100.
Ugunduzi huu unaonyesha kwamba masharti nusu-tuli si uboreshaji wa jumla wa drop-in unaoweza kuchukua nafasi ya kila usemi wa if. Ikiwa set_direction na branch zitatekelezwa mfululizo bila nafasi, faida kuu ya mbinu inaweza kupotea.
Athari za BTB na BAC
Branch Target Buffer (BTB) ni muundo wa hardware unaosaidia kichakataji kutabiri kwamba kuna tawi katika nafasi fulani ya program counter na lengo lake liko wapi. Branch Address Calculator (BAC) hushiriki katika kuthibitisha anwani lengwa. Lengo la relatif la jmp la sharti nusu-tuli linapobadilishwa, lengo la zamani linaweza kubaki katika BTB.
Katika majaribio ya utafiti, malengo yaliyobadilishwa mara kwa mara yaliongeza marekebisho ya BAC. Baada ya kuongeza buffer ya hesabu, idadi ya marekebisho ilipungua kwa takriban nusu hadi karibu moja kwa iteration. Waandishi walipima gharama ya ziada ya takriban 2,2 ns kwa marekebisho ya BAC, sawa na takriban mizunguko 6 kwenye kichakataji kilichotumiwa. Gharama hii ni ndogo kuliko adhabu ya kutabiri vibaya tawi lenye sharti na, muhimu zaidi, inaweza “kulipwa” mapema kwa mwito wa warming kabla ya njia muhimu kuanza.
Active branch warming
Pendekezo muhimu la chanzo ni kuendesha method ya branch kwa mwito bandia au usio na athari kwenye njia baridi baada ya mwelekeo wa branch kubadilishwa. Mwito huu husaidia BTB kujifunza lengo la sasa, kupasha instruction-cache data inayohitajika na kuhamisha athari za SMC mbali na njia muhimu. Katika mfano wa HFT, utafiti unaeleza hili kimawazo kupitia mwito wa “dummy order”.
Nafasi yake ndani ya mfumo wa HFT
Katika usanifu uliorahisishwa wa HFT katika Kielelezo 7 cha chanzo, data ya soko husafiri kutoka safu ya mtandao kwenda kwenye financial protocol, order book na application logic maalumu; uboreshaji unaopendekezwa na utafiti hulenga njia muhimu ya order-action upande wa application maalumu. Mbinu hii si njia ya kuboresha moja kwa moja ucheleweshaji wa mtandao, ucheleweshaji wa exchange matching engine au muda wa usindikaji wa FPGA yenyewe.
Usalama
Kufanya executable page inayotumika iwe read/write/execute huongeza attack surface. Chanzo kinakubali hatari hii na katika mbinu ya set_direction_safe kinapendekeza page ifanywe writable wakati wa mabadiliko pekee, kisha irudishwe kwenye hali ya read/execute. Gharama yake ni system calls mbili na latency/jitter ya juu zaidi. Kwa hiyo, utafiti una trade-off ya wazi ya kihandisi kati ya usalama na ucheleweshaji wa chini kabisa.
Thread safety
Kwa kuwa lengo la assembly ni sehemu ya msimbo inayoshirikiwa na miito yote, thread moja inaweza kubadilisha lengo wakati thread nyingine inafanya mwito wa branch. Majaribio ya chanzo yameonyesha kwamba bila synchronization tawi lisilo sahihi linaweza kutekelezwa, ingawa mara chache. Synchronization kama Mutex huhakikisha tabia sahihi lakini huondoa sehemu kubwa ya faida ya utendaji.
Uhamishikaji
Maktaba imefungashwa kama static library inayotumia CMake. Jedwali la compatibility la chanzo linaripoti combinations zilizojaribiwa/kufanya kazi kwa GCC, MSVC na Clang kwenye Windows x86-64 na Linux x86-64, na pia kwa GCC na Clang kwenye Linux ARM. Combinations za macOS hazijawekwa alama kuwa zinafanya kazi. Hasa, vizuizi vya Apple Silicon Hardened Runtime juu ya ruhusa za write/execute za pages vinatajwa kuwa kikwazo muhimu kwa mbinu ya sasa.
Mbinu na Matokeo ya Utafiti
Utafiti ulifanywa katika hatua mbili. Katika hatua ya kwanza, prototype ya BranchChanger katika kiwango cha C++, compatibility ya calling convention, template deduction, uhariri wa assembly, kinga dhidi ya compiler optimizations, relative jump na taratibu za uhamishikaji ziliendelezwa. Katika hatua ya pili, vipengele vya branch-changing na branch-taking vilipimwa kwa mizunguko ya CPU, performance counters na microbenchmark za kiwango cha juu zaidi.
Mazingira ya uendelezaji na majaribio
- Mfumo wa uendeshaji: Linux, usambazaji wa Ubuntu.
- Compiler: GCC 13.1.
- Lugha ya uendelezaji: C++20 katika sehemu ya uendelezaji ya chanzo.
- CPU kuu ya benchmark: Intel Core i7-10700, 2,90 GHz.
- Uwezo wa cache ulioripotiwa katika chanzo: 256 KB L1 instruction/data, 2 MB L2 na 16 MB L3.
- Kipimo cha muda cha kiwango cha chini: RDTSC.
- Serialization: LFENCE.
- Performance counters: Linux perf na
perf_event_open. - Majaribio ya kiwango cha juu zaidi: Google Benchmark.
Katika vipimo vya RDTSC, LFENCE ilitumika kuzuia utekelezaji wa out-of-order wa kichakataji kuvuruga kipindi cha kipimo. Gharama ya miundombinu ya kipimo yenyewe ilibainishwa kwa kurudia mara nyingi loop tupu ya kipimo na ikaondolewa kwenye matokeo yaliyofuata. Chanzo kilitumia takriban \(10^7\) marudio katika baadhi ya majaribio ya instruction-level.
Matokeo makuu ya benchmark
| Jaribio | Kawaida / rejea | Sharti nusu-tuli | Maana ya kisayansi |
|---|---|---|---|
| Branch-taking vs mwito wa moja kwa moja wa function | mizunguko 9, SD=1 | mizunguko 10, SD=1 | jmp ya ziada ya relatif huleta tofauti ya takriban mzunguko mmoja. |
| Njia moto ya nasibu inayofanana na HFT, hakuna cache warming | mizunguko 75, SD=10 | mizunguko 63, SD=3 | Mchanganyiko wa predicted/mispredicted wa tawi lenye sharti huunda usambazaji mpana zaidi. |
| Njia moto ya nasibu inayofanana na HFT, cache warming ipo | mizunguko 68, SD=8 | mizunguko 62, SD=2 | Athari ya cache inapopungua, usambazaji wa njia nusu-tuli hubaki mwembamba zaidi. |
| Njia moto yenye hesabu zaidi | mizunguko 120, SD=10 | mizunguko 104, SD=3 | Athari ya misprediction hubaki hata mantiki ya jirani inapoongezwa. |
| switch ya nasibu yenye hali 5 | mizunguko 30, SD=8 | mizunguko 8, SD=1 | Gharama za Jump-table/indirect-branch huongezeka wakati kiwango cha ubashiri usio sahihi ni kikubwa. |
| Tawi linalotabirika; mwelekeo hubadilika kila iteration 1000 | mizunguko 64, SD=3 | mizunguko 62, SD=2 | Hata ubashiri usio sahihi ukiwa mdogo, maelekezo ya ziada kwenye njia ya assembly huleta tofauti ndogo. |
Katika Kielelezo 16 cha chanzo, usambazaji wa conditional-branch wa jaribio la pande mbili lenye masharti ya nasibu ni bimodal. Bila cache warming, makundi ya predicted na mispredicted yanaonekana karibu na vituo vya mizunguko 65 na 78; kwa warming, karibu na mizunguko 64 na 80. Tofauti ya mizunguko 13–16 inaonyesha ukubwa wa adhabu ya kawaida ya ubashiri usio sahihi katika usanifu uliotumiwa na utafiti.
Kulingana na hesabu za waandishi, masharti nusu-tuli yaliokoa kwa wastani takriban 2–4 ns katika jaribio hili, na takriban 6 ns pale ambapo tawi lilikosewa kila mara. Thamani hizi si dhamana ya jumla ya C++; ni maalumu kwa kichakataji kilichopimwa, mpangilio wa msimbo, hali ya cache, compiler na senario ya jaribio.
Kwa nini [[likely]] na [[unlikely]] hazikusaidia katika masharti ya nasibu?
Kwa kuwa katika masharti ya Boolean yaliyotengenezwa kwa nasibu pande mbili zilikuwa na uwezekano karibu sawa, static code layout iliyofanywa na compiler haikuweza kutabiri tabia halisi ya runtime. Katika majaribio ya chanzo, matumizi ya [[likely]] na [[unlikely]] hayakupunguza kiwango cha ubashiri usio sahihi. Matokeo haya ni halali tu chini ya masharti ya mpangilio huu wa jaribio; hayamaanishi kwamba sifa hizi hazina athari katika programu zote.
Utoaji wa matawi wa njia N
Chanzo kinasema kwamba katika muundo wa n-way if/else au switch unaochaguliwa kwa nasibu, kutabiri lengo sahihi huwa kugumu zaidi kadiri idadi ya chaguo inavyoongezeka. Katika jaribio la switch yenye hali tano, Kielelezo 18 cha chanzo kinaripoti median ya mizunguko 30 na mkengeuko sanifu wa 8 kwa switch ya kawaida; na median ya mizunguko 8 na mkengeuko sanifu wa 1 kwa sharti nusu-tuli. Kwa kuwa matawi yaliyotumiwa katika jaribio hili yalikuwa function tupu, matokeo hayawezi kutafsiriwa moja kwa moja kuwa utendaji wa mzigo halisi wa uzalishaji.
Nini kilitokea katika matawi yanayotabirika?
Sharti lilipobadilishwa mara moja kila iteration 1000, conventional branch ilionyesha median ya mizunguko 64 na mkengeuko sanifu wa 3, wakati mbinu ya nusu-tuli ilionyesha median ya mizunguko 62 na mkengeuko sanifu wa 2; chanzo kinatoa \(P<0.000001\) kwa ulinganisho huu. Waandishi wanahusisha tofauti ndogo ya takriban mizunguko 2–3 na mipangilio tofauti ya assembly ambayo compiler huunda katika njia za branch za mbele na nyuma.
Katika miundo ya switch, athari hiyo ya code layout ilikuwa dhahiri zaidi, na utafiti uliripoti kwamba katika baadhi ya masharti ya predictable-switch njia nusu-tuli ilikuwa takriban mizunguko 5–6 haraka zaidi.
Gharama ya Branch-changing
Ingawa gharama iliyotengwa ya kubadilisha mwelekeo wa baiti nne inaonekana ndogo, SMC machine clear inaweza kutokea ikiwa anwani iliyoandikwa tayari ilikuwa katika miundo ya instruction cache/pipeline. Katika senario ya edit-and-execute ya muda mfupi, chanzo kiliripoti kupungua kwa kasi kwa takriban mara 30–40. Hii ndiyo mojawapo ya vikwazo muhimu zaidi vya muundo wa mbinu.
Kusafisha mistari husika ya instruction-cache kwa CLFLUSH na kuweka buffer ya hesabu kati ya assembly edit na branch-taking kulipunguza idadi ya machine clear; lakini hakukuondoa gharama kabisa. Kwa hiyo, chanzo kinachukulia umbali wa muda na mikroarkitektura kati ya kubadilisha mwelekeo na branch-taking kuwa kigezo muhimu cha uboreshaji.
Uaminifu na uendeshaji sambamba
Katika majaribio ya usahihi ya thread moja, ilithibitishwa kwamba function inayotarajiwa ilitekelezwa wakati mwelekeo ulipobadilishwa mara kwa mara na tawi kutekelezwa mara moja. Katika hali ya thread nyingi, kwa kuwa uandishi wa assembly hautoi chaguo la atomiki la branch katika kiwango cha juu, race condition inaweza kutokea. Synchronization huzuia hatari ya tawi lisilo sahihi kutekelezwa, lakini ulinganisho katika chanzo unaonyesha kwamba utendaji hupungua kwa kiasi kikubwa.
Je, Benchmark Hizi Zinathibitisha Faida Ileile Katika Mfumo Halisi wa Uzalishaji wa HFT?
Hapana. Utafiti haujafanya benchmark ya end-to-end ya data halisi ya soko, miundombinu ya mtandao wa uzalishaji, muunganisho wa exchange na mazingira ya HFT kernel yaliyosanidiwa kikamilifu; matokeo yametokana na majaribio ya kiwango cha CPU na microbenchmark ambayo kwa sehemu yanaiga tabia ya uzalishaji. Kwa hiyo, faida za kiwango cha nanosecond zinaonyesha uwezo wa mbinu, lakini hazihakikishi faida ya end-to-end ya ukubwa huo huo katika mfumo halisi wa trading.
Waandishi katika sehemu ya evaluation wanasema kwamba kutokana na kutokuwa na ruhusa za root, hawakuweza kusanidi mipangilio ya kernel kama CPU scaling na scheduler katika kiwango kinachotumika kwenye mfumo halisi wa HFT. Pia wanakubali wazi kwamba pseudo-realistic microbenchmark haziwakilishi kikamilifu mfumo halisi wa uzalishaji wa trading.
Kielelezo cha mwisho cha chanzo kinapendekeza mpangilio wa majaribio ya uthibitishaji imara zaidi wa baadaye unaojumuisha server tofauti ya market-data replay, network switch yenye kipengele cha timestamp cha usahihi wa juu, mfumo wa uzalishaji unaopimwa, na server tofauti ya vipimo inayohesabu nyakati za majibu.
Matokeo yanayoungwa mkono na utafiti
- Mwito wa nusu-tuli wa
branchuliweza kupunguzwa hadi gharama ya utekelezaji iliyo karibu sana na mwito wa moja kwa moja wa function katika usanifu uliotafitiwa. - Katika branch zinazokosewa mara kwa mara, branch-changing ilipoweza kuwekwa nje ya njia muhimu, median latency ya chini na latency variance ya chini zilipimwa.
- Badala ya gharama ya conditional branch misprediction, taratibu za kurekebisha lengo zenye gharama ndogo zinaweza kutumika.
- SMC machine clear ni mojawapo ya vikwazo vikuu vya utendaji wa mbinu.
- Ikiwa kubadilisha mwelekeo na branch-taking vitatenganishwa vya kutosha, gharama kubwa ya mabadiliko inaweza kusambazwa katika miito mingi ya branch yenye gharama ndogo.
- Thread safety, usalama na uhamishikaji wa jukwaa ni vikwazo muhimu katika utekelezaji.
Matokeo ambayo utafiti hauungi mkono
- Haijaonyeshwa kwamba masharti nusu-tuli ni haraka kuliko kila muundo wa C++
ifauswitch. - Haijaonyeshwa kwamba faida ileile ya mizunguko au nanosecond itapatikana kwenye kila usanifu wa CPU.
- Faida kubwa zaidi ya kibiashara kwenye exchange halisi haijapimwa kwa majaribio.
- Jaribio la end-to-end market-data-to-order latency halijafanywa katika mfumo halisi wa uzalishaji wa HFT.
- Haijaonyeshwa kwamba matumizi yenye thread-safe synchronization yanahifadhi faida ileile ya utendaji.
- Haidaiwi kwamba assembly editing ni tabia ya kawaida ya C++.
- Haijaonyeshwa kwamba usimamizi salama wa RWX unaweza kutekelezwa bila gharama ya utendaji.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Semi-static Conditions in Low-latency C++ for High Frequency Trading: Better than Branch Prediction Hints
Waandishi: Paul Alexander Bilokon; Maximilian Lucuta; Erez Shermer.
Uhusiano wa taasisi katika preprint: Paul Alexander Bilokon — Department of Computing na Department of Mathematics, Imperial College London; Maximilian Lucuta — Department of Computing, Imperial College London; Erez Shermer — qSpark LLC, Wilmington, Delaware, Marekani.
Chanzo kilichopakiwa: arXiv:2308.14185v1 [cs.PF], 27 Agosti 2023. Faili lililopakiwa linajitambulisha wazi kama “A PREPRINT”.
Hali ya uchapishaji wa baadaye: Uthibitishaji wa kibibliografia ulionyesha kwamba utafiti baadaye ulichapishwa katika Journal of Parallel and Distributed Computing, Juzuu 196, Makala 105000. DOI ya toleo la jarida ni 10.1016/j.jpdc.2024.105000. Maelezo ya majaribio katika maandishi haya ya Verianla yametolewa kutoka preprint ya 2023 iliyopakiwa; mabadiliko yoyote ya uhariri au kisayansi yanayoweza kuwa katika toleo la baadaye la jarida hayajaunganishwa kimya kimya na chanzo kilichopakiwa.
Mchapishaji: Elsevier.
Artefakti ya programu: Utafiti unawasilisha utekelezaji wa masharti nusu-tuli kama maktaba ya chanzo huria na kutaja repository ya msimbo wa chanzo kwa jina maxlucuta/semi-static-conditions.
Ufadhili / mgongano wa maslahi / CRediT: Katika preprint iliyopakiwa hakuna taarifa tofauti na wazi ya ufadhili, mgongano wa maslahi au mchango wa waandishi wa CRediT iliyobainishwa; sehemu hizi hazijajazwa kwa sababu hazipo katika chanzo.
Kizuizi kikuu cha kimetodolojia: Matokeo ya utendaji yanategemea usanifu na jukwaa. Benchmark kuu zilifanywa kwenye Intel Core i7-10700, na mfumo halisi kamili wa uzalishaji wa HFT pamoja na mazingira kamili ya kernel/network tuning hayakutumika. Kufanya matumizi ya thread nyingi yawe thread-safe huleta gharama ya synchronization. Assembly editing si tabia salama iliyofafanuliwa ndani ya kiwango cha kawaida cha C++, na ruhusa za executable pages zinaweza kusababisha matatizo ya usalama/uhamishikaji.
Dokezo la kiufundi ndani ya chanzo: Sehemu ya uendelezaji inataja mazingira ya C++20/GCC 13.1, ilhali katika mfano wa usage -std=c++17 inatumika. Aidha, maelezo ya kikomo cha kufikiwa kwa relative jump na usemi wa 2 GiB katika ujumbe wa hitilafu wa runtime hayajaandikwa kwa namna ileile. Tofauti hizi hazijasahihishwa kimya kimya na Verianla.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *