

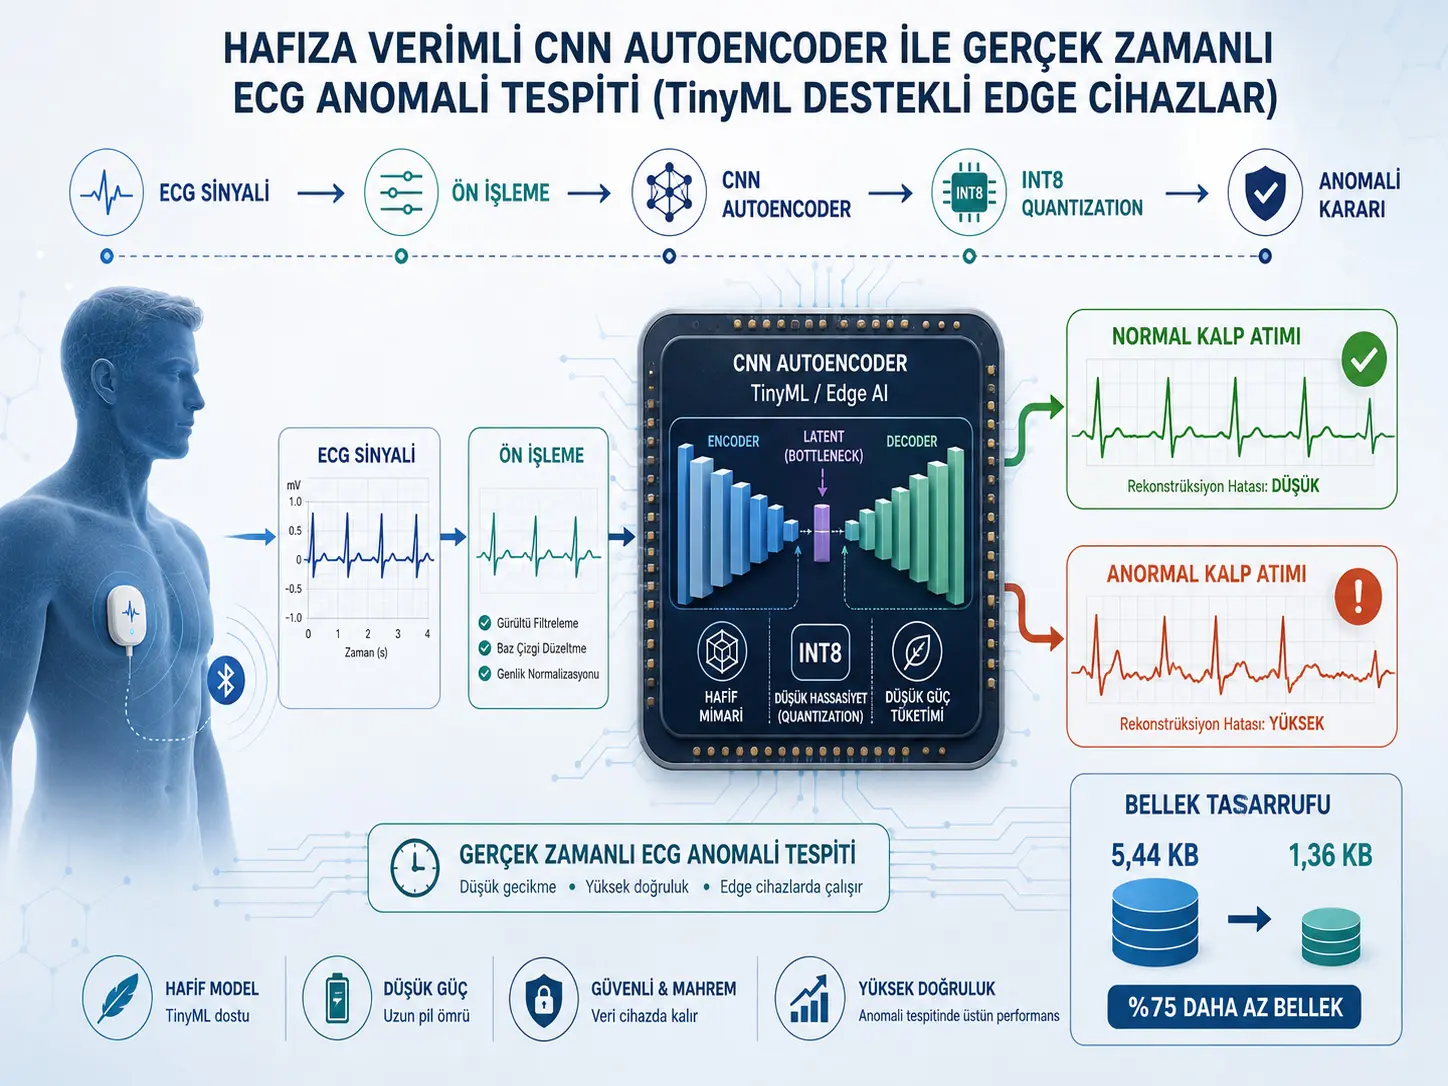
Utafiti huu unalenga kuunda modeli ya akili bandia iliyo ndogo vya kutosha kutambua mapigo ya moyo yasiyo ya kawaida katika ishara za elektrokadiografia (ECG) kwenye vifaa vya edge au vya daraja la TinyML vyenye rasilimali chache, bila kutuma data kila wakati kwenye seva kubwa. Kwa kusudi hili, watafiti walitengeneza convolutional autoencoder ya mwelekeo mmoja inayofundishwa kwa mapigo ya ECG ya kawaida pekee, na wakatumia uwezo wa modeli kuunda upya pigo la kawaida la moyo kama anomaly score. Morfolojia za ECG zinazotofautiana na hali ya kawaida zinapozalisha reconstruction error ya juu zaidi, sampuli huainishwa kuwa na anomaly ikiwa hitilafu hiyo iko juu ya threshold iliyowekwa awali.
Seti ya data iliyotumika ya ECG Heartbeat Categorization imetokana na PTB Diagnostic ECG Database, na chanzo kinaeleza kuwa ina jumla ya mapigo ya moyo 14.552: 4046 normal na 10.506 abnormal ECG beat. Kila pigo la moyo linawakilishwa na sampuli 187 za muda zilizopangiliwa kuzunguka kilele cha R. CNN autoencoder ilifundishwa kwa mfumo wa one-class kwa kutumia sampuli za normal pekee; mapigo ya abnormal hayakutumiwa wakati wa mafunzo na yalihifadhiwa kwa ajili ya majaribio.
Modeli ina vigezo 1393 pekee. Kwa mujibu wa hesabu ya chanzo, kuhifadhi vigezo katika FP32 kunahitaji takriban 5,44 KB, huku kuvifanya quantize hadi INT8 kukihitaji takriban 1,36 KB. Hivyo, hupatikana upungufu wa takriban %75 katika kumbukumbu ya kuhifadhi vigezo. Hata hivyo, thamani hii si kumbukumbu yote ya programu ya TinyML; activations, buffer za kazi, msimbo wa programu na runtime overhead hazijajumuishwa katika hesabu hii.
Kwa modeli ya FP32, utafiti umeripoti %83,12 accuracy, %85,88 precision, %91,47 recall na %88,67 F1-score. Katika modeli ya INT8, baada ya threshold kurekebishwa upya, accuracy iliripotiwa kuwa %82,19, precision %83,66, recall %93,61 na F1-score %88,36. Kwa hiyo, ingawa kumbukumbu ya vigezo inapungua hadi robo ya awali, upungufu ulioripotiwa katika F1-score ni pointi 0,31 za asilimia pekee.
Kuna tatizo muhimu la uwekaji wa lebo katika confusion matrix za chanzo. Ingawa seti ya data inaelezwa katika maandishi kuwa na 4046 normal na 10.506 abnormal beat, katika confusion matrix za FP32 na INT8 mstari wenye sampuli 4046 umepewa lebo “Abnormal”, na mstari wenye sampuli 10.506 umepewa lebo “Normal”. Majina ya madarasa yanapotafsiriwa kinyume kwa kuzingatia maelezo ya seti ya data, sehemu kubwa ya metriki zilizoripotiwa zinaweza kuzalishwa upya kutoka kwenye matriksi. Kwa FP32 precision, hata hivyo, matriksi hutoa takriban %86,03 ilhali chanzo kimeripoti %85,88.
Kizuizi muhimu zaidi cha utafiti kwa mtazamo wa TinyML ni kwamba deployment kwenye microcontroller halisi haikufanywa. INT8 quantization, urekebishaji wa threshold na tathmini ya inference zilifanywa kwa programu katika mazingira ya MATLAB/CPU. Kwa hiyo, utafiti unatoa ushahidi kuhusu kumbukumbu ndogo ya vigezo vya modeli na utendaji wa anomaly-detection unaoweza kuhifadhiwa baada ya quantization; hauonyeshi latency halisi, matumizi ya nishati au utendaji wa mwisho-hadi-mwisho wa mfumo wa afya kwenye MCU mahususi.
Maoni kwa mtazamo wa Uturuki: Utafiti huu haukufanywa kwenye rekodi za kliniki za ECG au idadi ya wagonjwa nchini Uturuki. Mbinu inaweza kutathminiwa kiufundi nchini Uturuki kwa ajili ya kubuni vifaa vya ufuatiliaji wa afya vinavyobebeka na vya huduma ya nyumbani; hata hivyo, kabla ya matumizi halisi, uthibitishaji huru wa kliniki unahitajika kwa vikundi vya wagonjwa wa ndani, vifaa tofauti vya ECG, hali za kelele na magonjwa tofauti ya moyo. Aidha, mfumo katika utafiti huu hufanya tu utenganishaji wa “normal / abnormal”; hautambui aina ya arrhythmia. Kwa hiyo, matokeo hayapaswi kufasiriwa kama utendaji wa kifaa cha utambuzi wa kliniki.
Tatizo kuu la utafiti ni nini?
Ufuatiliaji endelevu wa ECG unaweza kuwa muhimu katika kutambua mapema mkengeuko kutoka kwenye mpigo wa kawaida wa moyo. Hata hivyo, kutuma data ya ECG kila wakati kwenye seva kuu kunaweza kuleta hasara katika mzigo wa mawasiliano, ucheleweshaji, matumizi ya nishati na faragha. Kwa upande mwingine, kuendesha modeli kubwa za CNN, LSTM au Transformer kwenye microcontroller zenye nguvu ndogo pia ni vigumu kwa sababu ya mipaka ya kumbukumbu na uchakataji.
Mbinu ya utafiti inashughulikia matatizo haya mawili kwa pamoja: kuunda autoencoder ndogo kadiri iwezekanavyo na kisha kupunguza kumbukumbu ya vigezo kwa kushusha uzito wa modeli kutoka 32 bit floating point hadi uwakilishi wa 8 bit integer.
Mfumo unafanyaje kazi?
Mlolongo wa uchakataji kutoka ECG hadi uamuzi wa edge anomaly
| Hatua | Mchakato | Chanzo |
|---|---|---|
| 1. Ingizo la ECG | Kila pigo la moyo linawakilishwa na sampuli 187 za muda zilizopangiliwa kuzunguka kilele cha R. | Sehemu 2.2 |
| 2. Urekebishaji | Kila ECG beat hurekebishwa kuwa na wastani sifuri na mkengeuko wa kawaida wa kitengo kimoja. | Mlinganyo 1 |
| 3. CNN Autoencoder | Modeli hujaribu kuunda upya morfolojia ya normal ECG kupitia encoder–bottleneck–decoder. | Kielelezo 2 / Sehemu 2.4 |
| 4. Reconstruction error | MSE kati ya ECG ya awali na reconstructed ECG hukokotolewa kama anomaly score. | Mlinganyo 3 |
| 5. Threshold | Ikiwa hitilafu iko juu ya threshold hupewa darasa la anomaly, na ikiwa iko chini au sawa hupewa darasa la normal. | Mlinganyo 6 |
| 6. INT8 quantization | Uzito wa FP32 hubadilishwa kuwa uwakilishi wa INT8 wenye ulinganifu na threshold huwekewa optimization upya. | Sehemu 2.5–2.8 |
| 7. Lengo la Edge/TinyML | Lengo ni kutumia modeli ndogo kwa anomaly screening ya ndani kwenye vifaa vyenye rasilimali chache. | Kielelezo 1 / Majadiliano |
Verianla Live: Mchakato umeundwa kutoka Kielelezo 1–3 na sehemu ya mbinu ya utafiti. Hakuna modeli mpya au hatua ya uamuzi wa kliniki isiyopatikana katika chanzo iliyoongezwa.
Seti ya data iliandaliwa vipi?
Chanzo kinachukua ishara za ECG kutoka seti ya data ya Kaggle ECG Heartbeat Categorization. Imeelezwa kwamba seti hii ya data imetokana na PTB Diagnostic ECG Database.
Kila sampuli ni heartbeat cycle moja na:
- imewekwa katikati kuzunguka kilele cha R,
- ina sampuli 187 za time-domain,
- imegawanywa kuwa normal au abnormal.
Jumla ya data katika chanzo:
| Darasa | Idadi ya ECG beat |
|---|---|
| Normal | 4046 |
| Abnormal | 10.506 |
| Jumla | 14.552 |
Autoencoder hufundishwa kwa ECG beat za normal pekee. Kwa hiyo, modeli hailengi kujifunza madarasa maalumu ya arrhythmia, bali kuunda representation inayojibu swali “pigo la kawaida la moyo linaonekanaje?”
Kwa nini kila ECG beat hurekebishwa kando?
Chanzo hurekebisha kila sampuli kwa wastani na mkengeuko wake wa kawaida ili kupunguza athari za tofauti za amplitude:
\[ \tilde{x}_i= \frac{x_i-\mu_x}{\sigma_x} \]
Kutokana na mchakato huu, kila beat huletwa takriban kwenye kipimo cha wastani sifuri na variance ya kitengo kimoja.
Kikomo muhimu cha tafsiri hapa ni hiki: per-sample normalization inaweza kurahisisha modeli kuchunguza morfolojia ya ECG, lakini pia hurekebisha sehemu ya taarifa ya amplitude kamili. Utafiti haulinganishi kando athari ya uchaguzi huu wa preprocessing katika mazingira tofauti ya kliniki.
Muundo wa CNN Autoencoder ni mdogo kiasi gani?
Modeli huchakata ingizo la ECG lenye ukubwa wa 187×1×1 kwa muundo wa encoder–decoder.
Kulingana na Kielelezo 2 na sehemu ya mbinu ya chanzo:
- convolution ya 3×1 yenye filters 8 upande wa encoder,
- activation ya ReLU,
- tabaka la bottleneck/dense lenye units 16,
- dense + reshape upande wa decoder,
- 3×1 transposed convolution
vinatumika.
Jumla ya vigezo vinavyoweza kufundishwa ni:
1393
pekee.
Modeli ilifundishwa vipi?
| Kigezo | Thamani ya chanzo |
|---|---|
| Training precision | FP32 |
| Epoch | 40 |
| Optimizer | Adam |
| Learning rate | 1 × 10⁻³ |
| Batch size | 256 |
| Loss | MSE |
| Threshold search | grid search juu ya thamani 2000 teule |
| Darasa la data ya Training | ECG ya normal pekee |
Chanzo kinaeleza kwamba training ilichukua takriban dakika 3–4 kwenye CPU ya kawaida. Hata hivyo, kwa kuwa modeli ya prosesa iliyotumika na hali nyingine za benchmark hazijatolewa, muda huu hauwezi kuhamishwa moja kwa moja kwenda kwenye vifaa vingine.
Reconstruction error hukokotolewa vipi?
Beat inayofanyiwa reconstructed na autoencoder:
\[ \hat{x}_i=f_{\theta}(x_i) \]
hufafanuliwa hivyo.
Thamani ya reconstruction error ya kila beat:
\[ e_i= \frac{1}{H} \sum_{j=1}^{H} (x_{i,j}-\hat{x}_{i,j})^2 \]
hukokotolewa kwa namna hiyo. Hapa \(H=187\).
Kwa kuwa modeli imeona tu maumbo ya normal ECG, dhana msingi ya utafiti ni kwamba itaunda upya beat za normal kwa hitilafu ndogo, na beat za abnormal zenye morfolojia tofauti kwa reconstruction error ya juu zaidi.
Uamuzi wa anomaly unafanywaje?
Chanzo kinatoa thamani ya kudumu ya threshold kwa modeli ya FP32 kuwa:
\[ \tau=3.55993\times10^{-4} \]
.
Uainishaji ni:
\[ Label_i= \begin{cases} 1,& e_i>\tau \quad \text{anormal}\\ 0,& e_i\leq\tau \quad \text{normal} \end{cases} \]
.
Thamani ya threshold imeamuliwa kwa kuchagua mgombea anayefanya F1-score kuwa ya juu zaidi. Mbinu hii haibadilishi anomaly score yenyewe; inaweka tu mpaka wa uamuzi wa normal/anormal.
Mpito kutoka FP32 kwenda INT8 unafanywaje?
Quantization hutekelezwa baada ya mafunzo kukamilika. Chanzo hukokotoa scale factor kwa kutumia uzito wa juu kabisa kwa thamani kamili katika kila tabaka:
\[ s= \frac{\max(|W|)}{127} \]
Kisha uzito:
\[ \omega_q= round \left( \frac{127}{\max(|\omega|)} \omega \right) \]
hubadilishwa kuwa uwakilishi wa INT8 kati ya −127 na +127.
Chanzo kinaonyesha wazi kwamba baada ya quantization, usambazaji wa reconstruction error hubadilika kwa kiasi fulani. Kwa hiyo, badala ya kutumia threshold ya FP32 bila kubadilisha kwenye modeli ya INT8, threshold tofauti imewekewa optimization:
\[ \tau_q= \arg\max_{\tau}F1(\tau) \]
Katika kichwa cha Kielelezo 6, “best-th” iliyochaguliwa kwa INT8 inaonyeshwa kuwa takriban 0,0005052.
Kwa nini threshold hurekebishwa upya?
Kwa kuwa INT8 quantization huwakilisha uzito kwa bit chache zaidi, inaweza kuleta mabadiliko madogo ya namba katika ishara reconstructed. Mabadiliko haya yanaweza kusogeza usambazaji wa reconstruction-error unaotumiwa na anomaly detection.
Chanzo kinaeleza kwamba kutumia moja kwa moja threshold ya FP32 kwenye INT8 huongeza idadi ya false-positive; optimization ya threshold maalumu kwa INT8 hupunguza athari hii.
Matokeo haya yanaonyesha kwamba kupunguza tu uzito wa modeli haitoshi; ni muhimu ku-calibrate upya anomaly threshold baada ya quantization.
Kumbukumbu ya vigezo inapungua kwa kiasi gani kweli?
Hesabu ya memory katika chanzo ni:
\[ Memory=N_p\times b \]
.
Vigezo 1393 × 4 byte ni takriban 5,44 KiB; vigezo 1393 × 1 byte ni takriban 1,36 KiB. Kwa hiyo, kumbukumbu ya vigezo hupungua moja kwa moja hadi robo.
Tofauti muhimu ya kiufundi: Hesabu hii inajumuisha uzito wa modeli pekee. Katika programu halisi ya TinyML, activation tensor, input/output buffer, thamani za quantization scale, firmware, inference engine na stack/heap pia hutumia kumbukumbu. Utafiti haupimi jumla ya vipengele hivi.
Matokeo ya FP32 ni yapi?
| Metriki | Thamani iliyoripotiwa katika chanzo |
|---|---|
| Accuracy | 83,12% |
| Precision | 85,88% |
| Recall | 91,47% |
| F1-score | 88,67% |
| ROC AUC | 0,8327 |
Kielelezo 7 kinaonyesha wazi kwamba thamani ya AUC ya mkunjo wa FP32 ROC ni 0,8327.
Matokeo ya INT8 ni yapi?
| Metriki | FP32 | INT8 | Mabadiliko |
|---|---|---|---|
| Accuracy | 83,12% | 82,19% | −0,93 pointi ya asilimia |
| Precision | 85,88% | 83,66% | −2,22 pointi ya asilimia |
| Recall | 91,47% | 93,61% | +2,14 pointi ya asilimia |
| F1-score | 88,67% | 88,36% | −0,31 pointi ya asilimia |
| Kumbukumbu ya vigezo | 5,44 KB | 1,36 KB | −75% |
Katika modeli ya INT8, accuracy na precision zimepungua kiasi, huku recall ikiongezeka. Kwa hiyo, haitoshi kutathmini athari ya quantization kwa kuangalia accuracy pekee.
Ni tatizo gani lililo katika confusion matrix?
Maelezo ya seti ya data katika chanzo yanatoa mgawanyo huu wa madarasa:
4046 normal + 10.506 abnormal = 14.552 beat.
Hata hivyo, matriksi inayoonekana katika Kielelezo 4 cha FP32 ni hii:
| Kwenye kielelezo “Abnormal” | Kwenye kielelezo “Normal” | |
|---|---|---|
| Kwenye kielelezo “Abnormal” | 2486 | 1560 |
| Kwenye kielelezo “Normal” | 896 | 9610 |
Jumla ya mstari wa juu ni:
\[ 2486+1560=4046 \]
na jumla ya mstari wa chini ni:
\[ 896+9610=10506 \]
. Hizi ni, kwa mpangilio huo, idadi za normal na abnormal katika seti ya data. Kwa hiyo, majina ya madarasa katika confusion matrix yanaonekana kuwa yamegeuzwa ikilinganishwa na maelezo ya seti ya data.
Muundo huo huo unajirudia katika Kielelezo 6 cha INT8:
| Kwenye kielelezo “Abnormal” | Kwenye kielelezo “Normal” | |
|---|---|---|
| Kwenye kielelezo “Abnormal” | 2125 | 1921 |
| Kwenye kielelezo “Normal” | 671 | 9835 |
Hapa pia:
\[ 2125+1921=4046 \]
na:
\[ 671+9835=10506 \]
.
Kwa hiyo, tafsiri iliyo thabiti zaidi ni kwamba majina Normal/Abnormal kwenye mhimili wa confusion matrix yameandikwa mahali pa kila moja.
Je, metriki zinaweza kuzalishwa upya kutoka kwenye matriksi?
FP32 matrix inapotafsiriwa upya kulingana na idadi halisi za madarasa katika seti ya data, kwa abnormal detection:
\[ Precision= \frac{9610}{9610+1560} \approx86,03\% \]
\[ Recall= \frac{9610}{9610+896} \approx91,47\% \]
\[ F1\approx88,67\% \]
\[ Accuracy= \frac{2486+9610}{14552} \approx83,12\% \]
hupatikana.
Accuracy, recall na F1 zinaendana na chanzo; hata hivyo, chanzo kinatoa precision ya %85,88. Kutoka kwenye matriksi hupatikana takriban %86,03. Tofauti ni takriban pointi 0,15 za asilimia.
Katika INT8 confusion matrix, tafsiri hiyo hiyo upya:
\[ Precision\approx83,66\% \]
\[ Recall\approx93,61\% \]
\[ F1\approx88,36\% \]
\[ Accuracy\approx82,19\% \]
hutoa matokeo hayo, na yanaendana na thamani zilizoripotiwa katika chanzo.
Je, morfolojia ya QRS kweli inahifadhiwa?
Chanzo kinaeleza kwamba maumbo ya reconstructed ECG ya FP32 na INT8 pamoja na usambazaji wa reconstruction-error yako karibu na kila mmoja na kwamba hasa muundo msingi wa QRS complex umehifadhiwa. Pia inaelezwa kwamba baadhi ya maeneo yenye nishati kubwa yanaonekana laini kidogo baada ya quantization.
Hata hivyo, hapa haiwezi kutolewa hitimisho lenye nguvu zaidi kwamba “vipengele vyote vya ECG vyenye umuhimu wa kliniki vimehifadhiwa bila hasara”. Utafiti hauwasilishi tathmini ya morfolojia iliyofanywa kwa upofu na madaktari bingwa wa moyo, clinical equivalence test au multi-center diagnostic validation.
Je, iliendeshwa kwenye vifaa halisi vya TinyML?
Hapana. Utafiti unaweka hili wazi kama kizuizi. Quantization pipeline ilitekelezwa kwa mbinu ya dlquantizer ya MATLAB R2025a na kwenye CPU.
Chanzo kinaeleza kwamba hatua zifuatazo zilifanywa kwa programu:
- FP32 inference,
- INT8 approximation,
- threshold optimization,
- metric evaluation.
Hakuna microcontroller au accelerator hardware iliyotumika.
Kwa hiyo, “TinyML-enabled edge device” si kifaa kilichojaribiwa moja kwa moja katika utafiti huu, bali ni daraja lengwa la deployment ya modeli.
Je, INT8 ni integer-only inference kweli?
Chanzo kinajadili kwamba INT8 inafaa kwa integer-only inference siku zijazo. Hata hivyo, katika pipeline ya majaribio inaelezwa kwamba thamani za quantized zilifanyiwa dequantize kwenda FP32 approximation inapohitajika.
Kwa hiyo, utafiti haukupima utendaji wa inference pipeline inayotumia integer arithmetic pekee kwenye MCU halisi. Integer-only inference imewasilishwa kama faida inayowezekana ya deployment ya usanifu.
Je, ni bora kuliko modeli nyingine za ECG?
Chanzo kinatoa ulinganisho huu na tafiti tofauti katika fasihi:
| Modeli | Dataset | Accuracy | F1 | Ukubwa wa modeli |
|---|---|---|---|---|
| Utafiti huu — CAE FP32 | PTB | 83,12% | 88,67% | 5,44 KB |
| Utafiti huu — CAE INT8 | PTB | 82,19% | 88,36% | 1,36 KB |
| Utafiti unaotegemea Transformer | MIT-BIH | 89,5% | 92,3% | Haijabainishwa |
| ECG-AAE | CMUH | 93,58% | 93,25% | Haijabainishwa |
| Large-scale multilabel CNN | Seti kubwa maalumu ya data | 86,7% exact-match | 91,3% | Haijabainishwa |
| CNN Autoencoder | PTB | 78% | 77% macro | Haijabainishwa |
Chanzo kinaeleza kwa usahihi kwamba jedwali hili si benchmark ya moja kwa moja. Dataset, kazi, preprocessing na metriki za tathmini ni tofauti. Hasa, 86,7% “Exact Match Ratio” na binary accuracy ya kawaida si metriki ileile.
Faida ya mbinu ya one-class ni nini?
Kasoro za moyo zinaweza kuwa za aina nyingi sana, na ni vigumu kuweka lebo kwa kila morfolojia inayowezekana ya abnormal. Modeli ya one-class hujifunza mpigo wa normal pekee na hutathmini mkengeuko kutoka normal kama anomaly.
Faida yake ni kwamba pattern mpya au adimu za abnormal zinaweza kinadharia kutiwa alama na modeli kuwa “si normal”.
Hasara yake ni kwamba haisemi abnormal beat ni ya darasa gani la arrhythmia. Modeli ya utafiti hujaribu kujibu:
“Je, beat hii ni tofauti na normal?”
lakini haijibu:
“Hii ni arrhythmia gani?”
.
Kwa nini false negative ni muhimu kitabibu?
Watafiti wanaeleza kwamba katika mfumo wa anomaly screening, kukosa pigo la moyo la abnormal kwa kulichukulia kuwa normal kunaweza kuwa hatari zaidi kuliko kuzalisha false positive. Kwa hiyo, recall/sensitivity ni muhimu.
Katika modeli ya INT8, kuongezeka kwa recall katika chanzo kutoka %91,47 hadi %93,61 kunaonekana kuwa jambo chanya kwa mtazamo huu; hata hivyo, thamani hizo zinahusu tu seti ya majaribio iliyotokana na PTB iliyotumika na haziwezi kujumlishwa kama clinical sensitivity.
Matokeo yanayoungwa mkono na utafiti
- CNN autoencoder ndogo yenye vigezo 1393 imetekelezwa kwa ECG reconstruction-based anomaly detection.
- Modeli imefundishwa kwa mfumo wa one-class kwa ECG beat za normal pekee.
- Kwa modeli ya FP32, chanzo kinaripoti %83,12 accuracy na %88,67 F1-score.
- Baada ya INT8 quantization, kumbukumbu ya kuhifadhi vigezo hupungua kutoka takriban 5,44 KB hadi 1,36 KB.
- Katika modeli ya INT8, F1-score imehifadhiwa katika %88,36.
- Kwa sababu ya mabadiliko katika usambazaji wa reconstruction-error baada ya quantization, kuweka optimization upya kwa threshold kumeboresha utendaji.
- Usanifu wa utafiti ni mdogo sana kwa ukubwa wa vigezo kwa matumizi ya daraja la TinyML.
Matokeo ambayo utafiti hauungi mkono au haujayajaribu
- Modeli haijajaribiwa kwenye microcontroller halisi.
- Real MCU inference latency haijapimwa.
- Matumizi halisi ya nguvu au nishati ya kifaa hayajapimwa.
- Thamani ya 1,36 KB si hitaji la jumla la RAM au Flash la mfumo.
- Modeli haitambui aina maalumu za arrhythmia.
- Prospective clinical validation haijafanywa kwa wagonjwa halisi.
- Haijaonyeshwa kwamba modeli itatoa utendaji uleule katika demografia, hospitali, vifaa vya ECG na hali tofauti za sampling.
- Tathmini ya INT8 si benchmark halisi ya integer-only MCU inference.
- Kwa kuwa Jedwali 1 la fasihi lina dataset na kazi tofauti, halithibitishi moja kwa moja ubora wa state-of-the-art.
Mbinu na Matokeo ya Utafiti
Data na preprocessing
| Kigezo | Thamani |
|---|---|
| Chanzo cha data | ECG Heartbeat Categorization / inayotokana na PTB Diagnostic ECG Database |
| Jumla ya beat | 14.552 |
| Normal | 4046 |
| Abnormal | 10.506 |
| Urefu wa beat | Sampuli 187 za muda |
| Urekebishaji | zero mean / unit variance kwa kila sampuli |
| Training | Beat za normal pekee |
Vigezo vya CNN-AE
| Sifa | Thamani |
|---|---|
| Jumla ya vigezo | 1393 |
| Filter za Encoder | 8 |
| Kernel | 3 × 1 |
| Activation | ReLU |
| Bottleneck | 16 |
| Epoch | 40 |
| Batch size | 256 |
| Learning rate | 1 × 10⁻³ |
| Optimizer | Adam |
| Loss | MSE |
Noti ya batch/MSE ndani ya chanzo
Sehemu 2.4 inatoa thamani ya batch size kwa model training kuwa 256. Hata hivyo, mara moja chini ya Mlinganyo (4):
“M denotes the number of training samples = 128”
imeandikwa.
Chanzo hakielezi kama 128 ni mini-batch nyingine, subset ya hesabu ya loss au mabaki ya uhariri. Kwa hiyo, Verianla haisahihishi kimya kimya tofauti kati ya 128 na 256.
Ulinganisho wa FP32–INT8
| Sifa | FP32 | INT8 |
|---|---|---|
| Accuracy | 83,12% | 82,19% |
| Precision | 85,88% | 83,66% |
| Recall | 91,47% | 93,61% |
| F1 | 88,67% | 88,36% |
| Kumbukumbu ya vigezo | 5,44 KB | 1,36 KB |
| Usahihi wa vigezo | 32 bit | 8 bit |
Matokeo makuu ya udhibiti wa ubora
| Ukaguzi | Chanzo | Tathmini ya Verianla |
|---|---|---|
| Idadi za madarasa katika FP32 confusion matrix | 4046 na 10.506 | Majina ya madarasa kwenye mhimili yanaonekana kinyume na maelezo ya seti ya data |
| Idadi za madarasa katika INT8 confusion matrix | 4046 na 10.506 | Uwekaji uleule wa lebo kinyume unajirudia |
| FP32 accuracy | 83,12% | Inaweza kuzalishwa upya kutoka kwenye matriksi |
| FP32 recall | 91,47% | Inaweza kuzalishwa upya kutoka kwenye matriksi baada ya kurekebisha lebo |
| FP32 F1 | 88,67% | Inaweza kuzalishwa upya kutoka kwenye matriksi baada ya kurekebisha lebo |
| FP32 precision | 85,88% | Takriban 86,03% kutoka kwenye matriksi; kuna tofauti ndogo |
| Metriki za INT8 | 82,19 / 83,66 / 93,61 / 88,36% | Zinaendana na matrix baada ya kurekebisha lebo |
Noti ya namba za vielelezo
Chanzo katika Sehemu 3.1 kinatumia kauli “Figure 6” kwa ROC curve; hata hivyo, Kielelezo 6 ni INT8 confusion matrix, na FP32 ROC curve kwa kweli ni Kielelezo 7. Katika Sehemu 3.2, Kielelezo 7 kinatajwa kwa INT8 ROC; ulinganisho wa FP32–INT8 ROC uko katika Kielelezo 8. Mchanganyiko huu wa kiuhariri wa figure-reference upo katika chanzo ingawa haubadilishi matokeo ya kisayansi.
Matokeo muhimu zaidi ya kihandisi
Nguvu kuu ya utafiti si kufikia anomaly-detection accuracy ya juu zaidi. Chanzo pia kina modeli nyingine zinazoripoti usahihi wa juu zaidi. Matokeo ya kihandisi hapa ni kwamba kumbukumbu ya vigezo vya autoencoder yenye vigezo 1393 pekee inaweza kupunguzwa kwa INT8 hadi takriban 1,36 KB huku F1-score ikihifadhiwa karibu na kiwango cha %88 katika jaribio la chanzo.
Kwa hiyo, utafiti huu unapaswa kutathminiwa si kama “modeli bora zaidi ya utambuzi wa ECG”, bali kama muafaka wa kihandisi kati ya ukubwa wa modeli–utendaji wa kugundua anomaly–uwezekano wa deployment kwenye edge.
Maelezo ya Chanzo na Mbinu
Jina kamili la asili la utafiti: Memory-Efficient CNN Autoencoder for Real-Time ECG Anomaly Detection on TinyML-Enabled Edge Devices
Waandishi na mpangilio wao: Krishnaprasath Suryanarayanan; Ramanamurthy Gajula.
Mwandishi wa mawasiliano: Ramanamurthy Gajula.
Mchango sawa/waandishi wenza wa kwanza: Haujaelezwa katika chanzo.
Taasisi: Department of Electronics and Communication Engineering, Alliance School of Applied Engineering, Alliance University, Bangalore 562106, India.
Jarida: Future Internet
Mchapishaji: MDPI, Basel, Switzerland
Juzuu / toleo / makala: 18 / 6 / 286
Tarehe ya kupokelewa: 11 Aprili 2026
Tarehe ya marekebisho: 14 Mei 2026
Tarehe ya kukubaliwa: 15 Mei 2026
Tarehe ya kuchapishwa: 27 Mei 2026
DOI: 10.3390/fi18060286
Kiungo rasmi cha chapisho:https://doi.org/10.3390/fi18060286
Aina ya chanzo: Makala ya utafiti; ECG anomaly detection, one-class CNN autoencoder na tathmini ya INT8 quantization inayotegemea programu.
Hali ya mapitio: Ni utafiti uliochapishwa katika jarida lililopitiwa na wataalamu.
Leseni: Creative Commons Attribution (CC BY).
Ufadhili: Utafiti haukupokea ufadhili wa nje.
Upatikanaji wa data: Data za ECG zilizotumika zilitolewa kutoka ECG Heartbeat Categorization Dataset inayopatikana kwa umma; chanzo kinaeleza kwamba seti hii ya data imetokana na PTB Diagnostic ECG Database. Hakuna seti mpya ya data iliyoundwa katika utafiti.
Michango ya waandishi: Kwa mujibu wa tamko la chanzo, uundaji wa dhana ulifanywa na Krishnaprasath Suryanarayanan na Ramanamurthy Gajula; methodology, programu, uthibitishaji, formal analysis, uchunguzi, rasilimali na rasimu ya asili na Krishnaprasath Suryanarayanan; visualization na waandishi wote wawili; supervision na Ramanamurthy Gajula.
Mgongano wa maslahi: Waandishi wanatangaza kwamba hakuna mgongano wa maslahi.
Uthibitishaji wa hardware: Haujafanywa. Chanzo kinaeleza wazi katika Sehemu 2.8 kwamba FP32 inference, INT8 approximation, threshold optimization na metric evaluation zilifanywa kikamilifu kwa programu katika mazingira ya CPU yanayotegemea MATLAB na kwamba microcontroller/accelerator hardware haikuhitajika. Kwa hiyo, utafiti si benchmark ya kifaa halisi cha TinyML.
Tathmini ya kumbukumbu: Thamani za 5,44 KB na 1,36 KB ni hesabu za kinadharia za parameter-storage zinazotegemea kuhifadhi vigezo 1393 vya modeli kwa 4 byte na 1 byte kwa mpangilio huo. Haziwakilishi hitaji lote la Flash/RAM la kifaa halisi.
Kutolingana ndani ya chanzo 1 — lebo za madarasa katika confusion matrix: Maelezo ya seti ya data yanasema kuna 4046 normal na 10.506 abnormal ECG beat. Katika confusion matrix za FP32 na INT8, mstari wenye sampuli 4046 umepewa lebo “Abnormal”, na mstari wenye sampuli 10.506 umepewa lebo “Normal”. Kwa kuwa vielelezo vyote viwili vimewekewa lebo kinyume kwa namna ileile, inaashiria tatizo la kimfumo la class-label.
Kutolingana ndani ya chanzo 2 — FP32 precision: Madarasa ya confusion matrix yanaporekebishwa kwa kuzingatia idadi katika seti ya data na kukokotolewa upya, FP32 precision ni takriban %86,03. Chanzo kinaripoti %85,88. Accuracy, recall na F1 zinaendana na matriksi.
Kutolingana ndani ya chanzo 3 — idadi ya sampuli za batch/MSE: Sehemu 2.4 inatoa training batch size kuwa 256, ilhali chini ya Mlinganyo (4), M imeandikwa kuwa idadi ya training sample = 128. Tofauti hii haijaelezwa katika chanzo.
Kutolingana ndani ya chanzo 4 — marejeo ya vielelezo: Sehemu 3.1 inaelekeza kwenye Kielelezo 6 kwa FP32 ROC curve, na Sehemu 3.2 kwenye Kielelezo 7 kwa INT8 ROC. Kwa kweli, Kielelezo 6 ni INT8 confusion matrix, Kielelezo 7 ni FP32 ROC, na Kielelezo 8 ni ulinganisho wa FP32–INT8 ROC.
Kikomo cha utendaji: Tathmini za “real-time” na “low-power” katika chanzo zinategemea udogo wa modeli na uwezo unaowezekana wa TinyML deployment. Utafiti hauwasilishi measured latency kwenye kifaa halisi, matumizi ya nguvu ya watt/mW au kipimo cha energy/inference.
Kikomo cha kliniki: Modeli hufanya binary anomaly screening na haiainishi aina maalumu ya arrhythmia. Matokeo yaliyotumika ni tathmini ya retrospective dataset/model; si utafiti wa prospective diagnostic performance kwa wagonjwa halisi.
Mbinu ya kisayansi, matokeo ya namba, ukaguzi wa ubora wa confusion matrix, muundo wa modeli, utaratibu wa quantization na mapungufu katika maelezo haya ya Verianla yanategemea utafiti uliokaguliwa. Uthibitishaji wa nje ulitumika tu kuthibitisha utambulisho wa bibliografia wa chapisho; hakuna thamani mpya ya clinical performance au matokeo ya utambuzi wa ECG yaliyoongezwa kutoka nje ya chanzo.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *