

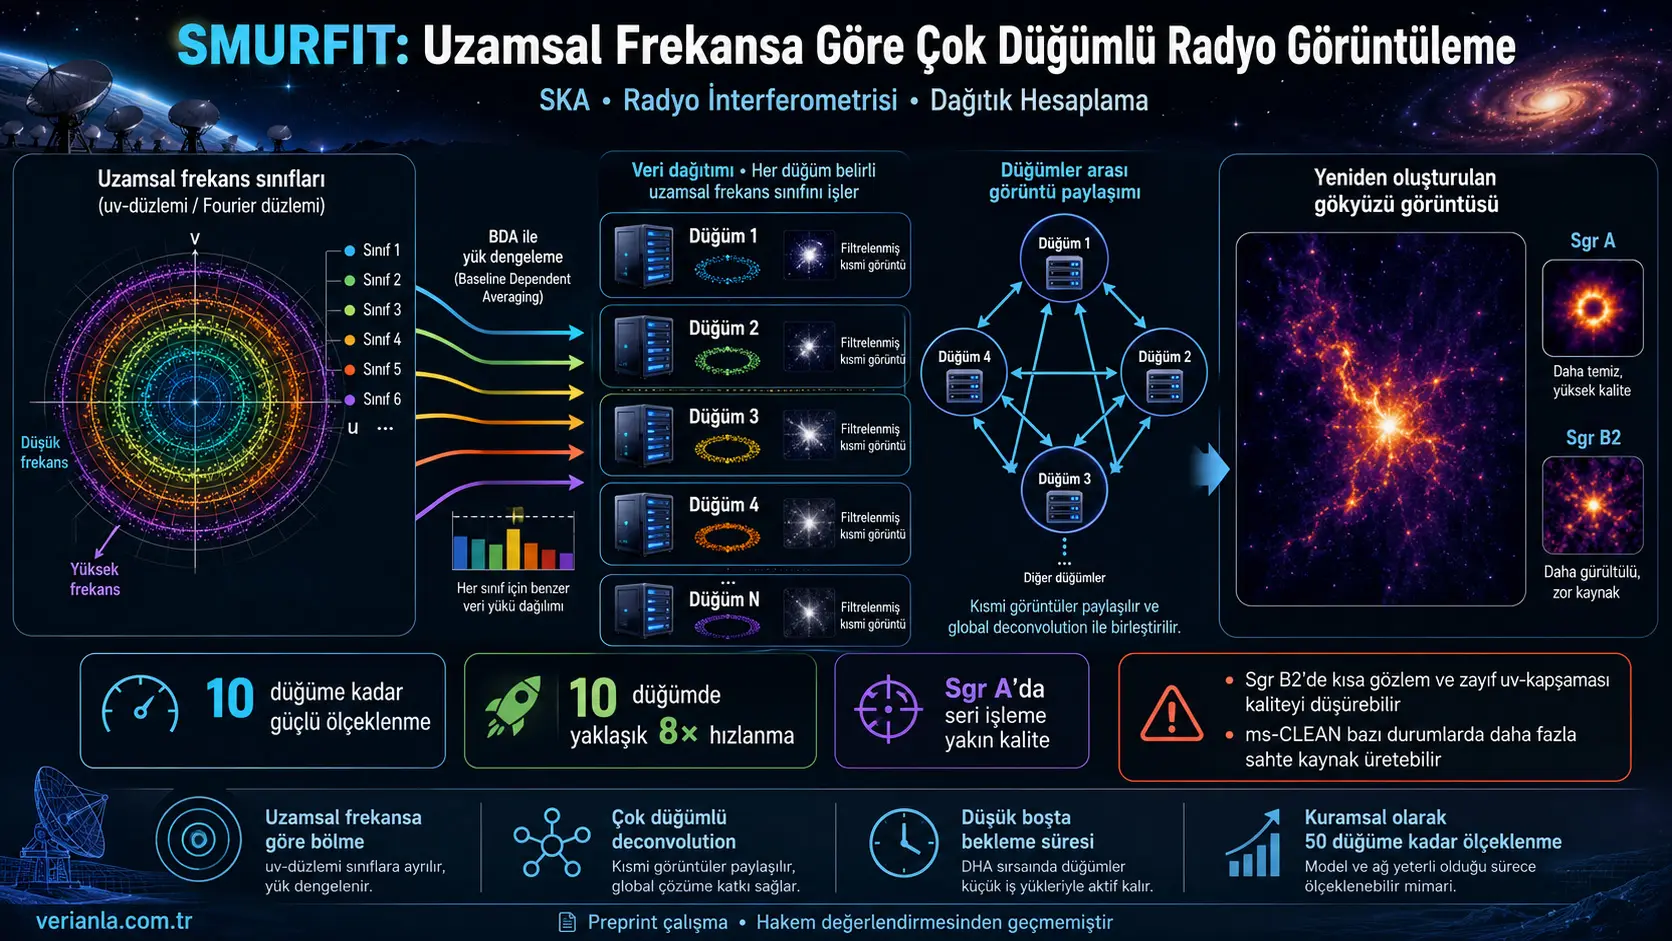
Utafiti huu umetengeneza mfumo wa SMURFIT unaosambaza mchakato wa radio-interferometric imaging kwenye idadi kubwa ya computational nodes kulingana na spatial frequencies za visibility data, na umeujaribu kwa majaribio ya nodes 4, 6, 8 na 10. Katika simulated datasets mbili zilizotokana na maeneo ya Sgr A na Sgr B2, SMURFIT ilidumisha image quality iliyo karibu na serial pipeline katika majaribio mengi huku ikitoa karibu linear computational speedup kwenye nodes 10. Proposed load-balancing model ilionyesha kwamba katika small transition regions, computation time inaweza kinadharia kuscale hadi angalau nodes 50. Hata hivyo, study inategemea simulations za pixels 512 × 512 badala ya real SKA observations; hasa katika Sgr B2 dataset yenye short observation duration na insufficient uv-coverage, multi-scale CLEAN method ilitengeneza false sources nyingi zaidi na lower image quality kuliko serial processing.
SMURFIT inageneralize SURFIT approach, ambayo hapo awali iligawa only low na high spatial frequencies kati ya nodes mbili, kwenda idadi yoyote ya spatial-frequency classes. Kila node inaprocess specific subset ya visibilities; baada ya first major cycle, nodes zinashare partial images zao ili kukamilisha missing spatial-frequency information. Hivyo, lengo ni kuchakata very large datasets kutoka radio telescopes bila kutegemea memory, input-output na processing capacity ya single node.
Important result ya study si kuongeza number ya nodes pekee. Watafiti walitengeneza new partitioning method based on baseline-dependent averaging na cumulative distribution ili kubalance SKA visibilities ambazo zinakuwa excessively dense kwenye short baselines kati ya classes. Katika experiments, low idle-waiting time ya nodes ilitambuliwa kama moja ya main reasons za observed speedup.
Main research question ni nini?
Main question ya study ni jinsi very large radio-interferometric datasets zitakazotengenezwa na SKA telescopes zinaweza kusambazwa kwenye computational nodes zaidi bila kuachana kabisa na traditional imaging algorithms. Watafiti hasa wanachunguza kugawa visibilities kulingana na spatial frequencies zao, si kulingana na electromagnetic frequency channels.
SKA-Mid telescope imepangwa kufanya kazi kutoka 350 MHz hadi 15,35 GHz, huku SKA-Low telescope ikiwa katika range ya 50–350 MHz. Antennas nyingi zinatengeneza baseline kwa kila antenna pair pamoja na associated visibility measurements. Kadiri number ya antennas na observation duration zinavyoongezeka, number ya visibilities inaweza kufikia billions of samples. Hii inafanya si processor time pekee, bali memory, disk access na data transfer kati ya nodes kuwa limiting factors.
Radio interferometer inatengeneza direct sky photograph?
Radio interferometer hairekodi direct two-dimensional photograph ya sky. Antenna pairs zinapima complex-valued visibilities zinazotokana na correlation ya electromagnetic field ya sky. Visibilities hizi zinaweza kufikiriwa kama samples za sky-brightness distribution katika Fourier space.
Katika study, basic measurement equation imetolewa hivi:
\[ V(u,v,w)=C\iint \frac{D(l,m)I(l,m)}{n} e^{-2\pi i[ul+vm+w(n-1)]}\,dl\,dm \]
\[ n=\sqrt{1-l^2-m^2} \]
- V(u,v,w): Complex visibility value inayopimwa na antenna pair.
- I(l,m): Sky-brightness distribution juu ya direction cosines.
- l, m na n: Dimensionless direction cosines zinazofafanua sky direction.
- u, v na w: Coordinates za baseline kati ya antennas zilizonscaleiwa kwa observation wavelength.
- C: Inawakilisha direction-independent instrumental effects kama antenna gain.
- D(l,m): Inawakilisha direction-dependent effects kama ionospheric phase changes au primary antenna beam.
Kwa sababu antenna array haiwezi kusample Fourier plane kikamilifu, inverse solution ya equation hii haiko well-conditioned. Kuchukulia unmeasured spatial frequencies kuwa zero kunatengeneza sidelobes na image structures around real sources. Kazi ya radio-imaging algorithms ni kutengeneza most accurate possible sky model chini ya incomplete measurements.
Major na minor cycles zinafanyaje kazi?
Kielelezo 1 katika study kinaonyesha traditional radio-interferometric imaging pipeline kwa three main steps: de/gridding, prediction na model update. Existing sky model inapelekwa kwenye measurement space, inatolewa kutoka measured visibilities, na remaining error inarudishwa kwenye image plane.
Katika n-th major cycle, residual image inahesabiwa hivi:
\[ \tilde{\imath}^{\,n}=F^{\dagger}G \left(v-G^{\dagger}F\hat{\imath}^{\,n}\right) \]
- v: Measured visibility vector.
- F na F†: Two-dimensional fast Fourier transform na inverse yake.
- G na G†: Gridding na inverse de-gridding operators zinazohamisha irregular visibility samples kwenda regular Fourier grid.
- în: Sky model mwanzoni mwa n-th major cycle.
- ĩn: Residual kati ya model na measurement, au “dirty image” katika first cycle.
Prediction algorithm inajaribu kutenganisha point-spread function iliyotengenezwa na measurement operator kutoka residual image. Resulting residual sky model inaongezwa kwenye existing model:
\[ \hat{\imath}^{\,n+1}=\hat{\imath}^{\,n}+\bar{\imath}^{\,n} \]
Kwa sababu deconvolution algorithm yenyewe pia ina iterations, outer process inaitwa “major cycle” na inner process “minor cycle”.
SURFIT inagawaje visibilities?
SURFIT inagawanya visibilities kwenye annular classes mbili kulingana na distance zao kutoka center ya uv-plane. Visibilities karibu na center zinawakilisha low spatial frequencies na large-scale structures za sky; visibilities mbali na center zinawakilisha high spatial frequencies na fine details.
Kielelezo 2 kinaonyesha low-frequency class L, high-frequency class H na overlapping transition region yao. Center radius ya transition region inafafanuliwa na ℓ, huku half-width ikiwa δ. Overlap inahitajika kwa sababu mbili:
- Kwa sababu convolutional gridding inasambaza visibility sample kwenye neighboring grid cells, classes haziwezi kutenganishwa kwa sharp line.
- Kwa sababu sharp Fourier cutoffs zinaweza kutengeneza ringing na oscillation katika image plane, smooth transition inahitajika.
Kielelezo 3 kinaonyesha working arrangement ya SURFIT nodes mbili. Katika first major cycle, kila node inareconstruct only own spatial-frequency range. Kuanzia second major cycle, nodes zinatumana filtered deconvolution residuals. Incoming images zinatumika kama approximate information inayochukua nafasi ya visibilities ambazo node haina. Katika final stage, full-resolution images mbili zinaunganishwa kwa weighted average.
SMURFIT inatofautianaje na SURFIT?
SMURFIT inageneralize two-class SURFIT structure kwenda K spatial-frequency classes na hivyo K computational nodes. Kila node inaprocess moja ya visibility subsets V0…VK−1 na inapokea filtered images kutoka other K−1 nodes.
Generalization hii haiwezi kufanywa kwa kuanzisha processes nyingi zaidi pekee. Deconvolution algorithms zinahitaji kuredefineiwa ili images kutoka all other nodes ziongezwe kwenye same objective function.
L1-regularized deconvolution imegeneralizeiwaje?
First method iliyotumiwa na study ni L1-regularized convex deconvolution inayotafuta sparse solution katika wavelet space. Basic single-node problem ni:
\[ \alpha^n=\arg\min_{\alpha} \left\|\tilde{\imath}^{\,n}-HW\alpha\right\|_2^2+ \lambda^n\|\alpha\|_1 \]
\[ \bar{\imath}^{\,n}=W\alpha^n \]
- H: Convolution operator yenye point-spread function.
- W: Wavelet-transform operator.
- α: Wavelet coefficients.
- λ: Regularization parameter inayodetermine balance kati ya data fit na sparse solution.
- ||α||1: Sum ya absolute values za coefficients, inayosuppress unnecessary components.
Katika SMURFIT, kwa j-th node, fit terms za images kutoka all other nodes zinaongezwa kwenye objective function:
\[ \begin{aligned} \alpha^{n}_{V_j}=\arg\min_{\alpha}\{& \|\Gamma_j(\tilde{\imath}^{\,n}_j-H_jW\alpha)\|_2^2+ \lambda^{n}_{V_j}\|\alpha\|_1 \\ &+\gamma_n\sum_{\substack{k=0\\k\neq j}}^{K-1} \|\rho^{\,n-1}_k-\Gamma_kW\alpha\|_2^2\} \end{aligned} \]
\[ \rho^{\,n-1}_k= \sum_{i=1}^{n-1}\Phi^i_k- \Gamma_k\sum_{i=1}^{n-1}\bar{\imath}^{\,i}_{V_j} \]
\[ \Phi^i_k=\Gamma_k\bar{\imath}^{\,i}_{V_k} \]
Γj na Γk ni filters zinazoruhusu only spatial-frequency band ya relevant node kupita. ρk inawakilisha difference kati ya image iliyopokelewa kutoka other node na same frequency components ambazo tayari zipo katika previous estimate ya j-th node. Hivyo same information haiongezwi mara mbili.
Katika first major cycle hakuna previous images kutoka other nodes, kwa hiyo γn ni zero. Katika subsequent cycles, γn inawekwa one na inter-node information inaingia kwenye objective function.
Kwa nini regularization parameter iliredefineiwa?
Katika two-node SURFIT, λ parameter ingeweza kuchaguliwa kwa simple decay rule depending on norm ya residual image na major-cycle number:
\[ \lambda^n=a\|\tilde{\imath}^{\,n}\|_2\,b^n \]
Study iliona kwamba rule hii inahitaji separate manual tuning kwa kila node wakati node count ni kubwa. Badala yake, λmax inayotegemea L1-regularization boundary ambapo nonzero solution inaweza kuzalishwa ilitumika:
\[ \lambda^{n}_{\max,V_j} =2\left\|W^{\dagger} \left( H_j^{\dagger}\Gamma_j^{\dagger}\Gamma_j\tilde{\imath}^{\,n}_j+ \gamma_n\sum_{\substack{k=0\\k\neq j}}^{K-1} \Gamma_k^{\dagger}\rho^{\,n-1}_k \right)\right\|_{\infty} \]
Actual regularization value inachaguliwa kama fraction ya upper bound hii:
\[ \lambda^{n}_{V_j}=c\,\lambda^{n}_{\max,V_j} \]
\[ c=a+(1-a) \frac{\exp[b(n-1)/N]}{\exp(b)-1} \]
a inaamua c value katika first cycle; b steepness ya increase across major cycles; N total number ya major cycles. Kadiri cycles zinavyoendelea residual image inakuwa noise-dominated zaidi, kwa hiyo c inaongezwa. Kufika kwa c hadi one katika final major cycle kunalenga kuzuia algorithm ku-over-reconstruct noise.
Multi-scale CLEAN imefanywaje multi-node?
Second method, multi-scale CLEAN, ni greedy algorithm inayochagua brightest component katika residual image kwa suitable spatial scale na kuiongeza kwenye model:
\[ \bar{\imath}^{\,n} =\operatorname{ms\mbox{-}CLEAN} (\tilde{\imath}^{\,n},H,S,K_{\mathrm{iter}}) \]
Katika SMURFIT, local residual image na images kutoka other nodes zinaunganishwa kwa kila node ili kuunda pseudo-full-resolution residual image na point-spread function:
\[ \tilde{\imath}^{\,n}_{V_j} =\mu_j\Gamma_j\tilde{\imath}^{\,n}_j+ \sum_{\substack{k=0\\k\neq j}}^{K-1} \mu_kH_k\rho^{\,n-1}_k \]
\[ H_{V_j}= \mu_j\Gamma_jH_j+ \sum_{\substack{k=0\\k\neq j}}^{K-1} \mu_k\Gamma_kH_k \]
μ coefficients zinaunganisha normalized point-spread functions za different nodes kwa correct weights. Tofauti na L1 method, inverse-variance weighting haikutumika kwa ms-CLEAN; watafiti wanasema haiko clear jinsi weighting hiyo inavyopaswa kutumiwa katika greedy CLEAN steps.
Load-balancing problem ilitatuliwaje?
Kwa sababu de/gridding inachukua sehemu kubwa ya total time, kila node inapaswa kuprocess approximately same number ya visibilities. Kwa kuwa visibilities zinagawanywa katika isotropic rings, two-dimensional uv-plane problem ilireduceiwa kuwa one-dimensional distribution inayotumia distance kutoka center.
P(x) ni normalized visibility density, huku C(x) ikiwa cumulative distribution function:
\[ C(x)=\int_{-\infty}^{x}P(u)\,du \]
Kwa K classes, K−1 transition centers ℓ1…ℓK−1 zinachaguliwa. Conditions zifuatazo zinatafutwa ili visibility share ya kila class iwe α:
\[ C(\ell_1+\delta)=\alpha \]
\[ C(\ell_n+\delta)-C(\ell_{n-1}-\delta)=\alpha, \quad n\in\{2,\ldots,K-1\} \]
\[ 1-C(\ell_{K-1}-\delta)=\alpha \]
α ikijulikana, transition centers zinaweza kuhesabiwa sequentially:
\[ \ell_1(\alpha)=C^{-1}(\alpha)-\delta \]
\[ \ell_n(\alpha)= C^{-1}\left[C(\ell_{n-1}(\alpha)-\delta)+\alpha\right]-\delta \]
Ili final class iwe na same size pia, root ifuatayo inasolveiwa:
\[ C(\ell_{K-1}-\delta)+\alpha-1=0 \]
Kwa kuwa function ni monotonic kwa α, watafiti walitumia bisection method. Kama transition regions zinaoverlap excessively au zaidi ya classes tatu zina contain same visibilities, configuration ilichukuliwa invalid. Constraint hii inazuia same visibility kuprocessiwa repeatedly kwenye nodes nyingi na very narrow frequency windows kutengeneza large sidelobes.
Kwa nini baseline-dependent averaging inahitajika?
Kwa kuwa SKA-Mid AA4 antenna layout ina short baselines nyingi, visibilities zinakuwa excessively dense katika center ya uv-plane. Upper histogram ya Kielelezo 5 inaonyesha kwamba bila averaging, transition regions za classes tano zinaoverlap sana na balanced partitioning inashindwa.
Watafiti walipunguza tatizo hili kwa baseline-dependent averaging (BDA). BDA inabalance data density kwa ku-average dense samples kwenye short baselines zaidi, na samples kwenye long baselines kwa kiwango kidogo. Allowed total correlation loss inafafanuliwa hivi:
\[ \rho=\rho_f\rho_t \]
\[ \rho_f=\operatorname{sinc} \left(\frac{\pi\nu_{\Delta}\tau_g}{2}\right) \]
\[ \tau_g=\frac{1}{c} \left[ul+vm+w(n-1)\right] \]
\[ \rho_t=\operatorname{sinc} \left\{\pi T\left( \frac{du}{dt}l+ \frac{dv}{dt}m+ \frac{dw}{dt}(n-1) \right)\right\} \]
Kwa short integration times, time-induced correlation loss inahesabiwa kwa third-order Taylor approximation:
\[ \rho_t\approx 1-\frac{\pi^2T^2}{6} \left( \frac{du}{dt}l+ \frac{dv}{dt}m+ \frac{dw}{dt}(n-1) \right)^2 \]
- ρ: Dimensionless fraction ya correlation inayobaki baada ya averaging.
- ρf: Decorrelation value inayosababishwa na frequency averaging.
- ρt: Decorrelation value inayosababishwa na time averaging.
- νΔ: Channel bandwidth.
- T: Integration duration, katika seconds.
- τg: Geometric delay kati ya source na phase center, katika seconds.
Time derivatives za uv-coordinates zilihesabiwa kwa kutumia horizontal baseline components na Earth rotation rate:
\[ \frac{du}{dt}= \frac{1}{\lambda} (L_x\cos H-L_y\sin H)\omega \]
\[ \frac{dv}{dt}= \frac{1}{\lambda} (L_x\sin\delta_s\sin H+ L_y\sin\delta_s\cos H)\omega \]
\[ \frac{dw}{dt}= \frac{1}{\lambda} (-L_x\cos\delta_s\sin H- L_y\cos\delta_s\cos H)\omega \]
Hapa λ inawakilisha observation wavelength, H hour angle, δs source declination, na Lx pamoja na Ly baseline components. Earth rotation rate ilitumika kama ω = 7,2925 × 10⁻⁵ rad/s.
Katika experiments, averaging ilifanywa only along time axis na worst-case decorrelation ikatumika kama msingi. Averaging levels zilichaguliwa kama powers of two ili kuhifadhi data structure. Lower histogram ya Kielelezo 5 inaonyesha kwamba baada ya BDA katika threshold ya ρ > 0,99, visibility density ilibalanceika significantly na classes zikaweza kutenganishwa more evenly.
Simulated datasets zilitengenezwaje?
Kwa datasets zote mbili, kwanza visibility locations zilisimulateiwa kulingana na telescope geometry na observation parameters, kisha sky model ika-de-grid kwenye locations hizo ili kutengeneza visibility values, na katika final stage noise ikaongezwa. Sky models ni Sgr A na Sgr B2 cutouts kutoka MeerKAT 1,28 GHz Galactic Center mosaic, zikiwa na edges zilizosoftishwa.
Dirty images katika Kielelezo 6 zinaonyesha different characteristics za datasets. Sgr A image ina more regular central structure kwa sababu ya longer observation na denser uv-coverage. Katika Sgr B2 image, broad sidelobe na noise structures zinazohusiana na shorter observation zinaonekana more clearly.
Main results za experiments ni zipi?
Computational speedup
Kielelezo 7 kinaonyesha measured wall-clock speedups zikiwa close na theoretical curves zinazotokana na assumption ya perfect load balancing. Katika nodes kumi, experimental speedup ni roughly 7,5–8,5 times kutoka graph, kutegemea dataset na deconvolution method. Ingawa value hii iko chini ya perfect 10-fold speedup, inaongezeka largely linearly na node count.
ms-CLEAN ilifanya kazi faster kuliko L1 deconvolution. Hata hivyo, kwa kuwa deconvolution inachukua small fraction ya total time, hakukuwa na large difference kati ya scaling curves za methods mbili.
Sgr A image quality
Katika Sgr A panels za Kielelezo 8, final signal-to-noise ratios za SMURFIT results kutoka nodes nne hadi kumi ziko close na serial pipeline na close kwa kila nyingine. L1 deconvolution results zinafikia roughly 12–13 dB katika final major cycles, huku ms-CLEAN results zikikusanyika roughly katika range ya 10–11 dB.
ms-CLEAN results zilibaki slightly below final value ya serial pipeline. Main reason ni kwamba SMURFIT inatumia images zilizotengenezwa katika previous major cycle na other nodes, na kwa hiyo inaendelea roughly one major cycle behind serial pipeline.
Sgr B2 image quality
Katika Sgr B2 dataset, difference kati ya SMURFIT na serial pipeline ni kubwa zaidi. Hasa ms-CLEAN ilitengeneza lower signal-to-noise ratios kuliko serial pipeline kadiri node count ilivyoongezeka. Katika ten-node image ya Kielelezo 9, artificial points nyingi zaidi na widespread error zinaonekana around real sources.
Sgr B2 observation ina hour-angle range ya only minutes 30, huku Sgr A observation ikidumu hours nne. Shorter observation inasample uv-plane more sparsely na kuongeza sidelobes katika point-spread function. Kwa kuwa kugawa spatial frequencies kwenye classes zaidi kunapunguza support ya kila node, sidelobes hizi zinakuwa even more pronounced.
Point-spread-function cuts katika Kielelezo 10 zinaonyesha kwamba oscillations around central peak katika ten-node class ya Sgr B2 ni stronger kuliko serial solution. ms-CLEAN, ambayo inachagua brightest component greedily, inaweza kutafsiri sidelobes hizi kama real sources.
Per-node parameter tuning
Watafiti walitune parameters za kila node manually kwa Sgr B2. Kulingana na Kielelezo 11, ms-CLEAN results ziliimprove, lakini ilihitajika kusacrifice resolution ili kupata fewer false sources na quality ya serial solution haikufikiwa. Katika L1 method, increasing regularization parameter more slowly kulifanya results kuwa roughly equivalent na serial pipeline.
Image quality na time zikitathminiwa pamoja
Kielelezo 12 kinaonyesha image quality directly against elapsed time. Hata four-node SMURFIT ilikamilisha all five major cycles kabla ya serial pipeline kukamilisha only preprocessing stage. Kwa hiyo, katika some cases limited image-quality loss hutokea in exchange for much shorter computation time.
Main bottleneck ni process gani?
Kielelezo 13 kinagawa per-node times za L1 na Sgr A experiments katika reading, gridding, de-gridding, deconvolution, waiting na other operations. Katika all node configurations, largest component ni data-reading time.
Watafiti waligundua kwamba most time haikutumika katika physical disk transfer, bali katika table.query call ya casacore software na katika RASCIL kubadilisha disk ordering kwenda own in-memory data structure. Pre-sorting measurement set na reading rows directly zimependekezwa kama main improvement inayoweza kupunguza bottleneck hii.
Kadiri node count ilivyoongezeka, L1 deconvolution cost pia iliongezeka. Sababu ni kwamba variance inahesabiwa kwa kila image iliyopokelewa kutoka kila node kwa 5 × 5 moving window inayohifadhi local structure. Kwa kuwa ms-CLEAN haitumii inverse-variance weighting, cost hii inaongezeka less katika method hiyo.
Waiting times kubaki small relative kwa total time inaonyesha load-balancing method ilikuwa effective. Hata hivyo, kwa sababu small errors katika recursive class-boundary calculation zilikusanyika katika final class, kwenye high node counts final node ilifanya kazi slightly longer kuliko nyingine.
Nini kinatarajiwa kwa larger images?
Experimental images ni pixels 512 × 512. Study inasema SKA-Low single-pointing images zinaweza kufikia roughly 4.000 × 4.000, huku SKA-Mid images zikifikia roughly pixels 20.000 × 20.000. Kwa kuwa SMURFIT inatransfer images kati ya nodes katika kila major cycle, network communication ni potential bottleneck katika sizes hizi.
Katika previous experiments za watafiti, ingawa image-transfer time iliongezeka hadi pixels 10.000 × 10.000, deconvolution na de/gridding times pia ziliongezeka kwa similar rates na communication time ikabaki smaller kuliko other operations. Hata hivyo, study inasema testing real SKA sizes itahitaji kugawa image katika subregions, more scalable deconvolution na more efficient gridding methods.
Je, inaweza kuscale theoretically hadi nodes 50?
Kielelezo 14 kinatoa theoretical calculations hadi classes 50 kwa kubadilisha BDA decorrelation threshold ρ na ratio ya transition half-width kwa field of view δ:FoV. Katika small transition regions, theoretical speedup inayowakilishwa na 1/α katika nodes 50 inakaribia roughly 40–45 times.
Kadiri transition regions zinavyokuwa kubwa, number ya visibilities zinazocopyiwa kati ya neighboring classes inaongezeka, total workload value n × α inaongezeka, na number ya nodes ambayo valid class configurations zinaweza kufikia inapungua. Largest contribution ya BDA ilionekana katika first one-percent decorrelation range; kupunguza ρ zaidi kutoka 0,99 kulitoa only more limited additional contribution kwa load distribution.
Kielelezo 15 kinaonyesha root function kwa 20-node configuration. Katika large transition regions, function inakuwa very steep around root, na numerical solution inakuwa difficult. Kwa hiyo, 50-node results si real computation na image-quality experiments, bali theoretical estimates kutoka load-balancing model.
Strengths za study ni zipi?
- Inageneralize mathematically two-node method kwenda arbitrary number ya spatial-frequency classes.
- Inatest both widely used ms-CLEAN algorithm na L1-regularized convex deconvolution method.
- Inasolve load-balancing problem kwa explicit equations based on cumulative function ya visibility distribution.
- Inashughulikia directly short-baseline density katika SKA antenna layout kwa BDA.
- Inafanya real high-performance-computing experiments kwa nodes 4, 6, 8 na 10.
- Inagawa computation time si kama total time pekee, bali katika reading, gridding, de-gridding, deconvolution na waiting components.
- Inatathmini image quality pamoja na computation speed.
- Inaonyesha wazi Sgr B2 na ms-CLEAN case iliyotoa weak au unsuccessful results.
- Inatoa online repository kwa code, configurations, results na datasets.
Limitations za study ni zipi?
- Study ni preprint ambayo haijapitia peer review.
- Experiments hazikufanywa kwa real SKA observational data, bali kwa simulated visibilities zilizotengenezwa kutoka MeerKAT images.
- Images ni pixels 512 × 512 na ni much smaller kuliko expected SKA production images.
- Experiments zilifanywa hadi maximum nodes 10; 50-node result inategemea load-balancing model pekee.
- Noise haikutolewa kutoka SKA sensitivity calculator; iliwekwa kuwa %5 ya signal standard deviation.
- Katika simulations, pseudo RA-DEC coordinates zilitumika badala ya real sky coordinates za sources.
- Kwa kuwa per-node parameter tuning haiscale, same deconvolution parameters zilitumika katika main comparisons.
- SMURFIT ina information delay ya one major cycle.
- Katika poor uv-coverage, especially when ms-CLEAN is used, image quality inaweza kushuka significantly.
- Data-reading order na RASCIL/casacore queries zinachukua large portion ya total time.
- Kwa larger images, inter-node transfer, memory consumption na deconvolution cost hazijatestwa bado katika production scale.
Study inaunga mkono nini?
- Inaunga mkono kwamba radio-interferometric imaging visibilities zinaweza kusambazwa kwenye many nodes kulingana na spatial frequency.
- Inaonyesha kwamba proposed load-balancing na BDA combination inaweza kutoa low idle-waiting time kati ya nodes 4–10.
- Inaonyesha kwamba katika Sgr A-like case yenye good uv-coverage, distributed solution inaweza kutoa image quality close na serial processing.
- Inaonyesha kwamba roughly 7,5–8,5 times computational speedup inawezekana katika nodes kumi.
- Inaonyesha kwamba L1-regularized deconvolution inaweza kuwa more robust kuliko ms-CLEAN katika poor uv-coverage.
- Inaonyesha kwamba small transition regions zinaboresha theoretical scalability kwa kupunguza duplicated visibilities.
Study haithibitishi nini?
- Haithibitishi kwamba SMURFIT itatoa same image quality kama serial processing kwa all radio sources na all observation arrangements.
- Haionyeshi kwamba real SKA data stream inaweza kuprocessiwa successfully katika production environment.
- Haionyeshi experimentally kwamba image quality inabaki acceptable katika nodes hamsini.
- Haithibitishi kwamba network na memory bottlenecks zitakuwa insignificant katika SKA-Mid images zenye width ya pixels elfu ishirini.
- Haionyeshi kwamba ms-CLEAN inafaa katika all conditions kwa multi-node use.
- Haionyeshi kwamba used %5 relative noise level inawakilisha real SKA instrumental noise.
- Haithibitishi kwamba theoretical speedup itaendelea linearly bila limit kadiri node count inavyoongezeka.
Mbinu na Matokeo ya Utafiti
Dataset na observation parameters
| Feature | Sgr A dataset | Sgr B2 dataset |
|---|---|---|
| Sky model | Sgr A region kutoka MeerKAT 1,28 GHz mosaic | Sgr B2 region kutoka MeerKAT 1,28 GHz mosaic |
| Telescope layout | SKA-Mid AA4 | SKA-Low AA4 |
| Hour-angle range | −2 hadi +2 hours; total 4 hours | −0,25 hadi +0,25 hours; total minutes 30 |
| Center electromagnetic frequency | 1 GHz | 200 MHz |
| Number ya channels | 128 | 128 |
| Channel width | 10 kHz | 10 kHz |
| Visibility time interval | Seconds 5 | Seconds 5 |
| Pseudo RA-DEC | [56; −15] | [56; −15] |
| Noise standard deviation | 0,05 × σsignal | 0,05 × σsignal |
| Visibility weighting | Uniform | Uniform |
| Image size | Pixels 512 × 512 | Pixels 512 × 512 |
Noise haikuhesabiwa kulingana na real SKA sensitivity. Kwa sababu sources katika study zilikuwa kwenye dJy na cJy scale huku SKA sensitivity calculator ikitoa values kwenye µJy scale, noise iliwekwa kuwa %5 ya signal standard deviation.
Visibility counts kabla na baada ya BDA
| Dataset | Original visibility count | Visibility count baada ya ρ = 0,99 BDA | Approximate reduction |
|---|---|---|---|
| Sgr A | 7,189 × 109 | 3,118 × 108 | Roughly %95,7 |
| Sgr B2 | 6,052 × 109 | 4,527 × 108 | Roughly %92,5 |
BDA haikupunguza data amount pekee; pia ilipunguza excessive density kwenye short baselines na kutengeneza more balanced distribution kati ya classes.
Spatial-frequency classes
| Dataset | Node/class count | Visibility share α ya kila class | Visibility increase kwa sababu ya overlap |
|---|---|---|---|
| Sgr A | 4 | 0,270 | %8,10 |
| Sgr A | 6 | 0,177 | %6,47 |
| Sgr A | 8 | 0,147 | %17,35 |
| Sgr A | 10 | 0,118 | %18,07 |
| Sgr B2 | 4 | 0,267 | %6,79 |
| Sgr B2 | 6 | 0,191 | %14,67 |
| Sgr B2 | 8 | 0,144 | %15,53 |
| Sgr B2 | 10 | 0,120 | %19,45 |
α value si exactly 1/K kwa sababu ya overlap katika transition regions. Kadiri class count inavyoongezeka, transition regions zaidi zinatokea na some visibilities zinarudiwa kwenye neighboring nodes.
Deconvolution parameters
| Method na dataset | Minor-cycle count | Relative threshold | Absolute threshold | Gain au regularization parameters |
|---|---|---|---|---|
| ms-CLEAN – Sgr A | 2.000 | 1 × 10⁻³ | 1 × 10⁻⁴ | Gain: 0,1 |
| ms-CLEAN – Sgr B2 | 1.500 | 5 × 10⁻³ | 1 × 10⁻³ | Gain: 0,1 |
| L1 – Sgr A | 100 | Not applicable | Not applicable | a = 0,01; b = 10 |
| L1 – Sgr B2 | 200 | Not applicable | Not applicable | a = 0,04; b = 10 |
Serial pipeline na SMURFIT ziliendesha major cycles tano kwa same basic deconvolution parameters. Spatial scales za kutumiwa katika first major cycle ya ms-CLEAN zilichaguliwa kupitia preliminary experiments kwa sababu ya limited frequency bandwidth.
Software na computing infrastructure
| Component | System iliyotumika |
|---|---|
| Computing cluster | IDRIS Jean Zay high-performance computing cluster |
| Node use | Dedicated cpu_p1 node kwa kila spatial-frequency class |
| Implementation language | Python |
| Radio astronomy library | RASCIL |
| Gridding/de-gridding | Improved w-stacking implementation ndani ya ducc0 |
| Inter-node parallelization | mpi4py |
| Data format | Measurement Set v2 |
Summary ya main findings
| Finding | Result katika study | Interpretation limit |
|---|---|---|
| 4–10 node scaling | Measured speedup iliongezeka largely linearly na node count | Katika nodes kumi, badala ya perfect 10-fold, roughly 7,5–8,5-fold speedup ilipatikana |
| Sgr A image quality | Most SMURFIT configurations zilitoa result close na serial pipeline | ms-CLEAN iliendelea roughly one major cycle behind |
| Sgr B2 image quality | Especially katika ms-CLEAN, lower quality na more false sources kuliko serial processing zilitokea | Short observation na weak uv-coverage zilikuwa main factors |
| L1 robustness | Kwa per-node tuning, quality roughly equivalent na serial Sgr B2 result ilipatikana | Manual node tuning si practical katika very large systems |
| Load balancing | Idle-waiting times kati ya nodes zilibaki low | Recursive error accumulation ilionekana katika final class |
| Main bottleneck | Reading, querying na reordering measurement set zilichukua large part ya total time | Result inategemea current RASCIL na casacore implementation |
| Theoretical nodes 50 | Roughly 40–45-fold theoretical speedup ilitabiriwa katika small transition regions | Image quality na real runtime hazikutestwa katika nodes 50 |
Overall result ni kwamba, ikiwa kuna sufficient uv-coverage na suitable deconvolution method, SMURFIT inaweza kusambaza radio-interferometric imaging effectively kulingana na spatial frequency. Hata hivyo, method inahitaji kuvalidateiwa kwa real SKA production data, larger images na zaidi ya nodes 10.
Maelezo ya Chanzo na Mbinu
Jina kamili la asili la study:SMURFIT: Spatial-frequency Multi-class Radio Fourier Imaging Technique
Waandishi na mpangilio: Sunrise Wang, Simon Prunet, Shan Mignot na Andre Ferrari.
Equal first author: Study haijaeleza equal contribution au equal-first-authorship.
Corresponding author: Sunrise Wang. Study imetoa contact address sunrise.wang@oca.eu.
Institutional affiliation: Université Côte d’Azur, Observatoire de la Côte d’Azur, CNRS, 06000 Nice, Ufaransa. Katika uploaded version, authors wote wanne wameonyeshwa chini ya same institutional marker.
DOI:10.2139/ssrn.6967740.
Journal: Hakuna specific peer-reviewed journal name iliyotolewa. First page ya study ina phrase “Preprint submitted to Elsevier”; phrase hii peke yake si evidence ya acceptance au publication na Elsevier journal.
Publication platform: SSRN.
Original publisher: Hakuna final peer-reviewed journal publisher aliyethibitishwa.
Publication year: 2026. Text ina preprint submission date ya 17 Juni 2026 na SSRN record date ya 19 Juni 2026.
Source type: Technical research preprint yenye numerical method, simulated-data analysis na high-performance-computing experiments.
Peer-review status: Study hii ni preprint ambayo haijapitia peer review; results zinapaswa kusomwa kwa kuzingatia limitation hii. Chini ya kila page pia inaelezwa kwamba study haijapitia peer review.
Official publication link:Official SSRN study record.
Code na experiment repository:Researchers’ radio-imaging repository.
Maelezo haya ya Kituruki yameandaliwa kwa kuchunguza uploaded study text, formulas, tables, graphs na images kutoka mwanzo hadi mwisho. Hakuna new result kutoka external sources iliyoongezwa kwenye scientific findings. External verification ilitumika only kukagua full names na order ya authors, DOI, SSRN record na publication status.
Main methodological limitations za study ni matumizi ya simulation badala ya real SKA data, images kuwa limited kwa pixels 512 × 512, noise kuwekwa kuwa %5 ya signal standard deviation badala ya real instrument sensitivity, experiments kufanywa hadi maximum nodes 10, na 50-node result kuwa only theoretical load-balancing estimate. Sgr B2 experiments pia zinaonyesha kwamba weak uv-coverage inaweza kuathiri seriously distributed deconvolution quality.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *