

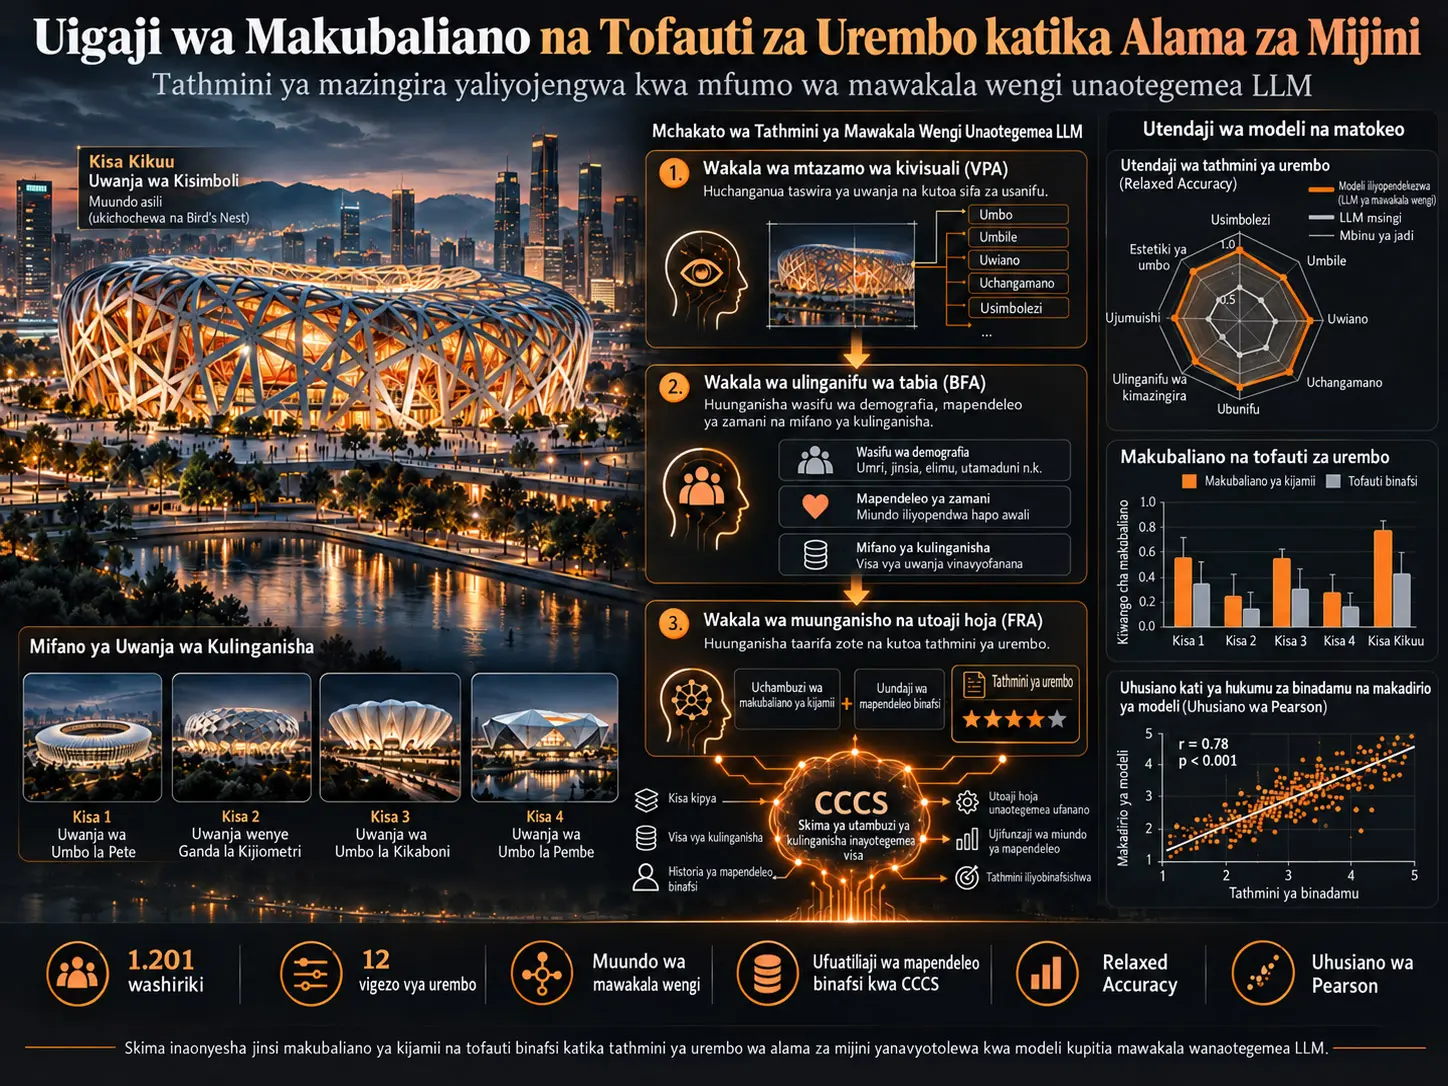
Jengo kuonekana na watu kuwa zuri, la kuvutia, changamano au linaloendana na mazingira halitokani tu na sifa za kimwili za jengo lenyewe. Tathmini pia huundwa na uzoefu wa awali wa mtazamaji, taaluma yake, ujuzi wa usanifu, mapendeleo binafsi na ulinganisho na majengo aliyowahi kuona. Utafiti huu unajaribu kukokotoa tathmini ya urembo wa alama za mijini kwa mfumo wa mawakala wengi unaotumia Miundo Mikubwa ya Lugha (Large Language Models; LLM).
Kama kisa, Uwanja wa Taifa wa Beijing, unaojulikana sana kama Bird's Nest, umetumika. Mfumo una mawakala watatu maalumu wa akili bandia. Visual Perception Agent (VPA) hubadilisha sifa za kimwili za jengo kutoka kwenye picha kuwa maelezo ya maandishi yaliyo ya kimalengo. Behavioral Fitting Agent (BFA) hutumia sifa za kidemografia na mapendeleo ya awali ya mtumiaji kuunda wasifu wa tabia. Fusion & Reasoning Agent (FRA) huunganisha ukweli wa kuona na wasifu wa mtumiaji ili kutabiri alama za urembo.
Maendeleo makuu ya utafiti, Comparative Case-based Cognitive Schema (CCCS), hutumia tathmini halisi za mtu kuhusu viwanja vingine vinne kama rejea ya kiutambuzi. Bila CCCS, miundo hukaribia zaidi mwelekeo wa wastani wa urembo wa jamii na hufuatilia tofauti binafsi kwa udhaifu. Historia ya mapendeleo ya kulinganisha inapoongezwa, uhusiano wa Pearson wa miundo unaofuatilia utofauti binafsi huongezeka kwa kiwango kinachoonekana.
Katika mfumo ulioboreshwa, thamani ya juu zaidi ya relaxed accuracy ya jumla iliripotiwa kuwa %82,07 na MAE 0,887. Hata hivyo, relaxed accuracy huhesabu utabiri kuwa sahihi ikiwa unabaki ndani ya ±1 alama kutoka kwenye alama halisi ya mtumiaji katika kipimo cha Likert cha 1–5. Kwa hiyo kiwango hiki hakipaswi kufasiriwa kama usahihi wa darasa wa moja-kwa-moja.
Kwa nini urembo wa mijini hauwezi kuelezwa kwa jengo lenyewe pekee?
Wasanifu na wapangaji miji wanaweza kutathmini jengo kupitia umbo, uwiano, mfumo wa kubeba mizigo, muundo wa fasadi au uhusiano wake na mazingira. Mtumiaji wa kawaida anaweza kulichukulia jengo hilo hilo kwa namna ya kiintuitivu zaidi na kutoa miitikio ya kihisia na kiutambuzi kama “linapendeza”, “baridi”, “linavutia”, “changamano”, “geni” au “linaendana na mazingira”.
Utafiti unachukulia tofauti hii kama pengo la kiutambuzi kati ya wabunifu na watumiaji. Tafiti za jadi za Post-Occupancy Evaluation (POE; tathmini baada ya matumizi) zinaweza kupima pengo hili; hata hivyo, kukusanya sampuli kubwa kunahitaji muda na gharama, na kwa kuwa hufanywa baada ya usanifu kukamilika, matokeo mara nyingi hubaki ya kutazama nyuma.
Lengo la watafiti si kuondoa mrejesho wa binadamu, bali kupanua data halisi ya binadamu iliyo na ukomo kwa uigaji unaotegemea LLM ili kujenga mfumo wa tathmini unaoweza kutumiwa mapema zaidi katika hatua ya usanifu.
Tathmini ya Urembo Hufanywa Katika Vipimo Gani 12?
Utafiti unaiga mwitikio wa urembo kama muundo wa vipimo 12 unaojumuisha vigezo saba vya kimuundo, vitatu vya dhahania na viwili vya kihisia.
| Kipimo | Kigezo | Sifa kuu inayotathminiwa |
|---|---|---|
| Kimuundo | Umbo na sura | Jiometri na kontua ya jumla ya ganda la jengo |
| Kimuundo | Kipimo na uwiano | Uhusiano wa vipimo kati ya sehemu za jengo na mazingira |
| Kimuundo | Rangi | Toni, thamani na ukolezi wa rangi kwenye fasadi |
| Kimuundo | Nyenzo | Usemi wa kuona na kiteknolojia wa nyenzo za ganda la jengo |
| Kimuundo | Muundo wa uso | Ukwaruzi, ulaini na marudio ya uso |
| Kimuundo | Mapambo na maelezo | Vipengele vya sekondari vya usanifu vinavyoboresha fasadi |
| Kimuundo | Ufungikaji | Kiwango cha uwazi au kufungwa kwa nafasi ya jengo |
| Dhahania | Uchangamano | Kiasi na utofauti wa vipengele vya kuona |
| Dhahania | Mpangilio | Mpangilio wa kimantiki na usomaji wa umbo |
| Dhahania | Ulinganifu wa kimazingira | Kiwango cha kuungana na mazingira ya asili au yaliyojengwa |
| Kihisia | Kupendeza | Hisia kuu chanya/hasi ya kulipenda jengo |
| Kihisia | Kuvutia | Kiwango cha msisimko na uchochezi kinachosababishwa na jengo |
Data halisi za binadamu zilikusanywa vipi?
Utafiti ulitolewa tu kwa watu waliokuwa wameitembelea Bird's Nest kimwili. Ukusanyaji wa data ulikamilika Februari 2026 na baada ya majibu batili kuondolewa, washiriki 1.201 walibaki.
| Sifa | Mgawanyo |
|---|---|
| Jinsia | %56 wanawake, %44 wanaume |
| <18 miaka | %18,2 |
| 18–30 miaka | %19,0 |
| 31–45 miaka | %17,0 |
| 46–60 miaka | %16,4 |
| >60 miaka | %29,4 |
| Ziara moja | %17,6 |
| Ziara 2–3 | %26,3 |
| Ziara ≥4 | %56,1 |
| Historia ya sanaa/usanifu | %91,2 |
Kwa kuwa %82,4 ya washiriki walikuwa wameitembelea stadion angalau mara mbili, seti ya data inawakilisha zaidi watumiaji waliozoea jengo kwa kiwango fulani kuliko watalii wanaoliona kwa mara ya kwanza.
Hata hivyo, kiwango cha %91,2 cha historia ya sanaa/usanifu ni cha juu sana. Kwa hiyo haifai kutafsiri matokeo ya utafiti kama “maoni ya wastani ya umma kwa ujumla” bila uthibitishaji wa ziada.
Tathmini ya Likert
Watumiaji walitathmini kuridhika kwao kwa jumla kwa urembo na vipimo 12 tofauti vya urembo kati ya:
1 = kutoridhika kabisa
na
5 = kuridhika kabisa
.
Linear Rank Weighting ilitumika kubadilisha mpangilio ambao mtumiaji anazipa umuhimu sifa za kuona kuwa uzito wa nambari:
\[ W=\frac{M-r+1}{M} \]
Hapa \(M\) ni idadi ya jumla ya viashiria katika kategoria na \(r\) ni nafasi ambayo mtumiaji ameipa sifa husika.
CCCS ni Nini na Inajaribu Vipi Kunasa Mapendeleo Binafsi?
Comparative Case-based Cognitive Schema hutumia alama halisi ambazo mtu amewahi kutoa kwa viwanja vingine kama kumbukumbu binafsi ya urembo badala ya kutabiri tathmini yake ya Bird's Nest kutoka kwenye sifa za kidemografia pekee.
Majengo manne ya kulinganisha
Mbali na Bird's Nest, viwanja vinne vya China vilitumika:
- Chengdu Fenghuangshan Sports Park Football Stadium
- Shanghai Pudong Football Stadium
- Xi'an Olympic Sports Center Stadium
- Quzhou Stadium
Majengo haya yalichaguliwa hasa kwa sababu yana sifa tofauti za umbo, nyenzo, muundo wa uso, ufungikaji na uhusiano wa kimazingira.
Kwa mfano, Bird's Nest inaelezwa katika chanzo kwa gridi ya chuma iliyosokotwa kwa hali ya mkanganyiko na kipimo cha monumental; Quzhou Stadium inaelezwa kama usanifu wa kitopografia, unaoungana na mandhari na wa kiorganiki. Hivyo, kutoka kwenye mifano ya kulinganisha inaweza kubainishwa ni sifa zipi za kuona ambazo mtumiaji huzijibu kwa chanya au hasi.
Usanifishaji wa vichocheo vya kuona
Picha mbili zilitumika kwa kila jengo:
- mwonekano wa angani wa kiwango cha makro,
- mwonekano wa karibu unaoonyesha maelezo ya fasadi na nyenzo.
Lengo ni kujumuisha si tu silueti ya jumla, bali pia muundo wa uso na sifa za tektoniki katika kiwango cha mikro kwenye mfumo wa tathmini.
Mawakala Watatu wa Akili Bandia Hushughulikia Majukumu Gani?
1. Visual Perception Agent — VPA
VPA haitathmini picha ya stadion moja kwa moja kuwa “nzuri/mbaya”. Jukumu lake ni kubadilisha picha kuwa maelezo ya kimwili yaliyo ya kimalengo.
Kwa mfano:
“exposed, unpainted Q460 steel”
inaweza kuunda maelezo ya kimwili ya nyenzo kama hayo.
Maelezo yanayotolewa na agent katika vipimo 10 vya kuona yaliwekwa chini ya maneno 20, na matumizi ya vivumishi vya kihisia vya kibinafsi yalizuiwa kupitia prompt.
2. Behavioral Fitting Agent — BFA
BFA huunda wasifu wa tabia ya urembo ya mtumiaji.
Kwanza huchuja wagombea wanaofaa kwa kuzingatia jinsia, umri, taaluma na sifa nyingine za kidemografia. Kisha ufanano wa cosine huhesabiwa kati ya vekta za sifa-uzito za watumiaji.
Kundi lenye watu:
\[ K=20 \]
wanaofanana zaidi na mtumiaji lengwa huchaguliwa.
Wastani wa tathmini wa kundi hili huwa Social Baseline, yaani alama ya kuanzia ya kijamii.
CCCS inapowashwa, majibu ya awali ya mtumiaji kuhusu viwanja vinne vya kulinganisha huongezwa pia kwenye wasifu. Hivyo mfumo hautumii tu swali “watu wa kundi hili la umri wanafikiri nini?”, bali pia “mtu huyu mahususi alipenda aina gani ya usanifu hapo awali?”.
3. Fusion & Reasoning Agent — FRA
FRA huunganisha sifa za kimwili za jengo kutoka VPA na modeli ya mtumiaji ya BFA.
Mantiki ya msingi:
- Unda alama ya kuanzia ya kijamii kutoka kwa majirani K=20.
- Chukua sifa za kimwili za jengo lengwa kutoka VPA.
- Angalia mapendeleo chanya/hasi ya awali ya mtumiaji.
- Ikiwa sifa zinaendana na pendeleo chanya, ongeza alama.
- Ikiwa zinaendana na pendeleo hasi, punguza alama.
- Ikiwa hakuna ulinganifu na pendeleo la awali, rudi kwenye social baseline.
Mbinu hii iliundwa ili kuzuia modeli kutengeneza kwa uhuru hoja za urembo inapokosa muktadha.
Kwa nini utabiri uleule unaendeshwa mara tano?
Matokeo ya LLM ni ya kinasibu kwa sababu ya temperature na token sampling. Kwa hiyo FRA huendesha kazi ileile kwa kila jozi ya mtumiaji–jengo:
\[ N=5 \]
mara kwa kujitegemea.
Alama ya mwisho ni wastani wa hesabu wa utabiri tano.
Chanzo kinaita hili Ensemble Averaging Strategy.
Mbinu na Matokeo ya Utafiti
Uthabiti wa ndani wa utafiti
| Takwimu | Matokeo |
|---|---|
| Cronbach α | 0,950 |
| Vipimo vidogo | Vyote >0,85 |
| KMO | 0,965 |
| Jaribio la Bartlett | p<0,001 |
Matokeo haya yanaunga mkono uthabiti wa juu wa ndani wa chombo cha tathmini chenye vigezo 12 ndani ya seti ya data ya chanzo.
Kwa nini LLM kumi tofauti zilijaribiwa?
Ili kuona kama mfumo unategemea modeli msingi moja, LLM kumi tofauti kutoka makundi ya proprietary na open-weights zilitathminiwa chini ya muundo uleule wa jumla wa mawakala.
Miongoni mwa zilizochunguzwa katika chanzo ni GPT-5.1, GPT-5.2, GPT-4.1, Gemini 2.5 Flash, Gemini 3 Flash, Claude 4.5, GLM 4.7, Qwen 3, Llama 3.3 na DeepSeek.
Miundo yote iliendeshwa kupitia API rasmi za wingu, chini ya muundo uleule wa kazi, na reasoning temperature:
\[ T=0,7 \]
iliwekwa. Matokeo yalizuiliwa kwa muundo wa lazima wa JSON.
Relaxed Accuracy ina maana gani hasa?
Kigezo kikuu cha usahihi cha utafiti ni:
\[ |Pred-True|\le1 \]
.
Kwa mfano, ikiwa alama halisi ya mtumiaji ni 4:
- 3 → sahihi kwa relaxed,
- 4 → sahihi kwa relaxed na exact,
- 5 → sahihi kwa relaxed,
- 1 au 2 → si sahihi kwa relaxed
huhesabiwa hivyo.
Kwa hiyo wakati wa kutathmini relaxed accuracy, uvumilivu wa ±1 wa kipimo chenye kategoria 5 lazima uzingatiwe.
Utendaji msingi bila pendeleo la kulinganisha
Wakati CCCS haitumiki, relaxed accuracy ya juu zaidi ya jumla:
GPT-5.1: %80,43
iliripotiwa.
Chanzo kinaonyesha kuwa miundo yote iliweza kuweka utabiri mwingi ndani ya eneo la ±1 la alama sahihi ya Likert, lakini ilipata ugumu kunasa tofauti za utu/mapendeleo binafsi.
Mfumo unafanikiwa zaidi wapi?
Mfumo msingi una nguvu hasa katika vipimo vya jumla zaidi vya utambuzi kama:
- ulinganifu wa kimazingira,
- kupendeza,
- nyenzo
.
Kwa upande mwingine:
- mapambo na maelezo,
- kuvutia
ndizo changamoto kuu za utabiri.
Watafiti wanahusisha hili na kutotosha kwa lebo za kidemografia kueleza mapendeleo madogo ya kuona na hisia zenye uchochezi mkubwa.
Nini Kilibadilika CCCS Ilipoongezwa?
Historia ya majengo ya kulinganisha ilipoongezwa, mabadiliko yaliyo wazi zaidi yalionekana si tu katika usahihi wa jumla, bali pia katika uwezo wa miundo kufuatilia tofauti za watumiaji binafsi.
| Kigezo cha mfumo ulioboreshwa | Matokeo yaliyoripotiwa |
|---|---|
| Gemini 3 Flash relaxed accuracy | %82,07 |
| Gemini 3 Flash MAE | 0,887 |
| Qwen 3 relaxed accuracy | %80,11 |
| Gemini 3 Flash Pearson | 0,255 |
| Qwen 3 Pearson | 0,199 |
| Wastani wa juu zaidi wa Pearson ulioripotiwa | 0,317 |
Jambo muhimu katika matokeo haya ni hili: relaxed accuracy tayari iko karibu na %80 katika mfumo msingi. Athari kuu ya CCCS si ongezeko la pointi chache katika usahihi wa jumla, bali kufuatilia vizuri zaidi tabia ya watu kutoa alama tofauti kutoka kwa wenzao.
Regression to the mean ni nini?
Katika hali ya msingi, nyingi za coefficients za uhusiano wa Pearson za miundo hubaki chini ya 0,05. Hii inaendana na modeli kutoa utabiri salama ulio karibu na alama ya wastani ya kundi badala ya kufuatilia mabadiliko binafsi ya watumiaji.
CCCS ilipoongezwa, uhusiano uliongezeka katika miundo yote kumi. Baadhi ya ongezeko katika chanzo:
\[ \Delta r=+0,138\; \text{ile}\; +0,272 \]
hufikia kiwango hiki.
Kwa hiyo, katika istilahi za utafiti wenyewe, CCCS inapunguza mwelekeo wa “regression to the mean” wa modeli.
Je, kila modeli inanufaika na CCCS kwa kiwango sawa?
Hapana.
Katika hatua ya msingi GPT-5.1 ilikuwa ya kwanza kwa takriban %80,4, lakini CCCS ilipoongezwa ilishuka kwa takriban -0,7 pointi ya asilimia.
Gemini 3 Flash ilipata takriban:
+4,3 pointi ya asilimia
na kupanda hadi nafasi ya kwanza karibu na %82,1.
Chanzo kinahusisha hili na tofauti katika uwezo wa usanifu wa LLM mbalimbali kutumia taarifa za mapendeleo ya kimuktadha zenye vipimo vingi. Hata hivyo, kutokana na usanifu wa modeli uliofungwa, utaratibu wake wa ndani haujaonekana moja kwa moja.
Athari ya CCCS kwa kila kipimo
Katika mfumo ulioboreshwa, Gemini 3 Flash:
| Kipimo | Relaxed Accuracy |
|---|---|
| Kupendeza | %91,1 |
| Ulinganifu wa kimazingira | %88,6 |
Katika vigezo vya mofolojia ya usanifu kama umbo, uchangamano na kipimo/uwiano, uhusiano wa Pearson wa baadhi ya miundo ulizidi 0,35. Hii inaonyesha kuwa mapendeleo ya kimuundo yanaweza kuhamishwa kwa kiwango fulani kati ya majengo ya kulinganisha.
Nini kilitokea katika maeneo yaliyokuwa dhaifu awali?
Mapambo na maelezo:
Relaxed accuracy ya Claude 4.5 iliongezeka hadi %77,2 baada ya CCCS; ongezeko:
\[ +8,7\;\text{yüzde puanı} \]
liliripotiwa.
Qwen 3 ilifikia %80,1 katika kipimo hicho na thamani ya RMSE ilishuka hadi 1,283.
Kuvutia:
Relaxed accuracy iliongezeka hadi takriban %74,7; RMSE:
\[ 1,591\rightarrow1,392 \]
ilipungua.
Je, Ensemble ya Mara Tano Inaleta Tofauti Kweli?
Katika chanzo, kuendesha utabiri uleule wa LLM mara tano kwa kujitegemea na kuchukua wastani kulipunguza utofauti wa makosa; hata hivyo, maboresho hayakuwa mruko mkubwa bali uthabiti mdogo lakini wa mara kwa mara.
| Mfano | Uendeshaji mmoja | N=5 ensemble |
|---|---|---|
| Qwen 3 RMSE | 1,290 | 1,268 |
| GPT-5.1 relaxed accuracy | %79,5 | %80,9 |
| Gemini 3 Flash relaxed accuracy | — | %82,2 |
Chanzo kinaripoti kuwa ongezeko la relaxed accuracy katika miundo mitatu wakilishi lilikuwa takriban 1,3–1,4 pointi ya asilimia.
Matokeo haya yanaonyesha kuwa ensemble ni zaidi mbinu ya kudhibiti utofauti inayopunguza kelele ya sampling katika mwito mmoja wa LLM kuliko mbinu inayobadilisha maudhui ya taarifa.
Je, Mfumo Huu Unaweza Kuchukua Nafasi ya Ushiriki Halisi wa Umma?
Utafiti hauonyeshi mfumo ambao data ya binadamu imeondolewa kabisa. Kinyume chake, ili CCCS ifanye kazi, tathmini za awali za watu halisi kuhusu Bird's Nest na majengo ya kulinganisha zinahitajika. Kwa hiyo mbinu hii ni zaidi ya uigaji unaojaribu kupanua kwa hesabu data halisi ya binadamu iliyo na ukomo kuliko mfumo huru wa “jamii pepe” unaochukua nafasi ya ushiriki wa umma.
Tofauti hii ni muhimu hasa kwa sababu uboreshaji mkubwa zaidi wa modeli unatokana na alama halisi za kulinganisha ambazo watu walitoa hapo awali.
Hitimisho zinazoungwa mkono na utafiti
- Usanifu wa mawakala watatu unaotegemea LLM unaweza kutoa tathmini ya urembo wa mijini yenye vipimo 12 kwa muundo uliopangwa.
- Taarifa za kidemografia na sifa-uzito zinaweza kutumiwa kukadiria kiwango cha jumla cha makubaliano ya urembo.
- Inapotumiwa taarifa ya kidemografia pekee, uhusiano wa tofauti binafsi huwa mdogo.
- Mapendeleo ya kulinganisha ya awali yanapoongezwa kupitia CCCS, uhusiano wa Pearson huongezeka katika miundo yote iliyojaribiwa.
- Baadhi ya LLM zilinufaika zaidi na muktadha wa CCCS kuliko nyingine.
- Wastani wa N=5 ensemble ulipunguza kwa kiwango kidogo lakini thabiti utofauti wa uendeshaji mmoja na vipimo vya makosa.
- Vipimo vyenye utofauti mkubwa binafsi kama maelezo madogo ya kuona na kuvutia ni vigumu zaidi kutabiri kwa kutumia demografia ya jumla.
Hitimisho ambazo utafiti hauungi mkono
- Matokeo ya %82,07 si asilimia ya alama za urembo zilizo sahihi moja-kwa-moja; ni relaxed accuracy yenye uvumilivu wa ±1 wa Likert.
- Mfumo hauthibitishi kuwa unawakilisha mapendeleo ya urembo ya wakazi wote wa jiji.
- Sampuli ambayo %91,2 ina historia ya sanaa/usanifu haiwezi kuchukuliwa kuwa mgawanyo wa kawaida wa watu kwa ujumla.
- Matokeo ya Bird's Nest hayawezi kujumlishwa moja kwa moja kwa mitaa ya vitongoji, fasadi za makazi, bustani au maeneo madogo ya kawaida ya mijini.
- Haijaonyeshwa kuwa modeli inatabiri muundo uleule wa mapendeleo ya urembo katika tamaduni au nchi tofauti.
- PDF hairipoti seti ya majaribio ya watumiaji wa nje iliyotenganishwa wazi au uthibitishaji nje ya eneo la utafiti.
- Ongezeko la uhusiano wa Pearson ni muhimu, lakini kiwango cha 0,317 hakimaanishi kuwa sehemu kubwa ya mapendeleo binafsi ya urembo imeelezwa.
- Haijathibitishwa kuwa hoja inayotolewa na LLM ni sawa na mchakato halisi wa kiutambuzi katika akili ya binadamu.
- Kwa kuwa uzito wa ndani wa modeli na utaratibu halisi wa maamuzi umefungwa, maelezo ya agent si tafsiri kamili ya kimekanika.
Umuhimu wa kisayansi
Sehemu yenye thamani zaidi ya utafiti ni kwamba haulizi “je, AI hufanya uamuzi wa urembo bora kuliko binadamu?”; badala yake unajaribu kutenganisha miundo miwili tofauti katika tathmini ya urembo ya binadamu:
makubaliano ya kijamii ya urembo na utofauti binafsi wa urembo.
Mfumo unaotegemea demografia hunasa muundo wa kwanza kwa kiwango fulani, huku historia za kulinganisha za mtu zikitoa taarifa za ziada kwa muundo wa pili.
Hii inaonyesha jambo muhimu la kimetodolojia katika tathmini ya mazingira yaliyojengwa: mapendeleo ya urembo ya mtu hayaamuliwi tu na yeye ni nani, bali pia na ni maeneo gani aliyopenda hapo awali na jinsi alivyoitikia sifa mbalimbali.
Wazo kuu la CCCS ni kubadilisha uzoefu huu wa zamani kuwa mfumo wa marejeo wa kimuktadha ambao mashine inaweza kutumia.
Hata hivyo, katika hatua hii mbinu si mfumo wa maamuzi uliothibitishwa unaochukua nafasi ya ushiriki halisi wa umma. Utafiti ni mfumo wa majaribio wa tathmini ya kihesabu uliofanywa kwenye jengo moja la alama, sampuli maalumu na matoleo maalumu ya LLM.
Maelezo ya Chanzo na Mbinu
Utafiti asili: Simulating Aesthetic Consensus and Divergence in Urban Landmarks: An LLM-based Multi-Agent System for Built Environment Evaluation
Waandishi: Yuxuan Li, Ting Zhang, Weimin Zhuang
Mwandishi wa mawasiliano: Weimin Zhuang
Taasisi: School of Architecture, Tsinghua University; School of Computer Science, Peking University, Beijing, China.
Aina ya chanzo: Makala ya utafiti ya preprint ambayo haijapitiwa na wahakiki.
Jukwaa: SSRN.
SSRN Abstract ID: 6907642.
DOI: 10.2139/ssrn.6907642.
Tarehe ya kuwasilishwa SSRN: 9 Juni 2026.
Uchunguzi wa kisa: Beijing National Stadium — Bird's Nest.
Utafiti: washiriki halali 1.201; ukusanyaji wa data Februari 2026.
Kesi za kulinganisha: Chengdu Fenghuangshan Sports Park Football Stadium, Shanghai Pudong Football Stadium, Xi'an Olympic Sports Center Stadium na Quzhou Stadium.
Usanifu msingi: Visual Perception Agent + Behavioral Fitting Agent + Fusion & Reasoning Agent.
Utaratibu wa ubinafsishaji: Comparative Case-based Cognitive Schema (CCCS).
Peer Neighborhood: K=20.
Temperature ya LLM inference: 0,7.
Ensemble: N=5 inference huru kwa kila tathmini ya mtumiaji–jengo.
Kigezo kikuu cha utendaji: Relaxed Accuracy, |Pred−True|≤1.
Relaxed accuracy ya juu zaidi ya mfumo msingi: GPT-5.1 — %80,43.
Matokeo ya jumla ya juu zaidi yaliyoripotiwa katika mfumo wa CCCS: Gemini 3 Flash — %82,07 relaxed accuracy, MAE 0,887.
Ufadhili: Beijing Natural Science Foundation, QY24288.
Mgongano wa maslahi: Waandishi hawajaripoti maslahi ya kifedha yanayojulikana au uhusiano wa kibinafsi.
Michango ya waandishi: Yuxuan Li — uundaji wa dhana, usimamizi wa data, uchambuzi rasmi, uchunguzi, mbinu, programu, uthibitishaji, uonyeshaji na uandishi; Ting Zhang — mbinu na programu; Weimin Zhuang — uundaji wa dhana, mbinu, usimamizi wa mradi, rasilimali, usimamizi, uthibitishaji na mapitio ya maandishi.
Taarifa ya AI generative: Waandishi wanaripoti kwamba walitumia ChatGPT na Gemini wakati wa kuandaa makala ili kuboresha usomaji na uhariri wa lugha; baadaye walipitia matokeo wenyewe na kuchukua wajibu wa maudhui.
Vikwazo vikuu vya ndani ya chanzo: Upotevu wa taarifa ndogo za kuona wakati wa kubadilisha picha kuwa maandishi; muktadha wa jengo moja la monumental; upendeleo wa kitamaduni/kijiografia wa LLM; asili ya sanduku-jeusi ya utaratibu wa ndani wa kufanya maamuzi.
Onyo la kimetodolojia la Verianla: Kwa kuwa %91,2 ya sampuli iliripoti historia ya sanaa/usanifu na PDF haibainishi wazi itifaki huru ya majaribio ya watumiaji wa nje, matokeo hayapaswi kufasiriwa kama uthibitishaji wa nje kwa watu kwa ujumla.
Maelezo ya matumizi ya taswira: Picha za Bird's Nest na viwanja vingine katika chanzo, michoro ya usanifu wa mawakala wengi na miundo asili ya grafu za radar/heatmap/scatter hazipaswi kutumiwa tena moja kwa moja. Taswira mpya kabisa za Verianla zinaweza kutayarishwa kwa kutumia mahusiano ya mbinu na thamani za nambari zilizoripotiwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *