

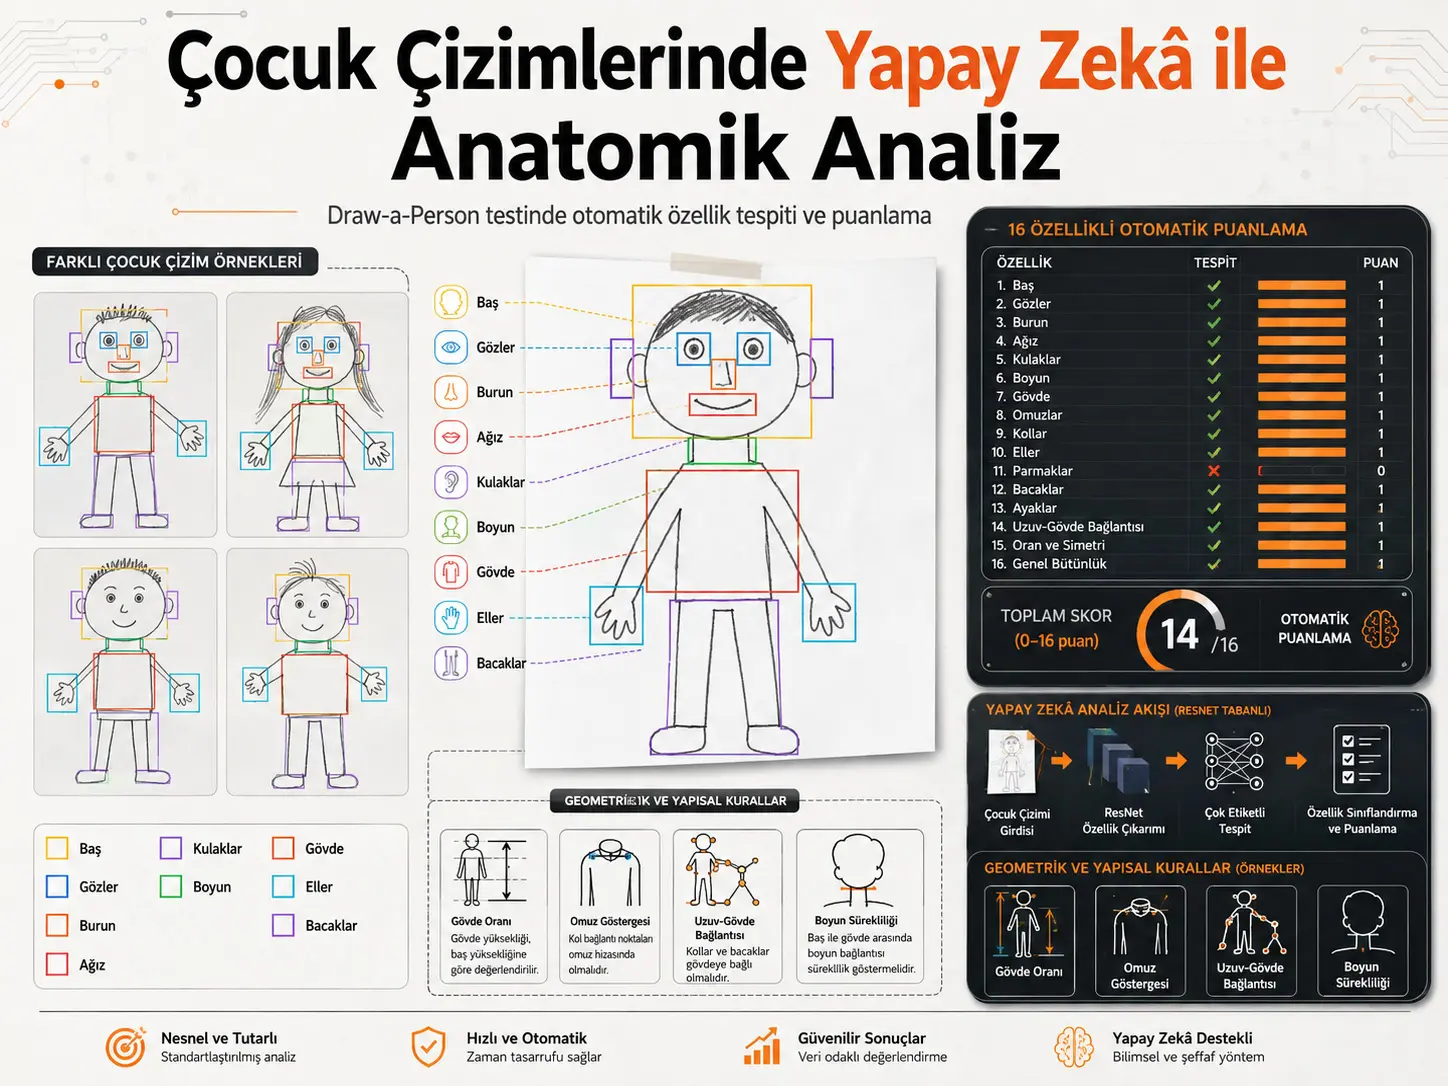
Utafiti huu unapendekeza mfumo mseto unaochanganya ujifunzaji wa kina na kanuni wazi za kijiometri ili kuchanganua kiotomatiki michoro ya umbo la binadamu inayotengenezwa na watoto katika jaribio la Draw-a-Person (DAP; Chora Mtu). Katika usanifu mkuu, modeli ya ResNet-50 iliyofunzwa awali kwenye ImageNet hutabiri vipengele 10 vya kuona vya kianatomia katika michoro: kichwa, macho, nywele, mikono, miguu, mdomo, pua, masikio, shingo na kiwiliwili. Vipengele sita vya kijiometri/heuristic vinavyotathmini uwiano wa kiwiliwili, kiashirio cha mabega, uwakilishi wa viungo pande mbili, muunganisho wa kiungo–kiwiliwili, eneo sahihi la muunganisho na mwendelezo wa shingo huongezwa, na hivyo kutengeneza jumla ya vipengele 16 vya binary.
Jumla ya michoro 948 ya mkono ilitumika katika utafiti. Kulingana na maelezo ya kina ya mgawanyo wa data, picha 663 zilitengwa kwa mafunzo, picha 142 kwa validation na picha 143 kwa jaribio huru. Accuracy iliyoripotiwa katika five-fold cross-validation ilitofautiana kati ya %90,05 na %91,64, ikiwa na wastani wa %91,01. Hata hivyo, utendaji ulitofautiana sana kutoka kipengele kimoja hadi kingine: kwa vipengele vinavyoonekana wazi kama kichwa, macho, mikono, miguu, mdomo na kiwiliwili, thamani za F1 zilifikia takriban 0,98–1,00, ilhali maelezo madogo zaidi au yanayochorwa kwa namna tofauti kama masikio na shingo yalikuwa magumu zaidi.
Katika test set huru ya michoro 143, correlation kati ya mfumo wa kiotomatiki na jumla ya alama za DAP zilizotolewa na binadamu iliripotiwa kuwa r=0,93 (p<0,001), na katika takriban %87 ya michoro tofauti kati ya alama ya kiotomatiki na alama ya rejea ilibaki ndani ya ±1 pointi. Hata hivyo, matokeo haya hayamaanishi kwamba mfumo unaweza kufanya utambuzi wa kisaikolojia au kuchukua nafasi ya tathmini ya mtaalamu. Utafiti ulitathmini tu utambuzi wa kiotomatiki wa vipengele 16 maalumu vya mchoro na kuunda alama rahisi ya jumla kutoka navyo. Aidha, baadhi ya kutokulingana ndani ya chanzo kuhusu mgawanyo wa data, ukubwa wa output na jedwali za utendaji kunahitaji matokeo yatafsiriwe kwa tahadhari.
| Kipengele kikuu | Muundo ulioripotiwa katika utafiti wa chanzo | Kikomo cha tafsiri |
|---|---|---|
| Dataset yote | Michoro 948 ya watoto | Namba 948 si test set huru; katika mbinu ya kina ni dataset yote. |
| Mgawanyo wa kina wa data | 663 mafunzo + 142 validation + 143 test | Hailingani na kauli ya “5-fold kwa picha 948” katika sehemu nyingine ya makala. |
| Kipengele cha msingi wa CNN | 10 | Kulingana na maelezo ya usanifu mkuu, hivi ni outputs za ResNet. |
| Kipengele cha kijiometri/heuristic | 6 | Hutengenezwa kwa kanuni kutoka jiometri ya bounding-box. |
| Jumla ya vipengele | 16 | Alama kati ya 0–16 hutengenezwa kwa jumla rahisi. |
| Wastani wa accuracy wa five-fold CV | %91,01 | Kwa sababu data ni multi-label na imbalanced, accuracy peke yake si kipimo cha kutosha cha utendaji. |
| Wastani wa F1 wa mfumo wa mwisho Jedwali 8 | 0,8996 | Utendaji hutofautiana sana kati ya vipengele. |
| Correlation ya alama otomatiki–rejea | r=0,93; p<0,001 | Correlation si clinical equivalence wala usahihi wa utambuzi wa kisaikolojia. |
Utafiti unajaribu kutatua tatizo gani?
Jaribio la Draw-a-Person hutegemea kupewa alama kwa vipengele maalumu vya kimuundo na kianatomia kutoka katika mchoro wa umbo la binadamu. Hoja ya kuanzia ya utafiti wa chanzo ni kwamba kukagua vipengele hivi kwa mkono huchukua muda na tofauti za tafsiri zinaweza kujitokeza kati ya tathmini.
Badala ya kuliacha tatizo lote kwa modeli ya AI ya “black box”, watafiti waliunganisha mbinu mbili tofauti. Miundo ya kianatomia inayopaswa kuonekana moja kwa moja kwenye picha hutathminiwa na CNN inayotegemea ResNet-50, huku mahusiano ya nafasi na kijiometri kati ya sehemu yakihesabiwa kwa kanuni wazi.
Kwa hiyo mfumo haujaribu kujibu tu swali “je, kuna mguu katika mchoro huu?”, bali pia maswali yaliyopangwa zaidi, kwa mfano kama viungo vimeunganishwa na kiwiliwili au kama urefu wa kiwiliwili ni mkubwa kuliko upana wake.
Vipengele 10 vya CNN ni vipi?
Sehemu ya kuona inayotegemea ResNet hutabiri kama vipengele kumi vifuatavyo vya kianatomia vipo au havipo katika mchoro:
- masikio,
- macho,
- nywele,
- mikono,
- kichwa,
- miguu,
- mdomo,
- shingo,
- pua,
- kiwiliwili.
Kila kipengele kinaweza kupewa lebo ya ipo/haipo bila kutegemea vingine. Kwa hiyo tatizo si classical single-class image classification, bali ni tatizo la multi-label classification.
Kanuni sita za kijiometri zinatathmini nini?
Vipengele sita vinavyoongezwa kando ya CNN huhesabiwa kutokana na coordinates za sehemu zilizochorwa na mahusiano ya bounding-box:
| Kipengele cha kijiometri | Kanuni kuu iliyotumiwa katika chanzo |
|---|---|
| Urefu wa kiwiliwili kuwa mkubwa kuliko upana | Ni positive ikiwa urefu wa bounding-box ya kiwiliwili ni mkubwa kuliko upana wake. |
| Mabega kuonyeshwa | Ni positive ikiwa upana wa kiwiliwili ni zaidi ya mara 1,2 ya upana wa shingo. |
| Uwakilishi wa viungo pande mbili | Nafasi za bounding-box za mkono/mguu pande mbili za mstari wa kati wa kiwiliwili hutathminiwa. |
| Muunganisho wa kiungo–kiwiliwili | Overlap kati ya bounding box za kiungo na kiwiliwili hukaguliwa kulingana na threshold ya IoU. |
| Maeneo sahihi ya kuunganisha viungo | Kuunganishwa kwa mikono katika sehemu ya juu na miguu katika sehemu ya chini ya kiwiliwili hutathminiwa kwa thresholds za nafasi. |
| Mwendelezo wa contour ya shingo | Sharti la ±2 pixels hutumiwa kati ya ukingo wa chini wa box ya shingo na ukingo wa juu wa kiwiliwili. |
Utafiti wa chanzo unasema thresholds za kijiometri zilirekebishwa kwa grid search kwenye validation data. Threshold ya IoU iliyochaguliwa kwa muunganisho wa kiungo–kiwiliwili ni 0,01; uwiano wa eneo la muunganisho wa juu ni 0,3 na uwiano wa eneo la chini ni 0,5.
Verianla Live: Jinsi mchoro mmoja unavyogeuka kuwa alama ya DAP ya kiotomatiki
Mtiririko huu unafupisha usanifu mseto ulioelezwa katika Kielelezo 1 cha utafiti wa chanzo.
| Hatua | Mchakato katika utafiti wa chanzo |
|---|---|
| 1. Input | Mchoro wa umbo la binadamu wa DAP uliotengenezwa na mtoto huingizwa kwenye mfumo. |
| 2. Image preprocessing | Picha hubadilishwa kuwa RGB na kupimwa upya hadi 224 × 224 pixels. |
| 3. ResNet-50 feature extraction | Backbone iliyofunzwa awali kwenye ImageNet na kufungwa hutengeneza visual feature vector yenye ukubwa wa 2048. |
| 4. CNN anatomical prediction | Predictions 10 hutengenezwa kwa kichwa, macho, nywele, mikono, miguu, mdomo, pua, masikio, shingo na kiwiliwili. |
| 5. Thresholding | Sigmoid probabilities hubadilishwa kuwa binary ipo/haipo outputs kwa thresholds zilizochaguliwa. |
| 6. Geometric analysis | Vipengele sita vya structural/heuristic huhesabiwa kutoka mahusiano ya bounding-box. |
| 7. Combining | Vipengele 10 vya CNN na vipengele 6 vya kijiometri huunganishwa katika feature vector ya vipengele 16. |
| 8. Scoring | Vipengele positive vya binary hujumlishwa ili kutengeneza alama ya DAP ya kiotomatiki kati ya 0–16. |
Mtiririko unaeleza usanifu wa utafiti; haumaanishi kwamba alama 16 peke yake zinatosha kwa utambuzi wa kisaikolojia au uamuzi wa kliniki.
“Umri” katika dataset unamaanisha nini?
Katika dataset, michoro 948 imegawanywa katika makundi manane na makundi hayo yamepewa lebo kutoka 4 hadi 11. Hata hivyo, utafiti wa chanzo unaeleza wazi kwamba haya ni mental-age groups yaliyowekwa kwa tathmini ya kitaalamu bila kutegemea umri halisi wa wanafunzi.
Tofauti hii ni muhimu hasa wakati wa kutafsiri grafu za F1 kulingana na umri ndani ya utafiti. Kwa mfano, kuongezeka kwa F1 ya utambuzi wa mdomo kutoka 0,30 katika kundi 4 hadi 0,95 katika kundi 11 si matokeo ya longitudinal developmental study inayofuatilia watoto wale wale wanapokua. Hizi ni performance za modeli kwenye makundi ya michoro yaliyowekwa mapema katika mental-age categories tofauti.
Ni vipengele gani vilikuwa rahisi na vipi vigumu?
Katika five-fold cross-validation, F1 scores za juu zilipatikana kwa vipengele vinavyoonekana wazi kama kichwa, mkono, mguu, macho, mdomo na kiwiliwili. Katika Jedwali 5 la chanzo, wastani wa F1 kwa macho, mkono, kichwa, mguu na kiwiliwili uliripotiwa kuwa takriban 0,99; mdomo 0,98.
Kinyume chake, wastani wa F1 kwa pua ni 0,84, kwa nywele 0,87 na kwa shingo 0,75. Kushindwa kwa wazi zaidi ni masikio: Jedwali 5 la chanzo linatoa wastani wa F1 wa masikio wa 0,09 ± 0,06 tu.
Tathmini ya kuona ya utafiti pia inahusisha hili na ukweli kwamba maelezo madogo au yaliyochorwa kwa mtindo hutofautiana sana kutoka mchoro mmoja hadi mwingine. Watoto wengine hawachori masikio kabisa, huku wengine wakiyawakilisha kwa maumbo madogo sana au yasiyo wazi.
Kwa nini accuracy ya jumla iliyo juu haitoshi peke yake?
Utafiti unahusu tatizo la multi-label lenye class imbalance kubwa. Waandishi wa chanzo pia wanaeleza kwamba kwa sababu hii precision, recall na F1 zinaweza kuwa informative zaidi kuliko accuracy.
Jambo hili linaonekana wazi hasa katika independent test. Katika Jedwali 10, idadi ya true negative (TN) ni sifuri kwa vipengele vyote kumi vya kuona vilivyotathminiwa na CNN. Kwa mfano, kwa masikio TP=57, FP=86, TN=0 na FN=0 zimeripotiwa. Katika mgawanyo huu, modeli imesema “masikio yapo” kwa michoro yote 143 ya test. Recall kwa hivyo ni 1,00, lakini precision ni 57/143 ≈ 0,399 tu na F1 ni takriban 0,57.
Vivyo hivyo, kwa kichwa, kwa kuwa michoro yote 143 ni positive, TP=143, FP=TN=FN=0. Katika test subgroup kama hii, haiwezi kupimwa kama modeli inaweza kukataa kwa usahihi mchoro ambao kichwa hakipo. Kwa hiyo baadhi ya thamani za 0,99–1,00 hazipaswi kutafsiriwa kama “modeli ni karibu perfect katika hali zote”.
Ilikubaliana kwa kiasi gani na alama za wataalamu?
Katika test set ya michoro 143, Pearson correlation kati ya jumla ya alama ya DAP ya kiotomatiki na ground-truth score iliyotolewa na binadamu iliripotiwa kuwa r=0,93 na p<0,001. Katika Kielelezo 8 cha chanzo, sehemu kubwa ya points zimekusanyika karibu na mstari bora wa \(y=x\).
Kulingana na distribution ya error katika Kielelezo 9, katika takriban %87 ya michoro tofauti kati ya alama ya kiotomatiki na alama ya rejea iko ndani ya ±1 pointi. Tofauti kubwa kuliko pointi mbili zimeripotiwa kuwa nadra.
Matokeo haya yanaunga mkono kuwepo kwa uhusiano mkubwa kati ya alama ya kiotomatiki na alama ya rejea. Hata hivyo, correlation si test kamili ya agreement kati ya methods na peke yake haithibitishi kwamba mfumo unaweza kubadilishana nafasi na mtaalamu katika tathmini ya kisaikolojia.
Matokeo yanayoungwa mkono na utafiti
- ResNet-based visual analysis na geometric rules zinaweza kuunganishwa katika automatic DAP workflow moja.
- Miundo ya kianatomia iliyo wazi ilitambuliwa kwa uaminifu zaidi kuliko maelezo madogo.
- Masikio na shingo ni miongoni mwa vipengele vigumu zaidi vya CNN katika utafiti.
- Correlation kubwa imeripotiwa kati ya automatic 0–16 score na human reference score katika utafiti wa chanzo.
- Kuhesabu geometric relationships kwa explicit rules hufanya baadhi ya maamuzi ya mfumo yafuatilike zaidi.
- Independent test performance si sawa kwa vipengele vyote.
Matokeo ambayo utafiti haujathibitisha
- Haijathibitishwa kwamba mfumo unaweza kutambua akili, hali ya kisaikolojia au hali ya psychiatric ya mtoto peke yake.
- Haijaonyeshwa kwamba automatic score inaweza kuchukua nafasi ya expert psychologist assessment kwa usalama.
- Haijathibitishwa kwamba modeli itatoa performance ileile kwa watoto kutoka tamaduni tofauti.
- Makundi ya data yenye lebo 4–11 si chronological age cohorts; kwa hiyo matokeo si direct age-related developmental curve.
- Haijaonyeshwa kwamba simple 0–16 total score inawakilisha kikamilifu weighting na clinical interpretation logic yote ya original Goodenough–Harris system.
- High correlation haimaanishi clinical equivalence au diagnostic validity.
Mbinu na Matokeo ya Utafiti
Maandalizi ya data
Dataset ya chanzo ina michoro 948 ya mkono. Maeneo kumi makuu ya kianatomia yaliwekewa bounding box labels kwa mkono kwa kutumia DigitalSreeni image annotation tool, na annotations zikahifadhiwa katika muundo wa mtindo wa COCO.
Picha zilibadilishwa kuwa RGB format na kurekebishwa kuwa 224 × 224 pixels ili zilingane na input ya ResNet-50. Wakati wa training, data augmentation ilitumika kwa horizontal flip yenye probability ya %50 na kubadilisha brightness/contrast kwa ±%20.
Mgawanyo uliotumiwa katika sehemu ya kina ya maandalizi ya data ni huu:
| Sehemu ya data | Idadi ya michoro | Uwiano katika data yote | Matumizi |
|---|---|---|---|
| Mafunzo | 663 | %70 | Kujifunza parameters za modeli |
| Validation | 142 | %15 | Threshold na method settings |
| Test | 143 | %15 | Final, unseen evaluation |
| Jumla | 948 | %100 | Dataset yote |
Mgawanyo huu hailingani na kauli ya “separate hold-out test set ya michoro 948” katika abstract ya makala. Kwa kuwa detailed methods na test tables zinaunga mkono independent test set ya michoro 143, hapa 948 imewasilishwa kama dataset yote na 143 kama hold-out test size.
Usanifu wa ResNet-50
Kulingana na maelezo ya msingi ya usanifu, ResNet-50 backbone iliyofunzwa awali kwenye ImageNet ilitumika kama fixed feature extractor na convolution layers ziligandishwa. Kwa mchoro wa RGB wa 224 × 224:
\[ x \in \mathbb{R}^{3\times224\times224} \]
Backbone hutengeneza feature vector ya vipimo 2048 katika global average pooling output:
\[ f_{\mathrm{ResNet}}(x)\in\mathbb{R}^{2048} \]
Katika maelezo ya basic architecture, linear layer mpya humapishwa kwenye vipengele 10 vya kuona vya kianatomia:
\[ z_{\mathrm{CNN}}=Wf_{\mathrm{ResNet}}(x)+b \]
\[ W\in\mathbb{R}^{10\times2048},\qquad b\in\mathbb{R}^{10} \]
Kila logit hubadilishwa kuwa probability kwa sigmoid:
\[ \hat{y}_i=\sigma(z_i)=\frac{1}{1+e^{-z_i}} \]
Kisha outputs 10 za CNN huunganishwa na vipengele sita vya geometric/heuristic:
\[ y_{\mathrm{final}}=[y_{\mathrm{CNN}},y_{\mathrm{heuristic}}]\in\mathbb{R}^{16} \]
Hata hivyo, katika Sehemu 4.2 ya utafiti wa chanzo imeandikwa kwamba classification layer humap feature vector ya vipimo 2048 moja kwa moja kwenye target features 16. Kauli hii hailingani na architecture ya “10 CNN + 6 heuristic” katika Kielelezo 1 na Sehemu 4.1 na 4.3. Kwa hiyo, katika maandishi ya Verianla muundo wa 10+6 unaorudiwa kwenye kielelezo na sehemu nyingi umetumika kama basic architecture, na kauli inayokinzana ya 16-CNN imerekodiwa kama source-internal inconsistency.
Loss function na class imbalance
Kwa multi-label classification, BCEWithLogitsLoss ilitumika, na pos_weight ikaongezwa ili rare positive features ziwe na uzito mkubwa zaidi wakati wa training.
Katika chanzo, feature weight inaelezwa kwa uwiano huu:
\[ w_i=\frac{negatives_i}{positives_i} \]
Kwa hiyo, katika vipengele vinavyotokea mara chache, misclassification ya positive example ina training cost kubwa zaidi.
Hata hivyo, katika sehemu ya loss function imeandikwa kwamba output ya \(N=16\) imejumuishwa moja kwa moja katika CNN loss. Hili pia halilingani kikamilifu na main architecture inayosema vipengele sita vya heuristic huhesabiwa nje ya CNN.
Mipangilio ya mafunzo
| Parameter ya mafunzo | Thamani iliyoripotiwa katika chanzo |
|---|---|
| Backbone | ResNet-50 iliyofunzwa awali kwenye ImageNet |
| Backbone training | Convolution layers zimegandishwa |
| Optimizer | Adam |
| Learning rate | 1 × 10⁻⁴ |
| Epoch | 10 |
| Gradient clipping | Maximum norm 1,0 |
| Loss | Weighted BCEWithLogitsLoss |
| Image size | 224 × 224 pixels |
Matokeo ya cross-validation
Katika Sehemu 4.6 ya makala, baada ya test set ya picha 143 kutengwa, picha 805 zilizobaki zinasemekana kutumika katika five-fold cross-validation. Katika kila iteration takriban picha 644 zilitumika kwa training na picha 161 kwa validation.
| Fold | Accuracy (%) |
|---|---|
| Fold 1 | 91,64 |
| Fold 2 | 91,12 |
| Fold 3 | 91,28 |
| Fold 4 | 90,94 |
| Fold 5 | 90,05 |
| Wastani | 91,01 |
Kinyume chake, katika Sehemu 4.7 imeandikwa kwamba “complete dataset” ya michoro 948 iligawanywa katika five folds. Kauli hii inapingana na protocol ya awali inayosema picha 143 ziliwekwa kando kabisa. Chanzo hakipatani maelezo haya mawili.
F1 kwa kipengele katika five-fold cross-validation
| Kipengele | Wastani F1 | SEM |
|---|---|---|
| Sikio | 0,09 | 0,06 |
| Jicho | 0,99 | 0,00 |
| Nywele | 0,87 | 0,01 |
| Mkono | 0,99 | 0,00 |
| Kichwa | 0,99 | 0,00 |
| Mguu | 0,99 | 0,00 |
| Mdomo | 0,98 | 0,01 |
| Shingo | 0,75 | 0,04 |
| Pua | 0,84 | 0,01 |
| Kiwiliwili | 0,99 | 0,00 |
| Urefu wa kiwiliwili > upana | 1,00 | 0,00 |
| Mabega yameonyeshwa | 1,00 | 0,00 |
| Viungo ni vya pande mbili | 1,00 | 0,00 |
| Viungo vimeunganishwa na kiwiliwili | 1,00 | 0,00 |
| Sehemu sahihi za kuunganisha viungo | 1,00 | 0,00 |
| Contour ya shingo inaendelea na kichwa/kiwiliwili | 1,00 | 0,00 |
Ni jambo la kuzingatia kwamba vipengele vyote sita vya heuristic vinapata F1=1,00 katika cross-validation. Sehemu ya methods inaeleza kwamba labels za cross-validation zilitengenezwa kwa heuristic rules hizo hizo. Kwa hiyo, kutathmini rule dhidi ya label iliyotengenezwa na rule yenyewe si independent validation. Kwa kweli, katika hold-out set ya michoro 143, vipengele hivi sita vilipowekewa labels na independent experienced raters, baadhi ya heuristic performances zilishuka kwa kiasi kikubwa.
Final feature performance katika independent test ya michoro 143
Verianla Live: F1 kwa kipengele katika hold-out test
Thamani zimechukuliwa kutoka automatic detection and scoring evaluation ya michoro 143 katika Jedwali 8 la chanzo. Kwa sababu class prevalences zinatofautiana, clinical importance ya vipengele haipaswi kulinganishwa kwa kuangalia F1 pekee.
| Kipengele | F1 score |
|---|---|
| Sikio | 0,5700 |
| Jicho | 0,9965 |
| Nywele | 0,8651 |
| Mkono | 0,9858 |
| Kichwa | 1,0000 |
| Mguu | 0,9930 |
| Mdomo | 0,9894 |
| Shingo | 0,7881 |
| Pua | 0,8514 |
| Kiwiliwili | 0,9858 |
| Urefu wa kiwiliwili > upana | 1,0000 |
| Mabega yameonyeshwa | 0,9765 |
| Viungo ni vya pande mbili | 1,0000 |
| Viungo vimeunganishwa na kiwiliwili | 0,4762 |
| Sehemu sahihi za kuunganisha viungo | 0,9163 |
| Contour ya shingo inaendelea na kichwa/kiwiliwili | 1,0000 |
Katika jedwali hili, wastani wa accuracy 0,8780, precision 0,8929, recall 0,9458 na F1 0,8996 umeripotiwa. Hasa, kushuka kwa F1 ya heuristic feature “viungo vimeunganishwa na kiwiliwili” hadi 0,4762 kunaonyesha kwamba thamani ya 1,00 katika cross-validation haikudumu dhidi ya independent reference label.
Kwa nini jedwali mbili za performance ndani ya chanzo zinahitaji kusomwa kwa uangalifu?
Jedwali 7 la chanzo linatoa wastani wa accuracy=0,9175, precision=0,8869, recall=0,9375 na F1=0,905 kwa vipengele 16. Jedwali 8 linalofuata la automatic detection/scoring linatoa accuracy=0,8780, precision=0,8929, recall=0,9458 na F1=0,8996.
| Matokeo ya chanzo | Accuracy | Precision | Recall | F1 |
|---|---|---|---|---|
| Jedwali 7 | 0,9175 | 0,8869 | 0,9375 | 0,9050 |
| Jedwali 8 | 0,8780 | 0,8929 | 0,9458 | 0,8996 |
Maandishi ya makala hayatai hatua hizi mbili za evaluation kwa namna inayolingana kikamilifu. Aidha, katika maelezo ya baadaye ya Jedwali 9 inaonekana table numbers zimesogea kwa nafasi moja. Kwa hiyo kutoa namba moja isiyo na context kama “accuracy ya mfumo ni %91,78” kungekuwa misleading kisayansi.
Mabadiliko makubwa katika matokeo ya sikio
Katika Jedwali 7 la chanzo, ear detection imepewa accuracy=0,63, precision=0,14, recall=0,01 na F1=0,07. Katika Jedwali 8, kwa sikio accuracy na precision ni 0,3986, recall 1,0000 na F1=0,5700.
Jedwali 9 linaeleza mabadiliko haya kama improvement baada ya “heuristic refinement”. Hata hivyo, kati ya vipengele sita vya heuristic vilivyoainishwa na utafiti hakuna rule inayorekebisha ear detection; heuristics zinahusu torso ratio, shoulder, bilateral limb, limb connection, connection region na neck continuity. Kwa hiyo sababu ya kiufundi ya mabadiliko ya ear F1 kutoka 0,07 → 0,57 haiwezi kubainishwa kwa kuaminika kutoka katika maandishi ya chanzo.
Confusion matrix inaonyesha nini?
Katika test ya michoro 143, confusion matrix ya vipengele kumi vya kuona pia inatoa tahadhari muhimu:
| Kipengele cha kuona | TP | FP | TN | FN |
|---|---|---|---|---|
| Sikio | 57 | 86 | 0 | 0 |
| Jicho | 142 | 1 | 0 | 0 |
| Nywele | 109 | 34 | 0 | 0 |
| Mkono | 139 | 4 | 0 | 0 |
| Kichwa | 143 | 0 | 0 | 0 |
| Mguu | 141 | 2 | 0 | 0 |
| Mdomo | 140 | 3 | 0 | 0 |
| Shingo | 93 | 50 | 0 | 0 |
| Pua | 106 | 37 | 0 | 0 |
| Kiwiliwili | 139 | 4 | 0 | 0 |
Namba hizi zinaonyesha kwamba kwa vipengele vyote kumi vya kuona FN=0 na TN=0. Kwa hiyo uwezo wa modeli kutambua kwa usahihi kwamba visual feature “haipo” haujapimwa katika test table hii. Baadhi ya high recall na F1 scores zinaathiriwa na prevalence na prediction structure hii.
Alama ya kiotomatiki inahesabiwaje?
Katika formula ya chanzo, vipengele 16 vya binary hujumlishwa moja kwa moja:
\[ S=\sum_{i=1}^{16}f_i \]
Hapa \(f_i=1\) inaonyesha kipengele kipo, na \(f_i=0\) inaonyesha hakipo. Kwa hiyo jumla ya alama hutofautiana kati ya 0 na 16.
Katika sehemu ya baadaye ya matokeo ya chanzo, sehemu moja inasema outputs 16 za binary zinachukuliwa kwa “averaging”; aya hiyo hiyo mara moja baada yake inasema score ya 0–16 inatengenezwa. Kwa kuwa scale ya 0–16 na equation iliyotolewa zinaunga mkono summation, maandishi ya Verianla yametumia jumla iliyo kwenye formula.
Mapungufu makuu ya kimetodolojia ya utafiti
- Dataset yote ina michoro 948 tu na hakuna independent cross-cultural validation iliyofanywa.
- “Mental age” groups zilizotumika katika chanzo si chronological age.
- Kuna strong class imbalance katika small anatomical features.
- Katika hold-out confusion matrix, TN=0 kwa vipengele vyote kumi vya CNN.
- Kwa vipengele sita vya heuristic, cross-validation labels zilitengenezwa kutoka kwenye rules, kwa hiyo perfect CV scores si independent validation.
- Heuristic thresholds zilirekebishwa empirically kulingana na dataset hii na huenda zisitoe accuracy ileile katika drawing styles nyingine.
- Vipengele 16 vinapata weight sawa katika total score; waandishi wa chanzo wanakubali kwamba hii huenda isiwakilishe kikamilifu real DAP scoring system.
- Kuna source-internal inconsistency kuhusu kama cross-validation ilifanywa kwenye michoro 805 au 948.
- Kuna inconsistency katika methods text kuhusu kama ResNet classification layer inatoa outputs 10 au 16.
- Chanzo kinasema threshold tuning ilifanywa kwa validation data, lakini baadaye kinasema cross-validation haikutumika kwa hyperparameter tuning.
- Performance stages na table references kati ya Jedwali 7, Jedwali 8 na Jedwali 9 hazilingani kikamilifu.
- Psychological au clinical diagnostic validity ya automatic score haijajaribiwa independently katika utafiti huu.
Maelezo ya Chanzo na Mbinu
| Kichwa kamili cha asili cha utafiti | Automated Anatomical Feature Analysis and Scoring for Draw-a-Person Test Drawings via ResNet-Based Multi-Label Detection and Classification |
|---|---|
| Waandishi | Asma Abdullah Alwadai; Emad Sami Jaha |
| Mpangilio wa waandishi | 1. Asma Abdullah Alwadai; 2. Emad Sami Jaha |
| Mchango sawa / mwandishi wa kwanza sawa | Hakuna taarifa ya equal contribution iliyotajwa katika utafiti wa chanzo. |
| Mwandishi anayewajibika | Asma Abdullah Alwadai |
| Taasisi | Department of Computer Science, Faculty of Computing and Information Technology, King Abdulaziz University, Jeddah 21589, Saudi Arabia |
| Aina ya chanzo | Makala ya utafiti wa experimental AI / computer vision. |
| Hali ya peer review | Ni makala iliyochapishwa katika peer-reviewed journal; si preprint. |
| Jarida | AI |
| Mchapishaji | MDPI |
| Volume / issue / article | 2026, 7(4), 130 |
| DOI | 10.3390/ai7040130 |
| Tarehe ya kupokelewa | 4 Machi 2026 |
| Tarehe ya marekebisho | 26 Machi 2026 |
| Tarehe ya kukubaliwa | 28 Machi 2026 |
| Tarehe ya kuchapishwa | 2 Aprili 2026 |
| Kiungo rasmi | https://doi.org/10.3390/ai7040130 |
| Leseni | Creative Commons Attribution (CC BY). |
Ufadhili na msaada wa taasisi
Katika funding statement ya makala imeelezwa kwamba utafiti haukupokea external funding. Katika acknowledgements, hata hivyo, imeandikwa kwamba mradi uliungwa mkono na KAU Endowment (WAQF) ndani ya King Abdulaziz University, na shukrani zimetolewa kwa WAQF na Deanship of Scientific Research kwa technical na financial support. Taarifa hizi mbili zikichunguzwa pamoja, kazi haitangazi “external funding” lakini inataja internal institutional support.
Maadili na chanzo cha data
Imeelezwa kwamba ethics committee review haikuhitajika kwa sababu utafiti ulitumia public na fully anonymized dataset na haukuhusisha new participant/data collection. Kwa sababu hiyo informed consent haikutumika.
Dataset ya chanzo ilichukuliwa kutoka public Kaggle repository yenye jina “Draw-a-Person Hand-Drawn Sketches by Children”, na tarehe ya access katika makala imetolewa kuwa 30 Novemba 2025.
Michango ya waandishi
Conceptualization na methodology zilifanywa na Asma Abdullah Alwadai pamoja na Emad Sami Jaha. Software, validation, investigation, data curation, first draft na visualization zilifanywa hasa na Asma Abdullah Alwadai. Supervision na funding acquisition zilichukuliwa na Emad Sami Jaha; waandishi wote wawili walichangia review na editing ya makala.
Mgongano wa maslahi
Waandishi walitangaza kwamba hakuna conflict of interest.
Muhtasari wa rekodi ya kutokulingana ndani ya chanzo
- Abstract inasema michoro 948 ni separate hold-out test set; detailed methods zinaonyesha 948 ni dataset yote na 143 ni test set.
- Sehemu moja inaeleza cross-validation kwenye michoro 805, nyingine kwenye michoro yote 948.
- Main architecture inaonyesha outputs 10 CNN + 6 heuristic, ilhali subsection moja inaeleza ResNet classifier yenye outputs 16.
- Katika loss function section pia kutajwa kwa features 16 kwa CNN hakulingani na architecture ya 10+6.
- Maandishi yanaripoti %91,78 macro accuracy, wakati wastani wa Jedwali 7 ni %91,75 na final average ya Jedwali 8 ni %87,80.
- Ear F1 ni 0,07 katika evaluation moja na 0,57 katika nyingine, na chanzo hakielezi vya kutosha mechanism ya mabadiliko hayo.
- Ingawa Jedwali 9 linahusisha mabadiliko ya sikio na heuristic refinement, hakuna hata moja ya heuristic rules sita iliyoelekezwa kwa sikio.
- Katika results text, sehemu moja inasema score ni “average”, lakini formula na scale ya 0–16 zinaonyesha features zinajumlishwa.
- Katika cross-validation heuristic features zote zinapata F1=1,00, lakini katika independent expert-labeled test F1 ya limb–torso connection inashuka hadi 0,4762.
Kwa hiyo hitimisho thabiti zaidi la utafiti si kwamba “AI sasa inaweza kufanya psychological assessment kutoka michoro ya watoto kiotomatiki na kikamilifu”. Hitimisho finyu zaidi linaloungwa mkono na chanzo ni kwamba kuunganisha ResNet-based visual feature detection na explicit geometric rules kunaweza kuunda automatic na interpretable prototype scoring system kwa vipengele 16 maalumu vya michoro ya DAP. Hasa, kabla ya mfumo huo kujumlishwa kama clinical au psychological decision mechanism, changamoto za small anatomical details, class imbalance, inconsistencies katika evaluation protocol na ukosefu wa external validation zinahitaji kutatuliwa; generalization hiyo haiungwi mkono na chanzo katika hali ya sasa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *