

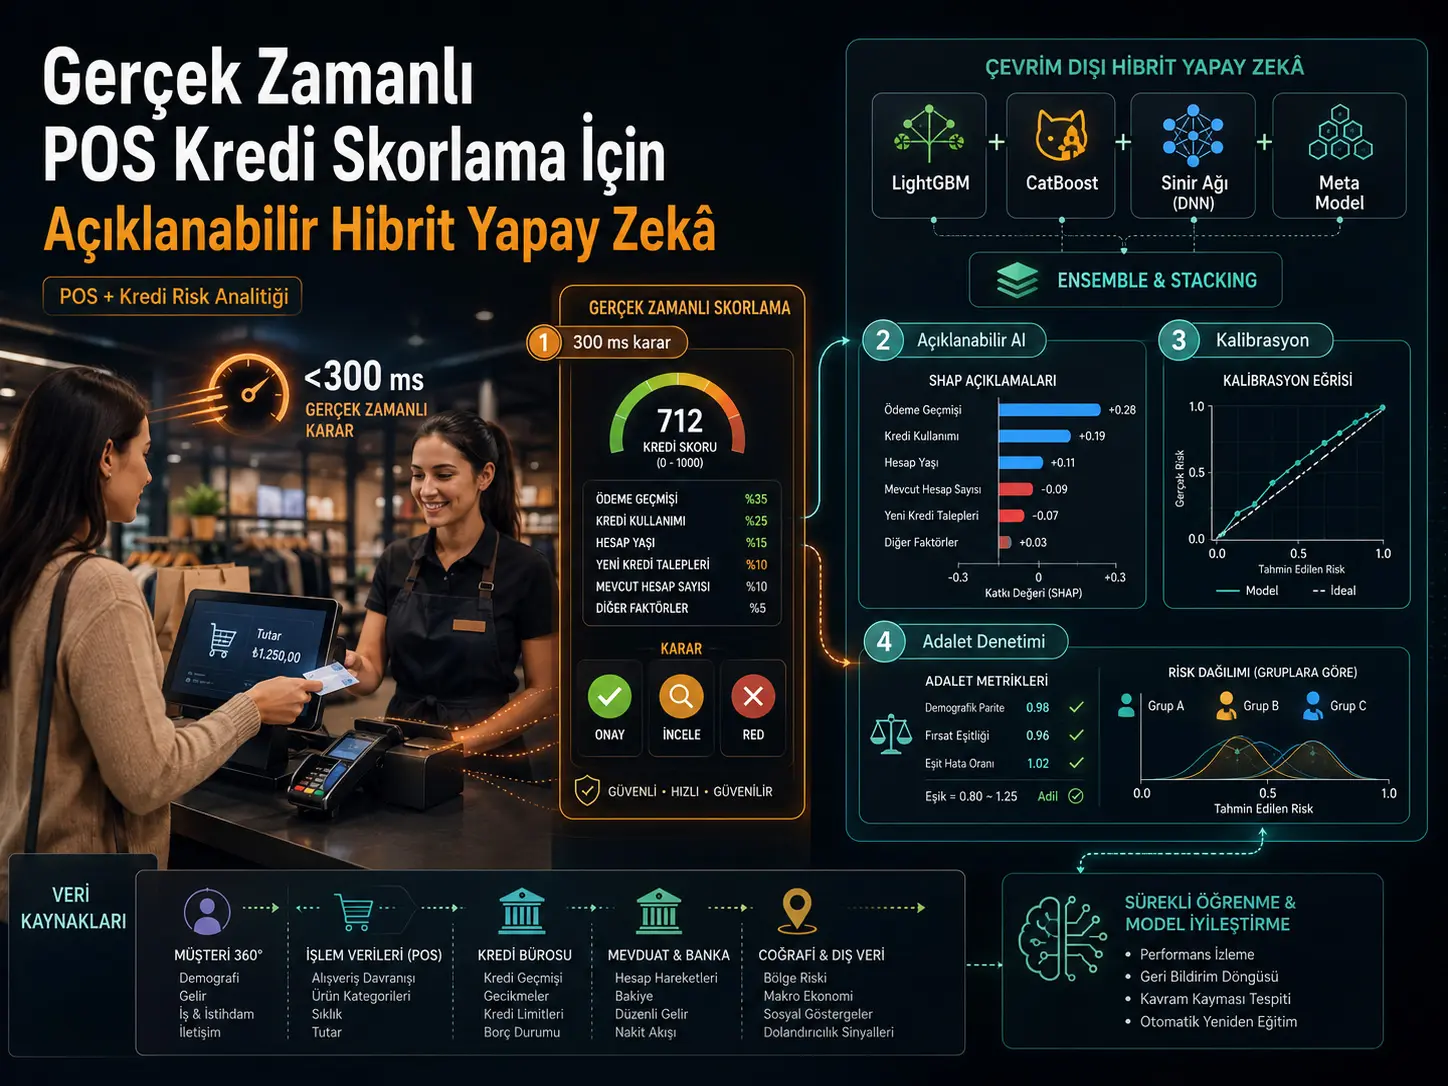
Utafiti huu unatokana na wazo kwamba modeli moja ya akili bandia huenda isitoshe katika kila hali kwa mikopo ya sehemu ya mauzo, ambapo uamuzi wa mkopo unapaswa kutolewa ndani ya mamia machache ya milisekunde kwenye kaunta ya duka. Badala yake, watafiti wanatengeneza usanifu mseto unaotenganisha mahitaji mawili tofauti ya kiutendaji: katika njia ya wakati halisi, scorecard za Weight of Evidence–Logistic Regression zinazoweza kuelezwa na zenye ucheleweshaji mdogo; na katika njia ya batch ya usiku, ensemble iliyokalibishwa inayojumuisha LightGBM, CatBoost na neural network yenye tabaka tatu inayoweza kutumia data pana zaidi za mteja.
Utafiti ulifanywa kwa rekodi 806.537 za uchanganuzi zilizopatikana kutoka portfolio ya uzalishaji ya benki moja kubwa ya daraja la pili nchini Kazakhstan. Kigezo lengwa ni NPL91_EVER, kinachoonyesha kama mkopo uliwahi kuchelewa kwa siku 90 au zaidi angalau mara moja katika maisha yake yaliyozingatiwa. Kiwango cha default katika sampuli ya uchanganuzi ni %10,22.
Kwa wateja waliopo, modeli ya wakati halisi LR-Old ilifikia katika test set:
\[ AUROC=0{,}8475,\qquad KS=0{,}5555,\qquad Gini=0{,}6950 \]
. Ensemble ya Ens-Off inayotumia seti pana zaidi ya data za offline ilitoa katika cohort hiyo hiyo ya wateja waliopo:
\[ AUROC=0{,}9178,\qquad KS=0{,}6825,\qquad Gini=0{,}8356 \]
. Hivyo thamani ya test Gini iliongezeka kwa takribani pointi 0,141 kwa thamani kamili. Kwa wateja wapya, test AUROC ya modeli LR-New iliripotiwa kuwa 0,8348.
Hata hivyo, matokeo haya si dhamana ya mafanikio tayari kwa nchi au benki nyingine. Data zote za utafiti zilitoka katika taasisi moja; train, test na validation sets ziliundwa kwa random kutoka portfolio ileile ya 2023–2024. Out-of-time validation halisi na external validation kwenye portfolio ya pili bado hazijafanywa.
Kwa nini credit scoring kwenye sehemu ya mauzo ni tatizo tofauti?
POS credit humaanisha kwamba mteja anaomba mkopo mdogo au wa ukubwa wa kati wa matumizi wakati wa kununua bidhaa dukani, ndani ya muamala huo huo. Katika mazingira haya, modeli ya credit risk haitakiwi tu kuwa na predictive accuracy kubwa; uamuzi wa mkopo pia lazima utolewe kwa kasi ya kutosha ili mteja asisubiri kwenye kaunta.
Katika utafiti wa chanzo, kikomo cha kiutendaji kinafafanuliwa kuwa takribani:
\[ <300\ \mathrm{ms} \]
kwa XML round-trip service level.
Pia inaelezwa kwamba real-time payload huwekwa kuwa ndogo sana, kwa sababu kuomba taarifa nyingi sana kutoka kwa mteja kwenye kaunta kunaweza kupunguza sales conversion.
Mahitaji haya mawili yanazalisha mgongano wa kawaida wa uhandisi katika credit risk:
Vipengele vingi zaidi kwa kawaida vinaweza kutoa predictive power kubwa zaidi; lakini si vipengele vyote vinavyopatikana wakati wa uamuzi au vinaweza kupatikana kwa kasi ya kutosha.
Dual-track architecture ina maana gani?
Utafiti unatatua mgongano huu kwa kuugawa katika njia mbili badala ya kulazimisha modeli moja kufanya kila kitu.
| Njia | Modeli | Lengo kuu | Muda uliotolewa katika chanzo |
|---|---|---|---|
| Online | WOE–Logistic Regression | Uamuzi wa mkopo unaoweza kuelezwa na wenye ucheleweshaji mdogo kwenye kaunta | Wakati halisi; lengo la XML round-trip <300 ms |
| Offline | LightGBM + CatBoost + neural network stacked ensemble | Uwezo mkubwa zaidi wa kutenganisha madarasa na PD iliyokalibishwa kwa data pana za mteja | Batch ya usiku |
Njia ya online hutumika moja kwa moja kwa uamuzi wa mkopo, wakati matokeo ya modeli ya offline huandikwa tena kwenye customer-360 repository na IFRS 9 risk data layer.
Kutolingana kwa idadi ya vipengele vya online ndani ya chanzo
Katika sehemu hii makala haiko thabiti kikamilifu ndani yake. Sehemu ya 3.5 na Kielelezo 1 zinaonyesha online roster kama:
sehemu 9 za application XML + sehemu 4 za bureau zilizohifadhiwa mapema
.
Kwa upande mwingine, Jedwali 2, Kielelezo 2 na ufafanuzi wa modeli zinaripoti LR-Old na LR-New kama:
modeli zenye vipengele 9
.
Chanzo hakifafanui wazi kama vipengele 4 vya bureau vinatumwa kwenye decision engine kisha baadhi yake vinachaguliwa ndani ya vipengele tisa vya mwisho, au kama inputs 13 zinatumika kweli. Kwa hiyo wakati wa kuitekeleza tena modeli, production feature roster inapaswa kuthibitishwa na waandishi.
Dataset iliundwaje?
Chanzo kinasema kwamba awali kulikuwa na:
\[ N=926.000 \]
mikataba ya POS credit.
Baada ya kuondoa rekodi:
\[ 119.463 \]
zilizofutwa na wateja na ambazo repayment behavior haikuweza kuzingatiwa, sampuli ya mwisho ya uchanganuzi ikawa:
\[ N=806.537 \]
.
Class distribution imetolewa kama:
\[ 89{,}78\%\ \text{non-default}, \qquad 10{,}22\%\ \text{default} \]
.
Default ilifafanuliwaje?
Dependent variable imefafanuliwa kama:
\[ y_i=NPL91\_EVER_i \]
.
Ikiwa mkataba wakati wowote katika kipindi chake kilichozingatiwa ulifikia kuchelewa kwa angalau:
\[ 90\ \text{gün} \]
, uliwekewa:
\[ y_i=1 \]
.
Muundo huu unaonyesha kwamba modeli ni binary classifier inayotabiri kama tukio la default lililofafanuliwa litatokea, si kiasi endelevu cha malipo.
Je, ulimwengu wote wa maombi unawakilishwa?
Chanzo katika baadhi ya sehemu kinaita data “contracts” na katika nyingine “loan applications”. Haijaelezwa kama maombi yaliyokataliwa, ambayo kwa hiyo repayment behavior ya baadaye haiwezi kuzingatiwa, yalijumuishwa kwenye analytical dataset.
Pia hakuna mbinu ya reject inference, inayotumika katika classic credit risk, iliyoelezwa.
Kwa hiyo haiwezi kuthibitishwa kutoka chanzo kama rekodi 806.537 zinawakilisha ulimwengu wote wa maombi ya POS credit au hasa mikataba yenye repayment performance inayoweza kuzingatiwa. Tofauti hii ni muhimu kwa transportability ya modeli kwenye population ya maombi mapya.
Kwa nini wateja waliopo na wapya wanatenganishwa?
Portfolio imegawanywa katika:
\[ N_{\mathrm{old}}=455.827 \]
wateja waliopo na:
\[ N_{\mathrm{new}}=350.710 \]
wateja wapya.
Sababu ni kwamba kwa watu ambao tayari wana uhusiano na benki, vipengele vya kihistoria kama mabadiliko ya amana, transactional behavior au internal cash flow vinaweza kupatikana; kwa wateja wapya, signal set hiyo hiyo huenda isiwepo.
Feature families ni zipi?
Kati ya candidate variables 148 za mwanzo, variables 101 zilibaki baada ya filtering. Kwa sababu ya banking confidentiality, chanzo hakitoi majina halisi ya production columns, bali semantic families tu.
| Feature family | Idadi baada ya filtering | Maudhui ya jumla |
|---|---|---|
fcb_ | 31 | Vipengele vya credit bureau |
app_ | 9 | Sehemu za application XML |
prod_ | 4 | Taxonomy ya bidhaa za mkopo |
trans_ | 18 | Mifumo ya miamala/matumizi |
depo_ | 11 | Mienendo ya salio la amana |
bank_ | 13 | Vipengele vya cash inflow ndani ya benki |
geo_ | 6 | Vipengele vya geospatial risk vinavyotegemea anwani |
behav_ | 9 | Digital session behavior |
Feature elimination ilifanywaje?
Vizingiti vitatu vya msingi vilitumika:
\[ IV\geq0{,}10 \]
\[ missingness\leq80\% \]
\[ |\rho|\leq0{,}70 \]
. Katika variable pairs zenye correlation kubwa, feature yenye Information Value ndogo zaidi iliondolewa.
Je, Information Value kubwa inaweza kuwa leakage?
Kwa sababu baadhi ya credit-bureau variables zilifikia:
\[ IV>0{,}50 \]
, utafiti ulifanya leakage checks za ziada.
Chanzo kinataja checks tano: kuhakikisha feature inatumia data iliyokuwapo tu hadi wakati wa maombi, kutokuwa na post-default information kimaana, WOE shape kuwa na mantiki ya kiuchumi, single-feature AUROC kutokuwa juu isivyo kawaida, na PSI stability kati ya time slices.
Univariate AUROC ya bureau feature yenye nguvu zaidi iliripotiwa kuwa 0,781. Kwa msingi huu, utafiti unatafsiri IV kubwa kama signal yenye nguvu ya credit-bureau inquiry intensity badala ya leakage.
Kwa nini WOE ilichaguliwa kwa modeli ya wakati halisi?
Weight of Evidence hugawa kila variable katika bins kulingana na viwango vya risk na kueleza kwa logarithm uwiano kati ya default na non-default distributions:
\[ WOE_k= \ln \left( \frac{ P(x\in B_k\mid y=1) }{ P(x\in B_k\mid y=0) } \right). \]
Hapa \(B_k\) ni bin ya \(k\) ya variable; \(y=1\) ni default class na \(y=0\) ni non-default class.
Discriminatory power ya jumla ya feature hufupishwa kwa Information Value:
\[ IV(x)= \sum_{k=1}^{K} (\hat p_{1,k}-\hat p_{0,k})WOE_k. \]
WOE transformation hutumiwa hasa katika credit risk ili kufanya scorecard kuwa orderly, monotonic na inayoweza kuchunguzwa na binadamu.
Real-time score inazalishwaje?
Baada ya WOE transformation, L2-regularized logistic regression inatumika. Chanzo kinafafanua production score kama:
\[ score(x) = Offset - Factor\cdot \langle\beta,WOE(x)\rangle \]
.
Hapa:
\[ Factor=\frac{PDO}{\ln2} \]
na:
\[ PDO=20 \]
imechaguliwa.
PDO ni classic credit-scoring scaling parameter inayoonyesha score inabadilika kwa pointi ngapi wakati default odds zinaongezeka mara mbili.
Offline ensemble iliundwaje?
Ens-Off inatumia base learners tatu tofauti:
- LightGBM,
- CatBoost,
- fully connected neural network yenye hidden blocks tatu.
Out-of-fold probabilities zilizotolewa na kila modeli katika five-fold stratified cross-validation hupewa logistic-regression meta-learner:
\[ \hat p_i^{stack} = \sigma \left( \alpha_0 + \alpha_1\hat p_i^{LGBM} + \alpha_2\hat p_i^{CB} + \alpha_3\hat p_i^{NN} \right). \]
Hapa:
\[ \sigma(z)=\frac{1}{1+e^{-z}} \]
ni logistic sigmoid function.
Kisha isotonic regression inatumika tu juu ya combined stacked score:
\[ \hat p_i^{cal} = g_{\mathrm{iso}} ( \hat p_i^{stack} ). \]
Yaani LightGBM, CatBoost na neural network hazikalibishwi kila moja peke yake; kwanza zinastackiwa, kisha combined output inakalibishwa.
Neural network architecture ni ipi?
Muundo wa msingi wa neural network katika chanzo ni:
\[ 72 \rightarrow 256 \rightarrow 128 \rightarrow 64 \rightarrow 1 \]
.
ReLU activations, batch normalisation na:
\[ dropout=0{,}30 \]
vilitumika.
Self-attention head moja iliwekwa kati ya hidden block ya pili na ya tatu ili kumodel interactions kati ya tabular features.
Hyperparameter search ilifanywaje?
Kwa LightGBM, CatBoost na neural network, Optuna Tree-Structured Parzen Estimator ilitumika kufanya:
\[ 30 \]
trials kila moja.
Optimization target ilikuwa five-fold stratified cross-validation AUROC.
Takribani tuning times zilizotolewa katika chanzo ni:
| Modeli | Muda kwa trials 30 za Optuna |
|---|---|
| LightGBM | dakika 42 |
| CatBoost | dakika 78 |
| Neural network | dakika 96 |
Jumla ya tuning cost iliripotiwa kuwa takribani 3,6 GPU-hours. Hardware ilikuwa NVIDIA T4 16 GB GPU, 16 vCPU na 64 GB RAM.
Kwa nini random split ni limitation muhimu?
Kila customer segment iligawanywa kwa stratified random sampling kama:
\[ 70\%/20\%/10\% \]
train/test/validation.
Njia hii inaunda hold-out samples zilizotengwa ndani ya data-generation period ileile; lakini haijaribu transportability kwenda future economic period.
Sehemu ya future work ya utafiti inasema kwamba real out-of-time cohort kutoka Q2–Q4 2024 originations itatumika. Kwa hiyo validation result ya sasa haipaswi kutafsiriwa kama external au temporal validation.
Kwa nini calibration ni muhimu katika credit risk?
AUROC hupima tu kiwango ambacho modeli inawapanga vizuri good na bad customers. Katika banking application, absolute level ya:
\[ PD=P(\mathrm{default}) \]
inayotolewa na modeli pia ni muhimu.
Hii ni kwa sababu chanzo kinasema PD inatumika katika IFRS 9 expected credit loss, risk-based pricing na credit cut-off decisions.
Calibration error hupimwa kwa Brier score:
\[ Brier= \frac{1}{N} \sum_{i=1}^{N} (\hat p_i-y_i)^2. \]
Brier ya chini inaonyesha predicted probabilities zilizo karibu zaidi na realized outcomes.
Kutolingana kwa maana katika Brier score ndani ya chanzo
Maandishi ya utafiti yanasema kwamba baada ya isotonic calibration, Brier score ilipungua kwa takribani:
%18
.
Hata hivyo, values zilizochapishwa katika Kielelezo 5 ni:
\[ Brier_{\mathrm{raw}}=0{,}1918 \]
na:
\[ Brier_{\mathrm{iso}}=0{,}0726 \]
.
Absolute difference kati ya namba hizi mbili ni:
\[ 0{,}1192 \]
na relative reduction ni takribani:
\[ 62{,}1\% \]
.
Kwa hiyo kauli ya “%18” na Brier values katika figure haziwezi kuwa sahihi kwa wakati mmoja. Haiwezekani kujua kutoka chanzo ni upande gani una writing au calculation error.
Je, calibration ya online scorecards ilionyeshwa?
Chanzo kinasema scorecards mbili za WOE–Logistic Regression ni “well calibrated by design” na hazihitaji correction ya ziada.
Hata hivyo, equivalents za reliability curve na Brier comparison zilizotolewa kwa offline ensemble hazijatolewa kwa LR-Old na LR-New.
Kwa hiyo calibration quality ya online models haijaonyeshwa kwa empirical evidence ya kina sawa na ensemble.
Model stability ilipimwaje?
Population Stability Index ilihesabiwa kwa:
\[ PSI = \sum_{k=1}^{B} (p_k^{ref}-p_k^{obs}) \ln \left( \frac{p_k^{ref}}{p_k^{obs}} \right) \]
.
Chanzo kinatumia:
\[ PSI<0{,}10 \]
kama stable, 0,10–0,25 kama attention, na zaidi ya 0,25 kama action level.
Train–test score PSI values ni:
| Modeli | Train–test PSI |
|---|---|
| LR-Old | 0,014 |
| Ens-Off | 0,021 |
| LR-New | 0,012 |
Kwa Ens-Off, train–validation PSI imetolewa kuwa 0,018.
Feature PSI values kubwa zaidi
Feature-level PSI mbili kubwa zaidi ni:
\[ app\_feature3=0{,}064 \]
na:
\[ trans\_feature1=0{,}057 \]
.
Values zote mbili ziko chini ya attention threshold 0,10 inayotumiwa na chanzo.
Hata hivyo, kwenye variable labels za Kielelezo 6, app_feature3 inaonekana mara mbili. Haiwezi kujulikana kutoka source text ni variable gani halisi inayolingana na repetition hii.
Score-band analysis inaonyesha nini?
Ens-Off test set iligawanywa katika vikundi kumi sawa kwa risk order.
| Risk band | Observed default rate (%) | Cumulative captured defaulters (%) | Policy label ya chanzo |
|---|---|---|---|
| 1 — hatari zaidi | 34,2 | 31,0 | Decline |
| 2 | 21,5 | 50,5 | Decline |
| 3 | 15,0 | 64,1 | Manual review |
| 4 | 11,1 | 74,2 | Manual review |
| 5 | 8,9 | 82,2 | Approve |
| 6 | 7,0 | 88,6 | Approve |
| 7 | 5,5 | 93,6 | Approve |
| 8 | 4,2 | 97,4 | Approve |
| 9 | 3,0 | 99,1 | Approve / pre-approved |
| 10 — salama zaidi | 1,7 | 100,0 | Approve / pre-approved |
Kundi la kwanza la %10 lenye risk kubwa zaidi pekee lina %31 ya defaulters wote, huku vikundi viwili vya kwanza vikiwa na %50,5.
Nini hutokea katika acceptance rate ya %60?
Katika acceptance-rate sensitivity analysis ya chanzo, wakati %60 ya total applications zinakubaliwa, bad-rate ya accepted customers imeripotiwa kuwa:
\[ 5{,}6\% \]
kwa Ens-Off na:
\[ 8{,}0\% \]
kwa LR-Old.
Tofauti ni:
\[ 2{,}4\ \text{yüzde puanı} = 240\ \text{baz puan} \]
.
Matokeo haya ni retrospective model result inayoonyesha kwamba richer offline model iliweza kuchagua group yenye risk ndogo kwa acceptance rate ileile. Hayapaswi kutafsiriwa kama realized credit-loss reduction au causal profitability gain.
SHAP explanation inageuzwaje kuwa production decision?
Katika global SHAP ranking ya Ens-Off, credit-bureau intensity family inaonekana kuwa muhimu. Spearman correlation kati ya IV ranking na mean absolute SHAP ranking imeripotiwa kama:
\[ \rho=0{,}86, \qquad p<0{,}001 \]
.
Katika production level, SHAP contributions hupangwa kwa kila application na factors nne zenye strongest negative contribution hugeuzwa kuwa reason codes zinazoweza kusomwa na binadamu.
Katika anonymous example ya chanzo, key negative drivers za declined application ni:
| Driver | SHAP contribution — log-odds | Reason code |
|---|---|---|
| High recent credit-bureau inquiry intensity | +0,78 | R-01 |
| High requested credit / income ratio | +0,54 | R-04 |
| Recent bureau delinquency | +0,39 | R-02 |
| Low recent deposit balance | +0,21 | R-07 |
Positive SHAP values hapa zinawakilisha factors zinazoongeza default log-odds ya modeli.
Fairness audit inapima nini?
Utafiti ulitumia demographic axes tatu:
- wanawake / wanaume,
- makundi ya umri 18–30, 31–45, 46–60 na 60+,
- makazi ya mjini / vijijini.
AUROC values katika groups zote zilikuwa katika:
\[ 0{,}913-0{,}922 \]
.
Maximum absolute gaps zilizoripotiwa na chanzo ni:
| Fairness metric | Maximum absolute group gap (percentage points) |
|---|---|
| Demographic parity | 1,2 |
| TPR gap | 1,4 |
| FPR gap | 0,6 |
| PPV gap | 1,3 |
Matokeo haya yanaonyesha kwamba katika test cohort iliyochunguzwa, small gaps ziliripotiwa kati ya demographic slices zilizobainishwa.
Hata hivyo group sample sizes na confidence intervals za gaps hizi hazikutolewa. Pia hakuna hitimisho linaloweza kutolewa kuhusu demographic characteristics ambazo hazikuchunguzwa.
Tatizo la direction katika fairness equation
Makala inatoa kwa demographic parity:
\[ \Delta DP_g = P(\hat y=1\mid G=g) - P(\hat y=1) \]
na kuieleza kama approval-rate difference.
Hata hivyo katika sehemu hiyo hiyo:
\[ TPR_g=P(\hat y=1\mid y=1,G=g) \]
inafasiriwa kama kuondoa true defaulters kwa usahihi,
\[ FPR_g=P(\hat y=1\mid y=0,G=g) \]
na kama kukataa good applications kimakosa.
Ikiwa \(\hat y=1\) katika definitions hizi inamaanisha “risky/declined” decision, basi \(P(\hat y=1)\) katika formula ya kwanza kimahesabu ni predicted-positive/decline rate, si approval rate. Chanzo hakielezi distinction hii ya sign na decision coding.
Je, KMeans segmentation imejumuishwa kwenye modeli?
Hapana. KMeans analysis iliyofanywa kwa existing customers ilitumika kama management interpretation layer pekee.
Default rates za clusters nne zinatofautiana takribani kutoka %4,1 hadi %21,6. Lowest-risk profile imefafanuliwa kwa low bureau activity na high cash inflow; highest-risk profile kwa high bureau activity na low cash inflow.
Waandishi wanasema wazi kwamba hawakutumia cluster labels kama predictors katika modeli tatu za mkopo.
Pia kwa kuwa cluster-stability bootstrap analysis haikufanywa, utafiti unaweka segmentation hii kama advisory management framework, si decision model.
MLOps architecture ikoje?
Katika production architecture, model artefacts zinapewa version kwa MLflow na Git tags.
Monitoring arrangement katika chanzo inaelezwa kama:
- monthly performance/stability calculations,
- quarterly champion–challenger governance review,
- retraining trigger wakati feature PSI > 0,25,
- retraining trigger wakati KS performance inashuka zaidi ya %10 dhidi ya development level
.
Ina maana gani kwa Uturuki?
Utafiti hauna data kutoka benki nchini Uturuki na haujathibitishwa dhidi ya credit regulation au customer behavior ya Uturuki.
Hata hivyo, technical architecture ina maana ya dhana kwa Uturuki: kutenganisha explainable online scorecard inayotumia taarifa chache zenye low latency zinazopatikana wakati wa decision na nightly/background risk model inayotumia customer data pana zaidi ni general engineering approach inayotenganisha data-access time na model complexity.
Katika application ya Uturuki, WOE bins, credit-bureau structure, income/debt behavior, default definition, fairness groups, model governance na legal requirements zinapaswa kuthibitishwa upya kwa local data na regulations. AUROC au Gini results za Kazakhstan haziwezi kuhamishwa moja kwa moja kwenye portfolio ya Uturuki.
Matokeo yanayoungwa mkono na utafiti
- Katika existing-customer test cohort ileile, offline ensemble yenye vipengele 72 ilitoa AUROC, KS na Gini kubwa zaidi kuliko LR-Old scorecard iliyoripotiwa kuwa na vipengele 9.
- Online WOE-LR models zilizotumiwa kwa existing na new customers zilitoa katika source test set AUROC takribani 0,847 na 0,835 mtawalia.
- Offline ensemble test AUROC ni takribani 0,918 na Gini yake ni takribani 0,836.
- Katika offline model, credit-bureau, internal-bank cash-flow, deposit na transaction data zina important predictive signal.
- Score-band analysis inaonyesha default risk inapungua kwa mpangilio kutoka highest-risk band kwenda safest band.
- Katika demographic slices zilizochunguzwa, source iliripoti small fairness gap values.
- SHAP contributions zilibuniwa kama explanation pipeline inayogeuzwa kuwa reason codes katika production.
- Utafiti unaeleza end-to-end MLOps approach inayojumuisha monitoring, model registry na retraining triggers.
Matokeo ambayo utafiti hauungi mkono au kuthibitisha
- Haijathibitishwa kwamba modeli itaonyesha performance ileile katika benki, nchi au economic periods nyingine.
- Real out-of-time au external validation kwenye taasisi ya pili haijafanywa.
- Random hold-out validation si test ya resilience dhidi ya economic regime change.
- Fairness audit haithibitishi kutokuwepo kwa discrimination katika demographic groups zote zinazowezekana.
- Kutumia SHAP pekee hakumaanishi certificate ya full regulatory compliance.
- Bad-rate difference ya 240 basis points katika acceptance rate ya %60 si realized financial-loss reduction.
- KMeans segments si causal risk segments zilizothibitishwa kwa credit decision.
- Utafiti haujajaribiwa katika recession au macroeconomic stress period.
- Kwa kuwa source haina taarifa za kutosha kuhusu rejected applicants na reject inference, representativeness ya modeli kwa entire application universe haiwezi kuthibitishwa.
- Kauli ya %18 Brier calibration improvement hailingani kimahesabu na values 0,1918 → 0,0726 zilizotolewa katika Kielelezo 5.
Mbinu na Matokeo ya Utafiti
Analytical population
| Hatua | Idadi ya rekodi |
|---|---|
| Initial POS credit records | 926.000 |
| Rekodi zilizofutwa na mteja na kuondolewa | 119.463 |
| Final analytical sample | 806.537 |
| Existing customers | 455.827 |
| New customers | 350.710 |
Muundo wa modeli na segment
| Modeli | Segment | Algorithm | Idadi ya vipengele iliyoripotiwa katika chanzo | Njia |
|---|---|---|---|---|
| LR-Old | Existing customer | WOE + L2 Logistic Regression | 9 | Wakati halisi |
| Ens-Off | Existing customer | LightGBM + CatBoost + NN + logistic stacking + isotonic calibration | 72 | Batch ya usiku |
| LR-New | New customer | WOE + L2 Logistic Regression | 9 | Wakati halisi |
Source note: Kwa kuwa Sehemu 3.5 na Kielelezo 1 pia zinaonyesha bureau features nne kwa online roster, online feature count haiko thabiti kikamilifu ndani ya chanzo.
Train/test/validation sizes
| Segment/model | Train | Test | Validation |
|---|---|---|---|
| Existing customer — LR | 319.078 | 91.211 | 45.538 |
| Existing customer — Ensemble | 319.078 | 91.211 | 45.538 |
| New customer — LR | 245.497 | 70.177 | 35.036 |
Main discrimination results
| Modeli | Train AUROC | Test AUROC | Validation AUROC | Test KS | Test Gini |
|---|---|---|---|---|---|
| LR-Old | 0,8472 | 0,8475 | Haikuripotiwa | 0,5555 | 0,6950 |
| Ens-Off | 0,9327 | 0,9178 | 0,9171 | 0,6825 | 0,8356 |
| LR-New | 0,8345 | 0,8348 | Haikuripotiwa | 0,5310 | 0,6696 |
Train AUROC ya Ens-Off inashuka kutoka 0,9327 hadi 0,9178 katika test. Validation AUROC ya 0,9171 inaonyesha kwamba hold-out performance ndani ya randomly split data window ileile iko karibu na test result; hii si ushahidi wa temporal au institutional transportability.
Verianla Live: Modeli ya online na offline ya mkopo katika existing-customer cohort ileile
Ulinganisho hapa chini unajumuisha LR-Old na Ens-Off pekee katika existing-customer test set ileile. Metrics zote tatu ziko kwenye scale ya 0–1 na value kubwa ina maana stronger class discrimination.
| Modeli | Test AUROC | Test KS | Test Gini |
|---|---|---|---|
| LR-Old — real-time scorecard | 0.8475 | 0.5555 | 0.6950 |
| Ens-Off — offline ensemble | 0.9178 | 0.6825 | 0.8356 |
Verianla Live: Values ni existing-customer test results katika Jedwali 6 la utafiti. Kwa kuwa comparison inafanywa kwenye cohort ileile, new-customer LR-New model haijajumuishwa kwenye visualization hii.
Ujumbe mkuu wa Verianla Live comparison ni kwamba offline ensemble ilitoa values kubwa zaidi kuliko real-time scorecard katika discrimination metrics zote tatu kwenye existing-customer test population ileile. Gharama yake ni feature roster pana zaidi, modeli tata zaidi, separate inference infrastructure na kutumia nightly batch badala ya real-time channel.
Baseline comparison katika cohort ileile
| Modeli | AUROC | Gini |
|---|---|---|
| Single fcb_feature1 Logistic Regression | 0,781 | 0,562 |
| Vanilla LR — bila WOE | 0,821 | 0,642 |
| Standalone LightGBM | 0,910 | 0,820 |
| LR-Old | 0,847 | 0,695 |
| Ens-Off | 0,918 | 0,836 |
Jedwali hili linaonyesha hasa kwamba tofauti kati ya ensemble na standalone LightGBM ni ndogo sana kuliko tofauti kati ya online LR na ensemble. AUROC ya Ens-Off ni 0,008 juu kuliko standalone LightGBM.
Predictor families zenye taarifa nyingi zaidi
Information Value kubwa zaidi zinaonekana hasa katika credit-bureau features.
| Feature | Maelezo ya jumla | IV — existing customer | IV — new customer |
|---|---|---|---|
| fcb_feature2 | Worst bureau delinquency severity | 0,730 | 0,660 |
| fcb_feature3 | Breadth of active bureau credit relationships | 0,725 | 0,295 |
| fcb_feature1 | Recent bureau inquiry intensity | 0,715 | 0,640 |
| app_feature1 | Declared income | 0,640 | 0,450 |
| app_feature2 | Requested amount / income ratio | 0,635 | 0,555 |
Operating point result
Kwa Ens-Off, Youden-optimal threshold imetolewa kuwa takribani:
\[ \hat p^\star=0{,}456 \]
.
Katika point hii:
\[ Sensitivity=0{,}716 \]
na:
\[ Specificity=0{,}881 \]
zimeripotiwa.
Test confusion matrix:
| Predicted 0 | Predicted 1 | |
|---|---|---|
| Actual 0 | 72.145 | 9.745 |
| Actual 1 | 2.647 | 6.674 |
Calibration result na problematic reporting
| Ens-Off output | Brier score katika Kielelezo 5 |
|---|---|
| Stacked meta-learner kabla ya isotonic | 0,1918 |
| Production PD baada ya isotonic | 0,0726 |
Values zilizotolewa katika figure zinalingana na takribani %62,1 relative reduction. Hata hivyo abstract, results na conclusion sections zinaripoti takribani %18 reduction. Kwa hiyo ingawa direction ya calibration inaonyesha improvement wazi, magnitude ya improvement haiwezi kuripotiwa kwa reliable single percentage kutoka source text.
Fairness results
| Kundi | AUROC | ΔDP (pointi) | ΔTPR (pointi) | ΔFPR (pointi) | ΔPPV (pointi) |
|---|---|---|---|---|---|
| Wanawake | 0,916 | +0,3 | +0,4 | +0,2 | −0,5 |
| Wanaume | 0,920 | −0,2 | −0,3 | −0,1 | +0,4 |
| 18–30 | 0,913 | −1,2 | −1,4 | −0,6 | −1,3 |
| 31–45 | 0,919 | +0,1 | +0,2 | +0,1 | +0,2 |
| 46–60 | 0,922 | +0,5 | +0,6 | +0,3 | +0,7 |
| 60+ | 0,917 | +0,8 | +0,9 | +0,4 | +0,9 |
| Mjini | 0,919 | +0,2 | +0,3 | +0,1 | +0,3 |
| Vijijini | 0,914 | −0,9 | −1,1 | −0,5 | −1,0 |
Largest absolute gap ni −1,4-point TPR difference katika age group 18–30. Hata hivyo kwa kuwa confidence intervals au group-specific \(n\) values za table hii hazijatolewa, uncertainty ya results haiwezi kuonyeshwa quantitatively.
Je, Decision Curve Analysis iliripotiwa?
DCA imeorodheshwa miongoni mwa pipeline evaluation components katika Kielelezo 2. Hata hivyo, hakuna Decision Curve Analysis result au graph katika results sections.
Sehemu ya future work ya utafiti inasema DCA itawasilishwa baadaye kwa alignment na policy thresholds. Kwa hiyo makala ya sasa haiungi mkono DCA kama completed analysis.
Production na retraining logic
Operational cycle inayopendekezwa na chanzo ni:
model registry → monthly monitoring → quarterly governance review → retraining baada ya threshold breach
.
Conditions mbili kuu zilizoripotiwa kwa retraining ni:
\[ PSI_{\mathrm{feature}}>0{,}25 \]
au:
\[ KS\ \text{düşüşü}>10\% \]
.
Main engineering contribution ya utafiti
Mchango wa makala si kutengeneza gradient-boosting algorithm mpya, SHAP method mpya au calibration technique mpya. Waandishi wanaiweka wazi kama “real-world implementation study”.
Originality claim inategemea hasa kuunganisha components zifuatazo katika operational structure moja:
feature availability → channel separation → WOE-LR → ensemble → isotonic calibration → SHAP reason codes → fairness audit → PSI/KS monitoring → champion–challenger governance.
Limitations muhimu zaidi
- Data za financial institution moja tu zilitumika.
- Random split ilitumika; real out-of-time validation haikufanywa.
- Hakuna stress validation katika economic recession au interest/inflation regime tofauti.
- IV values kubwa sana zinapaswa kuchunguzwa tena kadiri muda unavyopita.
- Katika highest-risk decile, isotonic model bado ina slight risk overestimation.
- Bootstrap cluster-stability analysis haikufanywa kwa KMeans segmentation.
- Online feature count haiko thabiti ndani ya chanzo.
- Percentage ya Brier improvement hailingani na numbers ndani ya chanzo.
- Fairness audit haina group sizes na uncertainty intervals.
- Status ya rejected applications katika analytical population na reject inference approach haijaelezwa.
- Raw credit records si public kwa sababu ya banking confidentiality.
Utafiti wa siku zijazo
Chanzo kinafafanua hatua nne kuu zinazofuata:
- real out-of-time validation kwenye 2024 Q2–Q4 originations,
- decision-curve analysis kwa bank policy thresholds,
- conformal prediction ili kuelekeza uncertain cases kwenye manual underwriting,
- transportability evaluation kwenye POS portfolio ya emerging market nyingine.
Maelezo ya Chanzo na Mbinu
Jina kamili la kazi asilia: An Explainable Hybrid AI Framework for Real-Time Point-of-Sale Credit Scoring
Waandishi: Gulnaz Zakariya; Aiman Moldagulova; Nor’ashikin Ali.
Co-first/equal contribution: Haijaelezwa katika chanzo.
Mwandishi wa mawasiliano: Aiman Moldagulova.
Taasisi: Department of Software Engineering, Satbayev University, Almaty, Kazakhstan; Department of Cybersecurity, Information Processing and Storage, Satbayev University, Almaty, Kazakhstan; Department of Information Systems, Universiti Tenaga Nasional, Kajang, Selangor, Malaysia.
Aina ya chanzo: Peer-reviewed original research article; retrospective single-portfolio credit-risk model development and internal validation study.
Jarida: AI.
Mchapishaji: MDPI.
Bibliographic record: AI, 2026, Juzuu 7, Toleo 6, Makala 211.
DOI: 10.3390/ai7060211.
Received / revised / accepted / published: 11 Mei 2026 / 7 Juni 2026 / 8 Juni 2026 / 9 Juni 2026.
Hali ya peer review: Ni chapisho la jarida lililopitiwa na wataalamu.
Leseni: Creative Commons Attribution (CC BY).
Academic Editors: Albert Y.S. Lam; Andy Chun.
Kipindi cha utafiti: 1 Januari 2023–31 Machi 2024.
Idadi ya rekodi za mwanzo: 926.000.
Analytical sample: 806.537.
Default rate: %10,22.
Default definition: Angalau mara moja kuchelewa kwa siku 90 au zaidi katika observed contract life; NPL91_EVER.
Customer segments: existing customers 455.827 na new customers 350.710.
Main model 1: LR-Old — WOE + L2 Logistic Regression real-time scorecard kwa existing customers.
Main model 2: Ens-Off — LightGBM + CatBoost + three-layer neural network stacked ensemble na isotonic calibration kwa existing customers.
Main model 3: LR-New — WOE + L2 Logistic Regression real-time scorecard kwa new customers.
Model selection/tuning: Stratified five-fold cross-validation na Optuna TPE; trials 30 kwa kila ensemble base learner.
Test AUROC: LR-Old 0,8475; Ens-Off 0,9178; LR-New 0,8348.
Test Gini: LR-Old 0,6950; Ens-Off 0,8356; LR-New 0,6696.
Test KS: LR-Old 0,5555; Ens-Off 0,6825; LR-New 0,5310.
Ens-Off validation AUROC: 0,9171. Validation hii ni random hold-out kutoka study period ileile; si external au out-of-time validation.
Explainability: TreeSHAP kwa LightGBM na CatBoost, KernelSHAP kwa neural component; strongest negative record-level contributions hugeuzwa kuwa adverse-action reason codes.
Fairness: Demographic parity, TPR, FPR na PPV differences zilichunguzwa kwa gender, age groups na urban/rural residence.
Monitoring: PSI, KS na bad-rate; monthly monitoring na quarterly governance assessment.
Funding: Utafiti unaripoti kwamba haukupokea external funding.
Ethics committee: Imeelezwa kuwa not applicable. Chanzo kinasema de-identified internal banking data zilitumika na human-subject research haikufanywa.
Informed consent: Imeripotiwa kuwa not applicable.
Data availability: Raw loan-level data si public kwa sababu ya banking confidentiality. Chanzo kinasema anonymous aggregate statistics, feature-family-level dictionary, WOE bin definitions, coefficients za production scorecards mbili na figure-generation code zinaweza kuombwa kutoka corresponding author chini ya reasonable request na data-use agreement.
Author contributions: Conceptualization G.Z. na A.M.; methodology, software, formal analysis, investigation, data curation, original draft na visualization G.Z.; validation authors wote; resources na project administration A.M.; supervision A.M. na N.A.; review/editing A.M. na N.A.
Conflict of interest: Waandishi hawakuripoti conflict of interest. Partner financial institution imeelezwa kutokuwa na role katika method selection, evaluation metrics, manuscript writing au publication decision.
Critical notes kuhusu source fidelity
Calibration: Kauli ya “takribani %18 Brier reduction” katika text hailingani na 0,1918 → 0,0726 values za Kielelezo 5. Verianla haisahihishi kimya kimya mojawapo kwa niaba ya chanzo.
Online model roster: Kielelezo 1 na Sehemu 3.5 zinaonyesha 9 application + 4 bureau fields kwa online path, huku Jedwali 2 na model summaries zikiripoti vipengele 9. Final production input count haiko wazi katika chanzo.
Validation: Neno “Validation” linamaanisha random hold-out; real out-of-time validation imeachwa kama future work.
DCA: Ingawa DCA imeorodheshwa katika pipeline ya Kielelezo 2, hakuna DCA katika current results section na inapendekezwa kama future work.
Fairness: Kuna terminological/mathematical ambiguity kati ya positive-class direction ya demographic-parity formula na maelezo yake kama “approval rate”.
Data population: Utafiti unatumia “contracts” na “loan applications” kwa kubadilishana; rejected-applicant population na reject inference process hazijaelezwa.
Kikomo cha tafsiri ya kisayansi
Utafiti huu unaripoti production-oriented credit-risk architecture iliyotengenezwa katika real bank portfolio; hata hivyo performance iliyoripotiwa ni ya institution moja na country context moja.
Values kama AUROC 0,918 au Gini 0,836 haziwezi kutumiwa kama expected performance katika customer population ya benki nyingine. Model performance inaweza kubadilika credit-bureau coverage, customer behavior, product design, economic regime na feature availability zinapobadilika.
Fairness results zinahusu tu demographic groups zilizochunguzwa na test set iliyochunguzwa. Small gap values si universal “fair model” certificate kisheria au kimaadili.
Vivyo hivyo, SHAP reason-code system ni engineering mechanism inayosaidia explainability; yenyewe pekee haithibitishi kwamba model-governance au regulatory-compliance requirements zote zimetimizwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *