

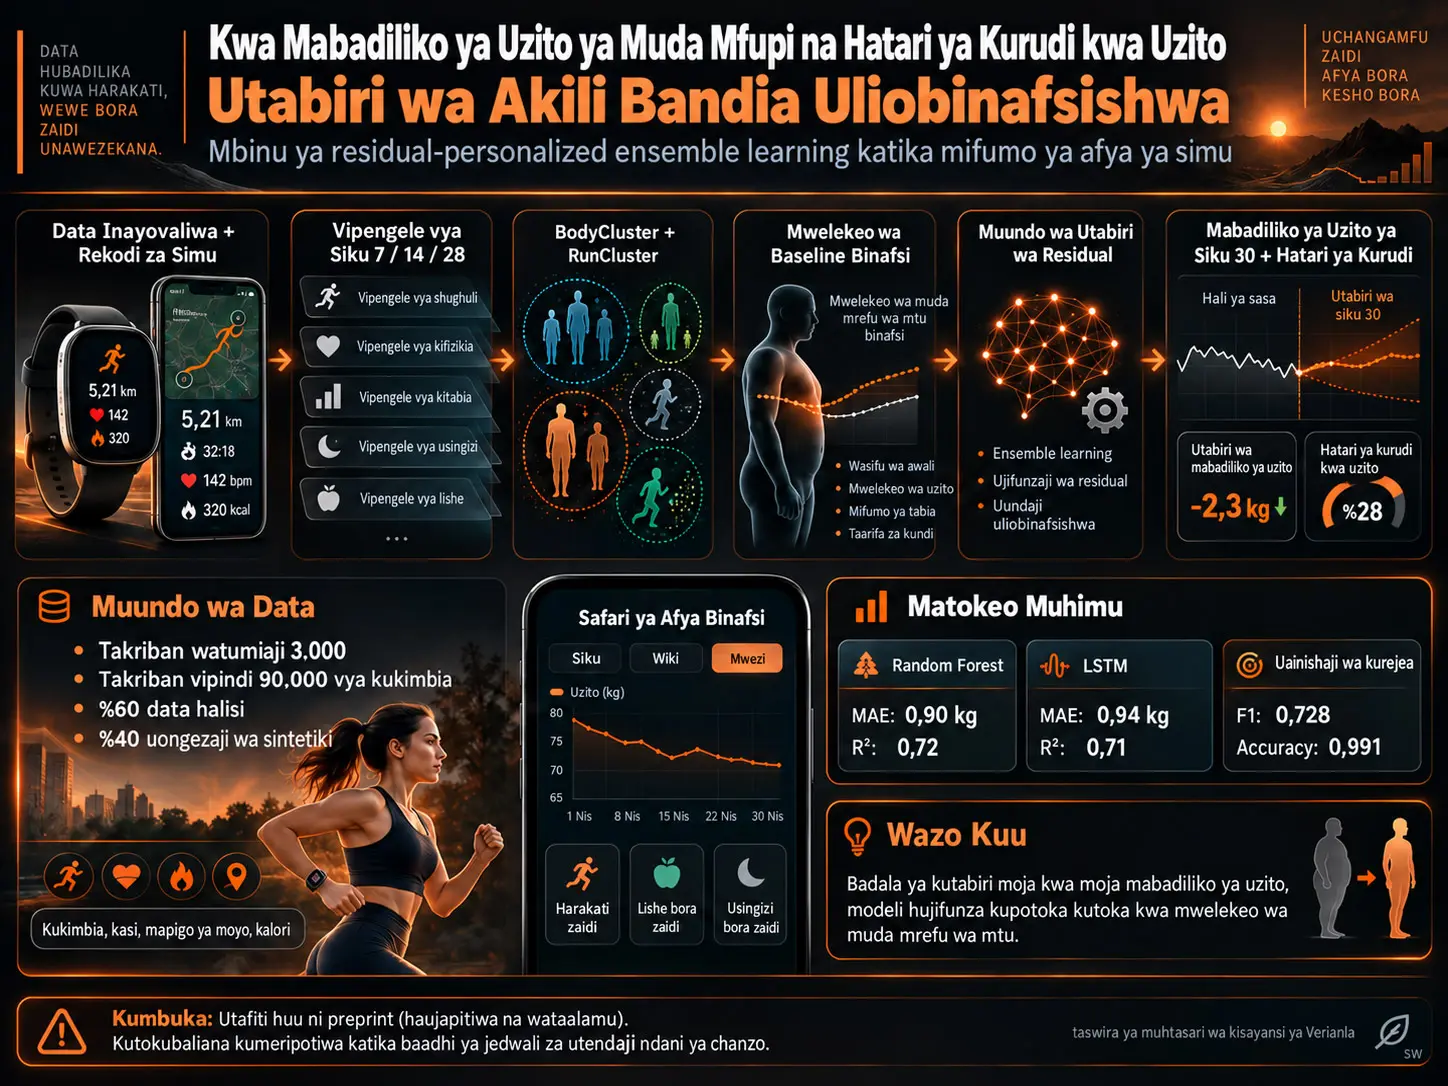
Vifaa vinavyovaliwa vinaweza kuzalisha kiasi kikubwa cha data za kitabia, kama vile umbali wa kukimbia, muda, kasi, mapigo ya moyo na matumizi yanayokadiriwa ya kalori. Hata hivyo, data nyingi hizi hutumiwa katika programu za mazoezi kwa kufupisha shughuli zilizopita. Utafiti huu unapendekeza mfumo wa ujifunzaji wa mashine unaotumia data hizo hizo kujaribu kutabiri mabadiliko ya uzito wa mwili wa mtumiaji katika siku 30 zijazo na hatari ya muda mfupi ya kuongezeka kwa uzito kwa angalau 1 kg.
Mbinu kuu ya utafiti ni, badala ya kutabiri moja kwa moja mabadiliko ya uzito, kwanza kukokotoa kwa kila mtumiaji mwelekeo binafsi wa muda mrefu wa uzito, kisha kuifanya modeli ya ujifunzaji wa mashine itabiri tu mkengeuko kutoka kwenye mwelekeo huo msingi. Waandishi wanaita mbinu hii residual personalization.
Seti ya data ya chanzo ina takriban watumiaji 3.000 na vipindi 90.000 halali vya kukimbia. Hata hivyo, takriban %60 ya seti ya data inatokana na rekodi halisi za vifaa vinavyovaliwa, huku takriban %40 ikitokana na mifuatano ya watumiaji iliyoundwa kwa njia sintetiki ili kuongeza mifumo ya kitabia iliyo nadra na mifumo ya rebound.
Tabia ya watumiaji ilifupishwa katika madirisha ya kurudi nyuma ya siku 7, 14 na 28; kigezo cha BodyCluster kiliundwa kwa kutumia umri, urefu na uzito, na RunCluster kwa kutumia tabia ya kukimbia. Modeli za Linear Regression, SVR, Random Forest, BP–MLP na LSTM zililinganishwa.
Katika jedwali kuu la utendaji la chanzo, Random Forest imeripotiwa kuwa na MAE = 0,90 kg na R² = 0,72; LSTM kuwa na MAE = 0,94 kg na R² = 0,71. Katika uainishaji wa rebound, Random Forest imepewa accuracy = 0,991 na F1 = 0,728.
Hata hivyo, kuna tatizo muhimu la uripoti wa namba ndani ya makala. Katika jedwali jingine, kwa tatizo hilo hilo la utabiri wa siku 30, thamani ya residual Random Forest MAE imetolewa kuwa 0,143 kg. Utafiti hauelezi tofauti hii ya takriban mara sita. Kwa hiyo, namba za utendaji hazipaswi kutathminiwa kama usahihi wa uhakika wa bidhaa bila uthibitishaji huru wa nje.
Kwa nini modeli moja ya kutabiri uzito inaweza isitoshe kwa kila mtu?
Mabadiliko ya uzito wa watu hayajibu kwa namna ileile kwa mazoezi yale yale. Uzito wa kuanzia, muundo wa mwili, kiwango cha kawaida cha shughuli, uwiano wa nishati na mambo mengi ya kifiziolojia hutofautiana kati ya watu.
Kwa hiyo, watu wawili wanaokimbia kiasi kilekile wanaweza kuwa na mwelekeo tofauti wa uzito katika siku 30.
Mbinu ya residual-personalization inayopendekezwa na utafiti inajaribu kutenganisha tofauti hii na ishara ya jumla ambayo modeli inalazimika kutabiri.
Msingi binafsi ulikokotolewaje?
Kwa kila mtumiaji, mwelekeo wa mstari wa OLS ulitumiwa kwenye data za uzito kwa muda:
\[ \hat w_{u,t}=\alpha_u t+\beta_u. \]
Hapa \(\alpha_u\) inawakilisha mwelekeo wa wastani wa kila siku wa mabadiliko ya uzito wa mtumiaji.
Mabadiliko ya msingi yanayotarajiwa kwa siku 30:
\[ 30\alpha_u \]
hukokotolewa.
Lengo la residual ambalo modeli inajaribu kujifunza:
\[ \Delta w'_{u,t} = (w_{u,t+30}-w_{u,t}) - 30\alpha_u. \]
Hatua hii inalenga kuifanya modeli izingatie mabadiliko ya muda mfupi ya tabia badala ya mwelekeo wa muda mrefu unaotofautiana kutoka mtu mmoja hadi mwingine.
Tabia ya Kukimbia Iliingizwaje Kwenye Modeli?
Kwa kila mtumiaji, rekodi za awali za kukimbia zilifupishwa katika madirisha ya muda ya kurudi nyuma ya siku 7, 14 na 28.
Vipengele vya msingi:
- jumla ya umbali wa kukimbia,
- jumla ya muda wa kukimbia,
- jumla ya matumizi ya kalori,
- kasi ya wastani,
- mapigo ya moyo ya wastani.
Pia zilitumiwa viashiria vilivyotolewa, kama vile kasi, matumizi ya nishati kwa kila kilomita na uwiano wa uzito/urefu.
Muundo huu wa mizani mingi unalenga kuwakilisha katika modeli moja si tu mikimbio michache ya mwisho, bali pia mpangilio wa mazoezi wa muda mfupi na wa muda wa kati.
BodyCluster na RunCluster ni Nini?
Utafiti uligawanya sifa za watumiaji katika maeneo mawili tofauti ya upangaji wa nguzo.
BodyCluster, ilitolewa kutoka sifa za kianthropometria zilizo thabiti zaidi, kama vile umri, urefu na uzito.
RunCluster, ilitolewa kutoka sifa za kitabia kama vile umbali wa kukimbia, muda, kasi na matumizi ya nishati.
Katika uchanganuzi wa K-Means, nguzo mbili katika maeneo yote mawili ya Body na Run zilitoa thamani ya juu zaidi ya silhouette.
Kwa Body, thamani ya k=2 silhouette ilikuwa 0,3088, na kwa Run 0,3149.
Upangaji wa nguzo wa kihierarkia wa Ward pia uliunga mkono muundo wa nguzo mbili kuu.
Nguzo hizi si utambuzi wa kiafya. Ni makundi ya watumiaji tu ambayo modeli ilipata katika nafasi ya vipengele.
Mabadiliko ya Uzito ya Siku 30 na Hatari ya Rebound Yalifafanuliwaje?
Lengo kuu la regresheni:
\[ \Delta W_{30}=W_{t+30}-W_t \]
lilifafanuliwa.
Matokeo hasi yanawakilisha kupungua kwa uzito, na matokeo chanya yanawakilisha kuongezeka kwa uzito.
Lebo ya rebound-risk katika utafiti:
\[ \Delta W_{30}\ge1,0\text{ kg} \]
ilipewa thamani 1 pale ilipotimia.
Kwa hiyo, “rebound” hapa si ufafanuzi mpana wa kitabibu wa kurejea kwa uzito kwa muda mrefu; ni lebo ya modeli inayomaanisha tu kuongezeka kwa uzito kwa angalau 1 kg ndani ya siku 30.
Kwa Nini Data Sintetiki Zilitumika?
Kwa watumiaji halisi wa vifaa vinavyovaliwa, baadhi ya matukio kama kurejea kwa uzito kwa kiwango kikubwa ndani ya muda mfupi yanaweza kutokea mara chache. Kwa hiyo, waandishi waliunda mifuatano sintetiki ya watumiaji ili kuongeza utofauti wa data na kuimarisha uwakilishi wa darasa la rebound.
Uzito sintetiki:
\[ W_{t+1}=W_t+\beta_u+\epsilon_t \]
ulitolewa kwa modeli ya stokastiki.
Vipengele vya kukimbia vilichukuliwa sampuli kutoka kwenye muundo wa wastani wa vigezo vingi na covariance uliokokotolewa kutoka seti halisi ya data.
Waandishi walitumia majaribio ya KS kwa usambazaji wa vipengele halisi na sintetiki na kuripoti kwamba katika vipengele vingi hawakupata tofauti yenye umuhimu katika kiwango cha α=0,05.
Hata hivyo, data sintetiki kuonyesha usambazaji wa pembeni unaofanana na data halisi hakumaanishi kuwa muundo wote wa muda, kimetaboliki au kisababishi wa tabia halisi ya binadamu umeundwa upya.
Mbinu na Matokeo ya Utafiti
Seti ya data
Takriban watumiaji 3.000 na vipindi 90.000 halali vya kukimbia vilichanganuliwa. Takriban %60 ya watumiaji walitokana na rekodi halisi za vifaa vinavyovaliwa, huku takriban %40 ya data iliyobaki ikiwa mifuatano sintetiki.
Mgawanyo wa mafunzo / uthibitishaji / majaribio
Data iligawanywa katika kiwango cha mtumiaji kuwa %70 mafunzo, %15 uthibitishaji na %15 majaribio.
Vipindi vyote vya mtumiaji mmoja viliwekwa katika sehemu moja tu; kwa njia hii ilijaribiwa kuzuia rekodi za mtu yuleyule kuwepo katika seti za mafunzo na majaribio kwa wakati mmoja.
Madirisha yanayosogea
Madirisha ya vipengele vya kurudi nyuma ya siku 7, 14 na 28 yaliundwa.
Modeli
- Linear Regression,
- Support Vector Regressor,
- Random Forest,
- BP–MLP,
- LSTM.
Jedwali kuu la regresheni la makala
| Modeli | MAE (kg) | R² |
|---|---|---|
| Linear Regression | 1,35 | 0,48 |
| SVR | 1,02 | 0,65 |
| Random Forest | 0,90 | 0,72 |
| BP–MLP | 0,96 | 0,70 |
| LSTM | 0,94 | 0,71 |
Kwa mujibu wa jedwali hili, Random Forest ilitoa matokeo bora zaidi.
Uainishaji
| Jukumu | Modeli | Accuracy | F1 |
|---|---|---|---|
| Kupungua kwa uzito | Logistic Regression | 0,877 | 0,862 |
| Kupungua kwa uzito | Random Forest | 0,893 | 0,874 |
| Rebound | Logistic Regression | 0,986 | 0,703 |
| Rebound | Random Forest | 0,991 | 0,728 |
Kipengele mtambuka cha Body × Run
Uwakilishi wa pamoja wa BodyCluster na RunCluster ulipunguza MAE kwa takriban 0,05 kg na kuongeza R² kwa takriban 0,03.
Usambazaji wa lengo
| Takwimu | ΔW30 |
|---|---|
| N | 27.972 |
| Wastani | 0,0226 kg |
| Mkengeuko wa kawaida | 0,4947 kg |
| Kiwango cha chini | −2,000 kg |
| Mediani | 0,0077 kg |
| Kiwango cha juu | 1,760 kg |
Kutolingana kwa utendaji ndani ya chanzo
Katika Table 9 ya makala, thamani ya raw ΔW30 MAE kwa Linear Regression imeripotiwa kuwa 0,144 kg, na kwa residual Random Forest kuwa 0,143 kg. Hata hivyo, katika Table 10 ya makala hiyohiyo, Linear Regression MAE = 1,35 kg na Random Forest MAE = 0,90 kg.
Chanzo hakielezi jinsi kinavyopatanisha mizani hii miwili. Kwa hiyo, kabla ya kutumia thamani za utendaji kama usahihi wa mwisho wa bidhaa, zinahitaji kuelezwa na waandishi au kuzalishwa upya kwa njia huru.
Dokezo la uripoti wa Cramér's V
Makala inaripoti uhusiano wa wastani wa V = 0,30 kati ya BodyCluster na RunCluster. Hata hivyo, katika jedwali la contingency lililochapishwa na kunormalishwa kwa safu, usambazaji wa Run kwa BodyCluster mbili ni takriban 53/47 na karibu sawa. Kwa kuwa hesabu ghafi hazijatolewa, mgawo huu hauwezi kuthibitishwa kwa kujitegemea na Verianla.
Matokeo yanayoungwa mkono na utafiti
- Kutenganisha mwelekeo msingi binafsi na kutumia utabiri wa residual ni mbinu inayoweza kutumika ya ubinafsishaji.
- Tabia ya kukimbia inaweza kuunganishwa katika madirisha tofauti ya muda ili kuunda vipengele vya utabiri wa muda mfupi.
- Katika jedwali kuu la utendaji la chanzo, modeli za nonlinear na ensemble zinaonyesha utendaji wa juu kuliko linear regression.
- Kipengele mtambuka kinachounganisha taarifa za Body na Run kilionyesha ongezeko dogo lakini thabiti la utendaji.
- Random Forest ilitoa mojawapo ya matokeo yenye nguvu zaidi kati ya modeli zilizojaribiwa katika majedwali ya chanzo.
Matokeo yasiyoungwa mkono na utafiti
- Mfumo huu si zana ya kudhibiti uzito iliyothibitishwa kitabibu.
- Haijathibitishwa kwa uhakika kwamba modeli hufanya kosa la takriban 0,9 kg kwa kila mtumiaji katika ulimwengu halisi.
- %99 rebound accuracy peke yake haimaanishi utabiri wa hatari ya kitabibu unaoaminika kwa %99.
- Utafiti huu haujathibitisha kwamba tabia ya kukimbia ndiyo sababu ya mabadiliko ya uzito yaliyoonekana.
- Data sintetiki si uigaji kamili wa kimetaboliki halisi ya binadamu.
- BodyCluster au RunCluster si utambuzi wa afya wala kategoria ya kitabibu.
- Uthibitishaji wa kitabibu wa prospective, huru na wa muda mrefu haujafanywa.
Maelezo ya Chanzo na Mbinu
Utafiti asilia:Residual-Personalized Ensemble Learning for Short-Term Weight Change and Rebound Risk Prediction in Mobile Health Systems
Waandishi: Khasherdene Baasankhuu; Yanpeng Qu.
Taasisi: Dalian Maritime University.
Chanzo: SSRN preprint.
Tarehe ya kuchapishwa kwa toleo la kurasa 30 katika SSRN: 19 Juni 2026.
SSRN DOI: 10.2139/ssrn.6958925
Hali ya mapitio ya rika: Preprint; PDF ya chanzo imewekewa wazi alama “not peer reviewed”.
Leseni: All rights reserved; no reuse allowed without permission.
Mgongano wa maslahi: Katika rekodi ya SSRN, waandishi hawakuripoti maslahi ya kifedha au binafsi yanayoshindana.
Ufadhili: Rekodi ya SSRN inaripoti kwamba hakuna ufadhili wa nje uliopokelewa.
Muundo wa data: Takriban watumiaji 3.000, takriban vipindi 90.000 vya kukimbia; takriban %60 data halisi za vifaa vinavyovaliwa na %40 synthetic augmentation.
Vikwazo vikuu vya kimetodolojia: Sehemu muhimu ya chanzo cha data ni sintetiki; uthibitishaji huru wa kohorti ya nje haujaonyeshwa; lishe, dawa, ugonjwa, usingizi na viashiria vingine muhimu vya uzito havijawakilishwa kwa kina katika modeli; kuna kutolingana kwa namba ambako hakujaelezwa kati ya majedwali ya utendaji; kuna tatizo linaloonekana la ulinganifu kati ya jedwali la cluster-association na thamani ya Cramér's V iliyoripotiwa; darasa la rebound linatumia kizingiti maalum cha utafiti cha ≥1 kg / 30 siku.
Kanuni ya uwasilishaji ya Verianla: Maudhui haya si tafsiri kamili ya maandishi ya preprint ya chanzo. Muundo wa modeli, muundo wa data, synthetic augmentation, matokeo ya utendaji na kutokuwa na uhakika ndani ya chanzo vimehifadhiwa; utafiti umeelezwa upya ndani ya muundo huru na wa kufundishia wenye mtazamo wa kina. Kwa matumizi ya kitaaluma na tathmini upya ya utendaji wa modeli, preprint asilia na, ikiwezekana, matokeo ya msimbo/data yanapaswa kuchunguzwa pamoja.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *