

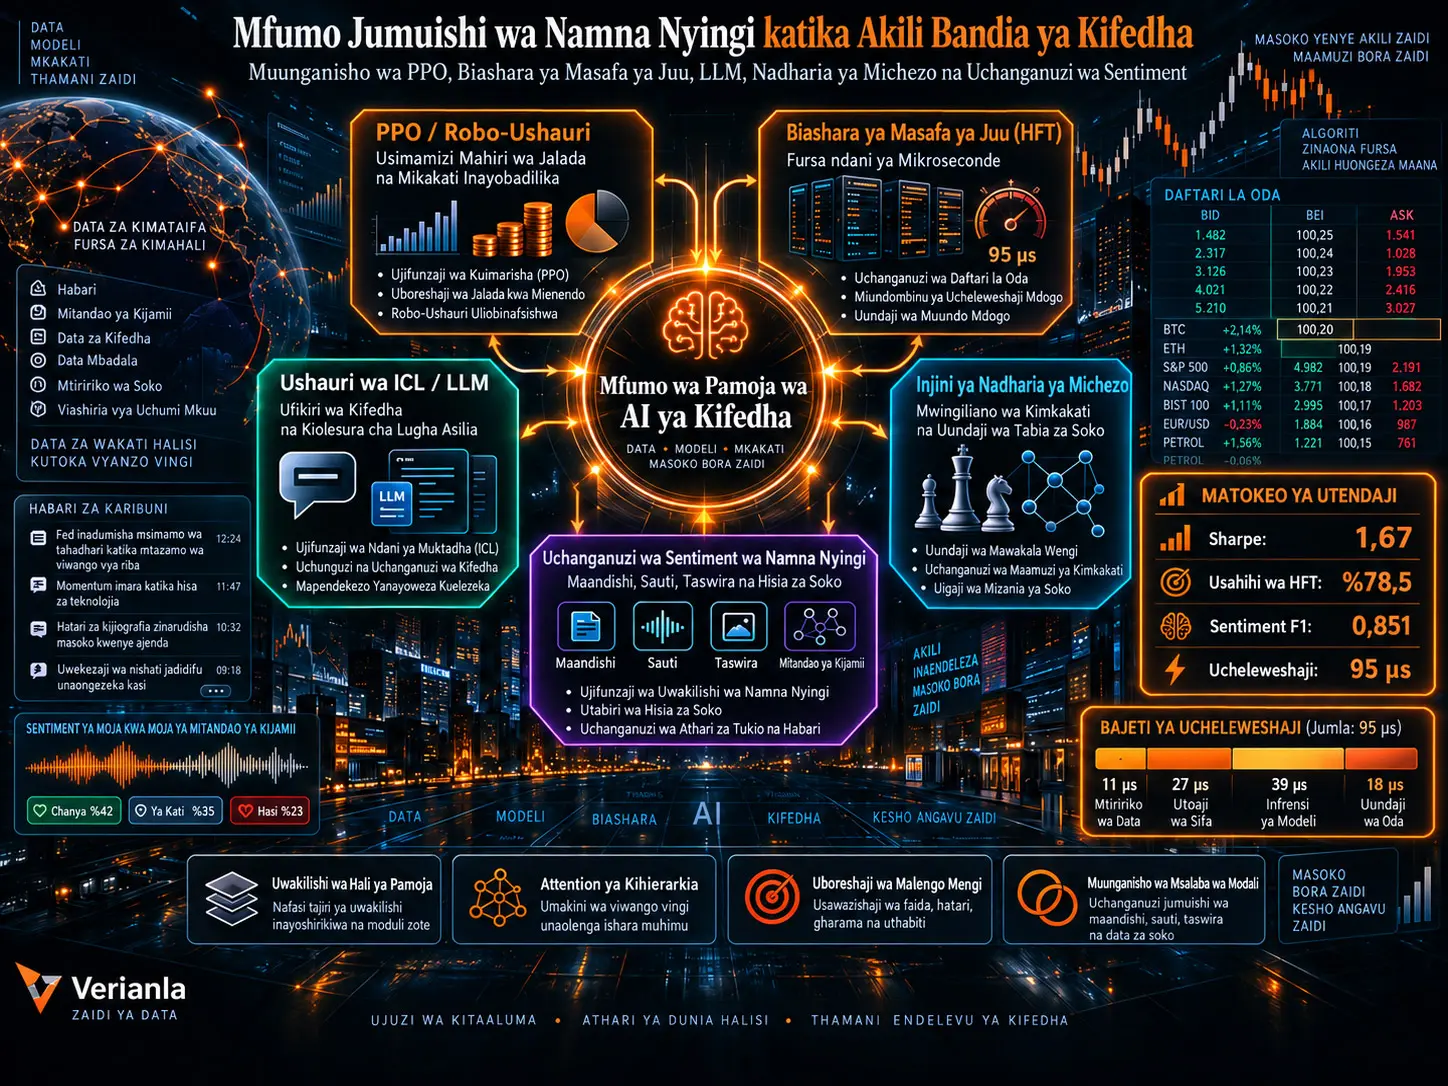
Mifumo ya akili bandia ya kifedha mara nyingi hutengenezwa kwa ajili ya matatizo tofauti: modeli moja huboresha mgao wa jalada, modeli nyingine hutabiri mienendo ya bei ya masafa ya juu, modeli ya lugha hujibu maswali ya uwekezaji, nadharia ya michezo huchunguza tabia za taasisi washindani, na modeli tofauti ya sentiment huchanganua habari au taarifa za kampuni. Utafiti huu unapendekeza usanifu jumuishi unaounganisha vipengele vitano tofauti vya akili bandia ya kifedha chini ya uwakilishi wa hali ya pamoja na uboreshaji wa malengo mengi badala ya muundo huo uliogawanyika.
Vipengele vitano vya msingi vya mfumo ni robo-ushauri unaotegemea Proximal Policy Optimization (PPO), utabiri wa biashara ya masafa ya juu kwa multi-scale Temporal Convolutional Network, ushauri wa uwekezaji unaotegemea retrieval-augmented in-context learning, injini ya nadharia ya michezo inayounda tabia shindani za kifedha, na uchanganuzi wa sentiment wa namna nyingi unaotoa taarifa kutoka maandishi, sauti na grafu za kifedha. Badala ya kuzalisha matokeo huru, vipengele hushirikiana kupitia state representation ya pamoja. Utaratibu wa Hierarchical attention huamua ni kipengele kipi kinapaswa kupewa uzito mkubwa kulingana na hali ya soko; uzito wa kazi unaojifunza na usimamizi wa gradient-conflict huweka mpangilio wa mafunzo ya pamoja.
Katika majaribio ya chanzo, mfumo uliounganishwa unaripoti uwiano wa Sharpe wa 1,67, maximum drawdown ya −%8,9, usahihi wa %78,5 katika utabiri wa mwelekeo wa masafa ya juu na thamani ya 0,851 ya sentiment F1. Jumla ya wire-to-order latency ya njia ya HFT ilipimwa kuwa 95 µs; kati ya hizo 11 µs zilitumika kwa feed parsing, 27 µs kwa feature extraction, 39 µs kwa model inference na 18 µs kwa order construction pamoja na FIX 4.4 serialization.
Hata hivyo, kuna vikwazo fulani katika kutafsiri matokeo. Baadhi ya maboresho ya asilimia ya kiwango cha juu katika makala hayawezi kuzalishwa upya kikamilifu kutoka kwenye majedwali kwa sababu baseline iliyotumika si wazi kabisa. Ulinganisho wa benchmark ya FI-2010 unahitaji ulinganishaji wa kina zaidi kuhusu prediction horizon na mpangilio wa majaribio. Zaidi ya hayo, matumizi matatu yanayodaiwa kufanywa katika taasisi halisi za kifedha yanategemea taasisi zisizotajwa majina, hivyo hayako wazi kwa uthibitishaji huru.
| Kipengele | Mbinu ya kiufundi | Kazi kuu |
|---|---|---|
| Robo-ushauri | PPO | Mgao wa jalada na uboreshaji wa muda mrefu wa hatari/faida |
| Biashara ya masafa ya juu | Multi-Scale TCN + cross-scale attention | Utabiri wa muda mfupi wa bei na mwelekeo |
| Ushauri wa uwekezaji | ICL + RAG + LLM | Kukabiliana haraka na mteja mpya na mazingira mapya ya soko |
| Ushindani wa kimkakati | Nadharia ya michezo inayoweza kutofautishwa | Uchanganuzi wa tabia ya mpinzani na usawa wa Nash |
| Uchanganuzi wa sentiment | Text + Audio + Visual fusion | Uzalishaji wa sentiment ya kifedha na ishara ya hatari |
Kwa nini modeli moja ya AI ya kifedha haionekani kuwa ya kutosha?
Uamuzi wa kifedha hautegemei historia ya bei pekee. Meneja wa jalada anaweza kulazimika kutathmini kwa wakati mmoja mwenendo wa soko, mipaka ya hatari, mtiririko wa habari, tabia za taasisi washindani na malengo binafsi ya mwekezaji.
Katika muundo wa kawaida, matatizo haya hugawanywa katika mifumo tofauti:
- modeli ya jalada huamua uzito wa mali,
- modeli ya HFT hufuatilia muundo-mdogo,
- modeli ya sentiment huchanganua habari,
- LLM huwasiliana na mwekezaji,
- modeli ya kimkakati huchunguza tabia ya mpinzani.
Dhana kuu ya utafiti ni kwamba kufanya mifumo hii iendeshe kwa kujitegemea kabisa kunaweza kusababisha upotevu wa taarifa zenye thamani.
Kwa mfano, habari hasi ya ghafla iliyogunduliwa na modeli ya sentiment inaweza kutoa taarifa si tu kwa mfumo wa jalada wa muda mrefu bali pia kwa modeli ya HFT ya muda mfupi. Injini ya nadharia ya michezo inayotabiri tabia za market maker washindani inaweza pia kubadilisha hatari ya maamuzi ya execution ya muda mfupi.
Mfumo Jumuishi wa Akili Bandia ya Kifedha Unafanyaje Kazi?
Katikati ya mfumo kuna nafasi ya hali ya pamoja ambayo mifumo yote midogo inaweza kutumia:
\[ S= S_{market} \times S_{portfolio} \times S_{sentiment} \times S_{strategic} \times S_{context} \]
Muundo huu unaunganisha madarasa matano tofauti ya taarifa katika nafasi moja ya uamuzi.
Hali ya soko
Hali ya soko:
\[ s_{market}^{t} = [p_t,v_t,b_t,a_t,\nabla p_t,\sigma_t^2,\rho_t] \]
inafafanuliwa kwa namna hii.
Hapa:
- \(p_t\): bei za mali,
- \(v_t\): ujazo wa miamala,
- \(b_t,a_t\): muundo wa bid na ask wa ngazi nyingi,
- \(\nabla p_t\): mabadiliko ya bei,
- \(\sigma_t^2\): volatiliti,
- \(\rho_t\): muundo wa uhusiano.
Hali ya jalada
Nafasi ndogo ya jalada hubeba taarifa za hatari na utendaji kama uzito wa sasa, faida, Value-at-Risk, Conditional VaR, alpha, beta na uwiano wa Sharpe.
Hali ya sentiment
Kipengele cha sentiment huunganisha aina tatu tofauti za data katika embedding ya pamoja:
\[ s_{sentiment}^{t} = f_{fusion} (e_{text}^{t},e_{audio}^{t},e_{visual}^{t}) \]
Maandishi yanaweza kutoka katika habari au ripoti za kifedha, sauti hasa kutoka katika rekodi za earnings call za kampuni, na kipengele cha kuona kutoka katika grafu za kifedha.
Hali ya kimkakati
Game-theory state inajumuisha vitendo vinavyoonekana vya washindani, mikakati ya Nash inayokadiriwa na tabia za market maker/watoa ukwasi.
Hali ya Context
Kwa LLM na in-context learning, uwakilishi wa prompt, kumbukumbu ya mifano na vigezo vya urekebishaji huhifadhiwa ndani ya context state tofauti.
Kwa Nini Hierarchical Attention Inatumika?
Haitegemewi kuwa moduli zote tano ziwe na umuhimu sawa katika kila hali ya soko. Katika volatiliti ya juu sana, vipengele vya HFT na sentiment vinaweza kuwa muhimu zaidi, huku katika kusawazisha upya jalada la muda mrefu moduli ya PPO inaweza kupewa uzito mkubwa zaidi.
Utafiti unaeleza kipaumbele hiki kwa:
\[ \alpha_i^t= \frac{ \exp(f_{priority}(s_i^t,M_t)) }{ \sum_{j=1}^{5} \exp(f_{priority}(s_j^t,M_t)) } \]
uzito wa attention unaohesabiwa kwa namna hii.
Kwa hiyo, kwa kila moduli:
\[ 0<\alpha_i^t<1 \]
na jumla ya uzito wote:
\[ \sum_{i=1}^{5}\alpha_i^t=1 \]
hutimia.
Uhamishaji wa taarifa haufanywi kwa uzito wa attention pekee. Utaratibu wa gating unaotegemea GRU pia hujifunza ni taarifa gani moduli moja inapaswa kukubali kutoka kwa moduli nyingine.
Malengo Matano Tofauti Yanaboreshwaje kwa Wakati Mmoja?
Lengo la pamoja:
\[ J(\pi) = \sum_{i=1}^{5} \lambda_iJ_i(\pi) + \gamma R_{synergy}(\pi) \]
linafafanuliwa kwa namna hiyo.
\(J_i\) inawakilisha lengo la kila kipengele, \(\lambda_i\) ni uzito wa kazi unaojifunza, na \(R_{synergy}\) ni termini ya ushirikiano inayolenga kupunguza hali ambapo modeli ndogo zinazuiana.
Chanzo hujifunza uzito wa kazi kwa kutegemea kutokuwa na uhakika:
\[ \lambda_i= \frac{1}{2\sigma_i^2} \]
Kwa njia hii, athari ya kipengele chenye kelele zaidi kwenye gradient ya pamoja inaweza kupunguzwa kiotomatiki.
Gradient conflict inashughulikiwaje?
Mielekeo ya gradient ya kazi tofauti inaweza kupingana. Kwa mfano, mabadiliko ya parameter yanaweza kuboresha utabiri wa HFT huku yakiharibu modeli ya sentiment.
Chanzo hufuatilia cosine similarity ya jozi za gradient. Conflict hasi inapojitokeza, kwa mbinu ya PCGrad kipengele kinachokinzana cha gradient kinaweza kuondolewa kwa projection.
Lengo la utaratibu huu ni kupunguza hali ambayo mfumo mdogo mmoja huharibu mafunzo ya mfumo mwingine katika ujifunzaji wa kazi nyingi.
Moduli ya Biashara ya Masafa ya Juu Inafanyaje Kazi?
Kipengele cha HFT hutumia Multi-Scale Temporal Convolutional Network.
Chanzo kinafafanua mizani mitano ya muda katika Appendix B:
- 1 ms,
- 10 ms,
- 100 ms,
- 1 s,
- 10 s.
Kila mizani huchakatwa na temporal convolution branch tofauti. Kisha cross-scale attention huruhusu ushirikishanaji wa taarifa kati ya maazimio tofauti ya muda.
Lengo la muundo huu ni kutathmini ndani ya utabiri mmoja mabadiliko ya order-flow ya muda mfupi sana pamoja na mifumo ya polepole zaidi ya soko inayoenea kwa sekunde kadhaa.
HFT objective
Lengo la kipengele cha masafa ya juu si kupunguza kosa la utabiri pekee:
\[ J_{HFT} = - E_t \left[ \|p_{t+\delta}-\hat{p}_{t+\delta}\|^2 + \alpha TC(a_t) \right] \]
Termini ya pili inawakilisha transaction cost. Hivyo usahihi wa kinadharia wa utabiri wa bei na gharama ya kiuchumi ya muamala vinaweza kutathminiwa ndani ya objective moja.
Ucheleweshaji wa Uamuzi wa Mikrosekunde 95 Unajumuisha Nini?
95 µs iliyoripotiwa katika chanzo si muda wa utabiri wa mtandao wa neva pekee. Wire-to-order latency ya jumla ina sehemu nne zifuatazo:
| Hatua | Ucheleweshaji |
|---|---|
| Feed parsing | 11 µs |
| Feature extraction | 27 µs |
| Model inference | 39 µs |
| Order construction + FIX 4.4 | 18 µs |
| Jumla | 95 µs |
Jukwaa la majaribio linatumia Intel Xeon Gold 6338, NVIDIA A100 40 GB, DPDK kernel-bypass networking na ONNX Runtime + TensorRT.
Kipimo hiki si round-trip latency kinachojumuisha kukubaliwa au fill ya oda na exchange; ni njia ya uchakataji wa ndani kutoka ingizo la mfumo hadi utoaji wa oda.
Kwa nini LLM haipunguzi kasi ya njia ya HFT?
Muda mmoja wa inference wa kipengele cha ICL/LLM ni takriban 2,4 ms na ni mrefu sana kuliko bajeti ya 95 µs ya HFT.
Kwa hiyo LLM haisubiri uamuzi wa HFT kwa synchronous. Advisory embedding ya hivi karibuni huhifadhiwa katika lock-free ring buffer na modeli ya HFT hutumia embedding mpya zaidi iliyopo.
Kwa hivyo:
uchanganuzi wa semantiki wa polepole → sasisho la asinkroni → njia ya HFT ya haraka
ndio usanifu ulioundwa.
Mbinu na Matokeo ya Utafiti
Ulimwengu wa data
| Moduli | Data | Kipindi / Masafa | Mgawanyo |
|---|---|---|---|
| PPO | S&P 500, FTSE 100, Nikkei 225 | 2010–2024 / kila siku | 60/20/20 |
| HFT | BTC/USDT, ETH/USDT, NASDAQ top-100 | 2022–2024 / tick | 70/15/15 |
| Sentiment | Earnings calls, FNSPID, X/Twitter | 2015–2024 / event | 70/15/15 |
| ICL | Logi za ushauri wa uwekezaji zisizotambulisha taasisi | 2019–2024 / session | Leave-one-quarter-out |
| Game theory | FDIC call reports | 2014–2024 / quarterly | Cross-validation |
Katika migawanyo ya HFT, embargo ya saa 24 ilitumika kati ya vipindi vya train na test, huku embargo ya trading-day tano ikitumika katika kazi za jalada na sentiment.
Chanzo pia kinasema kuwa matokeo yaliripotiwa kama wastani wa random seed tano huru, marudio 10.000 ya bootstrap yalitumika kuhesabu %95 confidence interval, na paired t-test ilitumika dhidi ya single-component baseline yenye nguvu zaidi.
Utendaji wa jumla
| Kipimo | Matokeo ya chanzo |
|---|---|
| Sharpe Ratio | 1,67 |
| Maximum Drawdown | −%8,9 |
| HFT Directional Accuracy | %78,5 |
| Sentiment F1 | 0,851 |
| Ukaribiaji wa Nash | 53 iteresheni |
| ICL Adaptation Score | 0,74 |
Kwa mfumo uliounganishwa, %95 bootstrap confidence interval zilitolewa kama 1,61–1,73 kwa Sharpe, takriban −%9,6 hadi −%8,1 kwa maximum drawdown, %77,4–%79,6 kwa HFT accuracy na kwa sentiment F1, 0,842–0,860.
Ulinganisho wa HFT
| Modeli | RMSE | MAE | Usahihi wa Mwelekeo | Latency | Profit Factor |
|---|---|---|---|---|---|
| ARIMA | 0,0834 | 0,0621 | %52,3 | 12 µs | 1,08 |
| LSTM | 0,0612 | 0,0453 | %58,7 | 47 µs | 1,21 |
| Transformer | 0,0543 | 0,0398 | %63,2 | 83 µs | 1,34 |
| DeepLOB | 0,0487 | 0,0352 | %66,8 | 91 µs | 1,42 |
| HFT Module | 0,0421 | 0,0304 | %71,4 | 78 µs | 1,53 |
| Framework Iliyounganishwa | 0,0289 | 0,0214 | %78,5 | 95 µs | 1,87 |
Kutoka HFT Module hadi mfumo uliounganishwa, RMSE:
\[ 0.0421\rightarrow0.0289 \]
hushuka hadi kiwango hiki. Hii ni punguzo la takriban %31,35 na inalingana na takriban %31,2 HFT prediction-error improvement iliyoripotiwa katika abstract.
Gharama za miamala
Backtest hutumia vipengele vitatu vya gharama:
- venue fee ya kudumu ya 10 bps kwa equities,
- venue fee ya kudumu ya 4 bps kwa crypto,
- bid-ask half-spread kwa market order,
- pamoja na square-root price-impact model.
Price-impact coefficient inapoongezwa mara mbili, Sharpe ya jumla huripotiwa kushuka kutoka 1,67 hadi 1,51 na HFT profit factor kutoka 1,87 hadi 1,62.
Matokeo ya sentiment ya namna nyingi
| Mbinu | Accuracy | F1 | AUC |
|---|---|---|---|
| Text Only | %71,3 | 0,698 | 0,782 |
| Text + Audio | %76,8 | 0,753 | 0,831 |
| All — Concatenation | %79,4 | 0,778 | 0,856 |
| All — Attention | %82,7 | 0,812 | 0,883 |
| Fusion Inayopendekezwa | %86,9 | 0,851 | 0,912 |
Matokeo yanaonyesha kuwa matumizi ya pamoja ya maandishi, sauti na taarifa za kuona yalitoa utendaji wa juu zaidi katika majaribio ya chanzo kuliko modeli za modality moja.
Matokeo ya ablation
Inaripotiwa kuwa kuondoa vipengele kulipunguza utendaji katika vipimo vingi.
| Muundo | Sharpe | HFT Accuracy | Sentiment F1 | Latency |
|---|---|---|---|---|
| Framework Kamili | 1,67 | %78,5 | 0,851 | 95 µs |
| Bila Sentiment | 1,53 | %71,9 | — | 71 µs |
| Bila Game Theory | 1,58 | %75,3 | 0,834 | 78 µs |
| Bila Attention | 1,42 | %72,4 | 0,812 | 103 µs |
| Bila Synergy term | 1,51 | %74,6 | 0,827 | 91 µs |
Hasa kuondoa safu ya attention kunaharibu si tu usahihi bali pia latency. Matokeo haya yanaendana na dai la chanzo kwamba utaratibu wa attention hutumiwa si kwa ubora wa utabiri pekee bali pia kuelekeza rasilimali za ukokotoaji.
Matokeo ya benchmark ya FI-2010 yatafsiriwaje?
Chanzo kinaripoti katika benchmark ya FI-2010 %80,7 directional accuracy kwa moduli yake ya HFT na kulinganisha na thamani ya %78,0 iliyochapishwa ya DeepLOB.
Hata hivyo, matokeo ya FI-2010 yanategemea sana prediction horizon na evaluation setup inayotumika. Katika fasihi ya DeepLOB, kuna matokeo ya accuracy kuanzia takriban %79 hadi zaidi ya %84 katika setup tofauti. Kwa hiyo, kulinganisha ubora kwa thamani moja ya asilimia bila kutumia horizon na masharti sawa ya preprocessing kwa modeli zote mbili hakutoshi.
Kesi tatu za ulimwengu halisi
Chanzo:
- uboreshaji wa %27 katika utendaji uliorekebishwa kwa hatari baada ya matumizi ya miezi sita katika hedge fund ya ukubwa wa kati,
- ongezeko la %34 katika kuridhika kwa wateja na %22 katika assets under management katika retail brokerage,
- kupungua kwa %19 kwa adverse-selection cost katika benki ya uwekezaji
kinaripoti.
Hata hivyo, kwa kuwa majina ya taasisi na data za kina za case hazijatolewa, matokeo haya si ushahidi wa aina ya jaribio la kitabibu au linalodhibitiwa unaoweza kuthibitishwa kutoka nje. Yanapaswa kutathminiwa kama matokeo ya matumizi halisi yaliyoripotiwa na chanzo.
Matokeo ya ukaribiaji wa kinadharia yana nguvu kiasi gani?
Makala yanawasilisha kiwango cha ukaribiaji cha \(O(1/\sqrt{T})\) kwa uboreshaji uliounganishwa. Hata hivyo, kwa mpaka wa juu wa daraja la pili unaotumika katika descent lemma, kwa kawaida si Lipschitz continuity ya kazi pekee inayohitajika bali pia dhana ya gradient smoothness.
Zaidi ya hayo, uandishi wa learning-rate katika Algorithm 1 kuu na Appendix A haulingani kikamilifu.
Kwa hiyo, matokeo ya ukaribiaji ni sehemu muhimu ya mfumo wa kinadharia wa utafiti, lakini ingekuwa manufaa kufafanua kwa usahihi zaidi dhana na notation za uthibitisho.
Nguvu za utafiti
- Kuunganisha taaluma tano tofauti za AI ya kifedha katika usanifu mmoja.
- Kuunda tick-level HFT, jalada la muda mrefu, LLM na multimodal sentiment ndani ya state space moja.
- Kutumia mgawanyo wa data wa kronolojia na embargo.
- Kuripoti random seed tano, bootstrap confidence interval na paired significance test.
- Kujumuisha transaction cost na market impact katika backtest.
- Kuripoti ucheleweshaji wa 95 µs kwa kuugawa katika vipengele vidogo.
- Kutoa majaribio ya ablation, sensitivity na cross-market transfer.
- Kutenganisha njia ya LLM na njia ya HFT kwa asinkroni.
Vikwazo vikuu
- Baadhi ya asilimia za maboresho katika abstract haziwezi kuzalishwa moja kwa moja kutoka majedwali makuu.
- Tofauti kati ya HFT Only katika Table 3 yenye %64,8 na HFT Module katika Table 5 yenye %71,4 haijaelezwa vya kutosha.
- Ulinganisho wa benchmark ya FI-2010 / DeepLOB hauonyeshi wazi ulinganifu wa prediction-horizon.
- Dhana za smoothness katika uthibitisho wa ukaribiaji zinapaswa kuwasilishwa kwa usahihi zaidi.
- Notation ya learning-rate hailingani kikamilifu kati ya algoritimu kuu na appendix.
- Licha ya dai la open-source implementation, chanzo hakitoi URL ya moja kwa moja ya code repository.
- Seti ya data ya proprietary ICL inapunguza uwezo wa kurudia matokeo kwa kujitegemea.
- Taasisi za real-world case-study zimehifadhiwa bila majina.
- Matokeo ya 95 µs yanategemea maunzi ya kiwango cha taasisi na uboreshaji maalum wa programu.
- Faida za kifedha na mafanikio ya prediction si lazima yaendelee katika kiwango kilekile katika masoko tofauti.
Maelezo ya Chanzo na Mbinu
Kichwa asili: A Unified Multi-Modal Framework for Intelligent Financial Systems: Integrating Reinforcement Learning, High-Frequency Trading, and Game-Theoretic Approaches with Cross-Modal Sentiment Analysis
Waandishi: Yuwei Zhang; Fanrong Liu; Chang-An Xu; Mingni Luo.
Jarida: Mathematics.
Juzuu / toleo: 14 / 13.
Nambari ya makala: 2437.
Tarehe ya kuchapishwa: 7 Julai 2026.
Received: 26 Mei 2026.
Revised: 25 Juni 2026.
Accepted: 30 Juni 2026.
DOI: 10.3390/math14132437.
Leseni: Creative Commons Attribution 4.0 International — CC BY 4.0.
Taasisi: City University of Hong Kong; Henan University; South China Agricultural University; Northeastern University.
Usanifu mkuu: PPO robo-advisory + multi-scale HFT TCN + ICL/RAG/LLM + differentiable game-theory engine + text/audio/visual sentiment fusion.
Usanifu wa HFT: Multi-Scale Temporal Convolutional Network katika mizani ya 1 ms, 10 ms, 100 ms, 1 s na 10 s; cross-scale attention; 1000 tick sequence.
Ulimwengu wa data wa HFT: BTC/USDT, ETH/USDT na NASDAQ top-100; data ya tick-level; 2022–2024; split ya kronolojia ya %70/%15/%15.
HFT leakage control: Embargo ya saa 24 kati ya train/test fold.
Modeli ya gharama za miamala: venue fee ya 10 bps kwa Equities, 4 bps kwa crypto; market order half-spread na square-root market-impact term.
Matokeo ya HFT yaliyounganishwa: RMSE 0,0289; MAE 0,0214; directional accuracy %78,5; profit factor 1,87; wire-to-order latency 95 µs.
Jukwaa la latency: Intel Xeon Gold 6338 + NVIDIA A100 40 GB; DPDK; ONNX Runtime; TensorRT.
Sentiment encoder: BERT-base, wav2vec2-base na ViT-B/16.
Ufadhili: Chanzo kinasema kuwa hakikupokea ufadhili wa nje.
Upatikanaji wa data: Inaelezwa kuwa data ghafi itatolewa na waandishi kwa ombi; sehemu ya seti ya data ya ICL/advisory ni proprietary.
Mgongano wa maslahi: Waandishi wametangaza kuwa hakuna mgongano wa maslahi.
Onyo la utendaji ndani ya chanzo: Ingawa %31,2 HFT prediction-error reduction katika abstract inaweza kuthibitishwa kwa takriban kupitia Table 5, msingi wa ulinganisho wa baadhi ya asilimia nyingine za maboresho ya jumla hauwezi kuhesabiwa upya kwa uwazi sawa kutoka majedwali makuu.
Onyo la benchmark: Matokeo ya FI-2010 hayapaswi kulinganishwa na DeepLOB kwa thamani moja bila kutaja prediction horizon na preprocessing setup.
Onyo la kinadharia: Kwa hatua ya descent inayotumika katika uthibitisho wa ukaribiaji wa \(O(1/\sqrt{T})\), huenda ikahitajika dhana ya smoothness yenye nguvu zaidi kuliko iliyoelezwa; notation ya learning-rate pia hailingani kikamilifu kati ya sehemu.
Onyo la upatikanaji wa msimbo: Makala yanasema open-source implementation imechapishwa; hata hivyo, PDF ya chanzo haitoi kiungo cha moja kwa moja cha repository.
Ujumla: Matokeo yalipatikana chini ya seti maalum za data, modeli ya gharama za miamala na maunzi yenye utendaji wa juu. Hakuna dhamana ya utendaji huo huo katika soko, venue au mazingira mengine ya latency.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *