


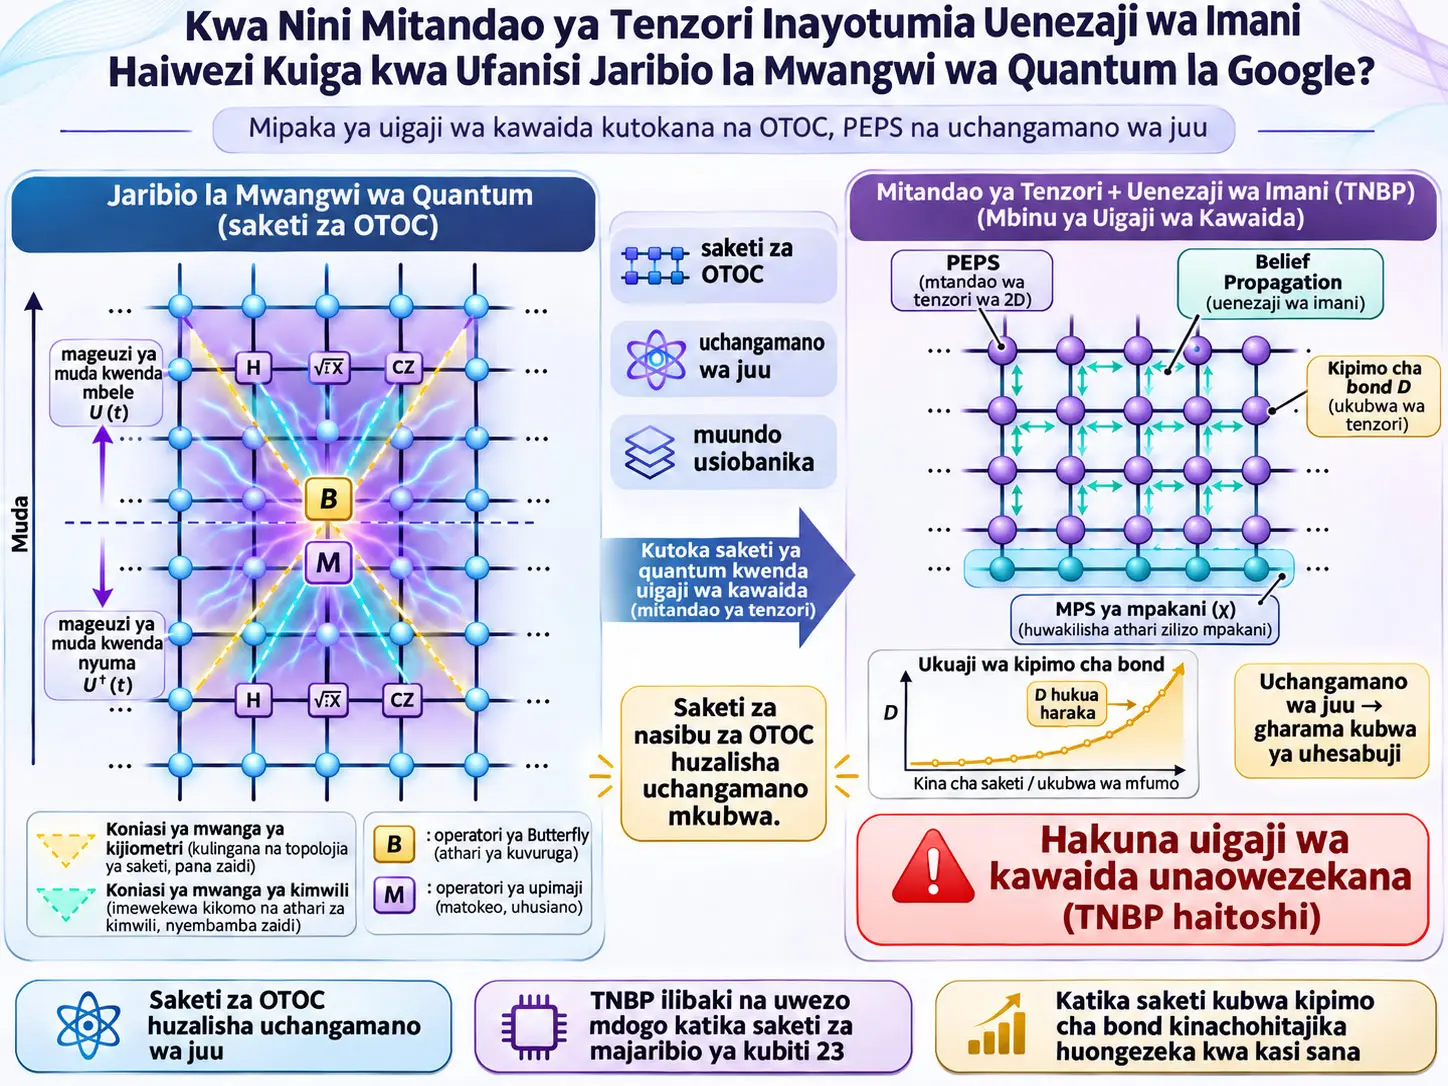
Mitandao ya tenzori inayotumia uenezaji wa imani (Tensor Networks with Belief Propagation, TNBP), ni mbinu ya kawaida ya uigaji wa mtandao wa tenzori ambayo hubadilisha kwa makadirio hali ya saketi ya quantum katika umbo la projected entangled pair state (PEPS), huweka kikomo cha bond dimension ya PEPS kwa truncation inayotegemea belief propagation, kisha hutoa observable husika kwa boundary matrix product state (bMPS) contraction. Utafiti huu unachunguza kama TNBP inaweza kuzalisha tena saketi za out-of-time-order correlator (OTOC) katika jaribio la quantum echoes lililofanywa kwenye prosesa ya Willow ya Google Quantum AI kwa gharama ya kompyuta ya kawaida inayowezekana kutekelezwa. Matokeo yanaonyesha kwamba, hasa katika saketi za random-circuit OTOC zinazozalisha entanglement kubwa, hali haiwezi kubanwa kwa kiwango kikubwa na bond dimensions zinazohitajika za PEPS/bMPS hukua kwa kasi.
Utafiti huu si jaribio jipya la vifaa vya quantum. Unaiga kwa TNBP kwenye kompyuta ya kawaida baadhi ya saketi zilizotumika katika jaribio la quantum echoes kwenye Willow pamoja na saketi mpya ndogo zilizotengenezwa kwa muundo huohuo; pia unaendeleza hoja za kinadharia za scaling kwa mifumo mikubwa. Watafiti kwanza wanathibitisha kwa uigaji wa nambari wa moja kwa moja scaling ya eksponenti ya bond dimension iliyotabiriwa katika mifumo yenye dimensheni moja. Katika mifumo yenye dimensheni mbili hawadai kuwa wamepima moja kwa moja scaling ya eksponenti ya asymptotic kutoka kwenye sampuli ndogo kama N=8–28; badala yake wanapata ushahidi mkubwa wa incompressibility katika saketi halisi za majaribio za qubit 23 na saketi mpya za qubit 8–28, kisha wanazitathmini pamoja na scaling ya kinadharia ya mifumo mikubwa.
Katika saketi mbili za OTOC za qubit 23 zilizochukuliwa kutoka kwenye jaribio halisi, TNBP hutoa uwiano wa signal-to-noise ratio (SNR) wa chini kuliko jaribio la Willow na pia kuliko mbinu ya Tensor Network Monte Carlo (TNMC). Katika saketi yenye gate 108 za qubit mbili, TNBP hufikia takriban 2,94 SNR, huku TNMC ikitoa 7,61 na jaribio 7,21 SNR. Katika saketi ya kina zaidi yenye gate 164 za qubit mbili, TNBP hushuka hadi takriban 1,31, huku TNMC ikitoa 6,73 na jaribio 5,26 SNR. Ulinganisho huu unaonyesha kuwa katika sampuli zilezile za OTOC, mbinu ya kawaida ya TNBP haiwezi kufikia usahihi wa jaribio.
Katika jaribio muhimu la udhibiti la utafiti, gate za qubit mbili zinazofanana na iSWAP na zinazozalisha entanglement kubwa hubadilishwa na gate za iSWAP zinazoweza kurekebishwa ambazo huzalisha entanglement polepole zaidi. Wakati kasi ya kuzalisha entanglement inapopunguzwa vya kutosha, TNBP inaweza kufanya kazi kwa fidelity ya juu na bond dimension ndogo. Kwa hiyo, chanzo kinatoa ushahidi huru kwamba kushindwa hakutokani tu na kasoro ya jumla ya implementation ya TNBP, bali na muundo wa entanglement kubwa na incompressibility wa saketi za quantum echoes.
Gharama zilizotolewa kwa majaribio makubwa zaidi si matumizi yaliyopimwa kutoka kwa uigaji mkubwa wa TNBP ulioendeshwa moja kwa moja. Waandishi hutengeneza makadirio ya gharama kwa kutumia matokeo ya nambari ya mifumo midogo na ya kati, jiometri ya saketi, na idadi ya gate za ku-entangle zinazotumika kwenye kila bond ya PEPS. Kwa lengo la usahihi unaolinganishwa na jaribio, wanakadiria kuwa OTOC ya kawaida ya qubit 95 ingehitaji takriban \(D\approx3.2\times10^3\), na second-order OTOC ya qubit 65 ingehitaji takriban \(D\approx8.4\times10^5\) kama PEPS bond dimension. Katika hali ya qubit 65, hitaji lililokokotolewa la kumbukumbu kwa tenzori moja tu ya PEPS liko katika kiwango cha \(7.9\times10^{24}\) byte. Hili si kipimo cha kumbukumbu kilichofanywa kwa uendeshaji halisi, bali ni makadirio ya feasibility chini ya dhana za chanzo.
Dai kuu la makala ni kwamba, katika mbinu ya Schrödinger-picture PEPS-evolution iliyochunguzwa, TNBP haitoi mbadala wa kawaida unaowezekana kutekelezwa kwa saketi ngumu zaidi za jaribio la Google quantum echoes. Hili halimaanishi kwamba “hakuna algorithm ya kawaida ya baadaye itakayoweza kuiga majaribio haya kamwe.” Waandishi wanajadili hasa kwamba mbinu za Heisenberg-picture zinaweza kuwa na uwezekano tofauti wa scaling, na wanaacha kama kazi ya baadaye mbinu ya hali ya juu zaidi ambapo operator mbili hubadilishwa pamoja katika picha ya Heisenberg.
Swali kuu linaloulizwa na utafiti
Utafiti wa quantum echoes wa Google Quantum AI ulikuwa umeripoti kwamba kupima thamani za out-of-time-order correlator za daraja la juu kwenye prosesa ya quantum ya Willow ni kwa kasi zaidi sana kuliko baadhi ya mbinu za kawaida za kompyuta zinazolenga usahihi unaofanana. Hata hivyo, katika ulimwengu wa algorithm za kawaida, kushindwa kwa mbinu moja hakutoshi kuhitimisha kwamba “mbinu zote za kawaida zimeshindwa.” TNBP hasa ni familia ya mbinu ambayo hapo awali imeweza kuiga kwa njia ya kawaida madai mengine ya majaribio makubwa ya quantum. Kwa hiyo swali kuu la utafiti mpya ni hili: Je, TNBP inaweza kutoa uigaji wenye ufanisi wa kutosha kuondoa dai kwamba jaribio la quantum echoes ni gumu kwa kompyuta za kawaida?
Jibu la utafiti ni hapana kwa mbinu ya TNBP/Schrödinger-picture iliyochunguzwa. Sababu kuu si jiometri yenye dimensheni mbili pekee, bali ni kwamba entanglement kubwa ya volume-law inayozalishwa na saketi za random OTOC hufanya hali za PEPS zisiweze kubanwa kwa kiwango kikubwa.
Out-of-Time-Order Correlator (OTOC) ni nini?
Out-of-time-order correlator (OTOC) ni kazi ya uhusiano ya mifumo ya miili mingi inayotumika kupima jinsi perturbation ya quantum ya mahali fulani inavyoenea chini ya evolution ya muda hadi kwenye degrees of freedom nyingine za mfumo na jinsi taarifa ya quantum inavyofanyiwa scrambling kwa kasi; katika utafiti huu thamani ya OTOC hubadilishwa kuwa expectation value ya operator ya kipimo ya mahali fulani \(M\) katika hali ya quantum iliyoevolve kwa muda, na hivyo kuwa observable moja ya nambari inayoweza kulinganishwa katika jaribio la quantum na uigaji wa kawaida.
Ufafanuzi wa kawaida wa OTOC
Fomula inakokotoa nini? Inakokotoa thamani ya OTOC inayobainisha kiwango ambacho perturbation ya mahali fulani \(B\) imeanza kuingiliana na operator ya kipimo \(M\) kutokana na evolution ya muda.
\(U(t)\): ni operator ya uniti ya time-evolution ya saketi ya quantum.
\(B\): ni operator ya perturbation ya mahali fulani ambayo chanzo huiita “butterfly operator”. Katika saketi kuu za utafiti, Pauli \(X\) ya qubit moja hutumika.
\(M\): ni measurement operator; katika utafiti Pauli \(Z\) ya qubit moja hutumika.
\(B(t)\): ni umbo la \(B\) lililoevolve kwa muda katika picha ya Heisenberg.
\(N\): ni idadi ya qubit amilifu zilizobaki katika saketi. Kwa kuwa baada ya gate-pruning qubit ambazo haziguswi na gate yoyote husika huondolewa kwenye mfumo, \(N\) iliyoripotiwa si lazima iwe idadi ya qubit zote katika grid ya awali ya kimwili.
Umbo la kipimo cha mahali fulani chini ya hali ya mwanzo ya product
Utafiti hutumia, badala ya maximally mixed state, kwa kufuata konvensheni ya jaribio la quantum echoes,
hali ya mwanzo. Wakati \(M=Z\) na \(B\) ni Hermitian:
na
Mabadiliko haya ni muhimu sana. Correlator inayoonekana tata ya time-evolution ya kwenda mbele na kurudi nyuma hupunguzwa katika uigaji wa vitendo kuwa tatizo la “andaa hali \(|\phi\rangle\) kisha pima \(M\) juu yake.” TNBP hutumia mantiki hii hasa: kwanza huunda \(|\phi\rangle\) kama PEPS ya makadirio, kisha hutoa expectation value ya \(M\).
Kwa nini jina “Second-order OTOC” linaweza kuchanganya?
Katika chanzo, OTOC ya kawaida huonyeshwa kihisabati kwa \(C^{(2)}\). Kinyume chake, observable ya daraja la juu zaidi ambayo Google huiita “second-order OTOC” au \(\mathrm{OTOC}^{(2)}\) hubeba kihisabati alama \(C^{(4)}\):
Kwa hiyo katika makala hii:
- \(C^{(2)}\) = OTOC ya kawaida/first-order,
- \(C^{(4)}\) = second-order OTOC, yaani \(\mathrm{OTOC}^{(2)}\).
Tofauti hii ya alama lazima ihifadhiwe; haipaswi kusomwa kuwa \(C^{(4)}\) ni “jaribio tofauti la daraja la nne” au kwamba \(\mathrm{OTOC}^{(2)}\) ni kiasi kilekile na \(C^{(2)}\).
Athari ya kipepeo na koni ya mwanga
Kama \(B\) ingekuwa identity operator, evolution ya mbele \(U\) na evolution ya nyuma \(U^\dagger\) zingefutana, na kwa \(M=Z\) OTOC ingekuwa 1 katika hali ya mwanzo. Perturbation halisi ya \(B\) inapotumika, hutokea “geometric lightcone” inayoundwa na gate za saketi ambazo athari ya \(B\) inaweza kuzifikia.
Chanzo hutofautisha koni mbili za mwanga:
- Koni ya mwanga ya kijiometri: huonyesha, kwa kuzingatia tu muunganisho wa saketi na mahali gate zilipo, ni maeneo gani yanaweza kuathiriwa kisababishi.
- Koni ya mwanga ya kimwili: huonyesha kasi halisi ambayo taarifa ya quantum huenea chini ya random dynamics fulani na kwa kawaida huwa nyembamba kuliko koni ya mwanga ya kijiometri.
Ikiwa \(M\) iko kabisa nje ya koni ya mwanga ya kijiometri ya \(B\), OTOC ni 1 hasa. Ikiwa iko mbali sana nje ya koni ya mwanga ya kimwili lakini ndani ya koni ya kijiometri, OTOC ni takriban 1. Ndani kabisa ya koni ya mwanga ya kimwili, OTOC ya wastani hukaribia takriban 0. Mabadiliko makubwa zaidi ya circuit-to-circuit huonekana karibu na ukingo wa koni ya mwanga ya kimwili; kwa hiyo mahali pa jamaa pa \(M\) na \(B\) ni muhimu sana katika jaribio na katika uchanganuzi wa chanzo.
Kwa nini SNR inatumika?
Kuangalia kosa la OTOC la saketi moja ya random pekee hakutoshi; saketi iliyochaguliwa inaweza kwa bahati kuwa rahisi sana au ngumu sana kwa uigaji wa kawaida. Kwa hiyo utafiti hutumia SNR iliyosanifishwa ambayo hupima jinsi mabadiliko ya instance-to-instance yanavyozalishwa tena kwa usahihi katika ensemble ya OTOC yenye random circuit instance nyingi.
Hapa mstari wa juu unaonyesha wastani wa ensemble, na \(\sigma\) inaonyesha mkengeuko wa kawaida wa ensemble.
Fomula inakokotoa nini? Hupima jinsi matokeo ya makadirio yanavyozalisha tena kwa usahihi muundo wa mabadiliko uliosanifishwa katika exact OTOC instance.
SNR ya juu: mbinu ya makadirio hufuata vizuri zaidi muundo wa instance-by-instance wa exact OTOC.
Kosa sifuri: kosa la RMS kwenye denominator huenda sifuri na SNR iliyodhaniwa bora hukaribia infinity.
Matokeo yasiyohusiana kabisa: katika kikomo cha instance zisizo na mwisho SNR hukaribia takriban \(1/\sqrt2\).
Katika uchanganuzi wa utafiti unaotumia instance 50, msingi wa signal isiyohusiana ni takriban 0,725. Thamani husika za SNR katika jaribio la quantum echoes ziko takriban katika kiwango cha 3–5. Kwa hiyo tafsiri rahisi kama “SNR ni kubwa kuliko 1, basi ni nzuri” si sahihi; kigezo cha mafanikio ni kuweza kulinganisha kiwango cha SNR kilichofikiwa na jaribio ndani ya gharama ya kompyuta ya kawaida.
Saketi za random OTOC zinaundwaje?
Saketi ya time-evolution \(U\) ina tabaka za brickwall zinazobadilishana za aina mbili za gate ili kuzalisha entanglement kubwa.
Gate za fSim za qubit mbili zinaweza kugawanywa katika chanzo kuwa iSWAP na sehemu ya CPHASE yenye conditional phase ya takriban radian 0,35. Sababu ya iSWAP iliyotolewa na chanzo:
Mizunguko ya random ya qubit moja huwa
katika umbo hilo na
vigezo hivyo hutumika.
Katika uchanganuzi mkuu \(M=Z\), \(B=X\) hutumika. Ingawa baadhi ya saketi katika data set ya asili ya quantum echoes hutumia tensor product ya \(X\) kwenye site nyingi, utafiti unaeleza wazi kuwa haukuiga ensemble hizo.
Kwa nini gate pruning ni muhimu kisayansi?
Kwa kuwa saketi za mbele \(U\) na za nyuma \(U^\dagger\) zipo pamoja, baadhi ya gate ambazo hazina athari yoyote kwenye matokeo ya OTOC hufutana kabisa. Chanzo huondoa gate hizi ili kutoifanya hesabu kuwa ngumu kwa njia ya bandia. Zaidi ya hayo, gate zilizo nje ya koni za mwanga za operator za kipimo na kipepeo, pamoja na qubit ambazo haziguswi tena na gate yoyote, huondolewa.
Kwa hiyo ulinganisho wa gharama ya kawaida katika utafiti si gharama ya “kuiga bila kuchagua saketi yote isiyohitajika.” Waandishi kwanza huondoa sehemu zisizoathiri matokeo ya OTOC, kisha huiga sehemu ngumu iliyobaki.
Saketi mpya za 2B scaling-analysis zinachaguliwaje?
Mchakato katika Appendix A una hatua nne:
- Mwanzoni huundwa grid ya qubit kubwa ya kutosha, kwa vitendo 10×10, na measurement operator \(M\) huwekwa karibu na katikati.
- Kwa nafasi zinazowezekana za Butterfly operator \(B\), ukubwa wa mabadiliko ya OTOC hutathminiwa. Ikiwa mkengeuko wa kawaida wa juu ni \(\Sigma\), nafasi zinazotimiza \(\sigma_B\ge0.3\Sigma\) pekee, yaani zinazotoa angalau %30 ya signal ya juu, huhifadhiwa kama wagombea.
- Kwa kila mgombea, gate zisizochangia thamani ya OTOC hupunguzwa kulingana na koni za mwanga na qubit zilizotenganika na saketi huondolewa.
- Miongoni mwa wagombea waliobaki, gharama ya exact tensor-network contraction hukadiriwa kwa TNCO na nafasi inayoonekana kuwa ngumu zaidi kwa kompyuta ya kawaida huchaguliwa.
Utaratibu huu wa uteuzi unaonyesha kwamba watafiti hawakuchagua tu saketi zenye signal kubwa, bali pia saketi zilizo ngumu kimfumo kwa kompyuta ya kawaida. Hata hivyo, chanzo pia kinasema kwamba mbinu ya haraka iliyotumika katika hesabu ya uteuzi wa \(\sigma\) katika Appendix A si hesabu ya moja kwa moja ya brute-force ya mkengeuko wa kawaida wa exact OTOC ensemble.
Tensor Networks with Belief Propagation (TNBP) inafanyaje kazi?
TNBP hugawa uigaji wa OTOC katika matatizo mawili tofauti ya makadirio: kwanza huevolve saketi ya quantum juu ya PEPS kwa truncation inayotegemea belief-propagation ili kuzalisha uwakilishi wa makadirio wa mtandao wa tenzori wa hali \(|\phi\rangle\); kisha hukokotoa expectation value ya \(M\) kwenye PEPS hiyo kwa boundary-MPS contraction. Kwa hiyo usahihi wa jumla hutegemea PEPS bond dimension \(D\) na extraction bond dimension \(\chi\).
PEPS ni nini?
Projected entangled pair state (PEPS) ni ansatz ya mtandao wa tenzori inayowakilisha hasa wavefunction za mifumo ya quantum ya miili mingi katika mifumo yenye dimensheni mbili kama mtandao wa tenzori za mahali fulani. Kila qubit ya kimwili ina tenzori yake. Indeksi ya kimwili ya tenzori hubeba hali ya qubit ya mahali fulani, huku indeksi za auxiliary/bond zikibeba taarifa ya entanglement inayoshirikiwa na tenzori jirani.
Ukubwa mkubwa zaidi wa indeksi ya auxiliary huitwa bond dimension \(D\).
- \(D=1\): hali ya product; mtandao haubebi entanglement kati ya majirani.
- \(D\) kubwa zaidi: entanglement zaidi inaweza kuwakilishwa.
- Entanglement kubwa sana: kwa uwakilishi exact, \(D\) inaweza kukua kwa kasi sana.
Kwa nini gate ya qubit mbili huongeza bond dimension?
Gate ya ku-entangle ya qubit mbili inapowekwa kwenye tenzori mbili jirani za PEPS, tenzori hizo huunganishwa kwa muda kisha hutenganishwa tena kwa SVD. Katika PEPS ya qubit yenye dimensheni mbili, katika hali exact gate moja kwa kawaida inaweza kuongeza bond dimension husika hadi mara nne:
Gate nyingi zinapoathiri bond ileile mfululizo, bond dimension ya exact PEPS hukua kwa eksponenti kulingana na idadi ya gate. Hoja ya incompressibility ya chanzo inaanza hapa.
Belief propagation truncation inafanya nini?
Katika hesabu za vitendo, \(D\) hairuhusiwi kukua bila kudhibitiwa. Singular values zinazotokea baada ya kutumia gate hufanyiwa truncation hadi bond dimension ya juu iliyowekwa \(D\). Ili kukadiria ni singular components zipi zinapaswa kuhifadhiwa kwa approximation bora ya mahali fulani, taarifa ya mazingira hupitishwa kwa ujumbe wa belief propagation.
Chanzo hutumia toleo la symmetric-gauge BP. Katika uwakilishi wa double-layer wa mtandao, matri za “message” zilizo positive semidefinite kati ya tenzori jirani husasishwa kwa iterative. Inaporejea kwenye uwakilishi wa layer moja, square roots za ujumbe huingizwa kwenye tenzori; tenzori mbili lengwa hupunguzwa kwa QR decomposition; gate hutumika; SVD hufanywa; matri ya singular-value hukatwa hadi \(D\), na ujumbe mpya huundwa.
Katika mitandao inayofanana na mti isiyo na loop, mazingira ya BP yanaweza kuwa exact na truncation inaweza kuwa optimal kimataifa. Katika mitandao ya PEPS yenye loop, BP ni hesabu ya mazingira ya makadirio na makosa ya truncation yanaweza kujilimbikiza kadiri muda unavyopita.
Chanzo wakati wa SVD huondoa kwa njia ya nambari
singular values zilizo chini ya kiwango hicho.
Gharama ya PEPS evolution
Chanzo kinatoa gharama ya PEPS evolution inayotegemea BP kwenye lattice ya mraba kwa takriban
scaling.
Hapa \(N\) ni idadi ya qubit/tenzori na \(D\) ni PEPS bond dimension ya juu. Ikiwa \(D\) inakua kwa eksponenti, gharama ya kompyuta hukua kwa kasi zaidi kutokana na utegemezi wa \(D^5\).
Hatua ya extraction na boundary MPS
Baada ya PEPS kutengenezwa, ili kukokotoa expectation value ya observable ya mahali fulani \(M\), PEPS, complex conjugate yake na \(M\) kwa pamoja huunda mtandao wa tenzori wa double-layer. Kwa sababu exact contraction ni ghali sana katika mifumo mikubwa, mbinu ya boundary matrix product state hutumika.
Bond dimension ya juu ya Boundary MPS ni \(\chi\). Chanzo kinatoa gharama ya extraction kuwa
.
Kwa nini fomula hii ni muhimu? \(D\) kubwa haifanyi evolution kuwa ghali tu, bali pia extraction. Hasa term \(D^6\chi^2\) inaonyesha kwamba ongezeko la PEPS bond dimension linaingia katika gharama ya kutoa observable kwa nguvu ya daraja la juu sana.
Kwa nini \(\chi\) ni parameter tofauti? Kuhifadhi wavefunction sahihi kwa \(D\) kubwa hakumaanishi OTOC itatolewa kwa usahihi moja kwa moja. Ikiwa \(\chi\) ni ndogo sana, taarifa ya correlations za masafa marefu inaweza kupotea wakati wa bMPS contraction.
Kwa nini entanglement inaweza kuongeza gharama ya TNBP kwa eksponenti?
Katika saketi za OTOC zinazozalisha entanglement kubwa, gate za qubit mbili zinazofuata kwenye bond ileile ya PEPS huongeza bond dimension ya uwakilishi wa exact tensor-network kwa kuzidisha; chanzo kinaonyesha kwamba kutokana na jiometri ya koni ya mwanga ya OTOC baadhi ya bond hupokea idadi ya gate za ku-entangle inayolingana na kina cha saketi, na chini ya dhana ya incompressibility, \(D\) inayohitajika hukua kwa eksponenti na \(N\) katika 1B, na na ukubwa wa mstari wa mfumo \(\sqrt N\) katika 2B.
Incompressibility inamaanisha nini hapa?
Katika Appendix C, chanzo kwanza hufafanua indeksi ya bond ya PEPS. Ikiwa bond dimension inaweza kupunguzwa bila kupoteza global fidelity muhimu na bila kuongeza ukubwa wa bond nyingine, bond hiyo huchukuliwa kuwa inaweza kubanwa. Vinginevyo haiwezi kubanwa.
Ikiwa bond zote husika za PEPS haziwezi kubanwa kwa maana hii, chanzo hufafanua PEPS kama “incompressible”. Quantum circuit huitwa “incompressible circuit” ikiwa exact PEPS inayozalishwa inapowekwa kwenye hali ya mwanzo ya product haiwezi kubanwa kwa maana hii.
Ufafanuzi huu si sawa na dhana ya “kubana faili ya data kwa ZIP”. Hapa compression ni tatizo la kama hali ya quantum ya miili mingi inaweza kuwakilishwa kwa makadirio kwa bond dimensions ndogo za tenzori.
Kwa nini bond ya exact PEPS inategemea idadi ya gate?
Katika exact construction ya Appendix C, kila gate ya qubit mbili hugawanywa kwa SVD kuwa tenzori mbili za rank-3. Kwenye PEPS yenye dimensheni mbili, kila gate inaweza kuleta hadi mara nne ukubwa mpya kwenye auxiliary bond husika. Ikiwa bond moja ina gate \(g\) zinazofaa za qubit mbili, idealized exact construction hutoa:
tabia hiyo.
Katika MPS yenye dimensheni moja, ukubwa wa Hilbert-space ya mahali fulani huweka kikomo cha ziada cha rank, hivyo ongezeko linaweza kuzuiliwa kwa factor ya juu ya 2 kwa kila gate. Kwa hiyo msingi 2 huonekana katika milinganyo ya scaling ya 1B.
Scaling ya kinadharia ya 1B
Kwa brickwall circuit yenye dimensheni moja, chanzo huonyesha uwiano wa propagation velocity unaohitajika kati ya \(M\) na \(B\) kwa \(v_{MB}/c\). Chini ya jiometri yenye unyeti mkubwa wa OTOC, bond dimension inayohitajika ni:
Kwa ukingo wa physical-lightcone wa saketi za Haar-random 1B, chanzo huchagua
. Hivyo
\(A_1\) ni constant inayotegemea usahihi lengwa. Chanzo kinaonyesha katika majaribio ya nambari ya 1B kwamba \(D\) inayohitajika kwa thamani tofauti za SNR lengwa hufuata scaling hii ya eksponenti kwenye grafu ya log-linear.
Scaling ya kinadharia ya 2B
Katika grid yenye dimensheni mbili, idadi ya jumla ya qubit huscale na eneo, na ukubwa wa mstari wa mfumo huscale takriban na \(\sqrt N\). Makadirio ya maandishi makuu ya chanzo kwa mwelekeo wa mlalo wa \(M\)-\(B\), unaotoa signal kubwa ya OTOC na kuongeza gharama ya classical-contraction, ni:
Kwa second-order OTOC, hoja hiyo hiyo ya kijiometri inatoa:
ongezeko la haraka zaidi.
Kikomo \(A_2\le0.5\) hapa kinatokana na kwamba layer ya kwanza ya gate hutumika kwenye hali ya product, hivyo katika hatua ya kwanza bond dimension inaweza kuongezeka kwa factor ya juu ya 2 badala ya 4.
Kwa nini mwelekeo hubadilisha gharama ya 2B?
Geometric na physical lightcone kwenye square lattice si rotationally symmetric. Appendix D huchunguza mwelekeo wa horizontal na diagonal tofauti.
Katika mwelekeo wa diagonal, chanzo kinaonyesha kwamba koni ya mwanga ya kimwili huenea karibu sana na koni ya mwanga ya kijiometri na kwamba takriban
scaling inaweza kupatikana.
Katika hali ya mlalo kwenye primitive lattice axis, tofauti ya kasi za koni ya mwanga ni kubwa zaidi na hufikia
scaling. Kwa sababu utaratibu wa kuchagua saketi za scaling-analysis unajaribu kuongeza classical contraction cost, maandishi makuu hutumia exponent ngumu zaidi ya takriban \(0.6\sqrt N\).
Je, sehemu kati ya koni za mwanga za kijiometri na kimwili haiwezi kubanwa kabisa?
Hapana. Ncha muhimu ya chanzo ni kinyume: baadhi ya maeneo yaliyo ndani ya geometric lightcone lakini nje ya dressed physical lightcone yanaweza kubanwa kwa makadirio. Gate za \(U\) na \(U^\dagger\) hufutana kwa sehemu katika maeneo haya.
Hata hivyo, karibu na \(B\) na katika makutano ya dressed physical lightcone mbili hubaki “incompressible core”. Chanzo kinasema kwamba \(D\) ya juu zaidi inayohitajika huamuliwa na eneo hili la ndani zaidi, na partial compression katika maeneo ya nje haiondoi asymptotic Schrödinger-picture scaling.
Kwa nini physical-lightcone front si kali?
Kwa sababu taarifa haienei kwa kasi ileile katika random circuit instance, mpaka wa physical-lightcone si mstari mmoja mkali. Chanzo kinaonyesha kuwa katika 1B upana wa front una tabia ya takriban
na kwamba katika 2B, kwa kutegemea fasihi husika ya kinadharia, hutumia
scaling. Upana huu husababisha dhana ya “dressed physical lightcone”.
Matokeo ya “Beyond Classical” yanamaanisha nini hasa katika makala hii?
Katika utafiti huu “beyond classical” inamaanisha kwamba ili kuzalisha tena ensemble fulani za OTOC kwa usahihi uliofikiwa na jaribio la Willow, mbinu za kawaida zinazowezekana zilizochunguzwa zinahitaji muda au kumbukumbu nyingi zaidi kuliko jaribio la quantum; makala haithibitishi theorem ya kihisabati ya kutowezekana inayotumika milele kwa algorithm zote zinazowezekana za kawaida.
Kigezo cha reproducible quantum advantage
Chanzo kinatofautisha masharti mawili ya msingi ya “reproducible quantum advantage”:
- Quantum advantage: ili kufanya computational task ileile kwa usahihi uleule, kompyuta ya kawaida ihitaji muda au kumbukumbu nyingi zaidi sana.
- Reproducibility: jaribio linaporudiwa, thamani ileile ya observable iweze kupatikana tena ndani ya kiwango fulani cha usahihi.
Katika utangulizi wa makala, lengo la kuwa na matumizi muhimu katika ulimwengu halisi pia linajadiliwa kama lengo la tatu na pana zaidi. Utafiti huu unaimarisha ushahidi wa ugumu wa kihesabu wa kawaida unaohusiana na vipengele viwili vya kwanza; wenyewe hauonyeshi quantum application mpya ya ulimwengu halisi.
Mbinu na Matokeo ya Utafiti
Rasilimali za kompyuta zilizotumika
Chanzo kinaeleza kwamba katika hesabu za TNBP kilitumia nodi za a2-ultragpu-8g au c2-standard-60 kwenye Google Cloud. Katika utafiti mkuu, kiwango cha juu cha PEPS bond dimension kilichoweza kufikiwa kilikuwa takriban
na boundary-MPS bond dimension ilikuwa takriban
Watafiti wanaeleza kwamba, chini ya jumla ileile ya rasilimali, mgawanyo tofauti unaweza kufanywa kati ya \(D\) na \(\chi\), lakini uchaguzi wa \(D=35,\chi=30\) ulikuwa takriban bora kwa rasilimali walizotumia.
Matokeo katika mizunguko halisi ya quantum echoes yenye qubit 23
| Mzunguko | Idadi ya two-qubit gate | TNBP SNR | TNMC SNR | SNR ya jaribio la Willow |
|---|---|---|---|---|
| Mzunguko wa qubit 23 wenye kina kidogo | 108 | takriban 2,94 | 7,61 | 7,21 |
| Mzunguko wa qubit 23 wenye kina kikubwa zaidi | 164 | takriban 1,31 | 6,73 | 5,26 |
Hata final PEPS inapofanyiwa exact contraction katika mzunguko wenye kina kidogo, inaonekana kwamba evolution truncation ya \(D=35\) imepoteza taarifa muhimu ya OTOC. Kwa hiyo, kufanya \(\chi\) iende hadi ukomo usio na mwisho wakati wa extraction hakuwezi kurudisha taarifa ambayo tayari ilipotea wakati wa evolution.
Chanzo huendesha evolution ya mzunguko wa 108-gate bila truncation na kuongeza final bond dimension hadi
kisha hufanya truncation hadi \(D=35\) katika hali ya mwisho pekee. Hata hatua hii hushusha SNR hadi chini ya 3. Matokeo yanaonyesha kwamba tatizo haliwezi kuelezwa tu kwa kusema “hitilafu hukusanyika kwa sababu truncation hufanywa tena na tena baada ya kila gate”; final wavefunction yenyewe pia hubeba taarifa muhimu inayohitaji \(D\) kubwa.
Hata hivyo, Appendix F inaongeza kizuizi muhimu: majaribio haya ya nambari pekee hayathibitishi kwamba haiwezekani kabisa kuiwakilisha hali ileile ya kimwili kwa \(D\) ndogo ikiwa mbinu tofauti na yenye gharama kubwa zaidi ya truncation ingetumika. Hitimisho la jumla zaidi la waandishi kuhusu incompressibility linategemea mkusanyiko wa hoja ya kinadharia na ushahidi mwingine wa nambari pamoja na jaribio hili.
Mizunguko mipya ya 2D yenye qubit 8–28
Mbali na mizunguko halisi ya jaribio, waandishi huunda ensemble mpya za OTOC kwa mantiki ileile ya kimwili na kuiga mifumo yenye 50 random instance kati ya \(N=8\) na \(N=28\).
Matokeo mawili ya msingi hupatikana:
- Incompressibility ya evolution: ili kupata OTOC sahihi, \(D\) lazima iwe kubwa. Katika mifumo ya \(N\le14\) ambako thamani exact inaweza kufikiwa, kupunguza bond dimension kwa takriban %20 pekee kunaweza kushusha SNR hadi kiwango cha 5–10.
- Gharama ya extraction: hata ikiwa PEPS sahihi ipo, \(\chi\) ndogo haitoshi kutoa OTOC kwa usahihi; \(\chi\) pia lazima ikue hadi sehemu yenye maana ya \(D\).
Matokeo ya Table I ya chanzo
| N | Wastani wa OTOC | σ(OTOC) | D | χ | Muda wa kati wa bMPS (saa) | SNR |
|---|---|---|---|---|---|---|
| 8 | −0,052 | 0,241 | 14 | 15 | 0,02 | Exact |
| 10 | 0,053 | 0,203 | 22 | 15 | 0,02 | Exact |
| 12 | 0,019 | 0,202 | 24 | 17 | 0,03 | Exact |
| 14 | 0,067 | 0,199 | 35 | 30 | 0,05 | Exact |
| 17 | 0,055 | 0,113 | 35 | 30 | 0,77 | 16,52 |
| 20 | 0,051 | 0,093 | 35 | 30 | 7,40 | 3,06 |
| 22 | 0,100 | 0,087 | 35 | 30 | 15,28 | 3,56 |
| 23 | 0,056 | 0,069 | 35 | 30 | 61,49 | 6,28 |
| 28 | 0,085 | 0,074 | 35 | 25 | 76,24 | 4,13 |
Nyakati zilizo kwenye jedwali ni median ya muda wa bMPS contraction kati ya instance 50 na zinahusu nodi za CPU za c2-standard-60. “Exact” humaanisha kwamba thamani za OTOC za instance husika zilihesabiwa kwa hitilafu ndogo kuliko \(10^{-6}\) katika kiwango cha single-precision.
Jedwali halionyeshi ongezeko la gharama linalofuata mpangilio mmoja kila ukubwa wa mfumo unapoongezeka. Chanzo kinaeleza hasa kwamba hali hii inatokana na finite-size effects zinazozalishwa na jiometria zisizo sawia za utaratibu wa circuit-construction. Kwa hiyo, si sahihi kutoa general asymptotic scaling kutoka kwa nyakati za qubit 20, 22, 23 na 28 moja moja.
Kwa nini D na χ zote lazima ziwe kubwa?
\(D\) ikiwa ndogo, taarifa ya hali ya quantum inayohitajika kwa OTOC hupotea kupitia truncation wakati wa evolution. Kufanya exact contraction baadaye hakuwezi kurudisha upotevu huu.
\(\chi\) ikiwa ndogo, taarifa inayohitajika inaweza kuwapo ndani ya PEPS lakini boundary contraction haiwezi kubeba correlations za masafa marefu. Chanzo kinaonyesha kwamba hata katika exact evolution iliyofanywa bila truncation hadi \(D=64\) kwa mifano ya \(N=14,17,20\), SNR yenye maana haikupatikana wakati \(\chi\lesssim8\); ili SNR ifikie takriban 10 au zaidi, \(\chi\) lazima ikaribie sehemu kubwa ya \(D\).
Udhibiti kwa gate zenye uwezo mdogo wa kuunda entanglement
Ili kupima dhana ya incompressibility, gate asilia zinazofanana na iSWAP hubadilishwa na gate zinazoweza kurekebishwa
hizi.
\(\alpha=1\) inalingana na kiwango cha utengenezaji wa entanglement cha iSWAP ya kawaida. \(\alpha\rightarrow0\) hupunguza athari ya entangling ya gate.
Kwa mujibu wa matokeo ya Figure 13 ya chanzo:
- \(\alpha=0.25\): ukuaji wa entanglement ni wa polepole zaidi, TNBP hupata fidelity ya juu zaidi sana na simulation yenye mafanikio kwa \(D\) ndogo;
- \(\alpha\approx0.5\): mizunguko iliyorekebishwa huwa takriban migumu sawa na mzunguko asilia;
- \(\alpha=0.7\) na \(1.3\): katika baadhi ya mifumo iliyochunguzwa, tabia ya simulation huwa ngumu hata kuliko mzunguko asilia wa \(\alpha=1\).
Matokeo haya hayaungi mkono hitimisho rahisi kwamba “kiasi cha entanglement huongezeka kwa mpangilio mmoja pamoja na \(\alpha\), na gharama pia huongezeka kwa namna ileile”. Chanzo kinaonyesha tu kwamba entanglement growth ya polepole katika \(\alpha\) ndogo huwezesha compression dhahiri na kwamba uchaguzi wa gate yenye uwezo mkubwa wa kuunda entanglement ni mojawapo ya vipengele vya msingi vya ugumu wa classical.
Je, data za mifumo midogo ya 2D kweli zinaonyesha exponential scaling?
Hapana. Hiki ni mojawapo ya mipaka muhimu zaidi ya tafsiri katika makala.
Appendix G huchunguza katika mifumo midogo ya 2D ya \(N=8\)–28 uhusiano wa SNR–\(D\) uliopimwa kwa kutumia exact extraction. Kwa kila \(N\), takriban:
fit hizi hupatikana. Kirasmi, hii hutoa:
aina ya polynomial-looking small-system scaling.
Kwa global infidelity, chanzo hutoa:
na kwa hiyo, kwa fixed fidelity, takriban
tabia hiyo inaripotiwa.
Hata hivyo, waandishi hawakubali matokeo haya kama asymptotic scaling. Wanaeleza kwamba katika mizunguko yote ya N=20, 22, 23 na 28, hakuna bond yoyote iliyokuwa na zaidi ya gate nne tu; mifumo bado haijaingia katika regime ya gate-depth inayoongezeka pamoja na \(\sqrt N\). Kwa hiyo, takriban \(N^{1.3}\) scaling inayoonekana ni matokeo ya finite-size regime na kwa \(N\) kubwa haibatilishi makadirio ya kinadharia ya \(D\sim\exp(\sqrt N)\).
Makadirio ya bond dimension kwa OTOC ya qubit 95 na OTOC(2) ya qubit 65
Kwa kuwa mizunguko halisi mikubwa zaidi ya jaribio haina jiometria sawa kabisa na mizunguko ya scaling-analysis, Eq. (7) haitumiki moja kwa moja kwa mizunguko hii. Badala yake, watafiti huhesabu idadi ya juu zaidi ya gate zinazofanana na iSWAP zinazotumika kwenye kila physical PEPS bond.
| Jaribio | Qubit | Idadi ya juu zaidi ya entangling gate kwenye bond moja | Makadirio ya awali ya exact-base | Makadirio ya chini ya kihafidhina kwa usahihi wa jaribio |
|---|---|---|---|---|
| OTOC ya kawaida | 95 | 8 | \(4^8\approx6.4\times10^4\) | \(D\approx3.2\times10^3\) |
| Second-order OTOC / \(C^{(4)}\) | 65 | 12 | \(4^{12}\approx1.7\times10^7\) | \(D\approx8.4\times10^5\) |
Thamani za awali zinarekebishwa kwenda chini kwa sababu mbili. Kwa kuwa safu ya kwanza ya gate hutumika kwenye product initial state, ongezeko la kwanza huzuiwa kwa factor ya takriban 2 badala ya 4. Pia, lengo si OTOC iliyo numerically exact, bali kulinganisha takriban usahihi wa SNR wa jaribio. Kutokana na matokeo ya majaribio ya 1D, waandishi hutumia kwa njia ya kihafidhina uwezekano kwamba \(D\) inayohitajika kwa SNR inayofanana na jaribio inaweza kupunguzwa kwa factor ya takriban 0,1 ikilinganishwa na exact estimate.
Kwa kuwa waandishi wanatarajia bond-dimension reduction ndogo zaidi katika mfumo mkubwa wa 2D kuliko katika 1D kwa SNR ileile, wanatumia factor ya 0,1 kwa njia ya matumaini ili kuunda lower bound . Kwa hiyo, safu ya mwisho ya jedwali si “hii ndiyo D inayohitajika kwa uhakika”, bali ni makadirio ya lower bound yaliyofanywa na chanzo kwa upendeleo wa classical simulation.
Hesabu ya kumbukumbu inafanywaje?
Katika square-lattice PEPS, tensor moja yenye auxiliary bond nne na physical dimension ya 2 ina takriban
complex number.
Kwa single-precision complex number, chanzo hutumia byte 8. Hivyo, kiwango cha kumbukumbu cha tensor moja ni:
Kwa \(C^{(4)}\) ya qubit 65, \(D\approx8.4\times10^5\) ikiwekwa katika hesabu, chanzo hutoa:
na kinaieleza kuwa zaidi ya petabyte \(10^9\).
Kwa kulinganisha, chanzo hutumia takriban 700 PB kama jumla ya storage capacity ya supercomputer Frontier. Ulinganisho huu ni sehemu ya feasibility argument ya utafiti katika muktadha wa 2026.
Kwa OTOC ya kawaida ya qubit 95, wakati \(D\approx3.2\times10^3\), chanzo huhesabu takriban
ya kumbukumbu kwa tensor moja ya PEPS. Hata kama tensor hii moja inaweza, kinadharia, kutoshea katika kumbukumbu za mifumo mikubwa zaidi, tensor kubwa zaidi zinazoundwa wakati wa extraction zinaweza tena kuzidi jumla ya rasilimali.
Kwa nini waandishi wanalinganisha na exact tensor-network contraction?
Ikiwa compression haiwezekani, faida ya mbinu ya approximate tensor-network state hupotea. Kuunda hali kama PEPS kubwa na kisha ku-contract hali hiyo, katika baadhi ya hali, kunaweza kuwa ghali zaidi kuliko kuhesabu tensor network ya observable tangu mwanzo kwa optimized exact contraction.
Mlolongo wa hoja wa chanzo ni huu:
- Sehemu ngumu za mizunguko ya OTOC kwa kiasi kikubwa haziwezi kubanwa.
- Kwa hiyo TNBP inahitaji \(D\) kubwa.
- Kuondoa kabisa maeneo ya nje yanayoweza kubanwa ni mojawapo ya mipaka yenye matumaini zaidi ya kupunguza gharama inayowezekana kwa TNBP.
- Hata gharama ya TNBP ya mzunguko huu uliopunguzwa gate si ndogo kuliko gharama ya optimized exact tensor contraction.
- Katika utafiti uliotangulia wa quantum echoes, tayari ilihesabiwa kwamba optimized exact contraction ilihitaji muda mrefu zaidi sana kuliko jaribio la Willow ili kufikia usahihi wa jaribio.
Kwa hiyo, TNBP haitoi classical shortcut mpya inayozidi mbinu ya classical exact-contraction iliyojaribiwa hapo awali.
Kauli ya 13.000× inahusu nini?
Katika utangulizi, chanzo kinarudia hitimisho kutoka utafiti uliotangulia wa Google quantum echoes kwamba optimized classical computation ya second-order OTOC ya qubit 65 kwa usahihi unaofanana, kwenye supercomputer ya kisasa, ilikuwa zaidi ya mara 13.000 polepole kuliko kipimo cha quantum. Hii 13.000× si uwiano mpya wa TNBP runtime uliopimwa moja kwa moja katika utafiti huu mpya wa TNBP; unatokana na ulinganisho wa classical exact-contraction katika utafiti uliotangulia.
Je, mbinu ya Heisenberg-picture inaweza kubadilisha matokeo?
Hitimisho kuu la chanzo lina nguvu zaidi kwa mbinu za Schrödinger-picture tensor-network evolution. Appendix E pia hujadili mbinu zinazowezekana za Heisenberg-picture.
Kuendeleza operator moja tu kama \(B\) au \(M\) katika Heisenberg picture huhitaji \(D\) na \(\chi\) kubwa zaidi katika majaribio ya chanzo kwa sababu ya doubled Hilbert space na hakutoi faida.
Kwa upande mwingine, mbinu inayoevolve \(M\) na \(B\) zote mbili katika Heisenberg picture kutoka pande mbili inaweza kuondoa kwa ukali zaidi maeneo yaliyo nje ya physical lightcone. Chanzo kinajadili kwamba kwa 1D, upana wa irreducible core unaweza kuwa
na kwa kuwa \(N\sim T\), gharama inaweza kupunguzwa kutoka \(\exp(N)\) katika Schrödinger-picture hadi tabia dhaifu zaidi ya aina ya
ya asymptotic.
Hata hivyo, mbinu hii ya bi-directional Heisenberg haijatekelezwa na ku-benchmarkiwa katika makala kama simulation ya vitendo ya mzunguko mkubwa. Exact asymptotic scaling kwa 2D pia haijatolewa. Waandishi wanaeleza kwamba \(\mathrm{OTOC}^{(2)}\) ya qubit 65 huenda bado isiweze kufikiwa hata kwa mbinu hii na kwamba qubit 65 huenda zisiwe nyingi vya kutosha kufidia prefactor kubwa za asymptotic scaling iliyo bora zaidi. Kwa hiyo, mbinu hii ni mwelekeo muhimu wa kazi ya baadaye, si matokeo yanayobatilisha dai la sasa la beyond-classical.
Matokeo yanayoungwa mkono na utafiti
- TNBP haiwezi kufikia usahihi wa SNR wa jaribio na TNMC katika mizunguko halisi ya quantum-echoes OTOC ya qubit 23 iliyochunguzwa.
- Entanglement kubwa ya random OTOC circuits hufanya PEPS representation isiweze kubanwa kwa kiasi kikubwa.
- Katika majaribio ya 1D, exponential scaling ya bond dimension inayohitajika pamoja na ukubwa wa mfumo inaendana na makadirio ya kinadharia.
- Katika majaribio ya 2D ya N=8–28, \(D\) kubwa na \(\chi\) kubwa zinahitajika kwa pamoja.
- Katika mizunguko ya mifumo midogo ya 2D, hata bond-dimension reduction ya karibu %20 inaweza kushusha SNR kwa kiasi kikubwa katika mifano inayoweza kutatuliwa exact.
- Modified iSWAP circuits zinazozalisha entanglement dhaifu zinaweza kuigwa kwa ufanisi mkubwa zaidi na TNBP; mbinu hunufaika pale compression inapowezekana.
- Uchambuzi wa kinadharia wa lightcone/incompressibility unatabiri kwamba kwa mizunguko mikubwa ya 2D OTOC, \(D\) hukua kwa exponential kulingana na linear system size.
- Makadirio ya bond dimension na kumbukumbu yaliyofanywa na chanzo kwa OTOC ya qubit 95 na second-order OTOC ya qubit 65 yanaunga mkono hitimisho kwamba TNBP si feasible.
- Mbinu za incompressible Schrödinger-picture tensor-network state hazitarajiwi kuwa na faida zaidi kuliko optimized exact tensor-network contraction.
Matokeo ambayo utafiti hauungi mkono
- Makala haitoi complexity-theory impossibility theorem kwamba algoriti zote zinazowezekana za classical hazitaweza kutatua tatizo la Google quantum echoes milele.
- Data za 2D kati ya N=8–28 si kipimo cha moja kwa moja cha asymptotic exponential scaling.
- Matokeo ya takriban \(D\sim N^{1.3}\) ya finite-size katika Appendix G hayaonyeshi kwamba mifumo mikubwa ni rahisi kwa polynomial.
- Haijaonyeshwa kwamba TNBP hushindwa katika quantum circuits zote; kinyume chake, inaonyeshwa kuwa inaweza kufanya kazi kwa ufanisi katika mizunguko yenye gate dhaifu za entangling.
- Utafiti huu haukufanya jaribio jipya la Willow.
- Kwa qubit 65, byte \(7.9\times10^{24}\) si matumizi ya RAM yaliyopimwa katika utekelezaji halisi; ni makadirio ya tensor moja yaliyohesabiwa kutoka kwa modeli ya chanzo.
- Thamani za \(D\approx3.2\times10^3\) na \(8.4\times10^5\) si mathematically exact minimum bond dimensions zilizothibitishwa; ni makadirio ya kihafidhina ya feasibility kwa lengo la SNR linalofanana na jaribio.
- Haijathibitishwa kwa majaribio ya nambari pekee kwamba hakuna mbinu nyingine yoyote ya PEPS truncation nje ya BP inayoweza kufanya compression bora zaidi.
- Gharama ya vitendo ya mbinu ya bi-directional Heisenberg-picture katika mizunguko mikubwa ya 2D quantum echoes haijaamuliwa kwa nambari katika utafiti huu.
- Makala hii haionyeshi kwamba quantum computers ni bora kuliko classical computers katika matatizo yote ya ulimwengu halisi.
Nguvu za utafiti
Utafiti hautoi dhana moja tu ya scaling. Unatumia udhibiti kadhaa unaokamilishana: jaribio la wazi la scaling katika 1D, ulinganisho wa moja kwa moja wa TNBP katika mizunguko halisi ya jaribio yenye qubit 23, uchambuzi wa \(D\)/\(\chi\) katika mizunguko mipya ya 2D, weak-entanglement control, na hoja mbili tofauti za feasibility kwa mizunguko mikubwa.
Hasa, udhibiti wa weak-entangling gate una thamani ya kimetodolojia. Kama kushindwa kwa TNBP kungetokana tu na utekelezaji mbaya, isingetarajiwa kwamba mbinu ileile ingeboreka sana wakati uzalishaji wa entanglement unapunguzwa. Uboreshaji unaoonekana katika chanzo unaunga mkono kwamba compression kwa kweli hutegemea fizikia ya mzunguko.
Vikwazo vya msingi
- Mizunguko mikubwa ya qubit 65 na 95 haikuigwa kikamilifu kwa brute-force kwa TNBP; gharama ilitathminiwa kwa theoretical na empirical extrapolation.
- 2D asymptotic exponential scaling haikuonekana moja kwa moja kutoka kwenye data ya nambari ya N≤28.
- BP truncation ni approximate katika PEPS networks zenye loops.
- Mbinu mbadala za PEPS update zenye gharama kubwa zaidi ya kompyuta haziku-benchmarkiwa moja kwa moja katika mizunguko hii mikubwa.
- Mbinu ya Heisenberg-picture bi-directional haijatekelezwa kwa vitendo na kuthibitishwa katika mfumo mkubwa.
- Makala yenyewe haionyeshi lengo la tatu pana la jaribio la quantum echoes, yaani quantum application muhimu ya moja kwa moja katika ulimwengu halisi.
Taarifa za reproducibility
| Kipengele | Taarifa iliyotolewa katika chanzo |
|---|---|
| Hali ya mwanzo | \(|0\rangle^{\otimes N}\) |
| Measurement operator | Katika ensemble za msingi, single-qubit \(M=Z\) |
| Butterfly operator | Katika ensemble za msingi zilizoigwa katika utafiti huu, single-qubit \(B=X\) |
| Two-qubit gate | fSim gate inayoweza kutenganishwa katika iSWAP + CPHASE ya takriban 0,35 rad |
| Pembe za random single-qubit | \(\theta/\pi\in\{0.25,0.5,0.75\}\), \(\phi/\pi\sim U[-1,1]\) |
| Mwanzo wa scaling-analysis grid | grid ya 10×10 |
| Kichujio cha signal kwa nafasi ya B | \(\sigma_B\ge0.3\Sigma\) |
| Idadi ya random instance | 50 katika uchambuzi mkuu wa 2D SNR |
| PEPS maximum bond dimension | Katika hesabu kuu, mara nyingi \(D\le35\) |
| bMPS maximum bond dimension | Katika hesabu kuu, mara nyingi \(\chi\le30\) |
| SVD numerical cutoff | \(10^{-14}\) |
| Rasilimali za Cloud | nodi za Google Cloud za a2-ultragpu-8g au c2-standard-60 |
| Uboreshaji wa TN contraction | TNCO; tathmini ya gharama ya contraction-path inayotegemea simulated annealing |
Marejeo pia yanataja hazina ya msimbo ya TNCO, maktaba ya programu ya ITensor na zana ya TensorNetworkQuantumSimulator.jl. Hata hivyo, katika utafiti uliopakiwa hakuna “data availability” statement tofauti au “code availability” statement maalumu inayojumuisha matokeo yote ya simulation ya makala hii.
Jukumu la kisayansi la vielelezo na nyenzo za ziada
Chanzo kinaunga mkono kwa kina mlolongo wa mbinu na ushahidi kwa vielelezo 28. Majukumu ya familia kuu ya vielelezo yanaweza kufupishwa hivi:
- kubadilisha OTOC kuwa kipimo cha ndani na mantiki ya gate pruning;
- tofauti kati ya geometric na physical lightcone;
- utoaji wa bond-dimension scaling kutoka jiometria ya lightcone ya 1D/2D;
- exponential scaling katika ensemble za 1D Haar na iSWAP;
- heatmap za \(D\)–\(\chi\)–SNR katika mizunguko ya jaribio yenye qubit 23;
- ulinganisho wa instance-error kati ya experiment, TNBP na TNMC;
- majaribio ya SNR na fidelity katika mizunguko mipya ya qubit 8–28;
- udhibiti wa weakly entangling iSWAP(\(\alpha\));
- uchambuzi wa circuit-construction, BP-update, exact-PEPS construction, 2D lightcone geometry, Heisenberg-picture na finite-size scaling katika Appendix.
Kwa kuwa orodha ghafi za nambari za grid/point za vielelezo vya heatmap na scatter hazijatolewa katika PDF kama jedwali linalosomeka na mashine, Verianla haibadilishi vielelezo hivi kwa kukadiria kutoka pikseli na kuviwasilisha kama data graph mpya. Namba zote zilizotolewa wazi katika chanzo zimewasilishwa kupitia maandishi na jedwali za HTML.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Tensor Networks with Belief Propagation Cannot Feasibly Simulate Google’s Quantum Echoes Experiment.
Waandishi na mpangilio: Pablo Bermejo; Benjamin Villalonga; Brayden Ware; Guifre Vidal; Aaron Szasz.
Taasisi 1: Google Quantum AI, Santa Barbara, CA 93111, USA.
Taasisi 2: Donostia International Physics Center, Paseo Manuel de Lardizabal 4, E-20018 San Sebastián, Spain.
Taasisi 3: Department of Applied Physics, Gipuzkoa School of Engineering, University of the Basque Country (UPV/EHU), Plaza Europa 1, 20018 San Sebastián, Spain.
Uhusiano wa taasisi: Pablo Bermejo anahusishwa na taasisi 1, 2 na 3; Benjamin Villalonga, Brayden Ware, Guifre Vidal na Aaron Szasz wanahusishwa na taasisi 1.
Alama za corresponding-author: Katika PDF, Pablo Bermejo na Aaron Szasz wana alama za mawasiliano. Anwani za barua pepe zilizotolewa ni pablo.bermejo@dipc.org na aszasz@google.com.
Mchango sawa: Katika PDF iliyopakiwa, hakuna taarifa ya equal contribution/equal first authorship inayoonekana.
Jukwaa: arXiv.
Kitambulisho cha arXiv: arXiv:2604.15427v1 [quant-ph].
Tarehe ya kuwasilisha: 16 Aprili 2026.
DOI: 10.48550/arXiv.2604.15427. Hii ni arXiv/DataCite DOI; si DOI ya jarida lililopitiwa na wataalamu.
Aina ya chanzo: Utafiti wa theoretical scaling + classical numerical tensor-network simulation.
Hali ya peer review: Kufikia 15 Novemba 2026, rekodi rasmi ya arXiv iliyothibitishwa iko katika hali ya v1 preprint; hakuna uchapishaji tofauti wa jarida uliopitiwa na wataalamu uliothibitishwa.
Taarifa ya kurasa/vielelezo: kurasa 37 na vielelezo 28.
Eneo la utafiti: Quantum computing, quantum computational advantage, out-of-time-order correlators, tensor networks, PEPS, belief propagation na classical simulation complexity.
Tofauti ya jaribio/simulation: Jaribio lenyewe la quantum echoes kwenye Willow quantum processor lilifanywa katika Ref. [1] ya awali. Utafiti huu unachunguza classical TNBP simulation ya experiment circuits hizo na mizunguko mipya iliyoundwa kwa mantiki ileile.
Acknowledgements: Waandishi wanawashukuru Sergio Boixo, Paolo Braccia, Kostya Kechedzhi, Salvatore Mandrà, Manuel Rudolph, Vadim Smelyanskiy na Adam Zalcman kwa mijadala na michango ya mawazo. Pablo Bermejo pia anataja msaada endelevu wa Donostia International Physics Center.
Ufadhili: Katika PDF iliyopakiwa, hakuna grant/funding statement tofauti wala namba ya grant inayoonekana. Msaada wa DIPC umeelezwa katika acknowledgements.
Mgongano wa maslahi: Katika PDF iliyopakiwa, hakuna competing-interests/conflict-of-interest statement tofauti inayoonekana.
Upatikanaji wa data: Katika PDF iliyopakiwa, hakuna data-availability statement tofauti inayoonekana.
Upatikanaji wa msimbo: Hakuna code-availability statement maalumu kwa matokeo yote ya makala; marejeo yanataja zana za programu huria zilizotumika/zinazohusiana kama TNCO, ITensor na TensorNetworkQuantumSimulator.jl.
Leseni: Kwa kuwa leseni maalumu ya Creative Commons ya matumizi tena haikuweza kuthibitishwa kwa kuaminika kutoka PDF na rekodi za bibliografia zilizochunguzwa, Verianla haichukulii kuwa kuna open license.
Mbinu kuu: OTOC random-circuit ensemble construction; geometric/physical-lightcone pruning; PEPS wavefunction evolution; symmetric-gauge belief-propagation truncation; boundary-MPS observable extraction; tathmini ya SNR na global fidelity; 1D/2D theoretical bond-dimension scaling; weak-entanglement control; large-circuit resource projection.
Vigezo vikuu vya udhibiti wa simulation: PEPS bond dimension \(D\), bMPS bond dimension \(\chi\), ukubwa wa mfumo \(N\), kina cha mzunguko \(T\), nafasi za butterfly na measurement operator, na entangling-gate parameter \(\alpha\).
Kipimo kikuu cha usahihi: SNR inayotegemea kinyume cha tofauti ya RMS kati ya exact na approximate results za thamani za ensemble-normalized OTOC.
Kikomo kikuu cha kimetodolojia: Mizunguko mikubwa ya TNBP ya qubit 65/95 haikuendeshwa kikamilifu kwa brute-force; feasibility ilitolewa kutoka theoretical scaling na matokeo ya nambari ya mifumo midogo/ya kati.
Kikomo muhimu cha 2D: Katika data ya majaribio ya N=8–28, theoretical \(D\sim\exp(\sqrt N)\) scaling haionekani moja kwa moja; Appendix G inahusisha hili na finite-size regime. Verianla haiwasilishi tabia hii ya small-system \(D\sim N^{1.3}\) kama matokeo ya asymptotic.
Kikomo cha ujanibishaji wa hitimisho: Hitimisho lenye nguvu zaidi la utafiti linahusu mbinu za Schrödinger-picture approximate tensor-network state evolution. Njia mbadala za Heisenberg-picture za pande mbili hazijaondolewa kabisa na zimeachwa kama mada ya kazi ya baadaye.
Ujenzi upya wa vielelezo: OTOC/lightcone mechanism, TNBP two-stage pipeline na incompressible-core relation zimejengwa upya kama independent inline SVG diagrams kwa kutumia mahusiano yaliyofafanuliwa wazi katika chanzo. Vielelezo vya uchapishaji havijanakiliwa moja kwa moja.
Mbinu ya grafu za kiasi: Kwa kuwa raw point arrays za heatmap/scatter figures za chanzo hazijatolewa, grafu hizi hazijachorwa upya kwa precision ya bandia. Namba zilizotolewa wazi katika Table I na maandishi zimewasilishwa kwa HTML tables.
Ufaafu wa Verianla Live / Live Figure: Inafaa. Mtiririko wa OTOC wa \(U\rightarrow B\rightarrow U^\dagger\rightarrow M\), mchakato wa gate-pruning/lightcone na mpangilio wa TNBP wa PEPS-evolution → BP truncation → bMPS extraction vinaweza kuelezwa katika muundo wa Live Process/Live Figure huku vigezo thabiti vya chanzo vikihifadhiwa. Hata hivyo, intermediate SNR values hazipaswi kuzalishwa bila raw data ya heatmap ya chanzo.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *