


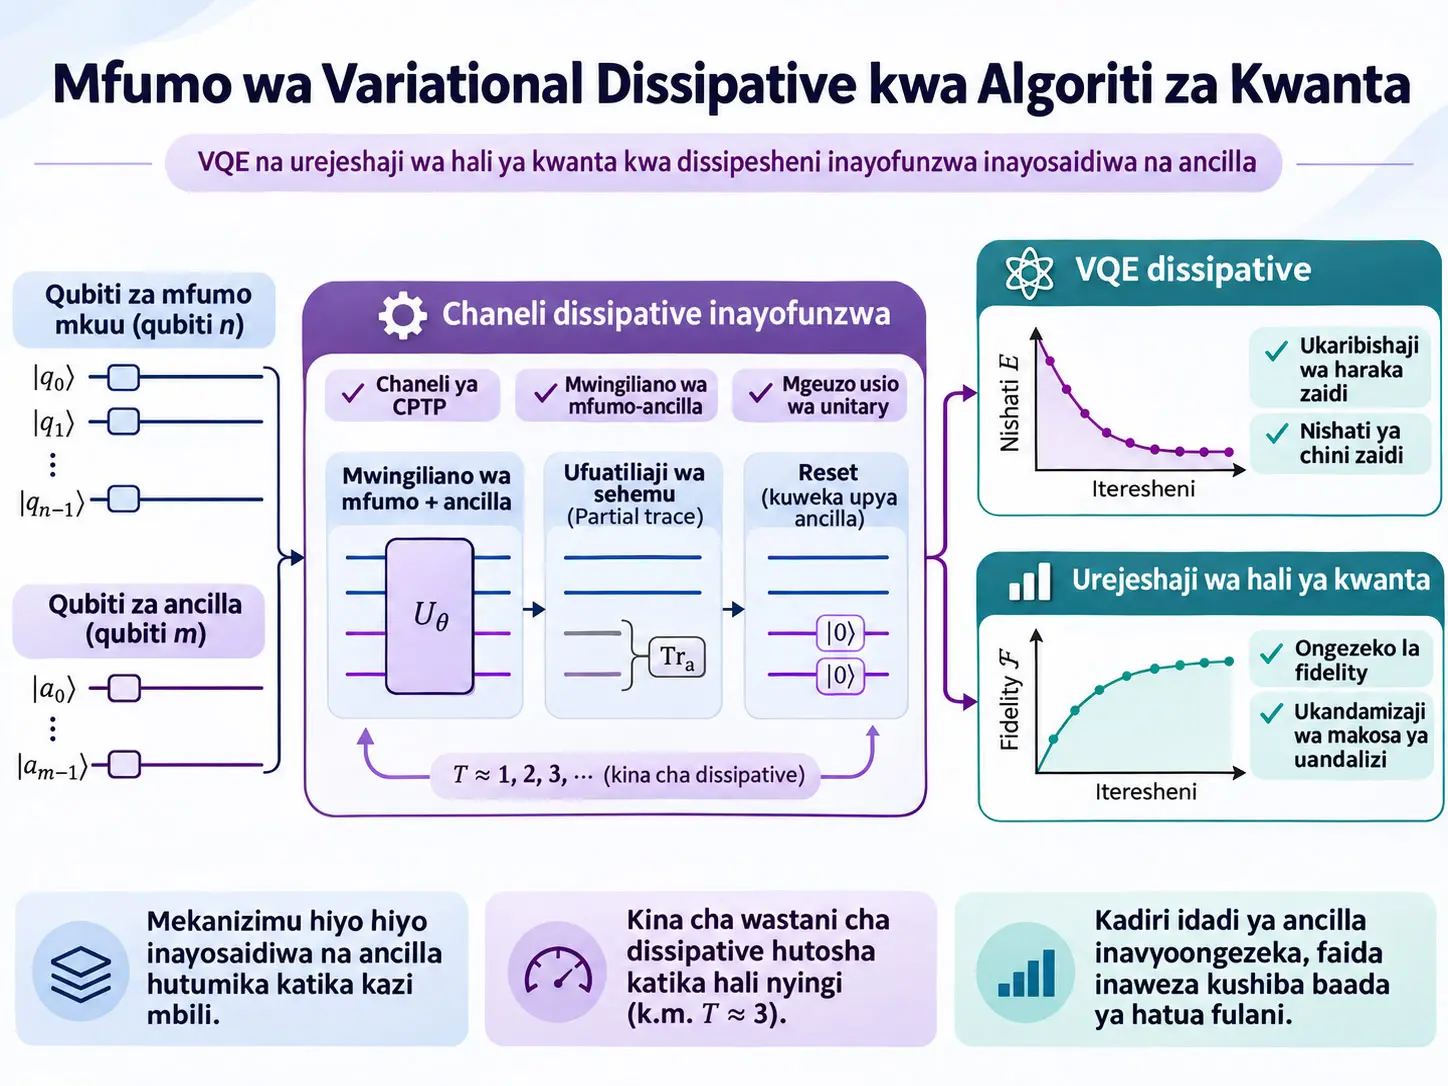
Mfumo wa variational dissipative ni mfumo wa kubuni algoriti za kwanta unaoongeza chaneli za kwanta za nonunitary, zinazosaidiwa na ancilla na zinazoweza kufundishwa, kwenye mabadiliko ya hali ya unitary pekee katika saketi za kawaida za kwanta zenye vigezo. Wakati qubit za mfumo mkuu zinachakatwa na kizuizi cha variational cha system-only chenye vigezo, qubit tofauti za ancilla huunganishwa na mfumo kwa namna inayodhibitiwa; baada ya unitary ya pamoja ya mfumo–ancilla, mfumo mdogo wa ancilla huondolewa kwa partial trace na kutayarishwa tena katika hali ya \(|0\rangle\). Hivyo, mabadiliko ya Completely Positive Trace-Preserving (CPTP), lakini kwa ujumla nonunitary, hupatikana kwenye mfumo mkuu. Utafiti unatumia utaratibu huu katika kazi mbili tofauti: dissipative Variational Quantum Eigensolver (VQE) inayopunguza nishati ya hali ya msingi, na dissipative state recovery inayoongeza fidelity ya hali ya kwanta iliyoandaliwa kwa kelele kuelekea hali lengwa.
Wazo kuu la utafiti ni kutumia dissipative si kama athari isiyotakiwa ya vifaa vya kwanta pekee, bali kama rasilimali ya variational inayoweza kuboreshwa pale mwingiliano sahihi wa mfumo–mazingira unapoundwa. Standard VQE inapoweka operesheni za unitary pekee kwenye hali safi ya awali, hubaki kwenye manifold ya hali safi. Mwingiliano na ancilla na baadaye kuondoa ancilla kwenye mfumo huruhusu mfumo mkuu kuingia katika mixed state na kuingiza kwenye nafasi ya utafutaji wa variational mabadiliko ya jumla zaidi ya CPTP yasiyoweza kufikiwa kwa mabadiliko ya unitary ndani ya mfumo pekee.
Katika majaribio ya namba ya VQE, modeli ilitathminiwa kwenye Hamiltonian za nearest-neighbor spin zenye masharti ya mpaka wazi. Katika jaribio wakilishi, \(J_x=1.0\), \(h_z=0.3\), coefficients nyingine ziliwekwa sifuri, learning rate \(lr=0.2\), idadi ya dissipative round \(T=1\), na depolarizing-noise strength \(p=0.1\) zilitumika. Katika mifumo mikuu ya \(n=3\) na \(n=5\), kadiri idadi ya ancilla ilivyoongezeka, nishati ilipungua kwa kasi zaidi katika iteresheni za mwanzo na final energy ilifikia viwango vya chini kuliko VQE isiyo na ancilla. Thamani za Exact ground-state energy, isipokuwa pale ilipoelezwa vinginevyo, zilichukuliwa kutoka exact diagonalization ya matriki za Hamiltonian husika.
Katika majaribio ya state-recovery, miundo mitatu tofauti lengwa ilitumiwa: W state, uniform superposition state, na dressed cluster state. Katika ulinganisho wa target-state chini ya masharti \(n=3\), \(m=3\), \(T=3\), \(lr=0.8\), na \(p=0.1\), final fidelity kwa malengo yote matatu ilipanda juu ya %99 ndani ya iteresheni 100 za uboreshaji. Hata hivyo, ongezeko lisilo na kikomo la rasilimali halikuonyesha faida endelevu: waandishi walitambua \(T=3\) kama uwiano mzuri katika majaribio mengi na waliona tabia ya ancilla saturation inayotegemea hali lengwa.
Matokeo yote ya utafiti yalipatikana kutoka kwenye simuleringi za namba; hakuna uthibitishaji wa majaribio uliofanywa kwenye kichakataji halisi cha kwanta. Zaidi ya hayo, matokeo ya “conditional exponential advantage” katika Kiambatisho B si ongezeko la kasi la wall-clock kwenye vifaa halisi wala quantum advantage isiyo na masharti. Matokeo haya ni ulinganisho wa kinadharia wa gradient-descent iteration complexity chini ya dhana kali, kama vile dissipative objective kutimiza sharti fulani la global Polyak–Łojasiewicz na trajectory ya uboreshaji ya ordinary unitary VQA kubaki exponentially flat.
Mfumo wa Variational Dissipative wa Kwanta ni Nini?
Mfumo wa variational dissipative wa kwanta ni mbinu inayounganisha saketi za parametric unitary na chaneli za kwanta za mfumo wazi zinazosaidiwa na ancilla na zinazoweza kufundishwa, na hivyo kupanua nafasi ya hali za variational za mfumo mkuu zaidi ya ansatz ya unitary iliyozuiliwa kwa hali safi; ingawa mwingiliano wa mfumo–ancilla ni unitary, kuondoa ancilla baadaye kwa partial trace huzalisha mabadiliko madhubuti ya CPTP yaliyo nonunitary kwenye mfumo mkuu.
Standard VQE hufanya nini kwanza?
Variational Quantum Eigensolver (VQE) huunganisha saketi ya kwanta yenye vigezo na uboreshaji wa klasiki ili kukadiria ground-state energy ya Hamiltonian fulani. Hali ya awali kwa kawaida huwa katika umbo la \(|0\rangle^{\otimes n}\), na unitary ya parametric \(U(\theta)\) hubadilisha hali hii kuwa trial state.
\(\rho_\theta\) ni uwakilishi wa density matrix wa variational trial state. \(n\) ni idadi ya qubit katika mfumo mkuu; \(\theta\) ni vigezo vinavyoboreshwa vya gate zenye vigezo. Kwa kuwa hali ya awali ni safi na \(U(\theta)\) ni unitary, hali katika Eq. (1) hubaki safi.
Energy objective ya VQE ni:
\(H\) ni Hamiltonian ambayo ground state yake inatafutwa; \(\operatorname{Tr}\) ni operesheni ya trace. Usemi huu huhesabu Hamiltonian expectation value ya trial state.
Variational principle:
hutoa ukosefu wa usawa huo. \(E_0\) ni ground-state energy halisi. Kwa hiyo VQE hujaribu kupunguza \(E(\theta)\); katika hali bora, trial state inapokaribia ground state, nishati hukaribia \(E_0\), lakini chini ya variational principle haiendi chini yake.
Upanuzi wa dissipative hubadilisha nini?
Wakati dissipative quantum channel yenye vigezo inapotumiwa badala ya standard unitary ansatz, trial state huandikwa kama:
\(\mathcal{D}_\theta\) ni chaneli ya CPTP yenye vigezo. Energy objective hubaki Eq. (2); kinachobadilika ni familia ya hali zinazoweza kufikiwa na uboreshaji. Mfumo mkuu sasa unaweza kuwakilisha si hali safi pekee, bali pia mixed state zinazoweza kutokea baada ya mwingiliano na ancilla.
Jambo hili halimaanishi kwamba “dissipative VQE lazima itoe matokeo bora kuliko standard VQE”. Mlinganyo unaonyesha tu kwamba nafasi ya utafutaji imepanuliwa hadi familia ya jumla zaidi ya quantum-channel; manufaa halisi yalijaribiwa tofauti kwa matokeo ya uboreshaji wa namba.
Tofauti kati ya hali safi na mixed state
Hali safi ya kwanta inaweza kuelezwa kikamilifu kwa state vector moja \(|\psi\rangle\), na density matrix yake ni \(\rho=|\psi\rangle\langle\psi|\). Mixed state huwakilisha mchanganyiko wa kitakwimu wa hali tofauti safi wenye kutokuwa na uhakika wa klasiki au wa kimazingira, na kwa ujumla haiwezi kuonyeshwa kwa state vector moja.
Baada ya ancilla na mfumo mkuu kuwa entangled, kupuuza taarifa ya ancilla kunaweza kufanya mfumo mkuu pekee uonekane kama mixed state. Huu ndio msingi wa kwa nini mfumo wa dissipative haupaswi kutafsiriwa kama circuit ya unitary iliyo na kina zaidi pekee.
Mfumo wazi wa kwanta ni nini?
Mfumo wazi wa kwanta ni mfumo wa kwanta usiotengwa kikamilifu na mazingira yake na unaoweza kuingiliana na degrees of freedom za nje. Mwingiliano huu unaweza kusababisha upotevu wa coherence, ubadilishanaji wa entropy na mtiririko wa taarifa kutoka mfumo kwenda mazingira.
Chini ya mkabala wa Born–Markov, chanzo kinatoa Gorini–Kossakowski–Lindblad–Sudarshan (GKLS) master equation kwa reduced dynamics za aina hii:
\(\rho_S\) ni density matrix ya mfumo mkuu; \(H_S\) ni Hamiltonian ya mfumo; \(L_k\) ni Lindblad jump operator; \(\gamma_k\) ni rate parameter ya dissipative process husika. \([A,B]=AB-BA\) ni commutator, na \(\{A,B\}=AB+BA\) ni anticommutator.
Hadi ya kwanza huwakilisha mabadiliko ya unitary ya Hamiltonian ya mfumo uliofungwa, na hadi zilizo katika jumla huwakilisha mabadiliko ya dissipative yanayotokana na mwingiliano na mazingira.
Tofauti muhimu: Mbinu ya saketi ya namba ya makala haisuluhishi moja kwa moja GKLS differential equation ya Eq. (5) kwa time integration. Mlinganyo wa GKLS unaeleza msingi wa kinadharia wa fizikia ya mfumo wazi; circuit construction halisi iliyopendekezwa imejengwa kupitia chaneli za CPTP zinazosaidiwa na ancilla.
Stinespring Dilation Huundaje Chaneli ya Kwanta?
Stinespring dilation inasema kwamba chaneli yoyote ya CPTP ya kwanta kwenye mfumo mkuu inaweza kuwakilishwa katika nafasi kubwa zaidi ya Hilbert ya mfumo–ancilla kama mabadiliko ya unitary yakifuatiwa na kuondolewa kwa ancilla kwa partial trace; utafiti huu hutumia usawa huu wa kihisabati kubuni system–ancilla interaction inayoweza kufundishwa.
Uwakilishi wa Stinespring
\(\mathcal{E}\) ni quantum channel madhubuti kwenye mfumo mkuu; \(V_{SA}\) ni unitary ya pamoja kwenye system \(S\) na ancilla \(A\); \(|0\rangle_A\) ni state ya awali ya ancilla; \(\operatorname{Tr}_A\) ni operesheni ya partial trace kwenye ancilla.
Partial trace haimaanishi “ancilla imeharibiwa kimwili”. Kihisabati, ni kuondoa taarifa ya degrees of freedom za ancilla kutoka kwenye matokeo wakati wa kupata reduced density matrix ya mfumo. Katika kiwango cha saketi, wazo hili linaweza kulingana na discard ya ancilla au ku-reset na kuitumia tena.
CPTP inamaanisha nini?
Completely Positive Trace-Preserving (CPTP) map ni darasa la kawaida la quantum-channel ya kimwili linalobadilisha density matrix halali kuwa density matrix halali. Trace-preserving huhakikisha jumla ya uwezekano inabaki 1, na complete positivity huhakikisha mabadiliko yanabaki halali kimwili hata mfumo ukiwa entangled na mfumo mkubwa wa rejea.
Uwakilishi wa Kraus
Projeksheni ya ancilla katika msingi wa orthonormal \(\{|i\rangle_A\}\):
hutoa Kraus operator na chaneli inaweza kuandikwa kama:
Stinespring dilation na Kraus representation si michakato miwili tofauti ya kimwili; ni maelezo mawili ya kihisabati ya mabadiliko yale yale ya CPTP.
Dissipative channel inayoweza kufundishwa katika makala
Kizuizi kilichopendekezwa hufanya umbo la Stinespring kuwa la parametric:
\(m\) ni idadi ya qubit za ancilla. Trainable parameters \(\theta\) zipo moja kwa moja ndani ya system–ancilla interaction. Ancilla hutayarishwa katika hali ya \(|0\rangle^{\otimes m}\) kabla ya kila matumizi na trace-out/reset mwishoni mwa matumizi.
Katika numerical implementation ya chanzo, dissipative module hutumia parametric single-qubit rotations kwenye qubit husika na system–ancilla \(i\mathrm{SWAP}\) couplings. Muunganisho ni fully connected: kila system qubit huunganishwa na kila ancilla qubit. Kwa hiyo, kwa \(n\) system qubit na \(m\) ancilla, ndani ya dissipative round moja:
kuna system–ancilla \(i\mathrm{SWAP}\) interaction. Usawa huu unatokana moja kwa moja na maelezo ya makala; total circuit gate count ni kubwa zaidi kwa sababu single-qubit rotations na system-only variational layers pia zipo tofauti.
iSWAP ya parametric hufanya nini?
Chanzo, katika Kielelezo cha Ziada 8, kinaonyesha coupling ya aina ya \(i\mathrm{SWAP}\) iliyotumiwa katika umbo lifuatalo:
Gate hii huchanganya kwa namna ya parametric vipengele vya \(|01\rangle\) na \(|10\rangle\); bloksi za \(|00\rangle\) na \(|11\rangle\) hubaki bila kubadilika katika matriki iliyoonyeshwa. Jukumu lake la kisayansi katika makala ni kutoa trainable coupling inayozalisha state/information exchange inayodhibitiwa kati ya mfumo mkuu na ancilla.
Tofauti Kuu Kati ya Dissipative VQE na VQE ya Kawaida ni Ipi?
Wakati VQE ya kawaida hubadilisha hali safi ya mwanzo kwenye mfumo kwa kutumia unitary za parametric pekee, dissipative VQE huongeza chaneli za CPTP zinazosaidiwa na ancilla kati ya tabaka hizo za unitary; hivyo upunguzaji wa nishati huboreshwa kwa pamoja katika vigezo vya coherent system-only na vigezo vya system–ancilla interaction, na reduced state ya mfumo mkuu inaweza kusogea katika familia pana ya variational inayojumuisha mixed state.
Ufafanuzi wa recursive wa Dissipative VQE
Hali ya mwanzo ya mfumo mkuu huchukuliwa kuwa:
Transformation ya kwanza ya system-only variational ni:
Kisha, kwa dissipative rounds za \(t=1,\ldots,T\):
Katika kila round, kwanza coherent variational transformation ya mfumo mkuu hutumika, kisha system–ancilla dissipative block. Baadaye ancilla hufanyiwa trace-out, huwekwa upya katika \(|0\rangle^{\otimes m}\), na hutumiwa tena kwa round inayofuata.
Final loss ni:
Kwa hiyo lengo la algoriti bado ni upunguzaji wa nishati; kilicho kipya ni familia ya transformations zinazozalisha trial state.
Kwa nini state recovery hutumia objective tofauti?
Katika kazi ya state-recovery, lengo si kutafuta ground-state energy. Lengo ni kuirudisha hali \(\rho_{\mathrm{in}}\), ambayo imeondoka kwenye target state kwa sababu ya kelele, karibu na lengo tena. Kwa hiyo tabaka za system-only VQE huondolewa na ancilla-assisted dissipative block ileile hufundishwa moja kwa moja kama recovery channel.
Target state huchukuliwa kuwa safi:
Mwanzo:
Kila recovery round hufafanuliwa kwa:
hivyo.
Fidelity hupima nini?
Fidelity ni metri isiyo na kipimo inayopima ukaribu wa quantum state mbili. Umbo la jumla la mixed-state ni:
Target state inapokuwa safi, usemi huu:
hurahisika kuwa hivyo. \(F_T=1\) inaonyesha fidelity ya juu kabisa kati ya final state na target state safi.
Recovery loss:
hufafanuliwa hivyo. Fidelity inapoongezeka, loss hupungua.
Kwa nini dissipation na recovery zinaweza kushughulikiwa ndani ya muundo uleule?
System–ancilla joint unitary ileile inaweza kuchakatwa kwa namna tofauti. Ancilla inapopuuzwa na kufanyiwa trace-out, unconditional dissipative channel hupatikana kwenye mfumo mkuu. Ancilla ikipimwa na measurement outcome ikatumika kwa conditional correction, mfumo huohuo uliopanuliwa unaweza pia kutafsiriwa kama mchakato wa recovery. Utafiti huu hutumia mbinu ya trainable channel kwa kufanya ancilla trace-out/reset katika protokali yake ya recovery.
Mbinu na Matokeo ya Utafiti
Benchmark Hamiltonian
Dissipative VQE ilijaribiwa kwenye nearest-neighbor spin Hamiltonian yenye open boundary conditions:
\(X_i\), \(Y_i\) na \(Z_i\) ni Pauli operators kwenye qubit ya \(i\). \(J_x,J_y,J_z\) ni nearest-neighbor interaction strengths; \(h_x,h_y,h_z\) ni local-field coefficients. Chanzo hakifafanui kitengo cha kimwili cha aina ya joule/eV kwa coefficients hizi au thamani za nishati; kwa hiyo Verianla haiwapi kitengo cha kimwili ambacho hakipo katika chanzo.
Jumla ya kwanza inawakilisha interaction ya jozi za spin jirani, na jumla ya pili inawakilisha local fields kwenye kila spin. Exact ground-state energy references zimehesabiwa kwa exact diagonalization ya matriki ya Hamiltonian isipokuwa pale ilipoelezwa vinginevyo.
Benchmark ya kwanza ya VQE
Jaribio wakilishi:
lilifanywa kwa uchaguzi huo, huku coefficients nyingine zikiwekwa kuwa sifuri. Kwa hivyo XX-type interaction na transverse Z field zilitumiwa pamoja.
| Parameta | Thamani iliyotumiwa katika chanzo | Jukumu la kisayansi |
|---|---|---|
| Ukubwa wa mfumo mkuu | \(n=3\) na \(n=5\) | Ukubwa mbili tofauti za tatizo |
| Idadi za ancilla | \(m=0,1,3,5,7\) | Uchunguzi wa rasilimali za dissipative channel |
| Learning rate | \(lr=0.2\) | Ukubwa wa hatua ya uboreshaji |
| Dissipative round | \(T=1\) | Round moja ya dissipative update |
| Noise | Depolarizing, \(p=0.1\) | Hali ya uboreshaji yenye kelele |
| Mwelekeo ulioonekana | \(m\) kubwa zaidi → kwa ujumla kushuka kwa nishati kwa kasi zaidi na final energy ya chini zaidi | Athari ya uboreshaji ya ancilla-assisted channel |
Katika grafu ya chanzo, mhimili x unaonyesha optimization iteration na mhimili y unaonyesha thamani ya energy. Katika mfano wa \(n=3\), mikunjo hutengana hatua kwa hatua kadiri idadi ya ancilla inavyoongezeka, huku tofauti ikiwa wazi zaidi katika mfano wa \(n=5\). Uchunguzi huu unaonyesha kuwa \(m\) kubwa zaidi ilitoa matokeo bora katika hali hizi zilizochunguzwa; si dhamana ya uboreshaji usio na kikomo na wa monotonic kwa thamani zote za \(m\).
Target states za state-recovery
Chanzo kilichagua miundo mitatu tofauti ya state.
1. W state:
W state ni superposition yenye amplitude sawa ya excitation moja tu katika nafasi zote \(n\) miongoni mwa computational basis states. Coefficient ya \(1/\sqrt{n}\) huhakikisha state normalization.
2. Uniform superposition state:
Hapa computational-basis bitstring zote \(2^n\) zipo kwa amplitude sawa.
3. Dressed cluster state:
Chanzo hutumia:
kwa \(i\) na \(d\) zote. \(CZ_{i,i+1}\) ni controlled-Z entangling gate kati ya neighboring qubits; \(R_y\) ni parametric single-qubit rotation kuzunguka mhimili Y.
Kuongezeka kwa ancilla katika state recovery
Katika Kielelezo cha Chanzo 3, ancilla-free baseline ya \(m=0\) inalinganishwa na dissipative configurations za \(m=1,2,3\). Mhimili X ni iteration, na mhimili y ni fidelity. Baada ya dissipative ancilla kuongezwa, fidelity hupanda juu ya noisy-input baseline, na kwa ujumla \(m\) kubwa zaidi hutoa recovery ya haraka zaidi pamoja na final fidelity ya juu zaidi.
Ustahimilivu katika noise channel tofauti
Chanzo hujaribu aina tatu kuu za noise:
- Amplitude Damping (AD): ni noise model ya kawaida inayowakilisha michakato ya aina ya energy relaxation ya \(|1\rangle\rightarrow|0\rangle\).
- Bit-Flip (BF): ni noise model inayoweza kugeuza computational basis states kwa kosa la Pauli-X.
- Depolarizing (DP): ni noise model ya kawaida inayoharibu state kuelekea random Pauli/mixed-state.
Maelezo haya mafupi matatu yametolewa ili kueleza maana ya lebo za kelele; si matokeo mapya ya kisayansi ya makala.
Chanzo kinapotumia kauli “fully noisy setting”, noise hutumika si tu kwenye main system variational circuit bali pia kwenye dissipative blocks. Hata hivyo, dissipative VQE iliconverge kwa kasi zaidi, ikawa na fluctuation chache, na kupata final energies za chini zaidi kuliko ancilla-free baseline.
Ingawa sentensi moja imeandika “DP, BP, AD”, ufafanuzi wa awali wa makala na legend ya grafu husika hutumia “BF” kwa Bit-Flip. Verianla haitafsiri hili kama noise model tofauti ya “BP”; inalihifadhi kama kutokuwiana kwa notation ndani ya chanzo.
Jaribio la robustness kwenye Hamiltonian tatu tofauti
Chanzo pia hulinganisha Hamiltonian tatu zifuatazo:
\(H_1\) hufafanuliwa kama XX-type model katika transverse Z field; \(H_2\) kama transverse-field Ising model; na \(H_3\) kama XXZ-type model. Ulinganisho huu ulifanywa katika fully noisy setting na chini ya depolarizing noise \(p=0.01\).
Kwa Hamiltonian zote tatu, dissipative VQE ilionyesha convergence ya haraka zaidi, training trajectory laini zaidi, na final energy iliyo karibu zaidi na exact ground-state energy kuliko ancilla-free baseline. Matokeo haya yanaunga mkono kwamba utendaji wa mbinu haukuwa maalum kwa energy landscape moja tu; hayathibitishi ubora wa jumla kwa madarasa yote ya Hamiltonian.
Matokeo ya target state tofauti na preparation noise
| Parameta | Thamani |
|---|---|
| System qubit | \(n=3\) |
| Ancilla | \(m=3\) |
| Dissipative round | \(T=3\) |
| Learning rate | \(lr=0.8\) |
| Noise strength | \(p=0.1\) |
| Noise comparison | DP, BF na AD |
| Target-state comparison | W, uniform superposition na dressed cluster |
Kwa input za target state zote tatu zilizotayarishwa kwa \(p=0.1\) depolarizing-noise, dissipative recovery iliinua final fidelity hadi zaidi ya %99 ndani ya 100 optimization iteration.
Matokeo haya ya %99 yanahusu moja kwa moja majaribio hayo matatu ya target-state. Si fidelity ya quantum hardware halisi na hayapaswi kujumlishwa moja kwa moja kwa system size nyingine.
Je, Ancilla Zaidi au Dissipative Round Zaidi Daima ni Bora?
Hapana. Resource scans za makala zinaonyesha kuwa utendaji hunufaika kwanza kutokana na kuongezeka kwa ancilla na dissipative-round, lakini baada ya hatua fulani rasilimali ya ziada hutoa faida ndogo tu au training/circuit overhead zaidi; hatua ya ancilla saturation katika kazi ya recovery hutegemea target state, na katika ulinganisho mwingi wa round \(T=3\) ilitumika kama chaguo lenye uwiano mzuri.
Athari ya idadi ya dissipative round
| Kazi | Hali kuu zilizotolewa katika kielelezo | Uchunguzi mkuu |
|---|---|---|
| Dissipative VQE | \(n=3\), \(m=3\), \(p=0.013\) | Round chache sana hazitoshi; katika jaribio wakilishi \(T=3\) hutoa uwiano bora wa jumla wa nishati. |
| State recovery | \(n=2\), \(m=3\), \(p=0.019\) | \(T=4\) au \(T=5\) zinaweza kuizidi \(T=3\) kwa kiasi kidogo baada ya takriban iteration 55; early convergence ni dhaifu zaidi na training ni ndefu zaidi. |
Paneli hizi mbili hazitumii hali zilezile za kimwili/hyperparameter; chanzo hakizitoi ili kufanya ulinganisho wa moja kwa moja wa ubora kati yao, bali kuonyesha kwamba resource trade-off inayofanana ipo katika kazi zote mbili.
Ancilla saturation
| Target state | Takriban saturation | Tafsiri |
|---|---|---|
| W state | \(m\approx2\) | Ancilla za ziada baada ya hapo hutoa fidelity gain ya ziada iliyo ndogo sana. |
| Uniform superposition | \(m\approx5\) | Inaonyesha hitaji la ancilla kubwa zaidi kati ya state tatu zilizochunguzwa. |
| Dressed cluster | \(m\approx3\) | Ancilla saturation ya kiwango cha kati huzingatiwa. |
Chanzo kinasema kuwa saturation haiwezi kuelezwa kwa kiasi cha entanglement cha target state pekee. Ancilla resource inayohitajika hutegemea kwa pamoja muundo wa preparation circuit, noise-induced error modes, na expressive compatibility ya dissipative ansatz iliyochaguliwa na error modes hizo.
Katika Kielelezo cha Chanzo 7, shaded region si statistical confidence interval. Kwa mujibu wa caption, ni envelope kati ya fidelity curves ya juu zaidi na ya chini zaidi iliyopatikana chini ya noise strengths tofauti kwa kila target state. Kwa hiyo itakuwa si sahihi kutafsiri eneo lenye kivuli kama standard deviation au %95 confidence interval.
Uchunguzi wa noise strength
Kielelezo cha Ziada 10 hulinganisha ordinary VQE na dissipative VQE inayotumia ancilla tano chini ya depolarizing-noise strengths tofauti. Katika kielelezo:
thamani hizo zinaonyeshwa. Katika ancilla-free VQE, tofauti kati ya converged energy na theoretical/exact ground-state value huongezeka kadiri noise strength inavyoongezeka. Katika \(m=5\) dissipative VQE, convergence hubaki ya haraka zaidi katika viwango vilevile vya noise na final energies huwa karibu zaidi na exact reference.
Matokeo haya hayamaanishi kwamba “dissipative circuit haiathiriwi na kelele”. Dai la chanzo ni robustness ya kulinganisha: katika hali zilizochunguzwa, chini ya noise ileile, dissipative model huacha energy gap ndogo kuliko ordinary baseline.
W-state fidelity gain na dokezo la “best 5 seeds”
Kielelezo cha Ziada 11 kinaonyesha fidelity gain ya \(F_m-F_0\) kwa W-state recovery dhidi ya noise strength na hutumia kuingiliana kwa kiasi kikubwa kwa gain curves baada ya \(m\ge2\) kama ushahidi wa ancilla saturation. Paneli za kielelezo zina usemi “The Best 5 Seeds”; hata hivyo, maandishi ya PDF kuu yaliyotolewa hayaelezi kwa undani jumla ya random-seed wala kanuni ya kuchagua seed hizo tano kama statistical protocol. Kwa hiyo confidence interval au population-level uncertainty haijatolewa kutoka kwenye kielelezo hiki.
Ukomo wa uripoti wa takwimu
Utafiti hauna muundo wa classic hypothesis testing. Maandishi makuu hayaripoti p-value, confidence interval au effect-size test. Alama \(p\) hapa mara nyingi ina maana ya noise strength / error probability; si statistical p-value.
Mielekeo katika grafu hutathminiwa kupitia optimization trajectories, na ground-state reference hupatikana kwa exact diagonalization. Kwa hiyo Verianla haiongezi lebo ya “statistical significance” ambayo haipo katika chanzo.
Vipengele visivyoripotiwa kwa upande wa reproducibility
PDF iliyotolewa inatoa baadhi ya hyperparameter muhimu: learning rate, idadi ya qubit/ancilla, idadi ya dissipative round, noise strength, Hamiltonian coefficients na miundo ya target-state preparation. Kwa upande mwingine, numerical section kuu hairipoti kwa undani software framework iliyotumika, jina kamili la optimizer, mbinu ya gradient-evaluation, random initialization distribution na seed/repetition protocol yote ya grafu kuu za matokeo.
Kiambatisho B huchanganua gradient descent kinadharia; hii haipaswi kutafsiriwa kuwa optimizer iliyotumika katika simulations kuu lazima ilikuwa sawa kabisa na idealized gradient-descent model ya Kiambatisho B.
“Faida ya Kipeo Yenye Masharti” kwa Dissipative VQA Inamaanisha Nini?
Faida ya kipeo yenye masharti katika makala si wall-clock speedup iliyopimwa kwenye quantum processor halisi; ni mgawanyiko wa kinadharia wa iteration-complexity unaoonyesha kuwa, chini ya dhana mahususi za smoothness, global Polyak–Łojasiewicz na trajectory-uniform flatness, gradient descent inaweza kupunguza dissipative VQA objective katika idadi ya iteration ya polynomial huku ordinary unitary VQA ikiweza kuhitaji idadi ya iteration ya exponential kufikia target gap hiyo hiyo.
Kwa nini Kiambatisho B kinapaswa kusomwa tofauti na majaribio makuu ya namba?
Kiambatisho B kinalinganisha ordinary VQA na dissipative VQA katika optimization model iliyo abstract zaidi. Hapa dissipative VQA hufafanuliwa kama reset-assisted quantum channel yenye periodic non-unital reset operations. Muundo huu unashiriki motisha ileile ya mfumo wazi na wazo la ancilla-assisted dissipative katika maandishi makuu; hata hivyo theorem si tu namna nyingine ya kuandika grafu kuu za namba.
Ufafanuzi wa Ordinary VQA: Milinganyo (25)–(26)
Parametric unitary ansatz:
na ordinary VQA state:
Cost:
\(O\) ni observable/cost operator inayoboreshwa. Katika muktadha wa VQE, \(O\) inaweza kuwa Hamiltonian.
Tofauti kati ya unital na non-unital channel
Unital quantum channel ni chaneli inayohifadhi identity operator kama identity. Non-unital channel hailazimiki kufanya hivyo. Reset ni non-unital na inaweza kutoa utaratibu wa kuhamisha entropy nje kwa sababu inaweza kuuelekeza mfumo kuelekea hali safi mahususi.
Kiambatisho B kinafafanua reset channel kama:
na kinachunguza zaidi hali ya \(q=1\). \(q=1\) inalingana na reset kamili ya subsystem \(R\) iliyochaguliwa hadi hali ya \(|0\rangle\).
Muundo wa chaneli wa Dissipative VQA: Milinganyo (27)–(30)
ambapo:
\(U_{\theta_{\mathrm{dis}}}^k\) ni parametric two-qubit layer; \(V^k\) ni fixed single-qubit gates; \(\mathcal{N}\) ni tensor product ya contractive unital single-qubit noise channels; \(\mathcal{A}_{\mathrm{nr}}\) ni non-unital reset map.
Dissipative VQA state:
na cost:
Katika maelezo ya kinadharia ya chanzo, tofauti muhimu kati ya ordinary unitary map na dissipative map ni uwezo wa non-unital reset-assisted transformation kuondoa entropy kutoka kwenye mfumo wakati wa hesabu.
Gradient descent: Milinganyo (31)–(32)
\(\eta_A\) ni learning rate / step size.
Kupungua kwa cost katika iteration moja na optimality gap:
\(\Delta C_{A,t}\) ni single-step improvement; \(\Delta_{A,t}\) ni umbali wa cost ya sasa kutoka optimum cost.
Dhana 1: Smoothness — Mlinganyo (33)
\(\beta_A\)-smoothness hudhani kuwa gradient haibadiliki kwa ukali usio na kikomo katika parameter space. Kwa gradient descent:
huchaguliwa. Chanzo pia hutumia dhana ya \(\beta_A=O(\operatorname{poly}(n))\).
Dhana 2: Unitary two-design
Katika initialization, inadhaniwa kuwa parametric unitaries zinatoka katika distribution inayounda unitary 2-design kwenye kila gate. Matokeo yake, mwanzoni:
na kwa hiyo:
uhusiano huu hutumika.
Dhana 3: Sharti la PL kwa Dissipative VQA — Mlinganyo (34)
Sharti la Polyak–Łojasiewicz (PL) linaunganisha norm ya gradient na cost gap hadi optimum. Ni dhana yenye nguvu ya optimization landscape inayozuia gradient kuporomoka kiholela hadi sifuri wakati gap bado ni kubwa. Matokeo ya global contraction ya Theorem 1 yanategemea sharti hili; makala haithibitishi kwamba linatimizwa kiotomatiki kwa dissipative quantum objectives zote.
Dhana 4: Trajectory-uniform flatness ya ordinary VQA — Mlinganyo (35)
\(m\) hapa ni idadi ya variational parameter; \(m\) hii ni matumizi ya herufi hiyo hiyo katika muktadha tofauti na alama ya ancilla-qubit katika maandishi makuu. Kwa hiyo maana ya alama inapaswa kusomwa kulingana na muktadha wa sehemu.
Factor ya \(b^{-n}\) inaonyesha kuwa gradient inaweza kupungua exponentially pamoja na system size \(n\). Dhana hii haitumiki kwa initialization pekee, bali kwa optimization trajectory yote husika hadi target gap \(\varepsilon\) ifikiwe; kwa hiyo ni sharti lenye nguvu sana.
Lemma 1: Kiwango cha chini cha kupungua kwa kila step — Milinganyo (36)–(37)
Matokeo haya ni halali kwa \(\beta\)-smooth \(f\) na \(0<\eta\le1/\beta\).
Kutoka smoothness:
hupatikana, na Eq. (36) hutokana baada ya kutumia kikomo cha step-size.
Lemma 2: Kiwango cha juu cha kupungua kwa kila step — Milinganyo (38)–(40)
Chanzo hutoa hili chini ya dhana kwamba norm ya Hessian imewekewa kikomo cha \(\beta\) katika segment husika.
Lemma 3: PL contraction — Milinganyo (41)–(44)
PL inequality na smoothness kwa pamoja hutoa exponential contraction ya gap ya gradient descent:
Hatua ya kati:
PL inequality ikitumika:
Lemma 4: Kikomo cha chini cha iteration kwa ordinary VQA iliyo flat — Milinganyo (45)–(47)
Expected gap ya mwanzo:
na lengo:
ikiwa hivyo:
Expected decrease kwa kila step:
Iteration zikijumlishwa:
Ikiwa gradient energy inabaki ndogo exponentially, expected cost improvement inayoweza kupatikana katika iteration moja pia huwa ndogo exponentially; kwa hiyo kupunguza optimality gap kwa kiasi kisichobadilika huhitaji iteration nyingi.
Theorem 1: Conditional global convergence ya Dissipative VQA — Milinganyo (48)–(52)
Dissipative cost:
Chini ya Assumption 1 na PL Assumption 3, ikiwa \(\eta_{\mathrm{dis}}=1/\beta_{\mathrm{dis}}\) itachaguliwa:
Idadi ya iteration inayohitajika kwa \(\Delta_{\mathrm{dis},T}\le\varepsilon\):
Ikiwa:
na logarithmic accuracy factor pia iko ndani ya kikomo cha polynomial:
Eq. (50),
hupatikana kwa kutatua inequality hii kwa \(T\).
Theorem 2: Conditional iteration-complexity separation — Milinganyo (53)–(56)
Kwa upande wa dissipative:
na kwa upande wa ordinary VQA:
ikidhaniwa, kwa dissipative VQA:
na kwa ordinary trajectory-flat VQA:
hupatikana.
Haya ndiyo matokeo ambayo waandishi wanayaita “conditional exponential advantage in gradient-descent iteration complexity”. “Advantage” hii ina mipaka mitatu muhimu:
- si kipimo cha runtime kwenye quantum device halisi;
- inategemea dissipative objective kutimiza PL condition;
- inategemea ordinary VQA kubaki trajectory-uniform exponentially flat hadi kufikia lengo.
Chanzo pia kinaweka kikomo hiki wazi: matokeo ya awali ya barren-plateau-avoidance peke yake hayathibitishi global convergence kwa dissipative VQA. Polynomial global iteration bound hutokea tu pamoja na dhana za ziada za PL na scaling.
Matokeo yanayoungwa mkono moja kwa moja na utafiti
Kimewekwa kimahesabu kwamba ancilla-assisted trainable dissipation huongeza quantum-channel degree of freedom kwenye standard system-only unitary ansatz.
Katika numerical VQE benchmarks zilizochunguzwa, dissipative VQE huonyesha energy descent ya haraka zaidi na final energy ya chini zaidi kuliko ancilla-free baseline.
Faida hii ya kulinganisha huhifadhiwa chini ya depolarizing, amplitude-damping na bit-flip noise, na katika representative Hamiltonian tatu tofauti.
Katika state recovery, dissipative block ileile huongeza final fidelity chini ya preparation-noise channels tofauti na target-state structures tofauti.
Katika ulinganisho wa target-state uliotathminiwa, final fidelity ya W, uniform-superposition na dressed-cluster state iliongezwa hadi zaidi ya %99 ndani ya 100 optimization iteration.
Inaonyeshwa kuwa kuna task-dependent saturation katika rasilimali za ancilla na dissipative-round; rasilimali zaidi hazitoi kila wakati faida ya ziada yenye uwiano sawa.
Kiambatisho B kinatoa conditional exponential separation kwa gradient-descent iteration complexity kati ya dissipative na ordinary VQA chini ya mathematical assumptions mahususi.
Matokeo ambayo utafiti hauungi mkono
Utafiti hauonyeshi speedup, quantum advantage au fault-tolerant operation kwenye quantum hardware halisi.
Utafiti hauonyeshi kwamba dissipation huondoa kabisa physical noise.
Utafiti hauthibitishi kuwa dissipative VQE ni bora kuliko ordinary VQE kwa kila Hamiltonian na kila system size.
Utafiti hauonyeshi kuwa utendaji utaongezeka bila kikomo kadiri idadi ya ancilla inavyoongezwa bila kikomo; badala yake unaona saturation.
Utafiti hauthibitishi kwamba PL condition katika Kiambatisho B hutimizwa kiotomatiki kwa dissipative circuits zote zilizopendekezwa.
Utafiti hauthibitishi kwamba ordinary VQA itaonyesha trajectory-uniform exponential flatness katika matatizo yote halisi ya uboreshaji.
Exponential iteration-complexity separation katika Theorem 2 si end-to-end computational speedup ya moja kwa moja wala hardware execution-time advantage.
Mapungufu makuu ya kimbinu
Simulation pekee: Hakuna hardware validation kwenye quantum processor ya kimwili.
Mifumo midogo: Numerical examples kuu zilizoonyeshwa ni spin systems za qubit chache na matatizo ya target-state recovery. Scaling ya system size kubwa zaidi imeachwa kuwa mada ya kazi ya baadaye.
Maelezo ya optimizer: Numerical section kuu inatoa thamani za learning rate lakini hairipoti kikamilifu maelezo ya software/optimizer implementation iliyotumika.
Seed/statistical protocol: Independent repetition na uncertainty protocol hazitolewi wazi kwa grafu kuu zote. Kielelezo cha Ziada 11 hutumia usemi “best 5 seeds” lakini hakielezi kwa kina jumla ya seed pool.
Resource overhead: Kila dissipative round katika fully connected system–ancilla architecture huhitaji \(nm\) iSWAP coupling. Ancilla na round zaidi huongeza circuit depth na mzigo wa trainable parameter.
Theoretical assumptions: Mgawanyiko mkubwa wa complexity katika Kiambatisho B unategemea dhana za PL na trajectory-flatness.
Noise realism: Modeli za AD, BF na DP zilizotumiwa ni controlled numerical noise models. Coherent calibration errors, crosstalk, leakage, non-Markovian effects na device-specific correlations katika kifaa halisi hazijathibitishwa kando.
Maelezo ya Chanzo na Mbinu
Kichwa asili: A Variational Dissipative Framework for Quantum Algorithms
Waandishi: Yuan Yao, Ruipeng Xing, Yongjian Gu, Yiming Huang, Xiao Yuan.
Mchango sawa: Hakuna alama ya mchango sawa/mwandishi wa kwanza sawa katika chanzo kilichotolewa.
Taasisi 1: Center on Frontiers of Computing Studies, Peking University, Beijing 100871, China.
Taasisi 2: School of Computer Science, Peking University, Beijing 100871, China.
Taasisi 3: Faculty of Information Science and Engineering, Ocean University of China, Qingdao 266100, China.
Taasisi 4: Institute of High Energy Physics, Chinese Academy of Sciences, Beijing 100049, China.
Taasisi 5: China Center of Advanced Science and Technology, Beijing 100190, China.
Corresponding author: PDF haitenganishi corresponding author mmoja kwa alama wazi. Chanzo kinatoa barua pepe za mawasiliano kwa Yuan Yao, Yongjian Gu, Yiming Huang na Xiao Yuan.
Dokezo la mawasiliano linaloonekana katika chanzo: Anwani ya barua pepe ya Yongjian Gu inaonekana kwenye PDF katika umbo `yjgu@.ouc.edu.cn`. Kwa kuwa umbo hili linaloonekana linaweza kuwa na tatizo la uandishi/formatting, Verianla haijalirekebisha kimya kimya.
Aina ya chanzo: Preprint.
Jukwaa: arXiv.
Eneo: quant-ph — Quantum Physics.
Kitambulisho cha arXiv: arXiv:2605.25841v1.
Tarehe ya kwanza ya kuwasilisha: 25 Mei 2026.
Tarehe iliyoonyeshwa kwenye PDF: 25 Mei 2026.
DOI: 10.48550/arXiv.2605.25841.
Hali ya peer review: Katika ukaguzi wa tarehe 13 Novemba 2026, journal version of record tofauti iliyopitiwa na rika haikuthibitishwa; utafiti unapaswa kushughulikiwa kama preprint katika Verianla.
Jarida / juzuu / toleo: Hakuna kwa sababu journal publication iliyothibitishwa haijapatikana.
Kiungo rasmi: https://arxiv.org/abs/2605.25841
Leseni: Hakuna leseni wazi ya Creative Commons ya matumizi tena kwenye PDF iliyopakiwa. Upatikanaji wa arXiv haujachukuliwa kuwa ruhusa isiyo na kikomo ya kutumia tena vielelezo vya chanzo.
Aina ya kisayansi ya utafiti: Mfumo wa kinadharia wa taarifa za kwanta za mfumo wazi + variational quantum algorithm design + numerical simulation + conditional optimization-complexity analysis.
Quantum hardware halisi: Haikutumiwa / haikuripotiwa.
Mbinu kuu: Kuunganisha system-only parametric variational layers na ancilla-assisted trainable CPTP dissipative channels.
Dissipative implementation: Parametric single-qubit rotations + fully connected system–ancilla \(i\mathrm{SWAP}\) couplings; kwa kila dissipative round, \(nm\) system–ancilla iSWAP interaction.
Mchakato wa Ancilla: Partial trace na reset mwishoni mwa kila round.
Kazi 1: Ground-state search kwa Dissipative VQE; objective ni final energy expectation value.
Kazi 2: Dissipative state recovery; objective ni target-state fidelity.
VQE benchmark reference: Exact ground-state energies zimehesabiwa kwa exact diagonalization isipokuwa pale ilipoelezwa vinginevyo.
Noise models: Depolarizing, Bit-Flip na Amplitude Damping.
Target states: W state, uniform superposition state na dressed cluster state.
Matokeo muhimu ya namba: Katika target-state experiments zilizochunguzwa, chini ya \(n=3\), \(m=3\), \(T=3\), \(lr=0.8\) na \(p=0.1\), final fidelity kwa target zote tatu ilipanda zaidi ya %99 ndani ya iteration 100.
Matokeo ya rasilimali: Moderate dissipative depth inatosha kwa majaribio mengi; chanzo hutumia \(T=3\) kama hatua ya jumla ya uwiano na huripoti state-dependent ancilla saturation.
Approximate ancilla saturation: W state \(m=2\), uniform superposition \(m=5\), dressed cluster \(m=3\).
Matokeo ya Kiambatisho B: Chini ya dhana za ziada zinazojumuisha PL na trajectory-uniform flatness, tabia ya gradient-descent iteration-complexity ya polynomial kwa dissipative VQA na ya exponential kwa ordinary VQA hutolewa. Matokeo haya yana masharti na si hardware speedup.
Ufadhili: Quantum Science and Technology-National Science and Technology Major Project (2023ZD0300200); Beijing Natural Science Foundation Z250004; NSAF U2330201; National Natural Science Foundation of China 12361161602; Beijing Science and Technology Planning Project Z25110100810000; High-performance Computing Platform of Peking University.
Upatikanaji wa data: Hakuna Data Availability statement tofauti katika PDF iliyotolewa.
Code availability: Hakuna Code Availability statement tofauti katika PDF iliyotolewa.
Mgongano wa maslahi: Hakuna competing-interest/conflict-of-interest statement tofauti katika PDF iliyotolewa; kwa hiyo haijadhaniwa kuwa hakuna mgongano wa maslahi.
Michango ya waandishi: Hakuna CRediT au author-contribution statement tofauti katika PDF iliyotolewa.
Ukomo wa reproducibility: Ingawa chanzo kinaripoti mipangilio muhimu ya kimwili na hyperparameter, software framework, maelezo ya optimizer na seed/repetition protocol yote ya numerical implementation kuu hayajatolewa kikamilifu.
Dokezo la notation ndani ya chanzo: Ingawa Bit-Flip noise hufafanuliwa kama BF katika sehemu nyingi, kifupi BP kinaonekana katika sentensi moja; hakijatafsiriwa kama noise model mpya.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *