

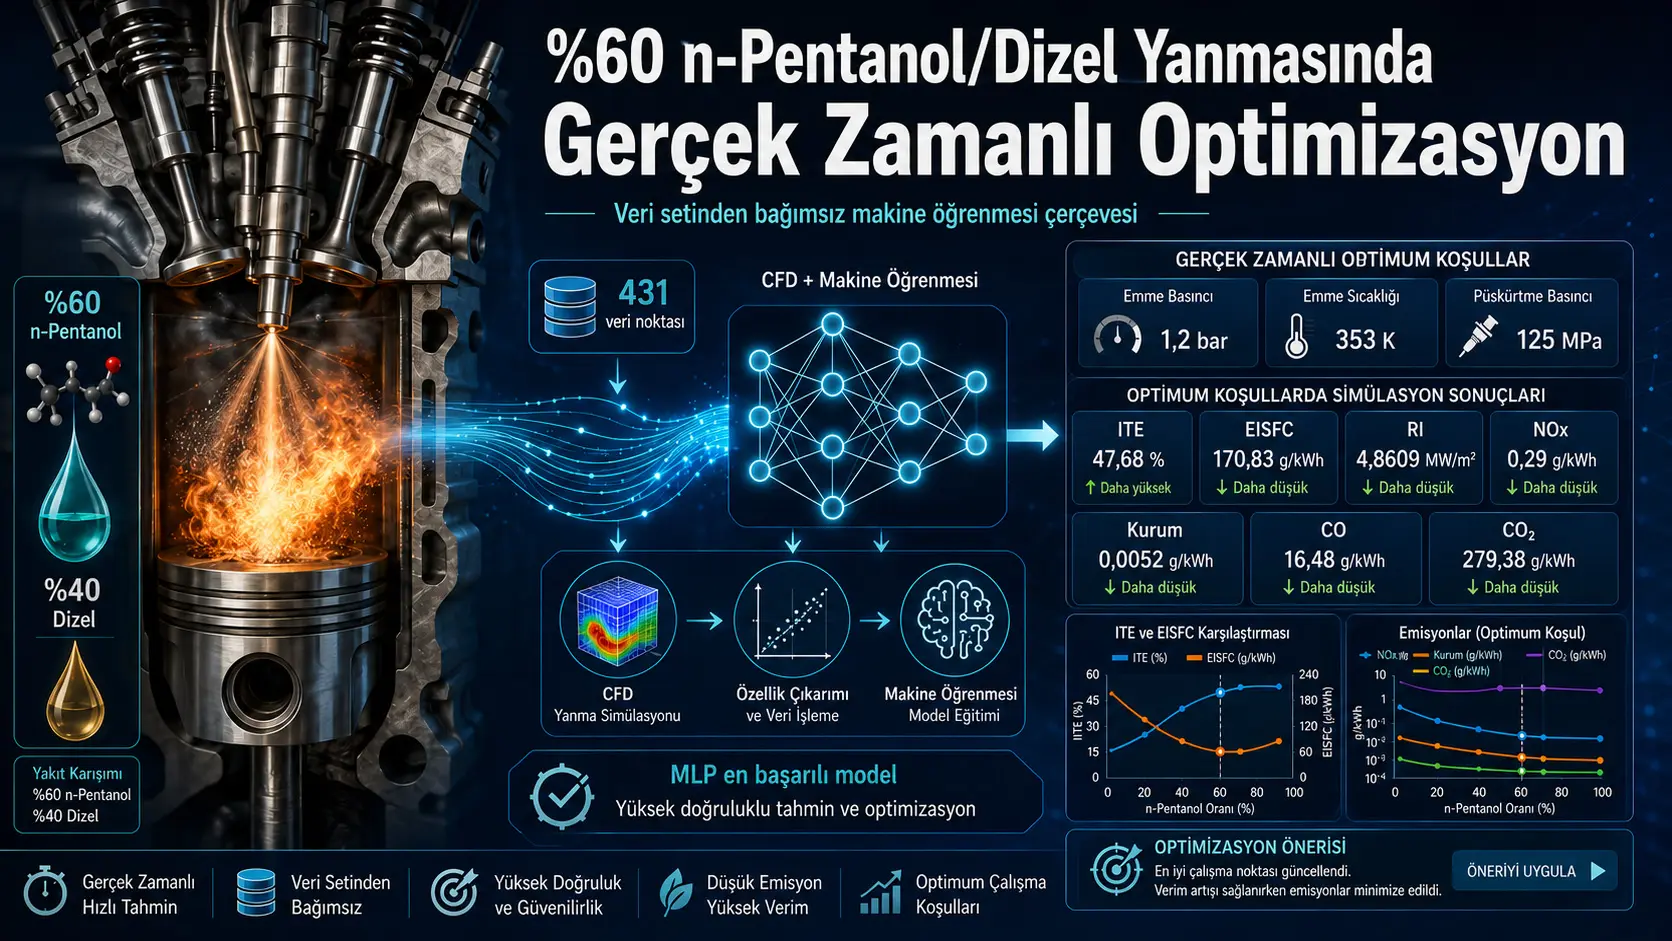
Utafiti huu umeunda dataset-agnostic machine-learning framework ya kutabiri performance, combustion intensity na exhaust emissions za compression-ignition engine inayotumia mixture ya %60 n-pentanol na %40 diesel kutoka engine-control variables tatu. Utafiti ulitumia 431 data samples zilizozalishwa kwa validated three-dimensional computational fluid dynamics model; kutoka intake pressure, intake temperature na injection pressure, indicated thermal efficiency, equivalent indicated specific fuel consumption, ringing intensity, NOx, soot, CO na CO2 zilitabiriwa. Multilayer perceptron neural network ilikuwa model yenye mafanikio zaidi kwa ujumla, huku support vector machine ikionyesha small advantage kwenye baadhi ya metrics kwa ringing intensity na NOx. Hata hivyo, study haijapitia peer review; training data hazikutokana na new independent engine experiments bali kutoka previously validated CFD model, na generalizability ya system kwenye different independent datasets haijaonyeshwa moja kwa moja.
Five supervised-learning models zililinganishwa: multilayer perceptron (MLP), random forest (RF), extreme gradient boosting (XGBoost), support vector machine (SVM) na k-nearest neighbors (KNN). %80 ya data samples zilitengwa kwa training na %20 kwa test; scaler ilifit kwenye training data pekee ili kupunguza data leakage.
MLP model ilifikia R² = 0,9491 katika indicated thermal efficiency, R² = 0,9439 katika equivalent indicated specific fuel consumption, R² = 0,9513 katika soot, R² = 0,9612 katika CO na R² = 0,8983 katika CO2. Kwa ringing intensity, SVM ilikuwa na R² ya 0,8959 na MLP 0,8953. Kwa NOx, SVM yenye R² = 0,8856 ilikuwa slightly above MLP value ya 0,8791.
Input conditions zilizowasilishwa kama optimum katika study ni intake pressure 1,2 bar, intake temperature 353 K na injection pressure 125 MPa. Katika point hii CFD simulation ilitoa %47,68 indicated thermal efficiency, 170,83 g/kWh equivalent indicated specific fuel consumption, 4,8609 MW/m² ringing intensity, 0,29 g/kWh NOx, 0,0052 g/kWh soot, 16,48 g/kWh CO na 279,38 g/kWh CO2. MLP predictions zilikuwa very close to simulation kwa efficiency, fuel consumption, CO na CO2, huku differences za NOx na ringing intensity zikiwa kubwa zaidi.
Python/Django interface iliyotengenezwa inaruhusu users kupakia CSV au XLSX files, kuchagua input na target columns, kuretrain models, kuona R², MAE na RMSE results na kutengeneza instant prediction kwa specified engine conditions. Neno “real-time” hapa linaeleza fast prediction ya trained model; study haionyeshi closed-loop real-time engine control iliyounganishwa na engine control unit.
Swali kuu la utafiti ni lipi?
Swali kuu ni kama performance na emissions za engine katika low-load condition kwa high-ratio n-pentanol/diesel blend yenye %60 n-pentanol zinaweza kutabiriwa kwa accuracy ya kutosha bila time-consuming new experiments au CFD calculations zinazorudiwa kwa every operating point.
Study inatafuta specifically majibu kwa maswali yafuatayo:
- Je, seven engine outputs zinaweza kutabiriwa simultaneously kwa intake pressure, intake temperature na injection pressure?
- Ni algorithm ipi kati ya five different machine-learning algorithms inatoa overall best result?
- Je, trained model inaweza kutumika kama faster surrogate model badala ya CFD?
- Je, interface inaweza kutengenezwa bila hard-coding data na target columns, ili different researchers wapakie own datasets?
- Je, efficiency, consumption, ringing na emissions zinaweza kuwekwa pamoja katika acceptable levels kwa specified engine conditions?
Kwa nini study ni muhimu?
Intake pressure, intake temperature, injection pressure, injection timing, load na fuel composition za compression-ignition engine huunda many interacting variables. Kupima every combination experimentally kunahitaji engine kufikia steady state, kurekodi fuel-consumption na pressure data, na kuchambua exhaust samples. High-resolution CFD simulations pia hutumia significant computation time kwa sababu ya combustion chemistry, spray breakup na emission models.
Machine learning inaweza kujifunza relationship ndani ya pre-generated dataset na kuhesabu possible outcome ya new input combination kwa muda mfupi zaidi. Approach hii hailengi kuchukua nafasi ya physical engine au CFD model, bali kujenga surrogate model inayofanya kazi ndani ya previously validated data domain.
Kwa nini n-pentanol imechunguzwa?
n-Pentanol ni oxygenated higher alcohol inayomiscible na diesel. Introduction ya study inaeleza kwamba energy density ya n-pentanol iko closer to diesel fuel kuliko lower alcohols kama ethanol na butanol, inamix vizuri na diesel na ni relatively resistant kwa phase separation during storage.
Presence of oxygen ndani ya fuel molecule inaonekana kama property inayoweza kupunguza soot formation katika fuel-rich regions. Hata hivyo, high n-pentanol ratios zinaweza pia kubadilisha ignition behavior, evaporation, cylinder-pressure rise na fuel consumption. Kwa hiyo haitoshi kuboresha single output; efficiency, consumption, combustion intensity na different emissions lazima zitathminiwe pamoja.
Ni literature gap gani iliyolengwa?
Kulingana na literature review ya paper, ingawa kuna machine-learning applications kwa lower n-pentanol ratios au other biofuel blends, comprehensive modeling ya P60D40 mixture yenye %60 n-pentanol under low-load conditions kwa simultaneously varying intake pressure, intake temperature na injection pressure ni limited.
Researchers walifafanua gaps mbili kuu:
- Ukosefu wa broad low-load dataset kwa %60 n-pentanol mixture yenye three control variables na seven engine outputs together.
- Ukosefu wa real-time decision-support interface isiyofungwa kwa single fixed dataset na inayotoa model training, comparison, prediction na data export katika mazingira yale yale.
Ingawa sehemu moja ya paper inatumia phrase “six machine-learning models,” methods, tables, graphs na software interface zinafafanua only five models. Hakuna name, hyperparameter au result ya sixth algorithm. Kwa hiyo study inapaswa kuchukuliwa kuwa ililinganisha five models kwa vitendo.
CFD dataset iliundwaje?
Training data za machine-learning models hazikutokana directly na new engine test campaign, bali zilipatikana kutoka three-dimensional CFD model iliyoundwa kwa CONVERGE v3.0. Model inawakilisha four-cylinder, four-stroke, electronically controlled diesel engine.
Ili kupunguza computational cost, 45-degree sector ya combustion chamber ilimodeliwa. Base cell size iliwekwa 3 mm na second-level adaptive mesh refinement ilitumika karibu na injector nozzle.
| Physical process | Model or approach used |
|---|---|
| Turbulence | RNG k-ε model |
| Spray breakup | Kelvin-Helmholtz-Rayleigh-Taylor (KH-RT) model |
| Combustion chemistry | SAGE detailed chemistry solver |
| Fuel chemistry | Reduced n-pentanol/n-dodecane mechanism with 75 species and 367 reactions |
| Diesel-fuel surrogate | n-Dodecane |
| NOx formation | Extended Zeldovich model |
| Soot formation | Hiroyasu model |
Authors wanaripoti kwamba CFD model ilionyesha good agreement na experimental data katika previous work. Hata hivyo, current paper haitoi new experimental validation graph au new raw engine-test data; inarejea previous validation. Kwa hiyo machine-learning accuracy si independent na accuracy ya underlying CFD model.
Engine iliendeshwa katika conditions gani?
Data generation ilifanywa chini ya low-load condition:
- Engine speed: 1.500 rpm
- Indicated mean effective pressure: approximately 3,8 bar
- Total fuel energy: 400 J per cycle
- Exhaust-gas recirculation: %0
- Intake-pressure range: 1,1-1,4 bar
- Intake-temperature range: 343-353 K
- Injection-pressure range: 75-125 MPa
Kuweka fuel energy per cycle constant at 400 J kulilenga kulinganisha different input conditions kwa same approximate engine load. EGR iliwekwa %0 ili effect ya intake thermodynamics isichanganywe na exhaust-gas dilution.
Inputs na target outputs ni zipi?
| Type | Variable | Unit or meaning |
|---|---|---|
| Input | Intake pressure | bar |
| Input | Intake temperature | K |
| Input | Injection pressure | MPa |
| Output | Indicated thermal efficiency (ITE) | % |
| Output | Equivalent indicated specific fuel consumption (EISFC) | g/kWh |
| Output | Ringing intensity (RI) | MW/m² |
| Output | Nitrogen oxides (NOx) | g/kWh |
| Output | Soot | g/kWh |
| Output | Carbon monoxide (CO) | g/kWh |
| Output | Carbon dioxide (CO2) | g/kWh |
Ringing intensity inawakilisha acoustic na mechanical combustion severity inayohusishwa na very rapid rise ya in-cylinder pressure. Higher RI value inaonyesha harsher na potentially riskier combustion behavior.
Ni operating points gani ziliondolewa kutoka dataset?
Wakati machine-learning dataset ikiundwa, operating points zinazozidi limits zifuatazo ziliripotiwa kuondolewa:
- EISFC > 240 g/kWh
- NOx > 0,4 g/kWh
- Soot > 0,01 g/kWh
- RI > 8 MW/m²
Filtering hii ilifanya models zifocus kwenye predefined feasible region badala ya operating points zilizochukuliwa technically unacceptable. Lakini kuna important interpretation limit: model inaweza kuwa haikujifunza high-emission au severe-combustion conditions nje ya filtered limits. Kwa hiyo prediction reliability kwa inputs nje ya safe operating region haijaonyeshwa.
Katika data-record screen ya interface, baadhi ya samples above 8 MW/m² au 0,4 g/kWh NOx zinaonekana. Haijaelezwa kama screen hii inawakilisha filtered P60D40 training dataset au different example file iliyotumika kuonyesha software data-upload function.
Machine-learning-CFD workflow iliundwaje?
First figure ya study inaonyesha five-stage workflow:
- Kufafanua limits za intake pressure, intake temperature na injection pressure.
- Ku-run input combinations hizi kwa CFD ili kutengeneza engine outputs.
- Kutrain MLP, RF, XGBoost, SVM na KNN models kwa CFD dataset.
- Kulinganisha predictions na CFD results kwa R², MAE na RMSE.
- Kutengeneza instant engine-performance na emission predictions kwa selected model na interface.
Figure ina phrase genetic algorithm katika generation ya initial operating points. Hata hivyo, population size, objective function, crossover, mutation au stopping criteria za genetic algorithm hazijaelezwa katika methods. Kwa hiyo exact way genetic algorithm ilichagua data points haijatolewa kwa reproducible detail.
Multilayer perceptron neural network inafanyaje kazi?
MLP inajifunza nonlinear relationships katika seven engine outputs kwa kupitisha three engine inputs kupitia interconnected hidden layers. Output ya neuron imeonyeshwa katika study kama:
\[ MLP = \phi\left(\sum_{j=1}^{n} w_jx_j+b\right) \]
\[ \phi(x)=\max(0,x) \]
Hapa xj ni input variable, wj learned weight, b bias term na φ rectified linear unit (ReLU) activation. ReLU hubadilisha negative values kuwa zero huku ikihifadhi positive values.
Study ilitumia 100 neurons katika kila moja ya two hidden layers. Model iliruhusiwa maximum 2.000 iterations na random seed ikawekwa 42.
Random-forest model inatengenezaje prediction?
Random forest hujenga many decision trees kwa kutumia different sample na variable subsets za same dataset. Regression prediction hupatikana kwa averaging tree outputs:
\[ \hat{y}=\frac{1}{M}\sum_{m=1}^{M}T_m(x) \]
M ni total number of decision trees na Tm(x) ni prediction ya m-th tree kwa input x. Study ilitumia 100 trees. At least one sample per leaf, at least two samples for split na bootstrap sampling zilichaguliwa.
XGBoost model inafanyaje kazi?
XGBoost huongeza decision trees sequentially badala ya independently. Kila new tree hujaribu kupunguza errors za previous trees. Objective function imetolewa kama:
\[ L = l(y,\hat{y})+\sum_{k=1}^{K}\Omega(f_k) \]
l(y,\hat{y}) inawakilisha loss kati ya actual na predicted value, na Ω(fk) ni regularization term inayopenalize complexity ya k-th tree. Hivyo model inalenga si kupunguza training error pekee bali pia kuepuka unnecessary complexity.
Study ilitumia squared-error regression objective, learning rate 0,3 na 100 trees.
Support vector machine ilitumikwaje?
SVM hujenga regression surface inayokaribia relationship kati ya inputs na target outputs ndani ya specified error tolerance. Kwa linear kernel, paper inatoa basic relation:
\[ F(X_i,X_j)=X_i\cdot X_j \]
Xi na Xj ni input vectors. Hata hivyo, actual model ilitumia radial basis function (RBF) kernel badala ya linear kernel. RBF kernel inaweza kuwakilisha nonlinear engine behavior.
Kwa SVM, C = 1, ε = 0,1 na gamma = “scale”.
K-nearest-neighbor prediction ilifanywaje?
KNN hulinganisha new engine condition na most similar operating points katika training data na kutumia weighted average ya neighbor outputs:
\[ \hat{y}_i=\sum_{j=1}^{k}w_{ij}y_{ij} \]
\[ \sum_{j=1}^{k}w_{ij}=1 \]
yij ni observed output katika j-th nearest neighbor ya i-th new example, na wij ni weight iliyotolewa kwa neighbor huyo. Study ilichagua k = 5 na leaf size 30.
Model training ilifanywaje?
Kati ya total 431 data samples, %80 zilitengwa randomly kwa training na %20 kwa test. Hii ni takribani 345 training na 86 test samples; PDF haitoi exact integer split separately.
Scales za input na target variables ni very different. Kwa mfano, intake pressure iko range 1,1-1,4, injection pressure range 75-125 MPa, huku soot ikiwa katika thousandths level. Ili scale difference isielekeze learning, all inputs na targets zili-standardizewa.
Kufit scaler kwenye training data pekee kunalenga kuzuia mean au standard-deviation information ya test data kuingia kwenye training stage.
Hyperparameters ni zipi?
| Model | Hyperparameter | Value |
|---|---|---|
| RF | Number of trees | 100 |
| RF | random_state | 42 |
| RF | min_samples_split | 2 |
| RF | min_samples_leaf | 1 |
| RF | bootstrap | True |
| XGBoost | Objective | reg:squarederror |
| XGBoost | Learning rate | 0,3 |
| XGBoost | Number of trees | 100 |
| MLP | Hidden-layer sizes | (100, 100) |
| MLP | Maximum iterations | 2.000 |
| MLP | Activation | ReLU |
| MLP | random_state | 42 |
| KNN | Number of neighbors | 5 |
| KNN | Leaf size | 30 |
| SVM | Kernel | RBF |
| SVM | ε | 0,1 |
| SVM | C | 1 |
| SVM | Gamma | scale |
Paper inasema hyperparameters “zilitunewa kwa uangalifu,” lakini haitoi comprehensive grid search, random search, Bayesian optimization au cross-validation results. Parameters nyingi zimeachwa katika default values. Kwa hiyo model comparison ni zaidi comparison ya selected configurations kuliko absolute best structure ambayo kila algorithm inaweza kufikia.
R², MAE na RMSE zinapima nini?
Model performance ilitathminiwa kwa metrics tatu.
Coefficient of determination
Katika PDF, Equation 6 ime-typeset kama:
\[ R^2=1-\frac{\sum_{k=1}^{N}(y_k-\hat{y}_k)}{\sum_{k=1}^{N}(y_k-\bar{y})} \]
Typesetting warning: Squares za differences hazionekani katika printed equation. Form hii haiendani na standard R² definition iliyoelezwa kwenye text. Ili kueleza logic ya study, standard relation inaweza kufikiriwa kama:
\[ R^2=1-\frac{\sum_{k=1}^{N}(y_k-\hat{y}_k)^2}{\sum_{k=1}^{N}(y_k-\bar{y})^2} \]
yk ni actual value, ŷk model prediction, ȳ mean ya actual values na N sample count. R² inapokaribia 1 inaonyesha model inaeleza larger portion ya data variability.
Mean absolute error
\[ MAE=\frac{1}{n}\sum_{k=1}^{n}|y_k-\hat{y}_k| \]
MAE inaaverage absolute magnitude ya all prediction errors. MAE ina same unit na target variable.
Root mean square error
Katika PDF, Equation 8 inaonekana kama:
\[ RMSE=\sqrt{\frac{1}{N}(y_k-\hat{y}_k)^2} \]
Typesetting warning: Summation symbol juu ya samples haionekani katika equation. Ili kueleza RMSE definition katika text, standard form ni:
\[ RMSE=\sqrt{\frac{1}{N}\sum_{k=1}^{N}(y_k-\hat{y}_k)^2} \]
Kwa sababu errors zinasquarewa, RMSE inapenalize large errors strongly zaidi kuliko MAE.
Ni model gani ilikuwa most successful?
MLP ilitoa highest R² katika five of seven targets. SVM, hata hivyo, ilitoa small advantage kwenye baadhi ya metrics kwa ringing intensity na NOx.
| Target | Model with highest R² | R² | MAE | RMSE |
|---|---|---|---|---|
| ITE | MLP | 0,9491 | 0,0750 | 0,0970 |
| EISFC | MLP | 0,9439 | 0,2895 | 0,3763 |
| RI | SVM | 0,8959 | 0,7376 | 1,1006 |
| NOx | SVM | 0,8856 | 0,0374 | 0,0604 |
| Soot | MLP | 0,9513 | 0,0002 | 0,0002 |
| CO | MLP | 0,9612 | 0,5269 | 0,7425 |
| CO2 | MLP | 0,8983 | 1,5484 | 2,1746 |
Kwa RI, SVM R² na RMSE values ni slightly better kuliko MLP; lakini MLP MAE value ya 0,7106 ni lower kuliko SVM value ya 0,7376. Kwa hiyo model ipi ni “best” kwa RI inategemea selected metric.
Kwa NOx, SVM ilifanya better kuliko MLP katika all three metrics: R² 0,8856 dhidi ya 0,8791, MAE 0,0374 dhidi ya 0,0398, na RMSE 0,0604 dhidi ya 0,0621.
Other models ziliperform vipi?
| Model | ITE R² | EISFC R² | RI R² | NOx R² | Soot R² | CO R² | CO2 R² |
|---|---|---|---|---|---|---|---|
| RF | 0,9263 | 0,9273 | 0,8231 | 0,8032 | 0,9117 | 0,9465 | 0,8772 |
| XGBoost | 0,9009 | 0,9041 | 0,8331 | 0,8210 | 0,9315 | 0,9481 | 0,8600 |
| MLP | 0,9491 | 0,9439 | 0,8953 | 0,8791 | 0,9513 | 0,9612 | 0,8983 |
| KNN | 0,8914 | 0,8910 | 0,8476 | 0,8550 | 0,9412 | 0,9446 | 0,8718 |
| SVM | 0,9327 | 0,9323 | 0,8959 | 0,8856 | 0,9305 | 0,9340 | 0,8966 |
Random forest ilitoa strong results katika efficiency na consumption, lakini ikabaki nyuma ya MLP na SVM katika NOx prediction ikiwa na R² = 0,8032. XGBoost ilikuwa strong kwa soot na CO lakini haikuzidi MLP. KNN efficiency na consumption R² values zilibaki karibu 0,89; researchers walitathmini overall prediction capability yake kuwa more limited kuliko other models.
Ni trends gani zinaonekana katika prediction-actual graphs?
Katika seven prediction-actual plots za MLP, ideal prediction inawakilishwa na points kukusanyika kwenye 45-degree line. Indicated thermal efficiency, fuel consumption, soot na CO points zimecluster relatively tightly karibu na line hii.
Katika ringing-intensity na NOx plots, scatter inaongezeka especially kwa high actual values. Visual trend hii inaendana na variables hizi mbili kuwa na lower R² na higher relative errors.
Katika CO2 plot, overall linear trend imehifadhiwa lakini baadhi ya low-valued examples zimejitenga zaidi na prediction line. Haijaelezwa kama red shaded bands kwenye plots ni statistically confidence intervals, prediction intervals au regression visualization pekee.
Web interface inafanyaje kazi?
Study ilitengeneza web-based graphical user interface kwa Python na Django. System architecture ina workflow ifuatayo:
- User authentication.
- Ikiwa administrator privileges zipo, create, update au view user accounts.
- Upload, view au delete CSV au XLSX dataset.
- Dynamically read input features na target columns.
- Kuruhusu user kuchagua training-test ratio.
- Retrain five machine-learning models.
- Calculate R², MAE na RMSE results.
- Load prediction-actual graphs.
- Produce instant prediction kwa specified inputs.
- Export results kama CSV file.
Upload system inakubali .csv na .xlsx formats na inalimiti file size hadi 10 MB. User anaweza preview uploaded dataset kama table, kuona error metrics za models na export result plots.
“Dataset-agnostic” ina maana gani?
Framework kuwa dataset-agnostic ina maana software haijahardwirewa kwenye P60D40 data columns pekee. User akipakia new file, system inaweza dynamically read columns, select input na target fields na retrain models.
Hata hivyo, prediction accuracy katika paper ilipimwa kwenye single P60D40 dataset yenye 431 samples pekee. Hakuna comparative generalization experiment na independent datasets kutoka different engine, fuel, load, sensors au institutions iliyowasilishwa. Kwa hiyo “dataset agnosticism” inaelezea zaidi flexibility ya software architecture kuliko validated universal model accuracy.
Security na user authorization zilishughulikiwaje?
System ina authentication mechanism inayohitaji verified users ku-login. Only administrators wanaweza manage user accounts. Logged-in researchers wanaelekezwa kwenye analysis panel na wanaweza kufanya dataset operations.
Hata hivyo, paper haitoi technical security testing kuhusu password-storage method, encryption, access logging, penetration testing, role-based permission matrix au data-privacy audit. Label ya “secure” inategemea presence ya login authentication na administrator authorization kwenye interface.
Optimum operating point iliamuliwaje?
Engine inputs zilizowasilishwa kama optimum katika model-optimization interface ni:
- Intake pressure: 1,2 bar
- Intake temperature: 353 K
- Injection pressure: 125 MPa
Under condition hii, CFD simulation na predictions za five models ni:
| Target output | CFD simulation | RF | MLP | SVM | XGBoost | KNN |
|---|---|---|---|---|---|---|
| ITE (%) | 47,68 | 47,6003 | 47,6622 | 47,4706 | 47,5978 | 47,5220 |
| EISFC (g/kWh) | 170,83 | 171,1014 | 171,0043 | 171,5918 | 170,9177 | 171,3840 |
| RI (MW/m²) | 4,8609 | 5,2923 | 5,2824 | 5,2817 | 5,9876 | 5,0680 |
| NOx (g/kWh) | 0,29 | 0,2477 | 0,2309 | 0,2103 | 0,2448 | 0,2100 |
| Soot (g/kWh) | 0,0052 | 0,0052 | 0,0054 | 0,0053 | 0,0056 | 0,0054 |
| CO (g/kWh) | 16,48 | 16,9377 | 16,6609 | 17,3225 | 17,4381 | 17,5120 |
| CO2 (g/kWh) | 279,38 | 279,1731 | 279,1059 | 277,5332 | 280,3731 | 277,6280 |
MLP ilikaribia CFD kwa kiasi gani katika operating point hii?
| Target | MLP-CFD absolute difference | Approximate relative difference versus CFD |
|---|---|---|
| ITE | 0,0178 percentage points | %0,04 |
| EISFC | 0,1743 g/kWh | %0,10 |
| RI | 0,4215 MW/m² | %8,67 |
| NOx | 0,0591 g/kWh | %20,38 |
| Soot | 0,0002 g/kWh | %3,85 |
| CO | 0,1809 g/kWh | %1,10 |
| CO2 | 0,2741 g/kWh | %0,10 |
Comparison hii inaonyesha MLP ilitoa predictions very close to CFD kwa ITE, EISFC, CO na CO2. Ingawa absolute difference ya soot ni very small, kwa sababu baseline value pia ni very small, relative difference ni takribani %3,85.
RI ilioverpredictiwa kwa takribani %8,67, huku NOx ikiunderpredictiwa kwa takribani %20,38. Kwa hiyo haiwezi kusemwa model inafanya kazi na “%1-2 deviation kwa all outputs.”
Conclusion inasema ITE, EISFC, soot, CO na CO2 predictions zinaagree within %1-2. Kulingana na Table 5, differences za ITE, EISFC na CO2 ziko far below %1, CO ni takribani %1,10, lakini relative difference ya soot ni takribani %3,85. Kwa hiyo kuna small inconsistency kati ya textual generalization na soot value kwenye table.
Radar graph inaonyesha nini?
Katika radar graph ya model performance chini ya same operating condition, simulation, MLP, RF, SVM, XGBoost na KNN zinalinganishwa kwenye same seven axes. MLP curve inaonekana karibu na simulation shape katika ITE, EISFC, soot, CO na CO2 axes.
Separation kati ya models ni more pronounced katika NOx na RI axes. Hata hivyo, kwa kuwa kila axis katika radar graph inatumia different units na scales, polygon area peke yake haipaswi kutafsiriwa kama overall performance metric. Numeric table na separate error metrics zinatoa more reliable comparison.
Tofauti kati ya results za previous study na current model
Abstract ina statements za %47,68 ITE, %98,76 NOx reduction na Euro VI compliance. Hata hivyo, current paper haitoi baseline diesel comparison table inayorecalculate %98,76 NOx reduction. Values hizi zimeripotiwa kama findings kutoka previous P60D40 optimization study ya authors.
Direct contribution ya current study ni kubadilisha previously generated CFD data domain kuwa machine-learning models na kutoa fast predictions katika web interface. Kwa hiyo emission reduction ya previous study haipaswi kuwasilishwa kama independent experimental emission success ya current machine-learning model.
Pia, exclusion ya operating points zinazozidi Euro VI au practical limits wakati wa dataset construction inaacha prediction region yenye compliant conditions. Method hii peke yake haithibitishi engine inakidhi Euro VI standard katika all possible conditions.
Nguvu za utafiti ni zipi?
- Unatabiri seven engine outputs kutoka three control variables katika same framework.
- Unalinganisha five algorithms kutoka neural-network, tree-based, kernel-based na neighborhood-based methods.
- Unaeleza scaler ilifit kwenye training data pekee ili kupunguza data leakage.
- Unatathmini model results kwa MAE na RMSE pamoja na R².
- Unalinganisha CFD na model predictions directly katika same operating point.
- Unaunganisha data upload, model training, graph viewing na CSV export katika one web interface.
- Software imeundwa kusoma input na target columns dynamically.
- Study inaripoti wazi cases ambapo SVM ilizidi MLP kwa RI na NOx licha ya overall MLP superiority.
Mapungufu ya utafiti ni yapi?
- Study ni preprint ambayo haijapitia peer review.
- Machine-learning data zilitengenezwa kutoka CFD simulations, si new independent engine experiments.
- Details za CFD validation hazijaonyeshwa tena katika current paper; readers wanaelekezwa kwa previous work.
- Dataset ina 431 samples pekee.
- Study inahusu only 1.500 rpm, approximately 3,8 bar IMEP na low-load condition.
- EGR ni %0 pekee; different EGR ratios hazikujifunzwa.
- Fuel composition ni fixed P60D40; model haijavalidatewa kwa different n-pentanol ratios.
- Mbali na three input variables, injection timing, number of injections, load na engine speed si model inputs.
- Prediction reliability kwa input combinations nje ya data domain haijatathminiwa.
- Kuondoa unsuitable operating points kutoka training kunaweza kupunguza uwezo wa model kutambua out-of-bound conditions.
- Only single random %80-%20 split ilitumika; hakuna k-fold cross-validation au multiple random split results.
- Extent ya hyperparameter search haijawasilishwa kwa undani.
- Model uncertainty, prediction intervals au confidence bounds hazijaripotiwa quantitatively.
- Dataset-agnostic performance haijavalidatewa kwa external datasets kutoka different research groups.
- Hakuna real engine-control unit, sensor stream, hardware loop au closed-loop control experiment iliyofanywa.
- NOx na RI predictions zilionyesha larger relative differences kuliko other outputs katika optimum point.
- Printed R² na RMSE equations zina mathematical typesetting omissions.
- Text inasema six models katika sehemu moja ingawa only five zimewasilishwa.
Matokeo yanayoungwa mkono na study
- Ndani ya selected P60D40 CFD data domain, five machine-learning models zilitabiri seven engine outputs kwa usable accuracy.
- MLP ilikuwa overall strongest model ikiwa na highest R² na low error kwa most targets.
- SVM ilizidi MLP katika NOx prediction.
- Katika 1,2 bar, 353 K na 125 MPa, MLP ilitoa predictions close to CFD kwa ITE, EISFC, CO na CO2.
- Baada ya training, machine-learning model inaweza kutoa predictions faster kuliko running new CFD.
- Python/Django interface inaunganisha data upload, retraining, model comparison na result export functions.
Matokeo ambayo study hauthibitishi
- Haijaonyeshwa kwamba model ni valid kwa all compression-ignition engines.
- Haijathibitishwa kwamba framework inahifadhi same accuracy kwa all fuel blends.
- Hakuna closed-loop optimization iliyofanywa kwenye real-time engine-control unit.
- Machine-learning model haiondoi kabisa need ya physical experiment au CFD.
- Haijaonyeshwa model inatoa safe predictions outside training range.
- Haijathibitishwa kwamba %60 n-pentanol ni more efficient au cleaner than diesel kwa all loads na speeds.
- Current study peke yake haikureconfirm independently %98,76 NOx reduction.
- Filtered dataset haionyeshi engine inakidhi Euro VI katika every possible operating condition.
- User login katika web interface haimaanishi comprehensive cybersecurity validation.
Possible future impact ni ipi?
Surrogate models za aina hii zinaweza kuruhusu rapid screening ya thousands of possible operating points wakati wa alternative-fuel development. Most promising regions zinaweza kisha kuverifywa kwa high-resolution CFD au engine tests. Hivyo costly experiments zinaweza kutumika more selectively badala ya kusambazwa equally kwenye entire design space.
Own future plan ya study ni kupanua dataset kujumuisha higher-load conditions na kuongeza automatic optimization algorithms kwenye interface. Zaidi ya hayo, kujumuisha different engine speed, EGR ratio, injection timing, multiple-injection strategy na different n-pentanol ratios kunaweza kuunda more comprehensive calibration tool.
Kwa transition kwenda real application, model inahitaji testing na independent engine experiments, datasets kutoka different research institutions, uncertainty analysis na online tests with engine-control hardware.
Mbinu na Matokeo ya Utafiti
Technical-method summary
| Technical element | Applied method |
|---|---|
| Fuel | %60 n-pentanol/%40 diesel; n-dodecane as diesel surrogate in CFD |
| Engine | Four-cylinder, four-stroke, electronically controlled compression-ignition engine |
| Operating condition | 1.500 rpm, approximately 3,8 bar IMEP, low load |
| Fuel energy | 400 J/cycle |
| EGR | %0 |
| CFD software | CONVERGE v3.0 |
| Geometry | 45° combustion-chamber sector model |
| Base mesh size | 3 mm |
| Nozzle mesh refinement | Level 2 adaptive refinement |
| Chemical mechanism | 75 species, 367 reactions |
| Inputs | Intake pressure, intake temperature, injection pressure |
| Targets | ITE, EISFC, RI, NOx, soot, CO, CO2 |
| Number of data | 431 samples |
| Training-test split | %80-%20 random hold-out |
| Models | MLP, RF, XGBoost, SVM, KNN |
| Evaluation | R², MAE, RMSE |
| Interface | Python/Django web application |
| File support | CSV and XLSX, maximum 10 MB |
Summary ya main findings
| Finding | Numerical result | Interpretation limit |
|---|---|---|
| ITE prediction | MLP R² = 0,9491 | Only for current low-load CFD data domain |
| EISFC prediction | MLP R² = 0,9439 | Different loads not tested |
| RI prediction | SVM R² = 0,8959; MLP R² = 0,8953 | At optimum point MLP overpredicted by approximately %8,67 |
| NOx prediction | SVM R² = 0,8856 | At optimum point all models underpredicted CFD NOx |
| Soot prediction | MLP R² = 0,9513 | Very small absolute values can magnify relative error |
| CO prediction | MLP R² = 0,9612 | Highest R² result in study |
| CO2 prediction | MLP R² = 0,8983 | Lower explanatory power than other strong targets |
| Optimum input | 1,2 bar, 353 K, 125 MPa | Details of automatic multiobjective optimization not given |
| MLP outputs closest to CFD | ITE, EISFC, CO and CO2 | RI and NOx differences are larger |
| Software framework | Dynamic data upload and retraining | Accuracy not tested with external datasets |
Technical results zote zikichukuliwa pamoja, MLP inajitokeza kama most balanced model kwa overall engine performance na emission prediction. Hata hivyo, kutumia same algorithm kwa all targets si lazima. Target-specific model selection, kama SVM kwa NOx na MLP kwa soot na CO, inaweza kuwa more accurate approach.
Maelezo ya Chanzo na Mbinu
Jina kamili asilia la utafiti: A dataset-agnostic machine learning framework for real-time optimization of 60% n-Pentanol/diesel combustion in compression ignition engines
Waandishi na mpangilio wao katika PDF: Sunday B. Ogunjide; Wenjun Zhong; Omolayo Abegunde; Tamilselvan Pachiannan; Oluropo F. Dairo; Sunday A. Salimon; Olubunmi F. Atilola; Zhixia He; Qian Wang.
Equal first author au equal contribution: Haijatajwa katika PDF.
Corresponding author: Wenjun Zhong.
Institutional affiliations:
- School of Energy and Power Engineering, Jiangsu University, Zhenjiang 212013, China.
- Department of Electrical and Electronic Engineering, Redeemer’s University, Ede 232102, Nigeria.
- Department of Computer Engineering, Redeemer’s University, Ede 232102, Nigeria.
- Hangzhou International Innovation Institute, Beihang University, Hangzhou 311115, China.
- Institute for Energy Research, Jiangsu University, Zhenjiang 212013, China.
Author–institution mappings: Sunday B. Ogunjide: Jiangsu University na Redeemer’s University; Wenjun Zhong: Jiangsu University; Omolayo Abegunde: Redeemer’s University Department of Computer Engineering; Tamilselvan Pachiannan: Beihang University Hangzhou International Innovation Institute; Oluropo F. Dairo, Sunday A. Salimon na Olubunmi F. Atilola: Redeemer’s University; Zhixia He: Jiangsu University School of Energy and Power Engineering na Institute for Energy Research; Qian Wang: Jiangsu University.
DOI: 10.2139/ssrn.6945187
Jarida: Hakuna peer-reviewed journal name au acceptance information iliyotajwa katika PDF version hii.
Publication platform: SSRN.
Original publisher: Peer-reviewed journal publisher information haijathibitishwa. SSRN ni Elsevier’s preprint platform; hii haimaanishi publication katika journal.
Document year: 2026. Exact official SSRN submission day haikuweza kuthibitishwa kutoka PDF.
Peer-review status: Utafiti huu ni preprint na haujapitia peer review.
Aina ya chanzo: Preprint research article inayotengeneza machine-learning comparison, optimization na web-based decision-support software juu ya CFD-generated data.
Official SSRN link:https://papers.ssrn.com/sol3/papers.cfm?abstract_id=6945187
DOI link:https://doi.org/10.2139/ssrn.6945187
Makala hii ya Kituruki iliandaliwa kwa kuchunguza text, equations, tables, model graphs, flow diagrams na software-interface images za PDF ya kurasa 32 iliyopakiwa. Hakuna new engine experiment, emission result, clinical au commercial success claim iliyoongezwa kutoka nje ya PDF. External verification ilitumika only kwa bibliographic check ya DOI, SSRN record, platform na peer-review status.
Main methodological limitations ni training data kutengenezwa kutoka CFD, focus kwenye single engine-fuel-load domain, absence ya external dataset validation, use ya single training-test split, non-reporting ya model uncertainty, na kutokuonyesha closed-loop control kwenye real engine hardware.
Document-level inconsistencies zinazopaswa kuzingatiwa ni text kusema “six models” ingawa only five zimewasilishwa, typesetting omissions katika R² na RMSE equations, na statement ya %1-2 deviation katika conclusion kutolingana kikamilifu na soot prediction.
Preprint warning: Utafiti huu ni preprint ambayo haijapitia peer review; results zinapaswa kusomwa kwa kuzingatia limitation hii.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *