

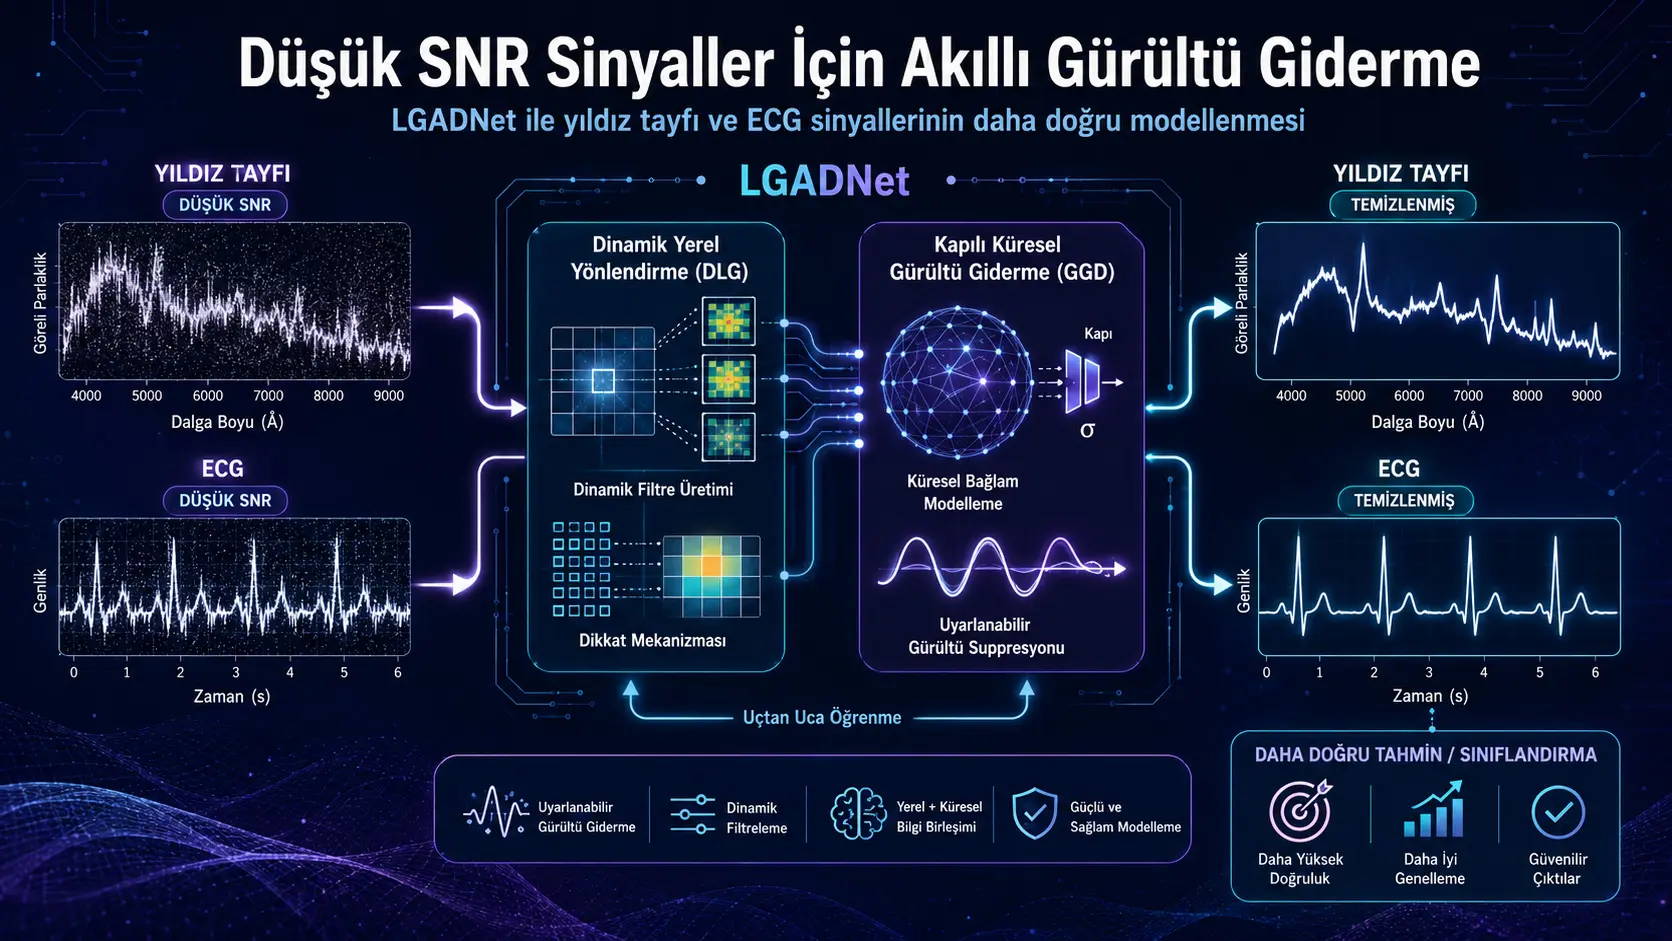
LGADNet, iliyotengenezwa na Jinfan Li na Xiangru Li, ni usanifu wa kujifunza kwa kina unaolenga kutambua mifumo dhaifu na ya ndani ya ishara iliyofichwa ndani ya kelele kali huku wakati huohuo ukimodeli uhusiano kati ya sehemu za mbali za mfuatano. Watafiti wameunganisha moduli ya Dynamic Local Guidance, inayotumia convolution za kimienendo zinazoweza kubadilika kulingana na sampuli, na moduli ya Gated Global Denoising yenye usimbaji wa nafasi unaojifunza na utaratibu wa gating.
Mbinu hiyo ilijaribiwa kwanza katika kukadiria halijoto fanisi, mvutano wa uso, wingi wa metali na wingi wa kaboni kutoka kwenye spektra za nyota zenye uwiano mdogo wa ishara kwa kelele. Seti ya data ya LSS iliyotayarishwa na watafiti ina spektra 59.983 zilizoundwa kwa kulinganisha kwa pamoja tafiti za astronomia zilizo wazi kwa umma. LGADNet ilipata wastani wa kosa kamili wa 50,18 kwa halijoto fanisi, 0,045 kwa [C/Fe] na 0,042 kwa [Fe/H], na hivyo kutoa kosa la chini zaidi katika vipimo hivi vitatu miongoni mwa mbinu zilizolinganishwa. Kwa mvutano wa uso ilifikia 0,079, lakini katika kipimo hiki ilibaki nyuma kidogo ya matokeo ya 0,078 ya MSFL-IECW.
Katika kazi ya kutambua nyota zenye kaboni nyingi na metali chache kutokana na vigezo vya nyota vilivyokadiriwa, LGADNet ilipata precision ya 0,816 na alama ya F1 ya 0,725. Thamani ya sensitivity ya 0,652 si matokeo ya juu zaidi; StarGRUNet ilifikia sensitivity ya 0,697. Kwa hiyo, faida kuu ya mbinu si kukamata wagombea wengi zaidi, bali kupunguza false positives na kuboresha uwiano kati ya precision na F1.
Modeli pia ilibadilishwa kwa uainishaji wa arithmia wa madarasa matano kwenye hifadhidata ya MIT-BIH na ikaripoti usahihi wa jumla wa 0,991. Hata hivyo, jaribio hili si uhamisho wa moja kwa moja wa modeli iliyofundishwa kwa data za astronomia kwenda kwenye ishara za ECG. Idadi ya blok na safu ya pato ya mtandao ilibadilishwa, na modeli ikafundishwa upya kwa kazi ya ECG. Kwa hiyo, matokeo hayaonyeshi uhamisho wa nyanja wa zero-shot, bali yanaonyesha kwamba wazo hilo hilo la usanifu linaweza kutumika katika eneo la pili la data.
Mapungufu muhimu zaidi ya utafiti ni kwamba zimeelezwa seti za mafunzo na uthibitishaji pekee, hakuna seti huru ya majaribio, haijaelezwa kama data za ECG ziligawanywa kwa msingi wa mgonjwa, sehemu muhimu ya mipangilio ya mafunzo haijaripotiwa, na msimbo pamoja na seti ya data ya LSS haikupatikana wakati wa ukaguzi. Matokeo yanaonyesha kuwa LGADNet ina matumaini; lakini uthibitishaji huru unahitajika kwa matumizi ya kliniki, uundaji wa katalogi za astronomia au uwezo wa kujumlisha katika vikundi tofauti vya utafiti.
Tatizo kuu linaloshughulikiwa na utafiti
Spektra za astronomia, elektrokardiogramu na ishara nyingine za kisayansi za mfululizo hubeba taarifa muhimu kuhusu mfumo unaochunguzwa. Hata hivyo, kutokana na mipaka ya usikivu ya vifaa vya kupimia, athari za mazingira, upotevu wa uwasilishaji na mwingiliano wa mandharinyuma, taarifa bainifu mara nyingi hubaki ndani ya kelele kama mifumo dhaifu na ya ndani.
Katika spektra ya nyota, bendi za molekuli zinazoonyesha wingi wa kaboni zinaweza kuonekana tu katika masafa fulani ya urefu wa wimbi. Katika rekodi ya ECG, mabadiliko ya kimofolojia yanayoashiria hitilafu ya mpigo yanaweza kuwepo katika kipindi kifupi cha mpigo wa moyo. Hata hivyo, kwa utabiri sahihi si maelezo haya ya ndani pekee yaliyo muhimu, bali pia uhusiano wa masafa marefu kati ya urefu tofauti wa mawimbi ya spektra au nyakati tofauti za mpigo wa moyo.
Mahitaji mawili yanayolengwa na utafiti ni haya:
- Kukamata miundo dhaifu, ya masafa mafupi na mahususi kwa sampuli inayobaki ndani ya kelele
- Kumodeli utegemezi wa kimataifa kati ya sehemu za mfuatano zilizo mbali kutoka kwa kila mmoja
Mapungufu ya mbinu zilizopo
Uhandisi wa jadi wa vipengele hutegemea vipengele vilivyobuniwa mapema kama wavelet transform, principal component analysis, template matching na viashiria vya takwimu. Vipengele hivi vinaweza kutafsiriwa katika ishara zenye ubora wa juu; lakini kelele inapoongezeka na mofolojia za sampuli zinapobadilika, uwezo wake wa kujumlisha unaweza kupungua.
Mitandao ya kawaida ya neva ya convolution inaweza kukamata kwa mafanikio mifumo ya ndani. Hata hivyo, baada ya mafunzo kukamilika hutumia kernel zile zile za convolution kwa sampuli zote. Wakati usambazaji wa kelele au mofolojia ya ishara hubadilika kwa kiasi kikubwa kutoka sampuli moja hadi nyingine, uwezo wa kernel zisizobadilika wa kujirekebisha unaweza kuwa mdogo.
Miundo ya Transformer inaweza kumodeli uhusiano kati ya nafasi za mbali za mfuatano kupitia utaratibu wa self-attention. Lakini self-attention yenyewe haijui ni jibu lipi ni ishara halisi na lipi ni kelele. Kuingiza moja kwa moja vipengele vyenye kelele katika mwingiliano wa kimataifa kunaweza kusababisha majibu yasiyotakiwa kuenea kupitia miunganisho ya masafa marefu.
Ingawa miunganisho ya CNN–Transformer huleta pamoja nguvu za mbinu zote mbili, watafiti wanasema miundo iliyopo ina mapungufu mawili ya msingi katika hali za SNR ya chini:
- Matumizi ya kernel zisizobadilika za convolution katika hatua ya ndani mara nyingi
- Kutokuwepo kwa utaratibu wa wazi unaokandamiza kelele kwa kuchagua kabla ya hatua ya kimataifa
Mbinu kuu ya LGADNet
LGADNet huimarisha kwanza miundo ya ndani kwa namna inayobadilishwa kwa sampuli, kisha hupitisha uwakilishi huu ulioimarishwa kupitia kichujio cha kuchagua na kumodeli uhusiano wa kimataifa. Mlolongo mkuu wa uchakataji ni huu:
\[ \text{Girdi dizisi} \rightarrow \text{özellik izdüşümü} \rightarrow \text{DLG} \rightarrow \text{GGD} \rightarrow \text{tahmin başlığı} \]
Mfuatano wa ingizo wa mwelekeo mmoja hufafanuliwa kama:
\[ X\in\mathbb{R}^{L} \]
Hapa L ni urefu wa mfuatano. Safu ya kwanza ya projection hubadilisha ingizo kuwa nafasi ya vipengele yenye njia C:
\[ X_{\mathrm{proj}}\in\mathbb{R}^{C\times L} \]
Uwakilishi huu hupelekwa kwanza kwenye moduli ya Dynamic Local Guidance na kisha kwenye moduli ya Gated Global Denoising.
Kielelezo 1: Mtiririko wa usanifu unaonyesha nini?
Kielelezo 1 kwenye ukurasa wa tisa kinaonyesha ngazi tatu kuu za LGADNet. Katika mtiririko mkuu, ishara ya mwelekeo mmoja hubadilishwa kwanza kuwa ramani ya vipengele yenye vipimo vya juu, kisha hupitishwa kwenye moduli za DLG na GGD hadi kufikia kichwa cha utabiri cha perceptron ya tabaka nyingi.
Katika maelezo ya DLG kwenye sehemu ya juu ya kielelezo kuna matawi matatu sambamba yanayochakata ingizo lile lile:
- Tawi la vipengele vya ndani
- Tawi la convolution ya kimienendo
- Tawi thabiti la njia fupi
Mchoro mdogo wa convolution ya kimienendo unaonyesha kuwa uzito unaozalishwa kutoka kwenye ingizo huunganisha kernel nne za convolution zinazogombea. Mchoro wa GGD katika sehemu ya chini unaonyesha kuwa usimbaji wa nafasi unaojifunza huongezwa kwenye vipengele, huzidishwa kwa kiwango cha elementi na thamani za gating, na vipengele vilivyochaguliwa hutumwa kwenye encoder ya Transformer.
Moduli ya Dynamic Local Guidance
Moduli ya DLG ina matawi matatu yanayokamilishana ambayo huchakata kwa sambamba kipengele kile kile cha ingizo. Lengo ni kuimarisha miundo ya ndani mahususi kwa sampuli huku ikiepuka kutokuwa thabiti kwa mafunzo kunakoweza kutokea katika muundo wa kimienendo kabisa.
Tawi la kwanza: Utoaji wa vipengele vya ndani visivyo vya mstari
Tawi la kwanza hutumia safu mbili mfululizo za convolution ya mwelekeo mmoja zenye uanzishaji wa ReLU. Convolution zinazofuatana huunda receptive field fanisi iliyo pana kuliko safu moja na kujaribu kukamata mifumo changamano ya ndani kati ya nafasi zilizo karibu.
Tawi hili halizalishi vigezo vya kimienendo vinavyobadilika kulingana na sampuli. Hutoa msingi thabiti na wa kuaminika wa vipengele vya ndani wa moduli.
Tawi la pili: Convolution ya kimienendo
Katika tawi la convolution ya kimienendo zimeundwa kernel nne zinazogombea:
\[ \{W_g\}_{g=1}^{G},\qquad G=4 \]
Kila kernel inayogombea ina vipimo:
\[ W_g\in\mathbb{R}^{C_{\mathrm{out}}\times C_{\mathrm{in}}\times K} \]
Hapa Cin ni idadi ya njia za ingizo, Cout ni idadi ya njia za pato, na K ni urefu wa kernel ya convolution.
Takwimu za njia za vipengele vya ingizo hutolewa kwa global average pooling:
\[ X_{\mathrm{glob}}=\operatorname{GAP}(X) \in\mathbb{R}^{C_{\mathrm{in}}\times1} \]
Mtandao mwepesi wa gating huzalisha coefficients za mchanganyiko mahususi kwa sampuli kwa kernel nne zinazogombea:
\[ \boldsymbol{\alpha} =[\alpha_1,\alpha_2,\ldots,\alpha_G] \]
Coefficients lazima zisiwe hasi na jumla yake iwe sawa na moja:
\[ \alpha_g\geq0,\qquad \sum_{g=1}^{G}\alpha_g=1 \]
Kernel ya kimienendo itakayotumika kwa sampuli huundwa kama:
\[ W_{\mathrm{mix}} =\sum_{g=1}^{G}\alpha_gW_g \]
Kwa njia hii, mchanganyiko tofauti wa kernel nne za msingi unaweza kutumika kwa ingizo zenye viwango tofauti vya kelele au mofolojia tofauti za ndani.
Utaratibu huu hauzalishi kernel mpya kabisa kwa kila nafasi. Huchanganya kwa uzito kernel nne zilizofundishwa mapema kulingana na muhtasari wa kimataifa wa njia za ingizo.
Tawi la tatu: Njia fupi thabiti
Tawi la tatu ni ramani ya njia fupi yenye safu moja ya convolution. Lengo lake ni kuhifadhi vipengele vya msingi, kurahisisha mtiririko wa gradient na kupunguza misukosuko ya mafunzo inayoweza kusababishwa na tawi la kimienendo.
Kuunganisha matawi matatu
Matokeo ya matawi matatu hujumlishwa kwa kiwango cha elementi badala ya kuunganishwa kwa njia:
\[ F_{\mathrm{out}} =\phi\left( F_{\mathrm{res1}}+ F_{\mathrm{res2}}+ F_{\mathrm{res3}} \right) \]
Hapa φ ni kazi ya uanzishaji isiyo ya mstari, iliyotekelezwa kama ReLU katika utafiti. Operesheni ya kujumlisha hupunguza idadi ya njia na gharama ya vigezo ikilinganishwa na kuunganisha vipengele kwa mfululizo.
Moduli ya Gated Global Denoising
Ingawa uwakilishi unaotoka DLG una miundo ya ndani bainifu, bado unaweza kuwa na kelele iliyobaki na majibu yasiyo ya lazima. Moduli ya GGD huchuja vipengele hivi kwa taarifa za nafasi na milango inayojifunza kabla ya kuvituma kwenye operesheni ya self-attention ya Transformer.
Usimbaji wa nafasi unaojifunza
Urefu wa juu wa mfuatano umewekwa kuwa 1000 na matrix ifuatayo ya usimbaji wa nafasi unaojifunza imefafanuliwa:
\[ P\in\mathbb{R}^{L_{\max}\times C_{\mathrm{final}}}, \qquad L_{\max}=1000 \]
Pato la DLG hubadilishwa kuwa mpangilio wa sequence-first na vekta za kwanza za nafasi zinazolingana na urefu wa sasa huongezwa:
\[ F_{\mathrm{pos}} =F_{\mathrm{dlg}}^{\mathsf{T}} +P_{1:L_d} \]
Usimbaji unaojifunza huzalisha uwakilishi wa nafasi unaoweza kurekebishwa kupitia data za mafunzo ya kazi badala ya kutumia kazi zisizobadilika za sine na cosine.
Gating ya kiwango cha elementi
Matrix ya gate huhesabiwa kutoka kwa vipengele vilivyoongezewa taarifa za nafasi:
\[ G= \rho\left(F_{\mathrm{pos}}A_g+b_g\right) \]
Hapa ρ ni kazi ya Sigmoid. Kwa hiyo kila thamani ya gate iko kati ya sifuri na moja.
Gates huzidishwa na vipengele kwa kiwango cha elementi:
\[ F_{\mathrm{sel}} =F_{\mathrm{pos}}\odot G \]
Thamani ya gate inapokaribia moja, jibu la nafasi na njia husika huhifadhiwa; inapokaribia sifuri, jibu hilo hukandamizwa. Hata hivyo, haijasimamiwa moja kwa moja kama gate inatenganisha “kelele” na “ishara” kwa maana ya kifizikia; utengano huo hujifunzwa kupitia uzito wa uwakilishi unaopunguza hasara ya mafunzo.
Umodeli wa utegemezi wa kimataifa
Vipengele vilivyochujwa hutumwa kwenye blok mbili za encoder ya Transformer:
\[ F_{\mathrm{trans}} =\mathcal{T}_{N}(F_{\mathrm{sel}}), \qquad N=2 \]
Kila blok ya encoder ina multi-head self-attention, mtandao wa feed-forward, layer normalization na dropout. Matokeo hubadilishwa tena kuwa mpangilio wa channel-first:
\[ F_{\mathrm{ggd}} =F_{\mathrm{trans}}^{\mathsf{T}} \]
Utafiti haujaeleza idadi ya attention head za Transformer, upana wa njia, ukubwa wa safu ya feed-forward wala kiwango cha dropout.
Seti ya data ya spektra za nyota ya LSS iliundwaje?
LSS iliandaliwa ili kutathmini ukadiriaji wa vigezo vya nyota katika hali za SNR ya chini. Ingizo lilitokana na spektra za azimio la chini za LAMOST DR12, huku lebo lengwa zikitokana na APOGEE DR17, katalogi za LAMOST–Subaru na hifadhidata ya SAGA.
Sampuli zenye uwiano wa ishara kwa kelele zaidi ya 5 pekee zilitumika. Ulinganishaji ulifanywa kwa programu ya TOPCAT na radius ya juu ya ulinganishaji ya sekunde tatu za arc. Katika hatua ya kwanza zilipatikana sampuli 189.780.
Mlolongo wa uchakataji wa awali ulijumuisha:
- Marekebisho ya Doppler
- Kukata masafa ya urefu wa wimbi na resampling
- Cubic spline interpolation
- Ulalishaji wa Savitzky–Golay
- Continuum normalization
- Kukata outlier kwa standard deviation tatu
Kwa kuwa Savitzky–Golay hulainisha spektra kabla ya kuziingiza kwenye modeli, LGADNet haikutathminiwa kwenye ishara ghafi zenye kelele ambazo hazijachakatwa kabisa. Utendaji wa modeli ni matokeo ya pamoja ya hatua za uchakataji wa ishara na usanifu wa mtandao.
Ili kupunguza kutokuwiana katika usambazaji wa [C/Fe] na [Fe/H], ilitumika sampling inayotegemea bin za vipengele viwili na seti ya mwisho ya spektra 59.983 ikaandaliwa.
| Sehemu ya data | Idadi ya sampuli | Sehemu ya jumla |
|---|---|---|
| Mafunzo | 47.984 | Takribani %80 |
| Uthibitishaji | 11.999 | Takribani %20 |
| Jumla | 59.983 | %100 |
Seti tofauti ya majaribio haijaripotiwa. Kwa hiyo, haiwezi kubainishwa kama matokeo yaliyowasilishwa ni huru kabisa na data za uthibitishaji zilizotumika katika uchaguzi wa modeli na hyperparameters.
Je, usambazaji wa madarasa ya LSS kweli umesawazishwa?
Sampuli za LSS zimegawanywa katika makundi matatu:
| Darasa | Uwiano wa mafunzo | Uwiano wa uthibitishaji |
|---|---|---|
| CEMP | %0,742 | %0,742 |
| MP-no-CEMP | %2,955 | %2,959 |
| Nyingine | %96,303 | %96,300 |
Usambazaji huu haujasawazishwa kwa idadi ya madarasa. Kauli ya “sampling iliyosawazishwa” inahusu sampling ya bin katika nafasi ya lebo za [C/Fe] na [Fe/H]; haimaanishi kusawazisha madarasa ya CEMP, MP-no-CEMP na Nyingine.
Kwa sababu darasa la CEMP lina sehemu ya takribani asilimia 0,74, usahihi wa jumla wa juu kama 0,996 pekee hautoshi. Kwa utendaji wa darasa nadra, sensitivity, precision na alama ya F1 vinaeleza zaidi.
Kielelezo 2: Spektra za madarasa matatu ya nyota
Kielelezo 2 kwenye ukurasa wa kumi na saba kinaonyesha mfano mmoja wa spektra iliyochakatwa kutoka kila kundi la CEMP, MP-no-CEMP na Nyingine. Mhimili mlalo unaonyesha urefu wa wimbi, huku mhimili wima ukiwakilisha flux iliyosawazishwa.
Mistari myekundu yenye vipindi inaashiria maeneo yanayohusiana na kaboni kama CH G-band na bendi za C2 Swan, na mistari ya buluu inaonyesha mistari ya ufyonzaji wa chuma. Viwango vya kelele na mofolojia za mistari ya ndani za sampuli hizo tatu zinatofautiana kwa wazi.
Kielelezo kinaonyesha kwa picha tatizo la mifumo ya ndani ambalo modeli hukabiliana nalo; hata hivyo, kwa kuwa kina sampuli tatu zilizochaguliwa tu, hakiwakilishi usambazaji wa jumla wa seti ya data au viwango vyote vya SNR.
Ni matokeo gani yaliyopatikana kwa vigezo vya nyota?
| Modeli | log g MAE | Teff MAE | [C/Fe] MAE | [Fe/H] MAE |
|---|---|---|---|---|
| Inception | 0,086 | 59,13 | 0,049 | 0,050 |
| ResNet | 0,091 | 59,91 | 0,050 | 0,050 |
| StarGRUNet | 0,080 | 55,01 | 0,048 | 0,047 |
| RRNet | 0,101 | 70,19 | 0,050 | 0,054 |
| StarNet | 0,092 | 60,69 | 0,047 | 0,049 |
| MSFL-IECW | 0,078 | 55,58 | 0,048 | 0,044 |
| LGADNet | 0,079 | 50,18 | 0,045 | 0,042 |
MAE ya chini ina maana ya utabiri bora. LGADNet ilitoa kosa la chini zaidi katika halijoto fanisi, wingi wa kaboni na wingi wa metali. Katika kipimo cha mvutano wa uso iko nafasi ya pili.
Mabadiliko ya kosa ukilinganisha na msingi wa ResNet ni haya:
- Kupungua kwa takribani %13,2 katika kosa la log g
- Kupungua kwa takribani %16,2 katika kosa la Teff
- Kupungua kwa %10 katika kosa la [C/Fe]
- Kupungua kwa %16 katika kosa la [Fe/H]
Jedwali la matokeo halijataja kando vitengo vya kifizikia vya vigezo. Zaidi ya MAE, hakuna RMSE, explained variance, confidence interval au thamani za kosa katika sehemu tofauti za SNR zilizowasilishwa.
Kielelezo 3: Thamani zilizotabiriwa na za kweli
Kielelezo 3 kwenye ukurasa wa ishirini na moja kinalinganisha thamani zilizotabiriwa na za kweli kwa halijoto fanisi, mvutano wa uso, [Fe/H] na [C/Fe]. Diagonal nyeusi yenye vipindi inaonyesha uhusiano bora wa y=x, huku mistari myekundu yenye vipindi ikionyesha mipaka ya plus na minus standard deviation tatu.
Sehemu kubwa ya nukta imejikusanya karibu na diagonal. Skeli ya rangi inaonyesha msongamano wa nukta na kufichua kwamba utabiri umejikusanya zaidi katika maeneo ya vigezo yenye msongamano mkubwa.
Grafu hii inaunga mkono ulinganifu wa jumla; lakini haitoshi peke yake kubainisha kama utendaji ni dhaifu zaidi katika maeneo yenye sampuli chache za vigezo. Hakuna majedwali tofauti ya kosa yaliyotolewa kwa masafa ya vigezo au viwango vya SNR.
Utambuzi wa nyota za CEMP
Watafiti hawakutumia classifier tofauti inayotabiri moja kwa moja darasa la CEMP. Walitabiri kwanza vigezo vya nyota, kisha wakatumia vigezo vya kifizikia vilivyofafanuliwa katika utafiti wa awali kwenye utabiri huo ili kutoa uamuzi wa CEMP.
| Modeli | Usahihi | Sensitivity | Precision | F1 |
|---|---|---|---|---|
| Inception | 0,995 | 0,573 | 0,718 | 0,638 |
| ResNet | 0,995 | 0,640 | 0,633 | 0,637 |
| StarGRUNet | 0,996 | 0,697 | 0,705 | 0,701 |
| RRNet | 0,995 | 0,551 | 0,731 | 0,628 |
| StarNet | 0,995 | 0,663 | 0,671 | 0,667 |
| MSFL-IECW | 0,996 | 0,640 | 0,722 | 0,679 |
| LGADNet | 0,996 | 0,652 | 0,816 | 0,725 |
Precision ya LGADNet inaonyesha kwamba false positives ni chache ikilinganishwa na mbinu nyingine. Kwa upande mwingine, sensitivity ya 0,652 ina maana kwamba takribani theluthi moja ya sampuli halisi za CEMP hazikutambuliwa. Kwa hiyo, alama ya juu ya F1 haipaswi kutafsiriwa kama kwamba mbinu imekamata nyota zote nadra.
Jaribio la MIT-BIH ECG lilifanywaje?
Katika eneo la pili la data ilitumika MIT-BIH Arrhythmia Database. Hifadhidata ina rekodi za ECG za nusu saa zenye njia mbili kutoka kwa wagonjwa 48, zilizochukuliwa kwa kiwango cha 360 Hz, pamoja na takribani mapigo ya moyo 109.446 yenye lebo.
Mapigo ya moyo yaligawanywa katika madarasa matano kulingana na mpangilio wa AAMI:
- N: Kawaida
- S: Supraventricular
- V: Ventricular
- F: Fusion
- Q: Haijulikani au nyingine
Kwa kuwa mifuatano ya spektra ina nukta 4901, blok sita za DLG zilitumika katika kazi ya astronomia na urefu ukapunguzwa hadi takribani 75 kwa kupunguza mara mbili katika kila blok. Kwa kuwa mifuatano ya ECG ina nukta 187, blok mbili tu za DLG zilitumika na urefu ukapunguzwa hadi takribani 46.
Kwa madarasa ya wachache ilitumika data augmentation yenye uwezekano unaotegemea darasa. Operesheni zilikuwa:
- Amplitude scaling kati ya 0,9–1,1
- Time shift ya plus au minus sampuli tano
- Kelele ya Gauss yenye standard deviation ya 0,01
- Mixup yenye α=0,2
- Label smoothing ya 0,1
Thamani sahihi za uwezekano wa data augmentation mahususi kwa kila darasa hazijatolewa. Pia haijaelezwa kama mgawanyo wa mafunzo, uthibitishaji na majaribio ulifanywa kwa msingi wa mgonjwa au kwa msingi wa mapigo ya moyo. Ikiwa mapigo ya mgonjwa yuleyule yameingia katika seti za mafunzo na tathmini, utendaji uliopimwa unaweza kuonyesha uwezo wa kujumlisha kati ya wagonjwa kuwa juu kuliko ulivyo kweli.
Matokeo ya uainishaji wa ECG
| Mbinu | Usahihi | N F1 | S F1 | V F1 | F F1 | Q F1 |
|---|---|---|---|---|---|---|
| Inayotegemea CNN | 0,953 | 0,974 | 0,916 | 0,950 | Haijaripotiwa | Haijaripotiwa |
| Inayotegemea vipengele | 0,931 | 0,969 | 0,334 | 0,773 | Haijaripotiwa | Haijaripotiwa |
| Inayotegemea Random Forest | 0,986 | Haijaripotiwa | 0,815 | 0,970 | Haijaripotiwa | Haijaripotiwa |
| MB-CNN-BiLSTM | 0,992 | 0,962 | 0,908 | 0,982 | Haijaripotiwa | 0,991 |
| PathFusion-Net | 0,947 | 0,973 | 0,832 | 0,914 | 0,064 | Haijaripotiwa |
| LGADNet | 0,991 | 0,996 | 0,975 | 0,887 | 0,846 | 0,996 |
LGADNet ilibaki nyuma kwa 0,001 tu ya matokeo bora katika usahihi wa jumla. Ilitoa thamani kubwa za F1 katika madarasa N, S, F na Q; lakini katika darasa V ilibaki chini kwa kiasi kikubwa kuliko baadhi ya mbinu za kulinganisha.
Machapisho yote yaliyolinganishwa hayakutumia seti zile zile za madarasa au mgawanyo ule ule wa data. Baadhi ya mbinu hazina darasa F au Q, na katika nyingine madarasa fulani yameondolewa kwenye tathmini. Kwa hiyo, jedwali ni zaidi ulinganisho wa thamani zilizoripotiwa katika machapisho tofauti kuliko jaribio moja la pamoja lililodhibitiwa.
Matokeo ya ECG hayaonyeshi kwamba uzito uliojifunzwa kwenye data za astronomia ulihamishwa kwenda kwenye eneo la biomedical. Usanifu ulibadilishwa kwa ECG na kufundishwa upya. “Uwezo wa kubadilika kati ya nyanja” unapaswa kutathminiwa kwa maana kwamba muundo ule ule unaweza kutumika katika kazi mbili tofauti.
Ufafanuzi wa modeli ulitathminiwaje?
Kielelezo 4 kwenye ukurasa wa ishirini na mbili kinaonyesha ramani ya saliency inayotegemea gradient ya ingizo kwa nyota moja ya uwakilishi ya CEMP. Paneli ya juu ina spektra iliyosawazishwa na mistari muhimu kifizikia, huku paneli ya chini ikionyesha ukubwa wa gradient wa kila urefu wa wimbi kwenye utabiri wa [C/Fe].
Vipengele vilivyoashiriwa ni pamoja na:
- CH G-band karibu na 4300 Å
- Bendi za molekuli za C2 Swan
- Mistari ya ufyonzaji wa Fe na Ca
- Mistari ya hidrojeni
- Mistari iliyotajwa kuwa nyeti kwa mvutano wa uso
Sehemu kubwa ya majibu makali ya saliency inaonekana katika eneo la buluu la spektra kati ya 3900–5500 Å. Watafiti wametafsiri hili kama ishara kwamba mtandao unaangazia miundo ya kifizikia ya spektra inayohusiana na wingi wa kaboni na metali.
Ramani ya saliency inahusu sampuli moja tu ya CEMP iliyochaguliwa. Gradient ya ingizo huonyesha unyeti wa ndani wa modeli kwa mabadiliko madogo ya ingizo; peke yake haithibitishi kwamba urefu wa mawimbi husika unatumika kwa sababu au kwamba modeli imejifunza uhusiano ule ule wa kifizikia katika sampuli zote. Hakujafanywa takwimu za saliency za pamoja kwa nyota nyingi, majaribio ya counterfactual au majaribio ya kufunika mistari.
Matokeo ya ablation ya DLG na GGD
| DLG | GGD | FLOPs | log g | Teff | [C/Fe] | [Fe/H] |
|---|---|---|---|---|---|---|
| Hakuna | Hakuna | 133,1 M | 0,091 | 59,91 | 0,050 | 0,050 |
| Ipo | Hakuna | 333,8 M | 0,081 | 52,59 | 0,046 | 0,044 |
| Hakuna | Ipo | 157,7 M | 0,080 | 54,50 | 0,047 | 0,045 |
| Ipo | Ipo | 420,0 M | 0,079 | 50,18 | 0,045 | 0,042 |
DLG pekee ilitoa kosa la chini zaidi kuliko GGD katika halijoto fanisi na vigezo vya wingi. GGD pekee ilifanya vizuri kidogo kuliko DLG katika kipimo cha log g. Kutumia moduli zote mbili pamoja kulitoa matokeo bora katika vigezo vyote vinne kuliko matoleo yenye moduli moja.
Faida hii ina gharama ya kihesabu. Thamani ya FLOP milioni 420 ya modeli kamili ni takribani mara 3,16 ya FLOP milioni 133,1 ya msingi. Kwa maneno mengine, mzigo wa kihesabu umeongezeka kwa takribani asilimia 216.
Matokeo ya ablation kwa utambuzi wa CEMP
| Muundo | Sensitivity | Precision | F1 |
|---|---|---|---|
| Modeli ya msingi | 0,640 | 0,633 | 0,637 |
| DLG pekee | 0,584 | 0,788 | 0,671 |
| GGD pekee | 0,663 | 0,711 | 0,686 |
| DLG na GGD | 0,652 | 0,816 | 0,725 |
DLG pekee iliongeza precision lakini ikapunguza sensitivity. GGD pekee iliongeza sensitivity. Moduli zote mbili kwa pamoja zilitoa precision na F1 za juu zaidi, lakini hazikufikia sensitivity ya juu zaidi.
Matokeo haya yanaunga mkono tafsiri ya watafiti kwamba moduli hizo mbili zina majukumu yanayokamilishana. Hata hivyo, haijaelezwa kama ablation zilitokana na mafunzo moja au wastani wa kuanzisha nasibu mara nyingi.
Convolution ya kimienendo inapaswa kuwekwa katika tawi gani?
| Mpangilio wa DLG | log g | Teff | [C/Fe] | [Fe/H] |
|---|---|---|---|---|
| Muundo wa residual wa statiki | 0,080 | 54,50 | 0,047 | 0,045 |
| Tawi la residual la kimienendo | 0,079 | 50,18 | 0,045 | 0,042 |
| Tawi kuu la kimienendo | 0,078 | 52,56 | 0,047 | 0,041 |
| Yote ya kimienendo | 0,090 | 59,30 | 0,047 | 0,042 |
Tawi la residual la kimienendo lilitoa matokeo bora zaidi katika halijoto fanisi na wingi wa kaboni, huku tawi kuu la kimienendo likitoa kosa la chini zaidi katika log g na [Fe/H]. Watafiti walichagua tawi la residual la kimienendo kama muundo wa kawaida kwa sababu ya uwiano wa vipimo vingi.
Kufanya matawi yote kuwa ya kimienendo kuliongeza kosa la Teff hadi 59,30. Matokeo haya yanaonyesha kuwa vigezo zaidi vya kimienendo havitengenezi kiotomatiki modeli bora na kwamba njia thabiti zisizobadilika zinaweza kuwa muhimu kwa uboreshaji.
Mwingiliano wa usimbaji wa nafasi na gating
| Mpangilio wa GGD | log g | Teff | [C/Fe] | [Fe/H] |
|---|---|---|---|---|
| Usimbaji wa nafasi usiobadilika, bila gate | 0,086 | 54,82 | 0,047 | 0,041 |
| Usimbaji unaojifunza, bila gate | 0,080 | 52,28 | 0,047 | 0,042 |
| Usimbaji usiobadilika na gating | 0,089 | 57,07 | 0,046 | 0,042 |
| Usimbaji unaojifunza na gating | 0,079 | 50,18 | 0,045 | 0,042 |
Gating ilipounganishwa na usimbaji wa nafasi usiobadilika, matokeo ya log g na Teff yalizorota. Ilipounganishwa na usimbaji wa nafasi unaojifunza, ilifikia matokeo bora au yaliyofungana kwa ubora katika vipimo vitatu.
Tafsiri ya makala kwamba ni “bora katika vipimo vyote” hailingani kabisa na jedwali. Kwa [Fe/H], kosa la chini zaidi la 0,041 lilipatikana katika mpangilio wa usimbaji wa nafasi usiobadilika bila gate; thamani ya mpangilio kamili wa GGD ni 0,042.
Nguvu za utafiti
- Matatizo ya mifumo ya ndani na utegemezi wa kimataifa yamegawanywa katika kazi wazi ndani ya usanifu mmoja.
- Matumizi ya convolution ya kimienendo pamoja na matawi thabiti yasiyobadilika, badala ya blok ya kimienendo kabisa, yamejaribiwa.
- Ablation tofauti na za pamoja zimewasilishwa kwa DLG na GGD.
- Mwingiliano wa usimbaji wa nafasi na utaratibu wa gating umechunguzwa kwa jaribio la 2×2.
- Matokeo ya regresha ya astronomia yameripotiwa si tu kwa wastani wa jumla bali kando kwa vigezo vinne vya kifizikia.
- Kwa kundi dogo nadra kama CEMP, sensitivity, precision na F1 zimeripotiwa.
- Maeneo ya spektra ambayo modeli inaangazia yamelanishwa na mistari ya kifizikia.
- Jaribio la pili limefanywa kwa kubadilisha wazo lile lile la usanifu kwa mifuatano ya biomedical yenye urefu tofauti.
- Gharama ya kihesabu imeongezwa kwenye jedwali la ablation kwa FLOP.
Mapungufu ya msingi ya utafiti
- Hali ya mapitio: Utafiti haujapitiwa na wataalamu wenza.
- Seti huru ya majaribio: Kwa LSS zimeelezwa sehemu za mafunzo na uthibitishaji pekee.
- Upatikanaji wa data: Ingawa LSS inadaiwa kuwa ya wazi kwa umma, imeelezwa kuwa data na msimbo vitashirikiwa baada ya uchapishaji.
- Maelezo ya mafunzo: Algoriti ya uboreshaji, learning rate, batch size, idadi ya epoch, loss function, weight decay na ratiba ya learning rate hazijaelezwa.
- Maelezo ya usanifu: Idadi ya njia, urefu wa kernel, idadi ya attention head, upana wa mtandao wa feed-forward na thamani za dropout hazipo.
- Uzalishaji upya: Random seed, marudio huru ya mafunzo na matokeo ya mean±standard deviation hayajaripotiwa.
- Ulinganisho wa takwimu: Hakuna confidence interval au jaribio la takwimu lililotolewa kwa umuhimu wa tofauti kati ya modeli.
- Uchambuzi wa SNR: Sampuli zimechaguliwa tu kwa sharti la S/N>5; utendaji haujagawanywa kwa masafa tofauti ya SNR.
- Athari ya uchakataji wa awali: Mlolongo mkubwa wa uchakataji, ukiwemo ulalishaji wa Savitzky–Golay, umetumika.
- Kutokuwiana kwa madarasa: Uwiano wa CEMP ni takribani %0,74 tu.
- Mgawanyo wa data ya ECG: Protokoli ya majaribio huru kwa msingi wa mgonjwa haijaelezwa.
- Ulinganisho wa ECG: Tafiti za awali hazikutumia madarasa yale yale wala protokoli ile ile ya mgawanyo.
- Uhamisho kati ya nyanja: Uzito wa modeli ya astronomia haukuhamishwa kwenda kwenye kazi ya ECG; modeli iliundwa upya na kufundishwa.
- Upeo wa ufafanuzi: Uchambuzi wa saliency umewekewa kikomo kwenye sampuli moja ya nyota iliyochaguliwa.
- Gharama ya kihesabu: Mtandao kamili unahitaji takribani mara 3,16 ya FLOP za usanifu wa msingi.
- Utendaji wa vifaa: Muda wa mafunzo, muda wa inference, matumizi ya kumbukumbu na vifaa vilivyotumika havijaripotiwa.
Matokeo yanayoungwa mkono na utafiti
- LGADNet ilitoa MAE ya chini kuliko modeli zilizolinganishwa katika vipimo vya Teff, [C/Fe] na [Fe/H] kwenye mpangilio wa uthibitishaji wa LSS uliotumika.
- DLG na GGD zilipotumika pamoja, utabiri wa vigezo uliokuwa na uwiano zaidi ulipatikana kuliko zilipotumika kila moja pekee.
- Kutumia convolution ya kimienendo katika matawi yote hakukuongeza utendaji na katika baadhi ya vipimo kulizorotesha kwa kiasi kikubwa.
- Usimbaji wa nafasi unaojifunza uliunda mpangilio ambamo utaratibu wa gating ulifanya kazi kwa manufaa zaidi.
- Katika utambuzi wa CEMP, LGADNet ilifikia precision na alama ya F1 za juu zaidi.
- Katika jaribio la MIT-BIH, mbinu ilitoa usahihi wa jumla wa juu na alama za F1 za juu katika baadhi ya madarasa chini ya mpangilio wa madarasa matano.
Matokeo ambayo utafiti haujathibitisha
- Haijaonyeshwa kuwa LGADNet ndiyo mbinu bora kwa aina zote za ishara zenye SNR ya chini.
- Haijathibitishwa kuwa modeli itadumisha usahihi ule ule katika tafiti huru za astronomia ambazo haijawahi kuona.
- Uwezo wa mbinu kujumlisha katika darubini tofauti, resolution tofauti au calibration tofauti za urefu wa wimbi haujajaribiwa.
- Haijaonyeshwa kuwa LGADNet inafaa kwa mifumo ya real-time au mifumo ya uzalishaji yenye ujazo mkubwa.
- Ramani ya saliency haithibitishi kwamba maamuzi ya modeli yanategemea kwa sababu mistari ya kifizikia.
- Matokeo ya ECG si ushahidi wa usalama wa utambuzi wa kliniki au uwezo wa kujumlisha nje kwa msingi wa mgonjwa.
- Hakuna kujifunza kwa zero-shot au uhamisho wa uzito kutoka astronomia kwenda eneo la ECG uliofanywa.
- Haijaonyeshwa kuwa seti ya data ya LSS ilikuwa inaweza kupakuliwa na kuzalishwa upya na watafiti huru wakati wa ukaguzi.
Umuhimu wa kisayansi na kiteknolojia
Mchango mkuu wa LGADNet ni kwamba haiishii kuweka mfululizo utoaji wa vipengele vya ndani na umodeli wa utegemezi wa kimataifa; badala yake, hulisha hatua ya kimataifa kwa toleo la vipengele vya ndani lililorekebishwa na kupitishwa kwenye gating.
Mbinu hii inaweza kutathminiwa kwa matatizo ambamo taarifa bainifu imejikita katika maeneo mafupi lakini utabiri wa mwisho unategemea muktadha mpana zaidi wa mfuatano. Spektra za astronomia na ishara za ECG ni mifano miwili iliyotumika katika utafiti; mbinu bado haijajaribiwa kwenye aina nyingine za sensor au data za kisayansi.
Katika astronomia, modeli inaweza kusaidia kutoa vigezo vya nyota na wagombea wa nyota nadra kutoka kwenye hazina kubwa za spektra. Kwa hili, uthibitishaji wa nje kwenye darubini tofauti, ukadiriaji wa uncertainty, upatikanaji wa data na majaribio huru vinahitajika.
Katika biomedical, utafiti hautoi kifaa cha kliniki au mfumo wa utambuzi. Matokeo hayapaswi kujumlishwa kwenda kwenye matumizi ya kliniki bila tathmini kwa msingi wa mgonjwa, rekodi kutoka vituo tofauti, uchambuzi wa artefact, uwiano wa sensitivity–specificity na ulinganisho na madaktari.
Mbinu na Matokeo ya Utafiti
Muhtasari wa mbinu ya kiufundi
| Kipengele | Mbinu iliyotumika katika utafiti |
|---|---|
| Modeli | LGADNet |
| Moduli ya ndani | Dynamic Local Guidance — DLG |
| Matawi ya DLG | Tawi la ndani lenye convolution mbili, tawi la kimienendo lenye kernel nne zinazogombea na njia fupi yenye convolution moja |
| Idadi ya kernel za kimienendo | G=4 |
| Uzalishaji wa uzito wa kimienendo | Global average pooling na mtandao mwepesi wa gating |
| Moduli ya kimataifa | Gated Global Denoising — GGD |
| Usimbaji wa nafasi | Unaojifunza, urefu wa juu 1000 |
| Gating | Sigmoid na kuzidisha kwa kiwango cha elementi |
| Kina cha Transformer | Blok mbili za encoder |
| Urefu wa ingizo la astronomia | Nukta 4901 |
| Idadi ya DLG ya astronomia | Blok sita |
| Urefu wa ingizo la ECG | Nukta 187 |
| Idadi ya DLG ya ECG | Blok mbili |
| Kazi ya astronomia | Regresha ya vigezo vinne endelevu vya nyota |
| Kazi ya biomedical | Uainishaji wa mapigo ya moyo wa madarasa matano |
Muhtasari wa data ya LSS
| Kipengee | Taarifa |
|---|---|
| Chanzo cha ingizo | Spektra za azimio la chini za LAMOST DR12 |
| Vyanzo vya lebo | APOGEE DR17, LAMOST–Subaru na SAGA |
| Radius ya ulinganishaji | Sekunde 3 za arc |
| Sharti la SNR | S/N>5 |
| Sampuli za awali zilizolinganishwa | 189.780 |
| Seti ya mwisho ya data | Spektra 59.983 |
| Seti ya mafunzo | 47.984 |
| Seti ya uthibitishaji | 11.999 |
| Seti tofauti ya majaribio | Haijaripotiwa |
| Malengo ya utabiri | Teff, log g, [Fe/H] na [C/Fe] |
Matokeo makuu ya kiasi
- LGADNet log g MAE: 0,079
- LGADNet Teff MAE: 50,18
- LGADNet [C/Fe] MAE: 0,045
- LGADNet [Fe/H] MAE: 0,042
- Usahihi wa utambuzi wa CEMP: 0,996
- Sensitivity ya CEMP: 0,652
- Precision ya CEMP: 0,816
- Alama ya F1 ya CEMP: 0,725
- Usahihi wa jumla wa MIT-BIH: 0,991
- F1 ya darasa N: 0,996
- F1 ya darasa S: 0,975
- F1 ya darasa V: 0,887
- F1 ya darasa F: 0,846
- F1 ya darasa Q: 0,996
- Gharama ya modeli ya msingi: FLOP milioni 133,1
- Gharama ya LGADNet kamili: FLOP milioni 420
Ujumbe mkuu wa vielelezo na majedwali
| Kielelezo | Maudhui | Kikomo cha tafsiri |
|---|---|---|
| Kielelezo 1 | Mtiririko wa usanifu wa DLG, mchanganyiko wa kernel za kimienendo, GGD na kichwa cha utabiri | Idadi ya njia na hyperparameters za mafunzo hazijaonyeshwa. |
| Kielelezo 2 | Spektra tatu za uwakilishi kutoka madarasa ya CEMP, MP-no-CEMP na Nyingine | Sampuli tatu zilizochaguliwa haziwakilishi usambazaji wa jumla wa data. |
| Kielelezo 3 | Usambazaji wa utabiri–thamani halisi kwa vigezo vinne vya nyota | Hakuna mgawanyo wa kosa kwa SNR na vikundi vidogo vya vigezo. |
| Kielelezo 4 | Mistari ya spektra na ramani ya saliency ya gradient ya ingizo kwa utabiri wa [C/Fe] | Saliency ya sampuli moja haitoi tafsiri ya kisababishi. |
| Jedwali 2 | Ulinganisho wa MAE kwa vigezo vinne vya nyota | Variance ya marudio na jaribio la umuhimu havijatolewa. |
| Jedwali 3 | Usahihi, sensitivity, precision na F1 za utambuzi wa CEMP | Usambazaji wa madarasa hauko sawa kwa kiasi kikubwa. |
| Jedwali 4 | Ulinganisho wa ECG wa madarasa matano kwenye MIT-BIH | Protokoli za madarasa na mgawanyo wa data za machapisho yaliyolinganishwa si sawa. |
| Jedwali 5–6 | Michango tofauti na ya pamoja ya moduli za DLG na GGD | Haijaelezwa matokeo yametokana na marudio mangapi ya mafunzo. |
| Jedwali 7 | Uwekaji wa convolution ya kimienendo katika matawi tofauti | Mipangilio tofauti hutoa matokeo bora kwa vigezo tofauti. |
| Jedwali 8 | Mwingiliano wa usimbaji wa nafasi na gating | Mpangilio kamili haukutoa kosa la chini zaidi kwa [Fe/H]. |
Taarifa zinazokosekana kwa uzalishaji upya
- Seti tofauti na iliyofungwa ya majaribio
- Algoriti ya uboreshaji
- Learning rate na ratiba ya learning rate
- Batch size
- Idadi ya epoch za mafunzo
- Loss function za regresha na uainishaji
- Upana wa njia na ukubwa wa kernel za convolution
- Idadi ya attention head za Transformer
- Viwango vya dropout
- Idadi ya vigezo vya modeli
- Random seed
- Wastani na standard deviation za marudio huru
- Vifaa vya mafunzo na inference
- Muda wa mafunzo, ucheleweshaji wa inference na matumizi ya kumbukumbu
- Protokoli ya mgawanyo wa data kwa msingi wa mgonjwa kwa MIT-BIH
- Hifadhi inayoweza kufikiwa ya seti ya data ya LSS na msimbo chanzo
Maelezo ya Chanzo na Mbinu
- Jina kamili asilia la utafiti: LGADNet: A Local-Guided Adaptive Denoising Network for Low-SNR Sequential Signal Modeling
- Waandishi na mpangilio wao: Jinfan Li; Xiangru Li
- Mchango sawa au uandishi wa kwanza wa pamoja: Haujaelezwa.
- Mwandishi wa mawasiliano: Xiangru Li
- Barua pepe ya mwandishi wa mawasiliano: xiangru.li@gmail.com
- Barua pepe ya mwandishi wa kwanza: joinfancy2024@163.com
- Taasisi: South China Normal University, School of Computer Science, No. 55 Zhongshan West Road, Guangzhou, Guangdong, China
- ORCID: Kitambulisho cha ORCID hakijatolewa katika utafiti.
- Aina ya chanzo: Makala ya utafiti ya preprint katika maeneo ya kujifunza kwa kina, uchambuzi wa spektra za astronomia na uchakataji wa ishara za biomedical
- Hali ya mapitio ya wataalamu wenza: Haijapitiwa na wataalamu wenza.
- Jukwaa la preprint: SSRN
- Nambari ya rekodi ya SSRN: 6958831
- DOI: 10.2139/ssrn.6958831
- Jarida: Hakuna jarida maalum lililopitiwa na wataalamu wenza lililothibitishwa.
- Hali ya uchapishaji: Utafiti una kauli “Preprint submitted to Elsevier”; kauli hii haimaanishi kukubaliwa au kuchapishwa baada ya mapitio ya wataalamu wenza.
- Mchapishaji asilia aliyepitiwa: Hajathibitishwa.
- Kiungo rasmi:Rekodi ya utafiti ya SSRN
- Ufadhili: Watafiti wameripoti kuwa hawakupokea ufadhili maalum kutoka mashirika ya umma, kibiashara au yasiyo ya faida.
- Mgongano wa maslahi: Watafiti wametangaza kuwa hakuna mgongano wa kifedha unaojulikana au uhusiano wa binafsi.
- Michango ya waandishi: Jinfan Li; conceptualization, methodology, software, validation, formal analysis, first draft na visualization. Xiangru Li; supervision, review na editing.
- Upatikanaji wa data na msimbo: Sehemu ya upatikanaji wa data inaeleza kwamba msimbo chanzo na seti ya data vitashirikiwa baada ya uchapishaji katika hifadhi ya GitHub ya waandishi. Wakati wa ukaguzi hakuna kiungo cha hifadhi ya wazi kilichotolewa.
Makala hii ya Verianla imeandaliwa kwa msingi wa hoja ya kinadharia ya utafiti, usanifu wa mtandao, ufafanuzi wa kihisabati, mchakato wa maandalizi ya data, matokeo ya regresha ya astronomia, vipimo vya utambuzi wa CEMP, uainishaji wa ECG, uchambuzi wa saliency na majaribio ya ablation. Hakuna manufaa ya kliniki, ugunduzi wa astronomia au mafanikio ya mfumo wa uzalishaji ambayo hayapo katika utafiti yaliyoongezwa.
Matokeo yanategemea mpangilio wa uthibitishaji ulioelezwa badala ya seti huru ya majaribio. Kwa kuwa maelezo muhimu ya protokoli ya mafunzo na tathmini hayapo, majedwali hayapaswi kuonekana kama ushahidi kamili na wa mwisho wa ubora wa mbinu moja dhidi ya nyingine. Upatikanaji wa LSS, mgawanyo wa ECG kwa msingi wa mgonjwa, tabia ya modeli katika viwango tofauti vya SNR na uwezo wa kuzalishwa upya na vikundi huru vya utafiti vinahitaji kufafanuliwa.
Matokeo yenye nguvu zaidi ya LGADNet ni kupunguza makosa ya halijoto fanisi, wingi wa kaboni na wingi wa metali katika mpangilio wa LSS uliotumika. Kwa upande mwingine, mbinu haikupata matokeo bora kabisa katika mvutano wa uso, sensitivity ya juu zaidi katika utambuzi wa CEMP, usahihi wa jumla wa juu zaidi katika jaribio la ECG au alama ya F1 ya juu zaidi kwa darasa V. Tofauti hizi zinapaswa kuhifadhiwa ili matokeo ya utafiti yatafsiriwe kwa uwiano.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *