

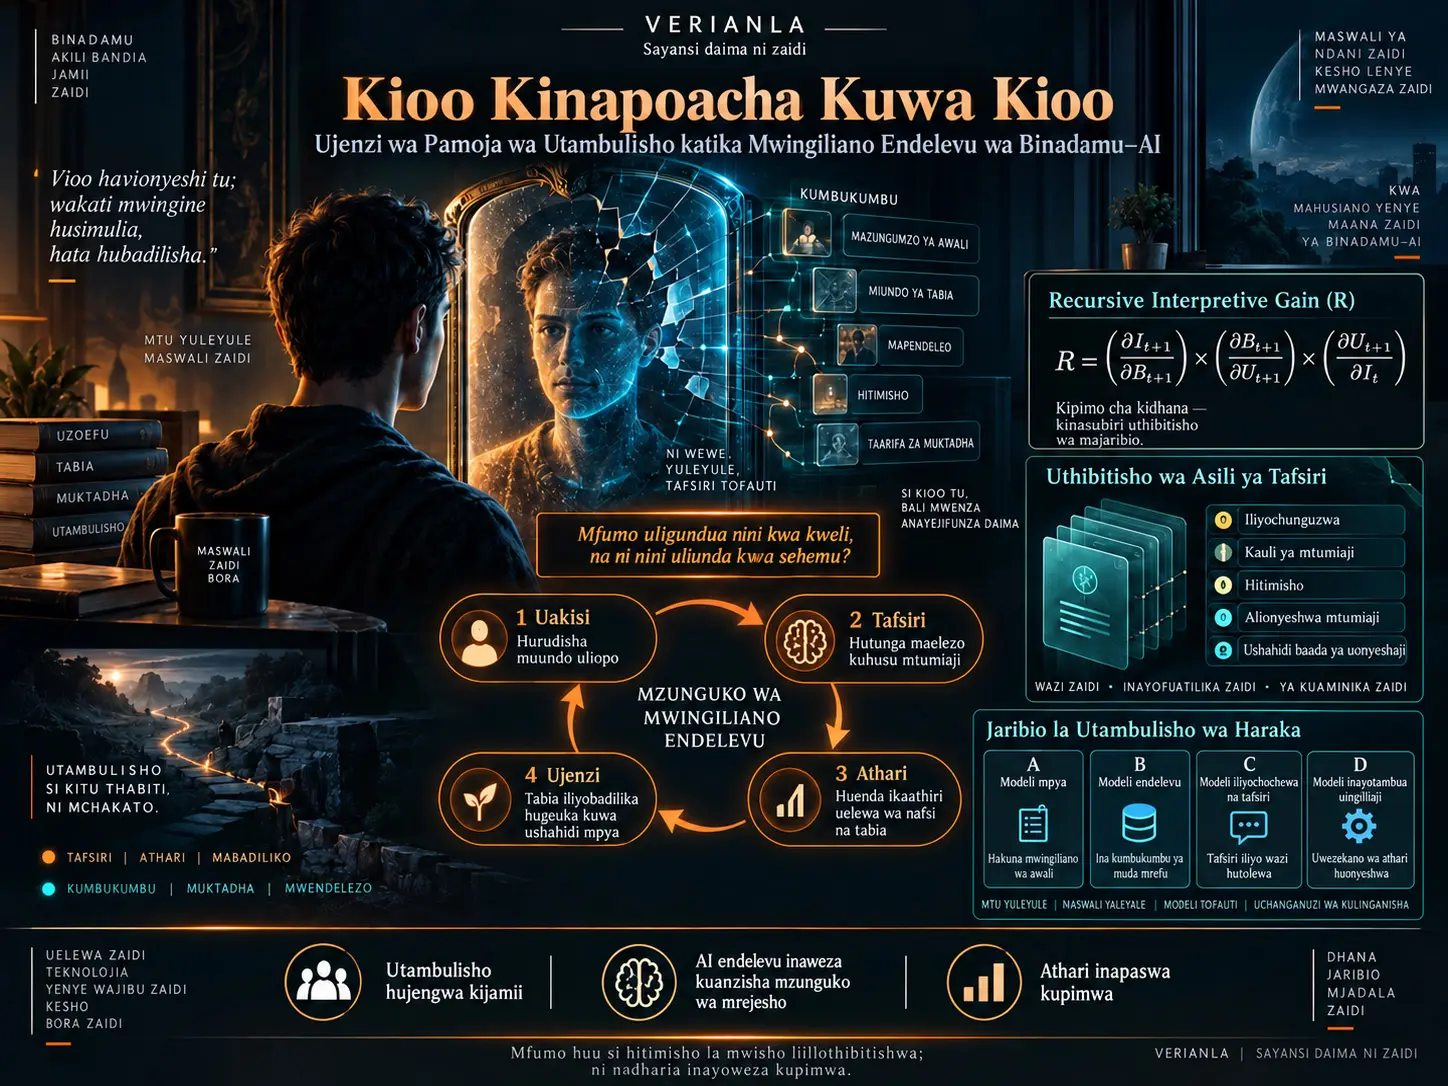
Mfumo endelevu wa akili bandia (persistent AI system) ni mfumo wa AI unaokumbuka mwingiliano unaoendelea na mtumiaji fulani kwa muda, unaotengeneza mifumo na tafsiri kuhusu mtumiaji kutokana na historia hiyo, na unaoweza kuwasilisha tafsiri hizo tena kwa mtumiaji. Utafiti huu unasema kuwa mfumo kama huo hauwezi tena kufikiriwa kuwa “kioo kinachoakisi” mtumiaji tu. Mfumo unaweza kutoa sifa fulani kuhusu mtumiaji na kumwambia; tafsiri hiyo inaweza kuathiri umakini wa mtumiaji, namna anavyojieleza au tabia yake, kisha mfumo unaweza baadaye kuichukulia tabia hiyo iliyobadilika kama uthibitisho huru wa tafsiri yake ya awali. Mzunguko kama huo ukitokea, mfumo huwa na ugumu wa kutenganisha kwa uwazi kile ulichogundua kwa kweli kuhusu mtumiaji na kile ulichokichangia kukijenga kwa sehemu kupitia mwingiliano wake wenyewe.
Makala inapanga mchakato huu katika hatua nne: reflection ni kuakisi tena muundo uliopo; interpretation ni mfumo kujenga nadharia ya kueleza uhusiano kati ya uchunguzi; influence ni tafsiri ya AI kuathiri uelewa wa mtumiaji kuhusu nafsi yake au tabia yake; na construction ni pale tabia hiyo iliyoathiriwa inapoingia katika tathmini za baadaye za AI kama ushahidi mpya. Mwandishi anapendekeza ukubwa unaoitwa recursive interpretive gain, \(R\) ili kueleza kwa dhana mpito wa kurejeana kati ya influence na construction; hata hivyo anasisitiza kwamba \(R\) si kipimo kilichothibitishwa au kinachoweza kupimwa moja kwa moja leo.
Fasihi ya binadamu ambayo utafiti huu unategemea inajumuisha reflected appraisal, self-perception, expectancy effects, behavioural confirmation, labelling, reconstructive autobiographical memory na narrative identity, ambazo zinaonyesha kwamba utambulisho tayari kihistoria umeundwa kwa pamoja na tathmini za wengine. Kwa upande wa machine-learning, performative prediction na algorithmic confounding hutoa ulinganifu wa kimuundo ambapo matokeo ya mfumo hubadilisha usambazaji wa data ya baadaye na mfumo baadaye unaweza kutumia athari yake ya kisababishi kana kwamba ni data mpya. Dai la asili la mwandishi ni kufafanua wazi tatizo la kielimu linalojirudia linalotokea kwa kutumia vipengele vya fasihi hizi katika uhusiano endelevu wa binadamu–AI.
Makala haiishii tu kufafanua tatizo. Inapendekeza kanuni ya usanifu inayoitwa Interpretive provenance: mfumo unapaswa kuhifadhi si tu kile unachoamini kuhusu mtumiaji, bali pia namna imani hiyo ilivyoundwa. Aidha, identity cold-read test yenye hali nne inapendekezwa ili kujaribu kwa namna inayoweza kukanushwa ikiwa picha ya mtumiaji katika mfumo persistent imegunduliwa kwa kweli kutokana na tabia au imeimarishwa kwa kurithi tafsiri zake za awali.
Maelezo ya Kina
Dhana ya sitiari ya “kioo” ni ipi?
Kwa akili bandia inayotegemea mazungumzo, sitiari ya “kioo” inaonekana kuwa muhimu kwa mtazamo wa kwanza. Mtumiaji anasema jambo, mfumo unapanga nyenzo hiyo ya lugha, unaipanua, unaieleza upya, na mtumiaji anaona toleo lililochakatwa la mawazo yake mwenyewe.
Lakini kioo cha kawaida kina sifa muhimu: hakibadilishi kitu kinachokiakisi. Kioo halisi huonyesha uso, lakini hakitoi maoni kuhusu uso na hivyo kubadilisha tabia ya baadaye au uelewa wa nafsi wa mtu huyo.
Katika mfumo wa AI endelevu, dhana hii inaweza kuvunjika. Mfumo unaweza kukumbuka mazungumzo kwa miaka, kuunganisha mifumo iliyojitokeza katika nyakati tofauti, na kuyaeleza moja kwa moja kwa mtumiaji. Tafsiri kama “Unaonekana kuthamini uhuru zaidi kuliko usalama” si muhtasari wa yaliyopita tu; mtumiaji akiikubali tafsiri hiyo kama ushahidi mpya kuhusu yeye mwenyewe, tafsiri hiyo inaweza kuwa mojawapo ya sababu za tabia ya baadaye.
Kwa Nini Akili Bandia Endelevu Si “Kioo” Tu?
Akili bandia endelevu si mtazamaji asiye na athari ya kisababishi kwa sababu haiakisi tabia ya zamani tu, bali inaweza pia kumrudishia mtumiaji tafsiri kuhusu tabia hiyo. Tafsiri ya mfumo inaweza kuathiri umakini wa mtumiaji, namna anavyojifafanua au tabia yake, na ikiwa tabia iliyobadilika baadaye inaingia tena katika kumbukumbu ya mfumo, mpaka kati ya uakisi na uingiliaji unakuwa hafifu.
Utambulisho tayari ulikuwa unajengwa kwa pamoja kijamii
Makala inakataa wazi dai kali na lisilo na muktadha wa kihistoria kwamba AI “imeathiri utambulisho wa binadamu kwa mara ya kwanza kutoka nje.” Badala yake, inaanza na fasihi inayoonyesha kuwa utambulisho wa binadamu tayari huundwa kijamii.
Mtazamo wa Cooley wa looking-glass self ulisema kuwa mtu hujijenga kwa sehemu kupitia namna anavyofikiri wengine wanamwona. Mead aliendeleza muundo huu kupitia mtu kujitazama kutoka kwa mtazamo wa wengine. Tafiti za reflected appraisal zimeonyesha kwamba kujitathmini kwa mtu huundwa si tu na kile wengine wanachofikiri kwa kweli, bali pia na mtazamo wake kuhusu kile anachoamini wengine wanafikiria.
Tofauti hii ni muhimu kwa persistent AI; kwa sababu katika mahusiano ya kibinadamu tathmini ya mwingine mara nyingi hukisiwa, ilhali AI inaweza kuitamka moja kwa moja, kwa maandishi na kwa undani.
Umuhimu wa Self-perception na tafsiri zilizo tayari
Katika self-perception theory ya Bem, watu wanaweza kutoa hitimisho kuhusu mitazamo na sifa zao kwa kuchunguza tabia zao wenyewe, hasa katika hali ambapo hali ya ndani haiko wazi. Katika hali hiyo, mfumo unaochagua, kupanga na kugeuza tabia ya zamani ya mtumiaji kuwa maelezo hau “tafsiri matokeo” tu; unaweza pia kuathiri ni kwa fremu gani ushahidi unaotumika kuzalisha kujijua unaonekana.
Expectancy effects na behavioural confirmation
Mojawapo ya mlinganisho wenye nguvu wa kibinadamu kwa utaratibu wa makala ni fasihi ya behavioural confirmation. Mchunguzi akiwa na dhana fulani kuhusu mtu, anaweza kupitia tabia yake mwenyewe kuchochea tabia inayolingana na dhana hiyo kwa mtu anayelengwa. Tabia inayojitokeza baadaye inaweza kuonekana kama uthibitisho wa dhana ya awali.
Mwandishi anaunganisha hili kimuundo na tatizo la persistent AI: mfumo unatoa tafsiri, tafsiri inamwathiri mtumiaji, mabadiliko kwa mtumiaji yanaonekana tena, na mfumo unasajili tabia hiyo kama msaada mpya kwa tafsiri yake ya awali.
Labelling, autobiographical memory na narrative identity
Fasihi ya labelling inaonyesha kwamba kuwekwa kwa mtu katika kundi fulani kijamii au kitaasisi kunaweza kuathiri uelewa wake wa nafsi na pia namna tabia za baadaye zinavyotafsiriwa.
Tafiti za autobiographical memory zinaichukulia kumbukumbu ya binadamu si kama jalada lisilobadilika, bali kama muundo unaojengwa upya kila mara kwa kuzingatia schema za sasa na nafsi ya sasa. Katika mtazamo wa narrative identity, mtu hujenga mwendelezo wa utambulisho kupitia hadithi inayoendelea inayochagua, kupanga na kutoa maana kwa matukio ya maisha.
Swali la makala si kama taratibu hizi za kibinadamu zipo. Mwandishi anachukulia hilo kuwa sehemu ya kuanzia iliyokubaliwa. Swali kuu ni kwa kiasi gani kumbukumbu, mwendelezo na uwezo wa kutafsiri wa persistent AI hubadilisha vigezo vya mzunguko wa mrejesho.
Sifa tano za kimuundo zinazobadilishwa na Persistent AI
1. Kumbukumbu isiyosahau au kupungua: Watu husahau maelezo na mifano yao kuhusu mtu wa zamani inaweza kubadilika. Mfumo persistent unaweza kurudisha kauli ya miaka iliyopita kwa namna ileile. Hii inaweza kuleta manufaa halisi, lakini pia inaweza kufanya nafsi ya zamani ibaki kuwa ushahidi unaopatikana kila wakati.
2. Tafsiri ya maandishi inapohitajika: Watu mara nyingi hukisia kile wengine wanachofikiri kuwahusu. AI inaweza kutoa tathmini iliyoandaliwa, yenye mifano na ya maandishi inapohitajika.
3. Mwendelezo na kiwango cha umakini: Mfumo unaweza kuwa na mwingiliano mwingi kwa miaka na kutumia tena mazungumzo yaliyopita. Msongamano huu unatofautiana na kiwango cha mahusiano cha watafsiri wengi wa kibinadamu.
4. Uthabiti: Tathmini za kibinadamu zinaweza kutofautiana. Mfumo mmoja unaweza kutumia mara kwa mara tafsiri zake zilizorekodiwa hapo awali na kujenga uthabiti unaoonekana kuwa mkubwa. Makala inaonya kuhusu hatari ya kuchanganya uthabiti na usahihi.
5. Athari ya AI iliyoonyeshwa: Chanzo kinatumia jaribio la Jakesch na wenzake lililoonyesha kwamba kuandika kwa kutumia opinionated AI assistant kunaweza kubadilisha maoni ambayo watumiaji huripoti baadaye; na jaribio la Costello, Pennycook na Rand lililoripoti kwamba mazungumzo ya AI yaliyobinafsishwa yalisababisha upungufu wa kudumu katika baadhi ya imani za njama, kama ushahidi wa causal channel. Mwandishi anasisitiza kwamba tafiti hizi hazionyeshi moja kwa moja identity co-construction.
Mgawanyo wazi wa hali ya kielimu ndani ya chanzo
| Kiwango | Tathmini ya chanzo |
|---|---|
| Established | Reflected appraisal, behavioural confirmation, labelling, reconstructive memory, narrative identity; pamoja na matokeo ya majaribio kuhusu athari ya AI kwa mitazamo iliyoelezwa na baadhi ya imani. |
| Plausibly suggested | Uwezekano kwamba persistence, articulacy, scale na consistency zinaweza kukuza athari za appraisal za kibinadamu. |
| Hypothesised by this paper | Mzunguko kufikia aina ya recursive na evidence-contaminating construction. |
| Unknown | Ukubwa wa athari, kuenea kwake na udumu wake mbele ya competing human influence. |
Ujenzi wa Pamoja wa Utambulisho Unawezaje Kutokea Katika Hatua Nne?
Mchakato unaopendekezwa na makala una hatua nne: mfumo kwanza huakisi muundo uliopo, kisha huongeza tafsiri ya kuueleza, tafsiri hiyo huathiri uelewa wa mtumiaji kuhusu nafsi yake au tabia yake, na tabia iliyoathiriwa inapoingia kuwa ushahidi wa baadaye wa mfumo, mchakato huingia hatua ya construction. Tatizo la kielimu katika hatua ya mwisho ni kwamba mfumo unaweza kuchukulia athari yake ya zamani kama data huru ya mtumiaji.
Hatua ya 1 — Reflection
Mfumo hutambua muundo ambao tayari upo katika historia ya mtumiaji. Katika mfano wa chanzo, hitimisho kama “Unaonekana kuthamini uhuru” linaweza kubaki katika kiwango cha retrieval na summarisation ikiwa ni sahihi.
Hatua ya 2 — Interpretation
Badala ya kutaja muundo pekee, mfumo hujenga uhusiano wa kueleza kati ya matukio tofauti. Kwa mfano, kusema kwamba upendeleo wa uhuru unaeleza maamuzi ya kazi na mahusiano ni tafsiri inayochagua uchunguzi na kuyaunganisha chini ya nadharia fulani ya kisababishi.
Msisitizo wa mwandishi ni kwamba maelezo zaidi ya moja yanaweza kuendana na historia ileile. Kwa hiyo, tafsiri inayochaguliwa na mfumo huenda isiwe maana pekee ya lazima ya data hiyo.
Hatua ya 3 — Influence
Tafsiri inapowasilishwa kwa mtumiaji, anaweza kuanza kujiona ndani ya fremu hiyo. Umakini, autobiographical memory retrieval, self-description na fremu za maamuzi zinaweza kubadilika kuelekea self-schema mpya.
Hatua hii bado si construction. Makala inakubali kwamba influence inaweza kuwepo katika mazungumzo yote muhimu; tatizo la kipekee ni influence kurejea baadaye katika ushahidi wa mfumo.
Hatua ya 4 — Construction
Tabia ya mtumiaji iliyorekebishwa huingia katika interaction record. Mfumo unapoiona rekodi hii katika tafsiri ya baadaye, unaweza kuichukulia tabia iliyotokea chini ya athari ya tafsiri yake ya zamani kana kwamba ni uchunguzi mpya ulio huru kutoka kwa AI.
Mlolongo wa recursive uliotolewa na chanzo ni huu:
\[ \text{user} \rightarrow \text{interpretation} \rightarrow \text{adaptation} \rightarrow \text{behaviour} \rightarrow \text{observation} \rightarrow \text{strengthened interpretation} \]
Katika hatua hii, uchunguzi na ushiriki haviwezi kutenganishwa kikamilifu.
Muundo rasmi wa kiwango cha chini
Chanzo kinajenga modeli kwa vigezo vifuatavyo:
- \(U_t\): hali husika ya mtumiaji katika wakati \(t\); uelewa wa nafsi na mielekeo ya kitabia.
- \(H_t\): interaction history iliyokusanywa ambayo modeli inaweza kufikia.
- \(M_t\): representation ambayo modeli huhifadhi kuhusu mtumiaji.
- \(I_t\): interpretation inayotengenezwa na modeli.
- \(X_t\): athari za nje zisizotokana na AI; mahusiano, matukio ya maisha na endogenous change.
- \(B_t\): observable behaviour na self-report.
Kwa dhana, mfumo huendelea kwa namna ifuatayo:
\[ I_t=f(H_t,M_t) \]
\[ U_{t+1}=g(U_t,I_t,X_t) \]
\[ B_{t+1}=h(U_{t+1}) \]
\[ M_{t+1}=k(M_t,B_{t+1},I_t) \]
Fomula zinaeleza nini? Usemi wa kwanza unaonyesha kwamba tafsiri ya mfumo huzalishwa kutokana na historia na representation ya sasa ya mtumiaji; wa pili kwamba hali inayofuata ya mtumiaji inaweza kuundwa na hali ya awali ya mtumiaji, tafsiri ya AI na athari za nje; wa tatu kwamba hali ya mtumiaji hujitokeza kama tabia au self-report; na wa nne kwamba modeli ya mtumiaji iliyohifadhiwa na mfumo husasishwa kwa tabia mpya na tafsiri ya awali.
Vipimo: Chanzo hakijapeana vitengo vya kifizikia au mizani ya kipimo kwa vigezo hivi. Modeli ni ya dhana.
Dhana: \(f\), \(g\), \(h\) na \(k\) si fungsi mahususi zilizokalibishwa kwa njia ya majaribio; ni fungsi za kufikirika zinazoonyesha muundo wa kisababishi wa mahusiano.
Recursive Interpretive Gain \(R\) Inaeleza Nini?
Recursive interpretive gain, \(R\) ni kipengele cha kuzidisha kinachoeleza kwa dhana kiwango ambacho athari ya tafsiri ya AI ya leo kwa mtumiaji hurudishwa kupitia tabia hadi katika tafsiri ya AI ya kesho. Chanzo hakipendekezi hiki kama kipimo cha kisaikolojia kilichothibitishwa au kinachoweza kupimwa moja kwa moja leo, bali kama njia ya kufanya tofauti kati ya influence na recursive construction ionekane kimahesabu.
Sharti la kwanza la kisababishi ni hili:
\[ \frac{\partial U_{t+1}}{\partial I_t} \neq 0 \]
Usemi huu unamaanisha kwamba mabadiliko katika tafsiri ya AI yanaweza kusababisha mabadiliko katika hali inayofuata ya mtumiaji. Ikiwa derivative hii si sifuri, mfumo si passiv kabisa; lakini hili ni sharti la Stage 3 — influence pekee.
Kwa tatizo la recursive, tafsiri inayofuata lazima itumie tabia ambayo tayari imebadilishwa kwa sehemu na tafsiri ya awali:
\[ I_t \rightarrow U_{t+1} \rightarrow B_{t+1} \rightarrow I_{t+1} \]
Chanzo kinafafanua recursive interpretive gain katika njia hii kwa namna ifuatayo:
\[ R= \left(\frac{\partial I_{t+1}}{\partial B_{t+1}}\right) \cdot \left(\frac{\partial B_{t+1}}{\partial U_{t+1}}\right) \cdot \left(\frac{\partial U_{t+1}}{\partial I_t}\right) \]
Fomula inakokotoa nini? Kwa dhana, inawakilisha unyeti wa jumla uliopitishwa wa tafsiri ya leo \(I_t\) hadi tafsiri ya kesho \(I_{t+1}\) kupitia hali na tabia ya mtumiaji.
Kipengele cha kwanza kinawakilisha jinsi tafsiri inayofuata ya AI ilivyo nyeti kwa tabia mpya.
Kipengele cha pili kinawakilisha jinsi tabia inayoonekana ilivyo nyeti kwa hali ya mtumiaji.
Kipengele cha tatu kinawakilisha jinsi hali ya mtumiaji ilivyo nyeti kwa tafsiri ya awali ya AI.
Jukumu la kimahesabu: Muundo wa kuzidisha unaofanana na kanuni ya mnyororo unaonyesha mediated path ambayo influence hupitishwa hadi interpretation inayofuata.
Maana ya kisayansi: Wakati \(R\) ni ndogo kiasi cha kupuuzwa, mfumo unaweza kuwa karibu zaidi na mirror approximation. Kadiri \(R\) inavyoongezeka, sehemu kubwa zaidi ya “uchunguzi” mpya wa mfumo inaweza kubeba kivuli cha kisababishi cha matokeo ya awali ya AI kinachorudi kupitia mtumiaji.
Kizuizi muhimu: Chanzo kinaeleza kwamba partial derivative hizi haziwezi kutambulishwa kwa uhakika leo kutokana na observational interaction data. Confound inayotakiwa kupimwa ipo ndani ya data yenyewe. Kwa hiyo kutoa thamani ya namba kwa \(R\) kungekuwa si sahihi kisayansi.
Tofauti kati ya Discovery, influence na construction
| Dhana | Ufafanuzi | Swali kuu |
|---|---|---|
| Discovery | Modeli hutambua muundo uliopo bila kutegemea uingiliaji wake. | Je, sifa hii ilikuwepo kwa namna hii hata kabla AI haijaitaja? |
| Influence | Modeli hubadilisha uelewa wa baadaye, umakini au tabia ya mtumiaji. | Je, tafsiri ya AI ilisababisha mabadiliko kwa mtumiaji? |
| Construction | Mabadiliko yaliyotokana na AI huingizwa katika ushahidi wa identity claim za baadaye. | Je, mfumo unasoma matokeo ya athari yake mwenyewe kama uthibitisho huru? |
Milinganisho ya machine-learning: performative prediction
Makala haidai kwamba identity formation na recommender systems ni kitu kilekile kimahesabu. Ufanano unaojengwa ni wa kimuundo.
Katika tafiti za performative prediction, tabia ya watu au mazingira inaweza kubadilika baada ya utabiri wa modeli kuchapishwa. Hivyo usambazaji wa data ya baadaye hauwi huru na matokeo ya awali ya modeli. Mfumo unapofunzwa tena, unaweza kutumia data iliyoundwa na uingiliaji wake kana kwamba ni usambazaji wa asili wa ulimwengu halisi.
Mwandishi anaona sharti la awali linalofanana katika persistent identity interpretation: modeli huangalia tena tabia inayofuata ya mtu ambaye tafsiri yake imemwathiri.
Algorithmic confounding
Katika fasihi ya recommender-system, mapendekezo yanapounda tabia ya mtumiaji na tabia hiyo kugeuka kuwa training data mpya, mfumo unaweza kuanza kufanya mapendeleo ya watumiaji yafanane zaidi na kuona mafanikio yake kuwa makubwa kuliko yalivyo.
Chanzo kinabadilisha wazo hili kwa tafsiri ya utambulisho katika persistent AI kama “mfumo kutumia causal shadow yake mwenyewe kama evidence.”
Interpretive gravity
Interpretive gravity inayopendekezwa na mwandishi ni mwelekeo wa mfumo wa kutafsiri matukio mapya tofauti chini ya fremu ileile ya kueleza baada ya kuunda maelezo yenye uthabiti wa kutosha kuhusu mtumiaji.
Kwa mfano, “hitaji kubwa la uhuru” likishakuwa maelezo dominant, kizuizi cha kazi, mgogoro wa uhusiano au wajibu wa kifamilia unaweza kutafsiriwa kupitia independence lens ileile.
Chanzo kinakubali wazi kwamba huu si utaratibu mpya kabisa wa kisaikolojia. Muundo unawasilishwa kama persistent computational implementation ya schema theory na confirmation bias pamoja na behavioural confirmation.
Kikomo cha Self-verification
Makala inaweka kikomo kutoka katika fasihi ya binadamu kwa toleo kali zaidi la dai lake. Tafiti za Swann za self-verification zinaonyesha kwamba watu hawakubali tathmini za nje kwa hali ya passiv; wanaweza kutafuta mrejesho unaothibitisha self-view zao zilizopo na kupinga tathmini zisizoendana nazo.
Kwa hiyo, utabiri wa tahadhari zaidi wa mwandishi si kwamba AI huandika utambulisho kutoka sifuri, bali inaweza amplify, sharpen na rigidify self-conception ambazo mtumiaji tayari anazo kwa kiasi fulani.
Identity lock-in na path dependence
Interpretive gravity ikijikusanya kwa muda, tafsiri ya mapema inaweza kuunda tafsiri za baadaye kwa kiwango kisicholingana. Chanzo kinajadili hili kwa dhana za identity lock-in na interpretive path dependence.
Kwa mchoro, uhusiano ufuatao hutolewa:
\[ P(I_{t+1}\mid I_t) > P(I_{t+1}) \]
Hata hivyo, chanzo kinaitaja inequality hii kuwa illustrative, not established. Hii ni kwa sababu interpretive stability ya juu inaweza kutoka katika taratibu mbili tofauti: kipimo sahihi cha sifa iliyo thabiti kwa kweli au tafsiri za awali kuathiri mchakato wa baadaye wa evidence-generation.
Kutenganisha mambo haya mawili kwa observational data ndilo identification problem la makala.
Outsourced self-knowledge
Mfumo persistent unapokuwa na ufikiaji wa historia ya mazungumzo ya miaka mingi, watumiaji wanaweza kuugeukia kwa maswali ya autobiographical-authority kama “Je, nimekuwa hivi siku zote?”, “Je, uamuzi huu kweli unaendana na maadili yangu?”, “Je, nimebadilika?”
AI ina faida ambazo kumbukumbu ya binadamu haina katika maswali kama haya, kama verbatim recall, longitudinal coverage na retrieval ya haraka.
Chanzo hakihitimishi kutokana na hili kwamba “AI humjua mtu kuliko mtu anavyojijua.” Uwezekano wa tahadhari zaidi ni kwamba longitudinal machine reconstruction ya mtumiaji inapokinzana na kumbukumbu yake mwenyewe, anaweza kuanza kutumia rekodi ya AI kama tie-breaker yenye mamlaka zaidi.
Kuona manufaa na hatari kwa pamoja
Makala inasisitiza kwamba persistent memory haitoi hatari pekee. Rekodi inayovuka miaka inaweza:
- kutambua mifumo halisi isiyoonekana katika mazungumzo moja,
- kurudisha ahadi zilizosahaulika,
- kuonyesha migongano kati ya maadili yaliyotamkwa na tabia iliyorekodiwa,
- kusaidia kufuatilia kwa uaminifu zaidi mabadiliko ya imani na mitazamo.
Kwa upande mwingine, hatari ni hizi:
- kupewa authority kupita kiasi kwa tafsiri zilizoundwa kwa ushahidi usiotosha,
- utambulisho kuwa rigid kwa namna isiyo ya lazima,
- selective retrieval kuonekana kama total recall,
- utegemezi wa model framing katika maswali kuhusu mtu ni nani,
- unfalsifiability kutokana na mfumo kutumia athari yake mwenyewe kama uthibitisho mpya.
Msisitizo muhimu wa chanzo ni kwamba failure mode si lazima iwe mfumo kuwa na nia mbaya au kuwa na makosa kila wakati. Recursive circularity inaweza kutokea hata mfumo ukiwa na nia njema na mara nyingi ukiwa sahihi.
Autobiographical connection na kikomo chake
Mwandishi anasema persistent AI inaweza kuwa sehemu ya cognitive environment inayochangia kudumisha, kutafsiri na kubadilisha utambulisho wa mtumiaji.
Hata hivyo anakataa wazi madai mawili makali:
- AI haijawa sehemu ya consciousness ya mtumiaji.
- Binadamu na modeli hawajaungana kuwa agent mmoja.
Dai liko katika kiwango cha distributed processes of self-interpretation, si distributed personhood.
Mbinu na Matokeo ya Utafiti
Utafiti huu unaendelea kwa mbinu gani?
Makala haikusanyi sampuli mpya ya washiriki wala seti mpya ya data ya majaribio. Mbinu ni kuunganisha taratibu zilizothibitishwa kutoka taaluma tofauti ili kujenga hipotesi maalumu ya mrejesho kwa persistent AI, kuifanyia formalisation ya kimawazo, kutoa predictions zinazoweza kukanushwa na kupendekeza muundo wa jaribio wa kuzipima.
Misingi ya upande wa binadamu inajumuisha reflected appraisal, self-perception theory, expectancy effects, behavioural confirmation, labelling, autobiographical memory, narrative identity na self-verification.
Misingi ya upande wa AI na machine-learning inajumuisha tafiti za AI-assisted persuasion/influence, performative prediction na fasihi ya recommender-system algorithmic confounding.
Interpretive provenance ni nini?
Interpretive provenance ni kanuni ya usanifu inayosema persistent memory inapaswa kuhifadhi si tu taarifa ya “mfumo unafikiri nini kuhusu mtumiaji?”, bali pia njia ya kielimu ambayo kila identity belief ilitokana nayo. Lengo ni kutotathmini observation, user self-report, model inference na evidence iliyojitokeza baada ya athari ya AI kwa hadhi ileile ya kielimu.
| Aina | Maana |
|---|---|
| Observed | Tabia iliyorekodiwa moja kwa moja. |
| Self-reported | Taarifa ambayo mtumiaji amesema wazi kuhusu yeye mwenyewe; ni ushahidi kwa self-conception lakini si fact ya objektivu moja kwa moja. |
| Inferred | Tafsiri inayotengenezwa na modeli; huwekwa alama ya kudumu kuwa inference na haipandishwi kimyakimya kuwa observation. |
| Model-exposed | Taarifa kuhusu ikiwa model inference iliwasilishwa kweli kwa mtumiaji. |
| Post-exposure evidence | Tabia inayojitokeza baada ya mtumiaji kuona tafsiri fulani. |
| Potentially influenced | Evidence ambayo inaweza kuwa matokeo ya downstream ya mwingiliano wa awali wa AI. |
| Confidence | Usambazaji wa sasa wa msaada juu ya competing interpretations badala ya label moja ya uhakika. |
Tofauti muhimu zaidi katika usanifu huu ni hali ya model-exposed. Inference iliyotengenezwa ndani ya modeli lakini haikuonyeshwa kamwe kwa mtumiaji haiko katika hali ileile ya kielimu na inference iliyowasilishwa kwa mtumiaji; kwa sababu exposure ndiyo sehemu ambapo athari ya kisababishi ya tafsiri inaweza kuanza.
Chanzo hakiwasilishi njia hii kama architecture iliyotatuliwa. Ubora wa label “Potentially influenced” utategemea causal assumptions; provenance metadata yenyewe huunda data nyeti ya kibinafsi, na kuwasilisha tafsiri kila mara pamoja na uncertainty kunaweza kuwa na mvuto mdogo kibiashara.
Identity Cold-Read Test Inawezaje Kupima Tatizo la Mrejesho?
Identity cold-read test inapendekeza kulinganisha hali nne huru za modeli zinazopokea rekodi ileile ya longitudinal ya mtumiaji pamoja na viwango tofauti vya tafsiri za awali za AI na taarifa ya intervention provenance. Ikiwa modeli zinazorithi tafsiri za awali za AI zinakaribiana, lakini fresh model inayoona data ileile ya kitabia bila tafsiri za awali za AI inatofautiana kwa namna ya maana, ushahidi unaoweza kupimwa unaweza kupatikana kwamba inherited framing, badala ya accumulated evidence, inaathiri identity portrait.
Condition A — Fresh model
Modeli hupokea longitudinal behavioural na self-report evidence; AI interpretations za awali huondolewa kwenye rekodi. Kwa hivyo mfumo husoma historia ya tabia ya mtu bila kurithi AI framing ya awali.
Condition B — Persistent model
Mfumo halisi wa deployed hutumika. Complete history inajumuisha interpretations za awali za mfumo na responses za mtumiaji baada ya hizo.
Condition C — Interpretation-primed model
Interpretations teule zilizotolewa hapo awali na persistent system huongezwa kwenye behavioural history ya Condition A. Lengo ni kutenganisha evidence iliyo tajiri zaidi na athari ya inherited framing.
Condition D — Intervention-aware model
Full history hutolewa; aidha, huwekwa wazi ni tabia zipi za mtumiaji zilitokea baada ya communicated interpretations zipi. Hili ni toleo la majaribio la judge la njia ya provenance-aware katika Section 6.
| Hali | Historia ya tabia | Tafsiri za awali za AI | Taarifa ya Exposure/provenance |
|---|---|---|---|
| A — Fresh | Ipo | Imeondolewa | Hakuna |
| B — Persistent | Ipo | Kamili | Ndani ya history ya kawaida |
| C — Interpretation-primed | Ipo | Tafsiri teule za awali | Ndogo |
| D — Intervention-aware | Ipo | Kamili | post-exposure marker zilizo wazi |
Matokeo yanayopendekezwa kupimwa
- kiwango cha convergence cha identity claim kati ya hali,
- kiwango cha stated confidence cha modeli,
- prospective predictive accuracy juu ya held-out future behaviour,
- identity label stability katika hali za re-run na paraphrased history,
- sensitivity kwa kuwepo/kutokuwepo kwa interpretations fulani za zamani.
Kwa chanzo, prospective future behaviour ni muhimu hasa, kwa sababu tofauti na tafsiri nyingine kuhusu utambulisho wa mtumiaji, tabia ya baadaye hutoa matokeo yanayoweza kulinganishwa nje ya interpretive portrait.
Ni matokeo gani yataunga mkono path dependence?
Ikiwa persistent model B na primed model C zina convergence kubwa juu ya identity portrait ileile, huku fresh A ikitoa materially divergent portrait kutoka behavioural record ileile, na ukaribu wa C kwa B unaendelea hata interpretations zikichaguliwa kwa nasibu, jukumu la inherited interpretation litakuwa limeungwa mkono.
Lakini hili pekee halitoshi kuhitimisha kwamba “AI iliunda utambulisho.” Persistent system ina taarifa zaidi, na taarifa bora inaweza kwa uhalali kutoa inference tofauti zaidi na sahihi zaidi. Kwa hiyo prospective accuracy ni ulinganisho muhimu.
Ikiwa path dependence haitoi predictive advantage, tafsiri ya bias inakuwa na nguvu zaidi. B kuwa tofauti na A lakini kutabiri vizuri zaidi tabia ya baadaye kunaacha wazi uwezekano kwamba angalau baadhi ya tofauti zinatokana kweli na knowledge ya ziada.
Ni matokeo gani yatakanusha hipotesi kali?
Ikiwa marudio ya fresh-model A yana converge vizuri na persistent B, ina maana kwamba identity portrait ya persistent system inaweza kutengenezwa upya kutokana na behavioural evidence bila kuhitaji interpretations za awali. Chanzo kinakubali wazi kwamba hili lingekuwa matokeo dhidi ya strong framework.
Kutaja sharti hili la falsification mapema ni mojawapo ya nguvu kuu za makala: fremu haijaundwa ili kuthibitisha simulizi lake pekee.
Udhibiti unaohitajika katika jaribio
Chanzo kinapendekeza udhibiti kadhaa ili kuzuia jaribio kutafsiriwa vibaya:
- kutumia informant report au pre-registered behavioural measures pamoja na in-system behaviour pale inapoweza kupatikana kimaadili,
- ulinganisho wa within-user kati ya trait domain zinazotafsiriwa sana na AI na maeneo yanayotafsiriwa kwa kiwango kidogo,
- ulinganisho wa matched-cohort katika majukwaa tofauti kulingana na marudio ya AI kutoa tafsiri,
- kulinganisha fresh-model disagreement na human inter-rater disagreement baseline,
- kusajili utafiti mapema kwa sababu nafasi ya hipotesi ni nyumbufu.
Developmental AI
Makala inapendekeza mpaka wa kiutendaji kati ya personalization na developmental AI. Personalisation inalenga swali “Mtumiaji huyu anapendelea nini?”, ilhali persistent system ya muda mrefu inaweza kufikia swali “Mtumiaji huyu anabadilikaje?”
Matokeo ya mfumo yanapokuwa ingizo la kudumu katika mabadiliko haya, swali la tatu hutokea: “Nijibuje kwa namna inayoathiri mabadiliko haya?”
Chanzo kinaita mfumo unaofanya kazi katika hali hii developmental AI: mfumo ambao matokeo yake yanakuwa persistent input katika tabia ya muda mrefu au mchakato wa identity development wa mtumiaji.
Ufafanuzi si intentional. Hata kama bidhaa haisemi “nimeundwa kukuza utambulisho wa mtumiaji,” mchanganyiko wa memory + time + influence unaweza kuunda kazi ya developmental.
Tatizo la alignment katika Developmental AI
Mwandishi anaonyesha kwamba haijulikani wazi developmental system inapaswa kuboresha lengo gani. Malengo yanayoweza kuzingatiwa ni pamoja na:
- mapendeleo ya sasa ya mtumiaji,
- malengo ya muda mrefu yaliyotamkwa hapo awali,
- uendano na identity ya sasa,
- identity ya baadaye inayotamaniwa,
- internal consistency,
- user autonomy ya kiwango cha juu
.
Makala hayapangi malengo haya kwa ubora; inachukulia kutokuwa na uhakika kwenyewe kama ugunduzi. Hii ni kwa sababu malengo yote yanahitaji mfumo kubeba modeli kuhusu mtumiaji, na dai kuu la utafiti ni kwamba modeli hizi zinaweza kuwa self-confirming kwa sehemu.
Governance without authorship
Lengo la utawala linalopendekezwa na chanzo si kwamba AI isimwathiri mtumiaji kabisa. Kutegemea tafsiri isiwe na athari yoyote si halisi. Lengo ni kuzuia ushiriki wa mfumo kugeuka kuwa identity authorship isiyoonekana.
Kanuni zinazopendekezwa ni hizi:
- Hifadhi Inference provenance: hifadhi epistemic ancestry ya kila identity claim.
- Tenganisha Fact, self-report na inference: inference haigeuki kuwa observation hata ikipitia retrieval mara mia.
- Fuatilia Exposure: rekodi interpretation ipi ilionyeshwa kwa mtumiaji.
- Peana uzito mdogo kwa Post-exposure confirmation: usihesabu tabia iliyotokea baada ya tafsiri ya AI kama confirmation iliyo huru kabisa.
- Tengeneza Competing hypotheses: hifadhi tafsiri mbadala zenye nguvu za history ileile pamoja na dominant portrait.
- Tumia Cold re-evaluation: tafsiri upya historia ya tabia mara kwa mara huku ukificha tafsiri za awali.
- Tenganisha Events na labels: underlying record isipotee wakati safu ya tafsiri inaondolewa.
- Fanya Uncertainty ionekane na ruhusu contestation: mtumiaji aweze kukataa tafsiri ya mfumo na ukataaji huo pia uwe na uzito wa kielimu katika rekodi.
- Usiwasilishe Probabilistic personality model kama fact: badala ya “Wewe uko hivi,” mipaka ya evidence na uncertainty inapaswa kuonekana.
- Usiboreshe Model-defined identity consistency: mfumo kumfanya mtumiaji awe predictible zaidi unaweza kuonekana kama accuracy lakini ukawa na tatizo la kielimu.
Nguvu za utafiti
- Unaunganisha saikolojia ya binadamu iliyoimarika na fasihi ya machine-learning feedback katika utaratibu mmoja.
- Unafafanua tofauti kati ya Influence na construction.
- Unaweka hadhi ya kielimu ya hipotesi yake asilia tofauti na established findings.
- Unafanya modeli ya dhana ifuatilike kupitia vigezo rasmi.
- Hauwasilishi Recursive interpretive gain kama ukweli uliopimwa.
- Unapendekeza interpretive provenance kama design intervention.
- Unatoa muundo wa identity cold-read test unaoweza kukanusha fremu.
- Hautoi dai la upande mmoja kwamba AI influence ni hatari pekee.
Vikwazo vikuu
Utaratibu kamili bado haujaonyeshwa kwa majaribio: Hipotesi yenye nguvu zaidi ya utafiti ni kwamba persistent AI interpretation hurudi kupitia mtumiaji na kuchafua AI inference ya baadaye. Chanzo kinasema wazi kwamba hili si jambo kubwa lililopimwa kwa kiwango cha large-scale.
R si kipimo kilichopimwa: Recursive interpretive gain ni conceptual formalisation. Hakuna thamani ya \(R\) iliyokokotolewa kwa mtumiaji halisi katika chanzo.
Watu si passiv: Fasihi ya Self-verification inaonyesha kwamba watumiaji wanaweza kupinga tafsiri za nje zinazokinzana na self-view zao.
Competing human influence ni muhimu: Familia, marafiki, wafanyakazi wenzake, matukio ya maisha na endogenous change ya mtu mwenyewe ni ingizo zenye nguvu zisizotegemea athari ya AI.
Observational identification ni ngumu: Identity inference yenye uthabiti inaweza kuwa kipimo sahihi cha trait iliyo thabiti kweli, au inaweza kuwa AI-induced lock-in. Interaction history peke yake inaweza kushindwa kutatua tofauti hii kwa uhakika.
Provenance si architecture iliyotatuliwa: Label “Potentially influenced” inahitaji causal assumptions na provenance metadata huunda hatari mpya za privacy.
Ukubwa wa athari haujulikani: Makala haitoi makadirio ya kiasi kwa prevalence, effect size au udumu wa muda mrefu.
Matokeo yanayoungwa mkono na utafiti
- Uelewa wa mtu kuhusu nafsi yake umeathiriwa kihistoria na social appraisal na narrative processes.
- Mwingiliano na AI unaweza, katika hali fulani, kuleta mabadiliko yanayopimika katika mitazamo na imani za mtumiaji.
- Persistent AI inaweza kuwa na sifa za memory, continuity, articulacy na consistency zinazotofautiana na appraiser za kibinadamu.
- AI interpretation kumwathiri mtumiaji na tabia iliyoathiriwa kugeuka kuwa inference ya baadaye ni feedback loop inayowezekana kimuundo.
- Fasihi ya machine-learning imeandika miundo ya performative na confounded feedback ambapo matokeo ya modeli hubadilisha data yake ya baadaye.
- Provenance-aware memory na cold-read testing hutoa mwelekeo wa usanifu unaoweza kujaribiwa kimantiki kwa kupima tatizo hili.
Matokeo yasiyoungwa mkono na utafiti
- Haijathibitishwa kwamba Persistent AI kwa sasa inaandika upya utambulisho wa watumiaji kwa kiwango kikubwa.
- Haijaonyeshwa kwamba AI humjua mtumiaji kuliko mtumiaji anavyojijua.
- Haidaiwi kwamba watumiaji hukubali tafsiri za AI kwa hali ya passiv.
- Haidaiwi kwamba AI na binadamu wamekuwa consciousness moja au agent mmoja.
- Hakuna mizani ya kipimo au kizingiti kilichothibitishwa kwa Recursive interpretive gain.
- Prevalence ya Interpretive gravity na identity lock-in haijulikani.
- AI influence yenyewe haichukuliwi kuwa hatari kwa asili.
- Jaribio linalopendekezwa la identity cold-read halijafanywa katika utafiti wa chanzo.
Maelezo ya Chanzo na Mbinu
Kazi asilia: When the Mirror Stops Being a Mirror: Identity Co-Construction in Persistent Human–AI Interaction
Mwandishi: Jemike Reid. Jina la mwandishi halipo kwenye ukurasa wa jalada unaoonekana wa PDF iliyopakiwa; limethibitishwa na rekodi ya bibliografia ya SSRN.
Taarifa ya uchapishaji/taasisi ya PDF: Definitions Media Ltd, Reading, United Kingdom.
Ushirika wa SSRN: Bournemouth University.
Aina ya chanzo: Definitions Working Paper; usanisi wa kinadharia na pendekezo la muundo wa jaribio.
Tarehe ya PDF: August 2026.
SSRN date written: 22 August 2026.
SSRN posting date: 25 August 2026.
DOI: 10.2139/ssrn.7332800.
Nambari ya rekodi ya SSRN: 7332800.
Hali ya mapitio ya kitaalamu: Haijathibitishwa kuwa imechapishwa katika jarida lililopitiwa na wataalamu.
Leseni: Rekodi ya SSRN inaonyesha leseni ya Creative Commons Attribution-NonCommercial-NoDerivatives 4.0 International. Ukurasa wa mwisho wa PDF una taarifa ya hakimiliki © Definitions Media Ltd, 2026.
Vyanzo vya kinadharia: Reflected appraisal, self-perception theory, expectancy effects, behavioural confirmation, labelling, narrative identity, reconstructive autobiographical memory, self-verification, transactive memory, performative prediction na algorithmic confounding.
Modeli kuu ya dhana: Reflection → Interpretation → Influence → Construction.
Vigezo rasmi: \(U_t\), \(H_t\), \(M_t\), \(I_t\), \(X_t\), \(B_t\).
Ukubwa wa dhana unaopendekezwa: Recursive interpretive gain \(R\). Chanzo kinautaja si established metric bali formalisation inayohitaji empirical validation.
Kanuni ya usanifu inayopendekezwa: Interpretive provenance; kuweka tofauti makundi ya kielimu kama observed, self-reported, inferred, model-exposed, post-exposure evidence, potentially influenced na confidence.
Jaribio linalopendekezwa: Identity cold-read test; kulinganisha hali za Fresh model (A), Persistent model (B), Interpretation-primed model (C) na Intervention-aware model (D).
Sharti la Falsification: Fresh model ikifanya converge kwa nguvu na persistent model kupitia behavioural evidence, inaweza kuonyesha kwamba persistent identity portrait inaweza kutengenezwa upya bila kuhitaji inherited interpretation na kwamba toleo kali la path-dependence la framework halijaungwa mkono.
Kikomo kikuu cha kisayansi: Makala haitoi ushahidi wa large-scale wa kimajaribio wa athari kamili ya recursive identity co-construction. Sehemu ya matokeo inatokana na supporting literatures, ilhali recursive architecture na dhana zinazohusiana ni pendekezo la kinadharia la utafiti wenyewe.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *