

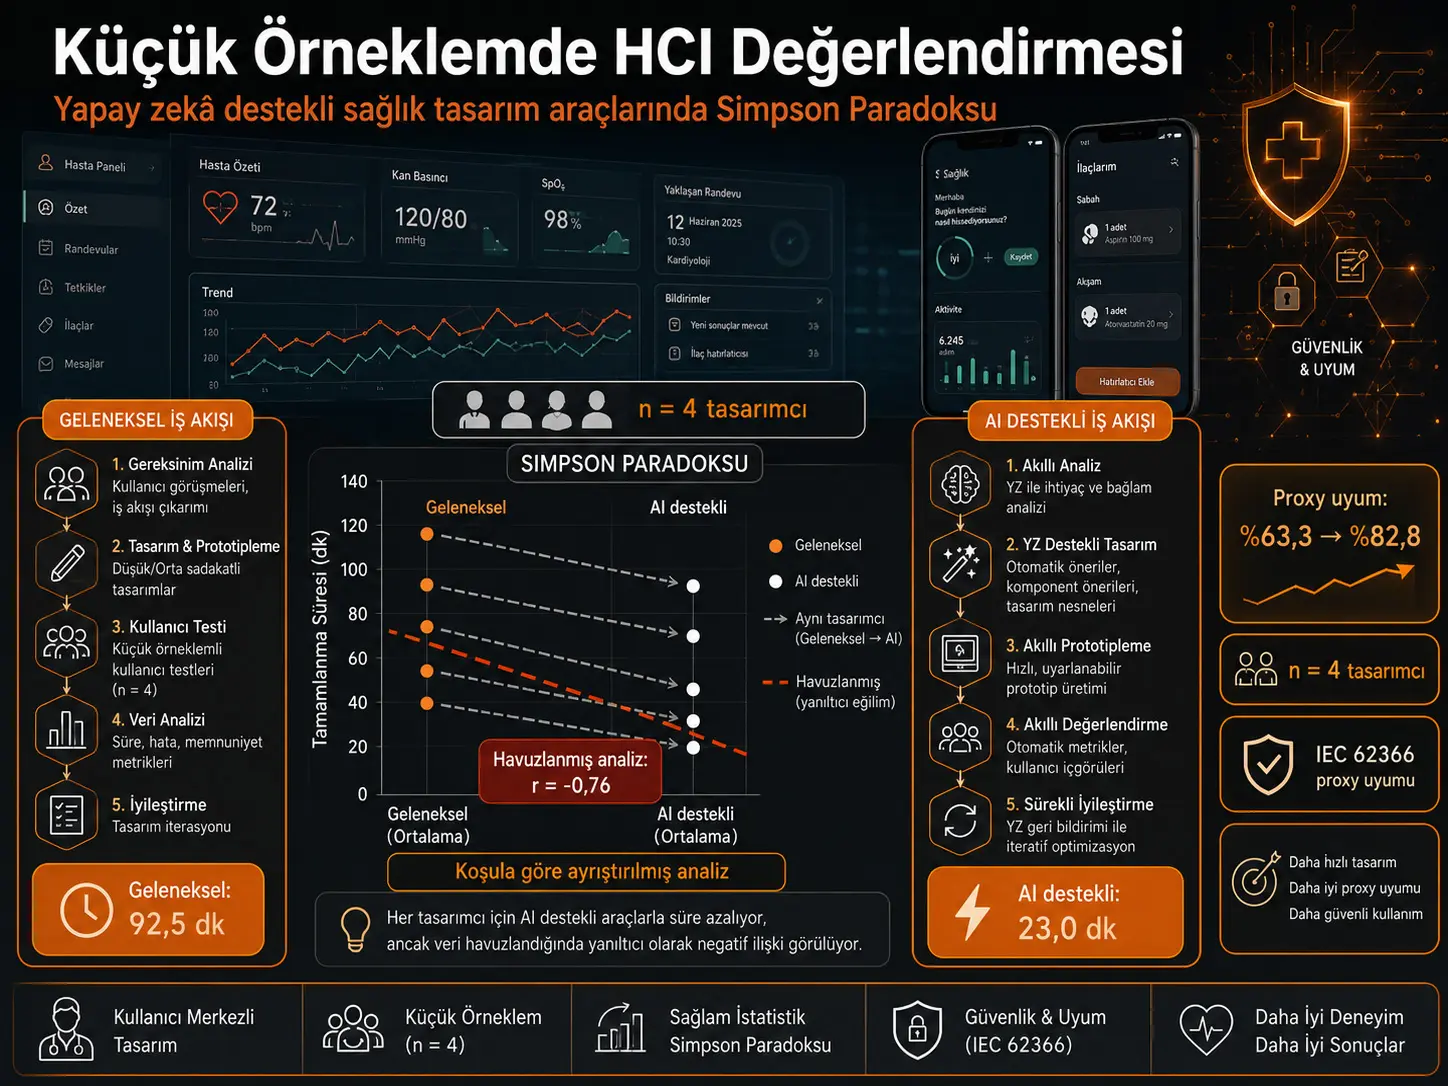
Utafiti huu unachunguza kupitia Kitendawili cha Simpson jinsi sampuli ndogo zinavyopaswa kuchanganuliwa katika tafiti za mwingiliano wa binadamu–kompyuta (Human–Computer Interaction, HCI) katika afya, ambako kupata washiriki wataalamu ni vigumu. Wabunifu wanne wa kitaalamu wa UI/UX walikamilisha kazi zilezile za kiolesura cha programu ya afya, kwanza kwa mbinu ya jadi na kisha kwa zana ya ubunifu inayotegemea GPT na kusaidiwa na akili bandia. Wakati uchunguzi wote nane ulipounganishwa kana kwamba ni mkusanyiko mmoja wa data, kulipatikana uhusiano hasi wenye nguvu na wenye umuhimu wa kitakwimu kati ya muda wa ubunifu na alama ya kiotomatiki ya proxy-mfuatano wa IEC 62366: \(r=-0{,}76\), \(p=0{,}029\), \(n=8\). Kwa upande mwingine, hali ya jadi ndani yake ilitoa \(r=-0{,}33\), \(p=0{,}67\); hali inayosaidiwa na AI ndani yake ilitoa \(r=+0{,}18\), \(p=0{,}82\). Uhusiano wa ndani ya kila hali haukuwa na umuhimu wa kitakwimu, na ishara zao zilikuwa tofauti. Kwa hiyo, uhusiano uliounganishwa haukutathminiwa kama uhusiano halisi wa mtu binafsi unaoweza kufasiriwa kuwa “kufanya kazi kwa haraka husababisha mfuatano bora”, bali kama aggregation artefact iliyotokana na kutengana kwa hali mbili tofauti za majaribio.
Katika data ghafi ilionekana kwamba wabunifu wote wanne katika hali inayosaidiwa na AI walifanya kazi kwa muda mfupi zaidi na pia walipata alama ya kiotomatiki ya proxy-mfuatano iliyo juu zaidi. Wastani wa muda wa kazi ulibadilika kutoka dakika 92,5 hadi dakika 23,0; wastani wa proxy-mfuatano kutoka %63,3 hadi %82,8. Hata hivyo, kwa kuwa washiriki wote walikamilisha hali kwa mpangilio uleule, tofauti hizi zote haziwezi kuhusishwa moja kwa moja na zana ya AI; athari za mazoezi, kujifunza na kuzoea kazi huenda zilichangia matokeo. Aidha, kuwepo kwa wabunifu wanne pekee kunazuia kufanya jumla zenye nguvu kuhusu dhana ya usambazaji wa Gaussian, mabadiliko ya variance na tofauti kati ya makundi ya uzoefu. Mchango mkuu wa utafiti si dai kwamba “watu wanne wanatosha”; ni kuonyesha kwamba pale sampuli ndogo inapokuwa haiwezi kuepukika, kuunganisha data kwa namna inayofuta hali za majaribio zinazojulikana kunaweza kupotosha, na uchambuzi uliotenganishwa kwa hali unaweza kuonyesha muundo halisi wa data kwa uwazi zaidi.
Kitendawili cha Simpson ni nini?
Kitendawili cha Simpson ni hali ambapo mahusiano yanayoonekana wakati vikundi vidogo vinachunguzwa kila kimoja peke yake hupotea, hubadilika au kuonekana katika mwelekeo wa kinyume data inapounganishwa. Tatizo si jambo la kudadisi kihisabati tu. Mtafiti anapochanganua uchunguzi wote kana kwamba unatoka kwenye usambazaji mmoja bila kuzingatia taarifa ya kikundi au hali ya majaribio, umbali kati ya wastani wa vikundi tofauti unaweza kuunda uhusiano bandia.
Mfano katika utafiti huu ni wazi sana. Hali ya ubunifu wa jadi kwa ujumla iko katika eneo la muda mkubwa–mfuatano wa chini zaidi; hali inayosaidiwa na AI iko katika eneo la muda mdogo–mfuatano wa juu zaidi. Vikundi viwili vinapoingizwa pamoja katika regression, grafu huzalisha mwelekeo hasi wenye nguvu unaoenea kutoka juu kushoto hadi chini kulia.
Hata hivyo, swali kuu la utafiti si “je, kuna uhusiano kati ya muda na mfuatano katika uchunguzi nane huru?” Watu wale wale wanne walipimwa chini ya hali mbili tofauti. Uanachama wa hali na kulinganisha watu wawili ni sehemu za msingi za muundo wa majaribio.
Kwa nini uchambuzi uliounganishwa ulikuwa wa kupotosha?
Uchunguzi nane unapohesabiwa pamoja:
\[ r_{\mathrm{pooled}}=-0{,}76,\qquad p=0{,}029,\qquad n=8. \]
Nambari hii ikisomwa peke yake, inaweza kufikiriwa kwamba kubuni kwa muda mfupi kunahusiana kwa uthabiti na mfuatano wa juu zaidi wa IEC 62366. Waandishi wanasisitiza hasa kwamba tafsiri kama hiyo haiungwi mkono.
Hali zinapotenganishwa:
\[ r_{\mathrm{traditional}}=-0{,}33, \qquad p=0{,}67, \qquad n=4 \]
na:
\[ r_{\mathrm{AI}}=+0{,}18, \qquad p=0{,}82, \qquad n=4 \]
ndizo thamani zinazopatikana.
Mahusiano yote mawili hayana umuhimu wa kitakwimu; zaidi ya hayo, moja ni hasi na nyingine ni chanya. Kwa hiyo, utafiti chanzi unasema kwamba mgawo uliounganishwa wa \(-0{,}76\) umetokana na tofauti ya nafasi kati ya hali na hauwakilishi mekanizimu ya ndani ya kasi–mfuatano miongoni mwa wabunifu wenyewe.
Wabunifu binafsi kwa kweli walibadilika vipi?
| Mbunifu | Muda wa jadi (dak) | Muda unaosaidiwa na AI (dak) | Proxy-mfuatano wa jadi | Proxy-mfuatano unaosaidiwa na AI |
|---|---|---|---|---|
| D1 | 90 | 33 | %64 | %93 |
| D2 | 88 | 32 | %50 | %75 |
| D3 | 120 | 10 | %63 | %83 |
| D4 | 72 | 17 | %76 | %80 |
Wabunifu wote wanne walihamia katika mwelekeo uleule wa jumla kwenye grafu walipotoka hali ya jadi kwenda hali inayosaidiwa na AI: muda ulipungua na alama ya kiotomatiki ya proxy-mfuatano ikaongezeka. Mwendo huu wa mtu binafsi uliolinganishwa unaonyesha kwa nini uhusiano uliounganishwa unaofuta taarifa ya hali unapaswa kutafsiriwa kwa tahadhari.
Modeli ya Gaussian ya masharti hufanya nini?
Katika mbinu iliyopendekezwa na utafiti, kila hali ya majaribio huwakilishwa kando kama muhtasari wa Gaussian wenye vigezo viwili:
\[ p(x\mid k)= \mathcal N(x;\mu_k,\Sigma_k), \]
ambapo:
\[ x= \begin{bmatrix} \text{süre}\\ \text{proxy-uyum} \end{bmatrix} \]
na \(k\) inaonyesha hali ya traditional au AI-assisted.
\(\mu_k\) inawakilisha kituo cha kila hali; \(\Sigma_k\) inawakilisha muundo wa variance na covariance uliotazamwa ndani ya hali hiyo.
Lengo la modeli hii si kukadiria usambazaji wa kuaminika wa idadi ya watu kutokana na uchunguzi wanne. Waandishi hutumia vipengele vya Gaussian kama muhtasari wa kimaelezo unaoonyesha kwa mpangilio vituo mahususi vya hali, utawanyiko na mwelekeo wa mabadiliko ya pamoja.
Je, hii kweli ni Gaussian Mixture Model?
Makala inafafanua istilahi kwa makusudi. Ingawa jina “conditional GMM” lilitumika wakati utafiti ulipoanza kuendelezwa, mbinu iliyotekelezwa si Gaussian Mixture Model ya kawaida ya unsupervised.
Katika GMM ya kawaida:
- huenda isijulikane ni uchunguzi upi uko katika kundi gani,
- mixing weights hukadiriwa,
- algoriti kama Expectation–Maximisation zinaweza kutumika,
- idadi ya vipengele inaweza kuchaguliwa kwa vigezo kama BIC.
Katika utafiti huu, hata hivyo, lebo za hali ya jadi na hali inayosaidiwa na AI tayari zinajulikana kutokana na muundo wa majaribio. Vipengele viwili havitagunduliwi; vinafafanuliwa tangu mwanzo. EM haikutumika, latent cluster haikutafutwa, na idadi ya vipengele haikuchaguliwa kwa BIC.
Kwa hiyo, waandishi hutumia katika matini ya sasa istilahi conditional Gaussian model kama jina la msingi.
Vituo vya hali vinatofautiana kwa kiasi gani?
Kituo cha hali ya jadi ni:
\[ \mu_{\mathrm{traditional}} = (92{,}5\ \mathrm{dk},\;63{,}3\%) \]
ilhali kituo cha hali inayosaidiwa na AI kimetolewa kama:
\[ \mu_{\mathrm{AI}} = (23{,}0\ \mathrm{dk},\;82{,}8\%) \]
ndivyo kilivyotolewa.
Tofauti ya vituo katika sampuli inaonyesha kwamba hali ya AI ilikuwa kwa wastani dakika 69,5 fupi zaidi na ilikuwa na thamani ya kiotomatiki ya proxy-mfuatano iliyo pointi 19,5 za asilimia juu zaidi kuliko hali ya jadi.
Hata hivyo, kutokana na mpangilio usiobadilika wa hali, haiwezekani kuhitimisha kwamba “zana ya AI peke yake iliokoa dakika 69,5” au “zana ya AI peke yake iliongeza mfuatano kwa pointi 19,5”. Thamani hizi ni tofauti za hali zilizotazamwa katika mpangilio ambao utafiti ulitekelezwa.
Alama ya IEC 62366 kwa kweli inapima nini?
Kipimo cha pili kikuu kilichotumiwa na utafiti ni alama ya asilimia iliyozalishwa na zana tofauti inayotegemea GPT ili kutathmini ulinganifu na IEC 62366-1:2015. Rubriki ya tathmini ina vipimo vitano:
- Kupunguza hitilafu za matumizi: kupunguza fursa za makosa katika mwingiliano muhimu kwa usalama.
- Hierarkia ya taarifa: kipaumbele cha kuona na kimuundo cha taarifa muhimu na za msingi za kazi.
- Uwazi wa mrejesho: majibu ya mfumo, hali za hitilafu na uthibitisho kuwa wazi.
- Ufikivu: usomaji, kontrasti, ukubwa wa shabaha na sifa za ufikivu zinazohusiana na mazingira ya matumizi ya kliniki.
- Mikataba ya kiolesura cha kifaa cha kitabibu: kuendana na istilahi zinazojulikana na matarajio ya mwingiliano.
Alama hii si uthibitisho rasmi wa IEC 62366 wala uamuzi wa udhibiti wa mfuatano. Rubriki imetolewa kutoka kwenye kiwango na zana ya tathmini na haijathibitishwa dhidi ya wataalamu wa kibinadamu. Kwa hiyo, waandishi wanaweka kikomo cha kipimo hiki kama “consistency-controlled proxy measure”.
Kwa nini ni muhimu kwamba familia ileile ya modeli izalishe na pia itathmini?
Zana ya ubunifu inayosaidiwa na AI ilikuwa custom GPT inayotegemea GPT-4o iliyofikiwa kupitia ChatGPT wakati wa utafiti. Compliance scorer tofauti pia iliundwa kama custom GPT nyingine inayofanya kazi kwenye familia ya modeli ya GPT-4o.
Waandishi wanakubali wazi kwamba hili linaweza kuunda model-family bias inayowezekana. Mifumo inayozalishwa na familia ya modeli iliyotumiwa katika uzalishaji wa ubunifu inaweza kuonekana kufaa zaidi kimuundo kwa mfumo wa tathmini unaotoka katika familia hiyo hiyo.
Kwa hiyo, uthibitishaji wa alama za mfuatano na wataalamu huru ni mojawapo ya udhibiti mkuu wa kimetodolojia unaopaswa kufanywa siku zijazo.
Mkengeuko wa kawaida katika sampuli unaonyesha nini?
Mkengeuko wa kawaida wa sampuli uliotazamwa katika chanzo ni kama ifuatavyo:
| Kipimo | Hali ya jadi | Hali inayosaidiwa na AI |
|---|---|---|
| Muda wa kazi | 20,0 dak | 11,3 dak |
| Proxy-mfuatano | 10,6 pointi za asilimia | 7,6 pointi za asilimia |
Katika vipimo vyote viwili, mkengeuko wa kawaida wa sampuli ni mdogo zaidi katika hali ya AI. Hata hivyo, kwa kuwa kuna uchunguzi wanne pekee, tofauti hii haithibitishi kwamba variance ya idadi ya watu kweli imepungua.
Katika jaribio la Levene la aina ya Brown–Forsythe, kwa muda:
\[ W=0{,}16,\qquad p=0{,}70 \]
na kwa proxy-mfuatano:
\[ W=0{,}12,\qquad p=0{,}74 \]
zilipatikana.
Waandishi hawatafsiri matokeo haya kama “variance ni sawa”. Kwa sababu ya \(n=4\), nguvu ya jaribio ni ndogo sana; data ya sasa haiwezi kuthibitisha wala kuondoa uwezekano wa kupungua kwa variance.
Ni muundo gani ulionekana kulingana na kiwango cha uzoefu?
| Mbunifu | Wasifu | Kupungua kwa muda kulikozingatiwa | Kuongezeka kwa proxy-mfuatano kulikozingatiwa |
|---|---|---|---|
| D1 | UI ya kati / AI ya juu | %63 | +29 pointi za asilimia |
| D2 | UI ya kati / AI ya juu | %64 | +25 pointi za asilimia |
| D3 | UI ya chini / AI kiasi | %92 | +20 pointi za asilimia |
| D4 | UI ya juu / AI ya chini | %76 | +4 pointi za asilimia |
D3, mbunifu mwenye uzoefu mdogo zaidi wa UI, alishuka kutoka dakika 120 hadi dakika 10 na kuonyesha tofauti kubwa zaidi ya muda katika sampuli. D1 na D2 wenye uzoefu mkubwa wa AI walikuwa na ongezeko kubwa zaidi la kiotomatiki la proxy-mfuatano, kwa +29 na +25 pointi za asilimia mtawalia.
Thamani hizi si athari za mwingiliano zilizothibitishwa kati ya makundi ya uzoefu. Kwa kuwa kuna mbunifu mmoja au uchunguzi mchache sana kwa kila wasifu, waandishi huzitathmini tu kama mifumo ya uchunguzi inayozalisha dhana kwa tafiti za baadaye.
Maoni ya wabunifu yalisema nini?
Katika Phase 1, wabunifu wote wanne walisema zana inayosaidiwa na AI iliharakisha mchakato wa kutoka wazo hadi ubunifu wa kuona. Wabunifu watatu waliripoti kwamba zana hiyo ilikuwa muhimu katika kubadilisha maono ya ubunifu kuwa muundo halisi.
Kwa upande mwingine, wabunifu wawili wenye uzoefu zaidi walisema mwongozo wa chaguo-msingi wa hatua kwa hatua ulisababisha msuguano usio wa lazima katika mtiririko wao wa kazi wa kitaalamu. Chanzo hakiwasilishi maoni haya kama formal thematic analysis; yanaripotiwa tu kama muhtasari wa kimaelezo wa mada zinazojirudia kutoka kwa sampuli ndogo.
Uchunguzi huu uliibadilishaje zana?
Watafiti hawakuripoti tu utofauti wa awamu ya kwanza, bali waliutumia katika awamu ya pili kubuni upya zana.
Zana mpya huuliza mwanzoni mwa kikao kuhusu:
- uzoefu wa mtumiaji na zana za AI,
- uzoefu wa mtumiaji katika ubunifu wa UI
na huchagua mojawapo ya modi mbili za mwingiliano.
Mtumiaji mwenye uzoefu mdogo: maamuzi wazi ya ubunifu, mwongozo wa inline na modi ya hatua kwa hatua ya “handholding”.
Mtumiaji mwenye uzoefu zaidi: modi wazi/free-form yenye scaffolding kidogo.
Aidha, juu ya mbinu ya zana ya kwanza iliyotegemea uzalishaji wa picha pekee, iliongezwa sehemu ya real-canvas ambapo vipengele vya UI vinaweza kuhaririwa moja kwa moja.
Nini kilitokea katika awamu ya pili?
D1, D2 na D3 walishiriki katika Phase 2. D4 hakushiriki katika awamu hii.
| Mbunifu | Zana ya AI ya Phase 1 (dak) | Zana inayobadilika ya Phase 2 (dak) | Mabadiliko ya muda yaliyotazamwa |
|---|---|---|---|
| D1 | 33 | 10 | −%70 |
| D2 | 32 | 17 | −%47 |
| D3 | 10 | 32 | +%220 |
D1 na D2 wenye uzoefu mkubwa wa AI walifanya kazi kwa kasi zaidi kwa kutumia zana iliyorekebishwa. D3 mwenye uzoefu mdogo wa UI alitumia dakika 32 badala ya dakika 10 za awali.
Chanzo hakitafsiri ongezeko hili moja kwa moja kama kuzorota. Katika mrejesho wa wazi, D3 alisema alifanya iteration kwa muda mrefu zaidi juu ya ubunifu na kuendeleza matokeo zaidi. Hata hivyo, kwa kuwa utafiti hauna kipimo cha ubora cha Phase 2 kilicho objektifu, hauwezi kutenganisha kwa kiasi uwezekano wa:
“polepole zaidi kwa sababu ni mwangalifu zaidi”
na:
“polepole zaidi kwa sababu zana ilizuia zaidi”
kwa njia ya kitakwimu.
Kwa nini kipimo cha ubora cha Phase 2 hakiwezi kulinganishwa na Phase 1?
Katika Phase 1, alama ya proxy ya IEC 62366 inayotegemea GPT ilitumika kwa ubora/mfuatano. Katika Phase 2, tathmini ileile ya kiotomatiki haikurudiwa; badala yake, washiriki walifanya tathmini ya kuridhika/ubora ya pointi tano.
Wabunifu wote watatu walitoa 4/5 na waliripoti kwamba scaffolding ilikuwa inafaa. Hata hivyo, kwa kuwa:
\[ \text{IEC 62366 proxy-puanı} \neq \text{öznel 5 puanlık memnuniyet} \]
thamani za ubora za Phase 1 na Phase 2 haziwezi kulinganishwa moja kwa moja.
Je, dhana ya Gaussian ilijaribiwa kweli?
Hapana. Watafiti wanasema wazi kwamba kwa uchunguzi wa \(n=4\), dhana ya bivariate normality haiwezi kuthibitishwa kwa namna yenye maana.
Majaribio kama Shapiro–Wilk, Kolmogorov–Smirnov au Anderson–Darling hayana nguvu inayoweza kutafsiriwa kwa sampuli ya ukubwa huu. Grafu ya Q–Q yenye pointi nne pia haiwezi kuamua kwa kuaminika umbo la usambazaji.
Kwa hiyo, conditional Gaussian model haitumiki kama modeli ya uwezekano iliyothibitishwa kwa formal likelihood inference, bali kama zana inayopanga hali na kuzifupisha kwa kuona.
Paired t-test ilionyesha nini?
Kwa kuwa washiriki wale wale walipimwa katika hali zote mbili, watafiti pia walifanya ulinganisho wa kawaida wa paired t-test.
Kwa tofauti ya muda:
\[ \bar d=69{,}5\ \mathrm{dk}, \]
\[ t(3)=5{,}15, \qquad p=0{,}014, \]
\[ 95\%\ GA=[26{,}5,\;112{,}5], \qquad d_z=2{,}57. \]
Kwa tofauti ya proxy-mfuatano:
\[ \bar d=19{,}5\ \text{yüzde puanı}, \]
\[ t(3)=3{,}56, \qquad p=0{,}038, \]
\[ 95\%\ GA=[2{,}0,\;37{,}0], \qquad d_z=1{,}78. \]
Waandishi hutumia paired t-test kama inferential comparator ya msingi kuhusu tofauti ya wastani kati ya hali mbili. Conditional Gaussian model badala yake hufanya Kitendawili cha Simpson na utofauti wa kimuundo kulingana na hali/wasifu wa watumiaji kuonekana. Kwa hiyo, conditional model haibadilishi paired t-test.
Kwa nini jaribio la Wilcoxon halikuwa na umuhimu?
Exact Wilcoxon signed-rank test ilitoa kwa matokeo yote mawili:
\[ W=0,\qquad p=0{,}125 \]
ndizo thamani zilizopatikana.
Hata hivyo, wakati jozi zote nne ziko katika mwelekeo uleule, p-value ndogo zaidi inayoweza kupatikana na exact Wilcoxon test ya pande mbili ni:
\[ 2\left(\frac12\right)^4=0{,}125 \]
Kwa hiyo, utafiti hautafsiri matokeo haya kama “hakuna athari”. Kwa ukubwa huu wa sampuli, azimio la p-value la jaribio tayari haliwezi kushuka chini ya 0,05.
Kwa nini mixed-effects model haikutumika?
Wabunifu wanne ni idadi ndogo sana ya viwango vya kikundi kwa kukadiria kwa kuaminika vipengele vya variance vya random-effect. Watafiti walijaribu random-intercept model, lakini suluhisho la maximum likelihood haliku-converge licha ya kujaribiwa tena kwa optimizer tatu; katika usanidi mmoja wa L-BFGS walipata singular design matrix.
Ingawa random-slope model ili-converge kihisabati, ilikubaliwa kuwa imejaa vigezo kupita kiasi kwa watu wanne tu, hivyo vipengele vya variance havikuweza kutafsiriwa.
Kwa nini Bayesian hierarchical model haikutumika?
Kwa mujibu wa tathmini ya utafiti, katika \(n=4\) hyperparameter inayowakilisha variance kati ya wabunifu haiwezi kutambuliwa vya kutosha kutoka kwenye data. Prior dhaifu ikitumika, posterior inaweza kwa kiasi kikubwa kurudisha prior; prior yenye nguvu ikitumika, matokeo yanaweza kuamuliwa moja kwa moja zaidi na prior hiyo.
Kwa hiyo Bayesian hierarchical model imeachwa kama kazi ya baadaye kwa mkusanyiko mkubwa zaidi wa data.
Matokeo yanayoungwa mkono na utafiti
Kwanza, katika sampuli hii, hali ya jadi na inayosaidiwa na AI zilipounganishwa kulizalishwa uhusiano hasi wenye nguvu, lakini hali zilipochanganuliwa kando uhusiano huo haukuonekana. Huu ndio msingi wa moja kwa moja wa kimajaribio wa dai la Kitendawili cha Simpson/aggregation artefact la utafiti.
Pili, kwa wabunifu wote wanne, hali inayosaidiwa na AI ilionekana pamoja na muda mfupi zaidi na alama ya juu zaidi ya kiotomatiki ya proxy-mfuatano kuliko hali ya jadi.
Tatu, uchambuzi mahususi kwa hali ulionyesha kuwa kuna wasifu tofauti wa majibu kati ya wabunifu; hata hivyo, kwa sababu ya sampuli ndogo, wasifu huu uko katika kiwango cha kuzalisha dhana.
Nne, utofauti wa scaffolding uliotazamwa katika Phase 1 ulisababisha kubuni toleo la pili la zana lililorekebishwa kwa uzoefu, na katika Phase 2 kulionekana majibu ya muda ya pande mbili kati ya wabunifu.
Matokeo ambayo utafiti hauungi mkono au haukujaribu
Utafiti hauonyeshi kwamba watu wanne kwa ujumla wanatosha kwa sampuli ndogo. Waandishi wanakubali wazi kinyume chake.
Utafiti haujathibitisha kwamba zana ya AI ndiyo chanzo cha kisababishi cha maboresho yote yaliyotazamwa. Kwa kuwa hali hazikuwa counterbalanced, athari za mazoezi na kuzoea kazi hazikutenganishwa.
Utafiti hauonyeshi kwamba alama ya mfuatano inayotegemea GPT ni sawa na mfuatano halisi wa udhibiti wa IEC 62366.
Utafiti haujathibitisha kwamba variance halisi ya idadi ya watu ni ndogo zaidi katika hali ya AI.
Utafiti hauonyeshi kwamba wabunifu wote katika viwango fulani vya uzoefu watajibu kwa njia ileile.
Phase 2 haijathibitisha kwamba zana inayobadilika ni bora kwa ubora. Katika Phase 2 hakikutumika kipimo kilekile cha ubora cha objektifu/proxy kama Phase 1.
Conditional Gaussian model haijathibitishwa kama suluhisho rasmi la inferential kwa sampuli ndogo. Kazi yake kuu katika makala ni uchambuzi wa kimaelezo na diagnostiki unaohifadhi muundo wa hali.
Hii ina maana gani kwa Uturuki?
Utafiti ulifanywa na watafiti wanaohusishwa na chuo kikuu nchini Japani na ulitumia convenience sample ya wabunifu wanne wa kitaalamu pekee. Hautoi matokeo ya moja kwa moja ya utendaji kwa wabunifu wa programu za afya au watengenezaji wa vifaa vya kitabibu nchini Uturuki.
Hata hivyo, ujumbe wa kimetodolojia si maalum kwa nchi: katika tafiti za HCI ya afya, programu za kitabibu, violesura vya viwandani au UX nyingine muhimu kwa usalama ambako washiriki wataalamu ni wachache, mifumo ya ndani ya hali inapaswa kuchunguzwa kabla ya kuunganisha hali katika bwawa moja. Kutumia mbinu hiyo katika muktadha wa Uturuki kunahitaji tafiti huru kubwa zaidi zenye wabunifu wa eneo na mpangilio wa hali uliosawazishwa.
Mbinu na Matokeo ya Utafiti
Muundo wa majaribio wa Phase 1
Wabunifu wanne wa kitaalamu wa UI/UX walikamilisha kazi zilezile za ubunifu wa kiolesura cha programu ya afya katika hali mbili:
- Mtiririko wa kazi wa jadi: mbinu ya mikono bila kutumia zana ya ubunifu ya AI.
- Mtiririko wa kazi unaosaidiwa na AI: zana inayotegemea GPT iliyoundwa kwa kanuni za HCI ya afya na maarifa ya IEC 62366.
Sifa za washiriki zilikuwa kama ifuatavyo:
| ID | Uzoefu wa UI | Uzoefu wa AI | Historia |
|---|---|---|---|
| D1 | Wastani | Juu | Healthcare UX, miaka 3+ |
| D2 | Wastani | Juu | Medical software, miaka 4 |
| D3 | Chini | Kiasi | UX ya jumla; kuhamia sekta ya afya |
| D4 | Juu | Chini | Mbunifu mwandamizi, miaka 8+ |
Kazi zilijumuisha violesura vya afya kama skrini salama ya kuingia na dashboard ya mhudumu wa afya kwa mfumo wa simu wa Portable Health Clinic. Mahitaji yalihusisha kuzuia makosa, hierarkia ya taarifa na vipimo vya ufikivu.
Vipindi vilipangwa kwa takriban dakika 90, lakini hakuna kikomo kigumu cha muda kilichowekwa. Muda ulirekodiwa kutoka kuanza kwa kazi hadi mbunifu kuwasilisha toleo la mwisho.
Athari ya mpangilio wa hali kwenye ubunifu
Washiriki wote wanne walifuata mpangilio:
kwanza traditional → kisha AI-assisted
ndio mpangilio waliofuata.
Watafiti walichagua hili ili kuzuia kukutana mapema na zana ya AI kuathiri ubunifu wa mikono. Kwa upande mwingine, uamuzi huu unachanganya matokeo ya hali ya pili na kujifunza kazi pamoja na kuizoea.
Kwa hiyo, utafiti hautafsiriwi kama randomised au counterbalanced causal trial, bali kama sequentially unbalanced exploratory comparison.
Muundo wa zana ya ubunifu ya AI
Programu iliyotumiwa katika hali ya AI ni zana ya ubunifu inayotegemea GPT na kufanya kazi kwa maagizo ya lugha asilia. Zana hiyo iliweza:
- kutengeneza mockup za kiolesura kutoka maelezo ya maandishi,
- kupendekeza maboresho kulingana na kanuni za HCI na usability,
- kuashiria makosa ya matumizi yanayoweza kutokea,
- kuingiza mifumo ya UX ya afya na maarifa ya IEC 62366 katika mchakato wa ubunifu.
Wakati wa utafiti, zana ilifanya kazi kama custom GPT kwenye jukwaa la ChatGPT na familia ya modeli ya GPT-4o.
Vipimo vikuu
Vipimo viwili vya msingi vya kiasi vilikusanywa:
- Muda wa kukamilisha kazi: dakika.
- Alama ya IEC 62366 proxy-mfuatano: thamani ya asilimia iliyopatikana kutoka zana tofauti ya tathmini inayotegemea GPT.
Data ghafi ya muda na Verianla Live
Kwa washiriki wote wanne, muda wa kazi ulikuwa mdogo zaidi katika hali inayosaidiwa na AI. Grafu ya Verianla Live hapa chini inalinganisha data ya muda iliyo katika kitengo kilekile pekee; alama za compliance hazijachanganywa katika mhimili wa muda.
Muda wa wastani:
\[ 92{,}5\ \mathrm{dk} \rightarrow 23{,}0\ \mathrm{dk} \]
ulibadilika hivyo. Chanzo kinaripoti hili kama upungufu wa takriban %75 katika wastani uliozingatiwa. Kwa sababu ya mpangilio usiobadilika wa hali, asilimia hii si athari safi ya kisababishi ya AI.
Matokeo ya proxy-mfuatano
| Mbunifu | Proxy-mfuatano wa jadi | Proxy-mfuatano unaosaidiwa na AI | Tofauti |
|---|---|---|---|
| D1 | %64 | %93 | +29 pointi za asilimia |
| D2 | %50 | %75 | +25 pointi za asilimia |
| D3 | %63 | %83 | +20 pointi za asilimia |
| D4 | %76 | %80 | +4 pointi za asilimia |
Wastani wa sampuli:
\[ 63{,}3\% \rightarrow 82{,}8\% \]
ulibadilika hivyo na mwelekeo ulikuwa chanya kwa wabunifu wote wanne. Hata hivyo, lazima ihifadhiwe wazi kwamba alama ni proxy ya kiotomatiki ambayo haijathibitishwa na wataalamu.
Muhtasari wa nambari wa Kitendawili cha Simpson
| Uchambuzi | Uhusiano \(r\) | p | n | Tafsiri ya chanzo |
|---|---|---|---|---|
| Uchunguzi wote umeunganishwa | −0,76 | 0,029 | 8 | Aggregation artefact inayoonekana kuwa na umuhimu lakini imeundwa na tofauti kati ya hali |
| Hali ya jadi pekee | −0,33 | 0,67 | 4 | Haina umuhimu |
| Hali inayosaidiwa na AI pekee | +0,18 | 0,82 | 4 | Haina umuhimu |
Dai la kimetodolojia la utafiti chanzi linatokana moja kwa moja na tofauti hii: kutenganisha hali kunarejesha muundo wa majaribio ambao hauonekani katika uhusiano uliounganishwa.
Kazi za uchambuzi wa paired na conditional model ni tofauti
| Mbinu | Jukumu lake katika utafiti huu |
|---|---|
| Paired t-test | Hupima kwa inferential tofauti ya wastani ya mshiriki yuleyule kati ya hali mbili. |
| Conditional Gaussian model | Huhifadhi kando kituo, utawanyiko na muundo wa mabadiliko ya pamoja wa kila hali; hufanya aggregation artefact ionekane. |
| Wilcoxon signed-rank | Udhibiti unaotegemea rank; kwa \(n=4\), inferential resolution haitoshi kwa sababu p ya chini zaidi ya pande mbili ni 0,125. |
| Repeated-measures ANOVA | Katika muundo wa hali mbili, ni sawa kihisabati na paired t-test. |
| Linear mixed-effects | Haikuweza kukadiriwa kwa kuaminika kutokana na viwango vinne vya random-effect. |
| Bayesian hierarchical model | Haikutumika kwa sababu variance ya between-designer katika sampuli hii ingekuwa tegemezi kupita kiasi kwa prior. |
Uchambuzi wa ziada wa Monte Carlo unaonyesha nini?
Katika nyenzo za ziada za makala, simuleringi ya Monte Carlo iliyolinganishwa na muundo wa majaribio imeripotiwa. Katika matokeo yaliyofupishwa na chanzo, chini ya mchakato wa kuzalisha data ambapo within-condition correlation imewekwa kuwa sifuri, katika kiwango cha \(n=4\) mtu/hali, katika %56 ya simuleringi 10.000 uchambuzi uliounganishwa ulizalisha uhusiano hasi wenye umuhimu wa kitakwimu.
Simuleringi hii inahusiana na usanidi mmoja tu wa vigezo katika makala. Hakuna utafiti wa jumla wa operating characteristics uliofanywa kwa ukubwa tofauti wa sampuli, ukubwa wa athari, miundo ya uhusiano na kupotoka kutoka usambazaji wa kawaida.
Maana ya kimetodolojia ya Phase 2
Mchango mkuu wa awamu ya pili ni kubadilisha dhana ya utofauti wa watumiaji iliyotokana na conditional analysis kuwa mabadiliko halisi ya muundo wa bidhaa:
uchambuzi → dhana ya scaffolding inayotegemea uzoefu → kubuni upya zana → kutazama majibu mapya ya watumiaji.
Waandishi wanakubali kwamba mzunguko huu si mbinu ya kipekee maalum kwa iterative HCI design. Mchango wa conditional model ni kuhifadhi kimuundo utofauti ambao uchambuzi uliounganishwa ungeusawazisha.
Mapendekezo ya kimetodolojia ya utafiti
- Ikiwa tofauti ya hali inatarajiwa, chunguza kwanza hali kando.
- Linganisha pooled correlation na within-condition correlations ili kufanya ukaguzi wa Kitendawili cha Simpson.
- Ripoti kando wastani, utawanyiko na mahusiano kwa kila hali.
- Katika sampuli ndogo, wasilisha tofauti za variance kama takwimu za kimaelezo, si kama ukweli wa inferential.
- Chunguza kwa njia ya uchunguzi majibu kulingana na sifa husika za mtumiaji kama uzoefu na utaalamu.
- Hifadhi muundo wa pairing wa within-subject design wakati wa uchambuzi wa inferential.
Vikwazo vikuu
- Phase 1 ina wabunifu wanne pekee.
- Phase 2 ina wabunifu watatu pekee.
- Washiriki walichaguliwa kupitia convenience sampling kutoka mitandao ya kitaalamu.
- Mpangilio wa hali ni thabiti na si counterbalanced.
- Athari ya mazoezi/kujifunza haiwezi kutenganishwa na athari ya AI.
- Kazi ziko katika muktadha mmoja tu wa programu ya afya ya simu.
- Mfumo wa alama wa IEC 62366 haujathibitishwa na wataalamu huru wa kibinadamu.
- Zana ya ubunifu na compliance scorer ziko katika familia ileile ya modeli ya GPT-4o.
- Dhana ya usambazaji wa Gaussian haiwezi kupimwa katika \(n=4\).
- Tofauti ya variance kati ya hali haijathibitishwa.
- Matokeo ya Experience-indexed ni mifumo ya uchunguzi iliyotolewa kutoka kwa uchunguzi mmoja mmoja.
- D4 hakushiriki katika Phase 2.
- Alama ya IEC 62366 proxy ya Phase 1 haikurudiwa katika Phase 2.
- Kipimo cha ubora/kuridhika cha pointi 5 cha Phase 2 hakiwezi kulinganishwa moja kwa moja na proxy-compliance metric ya Phase 1.
Tafiti za baadaye
Hatua zinazofuata zinazopendekezwa na waandishi ni sampuli kubwa zaidi na counterbalanced, kupima variance za hali kwa nguvu ya kutosha, tathmini ya Gaussian goodness-of-fit, uainishaji mpana wa modeli kwa simuleringi chini ya hali tofauti za sampuli na uhusiano, na uchambuzi wa inter-rater reliability wa alama ya kiotomatiki ya IEC 62366 dhidi ya wataalamu wa kibinadamu.
Pia inapendekezwa kujaribu mfumo katika maeneo mengine muhimu kwa usalama nje ya afya, kama violesura vya anga, compliance UI za huduma za kifedha na violesura vya umma vyenye wajibu wa ufikivu.
Maelezo ya Chanzo na Mbinu
Jina kamili la utafiti asilia: Conditional Gaussian Modelling for Small-Sample HCI Evaluation: Resolving Simpson’s Paradox in AI-Assisted Healthcare Design Tools
Waandishi: Mohammad Bilal Firoz; Ashir Ahmed.
Mwandishi wa kwanza sawa/mchango sawa: Haijabainishwa katika chanzo.
Mwandishi wa mawasiliano: Mohammad Bilal Firoz.
Taasisi: Department of Information Science and Technology, Kyushu University, Fukuoka 819-0395, Japan.
Aina ya chanzo: Makala ya utafiti wa HCI/usability yenye washiriki wa kibinadamu na sampuli ndogo; tathmini ya uchunguzi yenye awamu mbili na uchambuzi wa kimetodolojia.
Hali ya mapitio: Ni chapisho la jarida lililopitiwa na rika.
Jarida: AI.
Mchapishaji: MDPI, Basel, Uswisi.
Rekodi ya bibliografia: AI, 2026, Juzuu 7, Toleo 6, Makala 199.
DOI: 10.3390/ai7060199.
Kupokelewa / marekebisho / kukubaliwa / kuchapishwa: 31 Machi 2026 / 22 Mei 2026 / 26 Mei 2026 / 30 Mei 2026.
Leseni: Creative Commons Attribution (CC BY).
Academic Editors: Zubaer Mannan; Asif Karim; Nur Alam Md.
Sampuli ya Phase 1: Wabunifu wanne wa kitaalamu wa UI/UX.
Sampuli ya Phase 2: Watatu kati ya wabunifu wa awamu ya kwanza; D4 hakushiriki.
Muundo wa utafiti: Within-subjects lakini mpangilio wa hali ni thabiti, sequentially unbalanced exploratory comparison. Wabunifu wote walikamilisha hali ya traditional kwanza na hali ya AI-assisted pili.
Zana ya ubunifu ya AI: Custom GPT inayotegemea GPT-4o iliyofikiwa kupitia jukwaa la ChatGPT wakati wa utafiti.
Zana ya tathmini ya Compliance: Custom GPT tofauti na zana ya ubunifu, lakini pia imejengwa juu ya familia ya modeli ya GPT-4o.
Hali ya compliance metric: Kipimo cha kiotomatiki na consistency-controlled proxy cha ulinganifu na IEC 62366-1:2015; si uamuzi uliothibitishwa wa mfuatano wa udhibiti na hakuna inter-rater reliability iliyowekwa dhidi ya tathmini ya wataalamu wa kibinadamu.
Mbinu kuu ya kimetodolojia: Condition-stratified bivariate Gaussian summaries kulingana na hali zinazojulikana za majaribio. Unsurpervised GMM, EM algorithm, BIC component selection au latent cluster discovery hazikutumika.
Takwimu kuu: Pearson correlations, paired t-test, exact Wilcoxon signed-rank, Levene variance test ya aina ya Brown–Forsythe na usawa wa repeated-measures ANOVA. Linear mixed-effects fit ilijaribiwa lakini haikuweza kutumika kwa kuaminika; Bayesian hierarchical analysis haikutekelezwa.
Tofauti kuu iliyotazamwa katika Phase 1: Muda wa wastani ulibadilika kutoka dakika 92,5 hadi dakika 23,0; wastani wa kiotomatiki wa proxy-mfuatano kutoka %63,3 hadi %82,8. Kwa sababu mpangilio wa hali ni thabiti, thamani hizi haziwezi kutafsiriwa kama athari safi ya kisababishi ya zana.
Matokeo ya Kitendawili cha Simpson: Pooled \(r=-0{,}76\), \(p=0{,}029\), \(n=8\); traditional \(r=-0{,}33\), \(p=0{,}67\), \(n=4\); AI-assisted \(r=+0{,}18\), \(p=0{,}82\), \(n=4\).
Paired t-test: Kwa kuokoa muda \(t(3)=5{,}15\), \(p=0{,}014\), \(d_z=2{,}57\); kwa ongezeko la proxy-mfuatano \(t(3)=3{,}56\), \(p=0{,}038\), \(d_z=1{,}78\).
Ufadhili: Utafiti haukupokea ufadhili wa nje.
Bodi ya maadili: Kwa mujibu wa chanzo, idhini rasmi ya bodi ya maadili haikuonekana kuwa muhimu chini ya miongozo husika ya kitaasisi ya Japani. Utafiti ulifafanuliwa kama tathmini ya non-medical na non-interventional usability iliyofanywa na wataalamu watu wazima wa kujitolea, bila wagonjwa, uingiliaji wa kliniki, sampuli za kibaiolojia au data binafsi ya afya. Watafiti wanasema utafiti ulifanywa kwa mujibu wa kanuni za Tamko la Helsinki.
Ridhaa yenye taarifa: Ridhaa ilipatikana kutoka kwa washiriki wote; pia imeelezwa kwamba ridhaa ilitolewa kwa uchapishaji wa misimbo ya washiriki isiyotambulisha, nukuu za maelezo ya ubunifu yasiyotambulisha na miundo ya kiolesura iliyozalishwa katika kazi.
Upatikanaji wa data: Imeelezwa kwamba michango asilia ya utafiti imo ndani ya makala na Supplementary Materials, na maswali ya ziada yanaweza kuelekezwa kwa mwandishi wa mawasiliano.
Nyenzo za ziada: Imeripotiwa kuwa kuna sehemu za zana za ubunifu za AI, data za majaribio, maelezo ya kazi, miundo ya mfano, protokali ya utafiti, maelezo ya takwimu, upatikanaji wa data/zana, grafu za Q–Q, uchambuzi wa Monte Carlo wa Kitendawili cha Simpson na script ya reproducibility.
Michango ya waandishi: Uundaji wa dhana M.B.F. na A.A.; metodolojia M.B.F.; uchambuzi rasmi M.B.F.; uchunguzi M.B.F.; rasimu ya kwanza M.B.F.; mapitio na uhariri A.A.; uonyeshaji M.B.F.; usimamizi A.A.
Taarifa ya matumizi ya Generative AI: Katika jaribio, zana ya ubunifu ya UI/UX na zana ya proxy-tathmini ya IEC 62366 zilitumika kama custom GPT zinazotegemea GPT-4o. Chanzo pia kinaripoti kwamba Claude Opus 4.7 ilitumika wakati wa kuandaa makala kusaidia marekebisho ya lugha, uhariri na ukaguzi wa hesabu za takwimu; takwimu zote zilipitiwa na kuthibitishwa na waandishi, na waandishi wanawajibika kwa maudhui.
Mgongano wa maslahi: Waandishi hawakuripoti mgongano wa maslahi.
Kikomo cha tafsiri ya kisayansi
Ujumbe mkuu wa kimetodolojia wa utafiti si kwamba sampuli ndogo inakuwa ya kutosha; ni kwamba katika sampuli ndogo zisizoweza kuepukika, kuunganisha data kwa namna inayofuta muundo wa majaribio kunaweza pia kuzalisha kosa la ziada. Mbinu ya Conditional Gaussian katika utafiti huu ni mfumo wa kimaelezo/diagnostiki unaohifadhi muundo wa hali na haibadilishi tafiti za kitakwimu za uthibitishaji zenye sampuli kubwa.
Muda mfupi zaidi na alama ya juu zaidi ya proxy-mfuatano iliyotazamwa katika hali ya AI haiwezi kuhusishwa na athari ya kisababishi ya zana ya AI pekee kutokana na mpangilio usiobadilika wa hali. Watafiti wanarudia kikomo hiki katika utafiti mzima.
Asilimia ya IEC 62366 haimaanishi kwamba mfuatano wa udhibiti wa kifaa halisi cha kitabibu umethibitishwa. Kwa kuwa rubriki inayotegemea GPT haijathibitishwa dhidi ya tathmini ya wataalamu huru, thamani katika makala zinapaswa kuzingatiwa tu kama kipimo cha kiotomatiki cha proxy-mfuatano.
Jibu la muda la pande mbili kulingana na uzoefu lililoonekana katika Phase 2 pia si jaribio la uthibitishaji la mwingiliano. Kwa sababu ya wabunifu watatu, mpangilio usiobadilika wa kazi na kipimo tofauti cha ubora, matokeo yana sifa ya kuzalisha dhana ya ubunifu pekee.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *