

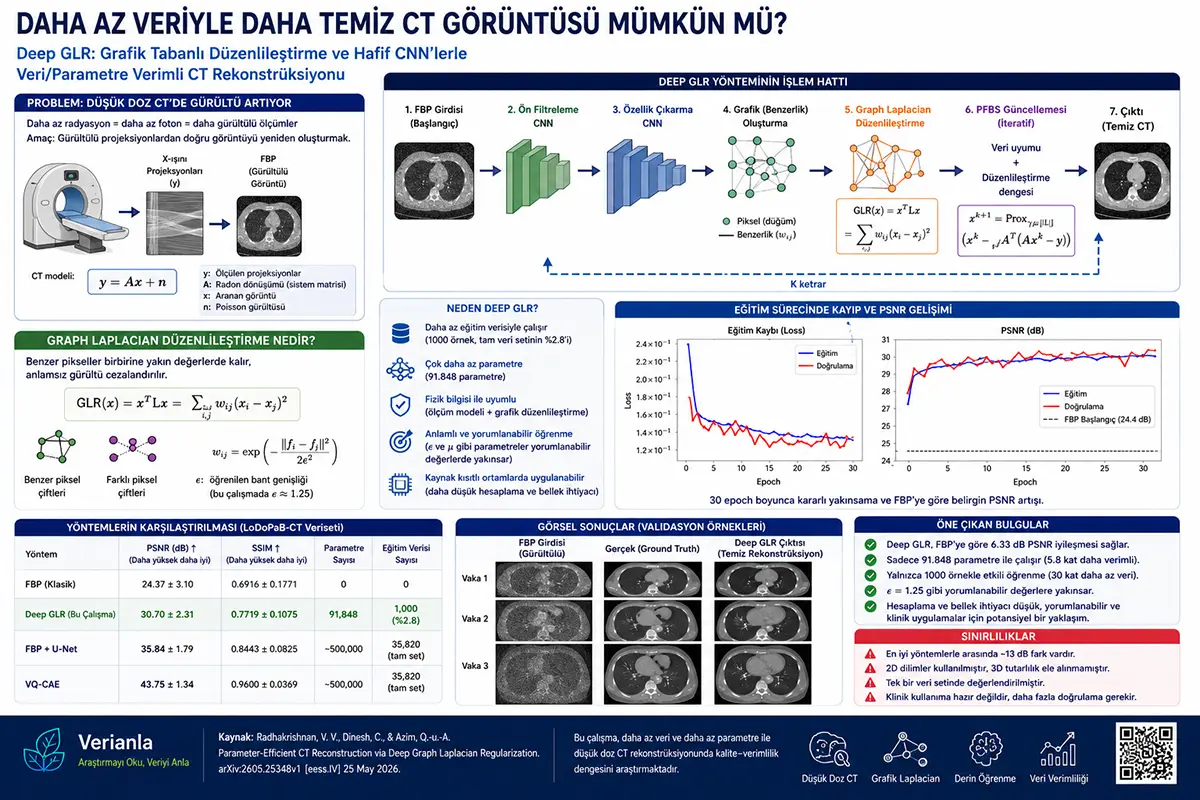
Tatizo ni nini? Katika CT ya dozi ya chini, kelele ya picha huongezeka
Tomografia ya kompyuta, yaani CT, ni mbinu muhimu ya upigaji picha wa kitabibu inayotumika kuchunguza muundo wa ndani wa mwili kwa picha za vipande. Hata hivyo, uchunguzi wa CT hutumia mionzi ionizishi. Kwa hiyo watafiti hutafuta njia za kupunguza dozi ya mionzi huku wakihifadhi ubora wa picha.
CT ya dozi ya chini inalenga kupunguza mionzi anayopokea mgonjwa. Lakini dozi inapopungua, data ya kipimo huwa yenye kelele zaidi. Hili linaweza kusababisha mistari, ukungu au upotoshaji bandia kwenye picha.
Katika hatua hii swali la msingi ni hili:
Je, kutoka kwenye vipimo vyenye kelele vilivyopatikana kwa dozi ya chini, picha ya CT iliyo safi vya kutosha na yenye maana inaweza kujengwa upya?
Utafiti huu unalishughulikia swali hili hasa kwa mtazamo wa upungufu wa rasilimali. Hivyo hauulizi tu “je, ubora wa juu kabisa unawezekana?” Bali pia unachunguza swali la “je, ubora wa kuridhisha unaweza kupatikana kwa data chache, vigezo vichache na modeli inayotafsirika zaidi?”
Ujenzi upya wa CT unamaanisha nini?
Kifaa cha CT hakipigi moja kwa moja picha ya ndani ya mwili. Kifaa hupima kudhoofika kwa miale ya X inayopita kutoka pembe mbalimbali. Baada ya vipimo hivyo, kompyuta huhesabu picha ya muundo wa ndani.
Katika makala, tatizo hili la msingi linaonyeshwa kwa fomula ifuatayo:
y = Ax + n
Fomula hii inaweza kusomwa kwa namna rahisi hivi:
y, ni data ya projeksheni iliyopimwa na kifaa.
x, ni picha halisi ya CT tunayolenga kupata.
A, inawakilisha mchakato wa kipimo cha kimwili wa uchunguzi wa CT.
n, ni kelele inayoingia kwenye kipimo.
Kwa hiyo hatuna picha safi moja kwa moja. Tunajaribu kupata matokeo yaliyo karibu zaidi na picha halisi kutoka kwenye kipimo chenye kelele.
Ndiyo maana ujenzi upya wa CT ni “tatizo la kinyume”. Tunajaribu kupata sababu tukianzia kwenye matokeo. Katika dozi ya chini kazi hii huwa ngumu zaidi kwa sababu kelele katika kipimo huwa wazi zaidi.
Mbinu ya kawaida: Kwa nini FBP inaweza kutotosha?
Filtered Backprojection, kwa kifupi FBP, ni mbinu ya kawaida na ya haraka inayotumika kuunda picha ya CT. Ni ya vitendo katika hesabu na imekuwa mojawapo ya mbinu za msingi kwa miaka mingi.
Hata hivyo, katika CT ya dozi ya chini FBP ina udhaifu muhimu: kelele katika kipimo inaweza kuonekana kwa nguvu kwenye picha. Hili linaweza kusababisha mistari na uharibifu wa kelele, hasa katika hali zinazohusiana na idadi ndogo ya fotoni.
Katika utafiti huu, FBP inatumika kama hatua ya msingi ya kuanzia kwa kulinganisha. Mbinu ya Deep GLR pia huanza na picha ya awali iliyopatikana kwa FBP, kisha hujaribu kuiboresha hatua kwa hatua.
Deep GLR inapendekeza nini?
Deep GLR inapendekeza mkabala mseto unaounganisha uboreshaji wa kawaida na ujifunzaji wa kina.
Wazo hapa ni hili:
Badala ya kutegemea kikamilifu modeli kubwa na changamano ya akili bandia, kuingiza wazi muundo wa kimwili wa CT na mahusiano ya ujirani wa picha ndani ya modeli.
Deep GLR ina sehemu tatu za msingi:
1. Mitandao mepesi ya CNN
Moduli ndogo za CNN hutumika kufanya uchakataji wa awali wa picha, kutoa sifa za pikseli na kujifunza uzito wa udhibiti.
2. Graph Laplacian Regularization
Udhibiti unaotegemea grafu hutumika ili pikseli zinazofanana katika picha zibaki katika thamani zilizo karibu.
3. Mfumo wa uboreshaji wa PFBS
Picha husasishwa hatua kwa hatua kwa mkabala wa uboreshaji wa kurudia unaoitwa Proximal Forward-Backward Splitting.
Muundo huu hujenga modeli inayojifunza lakini iliyowekewa mipaka na udhibiti wa kihisabati, badala ya modeli “inayojifunza tu”.
Udhibiti unaotegemea grafu unamaanisha nini?
Katika makala, picha hufikiriwa kama grafu. Hapa kila pikseli hukubaliwa kama nodi. Viungo huundwa kati ya pikseli zilizo karibu.
Ikiwa pikseli mbili zina sifa zinazofanana, kiungo kati yao huwa imara zaidi. Ikiwa zina sifa tofauti, kiungo huwa dhaifu.
Mtandao huu wa viungo hutoa kidokezo kuhusu mahali ambapo picha inapaswa kubaki laini na mahali ambapo mipaka inapaswa kuhifadhiwa.
Katika picha ya CT, mapafu, tishu laini, mfupa na mipaka ya viungo huonyesha miundo tofauti. Mkabala unaotegemea grafu hujaribu kupunguza kelele kwa kuzingatia kufanana kati ya pikseli jirani.
Fomula ya Graph Laplacian inaeleza nini?
Kauli ya msingi ya udhibiti inayotumika katika makala ni hii:
GLR(x) = xᵀLx = Σ wij(xi − xj)²
Fomula hii inaonekana ya kiufundi mwanzoni; lakini maana yake ni yenye kufundisha sana.
xi na xj, ni thamani za pikseli mbili jirani.
wij, ni uzito wa kufanana kati ya pikseli hizi mbili.
L, ni matrisi ya Laplacian ya grafu.
Kauli ya jumla huadhibu hali ya pikseli zinazofanana kuwa na thamani tofauti sana.
Kwa maelezo rahisi:
Ikiwa pikseli mbili zinafanana, modeli haitaki thamani zake zitengane kupita kiasi.
Hili ni la manufaa kwa kupunguza kelele. Kwa sababu kelele mara nyingi huzalisha mabadiliko ya ghafla na yasiyo na maana kati ya pikseli jirani.
Lakini hapa kuna uwiano. Iwapo kulainisha kunafanywa kupita kiasi, maelezo madogo ya anatomia yanaweza kupotea. Kwa hiyo mafanikio ya mbinu yanategemea uwezo wake wa kupunguza kelele huku ikihifadhi mipaka muhimu.
Kufanana kwa pikseli kunahesabiwaje?
Katika makala, uzito kati ya pikseli jirani huhesabiwa kwa fomula hii:
wij = exp(− ||fi − fj||² / 2ε²)
Maana rahisi ya fomula hii ni hii:
Ikiwa sifa zilizojifunzwa za pikseli mbili zinafanana, kiungo kati yao huwa imara.
Ikiwa sifa hizo ni tofauti sana, kiungo hudhoofika.
Hapa fi na fj, ni sifa za pikseli mbili zilizojifunzwa na CNN. ε ni kigezo cha upana wa bendi kinachoamua kipimo cha kufanana kitakuwa nyeti kiasi gani.
Katika utafiti, ε kigezo hiki kinaripotiwa kutulia karibu na 1,25 mwishoni mwa mafunzo. Thamani hii inaashiria kwamba modeli inaweza kuwa imejifunza kipimo cha kufanana chenye maana katika picha, badala ya kukariri kwa nasibu kabisa. Hata hivyo, tafsiri hii inapaswa kutathminiwa ndani ya masharti ya majaribio ya utafiti wenyewe.
Sasisho la PFBS linafanya nini?
Deep GLR haitoi picha kwa hatua moja. Huanza na picha iliyopatikana kwa FBP mwanzoni na kuiboresha kwa hatua nyingi ndogo.
Katika makala, mchakato huu unaweza kufikiriwa kama uwiano kati ya nguvu mbili kuu:
Uaminifu kwa data:
Picha inayozalishwa inapaswa kuendana na data ya kipimo cha CT.
Udhibiti:
Picha inapaswa kuondolewa kelele isiyo ya lazima na muundo wenye maana kati ya pikseli jirani unapaswa kuhifadhiwa.
Katika fomula, hili linaelezwa takriban kama tatizo hili la uboreshaji:
min 1/2 ||Ax − y||² + μ(xᵀLx)
Tulirahisishe:
Kipengele cha kwanza hupima jinsi picha inavyoendana na data ya kipimo.
Kipengele cha pili hudhibiti ulaini wa picha unaotegemea grafu.
μ, huweka uwiano kati ya malengo haya mawili.
Ikiwa μ ni ndogo sana, kelele zaidi inaweza kubaki. Ikiwa μ ni kubwa sana, picha inaweza kulainishwa kupita kiasi. Kwa hiyo kujifunza thamani ya μ ni muhimu.
Usanifu wa mtandao umeundwaje?
Mfumo wa Deep GLR hutumia moduli tatu mepesi za CNN.
Pre-filtering Network:
Hufanya usafishaji wa awali kwenye picha ya kwanza yenye kelele inayotoka kwa FBP.
Feature Extraction Network:
Hutoa vekta ya sifa ya vipimo vitatu kwa kila pikseli. Sifa hizi hutumika kujenga grafu ya kufanana kwa pikseli.
Parameter Learning Network:
Hujifunza thamani ya μ, ambayo ni uzito wa udhibiti kwa kila picha.
Zaidi ya hayo, mtandao mdogo wa uchakataji wa baada ya hatua ya mwisho hutumika. Lakini mfumo mzima haujaribu kuwa modeli kubwa ya ujifunzaji wa kina. Nguvu yake kuu hutokana na kuunganisha moduli ndogo zinazojifunza na uboreshaji wa kihisabati.
Jumla ya idadi ya vigezo inaripotiwa kuwa 91.848. Hii ina maana ya ukubwa mdogo kabisa wa modeli ikilinganishwa na baadhi ya mikabala ya ujifunzaji wa kina iliyolinganishwa katika makala.
Majaribio yalifanywaje?
Watafiti wanajaribu mbinu hii kwenye seti ya data ya benchmark ya CT ya dozi ya chini iitwayo LoDoPaB-CT.
Maelezo muhimu ya majaribio ni haya:
- Azimio la picha: pikseli 362 × 362
- Jiometri ya projeksheni: pembe 1000 na sehemu 513 za detekta
- Modeli ya kelele: takwimu za Poisson
- Mfano wa mafunzo: picha 1000
- Mfano wa uthibitishaji: picha 100
- Muda wa mafunzo: epoch 30
- Jumla ya vigezo: 91.848
Mifano 1000 ya mafunzo inalingana na asilimia 2,8 tu ya seti kamili ya mafunzo. Hili ni jambo muhimu kwa lengo kuu la utafiti, yaani ufanisi wa data.
Jedwali la 1 linaonyesha nini?
Jedwali la 1 katika makala linatoa ulinganisho wa Deep GLR na FBP pamoja na baadhi ya mbinu za benchmark.
Matokeo yanaweza kufupishwa hivi:
FBP:
PSNR: 24,37 dB
SSIM: 0,6916
Deep GLR:
PSNR: 30,70 dB
SSIM: 0,7719
Vigezo: 91.848
Data ya mafunzo: mifano 1000
FBP + U-Net:
PSNR: 35,84 dB
SSIM: 0,8443
Vigezo: takriban 500.000
Data ya mafunzo: mifano 35.820
VQ-CAE:
PSNR: 43,75 dB
SSIM: 0,96
Vigezo: takriban 500.000
Data ya mafunzo: seti kamili ya data
Jedwali hili linatuambia mambo mawili kwa wakati mmoja.
Kwanza, Deep GLR hutoa uboreshaji dhahiri ikilinganishwa na FBP ya kawaida. Thamani ya PSNR huongezeka kwa 6,33 dB.
Pili, Deep GLR si mbinu bora zaidi. Kuna tofauti kubwa ya takriban 13 dB hasa kati yake na VQ-CAE. Kwa hiyo mbinu hii haidai ubora wa juu kabisa; inapaswa kusomwa zaidi kama mkabala wenye ufanisi unaotoa uboreshaji wa kuridhisha katika hali za data ndogo na vigezo vichache.
Kielelezo cha 1 kinaeleza nini?
Kielelezo cha 1 katika makala kinaonyesha mnyororo wa usindikaji wa Deep GLR. Katika mchoro, picha ya CT inayoanza na FBP hupitia hatua za uchujaji wa awali unaotegemea CNN na utoaji wa sifa. Kisha grafu huundwa kati ya pikseli, Graph Laplacian regularization huhesabiwa na picha husasishwa kwa iteresheni za PFBS.
Ujumbe mkuu wa kielelezo hiki ni huu:
Deep GLR haipitishi picha ya CT kwenye kichujio cha CNN pekee. Inaishughulikia picha pamoja na modeli ya kipimo cha kimwili, kufanana kwa pikseli na uboreshaji wa kurudia.
Kwa hiyo mbinu hii inaweza kufikiriwa kama daraja kati ya uboreshaji wa kawaida na ujifunzaji wa kina wa kisasa.
Kielelezo cha 2 kinaonyesha nini?
Kielelezo cha 2 kinaonyesha mabadiliko ya loss na PSNR wakati wa mafunzo. Mikunjo inaonyesha kwamba modeli ilijifunza kwa uthabiti katika epoch 30 na thamani ya uthibitishaji ya PSNR ilipanda juu ya takriban 30 dB.
Katika grafu inaonekana kuwa kiwango cha kuanzia cha FBP kiko karibu na 24,4 dB. Kadiri mafunzo ya Deep GLR yanavyoendelea, kinapanda wazi juu ya kiwango hicho.
Ujumbe rahisi wa kielelezo hiki ni huu:
Modeli hujifunza kuunda picha safi zaidi kuliko FBP hata kwa data chache. Hata hivyo, mikunjo inaonyesha uboreshaji wa namba kwenye benchmark, si mafanikio ya kitabibu.
Kielelezo cha 3 kinaeleza nini?
Kielelezo cha 3 kinaonyesha FBP, ground truth na matokeo ya Deep GLR kwa mifano mitatu tofauti ya wagonjwa, zikiwa pembeni kwa pembeni.
Wakati picha za FBP zinaonyesha kelele na upotoshaji zaidi, matokeo ya Deep GLR yanaonekana safi zaidi na laini zaidi. Ingawa muhtasari wa jumla wa miundo ya anatomia unaonekana kuhifadhiwa, kuna hatari ya kulainisha kupita kiasi katika baadhi ya maelezo madogo.
Ujumbe mkuu wa kielelezo hiki:
Deep GLR inaonyesha mwelekeo wenye mafanikio katika kupunguza kelele; lakini ikiwa picha inatosha kwa utambuzi haiwezi kuamuliwa kwa picha hizi pekee. Kwa hilo, tathmini ya radiolojia, majukumu tofauti ya kliniki na majaribio ya ziada kwa data halisi za vifaa vinahitajika.
Utafiti unasema nini?
Ujumbe mkuu wa utafiti ni huu:
Kwa ujenzi upya wa CT ya dozi ya chini, modeli kubwa sana na seti kubwa sana ya data huenda zisihitajike kila wakati. Wakati udhibiti unaotegemea grafu, uboreshaji wa kawaida na moduli ndogo za CNN zinapotumiwa pamoja, ongezeko la ubora lenye maana linaweza kupatikana kwa rasilimali chache.
Deep GLR huongeza ubora wa picha ikilinganishwa na FBP. Hata hivyo, haifikii kiwango cha mbinu za hali ya juu zaidi za ujifunzaji wa kina. Hili pia ndilo upande wa uaminifu na muhimu wa utafiti: mbinu huongeza ubora, lakini inalenga “ubora wenye ufanisi” badala ya “ubora bora kabisa”.
Kwa nini hili ni muhimu?
Katika nyanja ya upigaji picha wa kitabibu, kukusanya data si rahisi kila wakati. Kwa sababu za faragha ya mgonjwa, magonjwa adimu, tofauti za vifaa na kushiriki data kati ya taasisi, seti kubwa za data huenda zisiwe zinapatikana kila mara.
Zaidi ya hayo, si kila kliniki au kituo cha utafiti kina vifaa vya kufundishia modeli kubwa. Kwa hiyo mbinu ndogo, zinazotafsirika zaidi na zinazohitaji data chache ni muhimu hasa kwa mazingira yenye rasilimali chache.
Tafiti kama Deep GLR zinatukumbusha kuwa katika AI ya kitabibu haitoshi kutafuta tu “alama ya juu kabisa”. Wakati mwingine modeli ndogo lakini zinazoeleweka zaidi na zinazoweza kutumika zaidi nazo ni zenye thamani.
Mambo yanayopaswa kuzingatiwa
Kwa kuwa utafiti huu unahusiana na nyanja ya afya, unapaswa kusomwa kwa uangalifu.
Kwanza, utafiti ni preprint. Haipaswi kudhaniwa kuwa umepitia mapitio ya wenzao.
Pili, majaribio yamefanywa kwenye seti moja tu ya data ya benchmark. Matokeo yanaweza kubadilika katika maeneo tofauti ya anatomia, aina tofauti za scanner, itifaki tofauti na masharti halisi ya kliniki.
Tatu, mbinu hufanya kazi kwenye vipande vya 2D. Uchunguzi wa CT wa kliniki mara nyingi hutathminiwa kama ujazo wa 3D. Kutotumia uhusiano kati ya vipande kunaweza kusababisha baadhi ya taarifa kupotea.
Nne, ingawa Deep GLR hufanya kazi kwa vigezo vichache na data chache, kuna tofauti ya ubora iliyo wazi kati yake na mbinu za hali ya juu zaidi.
Tano, vipimo vya namba kama PSNR na SSIM ni vya manufaa; lakini havitoshi peke yake kwa kutathmini ufaafu wa utambuzi wa kliniki. Tathmini ya radiolojia na vipimo vinavyotegemea kazi vinahitajika.
Hatimaye, maudhui haya si ushauri wa kitabibu. Dozi ya CT, mbinu ya upigaji picha au uamuzi wa utambuzi vinapaswa kuamuliwa na wataalamu wa afya pekee.
Hitimisho
Utafiti huu unaonyesha kwamba mkabala mdogo na wenye ufanisi wa data wa akili bandia unaweza kuwa unawezekana kwa ujenzi upya wa CT ya dozi ya chini.
Deep GLR imeleta ongezeko dhahiri la ubora ikilinganishwa na FBP kwa kuunganisha udhibiti unaotegemea grafu, uboreshaji wa kawaida wa PFBS na moduli mepesi za CNN. Mbinu hii imefikia thamani ya PSNR ya 30,70 dB kwa vigezo 91.848 tu na mifano 1000 ya mafunzo.
Hata hivyo, matokeo yako nyuma ya mbinu za hali ya juu zaidi na hayamaanishi kuwa mbinu iko tayari kwa matumizi ya kliniki. Thamani kuu ya utafiti iko katika kuchunguza uwiano wa ubora na ufanisi kwa mazingira ya upigaji picha wa kitabibu yenye rasilimali chache.
Ujumbe muhimu zaidi wa makala hii ni huu:
Katika akili bandia ya kitabibu, modeli kubwa zaidi si njia pekee kila wakati; muundo sahihi wa kihisabati na ujifunzaji wenye ufanisi vinaweza kutoa uboreshaji wenye maana hata katika rasilimali chache.
Dokezo la Chanzo na Mbinu
Maudhui haya yameandaliwa upya katika fomati ya uhariri ya Verianla kwa kutumia kazi ya kitaaluma yenye kichwa “Parameter-Efficient CT Reconstruction via Deep Graph Laplacian Regularization” iliyoandaliwa na Veera Varuni Radhakrishnan, Chinthaka Dinesh na Qurat-ul-Ain Azim.
Utafiti ni preprint iliyochapishwa kwenye arXiv. Maudhui haya yana madhumuni ya taarifa na elimu. Hayachukui nafasi ya ushauri wa utambuzi wa kitabibu, matibabu, itifaki ya upigaji picha, uamuzi wa dozi ya mionzi au matumizi ya kliniki.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *