

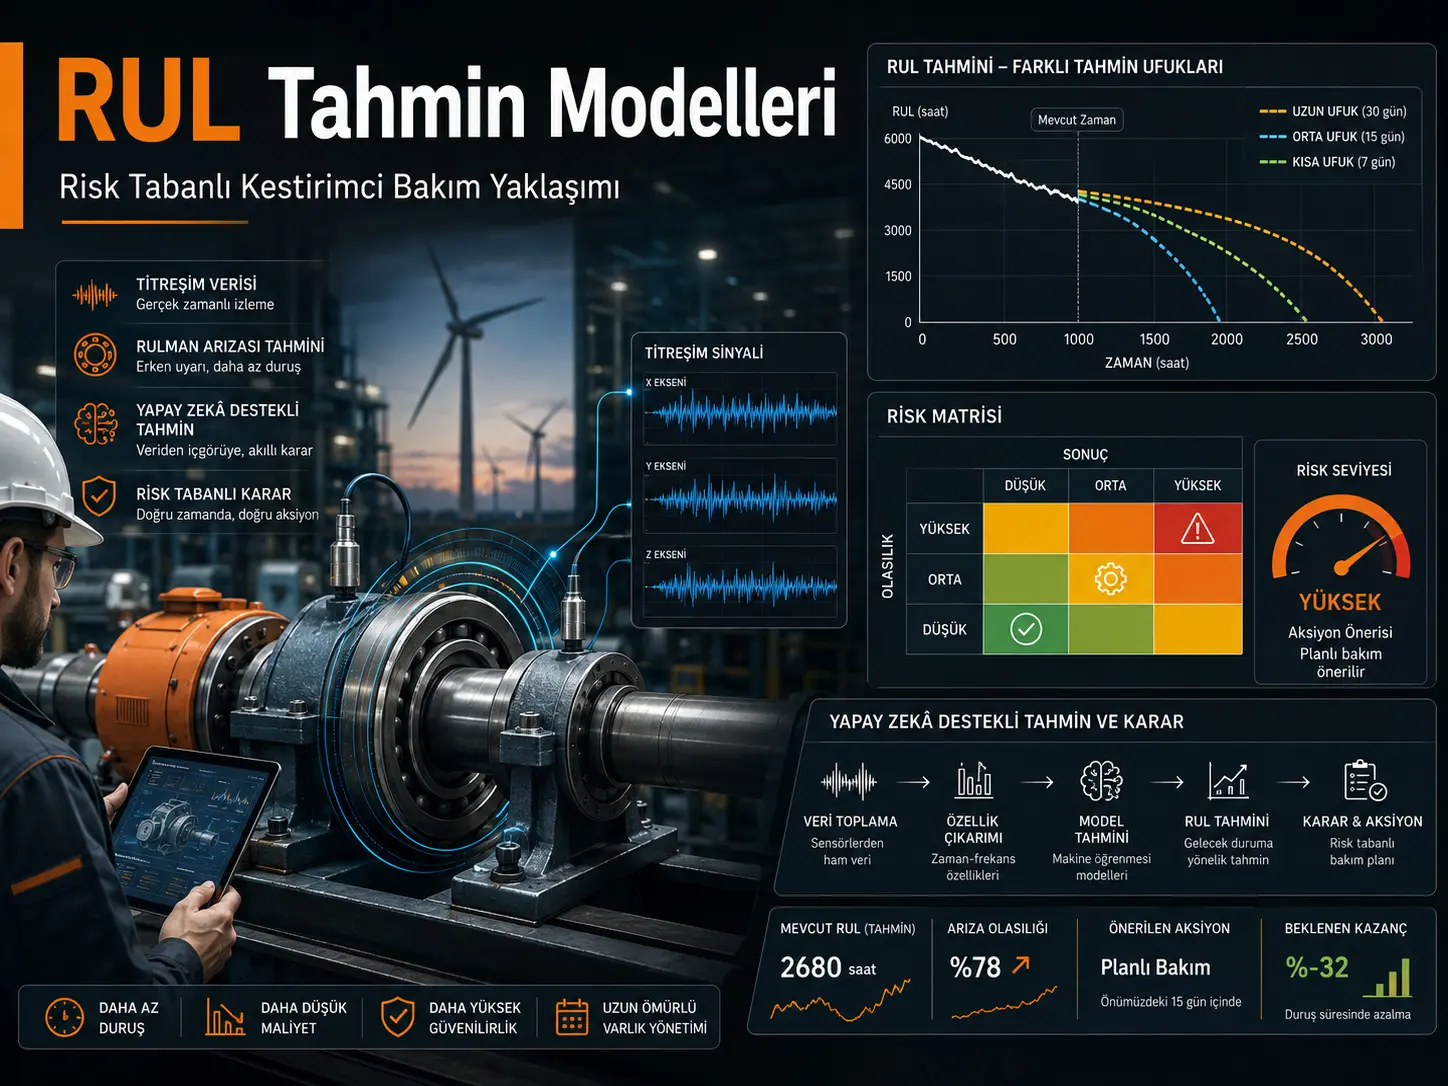
Kutabiri kwa usahihi lini mashine itaharibika huenda hakutoshi peke yake kwa matengenezo ya utabiri. Ili timu ya matengenezo iweze kupanga upatikanaji wa vipuri, wafanyakazi, kusimamisha uzalishaji au maandalizi ya kuingilia kati, utabiri lazima pia uje mapema vya kutosha. Utafiti huu unapendekeza kwamba miundo ya Remaining Useful Life (RUL; maisha muhimu yaliyobaki) isitathminiwe kwa thamani za jumla za kosa au usahihi pekee, bali pia kwa kuzingatia muda uliobaki hadi hitilafu, yaani upeo wa utabiri, pamoja na matokeo ya kiutendaji ya utabiri usio sahihi.
Katika utafiti, mbinu tano za utabiri—ARIMA, Facebook Prophet, LSTM, GRU na PatchTST—zimelinganishwa kwenye seti mbili za data wazi za mtetemo. Inaelezwa kwamba autoencoder ilitumika kabla ya miundo yote kwa ajili ya kubana data ghafi za mtetemo na kutoa sifa. Utendaji wa utabiri ulitathminiwa katika upeo tatu: mrefu, wa kati na mfupi. Katika seti ya kwanza ya data, hizi ziliundwa kwa mgawanyo wa siku 20 za mafunzo + siku 30 za utabiri, 40 + 10 na 47 + 3.
Matokeo yanaonyesha kwamba ni modeli ipi “bora zaidi” hubadilika kulingana na upeo wa utabiri. Katika Dataset 1, Prophet ilitoa usahihi uliotolewa wa juu zaidi wa %72,67 katika upeo mrefu, huku ARIMA ikipanda hadi %90,63 katika upeo mfupi. Katika Dataset 2, Prophet ilikuwa na %86,62 katika upeo mrefu, ARIMA %82,04 katika upeo wa kati kwa mujibu wa Jedwali 8, na ARIMA tena %98,25 katika upeo mfupi. Kinyume chake, PatchTST ilionyesha matokeo dhaifu hasa kwa %18,13 katika upeo wa kati wa Dataset 1 na %30,29 katika upeo mfupi wa Dataset 2.
“Accuracy” katika nambari hizi si usahihi wa kawaida wa uainishaji. Katika utafiti umefafanuliwa kama \(Accuracy = 100 - MAPE\). Tofauti hii ni muhimu; kwa sababu katika upeo mfupi wa Dataset 1, ingawa usahihi uliotolewa wa ARIMA ni %90,63, thamani ya R² ni −0,5988. Kwa maneno mengine, ingawa kosa la wastani la ukubwa wa utabiri linaonekana kuwa dogo kiasi, modeli haiwezi kueleza vya kutosha mabadiliko katika mkunjo halisi wa uharibifu.
Kikomo muhimu zaidi cha kimetodolojia cha utafiti ni kwamba wakati upeo wa utabiri unapofupishwa, kiasi cha data ya mafunzo huongezeka kwa wakati mmoja. Katika jaribio la upeo mrefu hutumika siku 20 za data ya mafunzo, na katika upeo mfupi siku 47. Kwa hiyo, muundo wa jaribio hauwezi kutenganisha ni kiasi gani cha mabadiliko ya utendaji kati ya upeo kinatokana na muda mfupi wa utabiri na ni kiasi gani kinatokana na data nyingi zaidi za mafunzo. Matokeo hayapaswi kutafsiriwa kama sheria ya jumla ya modeli kwamba “utabiri wa muda mfupi huwa sahihi zaidi katika hali zote”.
| Ugunduzi mkuu | Matokeo ya chanzo | Tafsiri ya kisayansi |
|---|---|---|
| Masafa ya usahihi katika upeo mrefu | %11,64–86,62 | Utabiri wa mapema hutoa muda zaidi wa kupanga, lakini matokeo yanategemea sana modeli na seti ya data. |
| Masafa ya usahihi katika upeo wa kati | %18,13–82,04 | Utendaji hubadilika sana. |
| Masafa ya usahihi katika upeo mfupi | %30,29–98,25 | Kwa ujumla ni wa juu zaidi, lakini muda uliobaki wa kuingilia kati ni mdogo. |
| Kiongozi wa upeo mrefu wa Dataset 1 | Prophet: %72,67 | Chanzo kimeiangazia kwa upande wa mipango ya mapema. |
| Kiongozi wa upeo mfupi wa Dataset 1 | ARIMA: %90,63 | Licha ya usahihi mkubwa uliotolewa, R² ni hasi. |
| Kiongozi wa upeo mfupi wa Dataset 2 | ARIMA: %98,25 | Matokeo ya upeo wa siku tatu katika seti hii ya data. |
Kwa nini RUL ni muhimu katika maamuzi ya matengenezo?
Remaining Useful Life hujaribu kutabiri muda unaoweza kutumika unaobaki kutoka hali ya sasa ya kifaa hadi hatua ya hitilafu ya kiutendaji. Lengo si kutambua tu kwamba hitilafu inakaribia, bali pia kukadiria dirisha la muda linaloweza kutumiwa kwa kuingilia kati.
Kwa hiyo hoja kuu ya utafiti ni ya kiutendaji sana: utabiri sahihi siku tatu kabla ya hitilafu unaweza kuonekana mzuri kwa nambari, lakini ukawa umechelewa kwa baadhi ya shughuli za matengenezo. Utabiri wenye kosa zaidi kidogo lakini unaoweza kutumika siku thelathini mapema unaweza kuwa na thamani kubwa zaidi kwa upande wa vipuri, timu, mpango wa uzalishaji na muda wa matengenezo.
Tofauti ni ipi kati ya matengenezo yanayotegemea hatari na matengenezo yanayoongozwa na taarifa ya hatari?
Kielelezo 2 katika makala kinaweka dhana hizi mbili katika hatua tofauti za mzunguko wa maisha. Matengenezo ya utabiri yanayotegemea hatari yanazingatia swali la mbinu gani ya utabiri ichaguliwe katika hatua ya mradi. Matengenezo ya utabiri yanayoongozwa na taarifa ya hatari yanahusu wakati gani matengenezo yafanywe baada ya utabiri kuwasili wakati mfumo tayari uko katika uendeshaji.
Uzito wa utafiti huu uko kwenye tatizo la kwanza, yaani jinsi modeli ya utabiri inavyopaswa kutathminiwa kabla ya kuingizwa kwenye mfumo. Inapendekezwa kwamba uchaguzi wa modeli utegemee si thamani ya wastani ya kosa pekee, bali pia utendaji wake katika upeo tofauti za utabiri na matokeo ya uamuzi usio sahihi.
Kwa nini upeo wa utabiri ni kipimo tofauti cha utendaji?
Kielelezo 3 katika makala kinaonyesha kwa dhana kwamba usahihi mkubwa wa muda mfupi hauleti moja kwa moja modeli yenye matumizi makubwa zaidi. Usahihi huwekwa kwenye mhimili mmoja, huku kiwango cha muda/matokeo kikiwa kwenye mwingine. Hivyo, mchanganyiko wa usahihi mdogo–ukali mkubwa wa matokeo hutafsiriwa kama eneo lenye hatari kubwa zaidi.
Utafiti unahusisha kosa la utabiri lililotokea siku 30 kabla na kiwango cha chini cha matokeo, siku 10 kabla na kiwango cha kati, na siku 3 kabla na kiwango cha juu. Viwango hivi si viwango vya ulimwengu wote; waandishi wanavitumia kama makadirio ya kiutendaji yanayohusiana na usimamizi wa mali za shamba la upepo.
Ni familia zipi za modeli za RUL zinazojadiliwa?
Mti katika Kielelezo 1 cha makala unagawanya modeli za utabiri wa RUL katika makundi mapana: mbinu za takwimu/zinazotegemea uaminifu, machine learning, deep learning na physics-based. Aidha, modeli mseto zinazochanganya vipengele vya makundi haya zinaonyeshwa kama tabaka tofauti.
Katika ulinganisho wa majaribio, mbinu tano zimetumika: ARIMA, Facebook Prophet, LSTM, GRU na mbinu inayotegemea Transformer ambayo inaitwa “PatchTST-inspired” katika jedwali la hyperparameter la chanzo. Katika sehemu za matokeo, modeli ya mwisho huitwa kwa kifupi PatchTST; kwa hiyo utafiti hauthibitishi kwamba maelezo yote ya utekelezaji wa kawaida wa PatchTST yalitumiwa kama yalivyo.
Seti mbili za data zinawakilisha nini?
Dataset 1 ni data za mtetemo wa bearing ya high-speed shaft ya turbine ya upepo ya 2 MW katika hali halisi za uendeshaji. Makala hutumia data za radial accelerometer zinazotegemea MEMS zinazofuatilia uharibifu unaoendelea wa bearing kwa siku 50. Kasi ya kawaida ya mzunguko imeelezwa kuwa 1800 rpm, kiwango cha juu cha sampling 97.656 Hz na muda wa kurekodi sekunde 6.
Dataset 2 inategemea majaribio ya bearing ya run-to-failure yaliyotengenezwa na University of Cincinnati Intelligent Maintenance Systems Centre. Kielelezo 5 katika makala kinaonyesha muundo wazi zaidi wa uharibifu ambapo amplitude ya mtetemo huongezeka kwa dhahiri unapokaribia mwisho wa maisha. Waandishi wanapendekeza kwamba Dataset 2 inaweza kuwa na ishara ya uharibifu inayojifunza kwa urahisi zaidi kuliko Dataset 1.
Kuna kutokuwa wazi kwa kibibliografia ndani ya chanzo kuhusu kutaja vyanzo vya data. Dataset 1 imeelezwa katika sehemu ya mbinu kuwa inapatikana kupitia GitHub, lakini rejea husika inaelekeza MathWorks. Kwa Dataset 2, sehemu za mbinu na upatikanaji wa data zinataja NASA Prognostics Data Repository, ilhali rejea namba [47] ni anwani ya Kaggle. Hali hii haifanyi matokeo kuwa batili yenyewe; lakini kwa reproducibility huru, repository asilia na toleo la data lililotumiwa vinahitaji kuandikwa kwa uwazi zaidi.
Upeo wa utabiri uliundwaje?
| Upeo | Sehemu ya mafunzo | Sehemu ya test / utabiri | Makadirio ya matokeo ya chanzo |
|---|---|---|---|
| Mrefu | Siku 20 | Siku 30 | Hatua ya mapema; muda zaidi wa kupanga matengenezo |
| Wa kati | Siku 40 | Siku 10 | Hatua ambapo hitilafu imeendelea na muda wa kuingilia kati unapungua |
| Mfupi | Siku 47 | Siku 3 | Karibu na hitilafu muhimu, hatua ambapo ukali wa matokeo unachukuliwa kuwa wa juu |
Matokeo muhimu ya muundo huu ni kwamba vigezo viwili vya majaribio hubadilika pamoja. Upeo wa utabiri unaposhuka kutoka siku 30 hadi siku 3, data ya mafunzo huongezeka kutoka siku 20 hadi siku 47. Kwa hiyo, haiwezi kusemwa kwamba ongezeko la utendaji katika upeo mfupi linatokana tu na kurahisika kwa kutabiri siku za karibu; kuona historia zaidi ya uharibifu na modeli pia kunaweza kuathiri matokeo.
Mpangilio wa modeli ulibadilika vipi katika Dataset 1?
Verianla Live: Mabadiliko ya usahihi wa modeli katika Dataset 1 kulingana na upeo wa utabiri
Thamani zimechukuliwa kutoka Jedwali 2 la chanzo. “Usahihi” huhesabiwa kama 100 − MAPE katika utafiti; si usahihi wa kawaida wa uainishaji. Kiasi cha data ya mafunzo pia hubadilika pamoja na upeo.
| Modeli | Upeo mrefu (%) | Upeo wa kati (%) | Upeo mfupi (%) | Chanzo |
|---|---|---|---|---|
| ARIMA | 11,64 | 56,56 | 90,63 | Jedwali 2 |
| Prophet | 72,67 | 66,12 | 89,81 | Jedwali 2 |
| LSTM | 34,46 | 59,04 | 79,72 | Jedwali 2 |
| GRU | 33,77 | 54,77 | 90,39 | Jedwali 2 |
| PatchTST | 33,99 | 18,13 | 67,64 | Jedwali 2 |
Katika Dataset 1, Prophet hutoa thamani ya juu zaidi katika upeo mrefu na wa kati, huku ARIMA ikiongoza katika upeo mfupi. Kupanda kwa ARIMA kutoka %11,64 hadi %90,63 kunaonyesha wazi jinsi mpangilio wa modeli unavyoweza kutegemea dirisha la tathmini.
Je, Dataset 2 ilitoa mpangilio uleule?
Hapana. Katika seti ya pili ya data, utendaji wa jumla wa modeli nyingi uliongezeka na baadhi ya nafasi zilibadilika. Hii ni mojawapo ya matokeo makuu yanayounga mkono dai la utafiti kwamba “wasifu wa hatari wa modeli si sifa ya algoriti pekee; unategemea pia muundo wa uharibifu wa seti ya data”.
Verianla Live: Mabadiliko ya usahihi wa modeli katika Dataset 2 kulingana na upeo wa utabiri
Thamani zimechukuliwa kutoka Jedwali 8 la chanzo. Jedwali linatoa %82,04 kwa ARIMA na %81,03 kwa Prophet katika upeo wa kati. Maelezo ya chanzo yanayosema Prophet ilikuwa bora zaidi pia katika upeo wa kati wa Dataset 2 hayalingani na jedwali.
| Modeli | Upeo mrefu (%) | Upeo wa kati (%) | Upeo mfupi (%) | Chanzo |
|---|---|---|---|---|
| ARIMA | 77,35 | 82,04 | 98,25 | Jedwali 8 |
| GRU | 76,56 | 73,21 | 95,18 | Jedwali 8 |
| LSTM | 84,86 | 70,72 | 95,14 | Jedwali 8 |
| PatchTST | 46,12 | 33,79 | 30,29 | Jedwali 8 |
| Prophet | 86,62 | 81,03 | 96,76 | Jedwali 8 |
Katika Dataset 2, Prophet hutoa matokeo ya juu zaidi ya %86,62 katika upeo mrefu. Katika upeo wa kati, thamani ya juu zaidi katika Jedwali 8 ni %82,04 ya ARIMA; Prophet ni %81,03. Katika upeo mfupi, ARIMA hufikia %98,25. PatchTST, tofauti na modeli nyingine, haikuboreshwa katika upeo mfupi na ilishuka hadi %30,29.
Inaweza kutafsiriwaje kwa Uturuki?
Utafiti haukufanya validation ya uwanjani nchini Uturuki. Hata hivyo, tatizo la uamuzi linalowasilishwa lina maana ya kihandisi pia kwa biashara za Uturuki zinazotumia matengenezo ya utabiri katika turbines za upepo, mistari ya uzalishaji, mashine zinazozunguka, bearings na vifaa vingine muhimu: badala ya kuchagua tu “modeli yenye kosa la chini zaidi”, lazima iamuliwe upeo wa utabiri unaolingana na muda halisi wa upatikanaji wa vipuri, uhamasishaji wa timu ya matengenezo, mahitaji ya kusimamisha uzalishaji kwa mpango na matokeo ya usalama/uzalishaji ya hitilafu.
Hata hivyo, mipaka ya siku 30, 10 na 3 katika utafiti si thamani za kawaida zinazoweza kutumiwa kwa mali zote za viwandani nchini Uturuki. Chanzo chenyewe pia kinasema kwamba muda huu unapaswa kurekebishwa kulingana na kifaa, mekanizimu ya uharibifu na mazingira ya uendeshaji.
Utafiti unaunga mkono nini na hauthibitishi nini?
| Matokeo yanayoungwa mkono na utafiti | Matokeo ambayo utafiti haujathibitisha / haujajaribu |
|---|---|
| Utendaji wa modeli unaweza kubadilika kwa kiasi kikubwa kulingana na upeo wa utabiri na seti ya data. | Haijathibitishwa kwamba algoriti moja ndiyo modeli bora zaidi ya RUL kwa mali zote za viwandani. |
| Usahihi mkubwa wa nambari katika upeo mfupi huenda usitoe onyo la mapema la kutosha kwa kupanga matengenezo. | Haijaonyeshwa kwamba ongezeko la utendaji katika upeo mfupi linatokana na urefu wa upeo pekee; kiasi cha data ya mafunzo pia hubadilika. |
| Kipimo kimoja cha kosa huenda kisiwakilishe kikamilifu mkunjo halisi wa uharibifu. | Haijaonyeshwa kwamba Shape-RMSE au PHEP zilizopendekezwa ni viwango vya ulimwengu wote vilivyothibitishwa kwa matumizi yote ya RUL. |
| Prophet imeonyesha utendaji thabiti kiasi katika upeo mrefu kwenye seti zote mbili za data. | Haijaonyeshwa kwamba Prophet itakuwa mbinu yenye hatari ya chini zaidi katika seti zote za data au aina zote za mali. |
| ARIMA imetoa usahihi wa juu zaidi uliotolewa katika upeo mfupi kwenye seti zote mbili za data. | Matokeo haya hayaonyeshi kwamba ARIMA imejifunza vizuri zaidi umbo halisi la uharibifu; R² ya upeo mfupi katika Dataset 1 ni hasi. |
| Kutumia seti mbili za data kumetoa taarifa zaidi kuhusu generalizability kuliko tathmini ya seti moja. | Matokeo hayawezi kuhamishwa moja kwa moja kwa bearings nyingine, gearboxes, pumps, motors au hali tofauti za uendeshaji. |
Mbinu na Matokeo ya Utafiti
Data zilichakatwaje kabla ya modeli?
Chanzo kinaeleza kwamba badala ya kuingiza moja kwa moja signal za mtetemo zenye vipimo vingi na kelele kwenye modeli za utabiri, autoencoder ilitumika. Autoencoder ilitumika kubana data na kutoa sifa, na representation iliyopatikana kisha ikapitishwa kwenye mbinu tano za utabiri.
Hata hivyo, usanifu wa layers za autoencoder, latent dimension na maelezo yote ya mafunzo yake hayajatolewa kwenye jedwali kuu la hyperparameter. Hii ni upungufu wa kimetodolojia hasa kwa watafiti wanaotaka kuzalisha upya matokeo ya utafiti kwa usahihi.
Mipangilio mikuu ya modeli
| Modeli | Mipangilio iliyochaguliwa iliyoripotiwa katika chanzo | Jambo la kuzingatia |
|---|---|---|
| LSTM | Urefu wa mfuatano 2; vitengo 16 vya LSTM; dropout 0,1; dense 16; 300 epoch; batch 4 au 2 | Jedwali halitenganishi hali ambayo thamani ya batch “4 au 2” ilitumika. |
| GRU | Urefu wa mfuatano 2; vitengo 16 vya GRU; dropout 0,1; dense 16; 300 epoch; batch 4 au 2 | Data ni chache sana kwa modeli ya deep learning. |
| ARIMA | p: 0–3; d: 0–2; q: 0–3; mpangilio bora unaotegemea AIC | Mbinu ya takwimu |
| Prophet | Seasonality ya kila siku/kila mwaka imezimwa; ya kila wiki imewashwa; changepoint prior 0,05; seasonality prior 10; Fourier order 3 | Chanzo kinatumia istilahi “Facebook Prophet”. |
| PatchTST-inspired | Urefu wa mfuatano 2; attention head 2; key dimension 4; feed-forward 16; dense 16; 300 epoch | Jina kwenye jedwali la hyperparameter ni “PatchTST-inspired”, kwenye majedwali ya matokeo ni “PatchTST”. |
“Accuracy” ilikokotolewaje?
Mojawapo ya vipimo vikuu vya kosa katika utafiti, Mean Absolute Error (MAE), ni:
\[ MAE=\frac{1}{n}\sum_{i=1}^{n}|\hat{y}_i-y_i| \]
Root Mean Square Error (RMSE):
\[ RMSE=\sqrt{\frac{1}{n}\sum_{i=1}^{n}(\hat{y}_i-y_i)^2} \]
na Mean Absolute Percentage Error (MAPE):
\[ MAPE=\frac{100}{n}\sum_{i=1}^{n}\left|\frac{\hat{y}_i-y_i}{y_i}\right| \]
zimetolewa kwa namna hiyo. Thamani ya “accuracy” katika utafiti imefafanuliwa moja kwa moja kama:
\[ Accuracy=100\%-MAPE(\%) \]
Kwa hiyo, usemi wa %90 accuracy haumaanishi “asilimia ya utabiri sahihi” kama katika uainishaji. Chanzo chenyewe pia kinasisitiza kwamba ufafanuzi huu unapaswa kutumiwa kwa tahadhari hasa wakati MAPE ni kubwa na tolerances za eneo ni muhimu.
Kwa nini R² inasimulia hadithi tofauti?
Coefficient of determination:
\[ R^2=1-\frac{\sum_{i=1}^{n}(y_i-\hat{y}_i)^2} {\sum_{i=1}^{n}(y_i-\bar{y})^2} \]
inakokotolewa kwa formula hii. R² hasi inaonyesha kwamba modeli inaweza kuwa mbaya hata kuliko kutabiri tu wastani wa RUL katika kueleza variation ya series halisi.
| Modeli | MAE | RMSE | R² | MAPE (%) | Usahihi uliotolewa (%) |
|---|---|---|---|---|---|
| ARIMA | 0,0252 | 0,0313 | −0,5988 | 9,3651 | 90,63 |
| Prophet | 0,0292 | 0,0294 | −0,4160 | 10,1910 | 89,81 |
| LSTM | 0,0558 | 0,0612 | −5,1204 | 20,2753 | 79,72 |
| GRU | 0,0275 | 0,0279 | −0,2698 | 9,6050 | 90,39 |
| PatchTST | 0,0905 | 0,0935 | −13,2818 | 32,3619 | 67,64 |
Sifa inayovutia zaidi ya Jedwali 3 ni kwamba R² ya modeli zote tano ni hasi katika upeo mfupi. Kwa hiyo, usahihi mkubwa unaotegemea MAPE na uwezo wa kueleza dynamics za mkunjo halisi wa uharibifu si jambo lilelile. Mkunjo wa ARIMA katika Kielelezo 8 cha makala pia unaonyesha tatizo hili kwa njia ya kuona.
Shape-RMSE inajaribu kupima nini?
Utafiti unapendekeza Shape-RMSE iliyosawazishwa ili kupima ni kwa kiwango gani umbo la mkunjo wa utabiri linafanana na mkunjo halisi wa uharibifu, badala ya kuangalia ukubwa wa absolute:
\[ Shape\text{-}RMSE= \sqrt{\frac{1}{N} \sum_{t=1}^{N} (\hat{y}^{norm}_t-y^{norm}_t)^2} \]
Series zinasawazishwa kulingana na minimum na maximum zake:
\[ y^{norm}_t= \frac{y_t-\min(y)} {\max(y)-\min(y)} \]
Shape-RMSE ya chini inachukuliwa kuwa bora zaidi.
| Modeli | Upeo mrefu | Upeo wa kati | Upeo mfupi |
|---|---|---|---|
| ARIMA | 0,3846 | 0,7464 | 0,5636 |
| GRU | 0,5307 | 0,5147 | 0,1024 |
| LSTM | 0,5323 | 0,4746 | 0,5999 |
| PatchTST | 0,5959 | 0,3228 | 0,0540 |
| Prophet | 0,1015 | 0,1734 | 0,0681 |
Prophet hutoa Shape-RMSE ya chini zaidi katika upeo mrefu na wa kati. Katika upeo mfupi, kwa nambari PatchTST ina thamani ya chini zaidi ya 0,0540. Hata hivyo, waandishi wa chanzo wanasema katika ukaguzi wa kuona kwamba Prophet hufuata njia halisi ya uharibifu vizuri zaidi. Kwa hiyo makala yenyewe inakubali kwamba katika madirisha mafupi sana, Shape-RMSE peke yake huenda isiakisi kikamilifu uaminifu wa umbo. Huu ni uthibitishaji muhimu wa ndani unaoonyesha kwamba kipimo kipya kilichopendekezwa bado si kipimo cha uamuzi kinachojitegemea.
Modeli ni thabiti kiasi gani dirisha la mafunzo linapobadilika?
Utafiti ulilinganisha masafa ya MAPE kwa kufanya mabadiliko ya ±3 siku karibu na urefu wa mafunzo uliochaguliwa. Hasa katika dirisha la mafunzo la siku 42–48 karibu na upeo mfupi, masafa ya MAPE ya Prophet ni %7,75–14,46, mojawapo ya masafa membamba na ya chini zaidi. ARIMA katika eneo hilohilo hubadilika zaidi kati ya %8,35–45,12.
| Modeli | MAPE karibu na upeo mrefu (%) | MAPE karibu na upeo wa kati (%) | MAPE karibu na upeo mfupi (%) |
|---|---|---|---|
| ARIMA | 95,15–110,82 | 15,21–93,18 | 8,35–45,12 |
| Prophet | 43,83–76,72 | 10,08–38,57 | 7,75–14,46 |
| LSTM | 91,98–101,41 | 36,60–90,98 | 20,99–48,31 |
| GRU | 93,16–100,39 | 42,70–91,17 | 25,80–55,45 |
| PatchTST | 79,90–104,66 | 55,76–117,48 | 32,36–65,27 |
Boxplot katika Kielelezo 10 inaonyesha Prophet kama modeli thabiti zaidi dhidi ya mabadiliko madogo ya dirisha la mafunzo na ARIMA kama nyeti zaidi. Matokeo haya yanaonyesha kwamba kufikia kwa ARIMA usahihi wa juu zaidi katika kipande fulani cha upeo mfupi hakumaanishi kwamba modeli ni thabiti kwa kiwango kilekile katika madirisha yote ya karibu ya mafunzo.
Kwa nini PHEP ilipendekezwa?
Prediction Horizon Error Profile (PHEP) inalenga kuonyesha jinsi ukubwa wa kosa unavyobadilika kulingana na muda uliobaki hadi hitilafu badala ya kutoa kosa moja la wastani:
\[ PHEP(h)= \frac{1}{N_h} \sum_{i=1}^{N_h} \left| \frac{y_{i,h}-\hat{y}_{i,h}}{y_{i,h}} \right| \times100 \]
Kielelezo 11 kinaeleza kwamba modeli nyingi huonyesha ongezeko mbili tofauti za kosa zinapokaribia hitilafu, huku Prophet ikionyesha wasifu wa kosa ulio tambarare zaidi. Chanzo kinatafsiri vilele hivi viwili kwanza kama hatua ya mpito ambapo regime ya uharibifu inaanza kubadilika, na baadaye kama hatua muhimu, isiyo ya mstari zaidi na isiyo thabiti karibu sana na hitilafu.
Kwa kuwa thamani za pointi za grafu ya PHEP hazijatolewa katika matini kuu kama jedwali, hakuna nambari za makadirio zilizotolewa kutoka kwenye grafu ndani ya Verianla Live.
Matrix ya hatari inaundwaje?
Katika utafiti, usahihi wa utabiri umegawanywa katika makundi matatu ya kiutendaji: zaidi ya %95 ni juu, %80–95 ni kati na chini ya %80 ni chini. Waandishi wanasema wazi kwamba mipaka hii ni uainishaji wa kulinganisha unaotegemea uzoefu wa meneja wa mali na si kiwango cha ulimwengu wote kwa matumizi yote ya RUL.
Ukali wa matokeo unachukuliwa kuwa chini siku 30 kabla, wa kati siku 10 kabla na juu siku 3 kabla. Katika Dataset 1, hakuna modeli iliyofikia daraja la usahihi wa juu au wa kati siku 30 kabla. Katika upeo mfupi, ARIMA, GRU na Prophet ziliingia eneo la usahihi wa kati, huku LSTM na PatchTST zikibaki katika eneo la usahihi wa chini.
Katika Dataset 2, katika upeo mfupi ARIMA %98,25, GRU %95,18, LSTM %95,14 na Prophet %96,76 zilikuwa katika daraja la usahihi wa juu, huku PatchTST ikiwa katika daraja la chini kwa %30,29.
Je, “uwezekano wa utabiri usio sahihi” kweli ni probability?
Ili kuendeleza zaidi mbinu ya hatari, chanzo kinaconceptualize uwezekano wa utabiri usio sahihi kama function ya vipengele vya accuracy, R², Shape-RMSE na PHEP:
\[ P_{wrong}=f(E_{acc},E_{R^2},E_{ShapeRMSE},E_{PHEP}) \]
Kisha inapendekezwa composite unreliability index ya takriban:
\[ P_{wrong}\approx w_1E_{acc}+w_2E_{R^2}+w_3E_{SSS}+w_4E_{PHEP} \]
\[ \sum_{i=1}^{4}w_i=1 \]
Formula hii si probability ya takwimu ya hitilafu iliyokalibishwa. Chanzo pia kinaeleza kwamba ni vigumu kuhesabu moja kwa moja uwezekano halisi wa utabiri usio sahihi na kwamba hapa unakadiriwa kwa composite predictive unreliability index. Aidha, kipengele cha tatu kilichoandikwa `EShapeRMSE` katika equation ya kwanza hubadilika bila maelezo kuwa `ESSS` katika equation inayofuata; huu ni kutokuwiana kwa notation ndani ya chanzo. Hakuna pia nambari za weights za ulimwengu wote au zilizothibitishwa kwa majaribio katika utafiti huu.
Mchakato wa mwisho uliopendekezwa wa tathmini ya modeli
Verianla Live: Mtiririko wa tathmini uliopendekezwa kabla ya kupeleka modeli ya utabiri wa RUL
Mtiririko unafupisha mantiki kuu ya tathmini ya Kielelezo 13 cha chanzo. Huu si utaratibu wa lazima uliothibitishwa kama kiwango cha uwanjani, bali ni mfumo wa tathmini uliopendekezwa na watafiti.
| Hatua | Maelezo | Chanzo |
|---|---|---|
| 1. Seed thabiti, upeo mmoja | Modeli inafundishwa; kosa, R², kufanana kwa mkunjo/umbo na utendaji wa msingi hutathminiwa. | Kielelezo 13 — Stage 1 FSSH |
| 2. Seed ya nasibu, upeo mmoja | Modeli inaendeshwa mara kadhaa ili kukagua takwimu za utendaji na uaminifu katika upeo mmoja. | Kielelezo 13 — Stage 2 RSSH |
| 3. Seed ya nasibu, upeo nyingi | Modeli hutathminiwa mara kwa mara katika upeo kadhaa za utabiri. | Kielelezo 13 — Stage 3 RSMH |
| 4. Utendaji wa jumla wa modeli | Matokeo ya vipimo vingi na upeo nyingi hulinganishwa na modeli nyingine. | Kielelezo 13 |
| 5. Jaribio la seti nyingi za data | Ikihitajika, utendaji hujaribiwa katika seti mpya za data, runs nyingi na upeo nyingi. | Kielelezo 13 — Stage 4 |
| 6. Idhini | Ikiwa modeli inakidhi mahitaji yaliyowekwa ya utendaji na uaminifu, inachukuliwa kuwa inafaa kwa matumizi. | Kielelezo 13 |
Mapungufu muhimu zaidi ya kimetodolojia ya utafiti
Kwa sababu upeo wa utabiri na kiasi cha data ya mafunzo hubadilika pamoja katika muundo wa jaribio, athari huru ya upeo haijatengwa. Seti ya kwanza ya data hutoa historia yenye kikomo ya siku 50 pekee, na waandishi wa chanzo wanasisitiza kwamba utabiri wa karibu tambarare unaoonekana katika LSTM, GRU na modeli zinazofanana na Transformer unaweza kutokana na data na optimization isiyotosha. Kwa hiyo, jaribio haliungi mkono hitimisho kwamba “miundo ya takwimu kwa ujumla ni bora kuliko deep learning”.
Katika majedwali makuu ya modeli hakuna confidence intervals au tests zinazoonyesha statistical significance ya rankings za modeli. Ingawa utafiti unachunguza sensitivity ya dirisha la mafunzo, hauonyeshi kwamba random-seed reliability tests zote katika mtiririko uliopendekezwa wa Kielelezo 13 zilitumika kwa upeo uleule katika comparisons kuu.
Matrix ya hatari inaunganisha moja kwa moja ukali wa matokeo na madirisha ya siku 30, 10 na 3; uainishaji huu si universal katika uwanja mzima. Vivyo hivyo, thresholds za usahihi wa %95 na %80 zinategemea maoni ya kiutendaji ya wataalamu. Hatari halisi ya kifaa inapaswa kurekebishwa upya kulingana na variables mahsusi za mali kama matokeo ya usalama, hasara ya uzalishaji, gharama ya matengenezo, athari ya mazingira, muda wa vipuri na gharama ya matengenezo ya mapema yasiyo sahihi.
Uwezekano uliopendekezwa wa utabiri usio sahihi bado si modeli ya probability iliyokalibishwa na weights zake hazijathibitishwa kwa kiasi na utafiti. Sehemu ya hitimisho pia inasema wazi kwamba uncertainty quantification haijaunganishwa kikamilifu katika utafiti wa sasa na imepangwa kama kazi ya baadaye.
Seti mbili tu za data zilitumika, na zote mbili zinategemea data za mtetemo wa bearing. Ingawa Dataset 1 inawakilisha hali halisi za turbine ya upepo na Dataset 2 jaribio la run-to-failure linalodhibitiwa, matokeo hayajathibitishwa moja kwa moja katika madaraja mengine ya vifaa.
Chanzo pia kina tofauti ya kiongozi wa upeo wa kati wa Dataset 2 kati ya maelezo na Jedwali 8, kutokuwiana kwa references za repository za data, mabadiliko ya alama `EShapeRMSE`/`ESSS`, istilahi za PatchTST/PatchTST-inspired na kutolingana kikamilifu kwa matokeo ya Shape-RMSE ya upeo mfupi na tathmini ya kuona ya waandishi. Hoja hizi hazifuti ujumbe mkuu wa makala, lakini zinapaswa kuzingatiwa kwa upande wa reproducibility na ukomavu wa vipimo.
Maelezo ya Chanzo na Mbinu
| Jina kamili la utafiti asilia | Evaluating RUL Predictive Models: A Risk-Based Predictive Maintenance Approach |
|---|---|
| Waandishi | Idriss El-Thalji; Ali Usman; Waqar Ali |
| Mpangilio wa waandishi | 1. Idriss El-Thalji; 2. Ali Usman; 3. Waqar Ali |
| Mchango sawa / mwandishi wa kwanza sawa | Hakuna taarifa ya mwandishi wa kwanza sawa au mchango sawa iliyotolewa katika utafiti chanzi. |
| Mwandishi wa mawasiliano | Idriss El-Thalji |
| Taasisi | Department of Engineering Management, Prince Sultan University, Riyadh, Saudi Arabia; Department of Mechanical and Structural Engineering and Materials Science, University of Stavanger, Stavanger, Norway. |
| Aina ya chanzo | Makala ya utafiti inayolinganishwa modeli za utabiri wa RUL katika seti mbili wazi za data za mtetemo na kupendekeza mfumo wa tathmini ya modeli unaotegemea hatari. |
| Hali ya mapitio | Ni makala ya utafiti iliyochapishwa katika jarida lililopitiwa na rika; si preprint. |
| Jarida | AI |
| Mchapishaji | MDPI |
| Juzuu / toleo / makala | 2026, 7(5), 169 |
| DOI | 10.3390/ai7050169 |
| Tarehe ya kupokelewa | 2 Machi 2026 |
| Tarehe ya marekebisho | 10 Mei 2026 |
| Tarehe ya kukubaliwa | 12 Mei 2026 |
| Tarehe ya kuchapishwa | 14 Mei 2026 |
| Kiungo rasmi | https://doi.org/10.3390/ai7050169 |
| Leseni | Creative Commons Attribution (CC BY). |
Ufadhili, maadili na mgongano wa maslahi
Waandishi wameripoti kwamba utafiti haukupokea ufadhili wa nje. Sehemu za Institutional Review Board na informed consent zimewekwa kuwa “hazitumiki”. Waandishi wametangaza kwamba hakuna mgongano wa maslahi.
Upatikanaji wa data
Utafiti chanzi unasema kwamba seti mbili kuu za data zilitoka kwenye repositories wazi. Seti ya kwanza ni data ya prognosis ya high-speed bearing ya turbine ya upepo, na ya pili ni IMS bearing run-to-failure dataset. Hata hivyo, kwa kuwa maelezo ya repository katika matini kuu hayalingani kabisa na destinations za references [46] na [47], repository asilia na toleo la data vinapaswa kukaguliwa kando katika reproducibility huru.
Michango ya waandishi
Idriss El-Thalji, Ali Usman na Waqar Ali walichangia conceptualization, software, validation, formal analysis, investigation, data curation, first draft, review na visualization. Methodology ilifanywa na Idriss El-Thalji na Ali Usman. Resources, supervision, project administration na funding acquisition zilifanywa na Idriss El-Thalji.
Rekodi muhimu kwa uaminifu kwa chanzo
Katika matini chanzi inaelezwa kwamba Prophet ndiyo modeli bora katika upeo wa kati wa Dataset 2; lakini Jedwali 8 linaonyesha %82,04 kwa ARIMA na %81,03 kwa Prophet. Katika matini ya Verianla, thamani za jedwali zimehifadhiwa bila kubadilishwa na kutokuwiana kwa maelezo–jedwali kumeainishwa wazi.
Chanzo kinafafanua modeli katika Jedwali 1 kama “PatchTST-inspired”, huku sehemu za matokeo zikitumia jina “PatchTST”. Kwa hiyo, matokeo hayajawasilishwa kama benchmark huru na kamili ya canonical PatchTST architecture.
Shape-RMSE katika upeo mfupi ni 0,0540 kwa PatchTST na 0,0681 kwa Prophet. Kwa kipimo cha kihisabati PatchTST inaonekana bora, lakini ukaguzi wa kuona wa waandishi wa chanzo unasema Prophet hufuata mkunjo halisi wa uharibifu vizuri zaidi. Chanzo chenyewe kinasema hii inaonyesha kwamba katika madirisha mafupi sana Shape-RMSE peke yake inaweza kuwa haitoshi.
Katika composite formula ya hatari ya utabiri usio sahihi, `EShapeRMSE` inatumika katika uwasilishaji wa kwanza, na katika equation inayofuata `ESSS` inatumika bila kufafanuliwa. Aidha, experimental calibration ya weights kwa composite index hii na validation dhidi ya uwezekano halisi wa utabiri usio sahihi hazijafanywa katika utafiti wa sasa.
Tafsiri salama zaidi ya matokeo ni kwamba kufaa kwa modeli ya RUL kwa matengenezo hakupaswi kutathminiwa kwa metric moja ya kosa au upeo mmoja wa muda pekee. Ingawa utafiti unaonyesha mbinu hii katika seti mbili za data za bearing, mfumo wa hatari uliopendekezwa unahitaji kuthibitishwa kwa upana zaidi kwa classes tofauti za mali, seti huru za data na uncertainty quantification.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *