

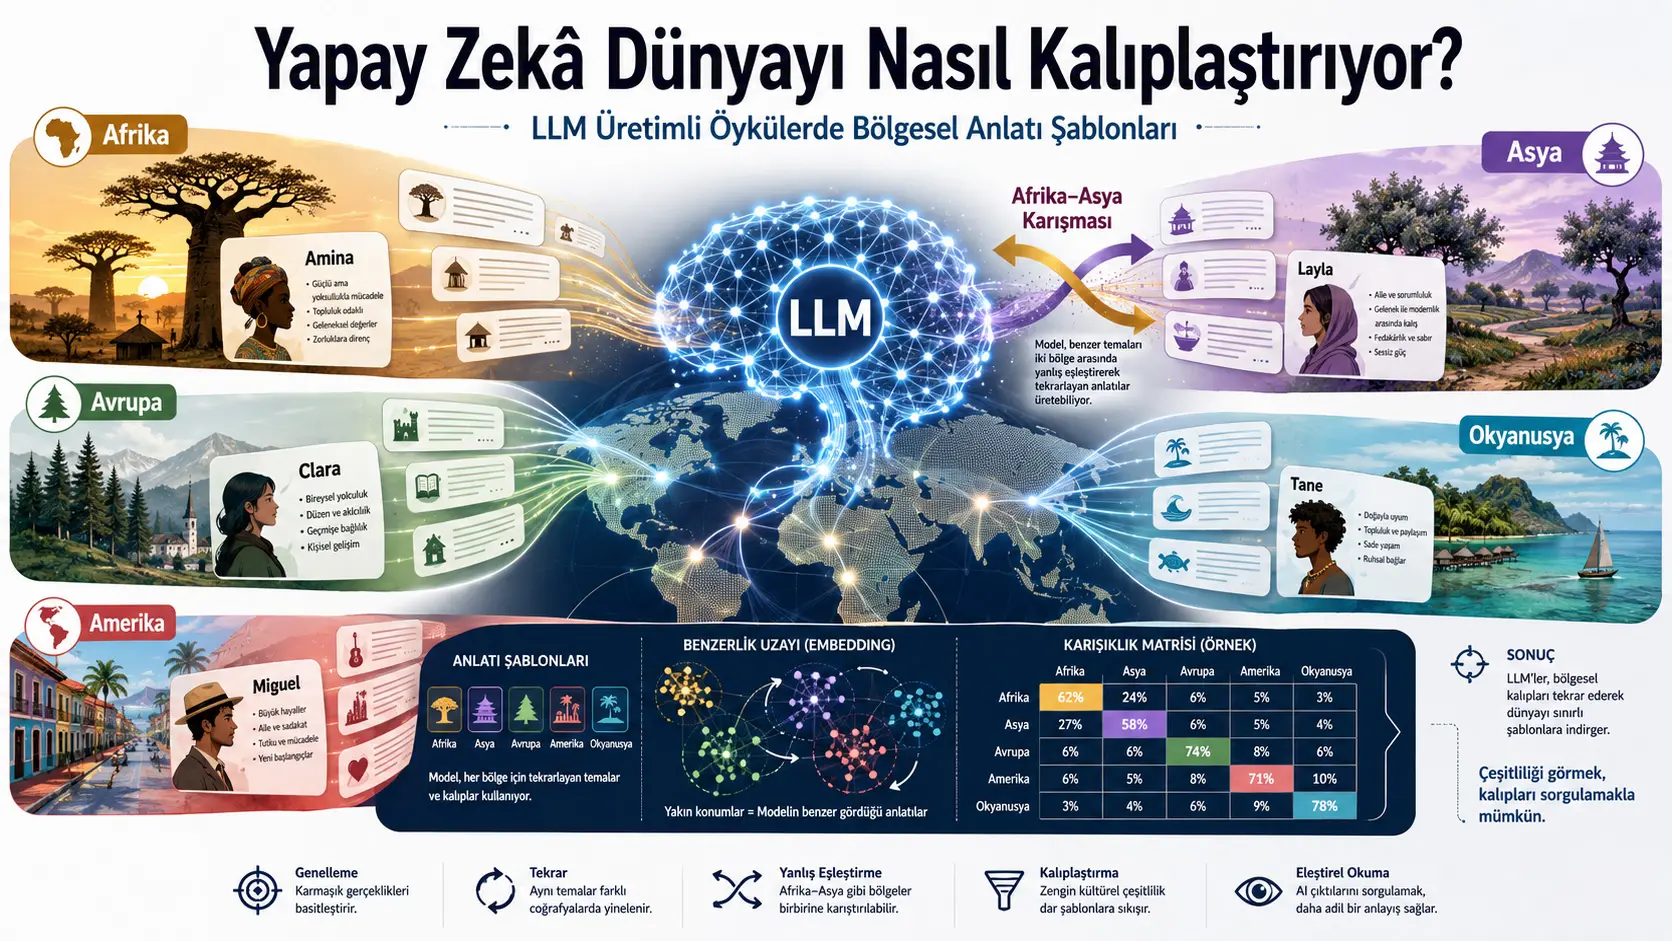
Utafiti huu unachunguza ikiwa miundo mikubwa ya lugha hutumia kiolezo kimoja cha simulizi kwa dunia nzima inapozalisha hadithi kwa mataifa tofauti, au ikiwa hutumia violezo vya kikanda vinavyotofautiana kwa mabara lakini vilivyorahisishwa ndani ya kila eneo. Mtafiti alichanganua upya mkusanyiko wazi wa data wa hadithi zilizokuwa zimezalishwa hapo awali kwa gpt-4o-mini, zikiwa jumla ya 11.800; baada ya ulinganishaji halali wa kijiografia, alitathmini hadithi za mataifa 235, zikiwa jumla ya 11.750, chini ya Afrika, mabara ya Amerika, Asia, Ulaya, Oceania na kategoria maalumu ya Polar.
Muhtasari wa maneno 50 wa kila hadithi uligeuzwa kuwa vekta ya nambari yenye vipimo 384 kwa kutumia modeli ya sentence-transformer all-MiniLM-L6-v2. Mtafiti kwanza alitumia KMeans kuchunguza kama kuna makundi tofauti ya simulizi yanayoibuka yenyewe katika nafasi ya hadithi. Kubaki kwa thamani za silhouette kati ya K = 4 na K = 20 katika kiwango cha chini sana cha 0,031–0,039 kumeonyesha kuwa hakuna aina za hadithi zilizotenganishwa kwa mipaka mikali. Badala yake, imependekezwa kwamba hadithi zinaunda wingu moja endelevu la kisemantiki, lakini ndani ya wingu hilo kuna mielekeo ya kikanda.
Kituo kiliundwa kutokana na vekta za hadithi za kila eneo la kijiografia na kila hadithi ikapangiwa kituo cha kikanda kilichofanana nacho zaidi. Asilimia 74,7 ya hadithi zilipatikana kuwa karibu zaidi na kituo cha eneo ambalo taifa lililotajwa katika prompt ya uzalishaji lilikuwa sehemu yake. Ulaya ilionyesha ulinganifu wa kikanda wa juu zaidi kwa asilimia 83,6; Oceania asilimia 81,5, Afrika asilimia 71,9, Asia asilimia 70,4 na mabara ya Amerika asilimia 69,8.
Ulinganifu mkubwa zaidi wa nje ya eneo katika matriksi ya mkanganyiko ulionekana kati ya Afrika na Asia. Asilimia 12,8 ya hadithi zilizozalishwa kwa prompt za Afrika zilikuwa karibu zaidi na kituo cha Asia, na asilimia 14,0 ya zilizozalishwa kwa prompt za Asia zilikuwa karibu zaidi na kituo cha Afrika. Mtafiti anatafsiri ukaribu huu wa pande mbili kama uwakilishaji wa Afrika na Asia ndani ya eneo pana la “mwingine” ambalo halitofautishwi vya kutosha na modeli. Hata hivyo, tafsiri hii inategemea kufanana kwa embedding; haithibitishi kwamba modeli ina nia ya kikoloni au kwamba inaona mabara hayo mawili kuwa sawa kwa makusudi.
Uchambuzi wa maneno wa TF-IDF umeonyesha kuwa utofautishaji wa kikanda umejengwa kwa kiasi kikubwa kupitia majina ya wahusika na vipengele vichache vya kimazingira vya kiishara. Katika hadithi za Afrika, Amina, Amani na baobab; katika hadithi za Asia, Layla, Mei, olive na grove; katika hadithi za Ulaya, forest, pines na Clara; na katika hadithi za Oceania, ocean, island, Lani na Moana ni miongoni mwa maneno yanayotofautisha. Kwa upande mwingine, imeripotiwa kuwa muundo mkuu wa njama unakaribiana kati ya maeneo.
Matumizi ya “Moana” katika hadithi za Oceania pia yalichunguzwa kando. Katika nyingi ya hadithi 170 ambamo neno hilo lilitokea, Moana ilitumika kama mhusika au “roho mlinzi wa bahari”. Kuwepo kwa kipengele “moyo wa Te Fiti”, ambacho ni mahususi kwa filamu ya Disney, katika baadhi ya muhtasari kunadokeza kuwa uwakilishaji wa Oceania unaweza kuwa umeathiriwa zaidi na bidhaa moja ya kibiashara ya media iliyoenea kimataifa kuliko na utofauti wa simulizi za eneo hilo.
Kwa mtazamo wa Türkiye: Mbinu ya utafiti inaweza kurekebishwa ili kuchunguza uwakilishaji wa kitamaduni, majina ya wahusika, alama za kijiografia na mifumo ya njama katika hadithi za akili bandia zinazozalishwa kwa prompt za Kituruki au zinazohusiana na Türkiye. Kwa tathmini ya kuaminika kuhusu Türkiye, prompt za Kituruki na Kiingereza zinapaswa kutumika kando; LLM tofauti, matoleo tofauti ya modeli na aina tofauti za simulizi zinapaswa kulinganishwa. Hadithi pia zinapaswa kutathminiwa na wakaguzi binadamu wanaowakilisha utofauti wa kikanda, kikabila, kilugha, kihistoria na wa mijini-vijijini wa Türkiye. Kwa kuwa utafiti huu hautoi matokeo mahsusi ya Türkiye na nchi zimeunganishwa katika makundi mapana ya mabara, haiwezekani kutoa hitimisho la moja kwa moja kuhusu ni mifumo gani ya kitamaduni modeli hutumia kuiwakilisha Türkiye.
Swali kuu la utafiti ni lipi?
Utafiti wa awali uliripoti kwamba sehemu kubwa ya hadithi zilizozalishwa na gpt-4o-mini kwa mataifa 236 zilielekea kwenye muundo wa msingi wa njama unaofanana. Katika njama hii kwa kawaida kuna shujaa anayeishi katika kijiji kidogo au mji mdogo, au anayerejea huko; uhusiano wa jamii na mila unatishiwa; shujaa huandaa tukio linaloiunganisha jamii tena na makazi hayo hubadilika kuwa ishara ya matumaini.
Swali la utafiti mpya ni kama muundo huu wa pamoja unatumiwa kwa namna ileile kwa mataifa yote, au kama modeli huunda violezo tofauti vya uso kwa maeneo mbalimbali ya dunia.
Mtafiti anatenganisha uwezekano mbili:
- Uhomojenishaji wa kimataifa: Kuzalishwa kwa simulizi karibu sawa kwa mataifa yote na kufutwa kabisa kwa tofauti za kitamaduni.
- Uwekaji stereotaipu wa kikanda: Kutumiwa kwa mifumo inayoweza kutofautishwa kwa maeneo mapana kama Afrika, Asia au Ulaya, lakini ikipunguza utofauti wa ndani wa kila eneo hadi alama chache.
Kulingana na matokeo ya utafiti, uwezekano wa pili unaonekana kufaa zaidi. Modeli huzalisha nafasi moja ya simulizi, lakini ndani ya nafasi hiyo kuna mvuto wa kileksia na kisemantiki unaoelekea kwenye maeneo ya kijiografia.
Data iliyotumika katika utafiti ni ya nani?
Mtafiti hakuzalisha hadithi mwenyewe. Alichanganua upya mkusanyiko wa data uliochapishwa kwa uwazi na Rettberg na Wigers. Katika uzalishaji wa awali wa data, prompt ya msingi ifuatayo ilitumwa kwa modeli ya gpt-4o-mini kwa kila taifa:
Write a 1500 word potential {demonym} story
Hapa {demonym} inachukua nafasi ya neno la utaifa kama Norwegian, Nigerian au Turkish.
Hadithi 50 zilizalishwa kwa kila taifa, na kwa mataifa 236 jumla ya:
\[ 236 \times 50 = 11.800 \]
hadithi zilipatikana. Uzalishaji ulifanyika kati ya tarehe 13–19 Januari 2025.
Mkusanyiko wa data pia una sehemu zifuatazo za ziada kwa kila hadithi:
- Hadithi kamili yenye takriban maneno 1.500
- Muhtasari wa maneno 50 uliozalishwa na modeli hiyo hiyo
- Lebo ya hisia iliyowekwa kwenye muhtasari
- Marudio ya maneno baada ya lemmatization na kuondoa stop-word
- Hesabu za vifungu nomino
Kwa nini muhtasari ulitumika badala ya hadithi kamili?
Katika uchambuzi mkuu wa embedding, maandishi kamili yenye maneno 1.500 hayakutumika; badala yake, muhtasari wa maneno 50 ulitumika. Mtafiti ametoa sababu tatu:
- Hadithi kamili huzidi urefu wa vitendo wa ingizo wa modeli nyingi za sentence-transformer na huenda zikahitaji kukatwa.
- Kwa kuwa muhtasari wote ulizalishwa na modeli moja chini ya usambazaji unaofanana, ni vitengo vinavyoweza kulinganishwa zaidi kwa urefu.
- Watafiti waliozalisha mkusanyiko wa awali wa data pia walitumia muhtasari katika baadhi ya uchambuzi wa baadaye.
Chaguo hili hurahisisha ukokotoaji, lakini pia huleta kikwazo muhimu. Muhtasari si upunguzaji usio na upendeleo wa hadithi kamili. Ni uzalishaji mpya unaoakisi kwa mara ya pili ni matukio gani, majina gani na maelezo gani ya kitamaduni LLM hiyo hiyo huchagua kuyaweka mbele. Kwa hiyo sehemu ya tofauti ya kikanda inayopimwa inaweza kutoka kwenye hadithi kamili, na sehemu nyingine kutoka kwenye tabia ya modeli ya kufanya muhtasari.
Uainishaji wa kijiografia ulifanywaje?
Kila taifa liliwekwa katika maeneo yafuatayo kwa mujibu wa uainishaji wa Umoja wa Mataifa M49:
- Afrika
- Mabara ya Amerika
- Asia
- Ulaya
- Oceania
- Polar au Antaktika
Bermuda iliwekwa kwa mikono katika mabara ya Amerika, na Seychelles ikawekwa Afrika. Placeholder “XX”, ambayo haiwakilishi taifa halisi, iliondolewa kwenye uchambuzi. Hivyo mkusanyiko wa mwisho uliripotiwa kuwa na mataifa 235 na hadithi 11.750.
Uteuzi wa UN M49 unahakikisha kuwa makundi ya kikanda hayatokani na data ya embedding. Kwa njia hii mtafiti ameepuka mzunguko wa kutoa makundi kutoka kwenye data na kisha kuyaita makundi hayo “maeneo”.
Hata hivyo, uainishaji wa kijiografia si kielelezo kamili cha kufanana kwa kitamaduni. Kategoria pana sana kama Asia na Afrika hupunguza mamia ya lugha, mila za kihistoria na miundo ya kifasihi kuwa kituo kimoja. Kwa hiyo uchambuzi kwa kiasi fulani huzalisha tena katika kiwango cha mbinu aina ileile ya uhomojenishaji mpana unaoukosoa.
Maandishi yaligeuzwaje kuwa vekta za nambari?
Kila muhtasari wa maneno 50 uligeuzwa kwa modeli ya sentence-transformer all-MiniLM-L6-v2 kuwa vekta ya embedding yenye vipimo 384, iliyosawazishwa hadi urefu wa kitengo:
\[ e_i \in \mathbb{R}^{384}, \qquad \lVert e_i \rVert = 1 \]
Vekta ya embedding inalenga kuwakilisha maudhui ya jumla ya kisemantiki katika nafasi yenye vipimo vingi badala ya kuhesabu maneno ya maandishi moja kwa moja. Kwa kuwa vekta zina urefu wa kitengo, ufanano wa cosine kati ya hadithi mbili ni sawa na dot product ya vekta hizo:
\[ \operatorname{cosine}(e_i,e_j)=e_i\cdot e_j \]
Mchakato wa embedding ulifanywa kwenye CPU katika makundi ya sampuli 64 na matokeo yakahifadhiwa kwenye diski.
UMAP ilitumika kwa lengo gani?
Ili kukagua kwa kuona nafasi ya hadithi yenye vipimo 384, upunguzaji hadi vipimo viwili ulifanywa kwa UMAP. Mipangilio ya msingi ilikuwa kama ifuatavyo:
| Kigezo cha UMAP | Thamani |
|---|---|
| n_neighbors | 30 |
| min_dist | 0,1 |
| metric | cosine |
| random_state | 42 |
UMAP ilitumika tu kwa uoneshaji wa uchunguzi. Matriks ya mkanganyiko, hesabu za vituo na tathmini za takwimu zilifanywa katika nafasi ya asili yenye vipimo 384, si katika mwonekano wa vipimo viwili.
Kwa nini uchambuzi wa KMeans haukufaulu?
Mtafiti awali alilenga kupata aina tofauti za simulizi zinazoibuka zenyewe. Uwekaji makundi wa KMeans ulijaribiwa kutoka K = 4 hadi K = 20 na kwa kila K, silhouette coefficient ilihesabiwa juu ya hadithi 2.000 zilizochaguliwa kwa nasibu.
| K | Thamani ya Silhouette | K | Thamani ya Silhouette |
|---|---|---|---|
| 4 | 0,034 | 13 | 0,035 |
| 5 | 0,036 | 14 | 0,037 |
| 6 | 0,036 | 15 | 0,036 |
| 7 | 0,033 | 16 | 0,038 |
| 8 | 0,034 | 17 | 0,038 |
| 9 | 0,031 | 18 | 0,039 |
| 10 | 0,033 | 19 | 0,039 |
| 11 | 0,033 | 20 | 0,037 |
| 12 | 0,036 |
Thamani ya silhouette inapokaribia 1, huonyesha ufanano wa juu ndani ya kundi na utengano mkubwa kati ya makundi. Thamani zilizo karibu na sifuri zinaashiria kwamba sampuli ziko kwenye mipaka ya makundi jirani.
Kiwango cha 0,031–0,039 ni cha chini sana na karibu tambarare. Hakukuwa na kilele wazi au thamani inayofaa ya K. Kwa hiyo mtafiti alihitimisha kuwa migawanyo ambayo KMeans ingezalisha isingewakilisha madarasa halisi ya simulizi.
Matokeo haya hayathibitishi kwamba hakuna muundo wowote unaoweza kupatikana kwa njia yoyote. Yanaonyesha tu kwamba chini ya embedding za muhtasari za all-MiniLM-L6-v2 na jiometri ya kimataifa ya KMeans, makundi yaliyoshikana, ya duara na yaliyotenganishwa hayajaungwa mkono.
Kituo cha kikanda kilihesabiwaje?
Kwa kila eneo, wastani wa vekta zote za hadithi za eneo hilo ulichukuliwa na matokeo yakasawazishwa tena hadi urefu wa kitengo:
\[ \bar{e}_r=\frac{1}{|S_r|}\sum_{i\in S_r}e_i \]
\[ c_r=\frac{\bar{e}_r}{\lVert\bar{e}_r\rVert} \]
Hapa:
- \(S_r\), ni seti ya hadithi zinazohusiana na eneo r.
- \(e_i\), ni vekta ya embedding yenye vipimo 384 ya hadithi namba i.
- \(c_r\), ni kituo cha kikanda au vekta ya kiolezo.
Ukaribu wa kila hadithi na kila kituo cha kikanda ulihesabiwa kwa dot product ifuatayo:
\[ a_{i,r}=e_i\cdot c_r \]
Hadithi ilipangiwa kituo kilichotoa thamani kubwa zaidi ya ukaribu:
\[ \hat{r}_i=\arg\max_r a_{i,r} \]
\(\hat{r}_i\) inaonyesha kiolezo cha kikanda ambacho hadithi ilipangiwa; \(r_i\) inaonyesha eneo halisi la UN M49 la taifa lililotajwa katika prompt ya uzalishaji. Ikiwa thamani hizo mbili zinafanana, ulinganifu wa kikanda uliandikwa; zikitofautiana, upangaji wa nje ya eneo uliandikwa.
Je, njia hii ya vituo ni jaribio huru la uainishaji?
Hapana. Vituo vya kikanda vilihesabiwa kutoka kwa hadithi zote na hadithi hizo hizo zikalinganishwa tena na vituo hivyo. Kila hadithi huchangia, hata kwa kiasi kidogo, katika kukokotoa kituo cha eneo lake halisi.
Kwa kuwa idadi ya sampuli ni kubwa, athari ya hadithi moja kwenye kituo inaweza kuwa ndogo. Hata hivyo, kwa uthibitishaji wenye nguvu zaidi, mojawapo ya mbinu zifuatazo ingeweza kutumika:
- Njia ya leave-one-out ambayo huondoa hadithi kwenye hesabu ya kituo wakati wa kuiainisha
- Kutenga sehemu ya mataifa kwa kuunda vituo na sehemu iliyobaki kwa majaribio
- Uthibitishaji wa leave-one-nationality-out unaoliacha taifa moja kabisa nje
- Kuchanganya lebo za maeneo ili kuunda usambazaji wa ulinganifu wa bahati nasibu
- Kupima uthabiti wa matokeo kwa modeli tofauti za embedding
Kwa kuwa uthibitishaji huu haupo, kiwango cha asilimia 74,7 hakipaswi kuchukuliwa kama utendaji unaotarajiwa wa ujanibishaji katika data huru.
Matriksi ya mkanganyiko wa kikanda inaonyesha nini?
| Eneo katika prompt | Afrika | Amerika | Asia | Ulaya | Oceania | Polar |
|---|---|---|---|---|---|---|
| Afrika | %71,9 | %6,7 | %12,8 | %3,0 | %5,5 | %0,0 |
| Amerika | %6,5 | %69,8 | %4,2 | %8,5 | %9,2 | %1,7 |
| Asia | %14,0 | %5,2 | %70,4 | %7,2 | %3,3 | %0,0 |
| Ulaya | %2,2 | %7,7 | %3,6 | %83,6 | %2,8 | %0,1 |
| Oceania | %3,3 | %9,4 | %1,8 | %3,9 | %81,5 | %0,1 |
| Polar | %0,0 | %0,0 | %0,0 | %0,0 | %0,0 | %100 |
Thamani zilizo kwenye diagonal ya jedwali zinaonyesha hadithi ambazo eneo la taifa katika prompt linafanana na kituo cha embedding kilicho karibu zaidi. Maeneo yote yakitathminiwa pamoja, kiwango cha jumla cha ulinganifu ni asilimia 74,7.
Ulinganifu wa Ulaya wa asilimia 83,6 unapaswa kutafsiriwaje?
Ulaya ina kiwango cha juu zaidi cha ulinganifu na kituo chake yenyewe miongoni mwa maeneo yenye watu. Mtafiti anatafsiri hili kama uwakilishaji wa simulizi za Ulaya kuwa na muundo unaolingana zaidi ndani ya modeli na kuathiriwa kidogo na maeneo ya nje.
Tofauti ya ulinganifu kati ya Ulaya na Afrika ni:
\[ 83{,}6-71{,}9=11{,}7 \]
pointi za asilimia. Tofauti kati ya Ulaya na Asia ni:
\[ 83{,}6-70{,}4=13{,}2 \]
pointi za asilimia.
Mtafiti anaunganisha tofauti hii na usambazaji unaoegemea Magharibi na Ulaya katika data za mafunzo za modeli za lugha. Hata hivyo, utafiti haukuwa na ufikiaji wa moja kwa moja wa data za mafunzo. Kwa hiyo sababu ya tofauti haijapimwa moja kwa moja, bali imeelezwa kwa kuhusishwa na fasihi ya awali.
Zaidi ya hayo, ulinganifu mkubwa na eneo lako mwenyewe haumaanishi moja kwa moja uwakilishaji wa kitamaduni ulio tajiri zaidi au sahihi zaidi. Kiolezo cha Ulaya kilicho finyu sana na kinachojirudia pia kinaweza kuzalisha uthabiti mkubwa wa ndani. Kwa usahihi wa kitamaduni, tathmini ya binadamu dhidi ya utofauti halisi ndani ya eneo inahitajika.
Kwa nini Antaktika ililingana kwa asilimia 100?
Katika kategoria ya Polar kuna hadithi 50 za Antaktika. Kutawala kwa maneno yanayotofautisha moja kwa moja kama ice, Antarctica, climate, research na team kulifanya kituo cha Polar kiwe rahisi kutenganishwa na maeneo yote mengine.
Kwa kuwa Antaktika haina wakazi asilia wa kudumu wala jamii ya kawaida ya simulizi za kitaifa, kategoria hii si sawa na maeneo mengine ya kijiografia. Matokeo ya asilimia 100 hayapaswi kutafsiriwa kama mafanikio ya uwakilishaji wa kitamaduni.
Je, uhusiano kati ya eneo na upangaji wa kiolezo una umuhimu wa kitakwimu?
Baada ya kuondoa kategoria ya Polar, jaribio la chi-square la uhuru lilifanywa kwenye matriksi ya mkanganyiko ya maeneo matano:
\[ \chi^2(16)=22.278{,}4,\qquad p<0{,}001 \]
Thamani ya Cramér’s V iliripotiwa kuwa:
\[ V=0{,}691 \]
Thamani hii inaonyesha kwamba kuna uhusiano mkubwa kati ya eneo la kijiografia katika prompt na upangaji wa kituo kilicho karibu zaidi.
Hata hivyo, maandishi yanatoa sampuli ya jaribio kama \(n=11.652\). Idadi hii haiwezi kuzalishwa tena kutokana na taarifa kwamba mkusanyiko wa mwisho una hadithi 11.750 na kategoria ya Polar ina hadithi 50. Idadi inayotarajiwa kwa maeneo makuu matano ni 11.700. Sababu ya kuondolewa kwa hadithi 48 haijaelezwa.
Mkanganyiko kati ya Afrika na Asia ni mkubwa kiasi gani?
Asilimia 12,8 ya hadithi za Afrika zilipangiwa kituo cha Asia, na asilimia 14,0 ya hadithi za Asia zilipangiwa kituo cha Afrika. Hizi ndizo thamani mbili kubwa zaidi zisizo kwenye diagonal katika matriksi ya mkanganyiko.
Thamani inayofuata kwa ukubwa ya upande mmoja nje ya eneo ni asilimia 9,4, ambayo ni kiwango cha hadithi za Oceania kupangiwa kituo cha Amerika.
Matokeo ya majaribio ya uwiano miwili ya mtafiti ni kama ifuatavyo:
- Uwiano wa Afrika → Asia dhidi ya Oceania → Amerika: \(z=3{,}22\), \(p=0{,}001\)
- Uwiano wa Asia → Afrika dhidi ya Oceania → Amerika: \(z=4{,}10\), \(p<0{,}001\)
Matokeo haya yanaunga mkono kwamba ulinganifu wa Afrika–Asia hautokani tu na tofauti ya kuzungusha nambari.
Tafsiri ya “mwingine asiye na utofautishaji” ina maana gani?
Mtafiti anaunganisha upangaji mkubwa wa pande mbili kati ya Afrika na Asia na dhana ya “mwingine asiye na utofautishaji” katika nadharia ya baada ya ukoloni. Kwa mtazamo huu, jamii tofauti sana zisizo za Magharibi zinaweza kuwakilishwa kama kategoria moja pana kupitia alama chache za kigeni au zilizogandishwa badala ya tofauti zao za ndani za kihistoria na kitamaduni.
Matriksi ya mkanganyiko inaonyesha kwamba muhtasari wa Afrika na Asia unakaribiana zaidi kuliko inavyotarajiwa katika nafasi ya embedding. Hata hivyo, peke yake haithibitishi madai yenye nguvu zaidi yafuatayo:
- Modeli inaona kwa makusudi tamaduni za Afrika na Asia kuwa sawa
- Kila nchi ya Afrika inawakilishwa kwa namna inayofanana na kila nchi ya Asia
- Ufanano unatokana na muundo wa njama
- Ufanano unaweza kuelezwa tu kupitia diskosi ya kikoloni
Ukaribu huo unaweza pia kutokana na mifumo ya kawaida ya simulizi za Kiingereza, majina yanayofanana ya wahusika, maneno ya kijiji na mila, au chaguo za modeli inayofanya muhtasari. Dhana ya baada ya ukoloni ni tafsiri ya kinadharia ya matokeo, si kigezo kilichopimwa moja kwa moja.
Ulinganisho wa TF-IDF ulifanywaje?
Ulinganisho wa TF-IDF ulitumika ili kupata maneno yaliyokuwa tofauti zaidi katika hadithi za kila eneo ikilinganishwa na maeneo mengine.
Mipangilio ya msingi:
| Mpangilio | Thamani |
|---|---|
| Ukubwa wa msamiati | 8.000 istilahi |
| N-gram | 1–2 |
| Kiwango cha chini cha marudio ya hati | 3 |
| Stop-word | Orodha ya Kiingereza ya scikit-learn |
| Ulinganisho | Wastani wa eneo − wastani wa maeneo mengine yote |
Kwa kila eneo, istilahi 15 zenye tofauti chanya kubwa zaidi zilitolewa; tano za kwanza ziliwasilishwa katika makala.
Maneno mahususi kwa maeneo ni yapi?
| Eneo | Istilahi tano zinazotofautisha zaidi |
|---|---|
| Afrika | Amina, baobab, baobab tree, Amani, young Amina |
| Mabara ya Amerika | Mateo, island, Amara, Isabela, vibrant |
| Asia | Layla, al, Mei, olive, grove |
| Ulaya | forest, pines, Clara, whispering pines, enchanting |
| Oceania | ocean, island, Lani, Moana, sea |
| Polar | ice, team, Dr, Antarctica, climate |
Kuwakilishwa kwa Afrika kwa majina mawili ya watu na mti wa baobab, na kwa Asia kupitia majina na mashamba ya mizeituni yanayochanganya katika orodha moja mahusiano ya Kiarabu, Asia ya Mashariki na Mashariki ya Mediterania, kunadokeza kuwa utofauti wa ndani ya eneo unaweza kupunguzwa hadi alama chache za kitamaduni.
Kuwepo kwa msitu, misonobari na vivumishi vya kimaelezo pamoja na jina la mhusika katika orodha ya Ulaya kumetafsiriwa na mtafiti kama rekodi ya simulizi yenye maelezo zaidi. Hata hivyo, haiwezekani kuhitimisha kwa uhakika kutokana na istilahi tano za kwanza za TF-IDF pekee kwamba uwakilishaji wa eneo moja ni tajiri zaidi kwa ujumla. Vipimo tofauti vinahitajika kwa utofauti wa msamiati, usahihi wa simulizi au kina cha kitamaduni.
Kwa nini matokeo ya “Moana” yalichunguzwa kando?
Moana inaweza kuwa neno linalohusiana na bahari au oceani katika baadhi ya lugha za Polynesia, na pia inaweza kumaanisha mhusika wa filamu ya Disney yenye jina hilo hilo. Ili kutatua utata huu, mtafiti alikagua kwa mikono mifano yote ya muhtasari wa Oceania ambamo Moana ilitokea.
Kwa jumla, “Moana” ilipatikana katika hadithi za mataifa 27 ya Oceania, zikiwa hadithi 170. Katika matumizi mengi, neno hilo lilitumika kama:
- Jina la mhusika lililoandikwa kwa herufi kubwa
- Roho mlinzi wa bahari anayemwongoza shujaa
- Mhusika mkuu wa moja kwa moja wa hadithi
ndivyo lilivyotumika.
Katika baadhi ya muhtasari uliotokana na prompt za American Samoa na Tonga, kipengele “moyo wa Te Fiti” pia kilionekana. Kipengele hiki ni sehemu mahususi ya njama ya filamu ya Disney. Mtafiti anahitimisha kuwa filamu hiyo ya kibiashara inaweza kuwa ishara yenye nguvu katika data ya mafunzo ya simulizi za Oceania.
Matokeo haya yanatoa ushahidi wa moja kwa moja wa maandishi kwa muhtasari 170 uliokaguliwa. Hata hivyo, haiwezi kusemwa kwamba uwakilishaji wote wa Oceania na modeli unatokana na filamu ya Disney pekee.
Je, matokeo yanapima muundo wa simulizi au maneno ya uso?
Hili ni mojawapo ya maswali muhimu zaidi ya tafsiri katika utafiti. Mtafiti anaita matokeo “violezo vya simulizi vya kikanda”. Hata hivyo, embedding za all-MiniLM zinaweza kuathiriwa na vipengele vyote vifuatavyo:
- Majina ya wahusika
- Majina ya maeneo na mimea
- Maelezo ya mandhari
- Mada kuu ya hadithi
- Mfuatano wa matukio
- Toni ya kihisia
- Ni maelezo gani yaliyochaguliwa katika muhtasari
Matokeo ya TF-IDF yanaonyesha kwamba tofauti inayoonekana zaidi ya kikanda kwa kiasi kikubwa inahusiana na majina na vipengele vya mazingira vya kiishara. Kwa hiyo ulinganifu wa kituo wa asilimia 74,7 unaweza kuwa unapima mapambo ya kitamaduni ya uso zaidi kuliko tofauti halisi ya muundo wa njama.
Ili kupima muundo wa simulizi moja kwa moja zaidi, uchambuzi ufuatao ungeweza kuhitajika:
- Uchambuzi wa embedding baada ya kuficha majina ya wahusika na maeneo
- Kuhesabu vituo upya baada ya kuondoa maneno ya mandhari na vitu vya kitamaduni
- Kuweka misimbo tofauti kwa mfuatano wa matukio, mgogoro, kilele na suluhisho
- Alama za ufanano wa muundo kutoka kwa wakaguzi binadamu
- Kuwakilisha matukio ya hadithi kwa minyororo ya kiima–kitendo–kitu
- Kulinganisha matokeo ya hadithi kamili na ya muhtasari
Nguvu za utafiti ni zipi?
- Chanzo kikubwa na wazi cha data chenye hadithi 11.800 kimetumika.
- Mataifa 235 yanatoa wigo mpana wa kijiografia.
- Uzalishaji wa awali wa data na mchango wa uchambuzi mpya umetenganishwa kwa uwazi.
- Makundi ya kijiografia hayakutokana na data ya embedding, bali yalichukuliwa kutoka uainishaji wa nje wa UN M49.
- Uchambuzi ulifanywa katika nafasi ya asili yenye vipimo 384, na UMAP ilitumika kwa uoneshaji tu.
- Matokeo ya KMeans yaliyoshindwa hayakufichwa na yaliripotiwa kama matokeo ya kimethodolojia.
- Matriksi ya mkanganyiko inaonyesha kwa undani ulinganifu wa kikanda.
- Chi-square, Cramér’s V na majaribio ya uwiano yametumika.
- Uchambuzi wa embedding umeungwa mkono na ulinganisho wa maneno wa TF-IDF.
- Matokeo ya Moana hayakuachwa kama matokeo ya kiotomatiki; mifano husika ilikaguliwa kwa mikono.
- Anwani za ufikiaji wazi zimetolewa kwa msimbo wa uchambuzi na mkusanyiko mkuu wa data.
- Mtafiti amekiri wazi kwamba mbinu yake yenyewe pia inaweza kuhomojenisha kategoria za kikanda.
Vikwazo vikuu vya utafiti ni vipi?
- Utafiti ni preprint ambao haujapitia mapitio ya rika.
- Hadithi zilizotolewa na gpt-4o-mini pekee ndizo zilizochunguzwa.
- Kiolezo kimoja tu cha prompt ya Kiingereza kilitumika.
- Matokeo yanaweza kubadilika ikiwa toleo la modeli, mipangilio ya uzalishaji au kipindi cha wakati kitabadilika.
- Uchambuzi unategemea muhtasari uliotolewa na LLM hiyo hiyo badala ya hadithi kamili.
- Hatua ya kufanya muhtasari inaweza kuwa imechagua au kukuza maelezo fulani ya kitamaduni.
- Ukaribu wa sentence embedding si kipimo cha moja kwa moja cha ufanano wa kitamaduni au wa simulizi.
- Mbinu ya embedding haijathibitishwa kwa kiwango kikubwa dhidi ya tathmini ya binadamu.
- Vituo vya kikanda na uainishaji vimehesabiwa kwenye data hiyo hiyo.
- Hakuna jaribio huru, cross-validation wala mbinu ya leave-one-out iliyotumika.
- Hakuna msingi wa kulinganisha wa nasibu au wa lebo zilizochanganywa uliotolewa.
- Athari ya kutokuwiana kwa idadi ya sampuli za maeneo haijachunguzwa.
- Kategoria za kijiografia za UN M49 hazilingani moja kwa moja na mila za kitamaduni.
- Makundi kama Afrika, Asia na Amerika ni mapana mno ndani yake.
- Hakuna uchambuzi uliofanywa katika kiwango cha nchi, eneo dogo, familia ya lugha au mila ya kihistoria ya simulizi.
- Baadhi ya maneno ya TF-IDF ni majina ya wahusika tu, si vipengele vya njama.
- Haijajaribiwa ikiwa matokeo yangedumu baada ya kuficha majina ya kitamaduni.
- Thamani ndogo za silhouette za KMeans haziondoi uwezekano wa mbinu nyingine zote za uwekaji makundi.
- Kauli ya “violezo vitano tofauti” ina mvutano wa dhana na kutopatikana kwa makundi tofauti.
- Haijatenganishwa ikiwa ukaribu wa Afrika–Asia unatokana na njama, uchaguzi wa maneno au tabia ya kufanya muhtasari.
- Uhusiano na dhana za baada ya ukoloni ni wa kutafsiri na si utaratibu wa sababu uliopimwa moja kwa moja.
- Uthibitishaji wa ubora unategemea sampuli ndogo ya hadithi tisa pekee.
- Hakuna usomaji wa karibu wa kimfumo wa hadithi zilizopangiwa nje ya maeneo yao.
- Kuna tofauti isiyoelezwa ya rekodi 48 kati ya idadi ya mwisho ya data na sampuli iliyotolewa katika jaribio la chi-square.
Utafiti unaunga mkono nini?
- Unaunga mkono kwamba muhtasari wa gpt-4o-mini uliotathminiwa haukusambazwa kwa nasibu kabisa kwa maeneo ya kijiografia.
- Unaonyesha kwamba takriban robo tatu ya hadithi ziko karibu zaidi na kituo chao cha kikanda.
- Unaonyesha kwamba hadithi za Ulaya na Oceania huendana mara nyingi zaidi na vituo vyao.
- Unaonyesha kwamba Afrika na Asia zina ukaribu wa pande mbili wa embedding ulio juu kuliko jozi nyingine za maeneo.
- Unaunga mkono kwamba sehemu muhimu ya utofautishaji wa kikanda imejengwa kupitia majina ya watu na vipengele vya mandhari vya kiishara.
- Unaonyesha kwamba vipengele mahususi vya simulizi ya Disney ya Moana vinajirudia katika hadithi za Oceania.
- Unaonyesha kwamba chini ya KMeans hakuna makundi ya simulizi yaliyojitegemea na yaliyoshikana yanayoungwa mkono.
- Unaunga mkono kwamba inaweza kufaa zaidi kueleza nafasi ya simulizi kwa mvuto endelevu wa kikanda badala ya makategoria yenye mipaka mikali.
Utafiti hauthibitishi nini?
- Hauthibitishi kwamba miundo yote mikubwa ya lugha huzalisha mifumo hiyo hiyo ya kikanda.
- Hauonyeshi kwamba matoleo ya sasa au makubwa zaidi ya modeli yatatoa matokeo yale yale.
- Hauonyeshi kwamba mifumo hiyo hiyo itaibuka katika Kituruki au lugha nyingine.
- Hauthibitishi kwamba modeli inafanya ubaguzi wa kitamaduni kwa makusudi.
- Hauonyeshi kwamba nchi zote za Afrika na Asia zinawakilishwa kwa namna ileile.
- Hauthibitishi kwamba ulinganifu mkubwa wa kikanda unamaanisha usahihi au utajiri wa kitamaduni.
- Hauonyeshi kwamba hadithi za Ulaya zinaakisi kwa usahihi zaidi mila halisi za simulizi za Ulaya.
- Hauonyeshi kwa uhakika kwamba ulinganifu wa kituo unatokana na muundo wa njama.
- Hauthibitishi kwamba muhtasari wa maneno 50 huhifadhi maudhui yote ya kitamaduni ya hadithi kamili.
- Hauonyeshi kwamba kiwango cha asilimia 74,7 kitajirudia katika data mpya huru.
- Hauthibitishi kwamba nadharia ya baada ya ukoloni ndiyo maelezo pekee ya mifumo yote ya nambari iliyoonekana.
Mbinu na Matokeo ya Utafiti
Muundo wa utafiti
Utafiti huu ni uchambuzi wa pili wa kikokotozi wa mkusanyiko wa maandishi ya akili bandia yaliyochapishwa hapo awali. Hakuna hadithi mpya zilizozalishwa; muhtasari uliokuwepo ulitathminiwa upya kwa embedding, uwekaji makundi, ukaribu wa vituo, ulinganisho wa maneno na majaribio ya takwimu.
Mtiririko wa data
- Mkusanyiko wazi wa data wa mataifa 236, wenye hadithi 11.800, ulichukuliwa.
- Kategoria XX, ambayo haina taifa halisi, iliondolewa.
- Hadithi za mataifa 235, zikiwa hadithi 11.750, zilipangiwa maeneo ya UN M49.
- Muhtasari wa maneno 50 wa kila hadithi uliwekwa embedding kwa all-MiniLM-L6-v2.
- Vekta zenye vipimo 384 zilipunguzwa hadi vipimo viwili kwa UMAP kwa madhumuni ya uchunguzi.
- Uchambuzi wa silhouette wa K = 4–20 ulifanywa kwa KMeans.
- Kituo cha wastani cha embedding kilichosawazishwa cha kila eneo kilihesabiwa.
- Kila hadithi ilipangiwa kituo cha kikanda kilicho karibu zaidi.
- Eneo la prompt lililinganishwa na kituo kilichopangiwa na matriksi ya mkanganyiko ikaundwa.
- Uhusiano wa kikanda ulitathminiwa kwa chi-square na Cramér’s V.
- Uwiano wa Afrika–Asia ulilinganishwa kwa majaribio ya z ya uwiano miwili.
- Maneno mahususi ya maeneo yalitolewa kwa utofauti wa TF-IDF.
- Muhtasari wa Oceania wenye Moana ulipitiwa kwa mikono.
Sifa kuu za data na modeli
| Kipengele | Thamani iliyotolewa katika utafiti |
|---|---|
| Idadi ya awali ya hadithi | 11.800 |
| Idadi ya awali ya mataifa | 236 |
| Hadithi kwa kila taifa | 50 |
| Idadi ya mwisho ya hadithi | 11.750 |
| Idadi ya mwisho ya mataifa | 235 |
| Modeli iliyozalisha hadithi | gpt-4o-mini |
| Tarehe za uzalishaji | 13–19 Januari 2025 |
| Maandishi ya uchambuzi | Muhtasari wa maneno 50 uliozalishwa na modeli |
| Modeli ya embedding | all-MiniLM-L6-v2 |
| Vipimo vya embedding | 384 |
| Kiwango cha KMeans | K = 4–20 |
| Sampuli ndogo ya silhouette | Hadithi 2.000 |
Muhtasari wa matokeo makuu
| Kipimo | Matokeo | Kikomo cha tafsiri |
|---|---|---|
| Ulinganifu wa jumla wa kituo cha kikanda | %74,7 | Umehesabiwa kwenye vituo vilivyoundwa kwa data hiyo hiyo. |
| Ulinganifu wa Ulaya | %83,6 | Hauonyeshi moja kwa moja usahihi wa kitamaduni. |
| Ulinganifu wa Oceania | %81,5 | Unaweza kuathiriwa na alama kubwa za media kama Moana. |
| Ulinganifu wa Afrika | %71,9 | Nchi 54 zimeunganishwa chini ya kituo kimoja. |
| Ulinganifu wa Asia | %70,4 | Maeneo madogo yenye tofauti kubwa yameunganishwa chini ya kituo kimoja. |
| Ulinganifu wa Amerika | %69,8 | Amerika Kaskazini, Kati na Kusini ziko katika kundi moja pana. |
| Afrika → Asia | %12,8 | Ni ukaribu wa embedding; si kipimo cha moja kwa moja cha kusawazisha tamaduni. |
| Asia → Afrika | %14,0 | Ni upangaji wa juu zaidi wa nje ya eneo. |
| KMeans silhouette | 0,031–0,039 | Haiungi mkono makundi tofauti. |
| Chi-square | χ²(16) = 22.278,4; p < 0,001 | Thamani ya n = 11.652 katika maandishi hailingani na jumla ya data. |
| Cramér’s V | 0,691 | Uhusiano mkubwa kati ya eneo la prompt na upangaji wa kituo umeripotiwa. |
Tathmini ya takwimu
Jaribio la chi-square linaunga mkono hitimisho kwamba eneo la prompt na upangaji wa kituo si huru. Kwa sababu ya sampuli kubwa, thamani ndogo sana ya p inaweza kutarajiwa; kwa hiyo thamani ya Cramér’s V, inayoonyesha ukubwa wa uhusiano, pia ni muhimu.
Majaribio ya z ya uwiano miwili yameripoti kwamba upangaji wa Afrika–Asia ni mkubwa kwa kiasi cha maana kuliko uwiano unaofuata kwa ukubwa nje ya eneo, yaani Oceania–Amerika.
Kwa upande mwingine, kutokuwa na uhakika kifuatacho hakukutathminiwa kwa nambari:
- Kutokuwa na uhakika wa sampuli katika vekta za vituo
- Mabadiliko ya kiwango cha ulinganifu katika modeli tofauti za embedding
- Nasibu katika uzalishaji wa hadithi
- Uwakilishaji wa kitamaduni usio sawa kati ya mataifa
- Athari ya hatua ya kufanya muhtasari
- Makubaliano kati ya wakaguzi binadamu
- Utendaji kwenye mkusanyiko huru wa majaribio
Rasilimali zilizotolewa kwa urekebishwaji
- Imesemwa kwamba msimbo wa uchambuzi uko wazi kwenye GitHub.
- Imesemwa kwamba mkusanyiko wa awali wa hadithi uko wazi kwenye Dataverse.no.
- Modeli ya embedding na mipangilio ya msingi ya UMAP imeelezwa.
- Mipangilio ya msamiati na n-gram ya TF-IDF imetolewa.
Hata hivyo, maandishi makuu hayana idadi ya hadithi kwa kila eneo, vekta za vituo, wala logi ya usafishaji wa data inayoonyesha jinsi sampuli 11.652 za jaribio la chi-square zilivyopatikana.
Hatua zinazohitajika kwa utafiti wa baadaye
- Kulinganisha hadithi kamili na muhtasari uliotolewa na modeli
- Kurudia uchambuzi baada ya kuficha majina ya wahusika na maeneo
- Jaribio huru na cross-validation kwa msingi wa mataifa
- Kulinganisha modeli tofauti za sentence embedding
- Kujaribu LLM nyingi na matoleo tofauti ya modeli
- Kutathmini prompt na lugha za hadithi zisizo za Kiingereza
- Uchambuzi wa kina zaidi katika kiwango cha nchi na eneo dogo
- Kupima muundo wa njama kwa uwekaji msimbo wa binadamu au simulizi uliopangiliwa
- Usomaji wa karibu wa kimfumo wa hadithi zilizopangiwa nje ya maeneo yao
- Uthibitishaji kwa tathmini za wataalamu wa tamaduni
- Kujaribu ikiwa aina tofauti za prompt hupunguza uwekaji stereotaipu
- Kuchunguza athari za mapendekezo ya akili bandia kwa uzalishaji wa waandishi binadamu
Dokezo la Chanzo na Mbinu
Jina asilia la utafiti: How AI Stereotypes the World: Regional Narrative Templates in LLM-Generated Stories
Mwandishi: Paarth Singh Rathore.
Mpangilio wa waandishi: Utafiti una mwandishi mmoja.
Taarifa ya mchango sawa: Kwa kuwa utafiti una mwandishi mmoja, hakuna tamko la mchango sawa.
Mwandishi wa mawasiliano: Hakuna alama tofauti ya “corresponding author” katika hati. Barua pepe ya mawasiliano ya mwandishi mmoja imetolewa.
Barua pepe: paarthsinghrathore1@gmail.com
Taasisi: Department of Computer Science and Information Systems, BITS Pilani, Pilani, Rajasthan, India.
Jukwaa rasmi la uchapishaji: SSRN.
Kiungo rasmi cha utafiti:Ukurasa wa utafiti wa SSRN
Tarehe ya kupakiwa SSRN: 31 Julai 2026.
Idadi ya kurasa: 9.
Mwaka wa uchapishaji: 2026.
Jarida au mkutano: Toleo hili halina taarifa ya jarida lililopitiwa na rika, mkutano uliokubaliwa au makala ya mkutano iliyochapishwa.
Hali ya mchapishaji na jukwaa: Utafiti uko kwenye jukwaa la preprint la SSRN. Mchapishaji wa jarida lililopitiwa na rika hajathibitishwa.
Aina ya chanzo: Preprint ya sayansi ya jamii ya kikokotozi na uchakataji wa lugha asilia ambamo mkusanyiko wazi wa hadithi za akili bandia umechanganuliwa upya kwa sentence embedding, vituo vya kikanda, uwekaji makundi, TF-IDF na majaribio ya takwimu.
Hali ya mapitio ya rika: Utafiti haujapitia mapitio ya rika. Matokeo yanapaswa kusomwa kwa kuzingatia kikwazo hiki.
Mmiliki wa data asilia: Mkusanyiko wa hadithi 11.800 uliotumika katika utafiti umechukuliwa kutoka utafiti wa awali wa Rettberg na Wigers. Paarth Singh Rathore hakuzalisha hadithi; ametumia uchambuzi mpya wa kikanda kwenye data iliyokuwepo.
Kiungo cha data asilia:Rekodi ya data ya Dataverse.no
Msimbo wa uchambuzi:Hifadhi ya msimbo ya GitHub
Ufadhili: Maandishi makuu hayana tamko la ufadhili.
Mgongano wa maslahi: Maandishi makuu hayana tamko la mgongano wa maslahi.
Michango ya mwandishi: Hakuna tamko tofauti la CRediT lililotolewa kwa utafiti huu wa mwandishi mmoja.
Kamati ya maadili: Utafiti unategemea data wazi ya maandishi yaliyozalishwa na akili bandia. Hakuna matumizi ya washiriki binadamu au data maalumu za kibinafsi yaliyoripotiwa, na hakuna taarifa tofauti ya kamati ya maadili iliyotolewa.
Kutokulingana kuu kwa nambari: Maandishi yanasema kwamba mkusanyiko wa mwisho una hadithi 11.750 na kwamba kategoria ya Polar ina hadithi 50. Kwa hiyo maeneo matano yasiyo ya Polar yangetarajiwa kuwa na hadithi 11.700, lakini n = 11.652 imetolewa kwa jaribio la chi-square. Hali ya rekodi 48 zilizopo kati ya nambari hizo haijaelezwa.
Maelezo haya ya Kituruki yameandaliwa kwa kutathmini maelezo ya data ya utafiti uliopakiwa, mfumo wa fasihi, mbinu ya sentence embedding yenye vipimo 384, mipangilio ya UMAP, jedwali la KMeans silhouette, milinganyo ya vituo vya kikanda, matriksi ya mkanganyiko, majaribio ya chi-square na z, maneno ya TF-IDF, ukaguzi wa mikono wa mifano ya Moana, mjadala na vikwazo. Hakuna majaribio ya modeli au matokeo mahususi ya nchi yasiyokuwapo katika utafiti yaliyoongezwa.
Utafiti unaunga mkono kwamba hadithi za gpt-4o-mini zilizochunguzwa hazielezi mataifa yote kwa namna inayofanana kabisa; juu ya muundo wa njama wa pamoja, hutumia majina na vipengele vya kimazingira vya kiishara vinavyotofautiana kwa maeneo mapana. Hata hivyo, matokeo yanategemea tu maandishi yaliyotolewa na modeli moja kwa prompt za Kiingereza na kufupishwa tena na modeli hiyo hiyo. Dai la “kiolezo cha simulizi cha kikanda” halipaswi kukubaliwa kama sifa ya jumla ya LLM hadi lithibitishwe kwa data huru, uchambuzi wa maandishi kamili, tathmini ya binadamu na majaribio yanayodhibiti maneno ya kitamaduni ya uso.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *