

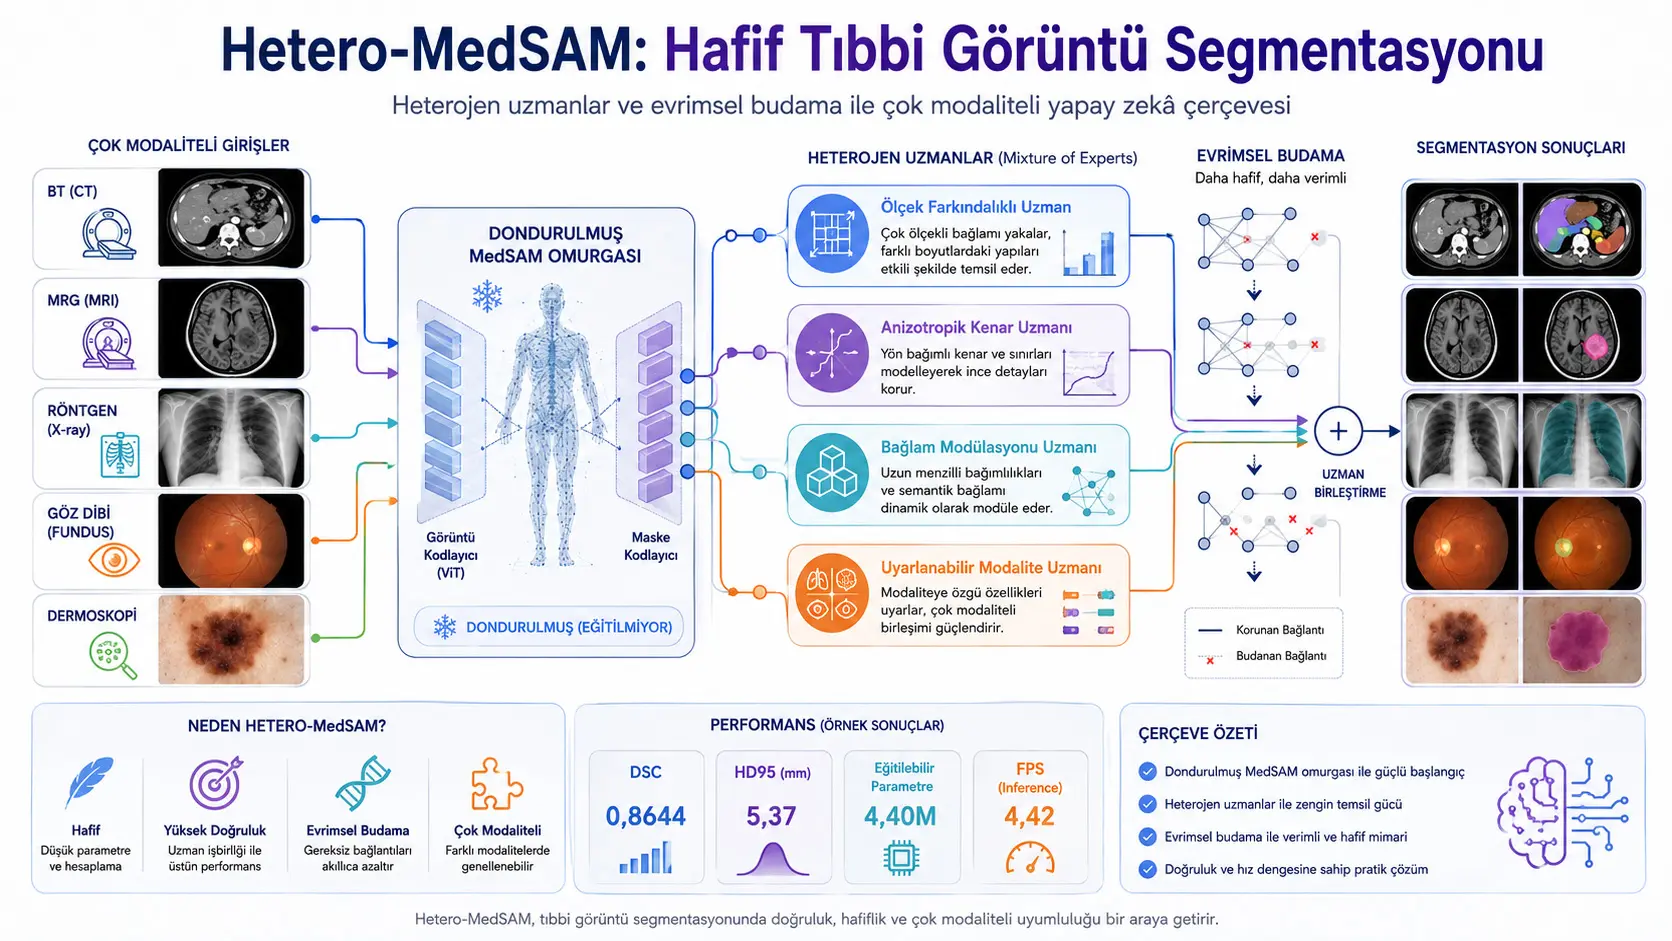
Uchanganuzi wa sehemu katika picha za kitabibu ni mchakato wa kutambua mipaka ya viungo, uvimbe, mishipa au miundo mingine ya anatomia kwa kiwango cha pikseli katika tomografia ya kompyuta, upigaji picha wa mwangwi wa sumaku, eksirei, ultrasound, endoscopy, dermoscopy na picha za fundus ya jicho. Mchakato huu unaweza kutoa taarifa muhimu kwa upangaji wa radiotherapy, ufuatiliaji wa maendeleo ya ugonjwa, maandalizi ya upasuaji na uchanganuzi wa kiasi wa picha.
Miundo msingi ya picha za kitabibu kama MedSAM ina uwezo wa jumla wa uwakilishi wa kuona unaoweza kutumika katika kazi nyingi za segmentesheni. Hata hivyo, visimbaji vikubwa vya picha katika miundo hii vinahitaji hesabu nyingi, kumbukumbu na nishati. Hali hii hufanya iwe vigumu kutumia miundo hiyo kwenye vifaa vinavyobebeka, vituo vya kliniki vyenye nguvu ndogo au taasisi za afya zilizo na vifaa vichache.
Katika preprint hii, watafiti wanapendekeza mfumo unaoitwa Hetero-MedSAM, ambapo uti wa mgongo wa MedSAM uliokwisha kufunzwa huhifadhiwa na moduli ndogo za pembeni zinazojifunza kuzoea kazi pekee ndizo zinazofunzwa. Katikati ya modeli kuna moduli nne zisizofanana, kila moja ikiwa maalumu kwa kazi tofauti:
- Mtaalamu Anayetambua Kipimo, anayelenga kunasa malengo ya anatomia yenye ukubwa tofauti,
- Mtaalamu wa Kingo Anizotropiki, anayelenga kufuatilia mipaka mirefu, myembamba na isiyo ya kawaida,
- Mtaalamu wa Urekebishaji wa Muktadha, anayechanganya maelezo ya eneo dogo na muktadha wa jumla wa picha,
- Mtaalamu Anayobadilika kwa Modality, anayelenga kufidia tofauti za ishara za kifizikia kati ya BT, MRG, eksirei na mbinu nyingine za upigaji picha.
Modeli hutathmini kwa pamoja modality ya picha, lengo la anatomia, kazi ya kliniki na maudhui ya picha, kisha hutengeneza uzani badilifu kwa wataalamu watatu wa kwanza. Wakati wa mafunzo, michango ya wataalamu hufuatiliwa kwa wastani unaosogea; matawi yanayoendelea kuwa na mchango mdogo kwa muda mrefu huzima kimwili. Watafiti wanaita mchakato huu “evolutionary pruning”.
Katika seti ya data ya HeteroMedSeg iliyoundwa kutoka takribani vipande 20.000 vya picha za kitabibu na modality nane za upigaji picha, Dice Similarity Coefficient ya jumla iliyoripotiwa ni 0,8644, HD95 ni 5,37, na kasi ya inference ni 4,42 fremu/sekunde. Kiwango cha parameta zinazofunzwa kiliripotiwa kuwa milioni 4,40.
Kwa kulinganisha, MedSAM ya msingi ilipata Dice 0,8037, HD95 7,50 na kasi ya 0,23 fremu/sekunde. Hetero-MedSAM katika mpangilio huu wa majaribio ilionyesha mwingiliano mkubwa zaidi wa kieneo, kosa dogo zaidi la mpaka na kasi kubwa zaidi ya usindikaji. Hata hivyo, MedSegX iliyowekwa ndani ya tabaka nne kwa eneo husika ilikuwa haraka kidogo kuliko Hetero-MedSAM kwa 4,69 fremu/sekunde; faida kuu ya Hetero-MedSAM ilikuwa katika usahihi wa segmentesheni na ulinganifu wa mipaka.
Matokeo muhimu ya utafiti ni kwamba kuongeza moduli za wataalamu kwenye kila tabaka la mtandao hakukuwa na manufaa. Modeli ya awali iliyoongeza wataalamu heterojeni kwenye tabaka zote ilipata Dice 0,8428 pekee. Matokeo bora yalipatikana wataalamu walipowekwa kwenye block namba 6, 7, 9 na 11 katika tabaka za kina za kisimbaji picha cha MedSAM.
Matokeo yanaonyesha kuwa wataalamu tofauti hujitokeza kwa matatizo tofauti ya upigaji picha. Katika dermoscopy, mtaalamu wa kingo alihifadhiwa mara nyingi zaidi kutokana na mipaka isiyo ya kawaida; katika MRG, mtaalamu wa muktadha alihifadhiwa zaidi kutokana na maeneo ya lengo yaliyotengana; na katika BT, mtaalamu wa kipimo alihifadhiwa zaidi kwa sababu ya malengo yenye ukubwa tofauti.
Hata hivyo, utafiti hauonyeshi ushahidi wa matumizi halisi ya kliniki. Majaribio yalifanywa kwenye picha zilizokusanywa kutoka vyanzo vya data vya umma. Hakukuwa na utafiti wa wagonjwa wa mbele, mtiririko halisi wa kazi wa hospitali, jaribio la kifaa cha kitabibu kinachobebeka au ulinganisho wa utendaji wa wahudumu wa kliniki. Aidha, thamani ya milioni 4,40 inawakilisha parameta za marekebisho zinazofunzwa; hitaji la kuhifadhi uti wa mgongo wa MedSAM uliogandishwa kwenye kumbukumbu na kuutumia wakati wa inference bado lipo.
Segmentesheni ya picha za kitabibu ni nini?
Mfumo wa uainishaji wa picha za kitabibu unaweza kutoa uamuzi mmoja kwa picha nzima kama “uvimbe upo” au “uvimbe haupo”. Mfumo wa segmentesheni huenda zaidi ya hapo kwa kujaribu kubainisha ni pikseli zipi hasa zinamiliki muundo lengwa.
Kwa mfano, kwenye picha ya BT ya ini, modeli ya segmentesheni inaweza kuonyesha:
- Mpaka wa nje wa ini,
- Kidonda kilicho ndani ya ini,
- Tishu inayozunguka kidonda,
- Na, inapohitajika, mishipa au njia za nyongo
kama maski tofauti.
Kwa hiyo, segmentesheni hailengi tu “uwepo wa kitu”, bali pia eneo lake, ukubwa wa eneo, ujazo, umbo na mipaka yake.
Kazi hii ni ngumu katika picha za kitabibu kwa sababu:
- Kiungo kilekile kinaweza kuwa na ukubwa na umbo tofauti kwa wagonjwa tofauti.
- Mpaka wa uvimbe unaweza kutokuwa wazi kutoka kwa tishu inayouzunguka.
- Mishipa na neva nyembamba zinaweza kuwa ndefu, zilizopinda na upana wa pikseli chache tu.
- BT, MRG, ultrasound na eksirei hutengenezwa kwa mifumo tofauti ya kifizikia ya ishara.
- Hata ndani ya modality moja, vifaa na itifaki tofauti za upigaji picha zinaweza kuzalisha usambazaji tofauti wa picha.
- Baadhi ya malengo huchukua sehemu kubwa ya picha, huku mengine yakiwa madogo sana.
Kwa nini MedSAM si modeli nyepesi moja kwa moja?
MedSAM ni toleo la usanifu wa Segment Anything Model la matumizi ya jumla lililobadilishwa kwa picha za kitabibu. Modeli hutumia kisimbaji kikubwa cha picha kubadilisha picha kuwa uwakilishi wa vipengele wenye vipimo vikubwa. Kisimbaji cha prompt huchakata mwongozo wa mtumiaji kama kisanduku, na kisimbua maski hutengeneza maski ya segmentesheni ya muundo lengwa.
Nguvu ya miundo mikubwa ya msingi ni kwamba inaweza kutumia tena vipengele vya jumla vilivyojifunzwa kwenye picha nyingi tofauti. Lakini kisimbaji kikubwa cha picha kina:
- Idadi kubwa ya parameta,
- Mahitaji makubwa ya FLOP,
- Matumizi makubwa ya kumbukumbu,
- Ucheleweshaji kwenye prosesa zenye nguvu ndogo
ambavyo vinaweza kuzuia usambazaji kwenye vifaa vya kliniki vya mwisho.
Katika jedwali la ulinganisho la utafiti, MedSAM ya msingi imeripotiwa kuwa na parameta milioni 93,74, 371,99 GFLOP na 0,23 fremu/sekunde kwenye prosesa Intel Xeon E5-2680 v4.
Hetero-MedSAM haitengenezi modeli mpya ndogo ya msingi kutoka mwanzo. Inagandisha kisimbaji picha na kisimbaji prompt cha MedSAM, kisha huongeza njia chache za wataalamu zinazofunzwa ndani au kando yake.
Tofauti hii ni muhimu:
- Parameta chache zinazofunzwa humaanisha uzani wachache ndio husasishwa wakati wa marekebisho.
- Modeli ndogo kwa ujumla humaanisha uti wote wa mgongo ni mdogo kimwili.
Hetero-MedSAM inalenga sana lengo la kwanza. Lakini kwa kuwa uti wa mgongo wa MedSAM uliogandishwa bado hutumika wakati wa inference, namba ya milioni 4,40 haipaswi kutafsiriwa kwamba alama nzima ya kumbukumbu ya modeli imepungua hadi parameta milioni 4,40 pekee.
Fine-tuning yenye ufanisi wa parameta ni nini?
Fine-tuning yenye ufanisi wa parameta haisasishi uzani wote wa modeli kubwa iliyofunzwa kabla; badala yake huhifadhi uti mkuu wa mgongo ukiwa thabiti na kusasisha idadi ndogo ya parameta za ziada.
Kwa mfano wa kawaida, ni kama kuongeza timu ndogo za wataalamu katika idara maalumu za hospitali iliyopo badala ya kujenga hospitali kubwa upya kutoka mwanzo. Miundombinu kuu hubaki, na kuzoea kazi mpya hufanywa kupitia timu hizo.
Njia hii inaweza:
- Kupunguza kumbukumbu ya mafunzo.
- Kupunguza ukubwa wa faili ya uzani maalumu kwa kazi.
- Kurahisisha kutumia uti uleule wa mgongo kwa kazi tofauti.
- Kupunguza gharama ya mafunzo ikilinganishwa na fine-tuning ya modeli nzima.
Hata hivyo, ikiwa adapter moja yenye muundo uleule itatumika kwa kazi zote, mahitaji tofauti ya picha za kitabibu yanaweza kutowakilishwa vya kutosha. Hili ndilo tatizo ambalo Hetero-MedSAM inajaribu kutatua.
Kwa nini wataalamu “heterojeni” hutumiwa?
Katika usanifu wa kawaida wa mixture of experts, matawi kadhaa ya mtandao yanayofanana yanaweza kuwepo. Matawi hayo hubeba muundo mkuu sawa lakini huwashwa kwa viwango tofauti kwa sampuli tofauti.
Katika Hetero-MedSAM, si uzani tu bali pia usanifu wa ndani na kazi za wataalamu hutofautiana. Kila mtaalamu analenga tatizo maalumu la picha za kitabibu:
| Mtaalamu | Tatizo analolenga | Operesheni kuu |
|---|---|---|
| Mtaalamu Anayetambua Kipimo | Kushughulikia vidonda vidogo na viungo vikubwa katika modeli moja | Convolution sambamba za depthwise zenye dilation tofauti |
| Mtaalamu wa Kingo Anizotropiki | Mipaka mirefu, myembamba, iliyopinda au isiyo sawia | Convolution za mistari ya mlalo na wima zenye padding ya upande mmoja |
| Mtaalamu wa Urekebishaji wa Muktadha | Kuchanganya maelezo ya eneo dogo na muktadha mpana wa anatomia | Global average na max pooling pamoja na urekebishaji wa channel |
| Mtaalamu Anayobadilika kwa Modality | Tofauti za ishara kati ya BT, MRG, eksirei na modality nyingine | Routing ya mtaalamu maalumu kwa modality na marekebisho ya parameta |
Mantiki ya usanifu huu inaweza kulinganishwa na jinsi radiologist hatumii sheria zilezile za kuona anapotathmini eksirei ya mfupa, MRG ya ubongo na picha ya dermoscopy. Kwa sababu mbinu za kifizikia za kutengeneza picha na malengo ya kliniki hutofautiana, njia za uwakilishi zinazosaidia modeli pia hutofautishwa.
Usanifu wa jumla wa modeli
Kielelezo 1 kinaonyesha mnyororo mzima wa uchakataji. Mtiririko mkuu ni huu:
- Picha ya kitabibu inaingia kwenye kisimbaji picha cha MedSAM kilichogandishwa.
- Vipengele vya picha huchakatwa katika block za Transformer.
- Moduli ya HeCon-MoAE huongezwa kama njia sambamba kwenye block za kina zilizochaguliwa.
- Modality, kiungo, kazi na muktadha wa picha huingia kwenye mtandao wa routing.
- Uzani wa michango ya wataalamu huhesabiwa.
- Matokeo ya wataalamu huunganishwa na matokeo ya mtandao wa feed-forward wa asili wa MedSAM.
- Prompt ya kisanduku huchakatwa kwa kisimbaji prompt kilichogandishwa.
- Uwakilishi wa picha na prompt huunganishwa katika kisimbua maski.
- Maski ya segmentesheni ya muundo lengwa hutengenezwa.
Usanifu huu unalenga kuhifadhi maarifa ya jumla ya picha za kitabibu yaliyokwisha kujifunzwa na MedSAM huku ukiongeza kupitia njia ndogo za wataalamu vipengele vya ziada vinavyohitajika kwa kazi maalumu.
Hierarkia ya maarifa ya anatomia ya MedSegDB
Utafiti unatumia MedSegDB, muundo wa maarifa ya anatomia na data ya segmentesheni uliotengenezwa hapo awali, kama rejea ya majaribio. MedSegDB huunganisha picha za kitabibu kutoka vyanzo 129 vya umma chini ya mti wa hierarkia ya anatomia.
Muundo unaoonyeshwa katika Kielelezo 2 una tabaka moja la mizizi na ngazi nne za anatomia:
| Ngazi | Yaliyomo | Upeo ulioripotiwa |
|---|---|---|
| Tabaka la mizizi | Uwakilishi wa jumla wa mwili wa binadamu | Vekta ya mwanzo ya pamoja |
| Tabaka 1 | Mfumo wa mwili | Matawi 5: kichwa-shingo, kiwiliwili, mifupa, mishipa na ngozi |
| Tabaka 2 | Eneo la anatomia | Maeneo 12 kama kifua, tumbo na nyonga |
| Tabaka 3 | Kiungo au tishu | Vitengo 39 vya viungo na tishu |
| Tabaka 4 | Kazi ya kliniki ya segmentesheni | Kazi 111 za kina |
Kwa mfano, njia ya kisemantiki ifuatayo inaweza kuundwa:
\[ \mathrm{İnsan\ vücudu} \rightarrow \mathrm{Gövde} \rightarrow \mathrm{Karın} \rightarrow \mathrm{Karaciğer} \rightarrow \mathrm{Karaciğer\ tümörü} \]
Hierarkia hii huipa modeli ufikiaji si kwa pikseli pekee bali pia kwa taarifa zilizopangwa kuhusu modality, kiungo na kazi ya kliniki.
Kielezi cha pamoja cha muktadha kinaundwaje?
Modeli huunganisha vyanzo vinne vya taarifa:
- Embedding ya modality ya picha: Em
- Embedding ya muundo wa anatomia: Ea
- Embedding ya kazi ya kliniki: Et
- Kipengele cha picha kilichofupishwa kwa global pooling: X̄
Mlinganyo wa muktadha wa pamoja uliotolewa katika utafiti ni:
\[ C_{\mathrm{all}} = \mathrm{Concat}(E_m,E_a,E_t,\bar{X}) \]
Hapa:
- Call ni kielezi kilichounganishwa cha muktadha kitakachotumika katika routing ya wataalamu.
- Concat ni kuunganisha vekta za vipengele katika kipimo cha channel.
- Em husimba kama picha ni BT, MRG, eksirei au modality nyingine.
- Ea huwakilisha eneo la anatomia na taarifa ya kiungo.
- Et huwakilisha muundo ambao segmentesheni yake inahitajika.
- X̄ ni muhtasari wa jumla wa maudhui ya picha.
Kwa maana ya kawaida, mfumo hauulizi tu “ninaona nini kwenye picha?”, bali pia “picha hii ilitoka kwenye kifaa gani, inaonyesha kiungo gani, na nimeombwa kutafuta muundo gani?” kwa wakati mmoja.
Uzani wa wataalamu huhesabiwaje?
Uzani wa wataalamu watatu wa kwanza huhesabiwa na mtandao wa routing:
\[ [w_1,w_2,w_3]^T = \mathrm{Softmax}(W_g \cdot \sigma(W_{in}\cdot C_{\mathrm{all}})) \]
Katika fomula hii:
- w1 ni uzani wa Mtaalamu Anayetambua Kipimo.
- w2 ni uzani wa Mtaalamu wa Kingo Anizotropiki.
- w3 ni uzani wa Mtaalamu wa Urekebishaji wa Muktadha.
- Win na Wg ni matrisi zinazojifunzwa wakati wa mafunzo.
- σ ni activation ya sigmoid.
- Softmax hubadilisha uzani watatu kuwa thamani chanya na kufanya jumla yao kuwa moja.
Sharti kuu la uzani ni:
\[ \sum_{i=1}^{3} w_i = 1 \]
Kwa njia hii, modeli hugawa bajeti yenye kikomo ya umakini kati ya wataalamu watatu wa kimofolojia. Ikiwa mipaka isiyo ya kawaida inatawala picha, uzani wa mtaalamu wa kingo unaweza kuongezeka; ikiwa ukubwa wa malengo unatofautiana sana, mtaalamu wa kipimo anaweza kupata uzani mkubwa zaidi.
Mtaalamu wa nne, Mtaalamu Anayobadilika kwa Modality, huwekwa nje ya ushindani huu. Katika utafiti uzani wa udhibiti:
\[ w_4 = 1 \]
umewekwa thabiti. Lengo ni kuhakikisha marekebisho maalumu ya ishara ya modality yanafanya kazi kila wakati bila kuathiriwa na ushindani wa uzani wa wataalamu watatu wa kwanza.
Matokeo ya wataalamu huongezwaje kwenye MedSAM?
Vipengele vinavyozalishwa na wataalamu huunganishwa na njia ya awali ya feed-forward ya MedSAM:
\[ Y = \mathrm{MLP}(X) + s \cdot \left(\sum_{i=1}^{3} w_iE_i(X)+w_4E_4(X)\right) \]
Hapa:
- X ni kipengele kinachoingia kwenye block ya Transformer.
- MLP(X) ni matokeo ya mtandao wa awali wa feed-forward wa MedSAM.
- E1-E3 ni mabadiliko ya wataalamu watatu wa kimofolojia.
- E4 ni mtaalamu wa modality.
- wi ni uzani wa michango ya wataalamu.
- s ni mgawo wa scale unaodhibiti ukubwa wa jumla wa mchango wa wataalamu.
- Y ni matokeo yaliyounganishwa ya njia ya awali na njia za wataalamu.
Muundo huu hauondoi uwakilishi wa awali wa MedSAM; badala yake huongeza marekebisho au taarifa ya ziada. Kwa hiyo, ikiwa njia za wataalamu zitajifunza vibaya au kwa kiwango kisichotosha, uwakilishi mkuu wa uti wa mgongo uliokwisha kufunzwa hujaribiwa kuhifadhiwa.
Mtaalamu Anayetambua Kipimo hufanyaje kazi?
Ukubwa wa malengo kwenye picha za kitabibu unaweza kubadilika sana. Picha moja inaweza kuhitaji segmentesheni ya ini lote, wakati nyingine inaweza kutafuta kidonda cha milimita chache.
Mtaalamu Anayetambua Kipimo kwanza hupunguza channel za vipengele kwa convolution ya 1×1 hadi bottleneck yenye vipimo vichache. Kisha hutumia convolution tatu sambamba za depthwise zenye viwango tofauti vya dilation:
\[ x_r = \mathrm{DConv}_r(\mathrm{Conv}^{down}_{1\times1}(X)), \quad r\in\{1,2,3\} \]
Hapa:
- r ni kiwango cha dilation ya convolution.
- r=1 huona zaidi maelezo ya karibu.
- r=2 na r=3 huchukua muktadha mpana zaidi unaozunguka.
- DConv ni depthwise convolution inayofanywa kwa gharama ndogo zaidi katika kila channel.
Vipimo vitatu huunganishwa baadaye:
\[ X_{\mathrm{scale}} = \mathrm{Conv}^{up}_{1\times1}\left(\mathrm{GELU}(\mathrm{Concat}(x_1,x_2,x_3))\right) \]
Mchakato huu unalenga kuunganisha maelezo madogo na kontua pana za anatomia katika uwakilishi mmoja.
Katika mchoro wa wataalamu wa Kielelezo 3, matawi yote matatu yanaonekana yameandikwa “R=1”, lakini maandishi ya mbinu na mlinganyo yanafafanua viwango vya dilation kuwa 1, 2 na 3. Hili ni kutokulingana ndani ya preprint kati ya mchoro na maelezo ya kihisabati. Utekelezaji halisi unahitaji kuthibitishwa kupitia msimbo.
Mtaalamu wa Kingo Anizotropiki hufanyaje kazi?
Neno “anizotropiki” lina maana kwamba muundo hauonekani sawa katika kila mwelekeo. Uvimbe wa ini unaweza kuwa wa mviringo kiasi, lakini mshipa, neva, ukuta wa utumbo au mpaka wa kidonda cha ngozi unaweza kuwa mrefu, mwembamba na kuelekea upande maalumu.
Kernel ya kawaida ya convolution ya mraba inapochunguza muundo mrefu na mwembamba inaweza pia kuingiza background isiyohitajika. Kwa hiyo modeli hutumia kernel za mistari ya mlalo na wima:
\[ y_h^{(i)} = \mathrm{Conv}_{1\times k}(\mathrm{Pad}^{(i)}_h(X)), \quad i\in\{0,1\} \]
\[ y_v^{(i)} = \mathrm{Conv}_{k\times1}(\mathrm{Pad}^{(i)}_v(X)), \quad i\in\{0,1\} \]
Katika fomula hizi:
- yh huwakilisha vipengele vya mwelekeo wa mlalo.
- yv huwakilisha vipengele vya mwelekeo wa wima.
- Pad ni padding ya upande mmoja isiyo linganifu inayoruhusu kernel kuelemea zaidi kushoto, kulia, juu au chini.
- Katika mchoro kernel zinaonyeshwa kama 1×3 na 3×1.
Matokeo ya pande nne huunganishwa:
\[ X_{\mathrm{edge}} = \mathrm{Conv}_{1\times1}\left(\mathrm{SiLU}(\mathrm{Concat}(y_h^{(0)},y_h^{(1)},y_v^{(0)},y_v^{(1)}))\right) \]
Mtaalamu huyu ametengenezwa hasa kwa mipaka isiyo ya kawaida ya vidonda vya ngozi, mishipa myembamba na kontua za anatomia zenye mwelekeo.
Mtaalamu wa Urekebishaji wa Muktadha hufanyaje kazi?
Baadhi ya makosa ya segmentesheni hutokea modeli inapolenga sana maelezo madogo na kupoteza mpangilio wa jumla wa anatomia katika picha.
Mtaalamu wa muktadha hutumia muhtasari wawili wa kimataifa:
- Global average pooling: Hufupisha usambazaji wa jumla wa vipengele katika picha.
- Global max pooling: Huleta mbele ishara zilizo dhahiri zaidi.
Uzani wa channel hutengenezwa kwa uhusiano ufuatao:
\[ W = \sigma(\mathrm{FC}(\mathrm{Concat}(\mathrm{GAP}(Z),\mathrm{GMP}(Z)))) \]
Hapa:
- Z ni kipengele cha bottleneck chenye vipimo vichache.
- GAP ni global average pooling.
- GMP ni global max pooling.
- FC ni badiliko la fully connected.
- W ni uzani unaoamua channel zipi ziimarishwe na zipi zipunguzwe.
Kipengele kilichorekebishwa ni:
\[ U = \mathrm{BN}(\mathrm{DWConv}_{3\times3}(Z\odot W)) \]
\[ X_{\mathrm{context}} = \mathrm{Conv}_{1\times1}(U) \]
Alama ⊙ inaonyesha kuzidisha kipengele kwa kipengele katika kiwango cha channel, na BN inaonyesha batch normalization.
Mtaalamu huyu analenga hasa kusaidia modeli kutambua maeneo madogo ya lengo yaliyotengana katika MRG ndani ya muktadha wa jumla wa anatomia.
Mtaalamu Anayobadilika kwa Modality hufanya nini?
Hounsfield units za BT, intensity ya ishara ya MRG, muundo wa projection wa eksirei, au sifa za rangi na mwanga za endoscopy si vitu sawa.
Mtaalamu Anayobadilika kwa Modality huchagua kwa routing njia inayofaa kati ya njia ndogo za wataalamu zilizotenganishwa kwa modality ya picha. Katika mchoro wa usanifu, wataalamu wa CT, MRI, X-ray na modality nyingine wanaonyeshwa kama matawi tofauti.
Lengo la tawi hili ni kufidia distribution shift inayotokea kwa muundo uleule wa anatomia katika mifumo tofauti ya upigaji picha.
Hata hivyo, katika maandishi ya mbinu uzani wa mtaalamu wa modality umewekwa 1, wakati katika sehemu ya pruning ya baadaye idadi ya jumla ya wataalamu imetajwa kuwa nne na mask ya pruning imefafanuliwa kwa namna inayoweza kuwajumuisha wote. Jedwali la evolution ya wataalamu, kwa upande mwingine, linaripoti wataalamu watatu wa kwanza tu. Kwa hiyo, preprint haielezi kikamilifu namna mtaalamu wa nne alivyoshughulikiwa wakati wa pruning.
Mzigo wa kihesabu wa benki ya wataalamu
Katika utafiti, wataalamu wote walilinganishwa chini ya input/output ya 768×16×16 na bottleneck ya pamoja yenye channel 64.
| Moduli | Parameta | Mzigo wa kihesabu |
|---|---|---|
| Ulinganisho wa convolution ya kawaida | 135,17 elfu | 34,60 milioni FLOP |
| Ulinganisho wa depthwise convolution | 98,88 elfu | 25,31 milioni FLOP |
| Convolution ya makundi manne | 107,52 elfu | 27,53 milioni FLOP |
| Mtaalamu Anayetambua Kipimo | 198,34 elfu | 50,77 milioni FLOP |
| Mtaalamu wa Kingo Anizotropiki | 124,48 elfu | 51,18 milioni FLOP |
| Mtaalamu wa Urekebishaji wa Muktadha | 100,54 elfu | 25,38 milioni FLOP |
| Mtaalamu Anayobadilika kwa Modality | 98,30 elfu | 25,17 milioni FLOP |
| Jumla ya benki ya wataalamu | 521,66 elfu | 152,50 milioni FLOP |
Jedwali hili linaonyesha gharama ya benki moja ya wataalamu. Kwa kuwa katika modeli ya mwisho benki za wataalamu zimewekwa kwenye block kadhaa za Transformer zilizochaguliwa, thamani za jumla katika kiwango cha modeli ziliripotiwa kando.
Utaratibu wa evolutionary pruning
Ikiwa matawi yote manne ya wataalamu yataendeshwa kila wakati kwenye kila tabaka lililochaguliwa, lengo la kuwa na modeli nyepesi linaweza kudhoofika. Kwa hiyo watafiti walitengeneza utaratibu wa kufuatilia mchango wa wataalamu wakati wa mafunzo.
Alama ya mchango ya wastani unaosogea ya kila mtaalamu husasishwa kwa fomula ifuatayo:
\[ S_{\mathrm{avg}}^{(t)}=(1-\lambda)S_{\mathrm{avg}}^{(t-1)}+\lambda\cdot\mathrm{Mean}(w^{(t)}) \]
Hapa:
- Savg(t) ni alama ya mchango iliyolainishwa katika wakati t.
- w(t) ni uzani wa sasa wa mtaalamu katika mini-batch.
- Mean ni wastani katika sampuli.
- λ huamua kasi ambayo wastani unaosogea hujibu taarifa mpya.
Katika utafiti:
\[ \lambda = 0{,}1 \]
ilitumika.
Katika picha moja, uzani wa mtaalamu unaweza kuongezeka au kupungua kwa bahati. Wastani unaosogea unalenga mchango wa muda mrefu badala ya mabadiliko ya muda mfupi.
Ikiwa mchango wa mtaalamu unabaki chini ya kizingiti kilichowekwa, mask ya pruning hutumika. Katika utafiti kizingiti kilikuwa:
\[ \tau = 0{,}01 \]
iliwekwa.
Tathmini zilifanywa katika epoch za 8., 16. na 24.
Hesabu ya uzani baada ya pruning ni:
\[ \hat{w}=\mathrm{Softmax}\left((W_g\cdot\sigma(W_{in}\cdot C_{\mathrm{all}}))\odot(1-m)-M\cdot m\right) \]
Hapa:
- m ni mask ya pruning yenye thamani 0 au 1 kwa kila mtaalamu.
- m=1 inaonyesha kuwa njia ya mtaalamu husika imezimwa.
- M ni namba kubwa inayosukuma alama ya mtaalamu aliyepunguzwa hadi thamani hasi sana kabla ya Softmax.
- ŵ ni uzani mpya wa wataalamu baada ya pruning.
Lengo si kuzidisha matokeo ya mtaalamu kwa sifuri tu, bali kusimamisha kabisa utekelezaji wa tawi la kimwili wakati wa inference ili kupata uokoaji halisi wa hesabu.
Kitendakazi cha hasara
Mafunzo ya segmentesheni hufanywa kwa jumla ya binary cross-entropy na Dice loss:
\[ \mathcal{L}_{\mathrm{mask}}=\lambda_1\mathcal{L}_{\mathrm{BCE}}+\lambda_2\mathcal{L}_{\mathrm{Dice}} \]
Katika utafiti, coefficients zote mbili ziliwekwa kuwa 1:
\[ \lambda_1=\lambda_2=1 \]
Binary cross-entropy loss:
\[ \mathcal{L}_{\mathrm{BCE}}=-\frac{1}{N}\sum_{i=1}^{N}\left(y_i\log p(y_i)+(1-y_i)\log(1-p(y_i))\right) \]
Hapa:
- yi ni lebo halisi ya pikseli i na inaweza kuwa 0 au 1.
- p(yi) ni uwezekano unaotabiriwa na modeli kwa pikseli hiyo.
- N ni idadi ya jumla ya pikseli katika picha.
Dice loss:
\[ \mathcal{L}_{\mathrm{Dice}}=1-\frac{2\sum_{i=1}^{N}p(y_i)y_i+\epsilon}{\sum_{i=1}^{N}p(y_i)+\sum_{i=1}^{N}y_i+\epsilon} \]
Katika fomula hii ε ni thamani ndogo ya namba inayozuia denominator kuwa sifuri.
Cross-entropy inalenga kuainisha kila pikseli kwa usahihi, na Dice loss inalenga mwingiliano wa jumla kati ya eneo linalotabiriwa na eneo halisi.
Modeli hutengeneza maski kadhaa za wagombea kwa picha moja. Wakati wa mafunzo, mgombea anayolingana vyema zaidi na maski halisi huchaguliwa:
\[ \mathcal{L}_{\mathrm{total}}=\min_{j\in\{1,\ldots,M\}}\{\mathcal{L}_{\mathrm{mask}}(P_j,Y)\} \]
Hapa:
- M ni idadi ya maski wagombea.
- Pj ni utabiri wa namba j.
- Y ni maski halisi ya segmentesheni.
Seti ya data ya HeteroMedSeg
Watafiti walikusanya takribani vipande 20.000 vya picha za kitabibu za pande mbili kutoka vyanzo vya umma na kutengeneza seti ya majaribio inayoitwa HeteroMedSeg.
Seti hiyo ina modality nane:
- Eksirei,
- Dermoscopy,
- Tomografia ya kompyuta,
- Picha ya fundus ya jicho,
- Upigaji picha wa mwangwi wa sumaku,
- Ultrasound,
- Endoscopy,
- Colonoscopy.
Kielelezo 4 kinaonyesha kuwa idadi ya sampuli si sawa kati ya modality. Usambazaji huu unaweza kufanya modeli ipokee ishara nyingi zaidi za mafunzo kutoka modality zenye sampuli nyingi.
Majina ya picha yaliandaliwa kwa muundo “Modalite-Görev Varlığı” ili modeli iweze kuchanganua msimbo wa modality na muktadha wa anatomia kutoka jina la faili.
Data ziligawanywa kuwa:
- Yüzde 70 mafunzo,
- Yüzde 15 validation,
- Yüzde 15 test
.
Maandishi hayatoi maelezo ya kina kama mgawanyo ulifanywa kwa kiwango cha mgonjwa, kipande cha picha au seti chanzo. Ikiwa vipande vinavyofuatana vya mgonjwa yuleyule vitaangukia sehemu tofauti, data leakage inaweza kutokea; hivyo maelezo haya ni muhimu kwa kuaminika kwa utendaji wa modeli.
Usindikaji wa awali
Picha zote zilibadilishwa ukubwa kuwa 256×256 pikseli.
Katika picha za BT, Hounsfield units zilikatwa katika:
\[ -150 \leq \mathrm{HU} \leq 250 \]
na kisha zikafanyiwa normalisation ya mstari.
Dirisha hili linaelekea kwenye tishu laini. Hata hivyo, baadhi ya ishara za mfupa, mapafu au tishu zenye density ndogo sana zinaweza kupotea wakati wa ukataji huu.
Katika MRG na modality nyingine, thamani za pikseli ziliwekwa katika:
\[ 0 \leq x \leq 1 \]
.
Wakati wa mafunzo:
- Random scaling kati ya 0,9-1,1,
- Random flipping
ilitumika.
Mipangilio ya mafunzo
| Programu | PyTorch |
|---|---|
| Vifaa | Mazingira ya NVIDIA GPU; modeli ya GPU haikutajwa |
| Optimisation | AdamW |
| Learning rate ya mwanzo | 1 × 10⁻⁴ |
| Weight decay | 0,01 |
| Ratiba ya learning rate | Cosine annealing |
| Ukubwa wa mini-batch | 24 |
| Muda wa mafunzo | Epoch 50 |
| Ukaguzi wa pruning | Epoch za 8., 16. na 24. |
Kutotaja modeli ya GPU, random seeds na idadi ya kurudia majaribio hufanya iwe vigumu kutathmini kwa kujitegemea muda wa mafunzo na utofauti wa matokeo.
Vipimo vya tathmini
Dice Similarity Coefficient: Huonyesha kiwango ambacho maski iliyotabiriwa inaingiliana na maski halisi. Kadiri thamani inavyokaribia moja, ndivyo ulinganifu wa kieneo unavyoongezeka.
HD95: Hupima asilimia ya 95 ya umbali wa pande mbili kati ya mpaka uliotabiriwa na mpaka halisi. Thamani ndogo inaonyesha ulinganifu bora wa mpaka. Kwa kuondoa asilimia 5 ya makosa makali zaidi, huwa imara zaidi dhidi ya pikseli moja yenye kelele kuliko Hausdorff distance ya kawaida.
Idadi ya parameta: Huonyesha kiwango cha uhifadhi na uwezo unaofunzwa wa modeli. Kwa Hetero-MedSAM, thamani iliyoripotiwa inalenga parameta za marekebisho zinazofunzwa.
FLOP: Huonyesha takribani idadi ya floating-point operations katika forward pass moja.
FPS: Ni idadi ya picha zinazochakatwa kwa sekunde. Katika utafiti ilipimwa kwenye CPU Intel Xeon E5-2680 v4.
Kwa nini wataalamu hawakuongezwa kwenye tabaka zote?
Kisimbaji picha cha MedSAM kina block 12 za Transformer. Watafiti kwanza walijaribu kuweka wataalamu kwenye tabaka zote.
Modeli heterojeni ya tabaka zote ilipata:
\[ \mathrm{DSC}=0{,}8428 \]
.
Matokeo haya yalikuwa chini ya alama 0,8567 ya MedSegX ya tabaka zote yenye wataalamu homojeni na chini ya muundo wa mwisho wa Hetero-MedSAM.
Watafiti walitafsiri hili kama ifuatavyo:
- Tabaka za juu juu hutoa vipengele vya msingi vya kingo na texture.
- Kuongeza njia nyingi zenye miundo tofauti katika tabaka za mwanzo kunaweza kuvuruga uwakilishi wa msingi uliojifunzwa kabla.
- Njia heterojeni zinaweza kuzalisha gradients zenye ukubwa na mwelekeo tofauti na kuongeza migongano kati ya kazi.
- Katika tabaka za kina, vipengele vya anatomia na kisemantiki huwa thabiti zaidi.
- Marekebisho maalumu ya kazi na wataalamu katika tabaka hizi yanaweza kuwa na usumbufu mdogo.
Matokeo haya yanaonyesha kuwa moduli nyingi zaidi si lazima zitoe utendaji bora moja kwa moja.
Majaribio ya idadi na nafasi ya tabaka
Utafiti ulijaribu mipangilio mingi yenye wataalamu kwenye tabaka moja, mbili, tatu, nne na tano.
Mipangilio mingi ya tabaka za juu juu au mchanganyiko haikupita kikomo cha Dice 0,83. Mipangilio ya tabaka za kina ilitoa matokeo bora.
Matokeo muhimu:
| Mpangilio | Tabaka | DSC | Parameta mwanzo → mwisho |
|---|---|---|---|
| Tabaka tatu za kina | 6, 9, 11 | 0,8534 | 4,20M → 4,05M |
| Tabaka nne za kina | 6, 7, 9, 11 | 0,8644 | 4,63M → 4,40M |
| Tabaka tano za kina | 6, 7, 8, 9, 11 | 0,8600 | 5,05M → 4,69M |
Mpangilio wa tabaka nne ulipata matokeo ya juu kuliko modeli ya tabaka tano huku ukitumia parameta chache. Kwa hiyo, sehemu nne za kuweka wataalamu zilichaguliwa kwa modeli ya mwisho.
Kwa nini tabaka 6, 7, 9 na 11 zilichaguliwa?
Watafiti walilinganisha mchanganyiko 15 tofauti wa tabaka nne katika eneo la kina.
Matokeo bora yaliripotiwa kuwa:
\[ [6,7,9,11] \rightarrow \mathrm{DSC}=0{,}8644 \]
.
Muundo huu una block tatu za window attention na block moja ya global attention. Waandishi wanautafsiri kama ushirikiano wa “eneo la karibu kwanza, kisha jumla”:
- Window attention katika tabaka 6., 7. na 9. huchakata miundo ya eneo la karibu.
- Wataalamu hukamilisha vipengele vya kipimo na kingo za eneo la karibu.
- Global attention katika tabaka 11. huunganisha muktadha mpana wa anatomia.
- Moduli ya mwisho ya mtaalamu huchangia kuunganisha vipengele vya eneo la karibu katika kiwango cha jumla.
Utendaji wa kulinganisha
| Modeli | DSC ↑ | HD95 ↓ | Parameta (M) ↓ | FLOP (G) ↓ | FPS ↑ |
|---|---|---|---|---|---|
| MedSAM | 0,8037 | 7,50 | 93,74 | 371,99 | 0,23 |
| SwinLite-MedSAM | 0,8112 | 7,85 | 14,29 | 101,05 | 2,25 |
| LiteMedSAM | 0,8150 | 7,47 | 9,79 | 74,95 | 1,68 |
| Med-FastSAM | 0,8234 | 6,85 | 26,41 | 94,15 | 2,17 |
| Rep-MedSAM | 0,8295 | 6,19 | 9,28 | 50,85 | 2,92 |
| MedSegX, 6-7-9-11 | 0,8455 | 5,72 | 4,50 | 69,54 | 4,69 |
| MedSegX, block zote | 0,8567 | 5,43 | 5,41 | 69,95 | 3,87 |
| Hetero-MedSAM | 0,8644 | 5,37 | 4,40 | 69,61 | 4,42 |
Hetero-MedSAM ilipata Dice ya jumla ya juu zaidi na HD95 ya chini zaidi katika modeli zilizolinganishwa. Kwa FPS, MedSegX ya eneo husika ilikuwa haraka kidogo.
Jedwali hili linaonyesha kwamba modeli si bora peke yake katika kila kipimo; badala yake inatoa uwiano kati ya usahihi, ubora wa mpaka, kiwango cha parameta na kasi.
Thamani ya FLOP ni kubwa kuliko Rep-MedSAM. Kwa hiyo, neno “nyepesi” halimaanishi kuwa modeli ina thamani ndogo zaidi katika kila kipimo cha kihesabu.
Utendaji kulingana na modality
Kielelezo 5 kinalinganisha MedSAM, MedSegX ya tabaka zote na Hetero-MedSAM katika kiwango cha modality.
Kulingana na tafsiri ya utafiti, Hetero-MedSAM ilionyesha matokeo mazuri kwenye:
- MRG,
- Picha za fundus,
- Eksirei,
- Dermoscopy,
- Modality nyingine
.
Katika BT, matokeo ya MedSegX yalikuwa juu kidogo kuliko Hetero-MedSAM. Hii inaonyesha kwamba wastani mmoja wa jumla haumaani ubora katika modality zote.
Evolution ya wataalamu kwa modality
Jedwali 5 linaonyesha namna uzani wa wataalamu ulivyobadilika kadiri mafunzo yalivyoendelea. Katika hatua ya mwisho, mtaalamu mmoja tu kati ya wataalamu watatu wa kimofolojia alihifadhiwa katika kila tabaka lililochaguliwa.
| Modality | Tabaka 6 | Tabaka 7 | Tabaka 9 | Tabaka 11 |
|---|---|---|---|---|
| BT | Kipimo | Muktadha | Kipimo | Kingo |
| Endoscopy | Muktadha | Kingo | Kingo | Muktadha |
| Dermoscopy | Kingo | Kingo | Kingo | Kipimo |
| MRG | Muktadha | Kipimo | Muktadha | Muktadha |
Mifumo hii inaendana na lengo la usanifu:
- Katika BT, mtaalamu wa kipimo alihifadhiwa mara nyingi kwa sababu ukubwa wa malengo hutofautiana.
- Katika endoscopy, wataalamu wa kingo na muktadha walijitokeza pamoja kutokana na mipaka isiyo wazi na muktadha mpana wa eneo.
- Katika dermoscopy, mtaalamu wa kingo alitawala kwa sababu ya kontua zisizo za kawaida za vidonda.
- Katika MRG, mtaalamu wa muktadha alihifadhiwa kwenye tabaka nyingi kwa sababu maeneo yaliyotengana yalihitaji kutambuliwa pamoja.
Mifano ya segmentesheni ya ubora
Kielelezo 6 kinalinganisha hali nne ngumu za kliniki:
- Kidonda kidogo kwenye BT,
- Mpaka usio wazi kwenye endoscopy,
- Topolojia isiyo ya kawaida kwenye dermoscopy,
- Maeneo ya lengo yaliyotengana kwenye MRG.
Kulingana na watafiti, Hetero-MedSAM ilipunguza kulainisha kupita kiasi kwa mipaka katika dermoscopy; katika MRG ilitambua vizuri zaidi maeneo madogo yaliyotengana nje ya eneo kuu la lengo.
Hata hivyo, katika mfano wa MRG imeelezwa kwamba kutenga uwezo zaidi kwa muktadha wa jumla kunaweza kupunguza kidogo ulinganifu wa eneo la karibu katika eneo kuu kubwa. Hii inaonyesha kuwa modeli inafanya biashara kati ya ukamilifu wa jumla na ulinganifu wa pikseli wa eneo la karibu.
Utafiti wa ablation ulionyesha nini?
Mchango wa kila mtaalamu ulitathminiwa kwa kuongeza vipengele vya modeli hatua kwa hatua.
| Muundo | DSC ↑ | HD95 ↓ |
|---|---|---|
| Mtaalamu Anayetambua Kipimo pekee | 0,8312 | 6,72 |
| Kipimo + Kingo | 0,8338 | 6,01 |
| Kipimo + Kingo + Muktadha | 0,8452 | 5,86 |
| Wataalamu wote wanne | 0,8551 | 5,49 |
| Wataalamu wanne + evolutionary pruning | 0,8644 | 5,37 |
Kila kipengele kilichoongezwa kiliongeza Dice na kupunguza kosa la mpaka. Pruning haikupunguza modeli tu, bali pia iliboresha utendaji.
Watafiti wanaeleza hili kwa uwezekano kwamba kuondoa matawi yenye mchango mdogo hupunguza migongano ya vipengele kati ya wataalamu na overfitting.
Hata hivyo, ablation ilifanywa kwa mpangilio mmoja tu wa kuongeza vipengele. Mchanganyiko wote unaowezekana, kama mtaalamu wa kingo pekee au mtaalamu wa muktadha pekee, haukuripotiwa. Kwa hiyo mchango huru wa kila mtaalamu hauwezi kutenganishwa kikamilifu.
Nguvu za utafiti
- Marekebisho yenye ufanisi wa parameta yalifanywa juu ya uti wa mgongo uliogandishwa badala ya kufunza MedSAM yote upya.
- Badala ya kurudia muundo mmoja, kazi nne tofauti za wataalamu zinazokamilishana zilibuniwa.
- Maudhui ya picha yalitumika pamoja na modality, kiungo na taarifa ya kazi ya kliniki katika routing.
- Nafasi ya tabaka ilichunguzwa kwa majaribio mengi ya ablation.
- Michango ya wataalamu ilifuatiliwa wakati wote wa mafunzo na njia zenye mchango mdogo zilikatwa kimwili.
- Ubora wa mpaka ulipimwa kwa HD95 pamoja na mwingiliano wa eneo.
- Parameta, FLOP na kasi ya CPU ziliripotiwa pamoja.
- Modality nane tofauti zilitumika.
- Utafiti wa ablation ulionyesha mchango wa hatua kwa hatua wa vipengele.
- Imeelezwa kuwa msimbo unapatikana kwa umma.
Mapungufu ya utafiti
Hakuna mapitio ya wenza: Utafiti ni preprint na bado haujapitiwa na wataalamu huru wa kisayansi.
Hakuna uthibitisho halisi wa kliniki: Modeli haijajaribiwa kwenye data ya wagonjwa ya mbele, mtiririko wa kawaida wa kliniki au chini ya uangalizi wa daktari.
Tafsiri ya idadi ya parameta “nyepesi”: Thamani ya milioni 4,40 inayoripotiwa inalenga parameta za marekebisho zinazofunzwa. Uti wa mgongo wa MedSAM uliogandishwa haujaondolewa kwenye modeli.
Hakuna jaribio halisi kwenye kifaa cha mwisho: FPS ilipimwa kwenye CPU ya kiwango cha seva Intel Xeon E5-2680 v4. Hakuna vipimo kwenye simu, ultrasound inayobebeka, embedded GPU au terminali ya kliniki yenye nguvu ndogo.
Matumizi yote ya kumbukumbu hayakuripotiwa: RAM, kumbukumbu ya GPU, ukubwa wa faili ya modeli, matumizi ya nishati na usambazaji wa latency havikuripotiwa.
Maelezo ya mgawanyo wa data ni machache: Haijaelezwa kama train, validation na test ziligawanywa kwa kiwango cha mgonjwa au seti chanzo.
Data hazina uwiano: Idadi ya sampuli katika modality nane si sawa. Wastani wa jumla unaweza kuathiriwa zaidi na modality zenye sampuli nyingi.
Jaribio huru la nje ni dogo: Utafiti hauonyeshi seti ya kliniki huru kabisa ya hospitali nyingi ambayo haikushiriki katika maendeleo ya modeli.
Kutokuwa na uhakika wa takwimu hakuripotiwi: Hakuna standard deviation, confidence interval au usambazaji wa majaribio yenye random seeds tofauti kwa DSC na HD95.
Maelezo ya GPU hayapo: Modeli ya NVIDIA GPU na vifaa vya mafunzo havijatajwa, hivyo muda wa mafunzo hauwezi kulinganishwa kikamilifu.
Hyperparameters za pruning zilichaguliwa kwa mkono: Hakuna uchanganuzi mpana wa sensitivity kwa kizingiti 0,01 na ukaguzi katika epoch 8., 16. na 24.
Nafasi ya tabaka haikuchaguliwa kiotomatiki: Mpangilio bora wa 6, 7, 9 na 11 ulipatikana kwa skani ya ablation ya mkono.
Uwezo wa kubadilika kwa kila sampuli hupungua baada ya pruning: Baada ya wataalamu kuzimwa kimwili, hawawezi kuwashwa tena kwa picha nyingine inayoweza kuhitaji tawi hilo.
Ukosefu wa uwazi kuhusu mtaalamu wa nne: Uzani wa mtaalamu wa modality umewekwa kuwa 1, lakini fomula ya pruning inajumuisha wataalamu wanne na jedwali la evolution linaonyesha watatu tu.
Kutokulingana kwa mchoro wa usanifu: Mchoro wa mtaalamu wa kipimo unaonyesha matawi yote matatu kuwa R=1, lakini milinganyo inaweka dilation 1, 2 na 3.
Itifaki ya box prompt haijaelezwa kwa kina: Haijaelezwa jinsi box prompt zilivyotengenezwa kutoka maski halisi, kiasi cha randomness na usahihi unaohitajika wakati wa test.
Njia ya vipande vya pande mbili: Seti ya data ina vipande vya picha. Mwendelezo wa ujazo wa pande tatu na taarifa ya vipande jirani haitumiki moja kwa moja.
Matokeo ya kliniki hayajapimwa: Dice ya juu haimaanishi moja kwa moja utambuzi sahihi zaidi, upasuaji salama zaidi au matokeo bora kwa mgonjwa.
Utafiti unasema nini, na haussemi nini?
| Kauli inayoungwa mkono na utafiti | Kauli isiyoungwa mkono na utafiti |
|---|---|
| Wataalamu heterojeni waliboresha matokeo ya segmentesheni katika seti hii ya majaribio. | Hetero-MedSAM ndiyo modeli bora katika hospitali zote na picha zote za kitabibu. |
| Kuweka wataalamu katika tabaka za kina kulikuwa bora kuliko tabaka za juu juu. | Wataalamu lazima wawe katika tabaka za kina pekee katika usanifu wote unaowezekana. |
| Evolutionary pruning ilipunguza idadi ya parameta na kuboresha utendaji. | Pruning lazima iboreshe usahihi katika kila seti ya data. |
| Modeli ilirekebishwa kwa parameta zinazofunzwa milioni 4,40. | Modeli nzima iliyosambazwa ina parameta milioni 4,40 pekee. |
| Jaribio la CPU lilipata 4,42 FPS. | Imethibitishwa kuwa itafanya kazi real-time kwenye kila kifaa kinachobebeka au chenye nguvu ndogo. |
| DSC 0,8644 na HD95 5,37 zilipatikana. | Modeli inaweza kutumika salama katika maamuzi ya utambuzi na matibabu ya kliniki. |
| Routing ya wataalamu ilionyesha mifumo tofauti kwa modality tofauti. | Uzani wa wataalamu hutoa maelezo ya moja kwa moja ya kibayolojia au kliniki. |
| Matokeo mazuri yalipatikana kwenye data za umma za modality nyingi. | Generalization kati ya hospitali na vifaa tofauti imethibitishwa kikamilifu. |
Umuhimu kwa mtazamo wa zamani, sasa na baadaye
Kwa mtazamo wa zamani: Juhudi za kupunguza modeli katika segmentesheni ya picha za kitabibu zililenga zaidi kubadilisha kisimbaji kikubwa kuwa uti mdogo au kutumia adapter ileile kwa kazi zote. Hetero-MedSAM inajaribu kuonyesha kwamba hata adapter nyepesi zinaweza kuwa na utaalamu tofauti wa kiutendaji.
Kwa mtazamo wa sasa: Utafiti unaonyesha kwamba modeli kubwa ya msingi inaweza kurekebishwa kwa modality tofauti bila kufunza uzani wote upya, na mpangilio sahihi wa wataalamu unaweza kuboresha uwiano wa usahihi na kasi.
Kwa mtazamo wa baadaye: Njia hii inaweza kusaidia utafiti katika:
- Neural architecture search inayotafuta kiotomatiki mahali pa kuweka wataalamu,
- Routing nyepesi zaidi inayobadilika kwa kila picha,
- Kurekebisha kwa ujazo wa kitabibu wa pande tatu,
- Uthibitisho wa nje kwa kiwango cha mgonjwa na hospitali,
- Jaribio la generalization kati ya vifaa vya watengenezaji tofauti,
- Vipimo vya nishati kwenye embedded hardware na vifaa vinavyobebeka,
- Kuripoti kutokuwa na uhakika wa segmentesheni,
- Segmentesheni shirikishi yenye marekebisho ya daktari,
- Ubunifu wa wataalamu maalumu kwa vidonda vidogo sana na vyenye contrast ndogo,
- Kuboresha uelezekaji wa maamuzi ya wataalamu.
Maana kwa maisha ya kila siku na huduma za afya
Uwezo wa modeli ya picha za kitabibu kufanya kazi kwenye vifaa vinavyobebeka unaweza, kwa nadharia, kusaidia picha kuchakatwa si katika vituo vikubwa vya data pekee bali pia kwenye terminali za chumba cha upasuaji, vifaa vya ultrasound vinavyobebeka, kompyuta za hospitali zenye vifaa vichache au vituo vya afya vya mbali.
Segmentesheni ya haraka inaweza:
- Kuharakisha kazi ya vipimo ya radiologist.
- Kusaidia kuhesabu ujazo wa kidonda kiotomatiki.
- Kutengeneza rasimu ya kwanza ya kontua za radiotherapy.
- Kurahisisha kuonyesha miundo ya anatomia katika upangaji wa upasuaji.
Hata hivyo, uwezekano huu haujaonyeshwa kliniki katika utafiti. Matumizi ya modeli katika huduma halisi za wagonjwa yanahitaji usalama wa data, uchanganuzi wa makosa, uthibitisho kwenye vifaa tofauti, uangalizi wa kliniki, tathmini ya udhibiti na tafiti za kliniki za mbele.
Mbinu na Matokeo ya Utafiti
Muundo wa kiufundi wa utafiti
| Aina ya utafiti | Utengenezaji wa modeli ya kihesabu na ulinganisho wa segmentesheni ya modality nyingi |
|---|---|
| Modeli ya msingi | MedSAM |
| Njia ya marekebisho | Fine-tuning yenye ufanisi wa parameta na mixture of heterogeneous experts |
| Moduli kuu | Heterogeneous Contextual Mixture of Experts, HeCon-MoAE |
| Idadi ya wataalamu | Aina nne za wataalamu wa kiutendaji |
| Mpangilio wa mwisho | Tabaka za Transformer 6, 7, 9 na 11 |
| Seti ya data | HeteroMedSeg |
| Idadi ya picha | Takribani vipande 20.000 vya pande mbili |
| Idadi ya modality | Nane |
| Ukubwa wa picha | 256 × 256 pikseli |
| Tathmini | DSC, HD95, parameta, FLOP na FPS |
Mtiririko mkuu wa kihisabati wa modeli
Muunganisho wa muktadha:
\[ C_{\mathrm{all}}=\mathrm{Concat}(E_m,E_a,E_t,\bar{X}) \]
Routing ya wataalamu watatu wa kwanza:
\[ [w_1,w_2,w_3]^T=\mathrm{Softmax}(W_g\sigma(W_{in}C_{\mathrm{all}})) \]
Sharti la uzani:
\[ \sum_{i=1}^{3}w_i=1,\qquad w_4=1 \]
Muunganisho wa wataalamu na uti wa mgongo:
\[ Y=\mathrm{MLP}(X)+s\left(\sum_{i=1}^{3}w_iE_i(X)+w_4E_4(X)\right) \]
Alama ya mchango inayosogea:
\[ S_{\mathrm{avg}}^{(t)}=(1-\lambda)S_{\mathrm{avg}}^{(t-1)}+\lambda\mathrm{Mean}(w^{(t)}),\quad\lambda=0{,}1 \]
Kizingiti cha pruning:
\[ \tau=0{,}01 \]
Hasara iliyounganishwa:
\[ \mathcal{L}_{\mathrm{mask}}=\mathcal{L}_{\mathrm{BCE}}+\mathcal{L}_{\mathrm{Dice}} \]
Matokeo yaliyoripotiwa ya modeli ya mwisho
| Kipimo | Matokeo ya Hetero-MedSAM | Maana |
|---|---|---|
| DSC | 0,8644 | Mwingiliano mkubwa wa kieneo kati ya maski iliyotabiriwa na halisi |
| HD95 | 5,37 | Upotovu wa mpaka wa chini zaidi kati ya modeli zilizolinganishwa |
| Parameta | milioni 4,40 | Kiwango kilichoripotiwa cha parameta za marekebisho zinazofunzwa |
| FLOP | bilioni 69,61 | Mzigo wa takribani wa kihesabu katika forward pass moja |
| Kasi ya CPU | 4,42 FPS | Kasi iliyoripotiwa kwenye Intel Xeon E5-2680 v4 |
Tofauti dhidi ya MedSAM ya msingi
| Kipimo | MedSAM | Hetero-MedSAM | Mabadiliko kamili |
|---|---|---|---|
| DSC | 0,8037 | 0,8644 | +0,0607 |
| HD95 | 7,50 | 5,37 | -2,13 |
| FLOP | 371,99 G | 69,61 G | -302,38 G |
| FPS | 0,23 | 4,42 | +4,19 FPS |
Matokeo ya hatua kwa hatua ya mchango wa wataalamu
| Hatua | DSC | HD95 |
|---|---|---|
| Mtaalamu wa kipimo | 0,8312 | 6,72 |
| + Mtaalamu wa kingo | 0,8338 | 6,01 |
| + Mtaalamu wa muktadha | 0,8452 | 5,86 |
| + Mtaalamu wa modality | 0,8551 | 5,49 |
| + Evolutionary pruning | 0,8644 | 5,37 |
Mchakato unaoelezwa kwa pamoja na vielelezo
- Kielelezo 1: Kinaonyesha jinsi moduli za HeCon-MoAE zinavyounganishwa na uti wa mgongo wa MedSAM.
- Kielelezo 2: Kinaonyesha mti wa maarifa ya anatomia kutoka mwili wa binadamu hadi kazi ya kliniki ya segmentesheni.
- Kielelezo 3: Kinafafanua mtandao wa routing na usanifu wa ndani wa matawi manne ya wataalamu.
- Kielelezo 4: Kinaonyesha kuwa usambazaji wa sampuli katika modality nane si sawa.
- Kielelezo 5: Kinalinganisha matokeo ya modeli katika BT, MRG, fundus, eksirei, dermoscopy na makundi mengine.
- Kielelezo 6: Kinaonyesha tofauti za ubora wa segmentesheni katika kidonda kidogo, mpaka usio wazi, topolojia isiyo ya kawaida na maeneo yaliyotengana.
Hitimisho la kiufundi
Majaribio ya utafiti yanaonyesha kwamba MedSAM inaweza kurekebishwa kwa njia za wataalamu zenye kazi tofauti bila kufunza tena uti wote wa mgongo. Matokeo ya juu zaidi yalipatikana wataalamu walipowekwa si kwenye kila tabaka, bali kwenye block maalumu za kina ambako vipengele vya kisemantiki vya kiwango cha juu hutengenezwa.
Evolutionary pruning haikupunguza tu idadi ya parameta kwa kuondoa matawi yenye mchango mdogo; pia iliboresha DSC na HD95, pengine kwa kupunguza migongano ya vipengele kati ya wataalamu.
Hata hivyo, matokeo haya hayaonyeshi kwamba Hetero-MedSAM iko tayari kwa matumizi ya kliniki au ni bora katika kazi zote za segmentesheni ya picha za kitabibu. Matokeo yanatumika kwa seti maalumu ya data iliyokusanywa na mpangilio wa majaribio ulioripotiwa na watafiti.
Maelezo ya Chanzo na Mbinu
Maudhui haya yanategemea utafiti “Hetero-MedSAM: A Lightweight Medical Image Segmentation Framework Based on Heterogeneous Mixture of Experts and Evolutionary Pruning” ulioandaliwa na Lieqiang Liu na Chengping Zhao.
Chanzo ni makala ya utafiti ya preprint iliyopo SSRN na iliyoandaliwa kwa ajili ya kuwasilishwa Elsevier. Maandishi yana kauli iliyo wazi “This preprint research paper has not been peer reviewed”. Kwa hiyo, utafiti haujapitia mapitio huru ya kisayansi ya wenza. Hakuna taarifa ya kukubaliwa na jarida au DOI katika maandishi.
Utafiti huu si jaribio la kliniki, jaribio la uingiliaji wa mgonjwa au utafiti wa usalama wa kifaa cha kitabibu. Ni utafiti wa utengenezaji wa modeli ya kihesabu na ulinganisho wa segmentesheni uliofanywa kwenye vyanzo vya umma vya picha za kitabibu.
Imeelezwa kuwa picha za kitabibu zilitoka kwenye vyanzo vya umma vilivyothibitishwa na kwa hiyo hakukuwa na haja ya idhini ya ziada ya maadili. Waandishi hawakuripoti mgongano wa maslahi.
Data zimeripotiwa kupatikana kwenye folda ya Google Drive na msimbo kwenye repository ya GitHub iliyotajwa katika utafiti. Hata hivyo, uzalishaji upya kamili wa matokeo unaweza kuhitaji maelezo yaliyo wazi zaidi kuhusu mgawanyo wa data, utengenezaji wa prompt, random seeds, modeli ya GPU na baadhi ya vipengele vya usanifu.
Parameta milioni 4,40 zilizoripotiwa zinawakilisha kiwango cha marekebisho kinachofunzwa. Uti wa mgongo wa MedSAM uliogandishwa bado hutumika wakati wa inference. Kwa hiyo, utafiti hauonyeshi kwamba modeli nzima huhifadhiwa kwa parameta milioni 4,40 pekee au itafanya kazi kwenye kila kifaa chenye nguvu ndogo.
Jaribio la kasi ya CPU lilifanywa kwenye Intel Xeon E5-2680 v4. Hakuna kipimo cha utendaji kilichoripotiwa kwenye ultrasound inayobebeka, embedded processor, simu, terminali ya kliniki yenye nguvu ndogo au kifaa halisi cha kitabibu cha edge.
Dice ya juu na HD95 ya chini zinaonyesha utendaji wa segmentesheni; si ushahidi wa usahihi wa utambuzi, mafanikio ya matibabu, usalama wa upasuaji au kuboresha matokeo ya mgonjwa.
Makala hii imeandaliwa kwa kutegemea pekee maelezo ya usanifu, fomula, mchakato wa maandalizi ya data, majedwali, grafu, ablations, matokeo ya kulinganisha, mapungufu na tafsiri za waandishi katika preprint iliyopakiwa. Hakuna madai ya mafanikio ya kliniki, idhini ya udhibiti, utendaji wa real-time wa kifaa au manufaa kwa mgonjwa ambayo hayapo kwenye PDF yaliyoongezwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *