

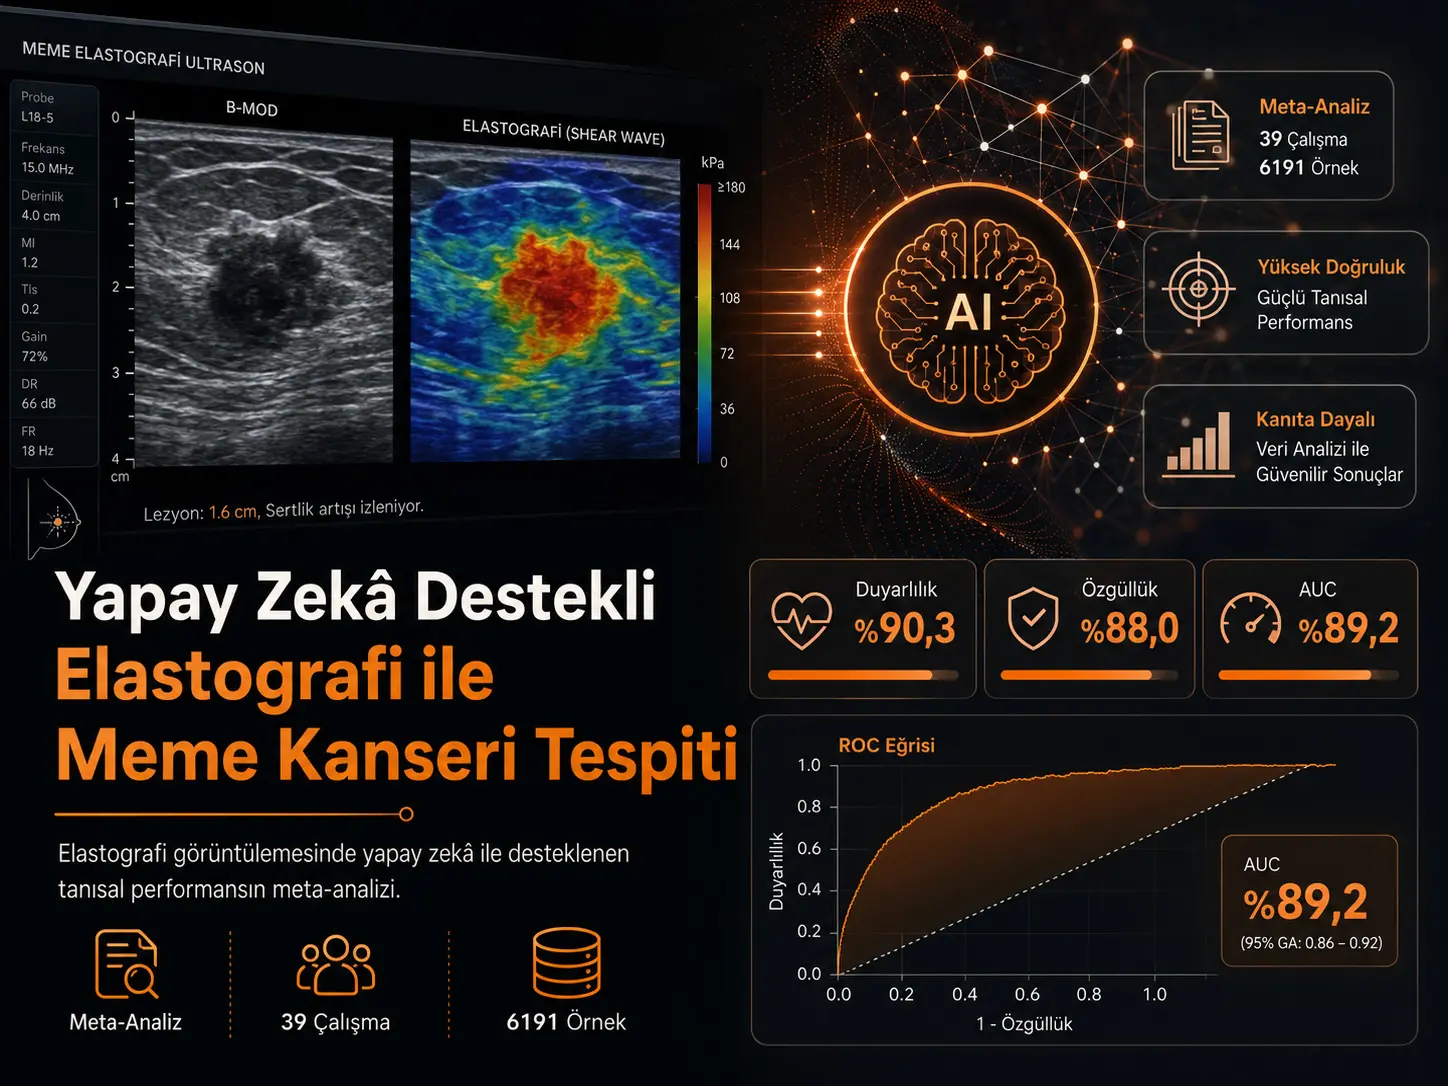
Mapitio haya ya kimfumo na meta-uchambuzi yalitathmini usahihi wa ultrasonografia elastografia inayosaidiwa na akili bandia katika kutofautisha vidonda visivyo vya saratani na vya saratani ya matiti. Tafiti 39 zilizochaguliwa kutoka rekodi 501 zilizobainishwa katika hifadhidata tano za kitaaluma, zikiwa na jumla ya vidonda 6191 vilivyothibitishwa kwa biopsy, zilichambuliwa. Katika meta-uchambuzi mkuu uliotumia modeli zilizofanya vizuri zaidi, sensitivity iliyounganishwa ya elastografia inayosaidiwa na akili bandia ilikuwa %90,3, specificity %88,0 na eneo chini ya ROC curve (AUC) %89,2. Hata hivyo, heterogeneity kati ya tafiti ilikuwa kubwa (I2=%78,0), Egger test ya publication bias ilikuwa significant (p=0,001), na tafiti nyingi zilitumia data za training au data kutoka source population ileile badala ya independent external validation. Kwa hiyo, ingawa matokeo yanaunga mkono ultrasonografia elastografia inayosaidiwa na akili bandia kama njia yenye matumaini ya kusaidia uchunguzi, viwango hivi vya performance haviwezi kutafsiriwa kama usahihi unaohakikishwa katika matumizi halisi ya kliniki.
Ultrasonografia elastografia (ultrasound elastography, UE) hutumia sifa za deformation au stiffness za tishu. Tafiti zilizochunguzwa zilitathmini uainishaji wa vidonda vya matiti kwa kuingiza taarifa hizi za picha katika modeli za akili bandia. Meta-uchambuzi ulichunguza kwa vikundi vidogo tofauti mifumo inayotumia elastografia pekee, mbinu zinazochanganya B-mode ultrasound na elastografia, mbinu tofauti za segmentation, data augmentation, cross-validation, classical machine learning na deep learning models.
| Matokeo makuu | Thamani iliyounganishwa | %95 confidence interval | Tafsiri |
|---|---|---|---|
| Sensitivity | %90,3 | %86,4–93,1 | Makadirio yaliyounganishwa ya uwezo wa kutambua kesi malignant kama positive. |
| Specificity | %88,0 | %83,6–91,4 | Makadirio yaliyounganishwa ya uwezo wa kutambua kesi negative/benign kama negative. |
| Positive likelihood ratio (pLR) | 7,5 | 5,4–10,5 | Inaonyesha uwezekano wa jamaa wa positive test result kuonekana katika kesi malignant ikilinganishwa na benign. |
| Negative likelihood ratio (nLR) | 0,110 | 0,078–0,156 | Thamani ndogo zaidi inahusishwa na negative result kuonekana mara chache katika malignancy. |
| Diagnostic odds ratio (DOR) | 68,3 | 42,3–110,1 | Kipimo cha diagnostic discrimination kinachofupisha sensitivity na specificity pamoja. |
| AUC | %89,2 | %86,7–91,3 | Inaonyesha discrimination performance iliyounganishwa. |
Verianla Live: Matokeo makuu ya diagnostic performance ya meta-uchambuzi
Grafu inaonyesha sensitivity, specificity na AUC pekee, ambazo zinaweza kulinganishwa kwa maana kwenye asilimia scale ileile. Kwa sababu pLR, nLR na DOR zina statistical scales tofauti, hazijajumuishwa katika visualization hii.
| Kipimo | Thamani (%) | %95 confidence interval |
|---|---|---|
| Sensitivity | 90,3 | 86,4–93,1 |
| Specificity | 88,0 | 83,6–91,4 |
| AUC | 89,2 | 86,7–91,3 |
Thamani hizi ni meta-analytic estimates zilizotokana na modeli zilizofanya vizuri zaidi katika tafiti 39; haziwakilishi performance ya mfumo mmoja wa akili bandia.
Swali kuu la utafiti lilikuwa nini?
Watafiti walichunguza kiwango cha usahihi wa ultrasonografia elastografia inayosaidiwa na akili bandia katika kuainisha saratani ya matiti, na jinsi usahihi huo unavyoathiriwa na chaguo za kimetodolojia kama aina ya AI model, segmentation method, data augmentation, cross-validation, dataset ambayo model ilitathminiwa, na kuongezwa kwa B-mode ultrasound kwenye elastografia.
Lengo la utafiti si swali la “AI ina usahihi gani?” pekee. Meta-uchambuzi pia unauliza ni katika experimental conditions zipi model performance za juu zilipatikana. Tofauti hii ni muhimu kwa sababu model inayofanya vizuri kwenye training data haihakikishiwi kufanya kwa kiwango kilekile kwenye picha kutoka hospitali tofauti au patient populations tofauti.
Ultrasonografia elastografia hupima nini?
Ultrasonografia elastografia ni imaging approach inayotumia mechanical properties za tishu kutoa taarifa kuhusu deformation au stiffness. Utafiti wa chanzo unasisitiza familia mbili kuu za elastografia: strain elastography (SE) na shear wave elastography (SWE). SE hutathmini deformation ya tishu kwa qualitative au semi-quantitative manner chini ya compression inayotumika kutoka nje; SWE hutoa quantitative stiffness measurements zaidi kutokana na propagation ya shear waves ndani ya tishu.
Katika meta-uchambuzi, AI processing ya elastography images ilitathminiwa kupitia tafiti zinazojumuisha hatua tofauti kama preprocessing, lesion segmentation, feature extraction na benign–malignant classification. Modeli zilizochunguzwa ni pamoja na artificial neural networks, convolutional neural networks, deep neural networks, support vector machines, logistic regression, random forest, fuzzy methods na hybrid approaches mbalimbali.
Tafiti 39 zilipatikana vipi?
Utafiti ulifuata extension ya PRISMA kwa diagnostic test accuracy studies. Protocol ilisajiliwa PROSPERO kwa nambari CRD42018091176. PubMed, CINAHL, Embase, Scopus na Web of Science zilitafutwa tangu kuanzishwa kwake; search ilisasishwa tarehe 22 Juni 2025.
Verianla Live: Mchakato wa uchaguzi wa tafiti wa PRISMA
Mtiririko unaonyesha jinsi watafiti walivyotoka kwenye database search ya awali hadi tafiti 39 zilizojumuishwa katika meta-uchambuzi.
| Hatua | Idadi ya rekodi/tafiti | Maelezo |
|---|---|---|
| Rekodi zilizobainishwa katika hifadhidata | 501 | Zilipatikana kutoka utafutaji wa PubMed, Embase, Scopus, Web of Science na CINAHL. |
| Rekodi zilizochunguzwa baada ya kuondoa duplicates | 256 | Duplicate records 245 ziliondolewa kupitia Rayyan. |
| Rekodi zilizoondolewa katika title na abstract screening | 195 | Rekodi ambazo hazikutimiza preliminary eligibility criteria ziliondolewa. |
| Tafiti zilizotathminiwa kwa full text | 61 | Ziliingizwa katika full-text review kwa eligibility. |
| Tafiti zilizoondolewa katika full-text stage | 22 | Tafiti zisizotimiza vigezo ziliondolewa, zikiwemo abstract-only mbili, duplicates tatu na foreign-language study moja. |
| Tafiti zilizojumuishwa katika meta-uchambuzi | 39 | Kundi la mwisho la diagnostic accuracy synthesis. |
Katika methods section imeelezwa kwamba search strategy haikuwa na date au language restriction, lakini eligibility criteria zinajumuisha kigezo cha kuondoa foreign-language publications. PRISMA flow pia inaonyesha kwamba utafiti mmoja uliondolewa kwa sababu ya lugha ya kigeni. Hii ni tofauti ya wazi ya method statement ndani ya source study na haipaswi kupuuzwa wakati wa kuwasilisha matokeo.
Muundo wa tafiti ulikuwaje?
Tafiti zilizojumuishwa zilichapishwa kati ya 2008–2025. Kati ya tafiti 39, 23 zilikuwa retrospective na 16 prospective. Sample sizes zilianzia vidonda 40 hadi 1000 na uchambuzi wa jumla ulijumuisha vidonda huru 6191 vilivyothibitishwa kwa biopsy. %43,0 ya vidonda katika meta-uchambuzi viliainishwa malignant.
Kwa segmentation, tafiti 14 zilitumia automatic, 13 manual, 11 no segmentation na utafiti mmoja semi-automatic approach. Tafiti nne pekee zilitumia data augmentation. Tafiti ishirini na saba zilitumia cross-validation, wakati katika tafiti 12 njia hii haikuripotiwa.
Ukosefu wa uwiano katika namna ya model evaluation ni muhimu sana. Tafiti ishirini na tisa ziliripoti model performance kwa data katika training stage; tafiti 10 tu zilitumia validation au external validation data. Kulingana na sehemu ya study characteristics, real external validation ilitumika katika tafiti mbili tu. Kwa hiyo, high pooled performance ya meta-uchambuzi si matokeo ya pamoja ya modeli 39 tofauti ambazo zote zimethibitishwa katika independent patient populations.
Quality na publication bias vilionyesha nini?
Katika QUADAS-2-based assessment, idadi ya methodological safeguards katika tafiti ilitofautiana kutoka 7 hadi 12, ikiwa na wastani wa 10,1. Watafiti walitumia taarifa hii kurekebisha study weights katika quality effects model.
Kulikuwa na heterogeneity kubwa kati ya tafiti: I2=%78,0. Thamani hii ni tahadhari muhimu kwamba patient characteristics, ultrasound systems, elastography techniques, model architectures, image-processing steps na validation designs hazikuwa sawa. Funnel plot ilionyesha slight positive asymmetry na Egger test ilikuwa p=0,001. Waandishi walitafsiri hii kama ishara ya publication bias ambapo small studies zinazoripoti high diagnostic performance zinaweza kuwa na uwezekano mkubwa wa kuchapishwa.
Kwa nini matokeo ya training set ni muhimu sana?
Moja ya subgroup findings zinazoonekana zaidi inahusu stage ambayo model ilitathminiwa. Katika tafiti 29 zilizotathminiwa wakati wa training, sensitivity ilikuwa %92,2, specificity %89,2 na AUC %90,8; katika validation na external-validation group, sensitivity ilishuka hadi %83,0, specificity %84,6 na AUC %83,8. Waandishi wa source study wanahusisha tofauti hii na uwezekano kwamba evaluations zilizo karibu na training data zinaweza kuonyesha model performance kwa matumaini kuliko ilivyo kweli.
Verianla Live: Performance ya training stage dhidi ya validation/external validation
Comparison inaonyesha kwamba data stage ambayo model inatathminiwa inahusiana kwa nguvu na reported diagnostic performance. Makundi si arms za randomized experiment; haiwezi kuhitimishwa kwamba evaluation stage ndiyo sababu pekee ya tofauti.
| Performance metric | Training stage (%) | Validation / external validation (%) |
|---|---|---|
| Sensitivity | 92,2 | 83,0 |
| Specificity | 89,2 | 84,6 |
| AUC | 90,8 | 83,8 |
Training group ina tafiti 29 na samples 4911; validation/external validation group ina tafiti 10 na samples 1280.
Matokeo yanayoungwa mkono na utafiti
- Katika literature iliyochunguzwa, AI-assisted ultrasound elastography ilionyesha pooled diagnostic performance ya kiwango cha kati hadi juu katika kutofautisha benign na malignant breast lesions.
- Katika best-model analysis, pooled sensitivity ni %90,3, specificity %88,0 na AUC %89,2.
- Automatic au no-segmentation approaches zilionyesha pooled specificity ya juu kuliko manual/semi-automatic segmentation group.
- Pooled sensitivity ya studies zilizotumia cross-validation ilikuwa juu kuliko group isiyotumia cross-validation.
- High performance ilionekana katika tafiti nne zilizotumia data augmentation; hata hivyo confidence intervals ni pana kwa sababu subgroup hii ni ndogo.
- Classical machine learning na hybrid models zilionyesha pooled results zinazokaribiana na neural-network/deep-learning group, na kidogo juu katika baadhi ya metrics, katika meta-uchambuzi huu.
- Model performance ilipokaribia independent validation, high results zilizoonekana katika training stage zilishuka kwa kiasi kikubwa.
Matokeo ambayo utafiti hauungi mkono au haujathibitisha
- Haijathibitishwa kwamba AI-assisted elastography ni bora kuliko experienced radiologists; waandishi wanaeleza wazi ukosefu wa direct na sufficient head-to-head comparisons.
- Haijaonyeshwa kwamba AI-assisted elastography inaweza kuchukua nafasi ya mammography, biopsy au existing clinical diagnostic systems.
- High performance katika meta-uchambuzi haimaanishi accuracy ileile itapatikana katika hospitali zote, ultrasound devices zote na patient populations zote.
- Kwa kuwa subgroup differences si randomized comparisons, hazithibitishi kwamba segmentation method fulani, data augmentation au model type fulani husababisha performance increase.
- Utafiti haukupima kama matumizi ya AI yanapunguza mortality katika screening programs au kuboresha long-term patient outcomes.
- Kiwango ambacho idadi ya biopsies inaweza kupunguzwa katika real clinical practice hakiwezi kubainishwa moja kwa moja kutoka meta-uchambuzi huu.
- Pooled diagnostic accuracy values si performance ya single product au single model iliyo tayari kwa clinical deployment.
Inapaswa kutafsiriwaje kwa mtazamo wa Uturuki?
Meta-uchambuzi ulijumuisha prospective study moja kutoka Uturuki; hata hivyo sehemu kubwa ya total dataset inatoka nchi tofauti na hasa Asian populations. Kwa hiyo sensitivity ya %90,3 au specificity ya %88,0 haiwezi kuwasilishwa kama performance inayotarajiwa moja kwa moja katika health institution ya Uturuki. Source study yenyewe inasisitiza kwamba differences katika patient populations, device manufacturers, imaging protocols na ukosefu wa external validation hupunguza generalizability.
Mbinu na Matokeo ya Utafiti
Diagnostic accuracy meta-analysis ilifanywaje?
Watafiti walitoa true positive (TP), false positive (FP), true negative (TN) na false negative (FN) values kutoka studies zilizojumuishwa, au wakazikokotoa upya kutoka reported sensitivity na specificity. Multi-class results zilibadilishwa kuwa binary structure ya malignant na benign.
Katika studies ambazo virtual sample count iliongezeka kutokana na data augmentation au cross-validation, TP, FP, FN na TN values zilirekebishwa kwa original sample size. Hii ililenga kuzuia artificially multiplied samples kupata disproportionate weight katika meta-analysis.
Ikiwa study iliripoti model zaidi ya moja, model iliyopendekezwa na authors au yenye highest diagnostic accuracy ilichaguliwa kwa main analysis. Ingawa approach hii inalenga kutathmini potential ya available technologies, watafiti wanakubali kwamba inaweza kusababisha optimistic model-selection bias inayosukuma matokeo juu.
Statistical method iliyotumika
Quality effects model ilitumiwa kujumuisha study quality katika synthesis. Split component synthesis (SCS) ilitumika kwa sensitivity, specificity, positive na negative likelihood ratios, diagnostic odds ratio na AUC. Heterogeneity ilitathminiwa kwa I2 statistic, na small-study/publication bias kwa funnel plot na Egger regression test. Analyses zilifanywa kwa Stata 16 na “diagma” module.
Basic formulas za diagnostic metrics zinategemea concepts hizi:
\[ Duyarlılık=\frac{TP}{TP+FN} \]
\[ Özgüllük=\frac{TN}{TN+FP} \]
Sensitivity inaonyesha ni malignant cases ngapi zimeainishwa positive na test; specificity inaonyesha ni benign/negative cases ngapi zimeainishwa kwa usahihi kuwa negative.
Matokeo ya jumla ya meta-uchambuzi
| Parameter | Result | %95 confidence interval |
|---|---|---|
| Idadi ya tafiti | 39 | — |
| Jumla ya samples/lesions | 6191 | — |
| Malignant lesion proportion | %43,0 | — |
| Sensitivity | %90,3 | %86,4–93,1 |
| Specificity | %88,0 | %83,6–91,4 |
| pLR | 7,5 | 5,4–10,5 |
| nLR | 0,110 | 0,078–0,156 |
| DOR | 68,3 | 42,3–110,1 |
| AUC | %89,2 | %86,7–91,3 |
| Heterogeneity | I2=%78,0 | — |
| Egger test | p=0,001 | — |
Segmentation approach ilileta tofauti kiasi gani?
Tafiti 14 zilizotumia manual au semi-automatic segmentation zilikuwa na samples 2210, wakati tafiti 25 zilizotumia automatic au no explicit segmentation zilikuwa na samples 4081. Sensitivities zilikuwa karibu sana: %90,2 na %90,7 mtawalia. Lakini specificity ilikuwa %81,9 katika manual/semi-automatic group na %91,1 katika automatic/no-segmentation group. AUC values zilikuwa %86,6 na %90,9 mtawalia.
| Segmentation | Tafiti | Samples | Sensitivity (%) | Specificity (%) | DOR | AUC (%) |
|---|---|---|---|---|---|---|
| Manual + semi-automatic | 14 | 2210 | 90,2 | 81,9 | 41,9 | 86,6 |
| Automatic + no segmentation | 25 | 4081 | 90,7 | 91,1 | 100,3 | 90,9 |
Source text inaeleza kwamba specificity ya %91,1 huongeza uwezekano wa “correctly classifying malignant lesions”. Hata hivyo, kulingana na standard diagnostic definition inayotumika katika makala yenyewe, specificity ni \(TN/(TN+FP)\) na inaelezea correct classification ya negative/benign samples. Kwa hiyo terminological inconsistency hii katika source imeandikwa wazi hapa.
Data augmentation na cross-validation
Tafiti nne tu zilizotumia data augmentation zilikuwa na samples 926 kwa jumla. Pooled sensitivity ya group hii ilikuwa %92,2 na specificity %92,4. Katika tafiti 35 zisizotumia data augmentation, corresponding values zilikuwa %89,9 na %87,4. Hata hivyo, kwa sababu data-augmentation group ilikuwa na tafiti nne tu, confidence intervals zilikuwa pana; waandishi wanasisitiza kwamba stability ya finding hii inapaswa kutafsiriwa kwa tahadhari.
Katika tafiti 27 zilizotumia cross-validation, sensitivity ilikuwa %92,4 na specificity %88,3; katika tafiti 12 zisizotumia cross-validation zilikuwa %86,4 na %87,3 mtawalia. Matokeo haya yanaendana na pooled performance ya juu kuonekana pamoja na cross-validation; lakini study-level subgroup comparison haithibitishi kwamba cross-validation pekee ndiyo imesababisha tofauti hii.
Nini kilitokea B-mode ultrasound ilipoongezwa kwenye elastografia?
Katika tafiti 17 zilizotumia elastografia pekee, sensitivity ilikuwa %88,3, specificity %89,5 na AUC %88,9. Katika tafiti 22 zilizochanganya B-mode ultrasound na elastografia, sensitivity iliongezeka hadi %91,8 na AUC hadi %89,5, huku specificity ikishuka hadi %86,5. Kwa hiyo, licha ya interpretation ya source study inayopendelea bimodal approach, subgroup results hazionyeshi kwamba metrics zote za diagnostic performance ziliboreshwa kwa direction ileile: sensitivity na AUC ziko juu, specificity iko chini.
| Imaging input | Tafiti | Samples | Sensitivity (%) | Specificity (%) | AUC (%) |
|---|---|---|---|---|---|
| Elastografia pekee | 17 | 2538 | 88,3 | 89,5 | 88,9 |
| B-mode ultrasound + elastografia | 22 | 3653 | 91,8 | 86,5 | 89,5 |
Classical machine learning dhidi ya deep learning
Katika tafiti 16 za neural-network na deep-learning group, sensitivity ilikuwa %90,3, specificity %86,9, DOR 61,7 na AUC %88,7. Katika tafiti 23 za classical machine learning na hybrid models, sensitivity ilikuwa %90,4, specificity %89,0, DOR 76,1 na AUC %89,7. Katika meta-uchambuzi huu, deep-learning models ngumu zaidi hazikuonyesha automatically higher pooled diagnostic performance.
| Model group | Tafiti | Samples | Sensitivity (%) | Specificity (%) | DOR | AUC (%) |
|---|---|---|---|---|---|---|
| Neural networks na deep learning | 16 | 3175 | 90,3 | 86,9 | 61,7 | 88,7 |
| Classical machine learning na hybrid models | 23 | 3016 | 90,4 | 89,0 | 76,1 | 89,7 |
Katika discussion text ya makala, specificity ya classical machine-learning group imeandikwa %86,9 sehemu moja. Lakini main results Table 2 inatoa specificity ya group hii kuwa %89,0 na ya neural-network/deep-learning group kuwa %86,9. Kwa hiyo jedwali hapo juu limehifadhi values kutoka main results table ya source study.
Athari ya kuchagua “best model” ilikaguliwa?
Kwa sababu main analysis ilitumia best model katika kila study, watafiti pia walifanya sensitivity analysis kwa kutumia eligible model datasets zote zilizotolewa. Katika analysis hii sensitivity ilikuwa %88,1 (%95 GA %85,4–90,4), na specificity %88,2 (%95 GA %85,5–90,5), na waandishi waliripoti kwamba results hazikuwa statistically significantly different kutoka best-model cohort. Hata hivyo, optimistic bias inayoweza kutokana na kuchagua highest-performing model katika main analysis inapaswa kubaki miongoni mwa study limitations.
Vikwazo vikuu kwa matumizi halisi ya kliniki
Source study inaorodhesha changamoto kuu za clinical translation ya AI-assisted elastography kuwa tofauti za ultrasound manufacturers na devices, probe frequencies, proprietary signal-processing algorithms, imaging depth, compression inayotumika katika strain elastography, probe orientation, region selection, patient populations na histopathological sampling.
Pia inasisitizwa kwamba breast tissue si homogeneous, isotropic na linearly elastic; heterogeneity, anisotropy na viscoelastic behavior zinaweza kuathiri elastography measurements. Waandishi wanataja physics-based modeling, kuchanganya finite-element methods na AI, detailed tissue-mechanics modeling na multicenter external validation kama future research directions.
Kwa hiyo ujumbe mkuu wa meta-uchambuzi hauwezi kurahisishwa kuwa “AI hugundua saratani ya matiti kwa usahihi wa %90”. Utafiti unaunganisha literature kutoka algorithms na clinical conditions tofauti sana, na katika conclusion unaweka AI-assisted elastography si kama independent definitive diagnostic tool bali kama potential adjunct diagnostic tool.
Maelezo ya Chanzo na Mbinu
| Kichwa kamili cha asili cha utafiti | Artificial Intelligence-Aided Detection of Breast Cancer Using Elastography: A Meta-Analysis of Diagnostic Test Accuracy |
|---|---|
| Waandishi | Ibrahim Elmakaty; Ruba Abdo; Amr Ouda; Mohamed Elmarasi; Mohamed Elahtem; Yaman Khamis; Mohammed Imad Malki |
| Mchango sawa | Ibrahim Elmakaty na Ruba Abdo walichangia kwa kiwango sawa. |
| Mwandishi anayewajibika | Mohammed Imad Malki |
| Taasisi | College of Medicine, QU Health, Qatar University; Department of Medical Education, Hamad Medical Corporation; Department of Basic Medical Sciences, College of Medicine, QU Health, Qatar University, Doha, Qatar. |
| Aina ya chanzo | Systematic review na meta-analysis ya diagnostic test accuracy. |
| Hali ya peer review | Utafiti uliochapishwa katika peer-reviewed journal; si preprint. |
| Jarida | AI |
| Mchapishaji | MDPI |
| Volume / issue / article | 2026, 7(3), 107 |
| DOI | 10.3390/ai7030107 |
| Tarehe ya kupokelewa | 27 Desemba 2025 |
| Marekebisho | 20 Januari 2026 |
| Kukubaliwa | 27 Januari 2026 |
| Kuchapishwa | 12 Machi 2026 |
| Kiungo rasmi | https://doi.org/10.3390/ai7030107 |
| Leseni | Creative Commons Attribution (CC BY) open-access license. |
| Usajili wa protocol | PROSPERO CRD42018091176 |
Ufadhili na mgongano wa maslahi
Waandishi waliripoti kwamba utafiti haukupokea specific external grant kutoka public, commercial au nonprofit funding bodies. Hata hivyo, Qatar University internal grant QUCG-CMED-25/26-750 ilitajwa kwa Mohammed Imad Malki, na article processing charge ililipwa na QU Health, Qatar University.
Ibrahim Elmakaty, Ruba Abdo, Amr Ouda na Mohamed Elmarasi walitajwa kuwa wanafanya kazi katika Hamad Medical Corporation. Waandishi walitangaza kwamba utafiti ulifanywa bila commercial au financial relationships ambazo zingeweza kuunda conflict of interest.
Upatikanaji wa data
Evaluation metrics za best AI models zilizotumiwa katika main analysis zimetolewa katika Table 1 ya makala. Additional datasets zilizozalishwa au kuchambuliwa wakati wa utafiti zimeripotiwa kuwa zinaweza kupatikana kutoka corresponding author kwa reasonable request.
Michango ya waandishi
Ibrahim Elmakaty na Ruba Abdo walichangia data curation, formal analysis, investigation, methodology, initial draft na review/editing. Amr Ouda na Mohamed Elmarasi walichangia data curation na writing; Mohamed Elahtem na Yaman Khamis walichangia data curation na review. Mohammed Imad Malki alifanya conceptualization, investigation, methodology, supervision, initial draft na review/editing, na alikuwa responsible kwa final decision ya kuwasilisha makala kwa publication.
Muhtasari wa mapungufu ya kimetodolojia
- Kuna high heterogeneity kati ya studies: I2=%78,0.
- Egger test ni significant kwa publication bias/small-study effects: p=0,001.
- Tafiti nyingi zilizojumuishwa ni retrospective.
- External validation ni limited sana; kulingana na study characteristics, tafiti mbili tu zilitumia external validation.
- Modeli nyingi zilitathminiwa katika training stage au kwa data kutoka source population ileile.
- Kwa sababu main analysis ilichagua best model ya kila study, kuna uwezekano wa optimistic selection bias.
- Tafiti zinatoka hasa Asian populations na global generalizability ni limited.
- Ultrasound devices, image-acquisition protocols, elastography methods na preprocessing approaches hazikuwa standardized.
- Operator-dependent factors kama compression na probe orientation hazikuweza kudhibitiwa.
- Direct na systematic comparison na experienced radiologists haitoshi.
- Subgroup sizes hazina uwiano; hasa data-augmentation group ina tafiti nne tu.
- Meta-analysis haikupima moja kwa moja patient outcomes, mortality au real reduction in biopsies katika clinical screening pathways.
Kwa hitimisho, utafiti unaonyesha kwamba AI-assisted ultrasound elastography ina potential kubwa katika classification ya breast lesions; lakini kiwango cha evidence cha sasa hakitoshi kuikubali kama independent clinical diagnostic system. Pendekezo la mwisho la waandishi ni kuongeza real external validation pamoja na large, prospective na multicenter studies zinazotumia standardized protocols.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *