

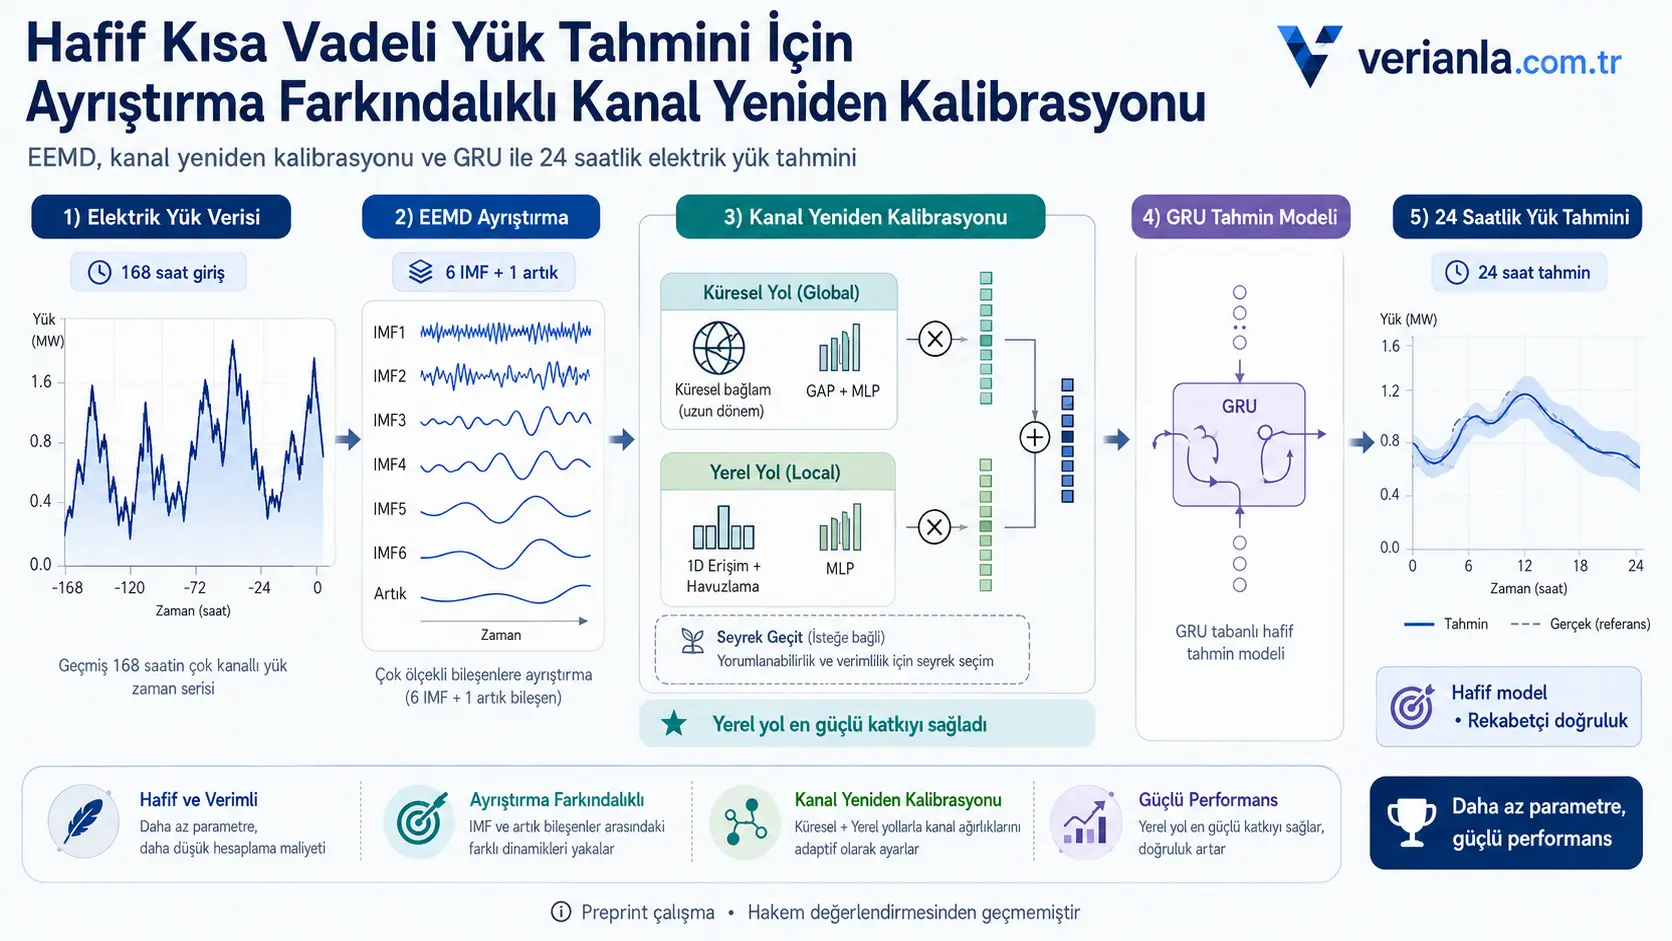
Utafiti huu uliunganisha utenganishaji unaotegemea EEMD, urekebishaji upya wa chaneli na modeli ya GRU ili kuboresha usahihi wa utabiri wa mzigo wa umeme wa saa 24 zijazo bila kutegemea usanifu mkubwa wa Transformer. Modeli ilitumia data ya mzigo ya saa 168 zilizopita kutabiri saa 24 zinazofuata; ilitathminiwa kwenye GEFCom2014 na seti ndogo nne za data za PJM kwa mianzo mitano tofauti ya nasibu. Kwenye GEFCom2014, modeli kamili yenye lango lenye uchache ilifikia MAPE ya %7,90, huku modeli ya LocalOnly inayotumia njia ya urekebishaji wa ndani pekee ikitoa MAPE ya chini zaidi ya %7,76. Hata hivyo, matokeo ya PJM yanaonyesha kuwa modeli haikuwa bora katika maeneo yote na kwa vipimo vyote, na kwamba urekebishaji upya wa chaneli haukutoa faida yenye maana katika majaribio ya EEMD ya kisababishi mtandaoni.
Mbinu kuu ya utafiti ni kuutenganisha mfululizo changamano wa mzigo kuwa vipengele vinavyowakilisha viwango tofauti vya muda na kupima upya umuhimu wa vipengele hivyo kabla havijaingia kwenye modeli ya utabiri. Ensemble Empirical Mode Decomposition, yaani Utenganishaji wa Modi Empiriki wa Kundi (EEMD), uliutenganisha mfululizo wa mzigo kuwa fungsi sita za modi asilia na kipengele kimoja cha mwenendo wa mabaki. Njia za jumla na za ndani za chaneli kisha zilijifunza ni vipengele gani vilivyotenganishwa, halijoto au sifa za muda zilikuwa na manufaa zaidi kwa utabiri.
Katika jaribio la GEFCom2014, modeli ya EEMD-DCA-GRU-SG yenye lango lenye uchache ilipata MAPE ya %7,90 kwa vigezo 167,5 elfu vinavyofundishika. Modeli ya Informer ilitoa %8,36 kwa vigezo 2,41 milioni, huku PatchTST ikitoa MAPE ya %8,49 kwa vigezo 615,5 elfu. Hitilafu ya chini zaidi ya benchmark katika utafiti haikutolewa na modeli kamili iliyounganishwa, bali na lahaja ya LocalOnly inayotumia ushahidi wa ndani wa muda pekee. Matokeo haya yanaonyesha kuwa baada ya utenganishaji, mifumo ya ndani ya muda mfupi inaweza kuwa na nguvu zaidi kuliko wastani wa jumla katika kuamua umuhimu wa chaneli.
Kwa mtazamo wa Türkiye, mbinu hii inatoa njia nyepesi ya uundaji modeli inayoweza kuchunguzwa kwa kutenganisha mfululizo wa mzigo wa ndani unaotumika katika upangaji wa usambazaji na uzalishaji wa umeme katika viwango tofauti vya muda. Hata hivyo, utafiti haukufanywa kwenye mfumo wa umeme wa Türkiye. Haiwezekani kuhitimisha mafanikio ya uendeshaji bila mafunzo na uthibitishaji tofauti kwa kutumia halijoto, sikukuu, matumizi ya kikanda, wasifu wa viwanda na hali za gridi nchini Türkiye. Hasa kwa matumizi ya mtandaoni, EEMD inapaswa kutekelezwa kwa namna ya kisababishi kwa kutumia tu data iliyopatikana hadi wakati wa utabiri, na modeli ifundishwe upya kwa itifaki hiyo hiyo.
Swali kuu la utafiti ni lipi?
Utafiti unalenga swali hili: EEMD inayotenganisha mfululizo wa mzigo wa umeme katika viwango vingi vya muda ikiunganishwa na upimaji upya wa uzito kwa chaneli, je, utabiri wa muda mfupi wa mzigo unaweza kufanywa kwa usahihi na uthabiti zaidi bila kuhitaji modeli kubwa za Transformer?
Utabiri wa muda mfupi wa mzigo ni muhimu kwa michakato kama mgawanyo wa kiuchumi wa mzigo, upangaji wa vitengo vya uzalishaji, uendeshaji wa soko la umeme, upangaji bei na usimamizi wa upande wa mahitaji. Hata hivyo, matumizi ya umeme hubeba ndani ya mfululizo mmoja mizunguko ya kila siku na kila wiki pamoja na mabadiliko ya halijoto, matukio yasiyo ya kawaida na mitikisiko ya masafa tofauti. Kuunda modeli ya mfululizo mbichi kama kitu kimoja kunaweza kusababisha mitikisiko ya haraka na mienendo ya polepole kufichana.
Ni pengo gani katika fasihi lililolengwa?
Utafiti unalenga matatizo matatu ya kiufundi:
- Kwa sababu mfululizo mbichi wa mzigo una mienendo ya kila siku, kila wiki, inayotegemea hali ya hewa na isiyo ya kawaida kwa wakati mmoja, kujifunza moja kwa moja muundo wa viwango vingi kunaweza kuwa vigumu.
- Mbinu za utenganishaji kama EEMD huzalisha IMF nyingi na chaneli saidizi; kuchukulia chaneli zote kuwa sawa kunaweza kuongeza athari ya vipengele vyenye kelele au vyenye taarifa dhaifu.
- Modeli zinazotegemea Transformer zinaweza kutoa uwezo mkubwa wa uwakilishi, lakini gharama za vigezo na ukokotoaji zinaweza kuwa juu zaidi.
Mfumo uliopendekezwa unalenga kujibu matatizo haya matatu kwa pamoja kwa kuunganisha utenganishaji wa vipengele kwa EEMD na urekebishaji upya mwepesi wa chaneli na kichwa cha utabiri cha GRU chenye tabaka mbili.
Mtiririko wa jumla wa kazi wa modeli umeundwaje?
Mchoro wa usanifu katika utafiti unaonyesha mlolongo huu wa uchakataji:
- Mzigo mbichi wa umeme na sifa saidizi zilizopo huchukuliwa.
- Mfululizo wa mzigo hutenganishwa kwa EEMD kuwa IMF sita na kipengele kimoja cha mabaki.
- Halijoto na sifa za muda wa mzunguko huongezwa kwenye chaneli zilizotenganishwa.
- Urekebishaji upya wa chaneli wa jumla, wa ndani au uliounganishwa hutekelezwa.
- Lango laini lenye uchache la hiari hukandamiza chaneli dhaifu.
- GRU yenye tabaka mbili huzalisha vekta ya mzigo ya saa 24 zinazofuata baada ya saa 168 zilizopita.
Mchoro wa usanifu unaonyesha kuwa urekebishaji upya wa chaneli umewekwa kabla ya GRU. Hivyo, badala ya kupokea vipengele vyote kwa uzito sawa, GRU hufanya kazi kwenye mfuatano wa sifa ambazo umuhimu wake umewekwa na modeli.
Tatizo la utabiri limefafanuliwaje kihisabati?
Mudat thamani ya mzigo katika wakati lt, urefu wa dirisha la ingizo L = 168saa na upeo wa utabiriH = 24 saa. Vekta lengwa ni kama ifuatavyo:
\[ \mathbf{y}_t = [l_{t+1},l_{t+2},\ldots,l_{t+H}]^{\mathsf{T}} \in \mathbb{R}^{H} \]
Vekta hii inawakilisha kwa pamoja thamani 24 za mzigo baada ya wakati wa utabiri. Dirisha la data ya kihistoria lenye chaneli nyingi ni kama ifuatavyo:
\[ \mathbf{X}_{t-L+1:t} = [\mathbf{x}_{t-L+1},\mathbf{x}_{t-L+2},\ldots,\mathbf{x}_{t}] \in \mathbb{R}^{C \times L} \]
HapaC idadi ya chaneli, L inaonyesha idadi ya saa za nyuma zinazotumiwa kwa kila chaneli. Tokeo la modeli:
\[ \hat{\mathbf{y}}_t = f_{\theta}(\mathbf{X}_{t-L+1:t}) \in \mathbb{R}^{H} \]
limewasilishwa kwa usemi huu. fθ, ni modeli ya utabiri yenye vigezo vinavyoweza kujifunzwa θ; alama ya kofia inaonyesha thamani iliyotabiriwa na modeli.
Wakati wa mafunzo, kosa la wastani la mraba la upeo mwingi lilipunguzwa:
\[ \mathcal{L}(\theta)=\frac{1}{BH}\sum_{i=1}^{B}\sum_{h=1}^{H}(y_{i,h}-\hat{y}_{i,h})^2 \]
B ukubwa wa mini-batch, H ni idadi ya saa zinazotabiriwa. Kosa la mraba huadhibu zaidi mikengeuko mikubwa ya utabiri. Katika utafiti, ukubwa wa mini-batch uliwekwa kuwa 64.
Utenganishaji wa EEMD hufanya nini?
EEMD hutenganisha ishara ya mzigo kuwa fungsi za modi asilia za masafa na viwango tofauti vya muda:
\[ l_t=\sum_{k=1}^{K}c_k(t)+r(t) \]
Hapack(t), k fungsi ya modi asilia yenye nambari r(t) inaonyesha kipengele cha mabaki au mwenendo unaobadilika polepole. Katika utafiti, K = 6 ilichaguliwa, hivyo IMF sita na chaneli moja ya mabaki zilihifadhiwa.
Mchakato huu unaweza kufananishwa na kuchunguza wimbi moja changamano kwa kutenganisha mitikisiko ya haraka, mizunguko ya kiwango cha kati na mienendo ya polepole. Katika grafu ya mfano ya utenganishaji wa saa 720, IMF1 inaonyesha mabadiliko ya masafa ya juu na kiwango kidogo, IMF3 mienendo ya vipindi vya kiwango cha kati, IMF5 mitikisiko ya polepole zaidi, na kipengele cha mabaki mwenendo wa jumla wa mzigo. Ili kudumisha usomaji wa grafu, si IMF zote zilizoonyeshwa.
Vekta ya sifa iliyoundwa kwa GEFCom2014 imefafanuliwa kama ifuatavyo:
\[ \mathbf{x}^{EEMD}_t=[c_1(t),\ldots,c_6(t),r(t),temp_t,a^0_t,h^{sin}_t,h^{cos}_t,w^{sin}_t,w^{cos}_t]^{\mathsf{T}}\in\mathbb{R}^{13} \]
Katika vekta hii, tempt inaonyesha taarifa ya halijoto, a0t inaonyesha chaneli ya uoanifu yenye thamani sifuri isiyobeba taarifa ya nje:
\[ a^0_t=0 \]
Lengo la chaneli sifuri ni kudumisha mpangilio uleule wa sifa saidizi kati ya majaribio; hakuna data ya nje iliyopakiwa kwenye chaneli.
Mizunguko ya saa na wiki imesimbwaje?
Saa na siku ya wiki hazikusimbwa kama nambari za kategoria, bali kwa namna ya mzunguko kwa jozi za sine na cosine:
\[ h^{sin}_t=\sin\left(\frac{2\pi\cdot hour_t}{24}\right), \qquad h^{cos}_t=\cos\left(\frac{2\pi\cdot hour_t}{24}\right) \]
\[ w^{sin}_t=\sin\left(\frac{2\pi\cdot weekday_t}{7}\right), \qquad w^{cos}_t=\cos\left(\frac{2\pi\cdot weekday_t}{7}\right) \]
Uwakilishi huu hupunguza tatizo la, kwa mfano, saa ya 23 ya siku na saa ya 0 kuonekana kuwa mbali kwa nambari. Sine na cosine zinapotumiwa pamoja, nafasi ya mzunguko wa siku au wiki huhifadhiwa katika vipimo viwili.
Njia ya jumla ya chaneli hufanyaje kazi?
Njia ya jumla huhesabu thamani ya wastani ya kila chaneli katika dirisha la ingizo la saa 168:
\[ s^g_c=\frac{1}{L}\sum_{\ell=1}^{L}X_{c,\ell} \]
Operesheni hii imeelezwa kama global average pooling, yaani uchukuaji wastani wa jumla:
\[ \mathbf{s}^{g}=GAP(\mathbf{X})\in\mathbb{R}^{C} \]
Kisha, projeksheni isiyo ya mstari yenye tabaka mbili huzalisha alama za chaneli:
\[ \mathbf{u}^{g}=\mathbf{W}^{g}_{2}\phi(\mathbf{W}^{g}_{1}\mathbf{s}^{g}+\mathbf{b}^{g}_{1})+\mathbf{b}^{g}_{2} \]
φ, ni fungsi ya uanzishaji ya ReLU. Njia ya jumla hufupisha kiwango cha jumla na tabia ya wastani ya kila chaneli katika dirisha lote; hata hivyo, haihifadhi moja kwa moja mahali hasa pa mifumo ya ndani ya muda mfupi.
Njia ya ndani ya chaneli hufanyaje kazi?
Njia ya ndani hutekeleza konvolusheni ya kipimo kimoja kwenye mhimili wa muda:
\[ \mathbf{H}^{l}=\phi(Conv1D(\mathbf{X}))\in\mathbb{R}^{C\times L} \]
Operesheni hii inalenga kutoa mifumo ya ndani ya muda kama ongezeko la ghafla, mzunguko mfupi au mtikisiko wa muda wa karibu. Tokeo la konvolusheni huwekwa wastani kwa muda:
\[ \mathbf{s}^{l}=GAP(\mathbf{H}^{l})\in\mathbb{R}^{C} \]
Alama ya chaneli ya ndani huhesabiwa kwa projeksheni nyingine yenye tabaka mbili:
\[ \mathbf{u}^{l}=\mathbf{W}^{l}_{2}\phi(\mathbf{W}^{l}_{1}\mathbf{s}^{l}+\mathbf{b}^{l}_{1})+\mathbf{b}^{l}_{2} \]
Kwa mujibu wa matokeo ya ablation, mchango mkubwa zaidi wa usahihi ulitoka kwenye njia hii ya ndani.
Taarifa za jumla na za ndani zimeunganishwaje?
Michango ya njia mbili iliunganishwa kwa skala inayoweza kujifunzwa:
\[ \alpha=\sigma(a) \]
\[ \mathbf{u}=\alpha\mathbf{u}^{g}+(1-\alpha)\mathbf{u}^{l} \]
σ ni fungsi ya sigmoid. α inapokaribia 1, njia ya jumla hutawala; inapokaribia 0, njia ya ndani hutawala zaidi. Thamani ya awali iliwekwa kwa kutanguliza njia ya ndani kwa kutegemea majaribio ya uthibitishaji; hata hivyo, wakati wa mafunzo uwiano wa njia hizo mbili uliruhusiwa kujifunzwa.
Lango zito la chaneli limewekewa ukomo katika nafasi ifuatayo:
\[ \mathbf{m}=\frac{1}{2}+\frac{1}{2}\sigma(\mathbf{u}), \qquad \mathbf{m}\in(0.5,1)^{C} \]
Ingizo lililorekebishwa upya:
\[ \tilde{\mathbf{X}}=\mathbf{X}\odot\mathbf{m} \]
ni kama ifuatavyo. ⊙, inaonyesha kuwa uzito wa chaneli unatumika kwa hatua zote za muda. Kwa kuwa kizidishi kinawekwa kati ya 0,5 na 1, mfumo badala ya kukuza chaneli au kubadilisha ishara yake, hudhoofisha kwa upole chaneli zinazobainishwa kuwa na manufaa kidogo.
Je, lango lenye uchache huondoa chaneli kabisa?
Hapana. Lango lenye uchache katika utafiti si uteuzi mgumu wa sifa unaopunguza chaneli hadi sifuri. Wakati wa mafunzo, kelele ya Gumbel hutumiwa:
\[ \epsilon\sim Gumbel(0,1) \]
Thamani ya lango lenye uchache:
\[ \mathbf{g}=\sigma\left(\frac{\mathbf{u}+b-\tau+\epsilon}{\gamma}\right) \]
huhesabiwa kwa usemi huu. Hapa b ni uhamisho unaoweza kujifunzwa, τ ni kizingiti cha uchache, γ ni kigezo cha halijoto.
Kizidishi cha lango laini:
\[ \mathbf{m}^{SG}=\frac{1}{2}+\frac{1}{2}\mathbf{g} \]
\[ \tilde{\mathbf{X}}_{SG}=\mathbf{X}\odot\mathbf{m}^{SG} \]
ni kama ifuatavyo. Kwa hiyo, hata chaneli dhaifu zaidi huhifadhiwa kwa kizidishi cha angalau 0,5. Kiwango cha uchache kimeripotiwa kama sehemu ya chaneli zenye thamani ya lango chini ya 0,5:
\[ S=\frac{1}{C}\sum_{c=1}^{C}\mathbb{I}(g_c<0.5) \]
Muundo huu unalenga kudumisha mtiririko wa gradient na kuzuia ufutaji wa sifa wenye ukali kupita kiasi huku ukitoa ukandamizaji wa chaneli unaoweza kufasiriwa.
Kichwa cha utabiri cha GRU hufanyaje kazi?
Matriki ya sifa zilizorekebishwa upya hubadilishwa kuwa mpangilio wa mfuatano wa muda:
\[ \tilde{\mathbf{X}}^{\mathsf{T}}\in\mathbb{R}^{L\times C} \]
GRU yenye tabaka mbili husasisha hali fiche katika kila hatua ya muda:
\[ \mathbf{h}_{\ell}=GRU(\tilde{\mathbf{x}}_{\ell},\mathbf{h}_{\ell-1}), \qquad \ell=1,\ldots,L \]
Hali fiche ya mwisho huonyeshwa kwa mstari kwenye nafasi ya matokeo ya saa 24:
\[ \hat{\mathbf{y}}_t=\mathbf{W}_{o}\mathbf{h}_{L}+\mathbf{b}_{o} \]
Kwa hivyo modeli hutabiri saa 24 tofauti ndani ya vekta moja ya matokeo ya hatua nyingi.
Ni seti gani za data zilizotumiwa?
| Seti ya data | Kipindi na wigo | Sifa zilizotumiwa | Lengo la jaribio |
|---|---|---|---|
| GEFCom2014 Zone 1 | Uchunguzi wa saa 50.376 kati ya 2005-2010 | Mzigo, halijoto, misimbo ya muda na vipengele vya EEMD | Usahihi na ufanisi wa vigezo kwenye benchmark ya kawaida |
| PJM-CE-pre | 2017-2019 | Taarifa za mzigo na muda | Uthabiti kwenye data halisi ya uendeshaji kabla ya janga |
| PJM-CE-post | 2023-2025 | Taarifa za mzigo na muda | Uthabiti kwenye data halisi ya uendeshaji baada ya janga |
| PJM-AEPOPT-pre | 2017-2019 | Taarifa za mzigo na muda | Kiwango tofauti cha mzigo na muundo wa kikanda |
| PJM-AEPOPT-post | 2023-2025 | Taarifa za mzigo na muda | Kipindi tofauti na muundo wa kikanda |
Maeneo ya PJM yaligawanywa katika vipindi viwili tofauti vinavyoendelea ili kuzuia madirisha yanayosogea kuvuka mapengo ya miaka mingi na kuepuka kuchanganya kipindi cha janga na vipindi vingine. Kila seti ndogo ilitathminiwa kwa kujitegemea.
Ingawa GEFCom2014 ina taarifa ya halijoto, hakuna kigezo cha hali ya hewa kilichotumiwa katika majaribio ya PJM. Utafiti unaripoti chaneli 13 za ingizo kwa modeli zinazotegemea EEMD; hata hivyo, katika majaribio ya PJM haijaelezwa tena kwa orodha ya kina ya chaneli jinsi chaneli ya halijoto ilivyobadilishwa hasa ndani ya mpangilio wa pamoja wa chaneli.
Vipimo vya utendaji vinamaanisha nini?
Kosa la wastani la asilimia kamili:
\[ MAPE=\frac{100}{NH}\sum_{i=1}^{N}\sum_{h=1}^{H}\left|\frac{y_{i,h}-\hat{y}_{i,h}}{y_{i,h}}\right| \]
MAPE huonyesha kosa la utabiri kama asilimia ya thamani halisi. Thamani ya chini ina maana utendaji bora.
Mzizi wa kosa la wastani la mraba:
\[ RMSE=\sqrt{\frac{1}{NH}\sum_{i=1}^{N}\sum_{h=1}^{H}(y_{i,h}-\hat{y}_{i,h})^2} \]
RMSE huadhibu makosa makubwa kwa nguvu zaidi kwa sababu ya operesheni ya mraba. Utafiti haujaeleza wazi katika jedwali kitengo halisi cha mzigo cha thamani za RMSE na MAE; kwa hiyo thamani hizo zinapaswa kutathminiwa katika kipimo cha data chanzo.
Kosa la wastani kamili:
\[ MAE=\frac{1}{NH}\sum_{i=1}^{N}\sum_{h=1}^{H}|y_{i,h}-\hat{y}_{i,h}| \]
Kigawo cha uamuzi:
\[ R^2=1-\frac{\sum_{i=1}^{N}\sum_{h=1}^{H}(y_{i,h}-\hat{y}_{i,h})^2}{\sum_{i=1}^{N}\sum_{h=1}^{H}(y_{i,h}-\bar{y})^2} \]
Kadiri R² inavyokaribia 1, modeli hueleza sehemu kubwa zaidi ya mabadiliko yaliyoonekana. R² hasi huonyesha kuwa modeli inaweza kufanya vibaya hata kuliko utabiri wa thamani ya wastani.
Uboreshaji wa jamaa dhidi ya modeli msingi ulihesabiwa kama ifuatavyo:
\[ RI=\frac{M_{baseline}-M_{model}}{M_{baseline}}\times100\% \]
HapaM, ni kipimo cha kosa kama MAPE, RMSE au MAE ambapo thamani ya chini inapendelewa.
Matokeo ya GEFCom2014 yanaonyesha nini?
Kwenye GEFCom2014, MAPE ya chini zaidi ya %7,76 ilipatikana katika modeli ya LocalOnly. Modeli kamili ya EEMD-DCA-GRU-SG yenye lango lenye uchache, ikiwa na MAPE ya %7,90, ilikuwa katika kundi la pili la matokeo yenye nguvu na ilizalisha kosa la chini kuliko modeli za EEMD-GRU, GRU, Informer na PatchTST.
| Modeli | MAPE (%) | RMSE | MAE | R² |
|---|---|---|---|---|
| NaiveMean | 26,59 ± 0,00 | 57,28 ± 0,00 | 45,07 ± 0,00 | -0,1848 |
| NaivePersistence | 24,34 ± 0,00 | 50,81 ± 0,00 | 38,18 ± 0,00 | 0,0676 |
| NaiveLastDay | 11,45 ± 0,00 | 26,11 ± 0,00 | 18,52 ± 0,00 | 0,7538 |
| XGBoost | 8,68 ± 0,00 | 20,98 ± 0,00 | 14,51 ± 0,00 | 0,8411 |
| GRU | 8,52 ± 0,08 | 20,47 ± 0,23 | 14,17 ± 0,15 | 0,8487 |
| LSTM | 9,24 ± 0,11 | 21,76 ± 0,25 | 15,37 ± 0,21 | 0,8290 |
| CNN-LSTM | 8,91 ± 0,14 | 21,12 ± 0,46 | 14,76 ± 0,26 | 0,8388 |
| DCA-GRU-SG, bila EEMD | 8,55 ± 0,07 | 20,31 ± 0,24 | 14,23 ± 0,17 | 0,8509 |
| Informer | 8,36 ± 0,08 | 19,86 ± 0,32 | 13,75 ± 0,23 | 0,8575 |
| PatchTST | 8,49 ± 0,06 | 19,95 ± 0,18 | 13,86 ± 0,13 | 0,8563 |
| EEMD-GRU | 8,34 ± 0,23 | 17,96 ± 0,53 | 13,41 ± 0,40 | 0,8834 |
| GlobalOnly | 7,88 ± 0,10 | 16,77 ± 0,17 | 12,46 ± 0,12 | 0,8984 |
| LocalOnly | 7,76 ± 0,08 | 16,60 ± 0,10 | 12,28 ± 0,13 | 0,9005 |
| EEMD-DCA-GRU, lango zito | 8,20 ± 0,18 | 17,70 ± 0,39 | 13,23 ± 0,28 | 0,8868 |
| EEMD-DCA-GRU-SG, lango lenye uchache | 7,90 ± 0,10 | 16,78 ± 0,17 | 12,46 ± 0,12 | 0,8983 |
Matokeo yanatoa ujumbe miwili tofauti. Kwanza, urekebishaji upya wa chaneli baada ya EEMD unaweza kuongeza usahihi wa benchmark. Pili, muunganiko kamili wa jumla na ndani si kila mara muundo bora. Matokeo bora yalitoka kwenye modeli ya ablation inayotumia njia ya ndani pekee.
Ufanisi wa vigezo na ukokotoaji ukoje?
| Modeli | Kigezo kinachofundishika | Muda wa mafunzo (dakika) | Inference kwa kila sampuli (ms) | MAPE (%) |
|---|---|---|---|---|
| GRU | 161,5 elfu | 1,33 | 0,0055 | 8,52 |
| Informer | 2,41 milioni | 4,50 | 0,0757 | 8,36 |
| PatchTST | 615,5 elfu | 1,89 | 0,0139 | 8,49 |
| EEMD-GRU | 163,8 elfu | 1,78 | 0,0057 | 8,34 |
| GlobalOnly | 167,5 elfu | 4,35 | 0,0124 | 7,88 |
| LocalOnly | 167,5 elfu | 3,68 | 0,0120 | 7,76 |
| EEMD-DCA-GRU | 167,5 elfu | 4,74 | 0,0127 | 8,20 |
| EEMD-DCA-GRU-SG | 167,5 elfu | 4,09 | 0,0127 | 7,90 |
Modeli kamili yenye lango lenye uchache ilizalisha MAPE ya benchmark ya chini kwa kutumia chini ya takribani sehemu moja ya kumi ya vigezo vya Informer. Kwa upande mwingine, EEMD na urekebishaji upya wa chaneli viliongeza gharama ya mafunzo na inference ikilinganishwa na GRU ya msingi. Zaidi ya hayo, ingawa nyakati za mafunzo katika jedwali zilipimwa kwenye kituo kilekile cha kazi, sifa za maunzi hazijaripotiwa kwa kina katika utafiti; hivyo muda huo haupaswi kuhamishwa moja kwa moja kwenda mifumo mingine.
Majaribio ya ablation yanaonyesha ni kipengele gani kilichokuwa na athari?
| Lahaja ya modeli | MAPE (%) | RMSE | Uchache | Kigezo |
|---|---|---|---|---|
| EEMD-GRU | 8,34 ± 0,23 | 17,96 ± 0,53 | 0,000 | 163,8 elfu |
| GlobalOnly | 7,88 ± 0,10 | 16,77 ± 0,17 | 0,265 | 167,5 elfu |
| LocalOnly | 7,76 ± 0,08 | 16,60 ± 0,10 | 0,106 | 167,5 elfu |
| EEMD-DCA-GRU | 8,20 ± 0,18 | 17,70 ± 0,39 | 0,000 | 167,5 elfu |
| EEMD-DCA-GRU-SG | 7,90 ± 0,10 | 16,78 ± 0,17 | 0,145 | 167,5 elfu |
Modeli ya LocalOnly ilipunguza MAPE kwa wastani wa pointi 0,579 za asilimia ikilinganishwa na EEMD-GRU na katika paired t-test ilitoa p = 0,0063 matokeo. Katika modeli kamili yenye lango lenye uchache, upungufu wa wastani ulikuwa pointi 0,438 za asilimia, uboreshaji wa jamaa %5,21 na p = 0,0051 uliripotiwa. Uboreshaji wa modeli zito ya NoSparse ulikuwa pointi 0,135 za asilimia pekee na haukupatikana kuwa na maana ya kitakwimu; p = 0,2061.
Hata hivyo, majaribio yanategemea mianzo mitano tu ya nasibu. Mwandishi anaeleza wazi kuwa jaribio la Wilcoxon lina azimio dogo kwa sampuli tano na vipimo vya takwimu vinapaswa kufasiriwa pamoja na uthabiti wa upangaji na ukubwa wa athari.
Matokeo ya PJM yanasema nini kuhusu uwezo wa modeli kujumuisha mazingira tofauti?
| Seti ndogo ya PJM | GRU RMSE / R² | EEMD-GRU RMSE / R² | EEMD-DCA-GRU zito RMSE / R² | Matokeo kuu |
|---|---|---|---|---|
| CE-pre | 751,88 / 0,8625 | 756,44 / 0,8608 | 782,79 / 0,8509 | GRU imefanya vizuri zaidi. |
| CE-post | 716,31 / 0,8831 | 684,77 / 0,8932 | 676,41 / 0,8958 | EEMD-DCA-GRU zito imetoa matokeo bora zaidi. |
| AEPOPT-pre | 334,08 / 0,9092 | 434,46 / 0,8458 | 423,07 / 0,8529 | Katika jedwali kuu la muhtasari, GRU imefanya vizuri zaidi. |
| AEPOPT-post | 406,77 / 0,8552 | 353,57 / 0,8906 | 361,76 / 0,8853 | EEMD-GRU imetoa matokeo bora zaidi. |
Maandishi ya utafiti yanaripoti kuwa katika matokeo ya ziada yaliyo pana zaidi, modeli ya EEMD-DCA-GRU-SG yenye lango lenye uchache ilitoa RMSE ya chini zaidi kwa AEPOPT-pre. Hata hivyo, thamani hiyo ya namba ya RMSE ya modeli hii haijaonyeshwa katika Jedwali la 3 la muhtasari katika hati kuu. Kwa hiyo, mpangilio uliotajwa kwenye maandishi unaweza kuhamishwa, lakini thamani inayokosekana haipaswi kukisiwa.
Matokeo ya PJM yanaonyesha kwamba modeli haitoi ubora wa jumla kila mahali. Utenganishaji huboresha vipimo vya kosa la kimuundo katika baadhi ya maeneo, huku katika maeneo mengine GRU rahisi au modeli inayotumia EEMD pekee ikifanya vizuri zaidi. Manufaa ya urekebishaji upya wa chaneli yanategemea eneo la mzigo na kipindi.
Grafu ya umuhimu wa chaneli inaonyesha nini?
Katika grafu ya umuhimu wa chaneli ya modeli yenye lango lenye uchache, sehemu kubwa ya IMF na chaneli za mabaki zilipata alama za juu za kuhifadhiwa. Hasa IMF5, kipengele cha mabaki, IMF4 na IMF6 zinaonekana katika nafasi za juu. Sifa za sine na cosine za saa zinazowakilisha mzunguko wa ndani ya siku pia zilipata umuhimu mkubwa.
Misimbo ya siku ya wiki ilipata alama za chini. Kutokana na grafu, inaweza kuonekana kwa takribani kuwa chaneli ya weekday_sin iko karibu sana na sifuri, huku chaneli ya weekday_cos ikiwa chini kwa wazi kuliko sifa nyingine za muda. Matokeo haya yanaonyesha kuwa ndani ya modeli iliyofitiwa, vipengele vya EEMD na mzunguko wa kila siku vilihifadhiwa zaidi kuliko misimbo ya kila wiki; hata hivyo, alama za umuhimu hazipaswi kufasiriwa kama athari ya kisababishi au umuhimu wa jumla wa kifizikia.
Grafu za utabiri zinaelezaje tabia ya modeli?
Grafu ya utabiri wa saa moja unaosogea katika hatua 168 mfululizo za majaribio inaonyesha kuwa modeli zinazotegemea EEMD zinafuatilia mwenendo wa mzigo wa masafa ya chini kwa utaratibu zaidi kuliko GRU na Informer. Hata hivyo, katika mabadiliko ya haraka na yenye amplitudo kubwa kati ya takribani hatua za 75-100 za majaribio, makosa kamili ya modeli zote huongezeka.
Katika grafu ya mfano ya utabiri wa saa 24, EEMD-GRU na EEMD-DCA-GRU huzalisha mikunjo laini zaidi. Ulainishaji huu husaidia kunasa mwenendo wa jumla wa kila siku, lakini unaweza pia kusababisha vilele na mabonde makali ya kila saa katika mfululizo halisi kuwakilishwa kwa upungufu. Grafu haiungi mkono kwamba modeli ni bora katika kila saa ya utabiri, bali kwamba huzalisha utabiri thabiti zaidi unaolenga masafa ya chini.
Ni nini kilitokea katika matumizi ya mtandaoni na ya kisababishi?
Katika majaribio makuu, EEMD ilitekelezwa kwenye kila seti baada ya data kugawanywa kwa mpangilio wa muda kuwa seti za mafunzo, uthibitishaji na majaribio. Mbinu hii huzuia mipangilio ya urekebishaji wa kiwango na utenganishaji kujifunzwa kwa pamoja kati ya seti tofauti za data; hata hivyo, si sawa na mfumo mkali wa mtandaoni ambapo katika kila wakati wa utabiri ni uchunguzi wa zamani pekee unaoweza kutumiwa.
Ili kuchunguza kizuizi hiki, mwandishi alifanya jaribio dogo la EEMD la kisababishi lililotumia tu kiambishi cha kihistoria hadi wakati wa utabiri:
| Modeli | MAPE ya kiambishi cha kisababishi (%) | RMSE ya kiambishi cha kisababishi | Maelezo |
|---|---|---|---|
| EEMD-GRU | 16,01 | 32,45 | Msingi wa ulinganisho |
| EEMD-DCA-GRU | 16,06 | 33,50 | Si bora kuliko msingi. |
| EEMD-DCA-GRU-SG | 16,21 | 33,11 | Si bora kuliko msingi. |
Jaribio hili la uchunguzi lilifanywa kwa mianzo 30 ya utabiri iliyochaguliwa kwa vipindi vya kila siku na majaribio 10 tu ya kundi la EEMD. Vipimo vya upande mmoja vya Wilcoxon vilivyooanishwa havikuwa na maana kwa lahaja zote mbili za DCA. Hivyo, mafanikio ya benchmark ya nje ya mtandao hayahamishiki moja kwa moja kwenda matumizi makali ya mtandaoni ya kisababishi.
Ni matokeo gani yanayoungwa mkono na utafiti?
- Urekebishaji upya wa chaneli baada ya EEMD unaweza kupunguza kosa la utabiri kwenye data ya benchmark ya GEFCom2014.
- Njia ya ndani ya muda ya chaneli ilitoa mchango binafsi wenye nguvu zaidi kwa usahihi katika jaribio la benchmark.
- Lango lenye uchache lilitoa matokeo bora kuliko lango zito katika modeli kamili ya jumla-na-ndani na likatoa ukandamizaji unaoweza kufasiriwa katika kiwango cha chaneli.
- Modeli zilizopendekezwa zilitumia vigezo vinavyofundishika vichache sana kuliko ulinganisho unaotegemea Transformer.
- Mbinu zinazotegemea EEMD ziliboresha matokeo ya RMSE na R² katika baadhi ya seti ndogo za PJM.
Utafiti hauthibitishi nini?
- Haijathibitishwa kuwa modeli iliyopendekezwa ndiyo mbinu bora katika gridi zote za umeme au seti zote za data.
- Modeli kamili yenye lango lenye uchache haikutoa kosa la chini zaidi kwenye benchmark; LocalOnly ilifanya vizuri zaidi.
- Matokeo ya EEMD ya nje ya mtandao si ushahidi wa mafanikio ya mtandaoni kwa wakati halisi.
- Modeli haijathibitishwa kwenye mfumo wa umeme wa Türkiye.
- Utafiti haujapima akiba ya kiuchumi, kupungua kwa gharama ya uzalishaji au mafanikio ya uendeshaji wa uwanjani.
- Utabiri wa kiuwezekano au vipindi vya kutokuwa na uhakika wa utabiri havikutathminiwa.
- Alama za umuhimu wa chaneli si ushahidi wa usababisho wa kifizikia.
- Matokeo ya kitakwimu yaliyopatikana kutoka mianzo mitano ya nasibu hayachukui nafasi ya uchanganuzi wa kutokuwa na uhakika wenye sampuli kubwa.
Ni yapi yaliyo nguvu na vikwazo vya utafiti?
Nguvu:
- Athari za vipengele vya modeli zilichunguzwa kando kwa ablation za GlobalOnly, LocalOnly, lango zito na lango lenye uchache.
- Mbali na seti ya benchmark, mifululizo halisi ya mzigo ya PJM iliyogawanywa katika vipindi tofauti ilitumika.
- Matokeo yaliripotiwa kwa wastani na mikengeuko ya kawaida ya mianzo mitano ya nasibu.
- Pamoja na usahihi, vigezo, muda wa mafunzo na muda wa inference vililinganishwa.
- Mwandishi pia aliwasilisha wazi matokeo ya PJM na ya mtandaoni ya kisababishi ambapo modeli ilishindwa au ilikuwa na mipaka.
Vikwazo vikuu:
- Utafiti ni preprint ambayo haijapitiwa na wataalamu wenza.
- Itifaki kuu ya EEMD si sawa na utenganishaji mkali wa mtandaoni wa kisababishi.
- Katika jaribio la kiambishi cha kisababishi, lahaja za DCA hazikuipita EEMD-GRU.
- Mchakato wa EEMD huleta gharama ya ziada ya uchakataji wa awali ikilinganishwa na modeli mbichi za GRU.
- Majaribio ya PJM yamewekewa mipaka kwenye maeneo ya CE na AEPOPT pekee.
- Vigezo vya hali ya hewa havikutumiwa katika data ya PJM.
- Ulinganisho wa kitakwimu unategemea mianzo mitano tu ya nasibu.
- Thamani za namba za baadhi ya matokeo katika jedwali la ziada la PJM hazikutolewa katika hati kuu.
- Msimbo, sehemu za data zilizochakatwa na modeli zilizofundishwa hazikuchapishwa kwa kiungo cha moja kwa moja; imeripotiwa kuwa mwandishi anaweza kuzitoa kwa ombi lenye sababu.
Mbinu na Matokeo ya Utafiti
Muhtasari wa kiufundi wa mpangilio wa jaribio
| Kipengele cha jaribio | Thamani au mbinu iliyotumika |
|---|---|
| Kazi ya utabiri | Kutabiri saa 24 zinazofuata kutoka saa 168 zilizopita |
| Mgawanyo wa data | Kwa mpangilio wa muda: %70 mafunzo, %15 uthibitishaji, %15 majaribio |
| Vipengele vya EEMD | 6 IMF na 1 kipengele cha mabaki |
| Jaribio la kundi la EEMD | Katika majaribio makuu 100 |
| Miundombinu ya ujifunzaji wa kina | PyTorch |
| Uboreshaji | Adam |
| Kiwango cha ujifunzaji | 1 × 10⁻⁴ |
| Ukubwa wa mini-batch | 64 |
| Kusimamisha | Kusimamisha mapema kulingana na hasara ya uthibitishaji |
| Idadi ya marudio | Kwa kila modeli ya kina, mianzo 5 ya nasibu |
| Kichwa cha utabiri | GRU yenye tabaka mbili na tokeo la mstari la saa 24 |
| Vipimo vya tathmini | MAPE, RMSE, MAE na R² |
Modeli zilizolinganishwa
- Watabiri rahisi wanaotumia wastani, persistence na thamani ya siku iliyopita
- XGBoost
- GRU, LSTM ve CNN-LSTM
- Informer ve PatchTST
- EEMD-GRU
- DCA-GRU-SG inayofanya kazi bila EEMD
- Ablation za GlobalOnly na LocalOnly
- EEMD-DCA-GRU zito
- EEMD-DCA-GRU-SG yenye lango lenye uchache
Muhtasari wa kiufundi wa matokeo makuu
- Usahihi wa benchmark: Modeli ya LocalOnly ilipata %7,76 MAPE, 16,60 RMSE, 12,28 MAE na 0,9005 R² kwenye GEFCom2014.
- Modeli kamili yenye uchache: EEMD-DCA-GRU-SG ilizalisha %7,90 MAPE na 16,78 RMSE.
- Athari ya utenganishaji: EEMD-GRU ilitoa uboreshaji mdogo katika MAPE ikilinganishwa na GRU mbichi; lakini uboreshaji ulionekana zaidi katika vipimo vya RMSE, MAE na R².
- Athari ya njia ya ndani: LocalOnly ilitoa kosa la chini kuliko GlobalOnly na lahaja mbili zilizounganishwa.
- Athari ya lango lenye uchache: Katika modeli kamili iliyounganishwa, lango lenye uchache lilipunguza MAPE ya lahaja zito kutoka %8,20 hadi %7,90.
- Ufanisi wa vigezo: Modeli kamili yenye uchache ilitumia vigezo 167,5 elfu, huku Informer ikitumia 2,41 milioni na PatchTST vigezo 615,5 elfu.
- Vikwazo vya PJM: Katika muhtasari wa CE-pre na wa msingi wa AEPOPT-pre, GRU ilifanya vizuri zaidi; katika CE-post EEMD-DCA-GRU zito; na katika AEPOPT-post EEMD-GRU ilifanya vizuri zaidi.
- Kikomo cha mtandaoni: Katika jaribio la kiambishi cha kisababishi, lahaja za DCA hazikutoa uboreshaji wenye maana ikilinganishwa na EEMD-GRU.
Hitimisho kwa matumizi
Utafiti unaonyesha kuwa katika utabiri wa muda mfupi wa mzigo, badala ya kuongeza ukubwa wa modeli, kutenganisha muundo wa ishara na kudhoofisha kwa kuchagua chaneli za ingizo kunaweza kuwa na ufanisi. Hata hivyo, muundo bora wa benchmark si modeli kamili iliyopendekezwa ya jumla-na-ndani, bali ni njia ya urekebishaji wa ndani pekee. Hii inaonyesha kuwa muunganiko tata zaidi hautoi kiotomatiki matokeo bora.
Kwa matumizi ya wakati halisi, modeli inapaswa kufundishwa upya kwa EEMD inayosogea au inayotegemea dirisha ambayo hutumia data ya zamani pekee. Mzigo wa ukokotoaji wa EEMD lazima upimwe kando katika mifumo inayotakiwa kutoa utabiri mara data inapowasili. Matokeo ya sasa ya utafiti yanaunga mkono mafanikio ya benchmark ya nje ya mtandao, lakini hayatoi mfumo tayari wa uwanjani au mafanikio ya uendeshaji wa wakati halisi.
Maelezo ya Chanzo na Mbinu
- Jina kamili la asili la utafiti: Decomposition-Aware Channel Recalibration for Lightweight Short-Term Load Forecasting
- Mwandishi: Jiezhuo Zhang
- Mpangilio wa mwandishi: Utafiti wa mwandishi mmoja
- Mwandishi mwenza wa kwanza: Hayupo.
- Mwandishi wa mawasiliano: Jiezhuo Zhang
- Taasisi: School of Information Science and Engineering, East China University of Science and Technology, Shanghai 200237, China
- DOI:10.2139/ssrn.7192485
- Jarida: Hakuna taarifa ya jarida lililopitiwa na wataalamu wenza.
- Jukwaa la uchapishaji: SSRN
- Mwendeshaji wa jukwaa: Elsevier Inc.
- Mwaka wa uchapishaji: 2026
- Tarehe ya usajili wa SSRN:27 Julai 2026
- Aina ya chanzo: Utafiti wa preprint unaojumuisha uundaji modeli na uchanganuzi wa data
- Hali ya mapitio ya wataalamu wenza: Utafiti huu ni preprint na haujapitiwa na wataalamu wenza.
- Kiungo rasmi cha utafiti:Ukurasa rasmi wa utafiti wa SSRN
Maelezo haya ya Kiswahili yaliandaliwa kwa kuchunguza maandishi, fomula, majedwali, mchoro wa usanifu, grafu za utenganishaji, matokeo ya ablation, ulinganisho wa PJM, grafu ya umuhimu wa chaneli na taswira za utabiri za utafiti uliopakiwa. Hakuna matokeo mapya ya majaribio, madai ya mafanikio ya kisayansi au ugunduzi wa kisayansi kutoka chanzo cha nje ambao haupo katika utafiti ulioongezwa. Ukaguzi wa vyanzo vya nje ulitumika tu kuthibitisha utambulisho wa kibibliografia kama DOI, tarehe ya SSRN, jukwaa na hali ya uchapishaji.
Vikwazo vikuu vya utafiti ni kutopitiwa na wataalamu wenza, tathmini kuu ya EEMD kutokuwa sawa na itifaki kali ya mtandaoni ya kisababishi, faida ya DCA kutothibitishwa katika jaribio la kiambishi cha kisababishi, gharama ya ukokotoaji ya EEMD, matumizi ya maeneo mawili tu ya PJM, kutokuwepo kwa data ya hali ya hewa katika majaribio ya PJM na majaribio ya kitakwimu kuwekewa mipaka kwenye mianzo mitano ya nasibu.
Mwandishi hakuripoti maslahi yoyote ya kifedha yanayoshindana au uhusiano binafsi na alisema kuwa utafiti haukupokea ufadhili maalum kutoka mashirika ya umma, ya kibiashara au yasiyo ya faida. Data za GEFCom2014 na PJM Data Miner zilichukuliwa kutoka vyanzo vinavyopatikana kwa umma; ilielezwa kuwa sehemu za data zilizochakatwa, msimbo na matokeo ya modeli zilizofundishwa zinaweza kutolewa kwa ombi lenye sababu.
Kwa mujibu wa tamko la akili bandia katika utafiti, OpenAI ChatGPT na Codex zilitumika kwa kuboresha lugha, kukagua msimbo, kuunda muundo wa hati na ukaguzi wa ulinganifu. Mwandishi alieleza kuwa alikagua na kuhariri baadaye matokeo yaliyosaidiwa na akili bandia, alithibitisha kwa kujitegemea taratibu za majaribio na matokeo, na anakubali wajibu wa maudhui ya chapisho.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *