

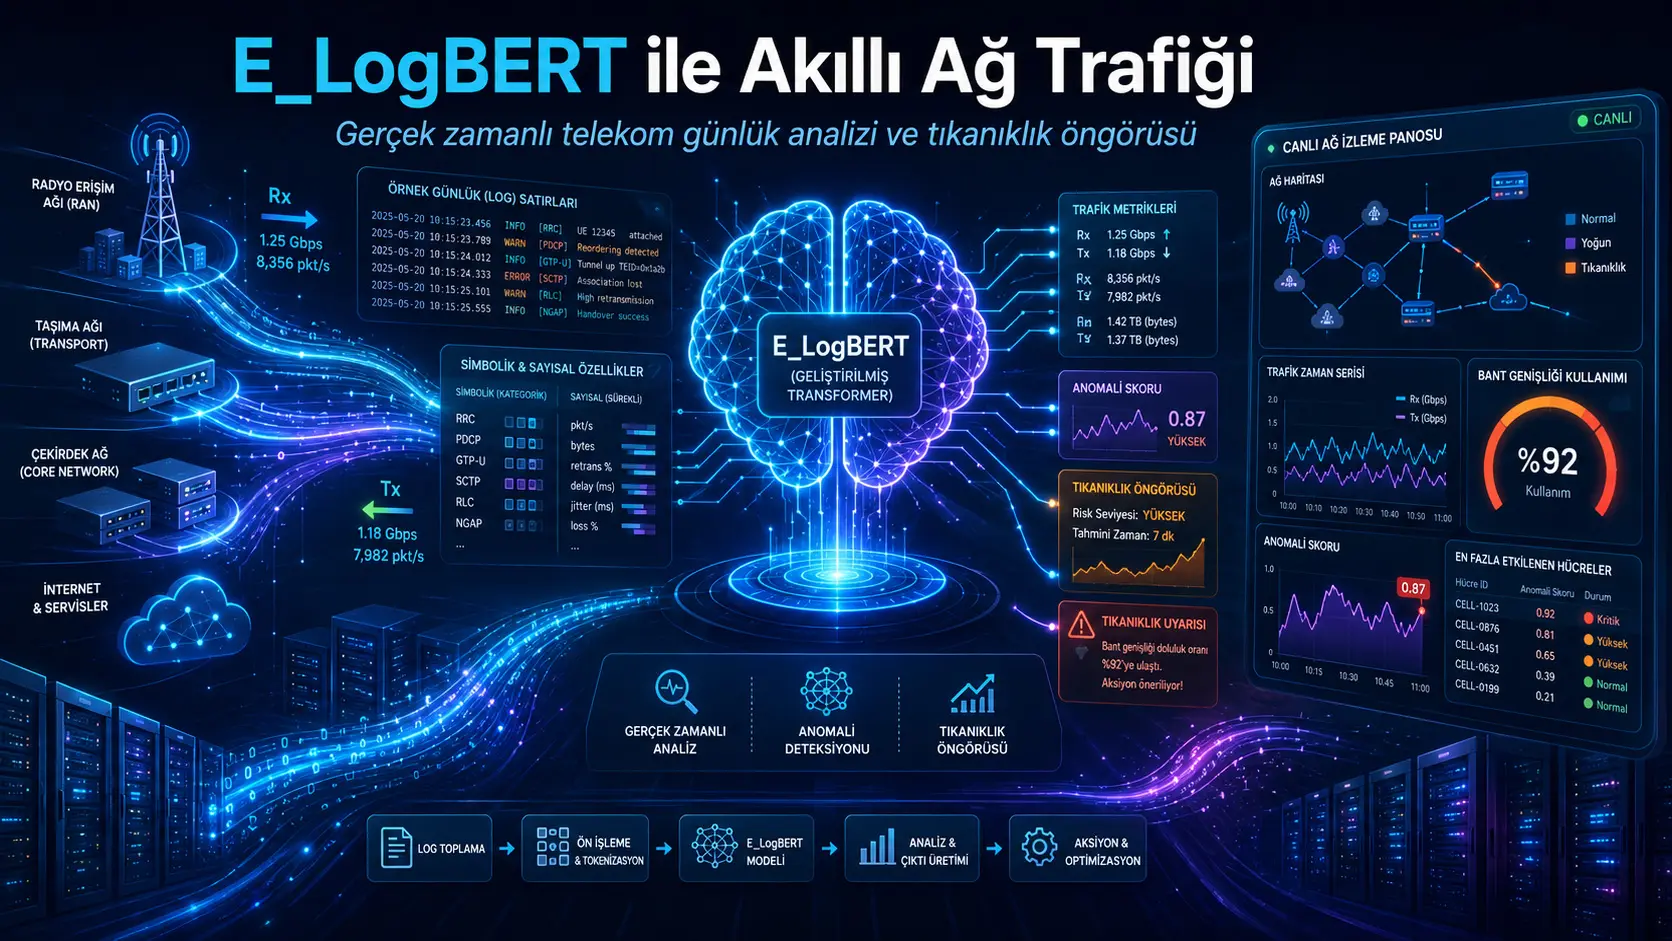
Utafiti huu umeunda mbinu ya akili bandia inayojisimamia iitwayo E_LogBERT ili kuchakata kwa pamoja majina ya matukio na thamani za namba za trafiki katika logs zinazozalishwa na mitandao ya mawasiliano. Watafiti walibadilisha metrics 45 za kupokea–kutuma zilizochukuliwa kutoka zana ya bmon kila sekunde mbili kuwa sentensi za maelezo zenye time stamp; wakakusanya mistari 13.608.000 ya log na tokens 27.216.000 za symbolic-numeric kwa siku saba. Modeli huunganisha symbolic metric identity kwa BERT embedding na thamani ya namba iliyofanyiwa normalization kwa njia ya dynamic kupitia learnable linear layer katika nafasi ileile ya dimensions 768. Utafiti uliripoti %92 accuracy, %90 precision, %89 recall, %89,5 F1 na %96 AUC kwa E_LogBERT. Hata hivyo haujaeleza jinsi congestion labels ziliundwa, jinsi training na independent test data zilivyogawanywa, kama matokeo ni wastani wa marudio mangapi, wala modeli inatabiri congestion mapema kwa muda gani.
Tofauti kuu ya mbinu ni kwamba inajaribu kuhifadhi ukubwa wa namba ambao katika modeli za kawaida za LogBERT mara nyingi huondolewa au kupunguzwa hadi token moja ya [NUM]. Kwa mfano, lengo ni modeli ijifunze si tukio la “Bytes_Rx” pekee bali pia mahali ambapo thamani ya sasa ya metric hii iko ndani ya anuwai yake ya kawaida. E_LogBERT hufundishwa kwa malengo ya Masked Log Key Prediction, inayotabiri metrics zilizofichwa katika logs za kawaida, na Volume of Hypersphere Minimization, inayokusanya normal network windows karibu na shared embedding center. Anomaly score huzalishwa kwa kuunganisha ishara hizi mbili.
Kwa mtazamo wa Türkiye: Mbinu ya utafiti inaweza kuchunguzwa kwa ufuatiliaji wa mapema wa traffic congestion na performance deviations katika telecom operators, internet service providers, data centers, enterprise networks, municipal network infrastructures na network operation centers nchini Türkiye. Kabla ya matumizi, modeli inapaswa kuthibitishwa kwa logs za mitandao halisi ya operators zilizotakaswa taarifa binafsi; kwa device vendors tofauti, 4G–5G core networks, fixed-access systems, IPv4–IPv6 traffic na vipindi tofauti vya mzigo. Mwanzo halisi wa congestion, forecast horizon, false-alarm cost na athari ya intervention kwa service quality zinapaswa kupimwa wazi. Kwa kuwa utafiti hauonyeshi field experiment katika operator wa Türkiye, national network data, production-environment reliability au cyberattack-detection success, kiwango cha mafanikio mahususi kwa nchi hakiwezi kutolewa moja kwa moja.
Kwa nini telecom network logs ni aina ngumu ya data?
Katika mitandao ya kisasa ya mawasiliano, routers, virtual network functions, firewalls, voice platforms na monitoring tools huzalisha logs kwa kuendelea. Logs hizi hubeba si taarifa ya “tukio limetokea” pekee, bali pia thamani za namba zinazobadilika kila wakati kama kiasi cha bytes zilizopokelewa na kutumwa, idadi ya packets, dropped packets, CRC errors, reassembly problems na multicast traffic.
Hoja ya kuanzia ya utafiti ni kwamba sehemu kubwa ya traditional log-analysis models hupoteza taarifa ya kiasi kwa:
- kuondoa kabisa thamani za namba,
- kugeuza kuwa token moja ya
[NUM], - kuzichakata kama statistics tofauti zisizohusiana na text
. Ingawa “Bytes_Rx = 100” na “Bytes_Rx = 100.000” zinawakilisha symbolic event ileile, hazina maana sawa kwa hali ya mtandao. Congestion na baadhi ya security events mara nyingi zinaweza kueleweka si kutoka event name pekee, bali kutoka magnitude ya values na mabadiliko yake kwa muda.
Mbinu ya msingi ya LogBERT ni ipi?
LogBERT hufananisha log sequences na sentensi za natural language. Tukio moja la log huchukuliwa kama word, na logs zinazofuatana kwa muda kama sentence au sequence. Kwa kutumia bidirectional attention ya BERT, uhusiano wa tukio na matukio yaliyotangulia na yanayofuata unaweza kujifunzwa.
Utafiti umetumia malengo mawili ya self-supervised learning ya LogBERT:
- Masked Log Key Prediction: Baadhi ya log keys katika sequence hufichwa na modeli huombwa kutabiri key inayokosekana kwa kuangalia context.
- Volume of Hypersphere Minimization: Global embeddings za log sequences zinazochukuliwa kuwa normal hukusanywa karibu na center moja ya pamoja.
Kupungua kwa masked-prediction accuracy au kuongezeka kwa distance kutoka embedding center kwa sequences mpya zinazotofautiana na normal patterns hutumiwa kama ishara ya anomaly.
E_LogBERT inalenga pengo gani?
Kulingana na watafiti, pengo kuu ni kutoweza kuchakata continuous values zinazohusiana na symbolic log keys ndani ya contextual model ileile. E_LogBERT inasisitiza michango minne:
- Kubadilisha raw bmon outputs kuwa timestamped descriptive log sentences,
- Kufanya dynamic min–max normalization kulingana na changing traffic distribution,
- Kutumia pamoja malengo ya MLKP na VHM kwa symbolic na numeric inputs,
- Kuunganisha data collection, training, anomaly scoring, alarm na visualization katika modules 13.
Data zilikusanywaje?
Network statistics zilipatikana kwa bmon, yaani Bandwidth Monitor, inayofanya kazi kwenye Linux systems. bmon hutoa metrics 45 tofauti kwa kila network interface. Kwa kuwa kila metric ina Rx value kwa received traffic na Tx value kwa transmitted traffic, jumla ya symbolic metrics 90 hutokea katika kila measurement cycle.
Baadhi ya metrics zilizopimwa ni:
- Bytes na Packets,
- Dropped na Errors,
- CRC Error, Frame Error na FIFO Error,
- Collisions na Carrier Error,
- IPv6 packet, delivery, forwarding na reassembly counters,
- Multicast na ICMPv6 indicators.
Data-collection script husawazishwa na mwanzo wa kila dakika, husubiri sekunde 60 za initial stability na kusoma mistari 45 kutoka WANbridge interface kila sekunde mbili. Kila mstari hubadilishwa kuwa template ya jumla ifuatayo:
[time stamp]: Interface: Metric_Rx thamani X wakati Metric_Tx thamani Y.
Kielelezo 1 kwenye ukurasa wa tano kinaonyesha upande wa kushoto raw bmon output yenye columns ambayo ni ngumu kutafsiri kwa binadamu, na upande wa kulia formatted logs zinazobadilisha kila measurement kuwa timestamped sentence. Mchakato huu huhifadhi metric name, traffic direction, unit na numeric value.
Je, test environment ilikuwa mtandao halisi wa operator?
Hapana. Utafiti uliunda realistic test environment; hata hivyo data haikutolewa kutoka production network ya commercial mobile operator. Setup inayoitwa Unified Telecom Platform ilikuwa na:
- Physical host inayotumia Zorin OS,
- 8-core 3,0 GHz processor,
- 32 GB RAM na 200 GB SSD,
- NVIDIA T4 GPU yenye 16 GB memory,
- KVM/QEMU-based virtual machine manager,
- pfSense virtual machine katika nafasi ya ISP gateway,
- Issabel virtual machine katika nafasi ya VoIP operator platform,
- WANbridge interface inayounganisha virtual machines mbili na kufuatiliwa.
Kielelezo 6 kwenye ukurasa wa kumi na tano kinaonyesha virtualized network functions, local network access na wide-area network connection kwenye virtual machines mbili. Setup hii inaruhusu controlled experiments; hata hivyo device diversity, user behavior, protocol complexity na scale ya real operator network havijawakilishwa kwa kiwango kilekile.
Ukubwa wa seti ya data
| Sifa ya data | Thamani iliyoripotiwa katika utafiti |
|---|---|
| Muda wa ukusanyaji | saa 168, siku 7 |
| Measurement interval | sekunde 2 |
| Log lines kwa measurement | 45 |
| Idadi ya daily log lines | 1.944.000 |
| Idadi ya log lines kwa siku saba | 13.608.000 |
| Numeric direction kwa mstari | Rx na Tx, jumla 2 |
| Jumla mixed tokens | 27.216.000 |
| Idadi ya sequences za sekunde kumi | 60.480 |
Kila measurement ya sekunde mbili huzalisha mistari 45 na Rx/Tx values 90. Measurement cycles tano huunganishwa kutengeneza window ya sekunde kumi yenye tokens 450, na [CLS] huongezwa mwanzo wa sequence ili total input length iwe 451.
Ni network indicators gani zinaweza kutolewa kutoka raw counters?
Utafiti unaeleza kwamba bmon counters zinaweza kutumiwa kwa baadhi ya high-level indicators. Network interface utilization imefafanuliwa kama:
\[ U=\frac{T}{C} \]
Hapa \(T\) ni traffic rate na \(C\) ni total interface capacity.
Packet delivery ratio imetolewa kama:
\[ PDR=\frac{\sum N_R}{\sum N_S}\times100 \]
\(\sum N_S\) ni idadi ya packets zilizotumwa na \(\sum N_R\) ni idadi ya packets zilizopokelewa.
Effective throughput imeelezwa katika chanzo kwa uhusiano:
\[ \mathrm{Throughput}=PDR\times\mathrm{Data\ Rate} \]
Uhusiano huu umetumika kueleza effective throughput.
Watafiti wanatafsiri ongezeko la pamoja la counters fulani kama operational clues:
- Kuongezeka kwa Dropped na FIFO Error kunaweza kuonyesha buffer overflow,
- kuongezeka kwa CRC Error na Frame Error kunaweza kuonyesha physical-link problems,
- kuongezeka kwa Collision na Carrier Error kunaweza kuonyesha duplex-setting au hardware problems,
- packet count kubwa yenye byte amount ndogo inaweza kuonyesha small-packet traffic flood
. Haya ni diagnostic interpretations za utafiti; E_LogBERT experiments hazikufanya separate cause classification kwa kila tukio.
Numeric values zilipelekwa BERT kwa namna gani?
Utafiti unaeleza kwamba kuna sources mbili za taarifa katika kila input position:
- Discrete symbolic identity kama metric name,
- Normalized continuous numeric magnitude.
Symbolic metric name hubadilishwa kuwa vector ya dimensions 768 kutoka BERT word embedding matrix. Numeric value nayo hupitishwa kupitia:
nn.Linear(1, 768)
layer ili iprojectiwe kwenye dimension ileile. Vectors mbili hujumlishwa na kupelekwa kwenye modeli. Addition hii imefananishwa na BERT kujumlisha word, position na type embeddings.
Representation inayolengwa na mbinu hii inaweza kufupishwa kama:
\[ \mathbf{e}_i= \mathbf{e}_{metric,i} + \mathbf{e}_{numeric,i} + \mathbf{e}_{position,i}. \]
Hata hivyo sehemu nyingine ya source text inaeleza mchakato huo kama “kuunganisha metric name na normalized value katika mixed token moja”. Kama kila numeric value tofauti ingekuwa sehemu ya vocabulary, fixed vocabulary yenye tokens 92 isingewezekana. Kwa hiyo implementation halisi inaonekana kuwa separate symbolic embedding na numeric projection; lakini chanzo hakitoi distinction hii kwa uwazi na bila contradiction.
Dynamic min–max normalization
Numeric values hunormalishwa kulingana na current minimum na maximum values. General min–max transformation ni:
\[ v_{norm}= \frac{v-v_{min}} {v_{max}-v_{min}} \]
.
Utafiti unaeleza kwamba limits hizi husasishwa new traffic values zinapowasili. Hii inalenga kupunguza dependence ya mfumo kwa manually fixed ranges. Hata hivyo haijaelezwa:
- minimum na maximum values zinahifadhiwa katika time window gani,
- jinsi outliers zinavyozuiwa kuharibu scale,
- kama test data huingia kwenye normalization statistics,
- jinsi old values zinavyosahaulika wakati wa sudden distribution shift
.
Lengo la Masked Log Key Prediction
%15 ya tokens zote isipokuwa [CLS] hufichwa kwa nasibu. Hidden vector katika Transformer layer ya mwisho hubadilishwa kuwa probability distribution juu ya symbolic classes 92:
\[ \mathbf{y}_m= \operatorname{softmax} \left( \mathbf{W}_{MLKP}\mathbf{H}_m+\mathbf{b}_{MLKP} \right). \]
Modeli hujifunza kutabiri kwa usahihi metrics zilizofichwa katika normal log sequences. Sequence mpya ikiwa haiendani na usual contextual patterns, masked-prediction accuracy inatarajiwa kupungua.
Uandishi wa cross-entropy equation katika source hauko wazi; predicted probability na true-class indicator zinaonekana kuandikwa kwa symbol ileile. Loss inayokusudiwa ni standard cross-entropy ya true-class indicator na predicted probability.
Lengo la Volume of Hypersphere Minimization
Hali ya jumla ya kila sequence huwakilishwa na embedding ya dimensions 768 ya token ya [CLS]. Center hukokotolewa kutoka initial normal sequences:
\[ \mathbf{c}= \frac{1}{N_{init}} \sum_{n=1}^{N_{init}} \mathbf{H}_{[CLS],n}. \]
Center kisha huwekwa fixed na embeddings za normal sequences husogezwa karibu nayo:
\[ L_{VHM}= \frac{1}{B} \sum_{b=1}^{B} \left\| \mathbf{H}_{[CLS],b}-\mathbf{c} \right\|_2^2. \]
Hivyo lengo ni normal network states ziunde compact cluster katika high-dimensional space. Sequences zinazovuruga usual cross-metric relationships zinatarajiwa kubaki mbali zaidi na center.
Lengo la jumla la training
Self-supervised losses mbili huunganishwa kwa weights:
\[ L_{total}= \alpha L_{MLKP} + \beta L_{VHM}. \]
Chanzo kinaeleza kwamba kwa kawaida \(\alpha=0{,}5\) na \(\beta=0{,}5\) zilitumika, na pia condition:
\[ \alpha+\beta=1 \]
ilihifadhiwa.
Anomaly score hukokotolewaje?
Anomaly score ya modeli huunganisha masked-prediction accuracy na VHM center distance:
\[ A(S)= 1- \left[ \alpha\,MLKP_{norm}(S) + \beta\left(1-VHM_{norm}(S)\right) \right]. \]
Score ikikaribia sifuri, sequence inalengwa kuchukuliwa normal; ikikaribia moja, anomalous. Utafiti umetaja operational zones tatu:
| Anomaly score | Tafsiri iliyotumika katika chanzo |
|---|---|
| 0–0,825 | Hakuna congestion |
| 0,825–0,960 | Congestion inayowezekana |
| 0,960 na zaidi | Congestion inayokaribia |
Haijaonyeshwa jinsi thresholds hizi zilivyobainishwa kwa ROC analysis, validation optimization au operational-cost calculation. Aidha, chanzo kinaeleza kwamba score itakuwa 1 ikiwa \(\alpha\) na \(\beta\) zote ni sifuri. Hii haiendani na constraint ya awali ya \(\alpha+\beta=1\).
Ukubwa wa modeli ya E_LogBERT
Modeli hutumia modified BERT-Base core:
- 12 Transformer layers,
- 768 hidden dimension,
- 12 attention heads,
- 451 input positions,
- Vocabulary yenye elements 92, ikiwa metrics 90 na special tokens 2.
Utafiti umetoa total trainable parameter count ya 86.691.164. Kutumia small vocabulary ya metrics 92 badala ya embedding table ya takribani words 30 thousand ya standard BERT-Base hupunguza word-embedding layer. Sehemu kubwa ya Transformer core hubaki.
Matatizo katika parameter table
Parameter table kwenye ukurasa wa kumi na moja na ishirini na nne ina baadhi ya technical uncertainties:
- Katika attention section \(W_V\) imeandikwa mara mbili; mojawapo ya mistari huenda ikawa output projection \(W_O\).
- Weights 768 na bias parameters 768 za
Linear(1,768)layer iliyoelezwa kwa numeric value hazionekani kwenye table. - Transformation ya VHM kutoka 768 hadi 1 imetolewa kama parameters 768, possible bias haijatajwa.
- Vipengele vya table havionyeshi wazi bias terms zote za standard BERT layer.
Kwa hiyo reported total haiwezi kuthibitishwa independently kutoka table pekee bila model code.
Usanifu wa mfumo wenye modules kumi na tatu
Kielelezo 2 kwenye ukurasa wa nane kinaonyesha software modules 13 zinazofanya kazi kuzunguka modeli katika muundo wa package moja:
| Module | Jukumu katika utafiti |
|---|---|
config.py | System parameters na central configuration |
data_structures.py | Standard data objects |
logger_config.py | Kurekodi system events |
utils.py | Common helper functions |
extract_normalize_format_embed.py | Log parsing, normalization na mixed-token generation |
sequence_buffer.py | Kutengeneza window yenye tokens 450 kutoka measurement cycles tano |
dataloader.py | Kubadilisha sequences kuwa PyTorch tensors na masking |
train.py | Continuous model training |
log_model.py | E_LogBERT model |
anomaly.py | Anomaly score na decision mechanism |
livemonitor.py | Workflow scheduling |
predict_log.py | Historical analysis na future-state prediction |
dashboard.py | Live measurements, alarms na model performance |
Kielelezo 3 kwenye ukurasa wa tisa kinagawanya mfumo katika hatua sita:
- Infrastructure na data generation,
- Configuration na data objects,
- Preprocessing na maandalizi ya windows za sekunde kumi,
- Model training na inference,
- Anomaly scoring na logging,
- Visualization na prediction.
Kielelezo 5 kwenye ukurasa wa kumi na nne kinaonyesha kwa kina file, parameter, model-weight, alarm na log flows za modules zote. Architecture ni pana; hata hivyo complexity ya figure pekee haitoshi kwa mfumo kutekelezwa upya. Module source codes na interface schemas hazijashirikiwa.
Utendaji wa wakati halisi umefafanuliwaje?
Mfumo hupokea measurement mpya kila sekunde mbili, huunda sequence ya sekunde kumi kutoka measurement cycles tano, na unalenga kutekeleza training, inference na alarm process ndani ya cycle ya sekunde kumi.
Kwenye ukurasa wa tano, imeelezwa kwamba data-collection script ilibaki chini ya %5 ya CPU usage kwenye test hardware. Hata hivyo:
- inference time ya BERT model kwa sequence moja,
- muda halisi wa training ya epochs tisa,
- ni cycles ngapi zilizotimiza limit ya sekunde kumi,
- GPU memory na energy consumption,
- scaling kwa interfaces nyingi kwa wakati mmoja
havikupimwa. Kwa hiyo sifa ya “real-time” iko katika kiwango cha architectural target na demonstration; haijathibitishwa kwa full performance benchmarking.
Live dashboard
Kielelezo 4 kwenye ukurasa wa kumi na mbili na ishirini na saba kinaonyesha live monitoring panel inayotegemea Streamlit. Visualization ina:
- matukio 156 kwa jumla,
- anomaly score 0,408,
- hali ya “No Congestion”,
- thamani ya F1 ya 0,874,
- data quality ya “Excellent”,
- anomaly score kwa muda,
- thresholds za possible na approaching congestion
. Dashboard inaunga mkono kwamba kuna prototype inayofanya kazi. Hata hivyo screenshot moja haithibitishi alarm accuracy au long-term production reliability.
Matokeo ya kulinganisha
| Kipimo | E_LogBERT | KTeleBERT | Tofauti |
|---|---|---|---|
| Accuracy | %92 | %78 | pointi 14 za asilimia |
| Precision | %90 | %75 | pointi 15 za asilimia |
| Recall | %89 | %74 | pointi 15 za asilimia |
| F1 | %89,5 | %74,5 | pointi 15 za asilimia |
| AUC | %96 | %84 | pointi 12 za asilimia |
Kielelezo 7 kwenye ukurasa wa kumi na saba kinaonyesha columns za E_LogBERT zikiwa juu kuliko columns za KTeleBERT katika metrics tano. Hata hivyo comparison protocol haijaelezwa:
- kama KTeleBERT ilifundishwa upya kwenye data ileile,
- jinsi hyperparameters zilivyochaguliwa,
- kama modeli mbili zilitumia training na test split ileile,
- kama matokeo ni run moja au wastani wa marudio
haijatajwa.
Abstract inasema baseline LogBERT pia ilizidiwa; hata hivyo hakuna numeric value iliyotolewa kwa basic LogBERT kwenye result table au graph.
Athari ya idadi ya epochs
| Epoch | Synchronized E_LogBERT accuracy | Unsynchronized baseline accuracy |
|---|---|---|
| 3 | %78 | %65 |
| 5 | %85 | %70 |
| 7 | %89 | %74 |
| 9 | %92 | %78 |
| 11 | %92 | %80 |
| 13 | %90 | %81 |
| 15 | %88 | %80 |
Kielelezo 8 kinaonyesha accuracy ya E_LogBERT ikifikia %92 katika epoch ya tisa, ikibaki hapo kwenye epoch ya kumi na moja, kisha ikipungua. Watafiti walichagua epochs tisa kama balance inayofaa kati ya accuracy na time cost.
Kupungua kunaweza kuhusishwa na overtraining au mabadiliko katika data stream; lakini kwa kuwa utafiti haujatoa training na validation losses, random seeds au repeated experiments, haiwezi kuthibitishwa kwamba hii ni overfitting kweli.
Tofauti kati ya “congestion forecasting” na “anomaly detection”
Kuna mpaka muhimu wa kidhana katika tathmini ya utafiti. Anomaly detection hubainisha kama pattern katika current au past window imetoka kwenye normal. Future congestion prediction inahitaji:
- future target time,
- forecast horizon,
- actual congestion onset,
- time from prediction to event,
- false-alarm na miss rates za early warning
.
Anomaly score ya E_LogBERT imeelezwa kwa kina, lakini target na evaluation metrics za future-state forecasting hazijatolewa. Kwa hiyo utafiti unatoa ushahidi wa real-time anomaly monitoring; hauonyeshi kwa uwazi uleule kwamba congestion imetabiriwa muda maalumu kabla haijatokea.
Je, cyberattack detection imeonyeshwa?
Utafiti unaeleza kwamba DDoS, small-packet flood traffic na ongezeko lisilo la kawaida la bandwidth vinaweza kuonekana kinadharia katika bmon counters. Hata hivyo majaribio hayajatoa:
- specific attack scenario,
- controlled attack injection,
- attack-type label,
- recall kwa kila attack,
- false-positive analysis
. Kwa hiyo haiwezi kuhitimishwa kutoka utafiti huu kwamba E_LogBERT hugundua cyberattacks mapema.
Nguvu za utafiti
- Kupotea kwa numeric values katika log analysis kumechukuliwa kama practical problem wazi.
- Data yenye high temporal resolution imekusanywa kwa siku saba.
- Raw network counters zimebadilishwa kuwa timestamped descriptive format.
- Rx na Tx values zimehifadhiwa kwa identities tofauti.
- Self-supervised learning inalenga kupunguza hitaji la labeled anomalies.
- Data collection, model, alarm na visualization zimeunganishwa katika mfumo mmoja wa modular.
- Live monitoring panel inayofanya kazi imewasilishwa.
- Parameter count, software dependencies na test hardware zimeripotiwa.
- Precision, recall, F1 na AUC zimetolewa pamoja na accuracy.
- LoRA, federated learning na validation katika operators tofauti zimetambuliwa kama future work.
Mapungufu ya utafiti
- Utafiti haujapitiwa na wahakiki.
- Data zimetoka kwenye controlled virtual test environment badala ya production network ya commercial operator.
- Data inahusisha mazingira moja ya siku saba pekee.
- Haijaelezwa jinsi congestion samples zilitengenezwa na jinsi ground-truth labels zilibainishwa.
- Training, validation na test split hazijatolewa.
- Haijaelezwa jinsi temporal data leakage ilivyozuiwa.
- Class distribution na raw confusion-matrix values hazipo.
- Hakuna multiple training repeats, standard deviation au confidence interval.
- Haijaonyeshwa kwamba comparison ya KTeleBERT ilifanywa katika conditions zilezile.
- Hakuna numeric comparison result ya baseline LogBERT.
- Future forecast horizon na early-warning time hazikupimwa.
- Detailed algorithm ya dynamic normalization haijaelezwa.
- Mixed-token description haiko internally consistent.
- Parameter table ina missing au duplicated rows.
- Hakuna validation analysis ya anomaly thresholds.
- Risk ya continuous training kujifunza anomalous data kama normal au kusababisha model drift haijachunguzwa.
- Model inference time na end-to-end latency hazikupimwa.
- Code, data, model weights na reproducibility scripts hazijashirikiwa.
- Cyberattack detection performance haijajaribiwa kwa majaribio.
Utafiti unaunga mkono nini?
- Unaonyesha kwamba symbolic metric name na numeric magnitude zinaweza kuchakatwa katika BERT-based model ileile.
- Unaonyesha kwamba bmon outputs zinaweza kubadilishwa kuwa timestamped descriptive log sequences.
- Unaonyesha kwamba MLKP na VHM objectives zinaweza kutumika pamoja kwenye mixed metric sequences.
- Unatoa prototype inayofanya kazi inayozalisha anomaly score kwenye windows za sekunde kumi.
- Unaonyesha kwamba kwenye controlled UTP data, metrics zilizoripotiwa ni kubwa kuliko baseline result ya KTeleBERT.
- Unaonyesha kwamba real-time dashboard na alarm-logging infrastructure vinaweza kuunganishwa kwenye architecture ileile.
Utafiti hauthibitishi nini?
- Haudhibitishi kwamba E_LogBERT itafanya kazi kwa %92 accuracy katika real mobile operator network.
- Hauonyeshi kwa namba kwamba congestion inatabiriwa muda fulani kabla.
- Haudhibitishi kwamba ni bora kuliko KTeleBERT na LogBERT katika datasets zote.
- Hauonyeshi kwamba modeli itahamishwa kwa logs za device vendors na operators tofauti bila retraining.
- Hauonyeshi kwamba inagundua au kuclassify cyberattack types.
- Hauonyeshi kwamba thresholds 0,825 na 0,960 ni universal.
- Haudhibitishi kwamba continuous online training huzuia model drift kwa usalama.
- Hauonyeshi kwamba operations zote za training na inference za sekunde kumi hukamilika kila wakati kwenye hardware iliyotajwa.
- Hautoi production environment availability, fault tolerance au long-term operational stability.
- Haupimi energy efficiency au carbon impact ya solar-powered UTP.
Umuhimu kwa mtazamo wa zamani, sasa na baadaye
Zamani, network monitoring kwa kiasi kikubwa ilitegemea fixed thresholds, rule-based alarm systems na dashboards zilizotengenezwa na binadamu. Baadaye, statistical methods na deep networks zinazojifunza log sequences zilitengenezwa. Modeli kama LogBERT zilijifunza contextual event relationships, lakini katika applications nyingi numeric values zilibaki kuwa taarifa ya sekondari au iliyopotea.
Kwa sasa, kipengele muhimu cha E_LogBERT ni kujaribu kuchakata event name ya log na numeric magnitude iliyopimwa ndani ya common context. Wazo hili linaweza kurekebishwa pia kwa mixed log systems nje ya network congestion, kama server load, data center performance, cloud services na industrial telemetry.
Katika siku zijazo, thamani halisi ya mbinu itaeleweka ikiwa independent validation katika operators tofauti, open data na code, defined forecast horizon kwa future congestion, online-learning safety na edge-device performance vitaonyeshwa. LoRA na federated learning zilizopendekezwa na watafiti zinaweza kuchunguzwa kwa data privacy na kupunguza computational cost; lakini features hizi hazijatekelezwa katika utafiti wa sasa.
Mbinu na Matokeo ya Utafiti
Muhtasari wa kiufundi wa research design
| Component | Mbinu iliyotumika katika utafiti |
|---|---|
| Aina ya utafiti | Self-supervised AI model na real-time network-monitoring prototype |
| Data source | bmon network-interface counters |
| Test environment | UTP yenye pfSense na Issabel virtual machines |
| Monitored interface | WANbridge |
| Idadi ya metrics | 45 metrics × Rx/Tx = 90 symbolic metrics |
| Collection interval | sekunde 2 |
| Collection period | siku 7 |
| Log lines | 13.608.000 |
| Mixed tokens | 27.216.000 |
| Idadi ya sequences | 60.480 |
| Sequence length | 450 metric tokens + [CLS] = 451 |
| Modeli | Modified 12-layer BERT-Base |
| Hidden dimension | 768 |
| Attention heads | 12 |
| Vocabulary | 90 metrics + [CLS] + [MASK] = 92 |
| Numeric representation | Dynamic normalization na Linear(1,768) projection |
| Self-supervised objectives | MLKP na VHM |
| Masking ratio | %15 |
| Loss weights | Kwa kawaida α = 0,5 na β = 0,5 |
| Reported parameters | 86.691.164 |
| Software modules | 13 |
| Hardware | 8-core CPU, 32 GB RAM, NVIDIA T4 16 GB |
| Data sharing | Haipo |
| Code sharing | Haipo |
Performance kuu iliyoripotiwa
| Kipimo | E_LogBERT | KTeleBERT |
|---|---|---|
| Accuracy | 0,92 | 0,78 |
| Precision | 0,90 | 0,75 |
| Recall | 0,89 | 0,74 |
| F1 | 0,895 | 0,745 |
| AUC | 0,96 | 0,84 |
Jukumu la kisayansi la figures
| Figure | Maudhui yaliyoonyeshwa | Jukumu la kisayansi |
|---|---|---|
| Figure 1 | Transformation kutoka raw bmon output hadi descriptive timestamped logs | Kuonyesha data-preparation process |
| Figure 2 | E_LogBERT architecture yenye modules 13 | Kufupisha software components na majukumu yake |
| Figure 3 | Six-stage system workflow | Kuonyesha order ya processing kutoka data generation hadi alarm na prediction |
| Figure 4 | Live congestion monitoring dashboard | Kuonyesha visualization ya anomaly score na network status |
| Figure 5 | Detailed module na file flow | Kuonyesha connections kati ya system components |
| Figure 6 | Unified Telecom Platform test environment | Kueleza virtualized network structure ambako data zilikusanywa |
| Figure 7 | E_LogBERT na KTeleBERT performance bars | Kuonyesha differences za reported accuracy, precision, recall, F1 na AUC |
| Figure 8 | Accuracy kulingana na epoch count | Kuhalalisha choice ya training ya epochs tisa |
Taarifa zinazokosekana kwa reproducibility ya matokeo
- Open na measurable definition ya congestion class,
- Idadi ya normal na congested samples,
- Labeling au event-generation protocol,
- Time-based training–validation–test split,
- Random seeds na training repeats,
- KTeleBERT na LogBERT hyperparameters,
- Dynamic normalization window,
- Method ya kuchagua anomaly thresholds,
- Model inference na training latencies,
- Source code na version information,
- Trained model weights,
- Raw au anonymized dataset.
Tafsiri ya kiufundi
Wazo lenye maana zaidi la utafiti wa E_LogBERT ni kuchakata metric identity na numeric magnitude katika network log kama embeddings tofauti lakini zenye dimension sawa. Mbinu hii inaweza kuingiza quantitative relationships ambazo modeli zinazojifunza event order pekee hupoteza ndani ya attention mechanism.
Hata hivyo nguvu ya ushahidi wa high classification values zilizoripotiwa inategemea evaluation protocol. Kama overlapping windows zilizogawanywa kwa nasibu kutoka time series ileile ya siku saba zilitumiwa kwa pamoja katika training na test, similarity kubwa kati ya neighboring windows inaweza kuinua matokeo kwa njia ya bandia. Kwa kuwa chanzo hakielezi splitting method, uwezekano huu hauwezi kuondolewa.
Vivyo hivyo, accuracy ya %92 haina operational meaning peke yake bila ground-truth congestion label iliyoelezwa. Congestion inapaswa kuhusishwa na capacity utilization, latency, packet loss au quality-of-service threshold, na kupimwa modeli inatabiri threshold hii mapema kwa muda gani.
Maelezo ya Chanzo na Mbinu
Jina kamili asili la utafiti: E_LogBERT: Enhanced LogBERT for Realistic Telecom Networks Traffic
Waandishi: Kareem A. Mostafa, El-Sayed Soliman A. Said, Abdelhady A. Ammar, Sayed A. Nouh na M. Zaki.
Mpangilio wa waandishi: Mpangilio katika rekodi rasmi ya SSRN umehifadhiwa.
Mchango sawa: Contribution statement ya utafiti inaeleza kwamba waandishi wote walichangia kwa usawa katika maandalizi ya makala.
Mwandishi wa mawasiliano: Kareem A. Mostafa. Ameonyeshwa kama “Contact Author” katika rekodi ya SSRN.
Taasisi 1: Al-Azhar University, Cairo – Faculty of Engineering, Nasr City, Cairo 11371, Misri. Imeripotiwa kwa Kareem A. Mostafa.
Taasisi 2: Al-Azhar University, Qena 83513, Misri. Imeripotiwa kwa El-Sayed Soliman A. Said.
Taasisi nyingine: Institutional affiliations za Abdelhady A. Ammar, Sayed A. Nouh na M. Zaki hazipo katika toleo lililopakiwa wala rekodi rasmi ya SSRN.
Kiungo rasmi cha chanzo:Ukurasa rasmi wa rekodi ya SSRN
Jukwaa la uchapishaji: SSRN.
Tarehe ya kupakiwa: 24 Juni 2026.
Mwaka wa uchapishaji: 2026.
Idadi ya kurasa: 30.
Jarida: Hakuna jina maalumu la journal iliyopitiwa na wahakiki au accepted journal version katika chanzo hiki.
Mchapishaji wa peer review: Hakuna. SSRN ni preprint-distribution platform.
Aina ya chanzo: Preprint research article inayokusanya data katika network test environment, kuwasilisha mixed symbolic-numeric BERT model na modular real-time monitoring prototype.
Hali ya mapitio ya rika: Utafiti haujapitiwa na wahakiki. Kurasa zote za faili zina onyo la “Preprint not peer reviewed”.
Ufadhili: Imeelezwa kwamba open-access funding ilitolewa na ushirikiano wa Science, Technology & Innovation Funding Authority na Egyptian Knowledge Bank. Technical-development budget au separate project number haijaripotiwa.
Michango ya waandishi: Imeelezwa kwamba waandishi wote walichangia kwa usawa katika kuendeleza original ideas, kuandika makala na kupitia sehemu zote.
Mgongano wa maslahi: Waandishi wametangaza kwamba hakuna competing interest.
Upatikanaji wa data na materials: Umeripotiwa kama “Not applicable”. Hakuna data repository au anonymized log dataset iliyotolewa.
Upatikanaji wa code na modeli: Hakuna kiungo cha source code, model weights, dependency-lock file au reproducibility package.
Kikomo kikuu cha validation: Utafiti unaripoti high performance values katika controlled UTP test environment; lakini kwa kuwa independent test split, congestion-labeling method, forecast horizon na repeated-run uncertainty hazijatolewa, %92 accuracy haiwezi kutafsiriwa kama performance iliyothibitishwa kwa real operator network.
Onyo la consistency ya architecture: Mixed-token generation imeelezwa kwa njia mbili tofauti katika chanzo. Parameter table ina duplicated \(W_V\) row na missing numeric-projection layer. Vipengele hivi havijarekebishwa kimya kimya.
Onyo la anomaly score: Condition \(\alpha+\beta=1\) imetolewa kwa training weights, lakini baadaye hali ya \(\alpha=\beta=0\) imejadiliwa. Definitions hizi mbili haziwezi kuwa valid kwa wakati mmoja kimahesabu.
Kikomo cha dai la prediction: Utafiti unatoa current anomaly score na congestion classification; hakuna separate experiment inayopima future congestion imetabiriwa sekunde au dakika ngapi mapema.
Maudhui haya ya Kiswahili yameandaliwa kwa kutegemea tu text, equations, tables, system diagrams, dashboard na reported experimental results za utafiti uliopakiwa. Hakuna dai la operator field success, cyberattack detection accuracy, production-environment reliability au performance mahususi kwa Türkiye ambalo halipo katika utafiti lililoongezwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *