

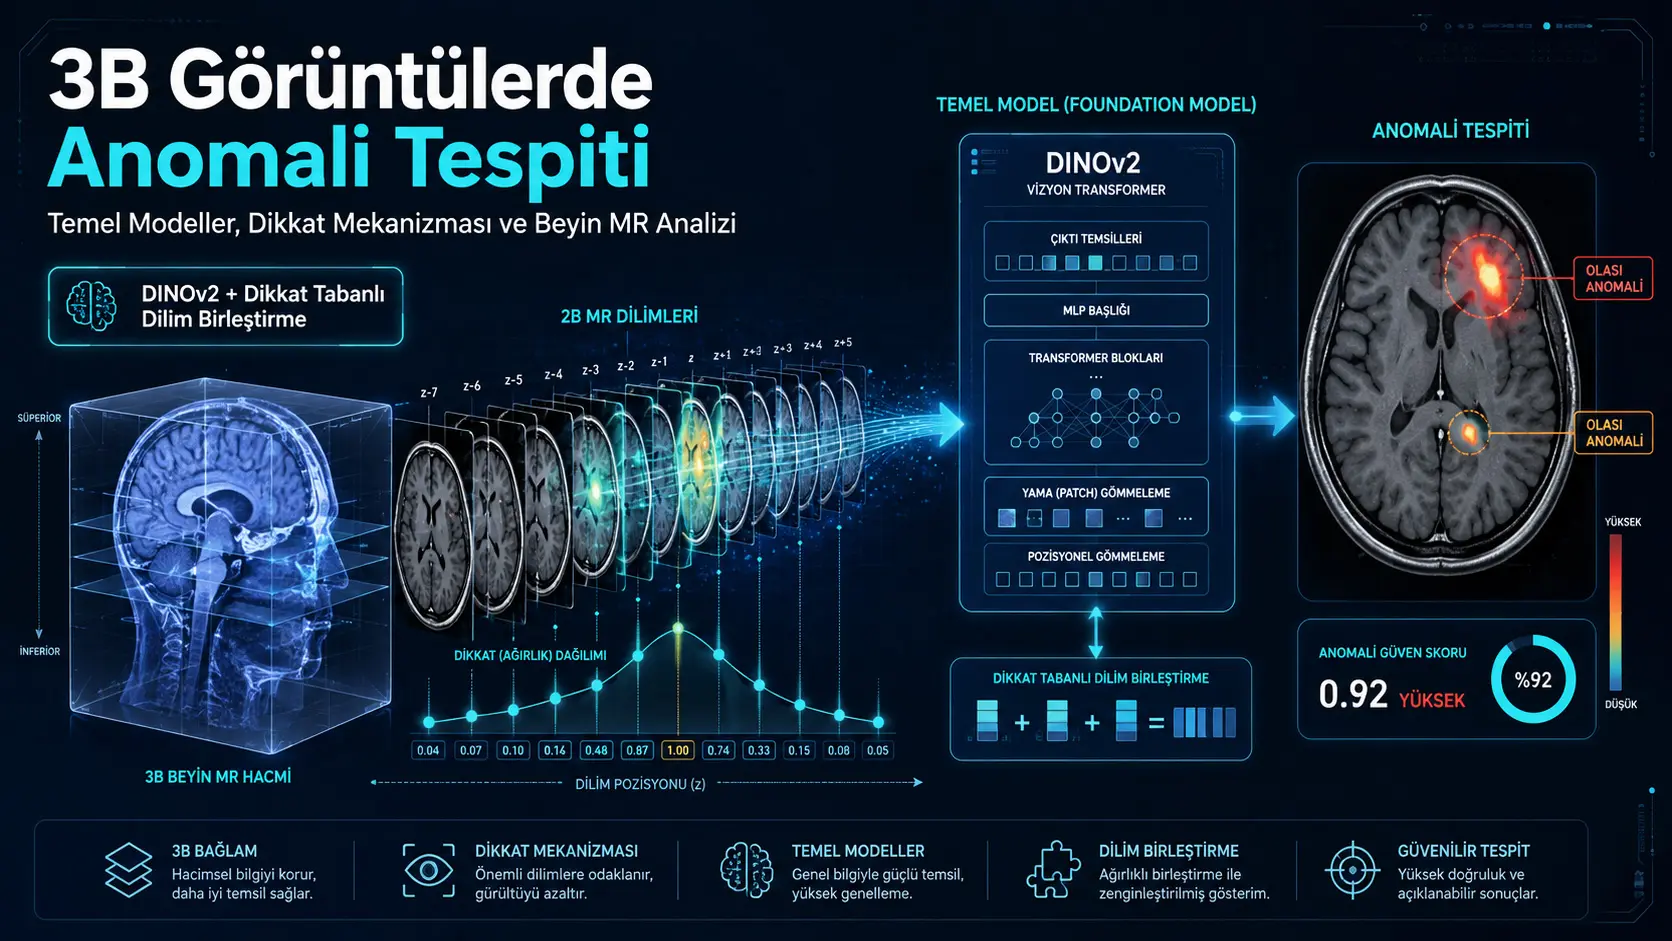
Utafiti huu umechunguza kama modeli msingi ya kuona ya DINOv2 iliyofundishwa awali kwenye picha za pande mbili inaweza kutumika katika uainishaji wa ujazo wa MRI za ubongo za pande tatu. Kila ujazo wa MRI uligawanywa katika vipande vya axial vya pande mbili, feature vectors zikatolewa kutoka kwenye vipande kwa kutumia DINOv2, na features hizi zikabadilishwa kuwa uwakilishi mmoja wa ujazo kupitia soft attention mechanism inayojifunza. Mfumo uliopendekezwa uliripoti %89,3 accuracy na %95,6 AUROC kwenye seti ya data ya Alzheimer’s Disease Neuroimaging Initiative; na %78,6 accuracy pamoja na %89,2 AUROC kwenye cohort ya maumivu ya kichwa yenye madarasa mengi. Hata hivyo, utafiti haujapitiwa na wahakiki; chanzo cha data ya taasisi, imaging protocols na maelezo ya external validation hayajakamilika. Aidha, majaribio yanapima zaidi supervised classification ya madarasa yaliyofafanuliwa mapema kuliko unknown anomaly detection kwa maana halisi.
Njia ya msingi ya modeli ni kuwakilisha kila kipande cha MRI kwa kutumia modeli msingi ya pande mbili iliyo tayari, badala ya kufundisha neural network ya pande tatu kutoka mwanzo. Mfumo kisha hauzipi vipande vyote uzito sawa; badala yake hutoa uzito mkubwa zaidi kwa vipande ambavyo umejifunza kuwa vina taarifa zaidi kwa uainishaji. Wakati wa training, supervised contrastive learning na within-class variance regularization ziliongezwa kwenye cross-entropy loss. Muundo huu unalenga kutengeneza volume representations zenye uwezo mkubwa wa kutofautisha chini ya hali za data chache zilizo na labels na class imbalance.
Kwa mtazamo wa Türkiye: Mbinu hii ni muhimu kwa tafiti za radiolojia nchini Türkiye kwa kutengeneza modeli za uainishaji wa MRI za ubongo kwa data chache zilizo na labels, kuchakata picha za pande tatu kutoka hospitali tofauti kwa gharama ndogo ya kompyuta, na kutathmini decision-support systems za matumizi ya utafiti. Hata hivyo kabla ya matumizi ya kliniki kuzingatiwa nchini Türkiye, external validation kwa data za ndani za vituo vingi, robustness analysis chini ya MRI scanners na acquisition protocols tofauti, comparison na radiologists, taratibu za data protection na ethics committee, model calibration na prospective clinical evaluation zinapaswa kufanywa. Kutokana na utafiti huu haiwezi kuhitimishwa kuhusu mafanikio ya utambuzi kwa wagonjwa wa Türkiye, matumizi salama katika hospitali nchini Türkiye au kuboreshwa kwa matokeo ya kliniki.
Swali kuu la utafiti ni lipi?
Swali kuu la utafiti ni jinsi modeli msingi ya pande mbili iliyofundishwa awali kwenye picha za kawaida inavyoweza kuhamishwa kwenye kazi za uainishaji za medical images za pande tatu. Data za MRI za pande tatu zina muundo wa ujazo, wakati modeli msingi za kuona zinazotumika sana kama DINOv2 hufanya kazi kwenye picha za pande mbili. Kwa hiyo, kuainisha tu kila kipande kando kunaweza kusababisha kupotea kwa volumetric context kati ya vipande vilivyo jirani.
Utafiti unapendekeza kutatua tatizo hili kwa kuunganisha features zilizotolewa kutoka kila kipande cha pande mbili kwa attention weights zinazojifunza. Lengo ni kuongeza mchango katika volume representation wa vipande vinavyojifunza kuwa muhimu zaidi kwa kutofautisha ugonjwa au darasa, badala ya kuchukua wastani rahisi wa vipande vyote.
Kwa nini utafiti ni muhimu?
Modeli za medical imaging za pande tatu kwa kawaida huhitaji idadi kubwa ya scans zilizo na labels, uwezo mkubwa wa kompyuta na kumbukumbu kubwa. Kuweka labels kwenye medical images na wataalamu ni ghali na huchukua muda. Kwa sababu hali adimu huwa na sampuli chache zaidi, class imbalance inaweza pia kutokea.
Utafiti ulitumia DINOv2 iliyofundishwa awali kama frozen feature extractor badala ya kufundisha modeli kubwa ya pande tatu kutoka mwanzo. Hivyo, attention module na classification head pekee ndizo zilizofundishwa kwenye task data. Chaguo hili linalenga kupunguza overfitting risk na idadi ya parameters zinazohitaji kufundishwa katika hali ya data chache.
Modeli ya DINOv2 iliyotumika hufanyaje kazi?
DINOv2 ni modeli ya Vision Transformer iliyofundishwa mapema kwa self-supervised learning isiyohitaji labels. Utafiti ulitumia toleo la ViT-Base lenye parameters milioni 86. Modeli hugawa picha katika patches ndogo na kuwakilisha mahusiano kati ya patches hizi kupitia self-attention mechanism.
Kila ujazo wa MRI ya ubongo uligawanywa katika axial slices. Slices ziliingizwa kwenye DINOv2 baada ya resizing, normalization na conversion kwenda image format inayotarajiwa na modeli. Kwa kila slice, feature vector ilitolewa kutoka penultimate layer ya modeli. Weights za DINOv2 hazikubadilishwa wakati wa training.
Attention-based global aggregation ni nini?
Attention-based global aggregation inategemea dhana kwamba slices tofauti za MRI si lazima zichangie kwa kiwango sawa katika volume-level classification. Baadhi ya slices zinaweza kubeba anatomical au pathological features zinazotenganisha madarasa, wakati nyingine zinaweza kuwa na taarifa chache.
Attention module katika utafiti hupeleka DINOv2 feature vector ya kila slice kwenye multilayer perceptron yenye layer moja. Module hii yenye hidden dimension ya 256 hutoa importance score kwa kila slice. Softmax hubadilisha scores hizi kuwa weights ambazo jumla yake ni 1. Volume representation ni weighted sum ya slice features kwa weights hizi.
- Ujazo wa MRI wa pande tatu hugawanywa kuwa axial slices za pande mbili.
- DINOv2 feature vector hutolewa kwa kila slice.
- Attention module hutoa content-based importance score kwa kila slice.
- Softmax hubadilisha scores kuwa weights zinazoweza kulinganishwa.
- Slice features hujumlishwa kwa uzito na volume vector moja hupatikana.
- Volume vector hupelekwa kwenye classification head.
Mbinu hii inaweza kupunguza athari ya slices zisizo na taarifa ikilinganishwa na simple averaging. Tofauti na max pooling, haitegemei slice moja tu au feature value moja. Hata hivyo si spatial model kamili ya pande tatu inayohifadhi mpangilio wa slices; geometric relationships kati ya slices jirani hazimodeliwi wazi.
Composite training objective inalenga nini?
Utafiti ulitumia loss components tatu kwa pamoja:
- Cross-entropy loss: Hupunguza kutolingana kati ya class probabilities zinazotabiriwa na modeli na true class labels.
- Supervised contrastive learning: Husogeza volume representations za darasa moja karibu katika feature space huku ikisogeza madarasa tofauti mbali.
- Within-class variance regularization: Inalenga kuzuia variability kupita kiasi kati ya representations za samples za darasa moja.
Uzito wa 0,5 ulitumika kwa contrastive loss, na 0,1 kwa within-class variance regularization. Temperature parameter ya contrastive learning iliwekwa kuwa 0,1. Utafiti haukutoa explicit mathematical formula ya total loss function; kwa hiyo haitakuwa sahihi kutengeneza formula mpya zaidi ya maelezo ya maneno ya components.
Ni seti gani za data zilitumika?
Seti ya data ya kwanza ni collection ya Alzheimer’s Disease Neuroimaging Initiative (ADNI), inayotumika katika tafiti za Alzheimer’s disease. Utafiti ulilinganisha normal individuals na Alzheimer’s disease class. Jumla ya scans 380 ziliripotiwa, ikiwa watu 190 katika kila darasa.
Seti ya data ya pili ni institutional cohort inayojumuisha madarasa ya normal control, migraine, tension-type headache na cluster headache. Jumla ya samples ni 410. Hata hivyo jina la taasisi ambako data zilikusanywa, labeling criteria, demographic characteristics za wagonjwa na imaging protocol hazijaelezwa katika utafiti.
| Seti ya data | Darasa | Training | Validation | Test | Jumla |
|---|---|---|---|---|---|
| ADNI | Normal | 120 | 30 | 40 | 190 |
| ADNI | Alzheimer’s disease | 120 | 30 | 40 | 190 |
| Headache cohort | Normal | 80 | 20 | 25 | 125 |
| Headache cohort | Migraine | 80 | 20 | 25 | 125 |
| Headache cohort | Tension-type | 60 | 15 | 20 | 95 |
| Headache cohort | Cluster headache | 40 | 10 | 15 | 65 |
Data ziligawanywa katika training, validation na test sets katika kiwango cha mtu. Imeelezwa kwamba split ilifanywa katika subject level ili kuzuia slices za mtu yuleyule kuingia katika seti tofauti. Mbinu hii ni muhimu kwa kuzuia data leakage katika slice level.
Matokeo makuu yanaonyesha nini?
Mfumo uliopendekezwa ulitoa matokeo ya juu kuliko mbinu tano kuu za comparison zilizotumika katika utafiti kwenye seti zote mbili za data. Katika ADNI test, accuracy ilikuwa %89,3, F1 score %89,3 na AUROC %95,6. Katika headache cohort, accuracy ilikuwa %78,6, F1 score %78,6 na AUROC %89,2.
| Mbinu | ADNI accuracy (%) | ADNI F1 (%) | ADNI AUROC (%) | Headache accuracy (%) | Headache F1 (%) | Headache AUROC (%) |
|---|---|---|---|---|---|---|
| Slice averaging | 82,5 ± 1,8 | 82,5 ± 1,9 | 89,1 ± 1,5 | 68,4 ± 2,3 | 68,4 ± 2,4 | 78,9 ± 2,0 |
| Max pooling | 83,1 ± 2,0 | 83,1 ± 2,1 | 89,8 ± 1,6 | 69,2 ± 2,5 | 69,2 ± 2,6 | 79,6 ± 2,1 |
| 3D CNN | 85,6 ± 1,6 | 85,6 ± 1,7 | 92,3 ± 1,2 | 72,8 ± 2,0 | 72,8 ± 2,0 | 84,1 ± 1,7 |
| ImageNet transfer | 86,8 ± 1,5 | 86,8 ± 1,6 | 93,1 ± 1,1 | 74,1 ± 1,8 | 74,1 ± 1,8 | 85,6 ± 1,5 |
| Mfumo uliopendekezwa | 89,3 ± 1,3 | 89,3 ± 1,3 | 95,6 ± 0,9 | 78,6 ± 1,6 | 78,6 ± 1,6 | 89,2 ± 1,2 |
Katika seti ya data ya ADNI, mbinu iliyopendekezwa ilitoa accuracy ya pointi 2,5 za asilimia juu kuliko ImageNet transfer baseline, na pointi 3,7 za asilimia juu kuliko 3D CNN iliyofundishwa kutoka mwanzo. Katika headache cohort, tofauti dhidi ya ImageNet transfer ilikuwa pointi 4,5 za asilimia na dhidi ya 3D CNN pointi 5,8 za asilimia. Hata hivyo hakuna separate comparison test au p value iliyotolewa kwa statistical significance ya tofauti hizi.
Utendaji ulibadilikaje kati ya madarasa ya maumivu ya kichwa?
Katika headache cohort, F1 score ya juu zaidi iliripotiwa katika migraine class kwa %81,0, na ya chini zaidi katika cluster headache class kwa %72,1. Cluster headache class pia ndiyo yenye training na test samples chache zaidi. Matokeo haya yanaonyesha kwamba performance katika madarasa madogo inahitaji kutathminiwa kando; hata hivyo utafiti haukufanya causal analysis kati ya class size na error rate.
| Darasa | Precision (%) | Recall (%) | F1 score (%) |
|---|---|---|---|
| Normal | 80,5 ± 2,1 | 81,2 ± 2,3 | 80,8 ± 2,2 |
| Migraine | 81,3 ± 2,0 | 80,7 ± 2,2 | 81,0 ± 2,1 |
| Tension-type headache | 77,8 ± 2,5 | 76,9 ± 2,7 | 77,3 ± 2,6 |
| Cluster headache | 72,4 ± 3,1 | 71,8 ± 3,3 | 72,1 ± 3,2 |
Majaribio ya ablation yanaonyesha component gani ni muhimu zaidi?
Katika majaribio ya ablation, kushuka kubwa zaidi kulionekana attention mechanism ilipoondolewa. Kuondoa attention kulishusha ADNI accuracy kutoka %89,3 hadi %86,8, na headache accuracy kutoka %78,6 hadi %75,2. Kwa maneno mengine, mchango wa attention module unakokotolewa kuwa pointi 2,5 na 3,4 za asilimia katika seti mbili za data, mtawalia.
| Configuration | ADNI accuracy (%) | Headache accuracy (%) |
|---|---|---|
| Mfumo kamili | 89,3 ± 1,3 | 78,6 ± 1,6 |
| Bila attention mechanism | 86,8 ± 1,5 | 75,2 ± 1,9 |
| Bila contrastive learning | 87,5 ± 1,4 | 76,3 ± 1,8 |
| Bila within-class variance regularization | 88,1 ± 1,3 | 77,1 ± 1,7 |
| Bila attention na contrastive learning | 84,2 ± 1,7 | 72,8 ± 2,0 |
| Linear classifier pekee | 81,5 ± 2,0 | 69,5 ± 2,2 |
Kuondoa contrastive learning kulipunguza accuracy kwa pointi 1,8 za asilimia katika ADNI na pointi 2,3 katika headache cohort. Athari ya within-class variance regularization ilikuwa ndogo zaidi; kushuka kulikuwa pointi 1,2 na 1,5 za asilimia, mtawalia. Ulinganisho huu unaonyesha kwamba components zinahusiana na matokeo ya modeli. Hata hivyo kwa kuwa training runs tofauti, random initializations na statistical comparisons hazijaripotiwa kwa kina, uhakika wa michango hii ni mdogo.
Utafiti unaunga mkono matokeo gani?
- Features za slices za pande mbili zilizotolewa kutoka DINOv2 zinaweza kuunganishwa katika kiwango cha volume kwa attention mechanism inayojifunza.
- Muundo uliopendekezwa ulitoa matokeo ya juu kuliko simple averaging, max pooling, 2D CNN, 3D CNN na standard transfer-learning baselines katika data splits zilizotumika katika utafiti.
- Katika matokeo ya ablation, mchango mkubwa zaidi wa component moja ulionekana katika attention-based slice weighting.
- Contrastive learning na within-class variance regularization zilitoa mchango wa ziada katika matokeo ya full model.
- Performance ya modeli ilikuwa ya juu zaidi katika binary ADNI task kuliko katika four-class headache task.
Utafiti hauthibitishi nini?
- Haudhibitishi kwamba modeli inaweza kufanya clinical diagnosis au kuchukua nafasi ya radiologist.
- Hauonyeshi kwamba modeli inaweza kugundua magonjwa mapya au unknown anomalies ambayo hayakuonekana wakati wa training.
- Hauonyeshi kwamba headache classification itatoa matokeo yale yale katika hospitali, scanners au patient populations tofauti.
- AUROC kubwa haimaanishi kwamba modeli ni salama kliniki, calibrated au kwamba inaboresha patient outcomes.
- Haijathibitishwa kwamba attention weights zinaonyesha disease mechanism halisi au causal anatomical relationship.
- Hautoi matokeo ya moja kwa moja kwa patient groups au healthcare institutions nchini Türkiye.
Upungufu katika maelezo ya visual una maana gani?
Utafiti unaeleza kwamba Figure ya kwanza inaonyesha slice attention weights kwenye ADNI samples, na Figure ya pili inaonyesha t-SNE projection ya volume representations. Kulingana na maandishi, modeli ilitoa uzito mkubwa zaidi kwa mid-brain slices zinazohusishwa na hippocampal atrophy na ventricular enlargement katika Alzheimer’s disease. Pia inadaiwa kwamba visualization ya t-SNE ilionyesha separation kati ya normal na Alzheimer classes.
Hata hivyo katika toleo lililopakiwa, figures zote mbili zina titles pekee; attention curves, MRI slices na t-SNE plot hazionekani. Kwa hiyo visual interpretations kwenye maandishi hazikuweza kuchunguzwa kwa kujitegemea. Aidha, attention weight pekee haipaswi kuchukuliwa kama clinical evidence inayotegemewa ya sababu ya uamuzi wa modeli.
Ni nguvu zipi za utafiti?
- Seti mbili tofauti za data na viwango viwili tofauti vya difficulty ya classification zilitumika.
- Imeelezwa kwamba data splitting ilifanywa katika kiwango cha subject.
- Badala ya baseline moja rahisi, mbinu tano tofauti za comparison ziliwasilishwa.
- Attention, contrastive learning na variance regularization zilitathminiwa kando kwa ablation experiments.
- Mbali na accuracy, precision, recall, F1 na AUROC values ziliripotiwa.
- Imeelezwa kwamba bootstrap ya iterations 1.000 ilitumika kutathmini variability ya matokeo.
Ni mapungufu gani ya utafiti?
Kikomo muhimu zaidi ni ukosefu wa maelezo yanayohitajika ili data na majaribio yaweze kuzalishwa upya kikamilifu. Chanzo cha institutional cohort, patient selection, labeling process, scanner characteristics, MRI sequences na data access hazijaelezwa. Preprocessing steps zimetolewa kwa kiwango cha jumla; software na parameters zilizotumika kwa skull stripping, atlas registration, resampling na intensity normalization hazijatajwa.
Data nje ya ADNI zinategemea institutional cohort moja. Hakuna multi-center external validation. Model calibration, decision threshold, idadi ya false positive na false negative samples, confusion matrix, specificity na positive predictive value—maelezo muhimu kwa clinical interpretation—hayajatolewa.
Ingawa utafiti umetumia neno “anomaly detection”, mbinu si one-class au unsupervised system inayotambua deviation kutoka normal data kwa njia ya wazi. Modeli hutenganisha madarasa yaliyofafanuliwa wakati wa training. Mtafiti pia anakubali hili kama limitation na anapendekeza kwamba kwa anomaly detection halisi, one-class structure inayofundishwa kwa normal data pekee ichunguzwe siku zijazo.
Mbinu na Matokeo ya Utafiti
Maandalizi ya data na mtiririko wa modeli
| Hatua | Mchakato uliotumika katika utafiti | Maelezo yaliyokosekana au yasiyo wazi |
|---|---|---|
| Preprocessing | Skull stripping, intensity normalization, registration kwenye atlas space, resampling na cropping | Software, atlas, resolution na parameters zilizotumika hazijatajwa. |
| Slice generation | Volumes ziligawanywa katika axial slices. | Idadi ya slices, thickness na spacing hazijaelezwa. |
| Feature extraction | Penultimate layer ya frozen DINOv2 ViT-Base model | Input resolution na extracted feature dimension hazijatajwa. |
| Attention module | Single-layer MLP yenye hidden dimension 256 na softmax | Activation function na full layer definition hazikutolewa. |
| Classifier | Two-layer MLP yenye hidden dimensions 256 na 128 | Dropout au regularization details nyingine hazikutolewa. |
| Training | AdamW, learning rate 0,001, weight decay 0,0001, batch size 32 | Random seeds na idadi ya repeated training runs hazijaelezwa. |
| Schedule | Warmup ya epochs 10, cosine decay, hadi epochs 200, early stopping patience ya epochs 20 | Mbali na validation accuracy, haijaelezwa kwa kina metric iliyotumika kuchagua best model. |
| Hardware | NVIDIA A100 GPU moja yenye 40 GB memory | Training na inference times hazikutolewa. |
Loss function na data augmentation
Katika total training objective, cross-entropy ilitumika kama component kuu. Supervised contrastive loss iliongezwa kwa uzito 0,5 na within-class variance regularization kwa uzito 0,1. Random rotation, translation na intensity transformations zilitumika kwenye data. Hata hivyo ranges na probabilities za transformations hazijaripotiwa.
Vigezo vya tathmini
- Accuracy: Uwiano wa test samples zilizowekwa katika darasa sahihi dhidi ya samples zote.
- Precision: Huonyesha ni kiasi gani cha samples zinazotabiriwa kuwa za darasa fulani kweli ni za darasa hilo.
- Recall: Huonyesha ni kiasi gani cha samples halisi za darasa kimegunduliwa na modeli.
- F1 score: Ni harmonic mean ya precision na recall.
- AUROC: Hufupisha uwezo wa modeli kutenganisha madarasa kupitia decision thresholds tofauti.
Imeelezwa kwamba metrics zilikokotolewa kwa kila darasa na kisha kuwekewa wastani. Bootstrap iterations 1.000 zilitumika kwa uncertainty estimation. Hata hivyo haijaandikwa wazi “±” values kwenye tables zinawakilisha confidence level gani.
Tafsiri ya kiufundi ya matokeo
AUROC ya %95,6 katika ADNI task inaonyesha kwamba modeli ilitoa discrimination yenye nguvu katika ranking ya normal na Alzheimer classes kwenye test set iliyotumika. Hata hivyo test set ina watu 80 tu. AUROC pekee haionyeshi idadi ya false negatives na false positives katika clinical decision threshold maalumu.
AUROC ya %89,2 na accuracy ya %78,6 katika headache cohort zinaonyesha kwamba four-class task ni ngumu zaidi kuliko binary ADNI task. Class performance ya chini zaidi ilionekana katika cluster headache. Kwa kuwa test set ya class hii ina watu 15 tu, uncertainty katika measurements inaweza kuwa juu zaidi kuliko katika madarasa mengine.
Ablation analyses zinaunga mkono kwamba attention mechanism ndiyo additional component yenye athari kubwa zaidi katika modeli. Hata hivyo utafiti haukufanya comparison pana na attention architectures tofauti, 3D foundation models au foundation models zilizofundishwa awali kwenye medical images. Kwa hiyo matokeo hayaonyeshi kwamba attention approach ni bora kuliko alternatives zote; yanaonyesha tu kwamba ilitoa matokeo ya juu dhidi ya baselines zilizochaguliwa katika utafiti.
Maelezo ya Chanzo na Mbinu
Jina kamili asili la utafiti: Leveraging Foundation Models for 3D Image Anomaly Detection
Mwandishi: Michael Harris
Mpangilio wa waandishi: Utafiti wa mwandishi mmoja
Mwandishi mwenza wa kwanza: Hakuna.
Mwandishi wa mawasiliano: Kwenye rekodi ya SSRN, Michael Harris ameonyeshwa kama corresponding author.
Taasisi: The University of Texas at Austin, Texas, Marekani
Jarida: Utafiti haujachapishwa katika jarida.
Mchapishaji: Hakuna taarifa ya original journal publisher.
Jukwaa: SSRN
Mwaka wa uchapishaji: 2026
Aina ya chanzo: Preprint yenye sifa ya experimental machine-learning study
Hali ya mapitio ya rika: Utafiti huu ni preprint ambayo haijapitiwa na wahakiki; matokeo yanapaswa kusomwa kwa kuzingatia limitation hii.
Kiungo rasmi:Ukurasa wa utafiti wa SSRN
Makala haya yameandaliwa kwa kupitia utafiti wa kurasa 37 uliopakiwa kutoka mwanzo hadi mwisho. Mbinu ya kisayansi, idadi za data na performance results zinategemea tu taarifa zilizoripotiwa katika utafiti. Hakuna dai la clinical success, diagnostic safety au performance maalumu kwa Türkiye ambalo halipo katika utafiti lililoongezwa.
Kuna inconsistency katika source identity inayohitaji kufafanuliwa: cover inayoonekana ya utafiti na rekodi ya SSRN zinaonyesha Michael Harris kama mwandishi, wakati author field katika technical metadata ya faili ina jina tofauti. Aidha, chanzo cha institutional headache cohort, imaging protocols, detailed ethics process na data-access conditions hazijaelezwa.
Utafiti si clinical validation study. Modeli haikulinganishwa na radiologists, haikujaribiwa katika prospective clinical setting, haikufanyiwa external validation katika hospitali tofauti na athari yake kwa patient outcomes haikutathminiwa. Matokeo ni halali tu kwa datasets, data splits na experimental conditions zilizoripotiwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *