

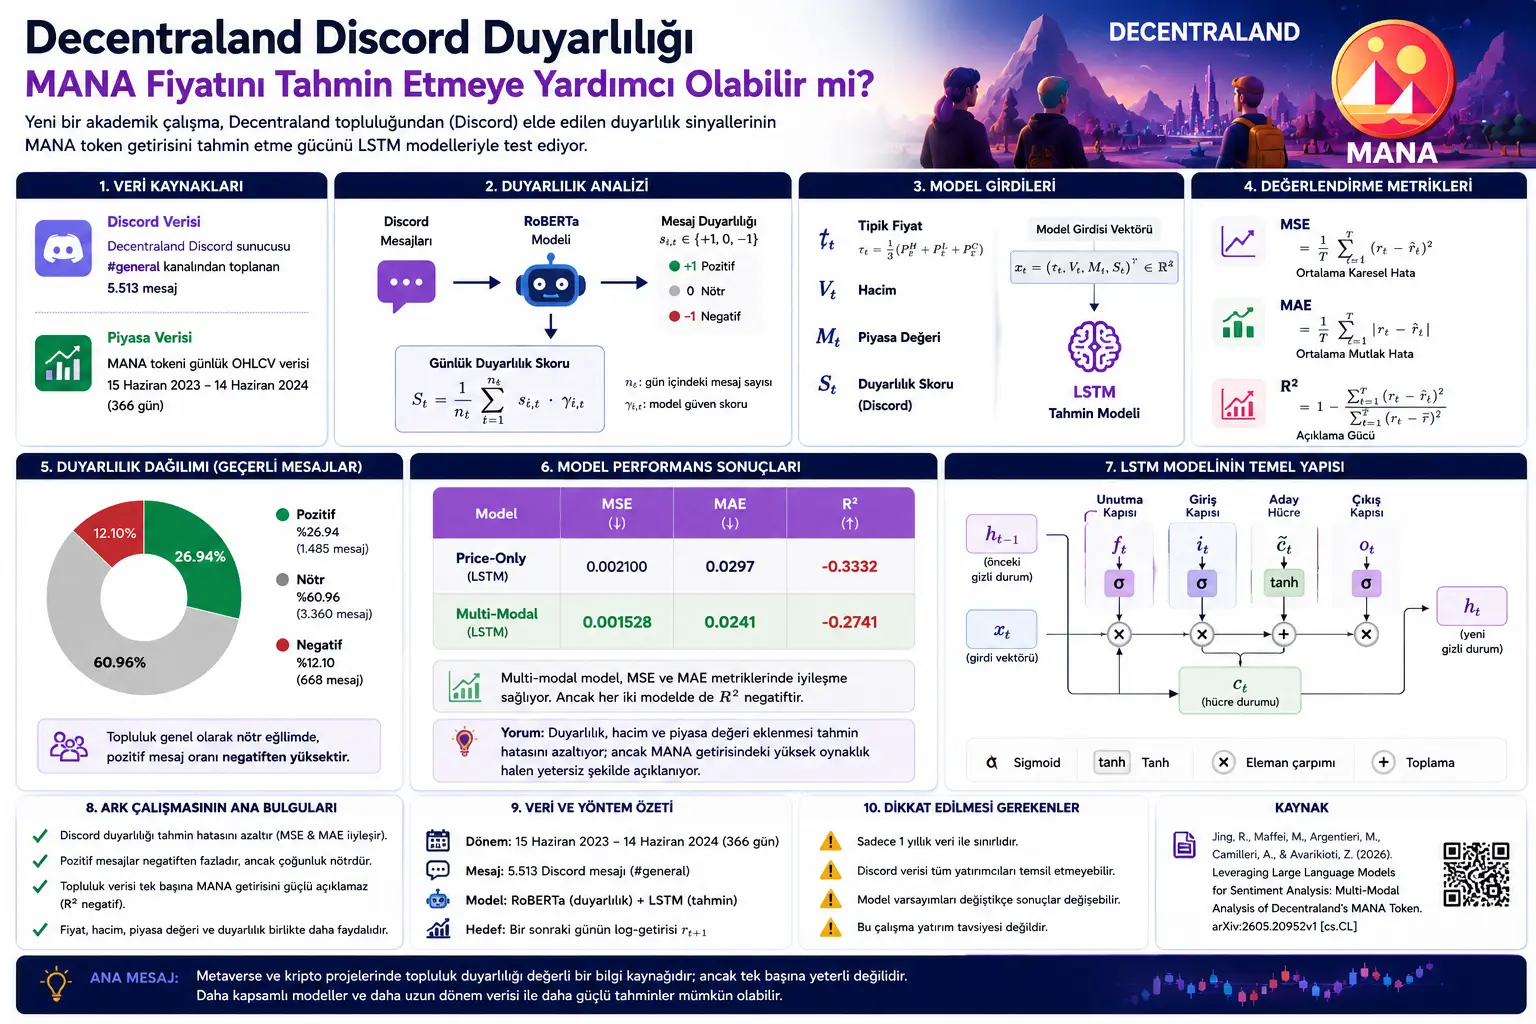
Makala haya yametayarishwa kutokana na utafiti wa kitaaluma unaochunguza uhusiano kati ya hisia za jamii na utabiri wa bei kwa tokeni ya MANA katika mfumo wa ikolojia wa Decentraland. Utafiti uliochunguzwa una kichwa Leveraging Large Language Models for Sentiment Analysis: Multi-Modal Analysis of Decentraland’s MANA Token.
Lengo la utafiti ni kupima ikiwa ishara za hisia zinazotokana na jumbe katika jamii ya Discord ya Decentraland zinatoa thamani ya ziada kwa data ya bei katika kutabiri faida ya tokeni ya MANA. Kwa hili, kiainishaji cha hisia kinachotegemea RoBERTa kilitumika, kisha miundo ya utabiri wa bei pekee na modeli za lugha nyingi zililinganishwa kwa kutumia mifano ya LSTM.
Maudhui haya si ushauri wa uwekezaji. Utafiti huu unawasilisha jaribio la utabiri wa kitaaluma juu ya data ya jamii ya Decentraland na data ya soko la MANA. Matokeo yanategemea data ya kihistoria, mawazo maalum ya mfano, na kipindi kidogo cha data. Kwa hivyo, haipaswi kufasiriwa kama pendekezo la moja kwa moja la kununua/kuuza au utabiri kamili wa soko.
Utafiti mpya wa kitaaluma unajaribu kufanya utabiri wa faida ya tokeni ya MANA ya Decentraland kwa kuchanganya jumbe za jamii ya Discord na bei, kiasi, na thamani ya soko. Katika utafiti, jumbe za Discord zinaainishwa kama chanya, zisizoegemea upande wowote, na hasi kwa kutumia modeli ya hisia inayotegemea RoBERTa. Kisha, modeli ya LSTM ya bei pekee na modeli ya LSTM ya lugha nyingi inayojumuisha hisia, kiasi, na thamani ya soko inalinganishwa. Matokeo yanaonyesha kuwa hisia za jamii zinaweza kupunguza makosa ya utabiri; hata hivyo, viwango hasi vya \(R^2\) vinaonyesha kuwa modeli bado haiwezi kueleza vya kutosha ubadilikaji mpana wa soko katika faida ya MANA.
1. Kichwa
Miradi ya Metaverse si majukwaa ya kiufundi pekee, bali pia ni chumi za kidijitali ambamo jamii huingiliana kikamilifu. Katika ulimwengu wa mtandaoni kama vile Decentraland, watumiaji huwasiliana mara kwa mara kuhusu ardhi ya kidijitali, avata, matukio, NFT, na michakato ya utawala. Baadhi ya mawasiliano haya yanaweza kuonyesha uaminifu, kuridhika, au kukatishwa tamaa kuelekea jukwaa.
Tokeni ya MANA ni rasilimali ya crypto inayohusiana na miamala ya rasilimali pepe na utawala katika mfumo wa ikolojia wa Decentraland. Kwa hivyo, ikiwa hisia za jamii zina uhusiano na bei au faida ya tokeni ni swali muhimu la utafiti.
Tatizo kuu la utafiti ni hili: Je, ishara za hisia zinazopatikana kutoka kwa njia za jamii kama Discord zinaweza kutoa matokeo bora kuliko modeli za utabiri zinazotegemea historia ya bei pekee?
Swali hili ni muhimu sana kwa chumi za metaverse. Kwa sababu katika miradi kama hii, mienendo ya bei haiathiriwi tu na soko kuu la crypto, lakini pia na uzoefu wa mtumiaji ndani ya jukwaa, maslahi ya jamii, matukio, masuala ya kiufundi, na mtazamo wa utawala.
2. Muhtasari mfupi
Utafiti unachanganya vyanzo viwili kuu vya data. Chanzo cha kwanza ni data ya soko la kila siku kwa tokeni ya MANA. Data hii inajumuisha nyanja za kawaida za kifedha kama vile bei ya ufunguzi, juu, chini, bei ya kufunga, kiasi cha biashara, na thamani ya soko. Chanzo cha pili ni jumbe za kituo cha #general katika jamii ya Discord ya Decentraland.
Kwa data ya maandishi, modeli ya hisia ya mitandao ya kijamii inayotegemea RoBERTa hutumiwa. Kila ujumbe hupokea lebo ya hisia chanya, isiyoegemea upande wowote, au hasi. Kisha alama ya hisia ya kila siku inahesabiwa. Alama hii ya kila siku inaingizwa katika modeli ya LSTM ya lugha nyingi pamoja na bei, kiasi, na thamani ya soko.
Katika utafiti huu, mbinu mbili za LSTM zinalinganishwa:
Price-only baseline: Modeli inatumia tu maelezo ya kawaida ya bei.
Multi-modal model: Modeli inatumia bei ya kawaida, kiasi cha biashara, thamani ya soko, na alama ya kila siku ya hisia za Discord kwa pamoja.
Ulinganisho huu unalenga kupima ikiwa data ya hisia inatoa maelezo ya ziada ikilinganishwa na modeli ya bei pekee.
3. Maelezo ya kina
Fomula katika utafiti zinaonyesha jinsi bei ya MANA inavyowakilishwa, jinsi faida inavyohesabiwa, jinsi alama ya kila siku ya hisia inavyozalishwa kutoka kwa jumbe za Discord, na muundo wa msingi wa modeli ya utabiri ya LSTM.
1. Bei ya kawaida
Katika utafiti, bei ya kawaida inatumika kupunguza bei ya kila siku kwa thamani moja ya uwakilishi:
Hapa \(P_t^H\) inawakilisha bei ya juu zaidi ya siku; \(P_t^L\), bei ya chini zaidi ya siku; \(P_t^C\), bei ya kufunga. Bei ya kawaida inawakilisha anuwai ya bei ya ndani ya siku kwa njia iliyolainishwa zaidi, badala ya kuangalia tu kufungwa.
2. Faida endelevu
Faida ya tokeni inahesabiwa kama faida ya logarithmiki juu ya bei ya kawaida:
Fomula hii hupima mabadiliko ya bei ya jamaa kati ya siku mbili zinazofuatana. Matumizi ya faida ya logi ni njia ya kawaida ya kufanya viwango vya bei kulinganishwa katika mfululizo wa muda wa kifedha.
3. Lebo ya hisia katika kiwango cha ujumbe
Kwa kila ujumbe wa Discord, modeli hutoa lebo ya hisia:
Hapa \(+1\) inaonyesha hisia chanya, \(0\) isiyoegemea upande wowote, na \(-1\) hisia hasi. \(i\) inaonyesha ujumbe ndani ya siku hiyo hiyo; \(t\) inaonyesha siku.
4. Alama ya hisia ya kila siku
Hisia ya kila siku inahesabiwa kwa kutumia hisia ya ujumbe na uaminifu wa modeli kwa pamoja:
Hapa \(n_t\) ni idadi ya jumbe katika siku ya \(t\). \(\gamma_{i,t}\) inawakilisha alama ya uaminifu wa modeli kwa ujumbe husika. Muundo huu hauzingatii mwelekeo wa lebo pekee, bali pia ni kiasi gani modeli inaamini lebo hiyo.
5. Madarasa ya hisia
Katika utafiti, alama ya hisia ya kila siku imegawanywa katika kanda tatu:
Vizingiti hivi hutumiwa kufupisha hali ya jamii ya kila siku kama chanya, isiyoegemea upande wowote, au hasi.
6. Vibadili vya ingizo vya LSTM
Katika modeli ya bei pekee, ingizo ni bei ya kawaida tu:
Katika modeli ya lugha nyingi, vekta ya ingizo inajumuisha vipengele vinne:
Hapa \(V_t\) inaonyesha kiasi cha biashara; \(M_t\), thamani ya soko; na \(S_t\), alama ya kila siku ya hisia za Discord. Muundo huu huruhusu modeli kuzingatia si tu historia ya bei, bali pia data ya jamii na taarifa za ukubwa wa soko.
7. Muundo wa lango la LSTM
Katika utafiti, utaratibu wa msingi wa lango la LSTM umeonyeshwa kwa urahisi kama ifuatavyo:
Hapa \(i_t\) inawakilisha lango la kuingia; na \(o_t\), lango la kutoka. \(\sigma\) ni chaguo la sigmoid. Kupitia malango haya, LSTM inajaribu kujifunza ni kiasi gani cha taarifa zilizopita inapaswa kubeba na ni kiasi gani inapaswa kuzingatia ingizo jipya.
8. Kosa la wastani la mraba
Kipimo cha kwanza kinachotumiwa kupima utendaji wa utabiri ni MSE:
MSE huadhibu makosa makubwa ya utabiri kwa ukali zaidi. Inatumika kupima jinsi modeli inatabiri faida kwa ukaribu kiasi gani.
9. Kosa la wastani kamili
Kipimo cha pili cha kosa ni MAE:
MAE inatoa ukubwa wa wastani kamili wa makosa ya utabiri. Haichukulii makosa ya nje kwa ukali kama MSE inavyofanya.
10. Nguvu ya maelezo: \(R^2\)
Kiasi gani modeli inaweza kuelezea ubadilikaji wa faida hupimwa na \(R^2\):
Wakati \(R^2\) ni chanya, modeli inachukuliwa kuwa yenye maelezo zaidi ikilinganishwa na utabiri wa wastani. Katika utafiti huu, \(R^2\) ilibaki hasi katika modeli zote mbili. Hii inaonyesha kuwa hata ukiongeza data ya hisia na soko, ubadilikaji mpana katika faida ya MANA bado hauwezi kuelezewa vya kutosha.
4. Mbinu na matokeo ya utafiti
Kielelezo 1 katika PDF, kinaonyesha njia ya data ya utafiti. Jumbe za Discord hupitishwa kupitia modeli ya hisia inayotegemea RoBERTa. Alama ya hisia ya kila siku \(S_t\) huundwa. Kisha alama hii huhamishiwa kwa modeli ya utabiri ya LSTM pamoja na viashiria vya kifedha kama vile bei ya kawaida \(\tau_t\) na kiasi cha biashara \(V_t\).
Kielelezo 2 kinafupisha usambazaji wa hisia za jamii na utendaji wa modeli. Sehemu kubwa ya jumbe za Discord imekusanywa katika tabaka lisiloegemea upande wowote. Katika utafiti, kiwango cha jumbe chanya kimeripotiwa kuwa takriban 26.94%, kiwango cha jumbe zisizoegemea upande wowote 60.96%, na kiwango cha jumbe hasi kikiwa 12.10%. Usambazaji huu unaonyesha kuwa hisia za jamii kwa ujumla haziegemei upande wowote lakini zinaelekea upande chanya.
Kwa upande wa utendaji wa modeli, muundo wa lugha nyingi umepunguza vipimo vya makosa ikilinganishwa na modeli ya LSTM ya bei pekee. Katika sehemu kuu ya matokeo, imeelezwa kuwa thamani ya MSE inashuka kutoka 0.002100 hadi 0.001528, na thamani ya MAE inashuka kutoka 0.0297 hadi 0.0241. Hata hivyo, kwa kuwa \(R^2\) ilibaki hasi katika modeli zote mbili, uboreshaji huu unapaswa kufasiriwa kwa mipaka.
Jedwali la ulinganisho wa modeli katika kiambatisho cha PDF pia linatoa ujumbe sawa. Katika wastani wa majaribio manane huru, MSE inaripotiwa kama 5.84 kwa modeli ya bei pekee, na 5.40 kwa modeli iliyoongezwa hisia. Wastani wa MAE pia ulishuka kidogo sana, na \(R^2\) iliboreka kutoka kiwango cha -0.266 hadi kiwango cha -0.170. Hii inaonyesha kuwa maelezo ya hisia yanaweza kutoa mchango lakini bado hayaunde modeli yenye nguvu ya maelezo.
5. Maelezo ya chanzo na mbinu
Katika utafiti, data ya kila siku ya OHLCV ya tokeni ya MANA imetumika. Kipindi cha data kinashughulikia siku 366 kati ya tarehe 15 Juni 2023 na 14 Juni 2024. Data ya soko inajumuisha nyanja za kufungua, juu, chini, kufunga, kiasi cha biashara na thamani ya soko.
Kwa upande wa data ya maandishi, jumbe katika kituo cha #general cha jamii ya Discord ya Decentraland vimetumika. Katika hatua ya kwanza, jumbe 5,883 zilikusanywa, na baada ya kuondoa rekodi batili, hifadhidata ya mwisho ya maandishi ilijumuisha jumbe 5,513.
Kila ujumbe umeainishwa na modeli ya hisia inayotegemea RoBERTa. Baadaye, jumbe ziliunganishwa katika kiwango cha kila siku na alama ya hisia ya \(S_t\) ikahesabiwa.
Katika sehemu ya utabiri, modeli ya LSTM ilitumika. Wakati modeli ya bei pekee inatumia bei ya kawaida tu, modeli ya lugha nyingi inatumia bei ya kawaida, kiasi cha biashara, thamani ya soko na alama ya hisia kwa pamoja. Utendaji ulipimwa na vipimo vya MSE, MAE na \(R^2\).
6. Lebo za meta
Matokeo ya kwanza ya utafiti ni kwamba hisia katika jamii ya Discord ya Decentraland kwa kiasi kikubwa haziegemei upande wowote. Ukweli kwamba jumbe nyingi haziegemei upande wowote unaonyesha kuwa hakuna hali ya matumaini kupita kiasi au kukata tamaa sana katika jamii. Walakini, kiwango cha jumbe chanya ni cha juu zaidi kuliko kiwango cha jumbe hasi.
Matokeo ya pili ni kwamba miinuko hasi ya hisia inaonekana zaidi kuhusishwa na masuala ya kiufundi katika kiwango cha mtumiaji. Huu ni utofautishaji muhimu. Kwa sababu hisia za Discord haziwezi kutoa ishara kuu ya soko kila wakati; wakati mwingine inaweza kuonyesha moja kwa moja uzoefu wa mtumiaji ndani ya jukwaa.
Matokeo ya tatu ni kwamba data ya hisia inaweza kutoa mchango mdogo lakini unaopimika kwa utendaji wa utabiri. Modeli ya lugha nyingi ilipunguza thamani za MSE na MAE ikilinganishwa na modeli ya bei pekee. Hii inaonyesha kuwa ishara inayotokana na jumbe za jamii si isiyo na maana kabisa.
Matokeo ya nne na yenye tahadhari zaidi yako upande wa \(R^2\). \(R^2\) ilibaki hasi katika modeli zote mbili. Hii inaonyesha kuwa faida ya tokeni ya MANA haiwezi kuelezewa kwa uthabiti tu kwa bei, kiasi, thamani ya soko na hisia za Discord. Kwa maneno mengine, hata kama modeli itaboresha katika vipimo vya makosa ya muda mfupi, bado haiwezi kunasa kikamilifu mienendo ya soko kwa ujumla.
Kwa Nini Hili Ni Muhimu?
Utafiti huu ni muhimu kwa sababu unaonyesha jinsi data ya jamii inaweza kujumuishwa katika modeli za utabiri wa kifedha katika chumi za metaverse. Kwenye majukwaa kama Decentraland, Discord si sehemu ya mazungumzo pekee; pia ni ishara ya jamii inayoonyesha kuridhika kwa watumiaji, matatizo ya kiufundi, matarajio, na maslahi katika jukwaa.
Modeli za utabiri wa kifedha mara nyingi hutegemea data ya bei na kiasi. Hata hivyo, katika miradi ya crypto na metaverse, maslahi ya jamii, ushiriki wa utawala, na hisia za kijamii pia vinaweza kuwa muhimu. Utafiti huu unaonyesha kuwa kwa kuongeza ishara hizi za kijamii kwa modeli, maboresho katika vipimo vya makosa yanaweza kupatikana.
Lakini matokeo pia yanaonyesha kuwa tahadhari lazima ichukuliwe. Hisia za Discord zinaweza kuonyesha uzoefu wa ndani ya jukwaa; hata hivyo, haiwezi kueleza soko zima la crypto, habari kuu, hali ya ukwasi, au tabia ya wawekezaji yenyewe. Kwa hiyo, data ya hisia ya jamii inapaswa kuzingatiwa kama sehemu ya mfumo mpana wa uchambuzi wa lugha nyingi, si injini huru ya utabiri.
Mambo ya Kuzingatia
Utafiti huu si ushauri wa uwekezaji. Haina mapendekezo ya kununua/kuuza kwa MANA au rasilimali nyingine yoyote ya crypto.
Kipindi cha data kinashughulikia siku 366 pekee. Matokeo yanaweza kubadilika katika vipindi virefu zaidi na katika mifumo tofauti ya soko.
Data ya Discord inaweza isiwakilishe msingi mzima wa wawekezaji. Watumiaji hai wa Discord wanaweza kuonyesha tu kikundi maalum cha wawekezaji wa MANA au watumiaji wa Decentraland.
Modeli ya hisia ni modeli inayotegemea RoBERTa iliyofunzwa kwenye lugha ya jumla ya mitandao ya kijamii. Inaweza isinase kwa usahihi kejeli, misimu, malalamiko ya kiufundi, au muktadha wa ndani ya jamii ambao ni mahususi kwa nafasi ya metaverse na crypto.
Thamani hasi za \(R^2\) zinaonyesha kuwa nguvu ya kueleza ya modeli ni mdogo. Kwa hiyo, uboreshaji katika vipimo vya makosa haupaswi kutiwa chumvi.
Vigezo vya ziada kama soko kuu la crypto, athari ya Bitcoin, hali ya mtandao wa Ethereum, kiasi cha NFT, shughuli za ardhi ndani ya Decentraland, au ukwasi mkubwa wa ubadilishaji havikupatikana katika utafiti. Vigezo hivi vinaweza kuwa muhimu kwa modeli za kina zaidi katika siku zijazo.
Hitimisho
Utafiti huu wa kitaaluma unaonyesha kuwa ishara za hisia zinazotolewa kutoka kwa jamii ya Discord ya Decentraland zinaweza kutoa mchango mdogo lakini wa maana kwa modeli za utabiri wa tokeni ya MANA. Modeli ya lugha nyingi ya LSTM imepunguza thamani za MSE na MAE ikilinganishwa na modeli ya bei pekee.
Hata hivyo, utafiti pia unatoa onyo muhimu: Hisia za jamii zenyewe si modeli yenye nguvu ya kueleza soko. Thamani hasi za \(R^2\) zinaonyesha kuwa bado kuna ubadilikaji mkubwa ambao haujaelezwa katika faida ya MANA.
Kwa mtazamo wa Verianla, ujumbe mkuu wa utafiti huu ni: Data ya jamii ni muhimu katika chumi za metaverse na crypto; lakini data hii inakuwa na maana zaidi pale tu inapokadiriwa pamoja na bei, kiasi, thamani ya soko, shughuli za jukwaa, na hali pana za soko.
Ujumbe wa Chanzo na Mbinu
Maudhui haya yametayarishwa kwa kuchunguza PDF ya kitaaluma yenye kichwa Leveraging Large Language Models for Sentiment Analysis: Multi-Modal Analysis of Decentraland’s MANA Token. Maandishi sio tafsiri ya neno kwa neno. Lengo, muundo wa data, fomula za kimsingi, mbinu, matokeo, na vikwazo vya utafiti vimesimuliwa upya katika Kiswahili kilichorahisishwa, asilia, na cha kihariri kwa wasomaji wa Verianla.
Fomula zinatolewa katika umbizo la LaTeX linaloendana na MathJax, ikibaki mwaminifu kwa muundo wa kimsingi wa hisabati katika utafiti. Makala haya si ushauri wa uwekezaji, pendekezo la tokeni, au ishara ya moja kwa moja ya biashara.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *