

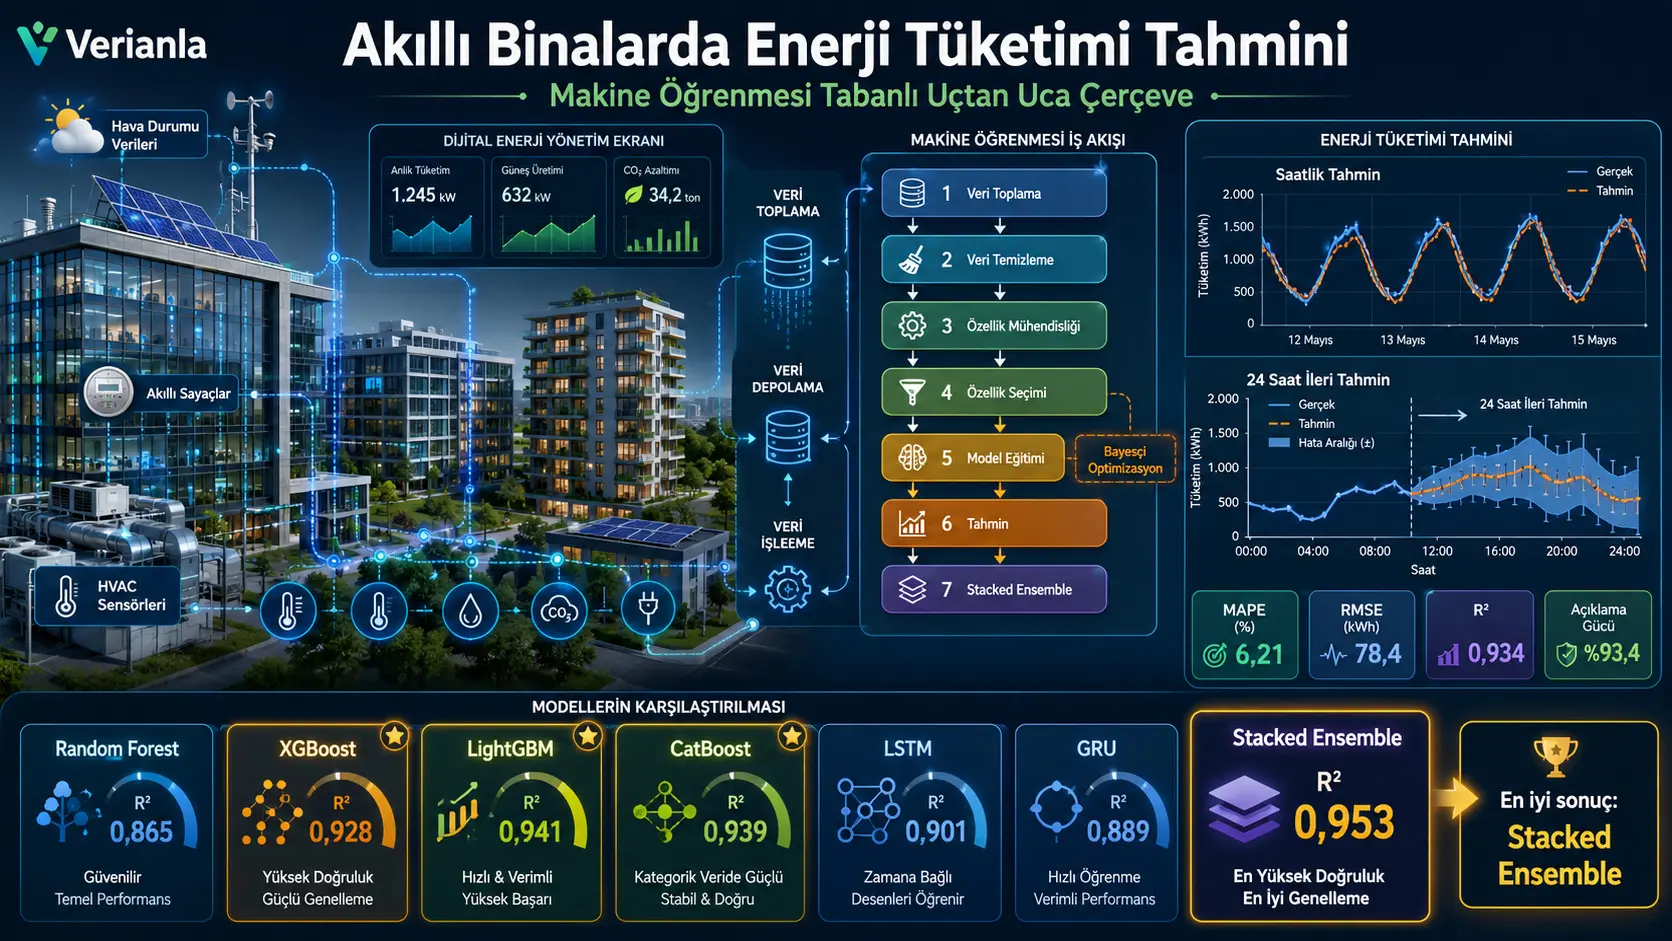
Utafiti huu unapendekeza mfumo jumuishi wa ujifunzaji wa mashine unaoanzia kwenye data ghafi za vihisi hadi utabiri wa mwisho, kwa lengo la kutabiri matumizi ya nishati ya kila saa katika majengo mahiri kwa muda mfupi na wa kati. Mfumo huu unajumuisha usafishaji wa data, uhandisi wa vipengele vinavyohusiana na muda na hali ya hewa, uteuzi mseto wa vipengele, mgawanyo wa kifuatano wa data za mafunzo–uthibitishaji–majaribio, ulinganisho wa modeli sita tofauti za ujifunzaji wa mashine na ujifunzaji wa kina, uboreshaji wa Bayes wa hyperparameter na kuunganisha modeli zilizofanikiwa zaidi kwa mbinu ya stacking.
Katika utafiti, modeli za Random Forest, XGBoost, LightGBM, CatBoost, Long Short-Term Memory (LSTM) na Gated Recurrent Unit (GRU) zimelinganishwa chini ya itifaki ileile ya majaribio. Zaidi ya hayo, utabiri wa modeli tatu zenye utendaji bora zaidi kwenye uthibitishaji — LightGBM, CatBoost na XGBoost — umeunganishwa kwa meta-learner inayotegemea ridge regression ili kuunda stacked ensemble.
Mfumo umetathminiwa kwenye vyanzo viwili vya data vinavyopatikana kwa umma: ASHRAE Great Energy Predictor III (GEPIII) na Building Data Genome Project 2 (BDG2). Katika uchambuzi wa GEPIII, majengo 380 yalitumika, huku katika BDG2 yakitumika majengo 250. Utendaji ulitathminiwa kwa vipimo vya MAE, RMSE, MAPE na R².
Katika utabiri wa GEPIII wa saa 24 mbele, LightGBM ilitoa matokeo bora zaidi miongoni mwa modeli binafsi; ilifikia 15,47 kWh MAE, 23,58 kWh RMSE, %7,96 MAPE na 0,929 R². Stacked ensemble inayounganisha LightGBM, CatBoost na XGBoost ilipunguza MAE hadi 13,92 kWh, RMSE hadi 21,34 kWh na MAPE hadi %7,11 katika jaribio hilo hilo, huku ikiongeza R² hadi 0,941.
Katika mkusanyiko wa data wa BDG2 pia mpangilio huo huo wa jumla uliendelea. Stacked ensemble ilikuwa mbinu yenye mafanikio zaidi katika utafiti ikiwa na 16,18 kWh MAE, 24,39 kWh RMSE, %8,60 MAPE na 0,921 R². Hivyo, iliripotiwa kuwa mbinu ya ensemble iliboresha MAE kwa takribani %10,0 kwenye GEPIII na takribani %9,5 kwenye BDG2 ikilinganishwa na modeli bora zaidi ya mtu mmoja, LightGBM.
Matokeo mengine muhimu ya utafiti ni kwamba katika utabiri wa nishati ya majengo si uchaguzi wa algoriti pekee wenye umuhimu mkubwa, bali pia uhandisi wa vipengele. Katika uchambuzi wa ablation wa GEPIII, MAPE ilikuwa %13,24 wakati vigezo vya kalenda pekee vilitumika; ilishuka hadi %10,02 baada ya kuongeza thamani zilizocheleweshwa za matumizi ya nishati ya zamani; na ilipungua hadi %7,96 kadiri takwimu za rolling, vigezo vya degree-hour vinavyotegemea joto na metadata za jengo zilivyoongezwa.
Kwa mtazamo wa Türkiye, utafiti hautoi modeli ya moja kwa moja ya nishati ya majengo ya ndani au kiwango cha kitaifa cha uokoaji wa nishati. Hata hivyo, unatoa mfano wa kimetodolojia wa jinsi usanifu wa utabiri wa aina hii unaweza kujengwa katika majengo yenye mita mahiri, mfumo wa otomatiki wa jengo, HVAC na data za hali ya hewa. Kwa matumizi nchini Türkiye, modeli zinapaswa kufundishwa upya kwa data za hali ya hewa ya eneo, ratiba ya matumizi, aina ya jengo, ushuru wa nishati, mfumo wa mitambo na tabia ya watumiaji, kisha kuthibitishwa kwa majaribio huru ya uwanjani.
Ni tatizo gani ambalo utafiti unajaribu kutatua?
Moja ya mahitaji muhimu ya usimamizi wa nishati katika majengo mahiri ni kutabiri kwa usahihi kadiri iwezekanavyo kiasi cha umeme, nishati ya kupasha joto au ya kupooza ambacho jengo litahitaji baada ya saa chache au siku moja. Utabiri kama huo unaweza kutumika katika usimamizi wa upande wa mahitaji, kupunguza mzigo wa kilele, kupanga ratiba za HVAC, kuunganisha nishati jadidifu na kugundua hitilafu.
Hata hivyo, matumizi ya nishati ya jengo si mchakato wa mstari na usiobadilika. Joto la nje, unyevunyevu, mionzi ya jua, siku ya wiki, saa ya siku, madhumuni ya matumizi ya jengo na hasa matumizi ya saa zilizopita vinaweza kuathiri kwa pamoja. Kuingia na kutoka kwa watumiaji katika jengo na ratiba za uendeshaji wa vifaa vya HVAC pia vinaweza kusababisha mabadiliko ya ghafla katika matumizi.
Kwa hiyo, badala ya kutathmini algoriti moja, mtafiti aliunda mtiririko wa kazi wa mwanzo hadi mwisho unaolinganisha modeli za ujifunzaji wa mashine zinazotegemea miti na mitandao ya neva ya recurrent chini ya hali zilezile za maandalizi na tathmini ya data.
Mtiririko uliopendekezwa wa ujifunzaji wa mashine unafanyaje kazi?
Mchoro wa dhana katika ukurasa wa 11 wa utafiti unaonyesha muundo wa hatua kwa hatua unaoanzia data ghafi hadi utabiri unaoweza kutumika katika usimamizi wa nishati. Mchakato una hatua kuu zifuatazo:
- Kukusanya data za mita mahiri, vihisi vya HVAC, data za hali ya hewa na metadata za jengo.
- Kushughulikia thamani zinazokosekana, outlier na mihuri ya muda.
- Kuunda vipengele vipya vinavyotegemea kalenda, matumizi ya zamani, takwimu zinazotembea na hali ya hewa.
- Uteuzi mseto wa vipengele unaounganisha mbinu za filter na wrapper.
- Kugawanya data kwa mpangilio wa muda katika seti za mafunzo, uthibitishaji na majaribio.
- Kufundisha modeli za Random Forest, XGBoost, LightGBM, CatBoost, LSTM na GRU.
- Uboreshaji wa Bayes wa hyperparameter.
- Kuunganisha modeli tatu bora zaidi kwa ridge regression kwa kutumia stacking.
- Kutathmini utendaji kwa MAE, RMSE, MAPE na R².
Muundo huu ni wa moduli. Kulingana na mbinu ya mtafiti, algoriti fulani au mbinu ya uteuzi wa vipengele inaweza kubadilishwa baadaye huku itifaki ya maandalizi na tathmini ya data ikiendelea kuhifadhiwa.
Data ghafi za majengo zinasafishwaje?
Mtiririko wote wa data huletwa kwenye azimio la pamoja la muda la kila saa ndani ya utafiti. Vipindi vya data vinavyokosekana vya saa tatu au chini hujazwa kwa linear interpolation. Kwa mapengo marefu zaidi, inapendekezwa kutumia thamani ya saa hiyo hiyo na aina hiyo hiyo ya siku katika wiki iliyopita.
Katika kutambua outlier, uchunguzi unaotoka zaidi ya IQR tatu kutoka kwenye median ya siku saba inayotembea na thamani zisizo na uhalisia wa kifizikia kama matumizi hasi ya nishati huwekwa alama. Uchunguzi huu pia hujazwa upya kwa mbinu iliyotumika kwa thamani zinazokosekana.
Katika modeli za mitandao ya neva, vipengele hupimwa hadi wastani wa sifuri na variance ya moja, huku scaling hiyo hiyo haitumiki kwa modeli zinazotegemea miti.
Kwa nini taarifa ya muda inasimbwa kwa sine na cosine?
Vigezo kama saa ya siku ni vya mzunguko. Saa 23 na saa 00 zinaonekana mbali kwa namba, lakini kwa kweli ni pointi za muda zilizo karibu. Katika utafiti, taarifa ya saa hubadilishwa kuwa jozi ya sine na cosine ili kuhifadhi mwendelezo huu:
\[ x_{\sin}=\sin\left(\frac{2\pi h}{24}\right), \qquad x_{\cos}=\cos\left(\frac{2\pi h}{24}\right) \]
Hapa h inawakilisha saa ya siku. Uwekaji msimbo wa mzunguko unaofanana hutumika pia kwa siku ya wiki.
Taarifa ya matumizi ya zamani inatumikaje?
Mfululizo wa muda wa matumizi ya nishati kwa kawaida huwa na autocorrelation yenye nguvu. Matumizi ya sasa ya jengo yanaweza kuhusiana na matumizi ya muda mfupi uliopita au saa hiyo hiyo siku moja na wiki moja iliyopita. Kwa hiyo, katika utafiti:
- thamani ya saa 1 iliyopita,
- thamani ya saa 24 zilizopita,
- thamani ya saa 168 zilizopita
hutumika kama vipengele.
Zaidi ya hayo, rolling mean na standard deviation huundwa kwa madirisha ya saa 3, 24 na 168 zilizopita. Rolling mean huleta mwenendo wa jumla kwenye modeli, huku rolling standard deviation ikileta utofauti wa matumizi katika kipindi cha hivi karibuni.
Katika grafu ya umuhimu wa vipengele ya LightGBM inayotegemea SHAP katika ukurasa wa 25 wa utafiti, kipengele muhimu zaidi pia kinaonekana kuwa lag_1h. Hiki kinafuatiwa na lag_24h, rolling mean ya saa 24 na joto la nje. Matokeo haya ya kuona yanaendana na mchango mkubwa wa vipengele vilivyocheleweshwa katika uchambuzi wa ablation.
Heating na cooling degree-hours zinahesabiwaje?
Ili kuwakilisha kwa njia ya moja kwa moja zaidi athari ya joto la nje kwenye matumizi ya nishati ya jengo, vigezo vya Heating Degree Hours na Cooling Degree Hours vinavyotegemea joto msingi la 18 °C vimeundwa:
\[ HDH_t=\max(0,T_b-T_t) \]
\[ CDH_t=\max(0,T_t-T_b) \]
Hapa Tb inaonyesha joto msingi, huku Tt ikionyesha joto la dry-bulb la hewa ya nje katika muda t. Ubadilishaji huu unalenga kuonyesha kwa uwazi zaidi kwa modeli uhusiano kati ya joto na mahitaji ya kupasha/kupooza.
Ni vipengele gani vilitathminiwa kwa jumla?
Dimbwi la vipengele katika utafiti limegawanywa katika makundi kadhaa makuu:
| Kundi la kipengele | Mifano |
|---|---|
| Kalenda | Saa sin/cos, siku ya wiki sin/cos, wikendi, sikukuu, mwezi |
| Matumizi yaliyocheleweshwa | lag_1h, lag_24h, lag_168h |
| Takwimu zinazotembea | Wastani na standard deviation za saa 3, 24 na 168 |
| Hali ya hewa | Joto, unyevunyevu, kasi ya upepo, mionzi ya jua, HDH, CDH |
| Metadata za jengo | Aina ya jengo, eneo la sakafu, mwaka wa ujenzi, kitambulisho cha site |
Vipengele 27 vya awali hupunguzwa hadi takribani vipengele 16–19 baada ya uteuzi mseto wa vipengele, kutegemea portfolio ya majengo.
Uteuzi wa vipengele unafanywaje?
Utafiti unatumia mbinu ya hatua mbili ya filter-wrapper. Katika hatua ya kwanza, mutual information na taarifa za correlation hutumika kutambua vipengele vinavyohusiana zaidi na lengo; inalengwa kuondoa kimoja kati ya vipengele vilivyo na uhusiano mkubwa sana.
Katika hatua ya pili, Recursive Feature Elimination (RFE) hutumika. Vipengele vyenye mchango mdogo zaidi huondolewa kwa zamu na mchakato huendelea hadi uboreshaji wa utendaji wa uthibitishaji ukome.
Katika maandishi ya chanzo, dhana ya mutual information na kizingiti cha correlation cha |r| > 0,9 vinatumika katika maelezo yale yale ya sehemu hii. Kwa hiyo, maelezo ya utekelezaji wa hatua ya uchujaji hayana maana moja iliyo wazi kabisa katika maandishi. Kwa kuwa msimbo wa utafiti pia haujatolewa katika toleo hili, urudiaji kamili wa hatua hiyo hauwezi kuthibitishwa kwa kutegemea maandishi ya makala pekee.
Random Forest inatumikaje?
Random Forest huchukua wastani wa utabiri wa miti B ya regression iliyofundishwa kwa sampuli za bootstrap:
\[ \hat y_{RF}=\frac{1}{B}\sum_{b=1}^{B}T_b(x) \]
Katika utafiti, modeli hii ilitumika hasa kama moja ya algoriti za kulinganisha kwa data za majengo zenye utofauti mkubwa na kelele.
XGBoost, LightGBM na CatBoost zinawakilisha nini?
Modeli zote tatu ni za familia ya gradient boosting. Weak learners huongezwa kwa mfuatano ili kupunguza kosa la modeli iliyotangulia. Katika chanzo, sasisho la jumla la boosting linaonyeshwa kama:
\[ F_m(x)=F_{m-1}(x)+\eta h_m(x) \]
Hapa η ni learning rate. XGBoost hutumia regularization na taarifa ya gradient ya daraja la pili, huku LightGBM ikiwa na mbinu ya histogram-based na leaf-wise ya kukuza miti. CatBoost hutofautiana hasa kwa kushughulikia moja kwa moja vigezo vya categorical na mbinu yake ya ordered boosting.
Katika matokeo ya majaribio, modeli hizi tatu za gradient boosting zilitoa usahihi wa juu zaidi kuliko LSTM na GRU kwenye data za majengo zilizo na muundo na zilizofanyiwa uhandisi wa vipengele.
Kwa nini LSTM na GRU zililinganishwa?
LSTM na GRU ni usanifu wa mitandao ya neva ya recurrent uliobuniwa kuiga utegemezi wa muda mrefu. LSTM hudhibiti kiasi cha taarifa ya zamani kinachohifadhiwa kupitia input, forget na output gates. GRU hufanya kazi inayofanana kwa gates chache na parameter chache.
Mikondo ya loss ya mafunzo na uthibitishaji katika ukurasa wa 28 wa utafiti inaonyesha kwamba GRU ilifikia early stopping karibu na epoch ya 27, huku LSTM ikiendelea hadi takribani epoch ya 33. Mtafiti anahusisha hili na muundo rahisi zaidi wa gate wa GRU na idadi yake ndogo ya parameter.
Katika muktadha wa utafiti huu, mitandao hiyo miwili ya recurrent haikuzidi modeli za gradient boosting ikiwa peke yake. Hata hivyo, mtafiti anaeleza kuwa katika mabadiliko yasiyo ya kawaida ya occupancy na utegemezi wa muda mrefu zaidi, modeli za recurrent zinaweza kuwa na tabia tofauti za kosa.
Stacked ensemble inaundwaje?
Utabiri wa modeli tatu za msingi zenye utendaji wa juu zaidi wa R² kwenye uthibitishaji hutumiwa kama matrix mpya ya data na meta-learner ya ridge regression hufundishwa:
\[ \hat y_{ens}=\sum_{k=1}^{3}\beta_k\hat y_k+\beta_0 \]
Ridge regularization inalenga kupunguza meta-modeli kutoa uzito mkubwa kupita kiasi kwa learner mmoja wa msingi:
\[ \boldsymbol{\beta} =\arg\min_{\boldsymbol{\beta}} \left\|y-X\boldsymbol{\beta}\right\|_2^2 +\lambda\left\|\boldsymbol{\beta}\right\|_2^2 \]
Ensemble ya mwisho inajumuisha LightGBM, CatBoost na XGBoost.
Hyperparameter ziliboreshwaje?
Bayesian optimization na mbinu ya Tree-structured Parzen Estimator zilitumika kwa kila modeli. Katika seti ya uthibitishaji ya GEPIII, majaribio 50 ya optimization yalifanywa kwa kila modeli.
Kwa mfano, kwa Random Forest idadi ya miti ilitafutwa katika 100–800, kwa XGBoost 100–1.000, na kwa LightGBM idadi ya majani katika 15–255. Kwa LSTM na GRU, hidden unit 32–256, layer 1–3, dropout 0–0,5, batch size 32–256 na learning rate 10−4–10−2 zilitathminiwa.
Ni seti gani za data zilizotumika?
| Kipengele | ASHRAE GEPIII | BDG2 |
|---|---|---|
| Majengo yaliyojumuishwa katika uchambuzi | 380 | 250 |
| Matumizi ya jengo | Ofisi, elimu, makazi | Ofisi, elimu, mikusanyiko ya umma, rejareja |
| Eneo la hali ya hewa | 8 | 6 |
| Azimio la muda | Kila saa | Kila saa |
| Wastani wa matumizi ya umeme kwa saa | 158,4 kWh | 172,6 kWh |
| Standard deviation | 142,7 kWh | 156,3 kWh |
| Usomaji uliokosekana kabla ya usafishaji | %4,8 | %6,2 |
| Uchunguzi wa outlier uliorekebishwa | %1,3 | %1,7 |
| Wastani wa eneo la jengo | 8.240 m² | 9.510 m² |
Chanzo cha awali cha GEPIII kina zaidi ya majengo 1.400, lakini katika utafiti takribani majengo 380 yenye angalau %90 ya data kamili ya mwaka mmoja na yaliyo katika aina maalum za matumizi yalihifadhiwa. Kwa BDG2, majengo 250 yenye vipimo vya umeme na rekodi za hali ya hewa za kutosha yalichaguliwa.
Data za mafunzo na majaribio ziligawanywaje?
Ili kuzuia uchunguzi wa baadaye kuvuja kwenda kwenye data za zamani, mfululizo wa muda uligawanywa kwa mpangilio wa muda kuwa %70 mafunzo, %15 uthibitishaji na %15 majaribio. Katika sehemu za mafunzo na uthibitishaji, blocked time-series cross-validation ya fold tano, ya kifuatano na isiyoingiliana pia ilitumika.
Katika mitandao ya neva, early stopping yenye patience = 10 epoch ilitumiwa kwa validation loss na matokeo ya kuanzisha kwa nasibu mara tano tofauti yalitathminiwa ili kupunguza stochastic variability.
Utendaji wa modeli ulitathminiwa kwa vipimo gani?
Mean Absolute Error (MAE):
\[ MAE=\frac{1}{n}\sum_{i=1}^{n}|y_i-\hat y_i| \]
Root Mean Squared Error (RMSE):
\[ RMSE=\sqrt{\frac{1}{n}\sum_{i=1}^{n}(y_i-\hat y_i)^2} \]
Mean Absolute Percentage Error (MAPE):
\[ MAPE=\frac{100\%}{n}\sum_{i=1}^{n} \left|\frac{y_i-\hat y_i}{y_i}\right| \]
Determination coefficient (R²):
\[ R^2=1-\frac{\sum_{i=1}^{n}(y_i-\hat y_i)^2} {\sum_{i=1}^{n}(y_i-\bar y)^2} \]
MAE huonyesha ukubwa wa wastani wa kosa kamili, RMSE huonyesha kiwango cha kosa kinachoadhibu zaidi makosa makubwa, MAPE huonyesha kosa la asilimia linalohusiana, na R² huonyesha sehemu ya variance inayozingatiwa ambayo inaweza kuelezwa na modeli.
Ni modeli gani iliyofanikiwa zaidi kwenye GEPIII?
| Modeli | MAE (kWh) | RMSE (kWh) | MAPE (%) | R² |
|---|---|---|---|---|
| Random Forest | 18,42 | 27,85 | 9,87 | 0,902 |
| XGBoost | 16,21 | 24,63 | 8,42 | 0,921 |
| LightGBM | 15,47 | 23,58 | 7,96 | 0,929 |
| CatBoost | 15,63 | 23,71 | 8,05 | 0,927 |
| LSTM | 16,85 | 25,12 | 8,71 | 0,916 |
| GRU | 17,10 | 25,47 | 8,89 | 0,913 |
| Stacked Ensemble | 13,92 | 21,34 | 7,11 | 0,941 |
Katika utabiri wa saa 24 mbele, ensemble ilitoa thamani bora zaidi katika vipimo vyote vinne. Katika grafu ya matumizi yaliyoonekana–yaliyotabiriwa katika ukurasa wa 24 wa utafiti, pointi nyingi pia zimejikusanya karibu na mstari wa marejeo wa 1:1.
Je, matokeo yalidumu kwenye seti nyingine ya data?
Katika uchambuzi wa BDG2 pia stacked ensemble ilifikia kosa la chini zaidi na R² ya juu zaidi:
| Modeli | MAE (kWh) | RMSE (kWh) | MAPE (%) | R² |
|---|---|---|---|---|
| Random Forest | 21,05 | 31,44 | 11,62 | 0,879 |
| XGBoost | 18,63 | 27,92 | 10,05 | 0,901 |
| LightGBM | 17,88 | 26,77 | 9,48 | 0,909 |
| CatBoost | 18,02 | 26,95 | 9,61 | 0,907 |
| LSTM | 18,94 | 27,63 | 9,92 | 0,898 |
| GRU | 19,31 | 28,10 | 10,14 | 0,894 |
| Stacked Ensemble | 16,18 | 24,39 | 8,60 | 0,921 |
Hata hivyo, jaribio hili halimaanishi uhamishaji wa moja kwa moja wa modeli kutoka jengo moja kwenda jingine bila mafunzo mapya. Kulingana na maelezo ya utafiti, mfumo uleule wa uhandisi wa vipengele na mbinu ya hyperparameter hufundishwa upya kwenye BDG2. Kwa hiyo, matokeo yanaunga mkono uhamishikaji wa kimetodolojia; hayathibitishi kwamba modeli moja iliyofundishwa kwenye GEPIII inaweza kufanya kazi moja kwa moja kwenye majengo ya BDG2.
Uhandisi wa vipengele ulibadilisha utendaji kwa kiasi gani?
| Seti ya vipengele | MAE (kWh) | RMSE (kWh) | MAPE (%) | R² |
|---|---|---|---|---|
| Kalenda pekee | 22,87 | 33,96 | 13,24 | 0,847 |
| + Matumizi yaliyocheleweshwa | 18,05 | 27,11 | 10,02 | 0,892 |
| + Takwimu zinazotembea | 16,31 | 24,68 | 8,64 | 0,914 |
| + HDH/CDH | 15,72 | 23,89 | 8,11 | 0,925 |
| + Metadata za jengo | 15,47 | 23,58 | 7,96 | 0,929 |
Mabadiliko makubwa zaidi ya hatua moja yalionekana wakati vigezo vya matumizi ya zamani viliongezwa. Ikilinganishwa na vipengele vya kalenda pekee, MAPE ilishuka kutoka %13,24 hadi %10,02. Hii inaonyesha kwamba historia ya karibu ya matumizi ya nishati ina taarifa muhimu kwa utabiri wa saa 24 mbele.
Je, modeli changamano zaidi ni ya haraka zaidi?
Hapana. Katika jedwali la gharama ya kukokotoa la utafiti, LightGBM inajitokeza kwa usahihi mkubwa pamoja na gharama ndogo ya kukokotoa.
| Modeli | Muda wa mafunzo (s) | Latency ya utabiri (ms/sampuli) | Ukubwa wa modeli (MB) |
|---|---|---|---|
| Random Forest | 148 | 0,42 | 86,4 |
| XGBoost | 96 | 0,18 | 12,1 |
| LightGBM | 41 | 0,09 | 7,8 |
| CatBoost | 112 | 0,21 | 15,6 |
| LSTM | 1.284 | 1,35 | 4,2 |
| GRU | 967 | 1,02 | 3,6 |
| Stacked Ensemble | 1.637 | 1,85 | 39,7 |
Muda wa mafunzo wa LightGBM ulioripotiwa kuwa sekunde 41 ni karibu mara 31 chini ya sekunde 1.284 za LSTM. Hata hivyo, thamani hizi ni halali tu kwa vifaa na mpangilio wa majaribio uliotumiwa katika utafiti; si sahihi kutarajia muda uleule kwa ukubwa tofauti wa data na vifaa tofauti.
Je, ubora wa ensemble ulijaribiwa kitakwimu?
Katika seti ya majaribio ya GEPIII, paired t-test zilitumika kati ya makosa kamili ya stacked ensemble na makosa kamili ya kila modeli ya msingi. Katika ulinganisho wote, p < 0,001 iliripotiwa.
| Ulinganisho | Tofauti ya wastani wa kosa (kWh) | t-statistic | p-value |
|---|---|---|---|
| Ensemble – Random Forest | 4,50 | 14,82 | <0,001 |
| Ensemble – XGBoost | 2,29 | 9,47 | <0,001 |
| Ensemble – LightGBM | 1,55 | 6,63 | <0,001 |
| Ensemble – CatBoost | 1,71 | 7,02 | <0,001 |
| Ensemble – LSTM | 2,93 | 10,15 | <0,001 |
| Ensemble – GRU | 3,18 | 10,88 | <0,001 |
Majaribio haya yanaonyesha kwamba katika sampuli ya GEPIII ya utafiti, uwezekano wa kupungua kwa kosa la ensemble kuelezewa na sampling variability ni mdogo. Hata hivyo, umuhimu wa kitakwimu haumaani kwamba ukubwa uleule wa faida ya utendaji umehakikishwa katika portfolios tofauti za majengo halisi.
Nini hutokea muda wa utabiri unapofika saa 48?
Grafu ya sensitivity katika ukurasa wa 32 wa utafiti inaonyesha mabadiliko ya MAPE kwa modeli tano zilizofanikiwa kutoka saa 1 hadi saa 48. Kadiri upeo wa utabiri unavyoongezeka, kosa huongezeka katika modeli zote.
Stacked ensemble ilidumisha MAPE ya chini zaidi katika upeo wote wa utabiri uliotathminiwa. Tofauti kati ya modeli bora zaidi ya mtu mmoja, LightGBM, na ensemble ilikuwa takribani pointi 0,7 za asilimia katika utabiri wa saa 1 na iliongezeka hadi pointi 1,1 za asilimia katika saa 48.
Ingawa miteremko ya ongezeko la kosa kwa LSTM na GRU ilikuwa myepesi zaidi kuliko kwa baadhi ya modeli za boosting, hazikuzidi usahihi wa modeli za gradient boosting ndani ya kipindi cha saa 1–48 kilichochunguzwa.
Utafiti unapendekeza nini kwa usimamizi halisi wa jengo?
Mtafiti anaeleza kwamba utabiri uliopatikana unaweza kutumika katika ushiriki wa upande wa mahitaji, kurekebisha mapema setpoint za HVAC, kusimamia mzigo wa kilele na kutumia tofauti kati ya utabiri na matumizi halisi kama kiashirio cha anomaly.
Hasa gharama ndogo ya mafunzo na inference ya LightGBM inachukuliwa kuwa faida kwa BEMS za eneo au matumizi ya edge yenye rasilimali chache za vifaa. Ensemble inapendekezwa kama chaguo zito zaidi kwa matumizi ambapo usahihi una umuhimu mkubwa zaidi wa kiuchumi.
Hata hivyo, utafiti haukuendesha control loop ya HVAC ya jengo halisi, haukupima uokoaji wa majaribio kwenye bili za nishati au matumizi halisi ya nishati, na haukuweka zabuni kwenye soko halisi la demand response. Haya ni maeneo ya matumizi yanayowezekana yaliyotolewa na mtafiti kutokana na matokeo.
Utafiti unasema nini na hausomi nini?
Utafiti unasema: Katika seti mbili za data za majengo zinazopatikana kwa umma, chini ya mfumo uleule wa maandalizi na tathmini ya data, modeli za gradient boosting zilitoa usahihi bora wa utabiri kuliko modeli binafsi za LSTM na GRU. Kuunganisha modeli tatu bora zaidi za gradient boosting kwa stacking kulitoa ongezeko la ziada la usahihi katika seti zote mbili za data. Hasa vipengele vilivyotengenezwa kutokana na matumizi ya zamani, takwimu zinazotembea na hali ya hewa vilikuwa na jukumu muhimu katika utendaji wa utabiri.
Utafiti hausomi: Hauthibitishi kwamba LightGBM daima ni bora kuliko LSTM katika kila aina ya jengo au hali ya hewa. Utafiti si jaribio la uwanjani kwenye mfumo wa otomatiki wa jengo wa wakati halisi. Hauonyeshi kwamba kupungua kwa kosa la utabiri kunasababisha moja kwa moja asilimia fulani ya uokoaji wa nishati. Vivyo hivyo, uchambuzi wa BDG2 hauthibitishi kwamba modeli iliyofundishwa kwenye GEPIII inaweza kuhamishwa kwenda majengo mengine bila kufundishwa upya.
Mbinu na Matokeo ya Utafiti
Muhtasari wa muundo wa majaribio
- Tatizo kuu: Utabiri wa matumizi ya nishati ya kila saa katika jengo mahiri.
- Upeo mkuu wa utabiri: Saa 24 mbele.
- Sensitivity ya ziada: Utabiri wa saa 1–48 mbele.
- Seti za data: ASHRAE GEPIII na Building Data Genome Project 2.
- Sampuli ya GEPIII: Majengo 380.
- Sampuli ya BDG2: Majengo 250.
- Azimio kuu la muda: Kila saa.
- Modeli: Random Forest, XGBoost, LightGBM, CatBoost, LSTM na GRU.
- Ensemble: LightGBM + CatBoost + XGBoost; meta-learner ya ridge regression.
- Mgawanyo wa data: %70 mafunzo, %15 uthibitishaji, %15 majaribio; kwa mpangilio wa muda.
- Cross-validation: Blocked time-series cross-validation ya fold tano.
- Uboreshaji wa hyperparameter: Bayesian optimization; majaribio 50 ya uthibitishaji kwa kila modeli.
- Tathmini: MAE, RMSE, MAPE na R².
Matokeo makuu kwenye GEPIII
Katika utabiri wa saa 24 mbele, modeli bora zaidi ya mtu mmoja ni LightGBM: MAE 15,47 kWh, RMSE 23,58 kWh, MAPE %7,96 na R² 0,929. Stacked ensemble iliboresha thamani hizi kwa mpangilio huo hadi 13,92 kWh, 21,34 kWh, %7,11 na 0,941.
Ikilinganishwa na LightGBM, kupungua kwa MAE kwa ensemble ni takribani:
\[ \frac{15.47-13.92}{15.47}\times100 \approx 10.0\% \]
.
Matokeo makuu kwenye BDG2
Modeli bora zaidi ya mtu mmoja tena ilikuwa LightGBM, ikiwa na 17,88 kWh MAE, 26,77 kWh RMSE, %9,48 MAPE na 0,909 R². Stacked ensemble ilifikia 16,18 kWh MAE, 24,39 kWh RMSE, %8,60 MAPE na 0,921 R².
Kupungua kwa MAE kwa ensemble ikilinganishwa na LightGBM ni takribani:
\[ \frac{17.88-16.18}{17.88}\times100 \approx 9.5\% \]
.
Matokeo makuu ya uhandisi wa vipengele
Katika jaribio la ablation la LightGBM, R² ilikuwa 0,847 na MAPE %13,24 kwa vipengele vya kalenda pekee; kwa kutumia vipengele vyote R² ilipanda hadi 0,929 na MAPE ikashuka hadi %7,96. Faida kubwa zaidi ya hatua moja ilipatikana kwa kuongeza vipengele vya lagged consumption.
Uwiano wa kasi na usahihi
Miongoni mwa modeli binafsi, LightGBM inatoa moja ya mizani bora zaidi ya usahihi na gharama ya kukokotoa katika utafiti kutokana na usahihi wake mkubwa pamoja na muda wa mafunzo ulioripotiwa wa sekunde 41 na latency ya inference ya 0,09 ms/sampuli.
Stacked ensemble inatoa usahihi wa juu zaidi lakini ina gharama kubwa zaidi ya kukokotoa, ikiwa na muda wa jumla wa mafunzo wa sekunde 1.637 na latency ya 1,85 ms/sampuli. Kwa hiyo, matokeo ya utafiti hayapaswi kufasiriwa kama “ensemble inapaswa kutumiwa kila wakati”; kuna uchaguzi kati ya mahitaji ya utendaji na rasilimali za kukokotoa.
Vikwazo vya kisayansi
- Matokeo yanategemea seti mbili za data za umma; uthibitishaji wa uwanjani kwenye mfumo hai wa otomatiki wa jengo haukufanywa.
- Ulinganisho wa BDG2 ni kufundisha upya mfumo uleule wa kimetodolojia kwenye data tofauti; si jaribio la cross-building transfer bila mafunzo mapya.
- Muda wa kukokotoa ulioripotiwa ni halali tu kwa vifaa na mpangilio wa majaribio uliotumiwa.
- Utafiti unatoa point forecast; uncertainty ya utabiri au probability interval zilizocalibrate hazijatathminiwa.
- Modeli za Transformer au attention-based hazikulinganishwa chini ya mpangilio uleule wa majaribio.
- Ushuru wa nishati wa wakati halisi, utambuzi wa kina wa occupancy na plug-load disaggregation hazikujumuishwa katika majaribio makuu.
- Kwa kuwa kushirikishwa wazi kwa source code na trained model artifacts hakujaonyeshwa katika toleo hili, independent reproducibility kamili haiwezi kuthibitishwa.
- Terminolojia ya mutual information na correlation threshold katika maelezo ya uchujaji wa vipengele haina maana moja iliyo wazi kabisa.
- Kuna kutofautiana kwa kiuhariri katika baadhi ya namba za michoro na majina ya modeli katika maandishi ya chanzo.
Mapendekezo ya utafiti wa baadaye
Utafiti unapendekeza tathmini ya probabilistic forecasts badala ya point forecast, usanifu wa Transformer na attention, federated learning, transfer learning, data za kina zaidi za occupancy na plug-load, pamoja na bei zinazobadilika za umeme.
Hasa federated learning inaelezwa kama mwelekeo wa utafiti unaoweza kuruhusu majengo au taasisi tofauti kufundisha modeli ya pamoja bila kukusanya data ghafi za matumizi ya nishati katika kituo kimoja. Transfer learning nayo inaonyeshwa kama mbinu inayowezekana ya kupunguza mahitaji ya data ya mwanzo katika majengo mapya au yenye data chache.
Dokezo la Chanzo na Mbinu
Jina asili la utafiti: A Machine Learning-Based Framework for Predicting Energy Consumption in Smart Buildings
Mwandishi: Sun Tao
Dokezo kuhusu utambulisho wa mwandishi: Ukurasa wa kwanza unaoonekana wa maandishi yaliyopakiwa hauna taarifa ya mwandishi au taasisi. Taarifa za Sun Tao na Zhejiang University zimethibitishwa kupitia rekodi rasmi ya bibliografia ya SSRN Abstract 7199510 iliyoashiriwa na utafiti.
Mchango sawa/mwandishi wa kwanza sawa: Kwa kuwa rekodi ina mwandishi mmoja, hakuna taarifa ya uandishi wa kwanza sawa.
Mwandishi wa mawasiliano: Katika rekodi ya SSRN, Sun Tao ameonyeshwa kama contact author.
Taasisi: Zhejiang University.
DOI: 10.2139/ssrn.7199510
Jukwaa la uchapishaji: SSRN, Abstract 7199510.
Jarida: Uchapishaji katika jarida lililopitiwa na wenzao haujathibitishwa.
Mwaka wa uchapishaji: 2026.
Aina ya chanzo: Preprint ya utafiti yenye ulinganisho wa majaribio wa modeli za ujifunzaji wa mashine kwa utabiri wa matumizi ya nishati ya majengo.
Hali ya peer review: Toleo la sasa la utafiti ni preprint ambayo haijapitiwa na wenzao. Kila ukurasa wa chanzo una kauli “Preprint not peer reviewed”.
Kiungo rasmi: SSRN Abstract 7199510.
Dokezo la utambulisho wa bibliografia: Rekodi nyingine yenye kichwa hicho hicho cha utafiti na muhtasari unaofanana kwa kiasi kikubwa, lakini chini ya mwandishi tofauti na namba tofauti ya SSRN, pia inaonekana katika vyanzo vya mtandaoni. Kwa kuwa utafiti uliopakiwa unaunganisha kwenye rekodi namba 7199510 katika kila ukurasa, maudhui haya yanatumia utambulisho wa bibliografia wa 7199510 pekee.
Mbinu, seti za data, fomula, thamani za utendaji, mpangilio wa umuhimu wa vipengele, gharama ya kukokotoa na matokeo ya utafiti katika maudhui haya ya Verianla yanategemea utafiti uliochunguzwa pekee. Vyanzo vya nje havikutumika kupanua matokeo ya kisayansi; vilitumika tu kuthibitisha utambulisho wa bibliografia, mwandishi, taasisi na taarifa ya DOI.
Matokeo ya utafiti ni utendaji wa utabiri uliopatikana kwenye benchmark za umma. Haiwezi kuhitimishwa kwamba uokoaji wa nishati, mafanikio ya udhibiti wa HVAC, kupungua kwa gharama au mapato ya demand response yamethibitishwa katika jengo halisi chini ya hali za uwanjani. Aidha, matumizi katika majengo na hali za hewa tofauti yanahitaji kufundisha upya mfumo uleule wa maandalizi ya data na modeling kwa data za eneo na uthibitishaji huru.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *