

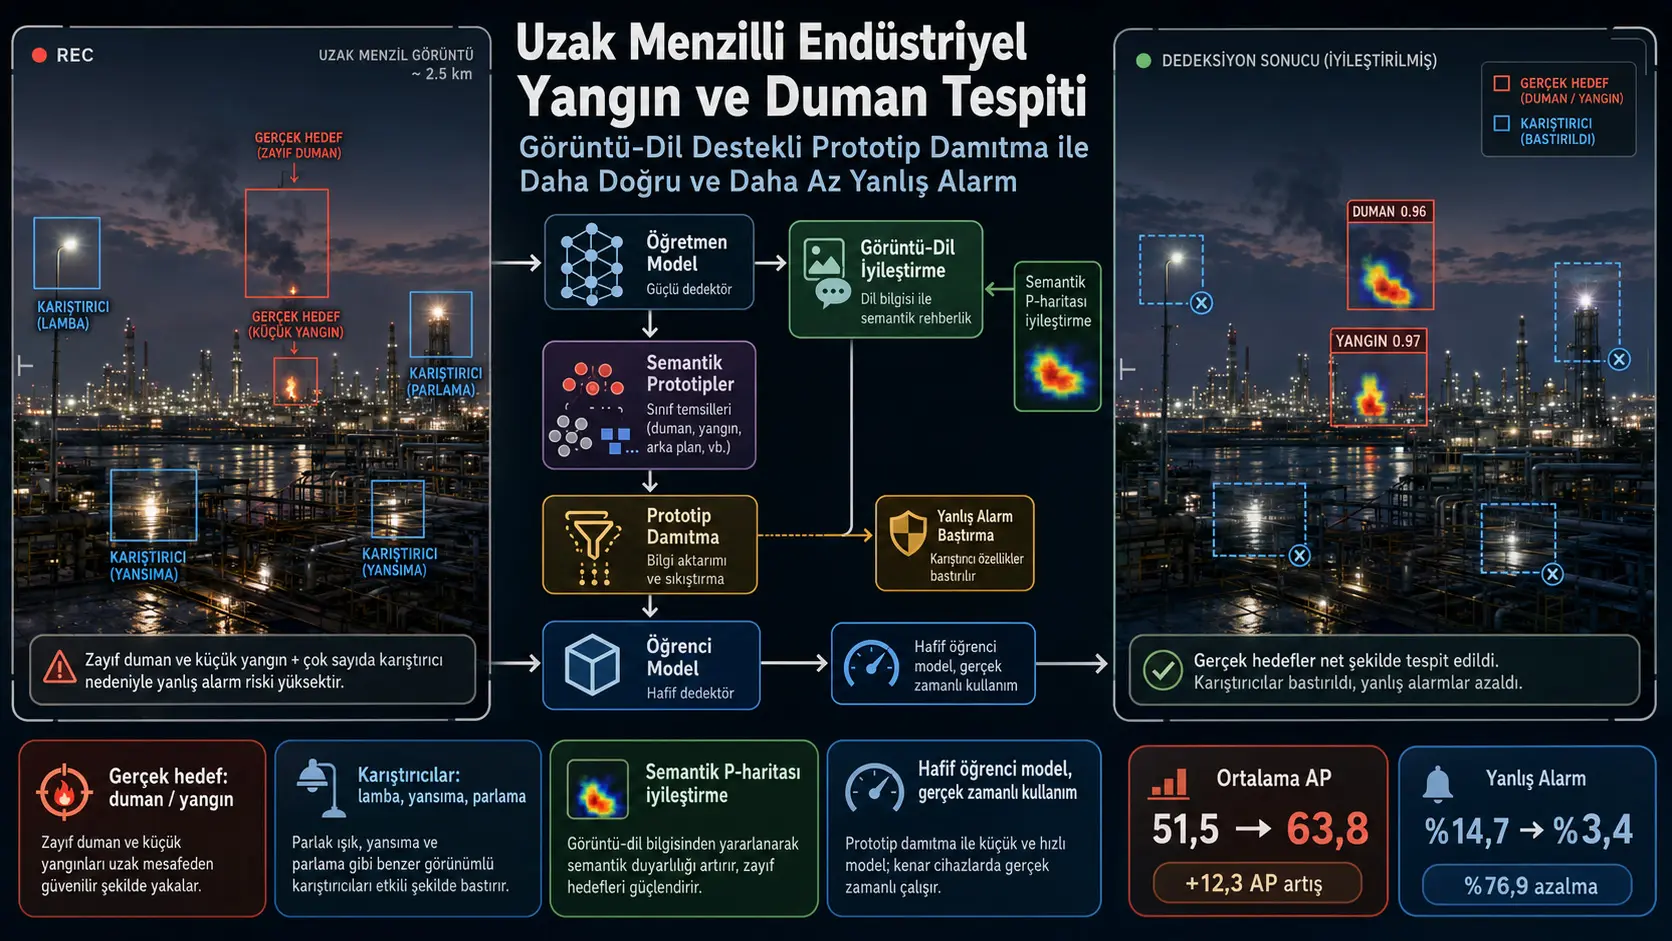
Bu çalışma, rafineri, petrokimya tesisi, tank sahası ve enerji santrali gibi geniş endüstriyel alanlarda uzaktaki küçük yangınları ve düşük kontrastlı duman bulutlarını gerçek zamanlı olarak algılamayı amaçlayan bir bilgi damıtma yöntemi geliştirmektedir. Uzak mesafeli güvenlik kameralarında tehlikeli bölgeler çoğu zaman yalnız birkaç piksel kaplamakta; gece lambaları, araç farları, metal yüzey yansımaları, ıslak zemin parlamaları ve aydınlık ağaç örtüleri yangın veya dumanla karıştırılabilmektedir. Bu nedenle hafif nesne algılayıcıları hem zayıf hedefleri kaçırabilmekte hem de sık yanlış alarm üretebilmektedir.
Araştırmacılar bu sorunu çözmek için yüksek kapasiteli bir öğretmen modelin bilgisini doğrudan ve yoğun biçimde kopyalamak yerine, güvenilir hedef bölgelerini ve yanıltıcı endüstriyel örüntüleri ayrı prototipler hâlinde temsil eden bir damıtma çerçevesi önermektedir. Öğretmen modelin yangın, hafif duman ve yoğun duman tahminleri hedef olasılık haritalarını; sokak lambası, güçlü yansıma ve parlak ağaç örtüsü tahminleri ise karıştırıcı olasılık haritalarını oluşturmaktadır. Dondurulmuş bir CLIP görüntü-dil modeli ve öğrenilebilir sürekli istem belirteçleri, bu haritaları semantik açıdan yeniden değerlendirmekte; gerçek tehlike kavramlarıyla uyumlu bölgeleri güçlendirirken aydınlatma kaynaklı yanıltıcı bölgeleri bastırmaktadır.
İyileştirilmiş olasılık haritaları, öğretmen modelden hedef ve karıştırıcı prototiplerin çıkarılmasında ve öğrenci model özelliklerinden eğitici uzamsal belirteçlerin seçilmesinde kullanılmaktadır. Maske Yönlendirmeli Çok Ölçekli Karşıt Hizalama adlı kayıp fonksiyonu, hafif öğrenci modelin gerçek yangın ve duman örüntülerini öğrenmesini ve görsel olarak benzer yanıltıcı bölgeleri ayırt etmesini hedeflemektedir. CLIP, öğretmen model, istem belirteçleri ve prototip bankası yalnız eğitim sırasında kullanılmakta; saha kullanımında yalnız 8,4 milyon parametreli öğrenci algılayıcı çalıştırılmaktadır.
11.023 görüntüden oluşan hibrit Fire&Smoke veri kümesindeki sonuçlara göre yöntem, YOLO26-small modelinin ortalama AP değerini 51,5’ten 63,8’e yükseltmiş ve bildirilen yanlış alarm oranını %14,7’den %3,4’e düşürmüştür. Gece görüntülerinden oluşan 625 karelik alt kümede ortalama AP 47,8’den 59,6’ya yükselmiş, yanlış alarm oranı ise %22,6’dan %4,6’ya gerilemiştir. Buna rağmen veri kümesinin yaklaşık yarısı özel endüstriyel görüntülerden oluşmakta, yanlış alarm oranının kesin hesaplama yöntemi açıklanmamakta ve gerçek bir gömülü uç cihaz üzerinde saha benchmarkı sunulmamaktadır.
Türkiye açısından anlamı
Yöntem; Türkiye’deki rafineriler, petrokimya ve kimya tesisleri, doğal gaz depolama alanları, limanlar, termik santraller, güneş ve rüzgâr enerji sahaları, maden işletmeleri, orman-endüstri sınırları ve geniş üretim kampüslerinde erken uyarı sistemlerine uyarlanabilir. Özellikle gece vardiyalarında projektörler, ikaz lambaları, araç farları, parlak metal ekipmanlar ve yağmur sonrası oluşan yansımalar, klasik kamera tabanlı sistemlerde yangın benzeri görüntüler oluşturabilir. Çalışmanın hedef ve karıştırıcı prototipleri ayrı modelleme yaklaşımı, bu tür çevresel koşullar için doğrudan ilgili bir mühendislik hipotezi sunmaktadır.
Türkiye’de uygulamaya geçilmeden önce farklı tesis türleri, kamera yükseklikleri, lensler, hava koşulları, mevsimler ve coğrafi bölgelerden toplanmış yerel görüntülerle yeniden eğitim ve doğrulama yapılmalıdır. Sis, buhar, baca gazı, kaynak kıvılcımları, meşale bacaları, sıcak proses parlamaları ve hareketli araç ışıkları ayrı karıştırıcı sınıflar olarak değerlendirilmelidir. Alarm performansı yalnız görüntü başına AP ile değil; olay tespit süresi, saat başına yanlış alarm, kaçırılan olay sayısı, kesintisiz video üzerindeki alarm kararlılığı ve operatör müdahale yüküyle ölçülmelidir.
Bu çalışma, yöntemin Türkiye’deki gerçek tesislerde yangını daha erken tespit edeceğini veya can ve mal kaybını azaltacağını doğrudan kanıtlamamaktadır. Sonuçlar görüntü tabanlı algılama başarısını desteklemekte; termal kamera, alev dedektörü, duman sensörü, gaz sensörü ve tesis alarm sistemiyle bütünleşik güvenlik performansını değerlendirmemektedir.
Araştırmanın temel problemi nedir?
Endüstriyel güvenlik kameraları çoğunlukla yüksek direk, çatı veya kulelere yerleştirilerek geniş alanları izlemektedir. Bu düzen, tek kamerayla büyük bir saha görülebilmesini sağlarken yangın ve duman hedeflerinin görüntüde çok küçük kalmasına neden olmaktadır. Uzak duman çoğu zaman gökyüzü, bulut, sis veya baca gazıyla düşük kontrast oluşturur. Küçük alevler ise projektör, far, uyarı lambası ve metal yansıması yanında kolayca kaybolabilir.
Hafif tek aşamalı nesne algılayıcıları, düşük gecikme ve sınırlı donanım tüketimi nedeniyle kenar cihazlarında tercih edilmektedir. Ancak küçük modellerin temsil kapasitesi daha düşüktür. Büyük bir öğretmen modelden hafif öğrenci modele bilgi aktarılması bu açığı azaltabilir; fakat öğretmen modelin yanlış tepkileri de doğrudan aktarılırsa öğrenci aynı hataları öğrenebilir.
Çalışmanın temel savı şudur: Endüstriyel yangın ve duman damıtmasında yalnız “yüksek güvenli bölge” ile “arka plan” ayrımı yeterli değildir. Aydınlatma kaynaklı zor negatiflerin, sıradan arka plandan ayrı biçimde modellenmesi gerekir. Bu nedenle sistem üç uzamsal örnek türünü ayırmaktadır:
- Pozitif tehlike bölgeleri: Hafif duman, yoğun duman ve yangın.
- Yapılandırılmış karıştırıcı bölgeler: Sokak lambaları, güçlü yansımalar ve parlak ağaç örtüleri.
- Ortam arka planı: Hedef veya özel karıştırıcı olarak tanımlanmayan diğer bölgeler.
Görüntü-dil rehberliği neden kullanılmıştır?
Çalışmanın 3. sayfasındaki Şekil 1, gece çekilmiş bir endüstriyel sahnede uzak duman bulutunu kırmızı pozitif bölge, parlak sokak lambasını ise mavi negatif bölge olarak göstermektedir. Duman bölgesi “ince beyaz duman”, lamba bölgesi ise “turuncu sokak lambası; yangın veya duman değil” benzeri metinsel kavramlarla ilişkilendirilmiştir. Şekil, iki bölge görüntü parlaklığı bakımından benzer görünse bile anlamsal olarak farklı oldukları düşüncesini açıklamaktadır.
Görüntü özellikleri aydınlatma, kamera açısı, kontrast ve gürültüye duyarlıdır. Metin temsilleri ise “yangın”, “duman”, “lamba” veya “yansıma” gibi üst düzey kavramları daha kararlı biçimde kodlayabilir. Ancak genel amaçlı CLIP modeli, petrokimya sahalarındaki özel görüntü koşullarına doğrudan uyumlu olmayabilir. Araştırmacılar bu alan farkını azaltmak için sabit cümleler yerine öğrenilebilir sürekli istem belirteçleri kullanmaktadır.
Genel öğretmen–öğrenci mimarisi
4. sayfadaki Şekil 2, yöntemin üst düzey işleyişini göstermektedir. Kamera kareleri hem güçlü öğretmen model hem de hafif öğrenci model için eğitim girdisidir. Öğretmen model, kendi özellik piramidi ve semantik modülü üzerinden yangın, duman ve yanıltıcı aydınlatma örüntülerini prototiplere dönüştürmektedir. Bu prototipler öğrenci modelin eğitimini yönlendirmektedir.
Dağıtım aşamasında öğretmen model, CLIP bileşeni ve prototip bankası kaldırılmaktadır. Kamera kareleri yalnız öğrencinin omurga, boyun ve algılama başlığından geçmektedir. Böylece damıtma sistemi eğitim maliyetini artırırken saha mimarisine yeni bir görüntü-dil modeli eklememektedir.
Şekil 3’teki ayrıntılı damıtma hattı
6. sayfadaki Şekil 3, bütün yöntemi aşağıdaki adımlara ayırmaktadır:
- Öğretmen algılayıcının tahmin kutuları sınıfa bağlı hedef ve karıştırıcı P-haritalarına dönüştürülür.
- Öğretmen özellik piramidindeki yerel özellikler 512 boyutlu CLIP semantik uzayına yansıtılır.
- Önceden öğrenilmiş metin prototipleri, hedef ve karıştırıcı kavramlara semantik yakınlığı hesaplar.
- Bu yakınlık değerleri algılama tabanlı P-haritalarını güçlendirir veya bastırır.
- İyileştirilmiş haritalar kullanılarak hedef ve karıştırıcı prototipler çıkarılır.
- Prototipler özellik piramidinin her seviyesi için ayrı kuyruklarda saklanır.
- Öğrenci özelliklerinden pozitif, karıştırıcı ve arka plan belirteçleri örneklenir.
- MMCA kaybı, öğrenci belirteçleriyle öğretmen prototiplerini ortak uzayda hizalamaya çalışır.
İlk P-haritaları nasıl oluşturulmaktadır?
Öğretmen modelin her özellik piramidi seviyesi için iki mekânsal harita oluşturulmaktadır:
\[ P_{\mathrm{target}}^{\ell}\in\mathbb{R}^{1\times H_\ell\times W_\ell} \]
\[ P_{\mathrm{confuse}}^{\ell}\in\mathbb{R}^{1\times H_\ell\times W_\ell} \]
\(\ell\), özellik piramidi seviyesini; \(H_\ell\) ve \(W_\ell\), o seviyedeki uzamsal boyutları belirtmektedir. Hafif duman, yoğun duman veya yangın etiketli öğretmen tahminleri hedef haritasına; lamba, yansıma veya parlak ağaç etiketli tahminler karıştırıcı haritaya eklenmektedir.
Tahmin kutusunun merkez hücresi tam ağırlık, komşu hücreler kısmi ağırlık almaktadır. Bir görüntüdeki bütün tahminler toplandıktan sonra harita kendi azami değerine bölünerek en büyük hücre 1 olacak şekilde normalleştirilmektedir.
Bu yöntem farklı görüntülerdeki mutlak güven puanlarının ölçek farkını azaltmaktadır. Ancak bütün tahminlerin düşük güvenli olduğu bir görüntüde bile en yüksek zayıf yanıtın 1’e ölçeklenebilmesi olasıdır. Çalışma bu riskin semantik düzeltme aşamasında ne ölçüde giderildiğini ayrı bir güven kalibrasyonu deneyiyle ölçmemiştir.
Sürekli istem belirteçleriyle ön hizalama
Hedef ve karıştırıcı kategorilerin her biri için dört öğrenilebilir bağlam belirteci kullanılmaktadır:
\[ Q_{\mathrm{tar}},Q_{\mathrm{conf}}\in\mathbb{R}^{N\times D_{\mathrm{word}}},\qquad N=4 \]
Kategori adı gömmesi \(e_m\), uygun bağlam belirteçleriyle birleştirilerek metin dizisi oluşturulmaktadır:
\[ X_m=[Q_{\mathrm{tar/conf}}\parallel e_m] \]
Bu dizi, ağırlıkları dondurulmuş CLIP metin kodlayıcısından geçirilmekte ve normalize edilmiş metin prototipine dönüştürülmektedir:
\[ t_m=\mathrm{Norm}(G(X_m)) \]
Çalışmada CLIP ViT-B/16 kullanıldığı ve ortak semantik uzayın 512 boyutlu olduğu belirtilmiştir. Öğretmenin farklı kanal sayılarına sahip özellik piramidi seviyeleri, iki katmanlı bir MLP ile aynı 512 boyutlu uzaya taşınmaktadır:
\[ h^\ell(f)=W_2^\ell\,\mathrm{GeLU}(W_1^\ell f+b_1^\ell)+b_2^\ell \]
Gerçek etiket kutularındaki öğretmen özellikleri RoIAlign ile havuzlanarak görsel prototiplere dönüştürülür. Görsel ve metinsel prototiplerin eşleşmesi çok kipli InfoNCE kaybıyla optimize edilmektedir:
\[ \mathcal{L}_{\mathrm{pre}}= -\frac{1}{K}\sum_{k=1}^{K} \log \frac{ \sum_{m=1}^{M}y_{k,m}\exp(\langle v_k,t_m\rangle/\tau_{\mathrm{clip}}) }{ \sum_{j=1}^{M}\exp(\langle v_k,t_j\rangle/\tau_{\mathrm{clip}}) } \]
\(v_k\), öğretmen özelliklerinden çıkarılan görsel prototipi; \(t_m\), öğrenilmiş metin prototipini; \(y_{k,m}\), doğru semantik eşleşmeyi; \(\tau_{\mathrm{clip}}\) ise sıcaklık katsayısını belirtmektedir.
8. sayfadaki Şekil 4, gerçek etiket kutularından öğretmen FPN özelliklerine, RoIAlign işlemine, iki katmanlı MLP’ye, görsel prototiplere ve öğrenilebilir metin istemlerine uzanan iki kollu ön hizalama sürecini göstermektedir. Öğretmen omurgası ve CLIP metin kodlayıcısı dondurulurken projeksiyon MLP’si ile sürekli istem belirteçleri güncellenmektedir.
Semantik P-haritası düzeltmesi
Ön hizalamadan sonra öğrenilmiş istem belirteçleri dondurulmaktadır. Öğretmen özelliklerinin her uzamsal konumu semantik uzaya yansıtılır:
\[ z_{x,y}^{\ell}=\mathrm{Norm}\left(h^\ell(f_{x,y}^{\ell})\right) \]
Yerel özelliğin hedef kavrama mı, yoksa karıştırıcı kavrama mı daha yakın olduğu aşağıdaki farkla hesaplanmaktadır:
\[ s^\ell(x,y)= \langle z_{x,y}^{\ell},t_{\mathrm{tar}}\rangle - \langle z_{x,y}^{\ell},t_{\mathrm{conf}}\rangle \]
Pozitif değer hedef semantiğine, negatif değer karıştırıcı semantiğine yakınlığı ifade eder. Semantik skor belirli bir \(\theta\) eşiğini aştığında kırpılmış bir düzeltme terimi oluşturulmaktadır:
\[ \Delta^\ell(x,y)= \gamma\,\mathrm{clip}(s^\ell(x,y),-1,1) \mathbb{I}(|s^\ell(x,y)|\geq\theta) \]
Hedef P-haritası şu şekilde güncellenmektedir:
\[ \widehat{P}_{\mathrm{target}}^\ell= \mathrm{Norm}_{\max} \left( \max(0,P_{\mathrm{target}}^\ell+\Delta^\ell) \right) \]
Semantik olarak yangın veya dumanla uyumlu bölgeler güçlenmekte; lamba veya yansıma kavramlarına yakın bölgeler zayıflamaktadır. Metin, karıştırıcı haritaya benzer bir düzeltmenin uygulanabileceğini belirtmekte, fakat sonraki bölümde kullanılan \(\widehat{P}_{\mathrm{confuse}}^\ell\) haritasının kesin güncelleme denklemini ayrı biçimde sunmamaktadır.
Prototip bankası nasıl oluşturulmaktadır?
İyileştirilmiş hedef haritası, hangi öğretmen özellik kanallarının tehlike bölgelerinde daha güçlü olduğunu hesaplamak için kullanılmaktadır. Kanal ağırlıkları softmax ile normalize edilir. Her özellik piramidi seviyesinde en yüksek yanıt veren yerel bölgeler seçilir ve kanal ağırlıklı havuzlama ile prototip vektörleri üretilir.
Prototipler iki grupta saklanmaktadır:
- Hedef prototipleri: Yangın ve dumanla ilişkili yüksek yanıtlı öğretmen özellikleri.
- Karıştırıcı prototipler: Lamba, yansıma, parlak yapı veya benzer zor negatiflerle ilişkili özellikler.
Her özellik seviyesi için sabit kapasiteli ayrı kuyruklar kullanılmaktadır. Kuyruk dolduğunda en eski prototip çıkarılmaktadır. Varsayılan ayarda seviye başına hedef ve karıştırıcı kuyruğu için 32 prototip tutulmaktadır.
Kuyrukların boş olması durumunda normalize edilmiş rastgele vektörlerin geçici prototip olarak döndürüldüğü belirtilmiştir. Bu koruma yazılımın çalışmasını sürdürür; ancak rastgele prototiplerin eğitime ne sıklıkta girdiği ve kayıp fonksiyonuna ne kadar gürültü eklediği raporlanmamıştır.
Öğrenci belirteçlerinin seçilmesi
Öğrenci özellik piramidindeki uzamsal noktalar üç dağılıma göre örneklenmektedir:
\[ p^\ell_{\tau}(y,x)= \begin{cases} \dfrac{\widehat{P}^\ell_{\mathrm{target}}(y,x)} {\sum_{y',x'}\widehat{P}^\ell_{\mathrm{target}}(y',x')+\epsilon}, & \tau=\mathrm{pos}\\[8pt] \dfrac{\widehat{P}^\ell_{\mathrm{confuse}}(y,x)} {\sum_{y',x'}\widehat{P}^\ell_{\mathrm{confuse}}(y',x')+\epsilon}, & \tau=\mathrm{neg}\\[8pt] \dfrac{1-\widehat{P}^\ell_{\mathrm{target}}(y,x)} {\sum_{y',x'}(1-\widehat{P}^\ell_{\mathrm{target}}(y',x'))+\epsilon}, & \tau=\mathrm{neg\_bg} \end{cases} \]
Pozitif dağılım gerçek tehlike bölgelerine, negatif dağılım özel karıştırıcılara, arka plan dağılımı ise düşük hedef olasılığı bulunan diğer bölgelere odaklanmaktadır. Varsayılan olarak seviye başına 32 pozitif ve 64 negatif belirteç seçilmekte; negatiflerin %60’ı karıştırıcı haritasından alınmaktadır.
Seçilen öğrenci özelliği seviye özelinde doğrusal bir başlıkla 512 boyutlu ortak uzaya aktarılmaktadır:
\[ z=\mathrm{Norm}(W_s^\ell h_{\ell,y,x}) \]
Maske Yönlendirmeli Çok Ölçekli Karşıt Hizalama
MMCA, öğrenci belirteçleri \(Z\) ile öğretmen prototipleri \(P\) arasındaki benzerlik matrisini hesaplamaktadır:
\[ S=\frac{1}{\tau}ZP^\top \]
Karıştırıcı prototipleri işaretleyen \(c\) vektörü kullanılarak benzerliklere sapma eklenmektedir:
\[ \widetilde{S}=S+\mathbf{1}c^\top\log(\eta_{\mathrm{conf}}) \]
Varsayılan \(\eta_{\mathrm{conf}}\) değeri 1,5’tir. Metin, bu işlemin karıştırıcı prototipleri yapılandırılmış zor negatif hâline getirdiğini ve öğrencinin onlardan uzaklaşmasını sağladığını belirtmektedir. Bununla birlikte pozitif, karıştırıcı ve arka plan belirteçleri için ayrı hedef etiket matrisi verilmemiştir. Her belirteç için azami benzerlikli prototipin hedef seçilmesi, özellikle negatif belirteçlerin hangi yöne optimize edildiğinin daha açık tanımlanmasını gerektirmektedir.
Her belirtecin kaybı, aynı özellik piramidi seviyesindeki en yakın prototip üzerinden hesaplanmaktadır:
\[ \ell_i= -\left(\widetilde{S}_{i,j_i^*}-m_i\right) + \log\sum_{j=1}^{N_p} \exp(\widetilde{S}_{ij}-m_i) \]
Uzamsal güven ağırlığı; pozitif örneklerde hedef P-haritasından, karıştırıcı örneklerde karıştırıcı P-haritasından, arka planda ise hedef olasılığının tamamlayıcısından alınmaktadır. Toplam kayıp:
\[ \mathcal{L}_{\mathrm{MMCA}}= \frac{\sum_i w_i\ell_i}{\sum_i w_i+\epsilon} \]
olarak tanımlanmıştır. Gradyan yalnız öğrenci özelliklerine ve öğrenci projeksiyon başlıklarına iletilmekte; prototip bankasındaki öğretmen vektörleri dondurulmuş olarak kullanılmaktadır.
Veri kümesi nasıl oluşturulmuştur?
Çalışmanın hibrit Industrial Fire&Smoke veri kümesi toplam 11.023 etiketli görüntü içermektedir:
| Veri kaynağı | Görüntü sayısı | Kaynak özelliği |
|---|---|---|
| Özel endüstriyel görüntüler | 5.340 | 12 petrokimya rafineri bölgesi ve kimyasal tank sahası |
| Açık DFS veri kümesi | 5.683 | Genel yangın ve duman görüntüleri |
| Toplam | 11.023 | Hibrit endüstriyel ve açık alan veri kümesi |
Özel görüntüler sabit 1080p uzun menzilli kameralarla toplanmış ve zamansal tekrarları azaltmak amacıyla her beş saniyede bir kare alınmıştır. Görünür duman veya alev bölgesi 5 × 5 pikselden büyük olduğunda sıkı sınırlayıcı kutuyla etiketlenmiştir.
Hedef sınıfları hafif duman, yoğun duman ve yangındır. Öğretmenin kullandığı karıştırıcı sınıflar sokak lambası, güçlü yansıma ve parlak ağaç örtüsüdür.
| Veri bölümü | Görüntü sayısı | Yaklaşık oran |
|---|---|---|
| Eğitim | 8.819 | %80 |
| Doğrulama | 1.102 | %10 |
| Test | 1.102 | %10 |
| SmokeFire–Night alt kümesi | 625 | Test kümesinden 19.00–05.00 kareleri |
11. sayfadaki Şekil 5, gündüz ve gece çekilmiş baca dumanı, uzak duman sütunu, açık alev, projektör, araç ışığı ve yansıma örneklerini göstermektedir. Görseller, veri kümesinin farklı hedef büyüklükleri ve aydınlatma koşulları içerdiğini göstermektedir. Bununla birlikte sınıf başına görüntü ve kutu sayıları, kamera başına dağılım, tesis bazlı bölme ve etiketleyiciler arası uyum raporlanmamıştır.
PASCAL VOC değerlendirmesi
Yöntemin yalnız endüstriyel veri kümesine özgü olup olmadığını değerlendirmek için yaklaşık 5.000 eğitim ve 5.000 doğrulama görüntüsünden oluşan PASCAL VOC kurulumu kullanılmıştır. Makale, birbirine yakın görsel kategorilere odaklandığını belirtmekte; ancak seçilen sınıfların tam listesi, örnekleme yöntemi ve “person/rider” eşlemesinin nasıl oluşturulduğu açıklanmamaktadır.
Çalışmanın Yöntemi ve Bulguları
Model ve eğitim düzeni
| Yöntem öğesi | Çalışmada kullanılan ayar |
|---|---|
| Varsayılan öğretmen | YOLO26-large |
| Varsayılan öğrenci | YOLO26-small |
| Alternatif öğrenciler | YOLOv10-small, YOLOv8-small ve RetinaNet-MNv2 |
| Görüntü boyutu | 640 × 640 piksel |
| Damıtma seviyeleri | FPN P3–P5 |
| Görüntü-dil kodlayıcısı | Dondurulmuş CLIP ViT-B/16 |
| Semantik uzay | 512 boyut |
| Sürekli istem belirteci | 4 |
| Prototip kapasitesi | Seviye ve kuyruk başına 32 |
| Pozitif öğrenci belirteci | Seviye başına 32 |
| Negatif öğrenci belirteci | Seviye başına 64 |
| Karıştırıcı örnek oranı | 0,6 |
| Karıştırıcı sapması | \(\eta_{\mathrm{conf}}=1,5\) |
| Optimizasyon | SGD; momentum 0,9; ağırlık azalması \(5\times10^{-4}\) |
| Başlangıç öğrenme oranı | \(1\times10^{-3}\), kosinüs azalma |
| Isınma süresi | 5 epoch |
| Eğitim süresi | 200 epoch |
| Batch büyüklüğü | 8 |
| Artırmalar | Yatay çevirme, HSV değişimi, Mosaic ve MixUp |
| Eğitim donanımı | İki RTX A6000 GPU ve otomatik karma hassasiyet |
PASCAL VOC sonuçları
| Yöntem | mAP@0,5 | mAP@[0,5:0,95] | Parametre | Gecikme |
|---|---|---|---|---|
| YOLO26-large öğretmen | 83,6 | 58,9 | 31,8 milyon | 6,4 ms |
| YOLO26-small öğrenci | 75,1 | 49,0 | 8,4 milyon | 2,3 ms |
| FGD | 78,0 | 51,6 | 8,4 milyon | 2,4 ms |
| PKD | 78,4 | 52,0 | 8,4 milyon | 2,4 ms |
| GID | 78,2 | 51,9 | 8,4 milyon | 2,5 ms |
| CrossKD | 78,7 | 52,4 | 8,4 milyon | 2,5 ms |
| UET | 79,1 | 52,8 | 8,4 milyon | 2,5 ms |
| Önerilen yöntem | 80,4 | 54,2 | 8,4 milyon | 2,5 ms |
Önerilen yöntem, ham öğrenciye göre mAP@0,5 değerini 5,3 puan ve daha katı mAP@[0,5:0,95] değerini 5,2 puan artırmıştır. Bu sonuç, yöntemin yalnız yangın ve duman kategorilerinde değil, genel nesne algılama görevinde de yararlı olabileceğini desteklemektedir. Ancak VOC alt kümesinin tam tanımı verilmediğinden deneyin aynen tekrarlanması zordur.
Industrial Fire&Smoke ana sonuçları
| Yöntem | Hafif duman AP | Yoğun duman AP | Yangın AP | Ortalama AP | Yanlış alarm | Parametre | Gecikme |
|---|---|---|---|---|---|---|---|
| YOLO26-large öğretmen | 66,8 | 68,5 | 65,7 | 67,0 | %2,9 | 31,8 milyon | 6,4 ms |
| YOLO26-small öğrenci | 51,2 | 53,8 | 49,6 | 51,5 | %14,7 | 8,4 milyon | 2,3 ms |
| FGD | 56,7 | 58,4 | 55,2 | 56,8 | %8,8 | 8,4 milyon | 2,4 ms |
| PKD | 57,4 | 59,1 | 55,9 | 57,5 | %8,0 | 8,4 milyon | 2,4 ms |
| GID | 57,8 | 59,5 | 56,3 | 57,9 | %7,7 | 8,4 milyon | 2,5 ms |
| CrossKD | 58,1 | 60,2 | 56,7 | 58,3 | %7,4 | 8,4 milyon | 2,5 ms |
| UET | 58,7 | 60,9 | 57,4 | 59,0 | %6,8 | 8,4 milyon | 2,5 ms |
| TCSN-YOLO | 62,4 | 63,6 | 57,5 | 61,2 | %8,6 | 8,9 milyon | 3,1 ms |
| Önerilen yöntem | 63,8 | 65,1 | 62,4 | 63,8 | %3,4 | 8,4 milyon | 2,5 ms |
Önerilen yöntem, ham YOLO26-small öğrenciye göre ortalama AP’yi 12,3 puan artırmış ve yanlış alarm oranını 11,3 yüzde puanı azaltmıştır. Öğretmenin 67,0 ortalama AP değerine yaklaşırken parametre sayısını 31,8 milyondan 8,4 milyona indirmektedir.
SSmokeDet satırında yangın AP’si çizgiyle gösterilmiş olmasına rağmen 61,2 ortalama AP verilmiştir. Sunulan hafif ve yoğun duman değerlerinden bu ortalama yeniden hesaplanamamaktadır. Bu nedenle yöntemler arası sıralamada ilgili satır temkinli okunmalıdır.
Farklı algılayıcı ailelerinde genelleme
| Öğrenci modeli | Ham ortalama AP | Damıtılmış ortalama AP | Ham yanlış alarm | Damıtılmış yanlış alarm |
|---|---|---|---|---|
| YOLOv10-small | 48,9 | 61,5 | %16,4 | %3,8 |
| YOLOv8-small | 47,6 | 60,7 | %17,2 | %4,2 |
| YOLO26-small | 51,5 | 63,8 | %14,7 | %3,4 |
| RetinaNet-MNv2 | 46,1 | 58,4 | %18,0 | %5,6 |
Dört öğrenci mimarisinin tamamında ortalama AP yaklaşık 12–13 puan artmış, yanlış alarm oranı belirgin biçimde azalmıştır. Bu sonuç yöntemin yalnız belirli bir YOLO sürümüne bağlı olmadığını desteklemektedir. Bununla birlikte her mimarinin sonuçları tek veri kümesi ve açıklanmayan tek gecikme donanımı üzerinde elde edilmiştir.
Gece sahnelerindeki sonuçlar
| Yöntem | Hafif duman AP | Yangın AP | Yoğun duman AP | Ortalama AP | Yanlış alarm | Gecikme |
|---|---|---|---|---|---|---|
| YOLO26-large öğretmen | 62,4 | 64,7 | 61,9 | 63,0 | %4,1 | 6,4 ms |
| YOLO26-small öğrenci | 47,3 | 49,2 | 47,0 | 47,8 | %22,6 | 2,3 ms |
| UET | 55,0 | 56,2 | 54,5 | 55,2 | %9,4 | 2,5 ms |
| TCSN-YOLO | 57,2 | 55,0 | 56,6 | 56,9 | %8,2 | 3,1 ms |
| Önerilen yöntem | 59,4 | 60,8 | 58,7 | 59,6 | %4,6 | 2,5 ms |
Gece alt kümesinde ortalama AP 11,8 puan yükselmiş ve yanlış alarm oranı 18 yüzde puanı düşmüştür. 15. sayfadaki Şekil 7, temel modelin parlak lamba bölgesinde yanlış etkinleştirme oluşturduğunu; önerilen yöntemin aynı bölgeyi bastırarak gerçek hedefe odaklandığını göstermektedir.
Etkinleştirme haritaları
14. sayfadaki Şekil 6; hafif duman, yangın ve yoğun duman için test görüntüsünü FGD, PKD, GID, CrossKD ve önerilen yöntemin ısı haritalarıyla karşılaştırmaktadır. Önerilen yöntemde sıcak etkinleştirme bölgeleri hedef üzerinde daha dar ve yoğun görünürken çevredeki parlak yapılar daha düşük yanıt almaktadır.
Bu görseller yöntemin çalışma mekanizmasıyla uyumludur; ancak seçilen örneklerin bütün test kümesini temsil edip etmediğini göstermez. Isı haritalarının nicel sonucu, sınırlı sayıdaki açıklamalı bölgede yapılan DSR analiziyle desteklenmiştir.
Semantik iyileştirmenin nicel analizi
SmokeFire–Night alt kümesindeki 80 açıklamalı ilgi bölgesinde, iyileştirme öncesi ve sonrası ortalama P-haritası etkinliği ölçülmüştür:
\[ V_{\mathrm{avg}}(R)= \frac{1}{N}\sum_{(x,y)\in R}P(x,y) \]
Dikkat Dağıtıcı Bastırma Oranı:
\[ \mathrm{DSR}(R)= \frac{V_{\mathrm{avg}}^{\mathrm{refined}}(R)} {V_{\mathrm{avg}}^{\mathrm{orig}}(R)} \]
| Bölge | İlk ortalama | İyileştirilmiş ortalama | DSR |
|---|---|---|---|
| Gerçek duman | 0,882 | 0,865 | 0,98 — korundu |
| Gerçek yangın | 0,915 | 0,908 | 0,99 — korundu |
| Sokak lambaları | 0,764 | 0,142 | 0,18 — bastırıldı |
| Yansımalar | 0,628 | 0,115 | 0,18 — bastırıldı |
16. sayfadaki Şekil 8, ön hizalama öncesinde hedef ve karıştırıcı prototiplerin ortak uzayda birbirine karıştığını, sonrasında ise iki kümenin ayrıştığını göstermektedir. Aynı şeklin P-haritası örneklerinde gerçek duman ve alev korunurken lamba ve su yansımalarının zayıflatıldığı görülmektedir.
Bu analiz mekanizmanın amaçlandığı gibi çalıştığını desteklemektedir. Ancak 80 bölgenin hangi görüntülerden ve hangi örnekleme yöntemiyle seçildiği, değerlendirmeyi yapan kişilerin körlenip körlenmediği ve belirsizlik aralıkları açıklanmamıştır.
Bileşen çıkarma sonuçları
| Model çeşidi | Semantik P-haritası | Ön hizalama | Karıştırıcı prototip | Ortalama AP |
|---|---|---|---|---|
| Damıtmasız öğrenci | Hayır | Hayır | Hayır | 51,5 |
| Semantiksiz prototip damıtma | Hayır | Hayır | Evet | 59,8 |
| Ön hizalamasız semantik P-haritası | Evet | Hayır | Evet | 61,6 |
| Karıştırıcı prototipsiz semantik yöntem | Evet | Evet | Hayır | 61,9 |
| Tam yöntem | Evet | Evet | Evet | 63,8 |
Yalnız prototip damıtma, öğrenciye 8,3 puan kazandırmıştır. Sabit metin semantiğiyle P-haritası iyileştirmesi sonucu 61,6’ya, sürekli istem ön hizalaması ve karıştırıcı prototiplerin birlikte kullanılması ise 63,8’e çıkarmıştır. Bu sonuç, performans artışının tek bir bileşenden değil, yapısal prototip aktarımı ile semantik ayrımın birleşiminden geldiğini göstermektedir.
MMCA oran ve sapma analizi
| Karıştırıcı örnek oranı | \(\eta_{\mathrm{conf}}\) | Ortalama AP |
|---|---|---|
| 0,3 | 1,5 | 62,4 |
| 0,6 | 1,5 | 63,8 |
| 0,9 | 1,5 | 63,0 |
| 0,6 | 1,0 | 62,7 |
| 0,6 | 2,5 | 62,2 |
Az sayıda karıştırıcı örnek kullanılması zor negatif öğrenimini zayıflatırken, oranı 0,9’a çıkarmak hedef prototiplerinin katkısını azaltmıştır. Benzer biçimde karıştırıcı sapmasının aşırı büyütülmesi performansı düşürmüştür. En iyi bildirilen denge 0,6 örnek oranı ve 1,5 sapma katsayısıdır.
Prototip, belirteç ve istem kapasitesi
| Değişken | Ayar | Ortalama AP |
|---|---|---|
| Seviye başına prototip | 16 | 62,3 |
| Seviye başına prototip | 32 — varsayılan | 63,8 |
| Seviye başına prototip | 64 | 64,0 |
| Pozitif belirteç | 16 | 63,0 |
| Pozitif belirteç | 32 — varsayılan | 63,8 |
| Pozitif belirteç | 64 | 63,9 |
| Sürekli istem belirteci | 2 | 63,1 |
| Sürekli istem belirteci | 4 — varsayılan | 63,8 |
| Sürekli istem belirteci | 8 | 63,7 |
64 prototip 64,0 ile en yüksek ortalama AP’yi üretmiştir; araştırmacılar 32 prototipi performans-kapasite dengesi nedeniyle varsayılan seçmiştir. Ancak 32 ve 64 prototip arasındaki bellek, eğitim süresi veya enerji farkı raporlanmamıştır.
Çalışmanın güçlü yönleri
- Endüstriyel yangın algılamada gerçek hedefleri ve aydınlatma kaynaklı zor negatifleri açıkça ayırması.
- Öğretmenin yanlış yüksek tepkilerini doğrudan öğrenciye aktarmak yerine önce semantik olarak süzmesi.
- Görüntü-dil modelini yalnız eğitim sırasında kullanarak saha modelini hafif tutması.
- Hedef ve karıştırıcı prototipleri özellik piramidi seviyelerine göre ayrı saklaması.
- PASCAL VOC, ana Fire&Smoke testi ve gece alt kümesi üzerinde farklı değerlendirmeler sunması.
- YOLOv8, YOLOv10, YOLO26 ve RetinaNet ailelerinde aynı performans yönünü göstermesi.
- Yanlış alarm oranını doğruluk metrikleriyle birlikte raporlaması.
- Bileşen çıkarma, prototip kapasitesi, örnek oranı ve istem uzunluğu analizleri yapması.
- Özel görüntülerin paylaşım sınırlılığını ve üretken yapay zekâ kullanımını açıkça beyan etmesi.
Temel sınırlılıklar
- Çalışma hakem değerlendirmesinden geçmemiştir.
- Özel endüstriyel görüntülerin paylaşılmaması tam yeniden üretimi engellemektedir.
- Tesis, kamera ve zaman dizisi temelinde veri ayrımı açıklanmamıştır.
- Sınıf başına görüntü ve kutu sayıları verilmemiştir.
- Etiketleyici sayısı, kalite denetimi ve gözlemciler arası uyum raporlanmamıştır.
- Fire&Smoke AP değerlerinin IoU eşiği açık değildir.
- Yanlış alarm oranının formülü ve değerlendirme birimi belirtilmemiştir.
- Sonuçlar tek çalıştırma değerleri olarak sunulmuş; standart sapma ve güven aralığı verilmemiştir.
- Gecikme testi için donanım, batch, hassasiyet, yazılım ortamı ve ısınma protokolü belirtilmemiştir.
- Jetson, FPGA, NPU veya endüstriyel edge bilgisayarda gerçek test yapılmamıştır.
- Video sürekliliği, zamansal alarm birleştirme ve olay düzeyi performans incelenmemiştir.
- Sis, su buharı, kaynak ışığı, baca emisyonu ve meşale bacası gibi ek endüstriyel karıştırıcılar ayrı sınıf olarak değerlendirilmemiştir.
- Öğretmenin altı sınıflı, öğrencinin üç güvenlik sınıflı çıkış yapısının kesin eğitim eşlemesi tam açıklanmamıştır.
- Karıştırıcı P-haritasının semantik güncelleme denklemi eksiktir.
- MMCA’nın negatif ve arka plan örneklerini hangi prototiplere çektiği veya hangilerinden ittiği matematiksel olarak yeterince açık değildir.
- Prototip kuyruğu boşken kullanılan rastgele vektörlerin etkisi ölçülmemiştir.
- P-haritalarının görüntü başına azami değere göre normalleştirilmesi mutlak öğretmen güvenini ortadan kaldırmaktadır.
- SSmokeDet için verilen ortalama AP tablodaki sınıf değerlerinden yeniden hesaplanamamaktadır.
- Makale şablon metinleri ve tamamlanmamış atıf işaretleri içermektedir.
Çalışmanın desteklediği sonuçlar
- Kontrollü deneylerde semantik yönlendirmeli prototip damıtma, ham hafif algılayıcıdan daha yüksek AP üretmiştir.
- Çalışmanın gece alt kümesinde lamba ve yansıma kaynaklı etkinleştirmeler belirgin biçimde azaltılmıştır.
- Hedef ve karıştırıcı prototiplerin ayrı modellenmesi, karıştırıcı prototipsiz varyanta göre daha yüksek ortalama AP sağlamıştır.
- Sürekli istem belirteçleri, sabit genel CLIP istemlerinden daha iyi sonuç vermiştir.
- Yöntem farklı YOLO ve RetinaNet öğrenci ailelerinde benzer performans yönü göstermiştir.
- Damıtma modülleri çıkarım sırasında kaldırılabildiği için öğrenci parametre sayısı 8,4 milyon olarak korunmuştur.
Çalışmanın kanıtlamadığı sonuçlar
- Sistemin gerçek bir yangını mevcut güvenlik sistemlerinden daha erken algıladığı gösterilmemiştir.
- Yöntemin bütün petrokimya tesislerine, iklimlere ve kamera türlerine genellenebilirliği kanıtlanmamıştır.
- Yanlış alarm azalmasının saat, vardiya veya kamera başına operasyonel karşılığı gösterilmemiştir.
- Modelin gerçek gömülü cihazda bildirilen milisaniye değerleriyle çalıştığı kanıtlanmamıştır.
- Termal, kızılötesi, gaz veya noktasal duman sensörleriyle bütünleşik güvenlik başarısı ölçülmemiştir.
- Özel veri kümesindeki sonuçların bağımsız bir araştırma grubu tarafından tekrarlandığı gösterilmemiştir.
- Modelin duman türü, yangın büyüklüğü veya tehlike seviyesi hakkında güvenilir fiziksel ölçüm yaptığı gösterilmemiştir.
- Tek görüntü değerlendirmesi, kesintisiz video üzerinde kararlı alarm davranışını kanıtlamamaktadır.
- Model çıktısı sertifikalı yangın alarmı veya güvenlik-kritik otomatik kapatma kararı olarak doğrulanmamıştır.
Kaynak ve Yöntem Notu
Çalışmanın tam özgün adı: Semantic-Guided Prototype Distillation with Vision-Language Refinement for Long-Range Industrial Fire and Smoke Detection
Yazarlar: Yang Zhang; Yijun Wan; Yuan Xu; Mingqing Zhang; Yanlin He; Wei Ke; Hao Sheng.
Yazar sıralaması: Yang Zhang birinci, Yijun Wan ikinci, Yuan Xu üçüncü, Mingqing Zhang dördüncü, Yanlin He beşinci, Wei Ke altıncı ve Hao Sheng yedinci yazardır.
Eş birinci yazar: Eş katkı veya eş birinci yazar beyanı incelenen sürümde yer almamaktadır.
Sorumlu yazar: SSRN resmî kaydı Yang Zhang’ı iletişim yazarı olarak göstermektedir. İncelenen makalenin yazar sayfasında sorumlu yazarı belirleyen yıldız veya ayrı bir dipnot bulunmamaktadır.
Yazarlar ve kurumlar:
- Yang Zhang — College of Information Science and Technology, Beijing University of Chemical Technology, Beijing, Çin.
- Yijun Wan — College of Information Science and Technology, Beijing University of Chemical Technology, Beijing, Çin.
- Yuan Xu — College of Information Science and Technology, Beijing University of Chemical Technology, Beijing, Çin.
- Mingqing Zhang — College of Information Science and Technology, Beijing University of Chemical Technology, Beijing, Çin.
- Yanlin He — College of Information Science and Technology, Beijing University of Chemical Technology, Beijing, Çin.
- Wei Ke — Macao Polytechnic University, Makao, Çin.
- Hao Sheng — School of Computer Science and Engineering, Beihang University, Beijing, Çin.
İletişim adresi: Yang Zhang için incelenen sürümde yang_zh@mail.buct.edu.cn adresi verilmiştir.
ORCID: ORCID bilgileri incelenen sürümde yer almamaktadır.
Dergi: Hakemli bir dergi adı incelenen sürümde yer almamaktadır.
Yayınevi: Kesinleşmiş nihai yayınevi bilgisi bulunmamaktadır. SSRN, çalışmanın preprint kayıt ve dağıtım platformudur.
Yayın platformu: SSRN.
SSRN kayıt tarihi: 27 Temmuz 2026.
Yayın yılı: 2026.
Kaynak türü: Bilgi damıtma, görüntü-dil ön hizalaması, özel ve açık görüntü veri kümeleri ve çoklu nesne algılayıcı karşılaştırmaları içeren deneysel yapay zekâ araştırması preprinti.
Hakemlik durumu: Çalışma hakem değerlendirmesinden geçmemiştir. Bu durum başlık sayfasında ve bütün makale sayfalarında açıkça belirtilmiştir.
Resmî kaynak:SSRN resmî çalışma kaydı.
Kaynak kod: Araştırmacılar uygulamanın anonim araştırma deposunda paylaşıldığını belirtmektedir. Depodaki bütün dosyaların sürümü ve deneyleri bu değerlendirmede ayrıca çalıştırılarak doğrulanmamıştır.
Veri erişimi: Açık DFS veri kümesi özgün kaynağından erişilebilir olarak belirtilmiştir. Petrokimya rafinerileri ve tank sahalarından alınan özel görüntüler; endüstriyel güvenlik, gizlilik ve mahremiyet gerekçeleriyle kamuya açık değildir. Ek bilgi, veri kullanım kısıtları altında sorumlu yazardan istenebilmektedir.
Finansman: Ayrı bir finansman beyanı incelenen sürümde yer almamaktadır.
Çıkar çatışması: Yazarlar çalışmayı etkileyebilecek bilinen mali çıkar veya kişisel ilişki bulunmadığını beyan etmiştir.
Etik ve mahremiyet: İnsan veya hayvan deneyi raporlanmamıştır. Özel endüstriyel görüntülerin mahremiyet ve güvenlik nedeniyle paylaşılmadığı belirtilmiş; kamera görüntülerindeki olası kişisel verilerin anonimleştirme veya etik inceleme yöntemi ayrıntılandırılmamıştır.
Üretken yapay zekâ beyanı: Araştırmacılar ChatGPT’yi dil düzeltme, makale düzeni, LaTeX biçimlendirmesi ve editoryal iyileştirme için kullandıklarını; deney verisi üretme, model eğitme veya bilimsel sonuç çıkarma amacıyla kullanmadıklarını belirtmiştir. Yazarlar bütün içeriği gözden geçirdiklerini ve nihai sorumluluğu üstlendiklerini açıklamıştır.
Bu Türkçe açıklama, yüklenen 20 sayfalık dosyanın başlık ve yazar bilgileri, ana metni, 13 denklemi, sekiz tablosu, sekiz şekli, veri kümesi örnekleri, etkinleştirme haritaları, bileşen çıkarma deneyleri, sonuçları, veri erişim beyanları ve kaynakçası incelenerek hazırlanmıştır. Bilimsel içeriğe çalışma dışında yeni bir deney sonucu eklenmemiştir. Dış kaynaklar yalnızca başlık, yazar sırası, iletişim yazarı, DOI, kayıt tarihi ve kurum bilgilerinin bibliyografik doğrulanması amacıyla kullanılmıştır.
Çalışmanın sonuçları, semantik yönlendirmeli prototip damıtmanın incelenen veri kümesinde küçük ve düşük kontrastlı yangın-duman hedeflerini algılamayı geliştirebildiğini ve aydınlatma kaynaklı yanlış tepkileri azaltabildiğini desteklemektedir. Ancak özel verinin paylaşılmaması, yanlış alarm ve AP ölçütlerindeki raporlama eksikleri, istatistiksel belirsizliğin verilmemesi ve gerçek uç cihaz saha testinin bulunmaması nedeniyle yöntem henüz bağımsız olarak doğrulanmış endüstriyel erken uyarı sistemi olarak değerlendirilmemelidir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir