

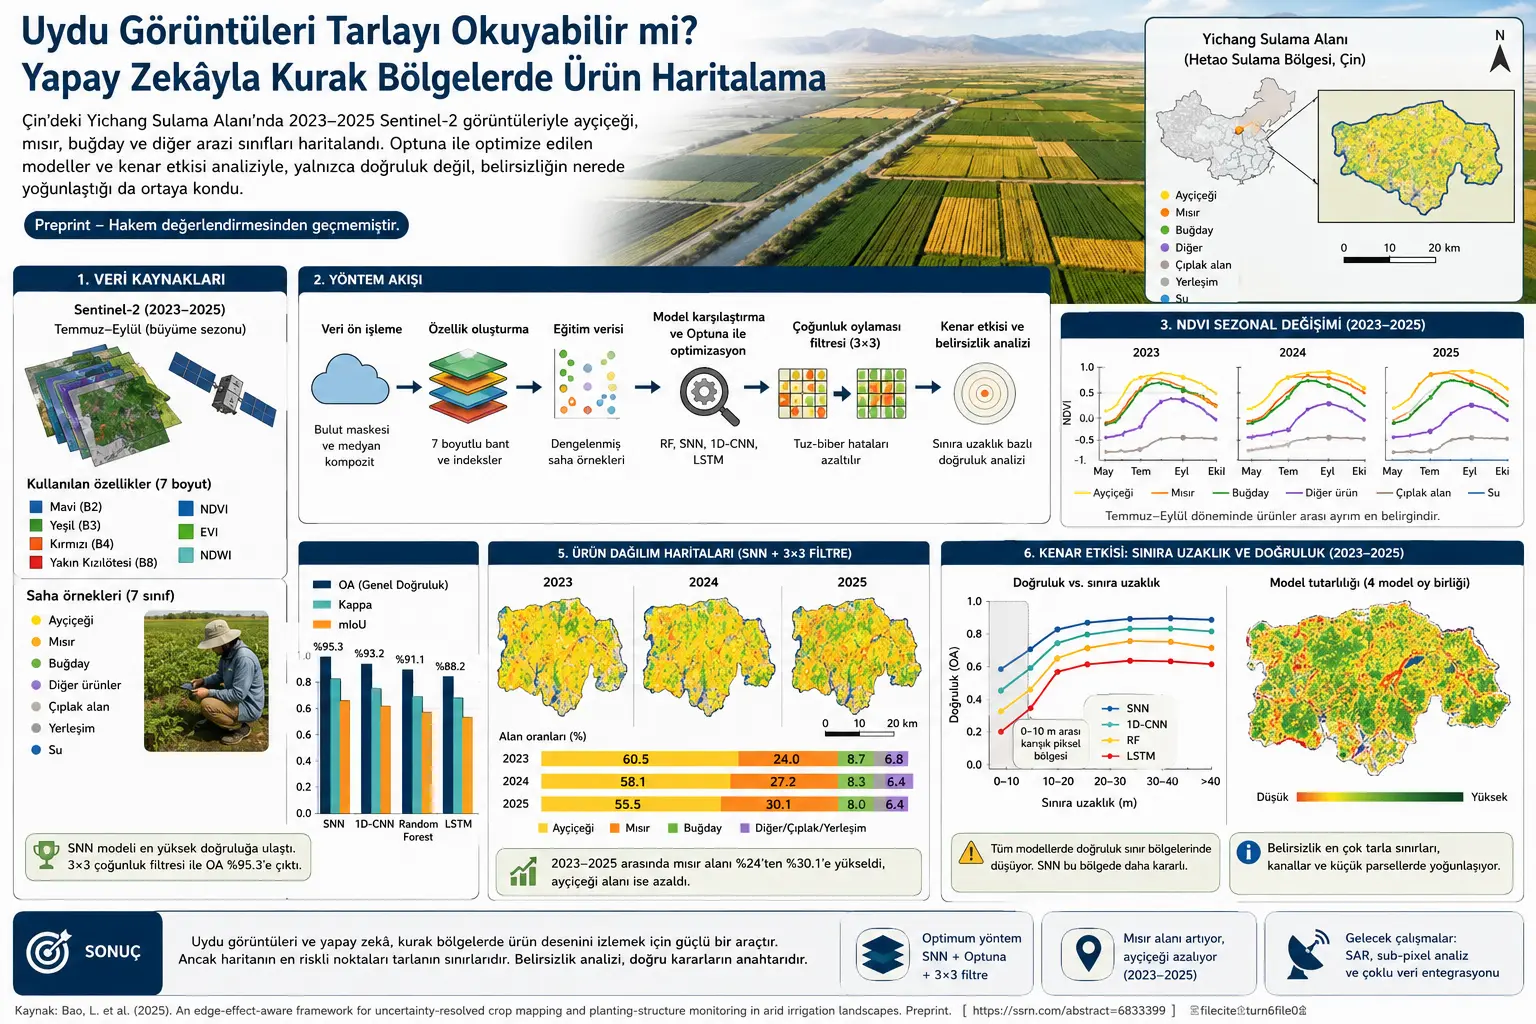
Araştırmacılar, 2023–2025 yıllarına ait Sentinel-2 uydu görüntülerinden 7 boyutlu bir özellik seti oluşturuyor: dört temel spektral bant ve üç bitki/su indeksi. Daha sonra Random Forest, SNN, 1D-CNN ve LSTM modelleri karşılaştırılıyor. Model ayarları Optuna adlı otomatik hiperparametre optimizasyon aracıyla iyileştiriliyor. Son aşamada ise sınıflandırma haritasındaki küçük, dağınık “tuz-biber” hatalarını azaltmak için çoğunluk oylaması filtresi uygulanıyor.
Çalışmanın dikkat çekici bulgusu şu: Parçalı, sınırları karmaşık ve karışık piksellerin yaygın olduğu tarım alanlarında en karmaşık model her zaman en iyi sonucu vermiyor. Daha basit bir Standart Sinir Ağı modeli, bazı karmaşık modellere göre daha kararlı çalışıyor. Ancak çalışmanın asıl katkısı yalnızca doğruluk puanlarını artırmak değil; hatanın özellikle tarla sınırlarına yakın bölgelerde yoğunlaştığını göstermesi. Bu da yapay zekâ destekli tarım haritalarında “nerede doğru, nerede belirsiz?” sorusunun en az “kaç puan doğru?” sorusu kadar önemli olduğunu gösteriyor.
Problem Ne?
Kurak ve yarı kurak bölgelerde tarım, su kaynaklarıyla doğrudan sınırlıdır. Özellikle büyük sulama bölgelerinde hangi ürünlerin ne kadar alana yayıldığını bilmek, su tahsisi, arazi planlaması ve ekim deseninin izlenmesi açısından kritik hale gelir. Fakat bu bilgi sahadan tek tek toplanırsa hem zaman alır hem de geniş alanlarda güncel kalması zorlaşır.
Uydu görüntüleri bu soruna güçlü bir çözüm sunar. Sentinel-2 gibi uydular, arazi yüzeyinden yansıyan ışığı farklı bantlarda ölçerek bitki örtüsü, su varlığı, çıplak toprak ve yapılaşma gibi sınıfların ayrılmasına yardım eder. Ancak tarım arazileri her zaman büyük ve düzenli parsellerden oluşmaz. Bazı bölgelerde tarlalar küçük, sınırlar karmaşık, sulama kanalları ve yollar iç içe geçmiş olabilir.
Bu çalışmadaki Yichang Sulama Alanı da böyle bir örnek. Bölge; ayçiçeği, mısır ve buğday gibi ürünlerin bulunduğu, parçalı tarım parsellerinin sulama kanalları, drenaj hatları, yollar ve koruma şeritleriyle kesildiği bir mozaik yapı gösteriyor. Bu yapı, uydu piksellerinin “tek bir sınıfı” temsil etmesini zorlaştırıyor.
Sorunun teknik adı karışık piksel etkisidir. Örneğin 10 metrelik bir uydu pikseli, küçük bir tarlanın kenarında hem mısır hem ayçiçeği hem de tarla yolu sinyali taşıyabilir. Model bu pikseli tek bir sınıfa atamak zorunda kaldığında hata riski artar. Bu nedenle tarla sınırları, yollar, kanallar ve küçük parseller sınıflandırma belirsizliğinin en yoğun olduğu yerler haline gelir.
Makalenin ana problemi şudur: Parçalı ve su kısıtı altındaki tarım bölgelerinde, uydu görüntüleri ve yapay zekâ modelleriyle ürün haritası çıkarırken hem doğruluğu artırmak hem de hatanın nerede yoğunlaştığını anlamak mümkün mü?
Yöntem Ne Öneriyor?
Çalışma, “kenar etkisi farkındalığı” olan bir ürün haritalama çerçevesi öneriyor. Kenar etkisi, tarla sınırlarına yakın bölgelerde uydu piksellerinin birden fazla arazi unsurundan sinyal alması nedeniyle sınıflandırma doğruluğunun düşmesi anlamına geliyor.
Yöntem birkaç aşamadan oluşuyor.
İlk aşamada Sentinel-2 uydu görüntüleri seçiliyor. Araştırmacılar, 2023–2025 yılları için Temmuz-Eylül arasındaki büyüme sezonuna odaklanıyor. Bu dönem, ayçiçeği, mısır ve diğer ürünlerin spektral olarak daha iyi ayrılabildiği dönem olarak ele alınıyor. Bulutlu görüntüler maskeleniyor ve birden fazla görüntüden medyan kompozit oluşturularak daha temiz bir yıllık büyüme sezonu görüntüsü elde ediliyor.
İkinci aşamada modelin kullanacağı özellikler hazırlanıyor. Dört temel Sentinel-2 bandı kullanılıyor: mavi, yeşil, kırmızı ve yakın kızılötesi. Bunlara üç indeks ekleniyor: NDVI, EVI ve NDWI. NDVI bitki canlılığı ve yeşilliği, EVI yoğun bitki örtüsü bölgelerindeki hassasiyeti, NDWI ise su ve nemli yüzey farklarını yakalamak için kullanılıyor. Böylece toplam 7 boyutlu bir özellik seti oluşturuluyor.
Üçüncü aşamada dört model karşılaştırılıyor: Random Forest, Standart Sinir Ağı, 1D-CNN ve LSTM. Random Forest klasik makine öğrenmesi tarafını temsil ediyor. SNN, spektral özellikleri doğrudan sınıflara bağlayan daha basit bir sinir ağı yapısı. 1D-CNN, spektral bantlar arasındaki yerel ilişkileri yakalamaya çalışıyor. LSTM ise normalde zaman serileri için güçlü olan, fakat bu çalışmada spektral-indeks dizisi üzerinde denenen daha karmaşık bir model.
Dördüncü aşamada Optuna ile otomatik hiperparametre optimizasyonu yapılıyor. Yani her modelin öğrenme oranı, katman sayısı, gizli birim sayısı, dropout oranı veya ağaç derinliği gibi ayarları elle deneme-yanılma ile değil, sistematik bir arama yöntemiyle optimize ediliyor.
Beşinci aşamada sınıflandırma haritalarına çoğunluk oylaması filtresi uygulanıyor. Bu filtre, bir pikselin çevresindeki komşulara bakarak izole hatalı noktaları azaltıyor. Örneğin büyük bir ayçiçeği parselinin ortasında tek bir piksel yanlışlıkla mısır olarak sınıflandırılmışsa, çevresindeki çoğunluk sınıfına göre düzeltiliyor. Ancak filtre çok büyürse dar kanallar, küçük parseller ve tarla sınırları silikleşebileceği için çalışma 3×3 pencereyi en dengeli seçenek olarak değerlendiriyor.
Son aşamada ise belirsizlik analizi yapılıyor. Araştırmacılar, piksellerin tarla sınırına uzaklığını hesaplıyor ve sınıflandırma doğruluğunu 0–10 m, 10–20 m gibi mesafe bantlarında inceliyor. Böylece hata yalnızca genel doğruluk puanıyla değil, “tarlanın neresinde hata artıyor?” sorusuyla birlikte değerlendiriliyor.
Formüller Ne Anlatıyor?
Bu çalışma formülleri ağır teorik anlatım için değil, uydu verisini sınıflandırılabilir bilgiye çevirmek için kullanıyor.
NDVI formülü, yakın kızılötesi ve kırmızı bant arasındaki farkı kullanır. Sağlıklı ve yoğun bitki örtüsü yakın kızılötesi ışığı güçlü yansıtır, kırmızı ışığı ise fotosentez nedeniyle daha fazla soğurur. Bu yüzden NDVI, bitki canlılığını anlamada temel göstergelerden biridir.
EVI formülü de bitki örtüsünü izler; ancak yoğun bitki örtüsünde ve atmosferik etkilerde daha kararlı bilgi üretmeyi hedefler. Mavi bandı da hesaba katarak bazı atmosferik sapmaları azaltmaya çalışır.
NDWI formülü, yeşil ve yakın kızılötesi bantları kullanarak su veya nemli yüzey sinyalini ayırmaya yardım eder. Tarım alanlarında su kanalları, nemli bitki örtüsü ve açık su yüzeyleri gibi sınıfların ayrılmasında yararlı olabilir.
Model eğitiminde çapraz entropi kaybı kullanılıyor. Bu formül, modelin verdiği olasılık ile gerçek sınıf arasındaki farkı ölçer. Model doğru sınıfa yüksek olasılık verdikçe kayıp azalır; yanlış sınıfa güvendikçe kayıp artar.
SNN tarafında formüller, katmanlar arasında ağırlıklar, bias değerleri ve ReLU aktivasyonuyla ilerleyen klasik sinir ağı mantığını gösterir. Basitçe söylersek model, 7 özellikten gelen sayıları katman katman dönüştürerek “bu piksel ayçiçeği mi, mısır mı, su mu?” sorusuna cevap üretir.
1D-CNN formülleri, spektral bantlar ve indeksler arasındaki küçük yerel ilişkileri yakalamaya çalışır. Görüntüdeki iki boyutlu mekânsal komşuluk yerine, burada özellik dizisi boyunca kayan küçük filtreler kullanılır.
LSTM formülleri, giriş, unutma ve çıkış kapılarıyla bilginin nasıl tutulup bırakıldığını anlatır. LSTM normalde zamana bağlı dizilerde güçlüdür. Ancak bu çalışmada kullanılan özellikler gerçek bir zaman serisi değil, daha çok spektral-indeks vektörüdür. Bu nedenle LSTM’nin avantajı sınırlı kalmış olabilir.
Çoğunluk oylaması filtresinin formülü, bir pencere içindeki sınıfları sayar ve merkez pikseli en çok görülen sınıfa atar. Bu basit yöntem, sınıflandırma haritasındaki dağınık tekil hataları azaltır.
Kenar etkisi formülü ise her pikselin en yakın tarla sınırına olan uzaklığını hesaplar. Böylece model başarısı yalnızca genel ortalamayla değil, sınıra yakınlıkla birlikte okunur.
Grafik / Tablo / Şema Ana Mesajı
Çalışma alanı görseli, Yichang Sulama Alanı’nın İç Moğolistan’daki Hetao Ovası içinde yer aldığını ve bölgenin ayçiçeği, mısır, buğday, su, çıplak alan ve yerleşim gibi sınıflardan oluşan karmaşık bir tarım mozaiğine sahip olduğunu gösteriyor. Görselin ana mesajı, araştırmanın düzenli ve tek tip tarlalardan çok, sulama kanalları ve parçalı parsellerle bölünmüş gerçek bir tarım coğrafyasında yapıldığıdır.
NDVI eğrilerini gösteren grafikler, ürünlerin büyüme sezonu boyunca farklı yeşillenme desenleri sergilediğini anlatıyor. Temmuz-Eylül aralığında ayçiçeği, mısır ve diğer ürünler arasındaki ayrım daha belirgin hale geliyor. Bu nedenle araştırmacılar sınıflandırma için bu dönemi seçiyor. Okuyucu açısından bu grafiklerin ana mesajı şudur: Uydu modeli, ürünleri rastgele bir tarihte değil, ürünlerin birbirinden en iyi ayrılabildiği büyüme döneminde okumaya çalışıyor.
Yöntem akış şeması, çalışmanın yalnızca bir yapay zekâ modeli kurmaktan ibaret olmadığını gösteriyor. Önce uydu verisi hazırlanıyor, sonra saha örnekleriyle model eğitiliyor, ardından Optuna ile model ayarları optimize ediliyor, daha sonra çoğunluk filtresiyle harita temizleniyor ve en sonunda kenar etkisi analiziyle belirsizlik haritası çıkarılıyor. Şemanın ana mesajı, doğruluk kadar belirsizliğin konumunu anlamanın da yöntemin parçası olduğudur.
Model karşılaştırma grafiklerinde SNN’nin güçlü bir performans sergilediği görülüyor. Başlangıçta SNN, CNN, Random Forest ve LSTM arasında en yüksek temel doğruluğa ulaşıyor. Optimizasyondan sonra da SNN önde kalıyor. Bu sonuç, parçalı tarım alanlarında daha karmaşık modelin her zaman daha iyi olmadığına işaret ediyor.
Çoğunluk oylaması filtresi grafiği, 3×3 pencerenin en iyi dengeyi verdiğini gösteriyor. Küçük pencere, izole sınıflandırma hatalarını temizlerken tarla sınırlarını büyük ölçüde koruyor. Buna karşılık 5×5 ve özellikle 7×7 gibi daha büyük pencereler haritayı daha pürüzsüz gösterse de küçük parselleri, dar kanalları ve sınır çizgilerini fazla yumuşatabiliyor.
Yerel sınıflandırma haritaları, filtre öncesinde modellerin genel ürün desenini yakaladığını ama bazı piksellerde dağınık hatalar ürettiğini gösteriyor. Filtre sonrasında haritalar daha bütünlüklü hale geliyor. Bu görsellerin ana mesajı, yapay zekâ çıktısının ham haliyle değil, mekânsal bağlamla birlikte işlendiğinde daha kullanışlı haritalar üretebildiğidir.
Ürün dağılım haritaları, Yichang Sulama Alanı’nda ayçiçeğinin baskın bir arka plan ürünü gibi yayıldığını, mısırın ise daha çok belirli kümeler halinde yoğunlaştığını gösteriyor. 2023’ten 2025’e doğru mısır alanlarının özellikle kuzeybatıdan merkeze doğru genişlediği anlatılıyor. Bu değişim, yalnızca tarımsal bir desen değil; su-toprak kısıtları ile ekonomik getiriler arasındaki gerilimi de yansıtıyor.
Çoklu model tutarlılık haritaları, model belirsizliğinin rastgele dağılmadığını ortaya koyuyor. Büyük parsellerin iç kısımlarında modeller daha çok aynı fikirdeyken, tarla sınırları, yollar, kanallar ve küçük parçalı bölgelerde model anlaşmazlığı artıyor. Bu, tarım haritalarında belirsizliğin “coğrafi bir yapısı” olduğunu gösteriyor.
Kenar etkisi grafikleri, sınıra en yakın 0–10 metrelik bölgelerde doğruluğun belirgin biçimde düştüğünü gösteriyor. Bu düşüş tüm modellerde görülüyor; ancak SNN, LSTM’ye göre bu bölgede daha kararlı kalıyor. Görselin ana mesajı açık: Haritanın en riskli yeri, parselin ortası değil, sınırıdır.
Deneyler Nasıl Yapılmış?
Araştırma, Çin’in İç Moğolistan bölgesindeki Yichang Sulama Alanı’nda yürütülmüş. Bölge, Sarı Nehir’den su alan Hetao Sulama Bölgesi’nin bir parçası. Kurak-yarı kurak iklim, yüksek buharlaşma, düşük yağış, tuzluluk ve yoğun sulama altyapısı bölgenin temel özellikleri arasında yer alıyor.
Veri kaynağı olarak 2023, 2024 ve 2025 yıllarına ait Sentinel-2 uydu görüntüleri kullanılmış. Temmuz-Eylül aralığında bulutluluk oranı uygun olan görüntüler seçilmiş. Bulutlar QA60 bandı kullanılarak maskelenmiş ve medyan kompozit yaklaşımıyla yıllık büyüme sezonunu temsil eden daha temiz görüntüler oluşturulmuş.
Model girişi olarak 7 özellik kullanılmış: mavi, yeşil, kırmızı ve yakın kızılötesi bantlar ile NDVI, EVI ve NDWI indeksleri. Ayrıca Mayıs-Ekim arasındaki aylık NDVI eğrileri, sınıflandırmada doğrudan kullanılmasa da ürünlerin fenolojik ayrımının hangi dönemde daha güçlü olduğunu görmek için yardımcı analiz olarak değerlendirilmiş.
Saha çalışmalarıyla yedi sınıf için örnek veri oluşturulmuş: ayçiçeği, mısır, buğday, diğer ürünler, çıplak alan, yapılaşmış alan ve su. Örnekler dengelenmiş ve eğitim/doğrulama verilerine ayrılmış. Böylece modelin yalnızca baskın sınıflara kaymasını önlemek amaçlanmış.
Dört model aynı veriyle karşılaştırılmış: Random Forest, SNN, 1D-CNN ve LSTM. Modellerin ayarları Optuna ile optimize edilmiş. Başarı ölçütleri olarak genel doğruluk, Kappa, F1 skoru ve mIoU kullanılmış. Daha sonra sınıflandırma haritalarına 3×3, 5×5 ve 7×7 çoğunluk filtreleri uygulanarak hangi pencere boyutunun en iyi dengeyi verdiği test edilmiş.
Son olarak, tarla sınırlarından uzaklığa göre doğruluk analizi yapılmış. Piksellerin sınıra uzaklığı hesaplanmış ve model performansı 0–10 m, 10–20 m gibi mesafe bantlarında incelenmiş. Bu bölüm, çalışmanın en değerli taraflarından biri; çünkü yalnızca “model başarılı mı?” sorusunu değil, “başarı nerede düşüyor?” sorusunu da cevaplamaya çalışıyor.
Sonuçlar Ne Gösteriyor?
İlk sonuç, SNN modelinin parçalı tarım alanlarında beklenenden güçlü performans göstermesi. Optimizasyon öncesi temel karşılaştırmada SNN en yüksek genel doğruluğu veriyor. Optuna ile optimize edildikten sonra SNN’nin genel doğruluğu 0.925’e çıkıyor. 1D-CNN 0.919, Random Forest 0.907 ve LSTM 0.896 ile onu takip ediyor.
İkinci sonuç, çoğunluk oylaması filtresinin harita kalitesini ciddi biçimde artırması. En iyi sonuç 3×3 filtreyle elde ediliyor. Bu filtre SNN modelinin genel doğruluğunu 0.953’e yükseltiyor. Daha büyük filtreler ilk bakışta daha düzgün haritalar üretebilir; ancak küçük tarla parçalarını ve dar sınırları fazla yumuşatabildiği için doğruluk düşebiliyor.
Üçüncü sonuç, bölgedeki ürün deseninin “ayçiçeği matrisi ve mısır kümelenmesi” şeklinde özetlenebilmesi. Ayçiçeği geniş ve süreklilik gösteren baskın ürün olarak kalırken, mısır daha çok belirli bölgelerde kümeleniyor. 2023’ten 2025’e mısır alanı artıyor; ayçiçeği alanı ise azalıyor. Makale bu değişimi ekonomik teşvikler, su-toprak kısıtları ve ürün tercihi arasındaki dengeyle ilişkilendiriyor.
Dördüncü sonuç, model belirsizliğinin en çok tarla sınırlarında yoğunlaşması. Sınırdan 0–10 m uzaklıktaki piksellerde doğruluk tüm modellerde düşüyor. Bunun temel nedeni karışık piksel etkisi. Aynı piksel içinde ürün, yol, kanal, tarla sınırı veya farklı ürün sınıfları birlikte temsil edilebiliyor. Bu bölgelerde SNN, LSTM’ye göre daha kararlı davranıyor.
Beşinci sonuç, genel doğruluk puanının tek başına yeterli olmaması. Bir model yüksek genel doğruluk verebilir; ancak sınır bölgelerinde sistematik hata yapıyorsa su yönetimi, ürün alanı hesabı veya arazi planlaması için riskli sonuçlar doğurabilir. Bu nedenle çalışma, tarımsal yapay zekâ uygulamalarında belirsizlik haritalarının da üretilmesi gerektiğini güçlü biçimde hatırlatıyor.
Bu Neden Önemli?
Kurak bölgelerde tarım planlaması, yalnızca üretim miktarıyla değil su bütçesiyle de ilgilidir. Hangi ürünün hangi alanda yetiştiğini doğru bilmek, sulama talebini, su tahsisini ve arazi kullanım kararlarını etkileyebilir. Ayçiçeği gibi daha toleranslı ürünlerle mısır gibi daha yüksek su ve uygun toprak koşulu isteyen ürünlerin mekânsal dağılımını izlemek, su kısıtı olan bölgeler için stratejik bir veri sağlayabilir.
Bu çalışma, yapay zekâ destekli tarım haritalarının yalnızca “güzel renkli harita” üretmemesi gerektiğini gösteriyor. Haritanın nerede güvenilir, nerede belirsiz olduğunu da bilmek gerekiyor. Çünkü tarla sınırlarında küçük görünen hatalar, alan hesabında, ürün istatistiğinde veya su planlamasında büyüyebilir.
Çalışmanın bir diğer önemli tarafı, model karmaşıklığı konusundaki varsayımları sorgulaması. LSTM gibi daha gelişmiş görünen modeller, her veri türünde otomatik olarak daha iyi sonuç vermez. Eğer veri gerçek bir zaman serisi değil de statik spektral özelliklerden oluşuyorsa, daha basit bir SNN modeli daha sağlam çalışabilir. Bu bulgu, yapay zekâ projelerinde “en karmaşık model” yerine “veriye en uygun model” seçiminin önemini hatırlatıyor.
Ayrıca çoğunluk oylaması filtresi gibi görece basit bir işlem, doğru ölçekte kullanıldığında model çıktısını ciddi biçimde iyileştirebiliyor. Bu da tarım yapay zekâsında yalnızca model mimarisinin değil, ön işleme ve son işleme adımlarının da başarıda belirleyici olduğunu gösteriyor.
Dikkat Noktaları
Bu çalışma preprinttir. Yani sonuçlar henüz hakem değerlendirmesinden geçmemiştir. Bu nedenle bulgular kesinleşmiş bilimsel sonuç gibi değil, değerlendirilmesi ve farklı koşullarda sınanması gereken yöntemsel katkılar olarak okunmalıdır.
Çalışma tek bir bölgeye odaklanıyor. Yichang Sulama Alanı; kurak-yarı kurak iklim, tuzluluk, sulama kanalları, parçalı parseller ve belirli ürün desenleriyle özel bir coğrafyadır. Aynı model performansı farklı ülkelerde, farklı ürünlerde, farklı parsel büyüklüklerinde veya farklı uydu görüntülerinde aynı şekilde elde edilmeyebilir.
Sentinel-2’nin 10 m çözünürlüğü birçok tarım uygulaması için yararlı olsa da küçük parseller ve dar sınırlar için sınırlı kalabilir. Özellikle 0–10 m sınır bölgelerinde karışık piksel sorunu fiziksel bir sınır olarak ortaya çıkıyor. Bu yalnızca daha iyi modelle tamamen çözülebilecek bir sorun değildir; daha yüksek çözünürlüklü veri veya sub-pixel analiz gerekebilir.
Çalışmada yöntem şeması çok kaynaklı veri entegrasyonundan söz ederken, veri açıklamasında ana sınıflandırma girişi Sentinel-2 bantları ve indeksleri üzerine kuruludur. Bu tür metodolojik ayrıntılar sonraki sürümlerde daha açık belirtilmelidir.
Model başarısı dengeli saha örneklerine ve seçilen Temmuz-Eylül pencereye bağlıdır. Farklı büyüme dönemlerinde, bulutlu sezonlarda veya fenolojik olarak birbirine daha çok benzeyen ürünlerde performans değişebilir.
Çoğunluk filtresi doğru seçildiğinde faydalıdır; ancak pencere büyürse küçük tarım unsurlarını silebilir. Bu nedenle harita düzeltme işlemleri yalnızca görsel pürüzsüzlüğe göre değil, sınır koruma ve sınıf doğruluğu birlikte değerlendirilerek yapılmalıdır.
Veri erişimi “talep üzerine sağlanır” şeklinde belirtilmiş. Bu durum, bağımsız tekrar üretilebilirlik açısından açık veri paylaşımı kadar güçlü değildir. Yöntemin başka araştırmacılar tarafından sınanması için veri ve kod erişimi önemlidir.
Sonuç
Bu preprint çalışma, uydu görüntüleriyle tarımsal ürün haritalamada önemli bir noktaya dikkat çekiyor: Doğruluk yalnızca ortalama bir sayı değildir; mekânda değişir. Parçalı tarım alanlarında model hatası özellikle tarla sınırlarında, kanal kenarlarında, yollarda ve küçük parsellerde yoğunlaşır. Bu nedenle iyi bir tarım haritası yalnızca “hangi ürün nerede?” sorusunu değil, “bu tahminin hangi kısmı daha belirsiz?” sorusunu da cevaplamalıdır.
Araştırmanın bulguları, Yichang Sulama Alanı’nda ayçiçeğinin baskın ürün olarak kaldığını, mısırın ise 2023–2025 arasında daha fazla alana yayıldığını gösteriyor. Bu değişim, su-toprak kısıtları ile ekonomik getiriler arasında şekillenen tarımsal kararların uzaktan algılamayla izlenebileceğine işaret ediyor.
Yapay zekâ tarafında ise en dikkat çekici sonuç, daha basit SNN modelinin parçalı ve karışık pikselli tarım alanlarında güçlü performans göstermesi. 3×3 çoğunluk filtresiyle birlikte bu modelin harita bütünlüğü ve doğruluğu artıyor. Ancak sınır bölgelerindeki karışık piksel sorunu devam ediyor. Bu nedenle gelecek çalışmaların daha yüksek çözünürlüklü veriler, radar görüntüleri, sub-pixel analiz ve meteorolojik-hidrolojik verilerle desteklenmesi önemli olabilir.
En güvenli yorum şudur: Bu yaklaşım, kurak sulama bölgelerinde ürün desenini daha iyi izlemek için güçlü bir yöntemsel adaydır; ancak farklı bölgelerde, farklı ürünlerde ve daha açık veriyle yeniden sınanması gerekir.
Kaynak ve Yöntem Notu
Bu yazı, “An edge-effect-aware framework for uncertainty-resolved crop mapping and planting-structure monitoring in arid irrigation landscapes” başlıklı preprint makaleden hazırlanmıştır. Çalışma, Çin’deki Yichang Sulama Alanı’nda 2023–2025 dönemine ait Sentinel-2 büyüme sezonu görüntülerini, saha örneklerini, spektral bantları, NDVI/EVI/NDWI indekslerini, Optuna tabanlı model optimizasyonunu, çoğunluk oylaması filtresini ve kenar etkisi belirsizlik analizini birlikte kullanmaktadır.
Metin birebir çeviri değildir. Makaledeki ana fikir, yöntem, formüller, grafikler, tablolar, deney akışı, sonuçlar ve sınırlılıklar Verianla okuyucusu için sadeleştirilerek özgün Türkçe editoryal içerik halinde yeniden anlatılmıştır. Çalışma preprint olduğu için bulgular kesin uygulama tavsiyesi olarak değil, farklı tarımsal ve coğrafi koşullarda doğrulanması gereken araştırma sonuçları olarak değerlendirilmelidir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir