

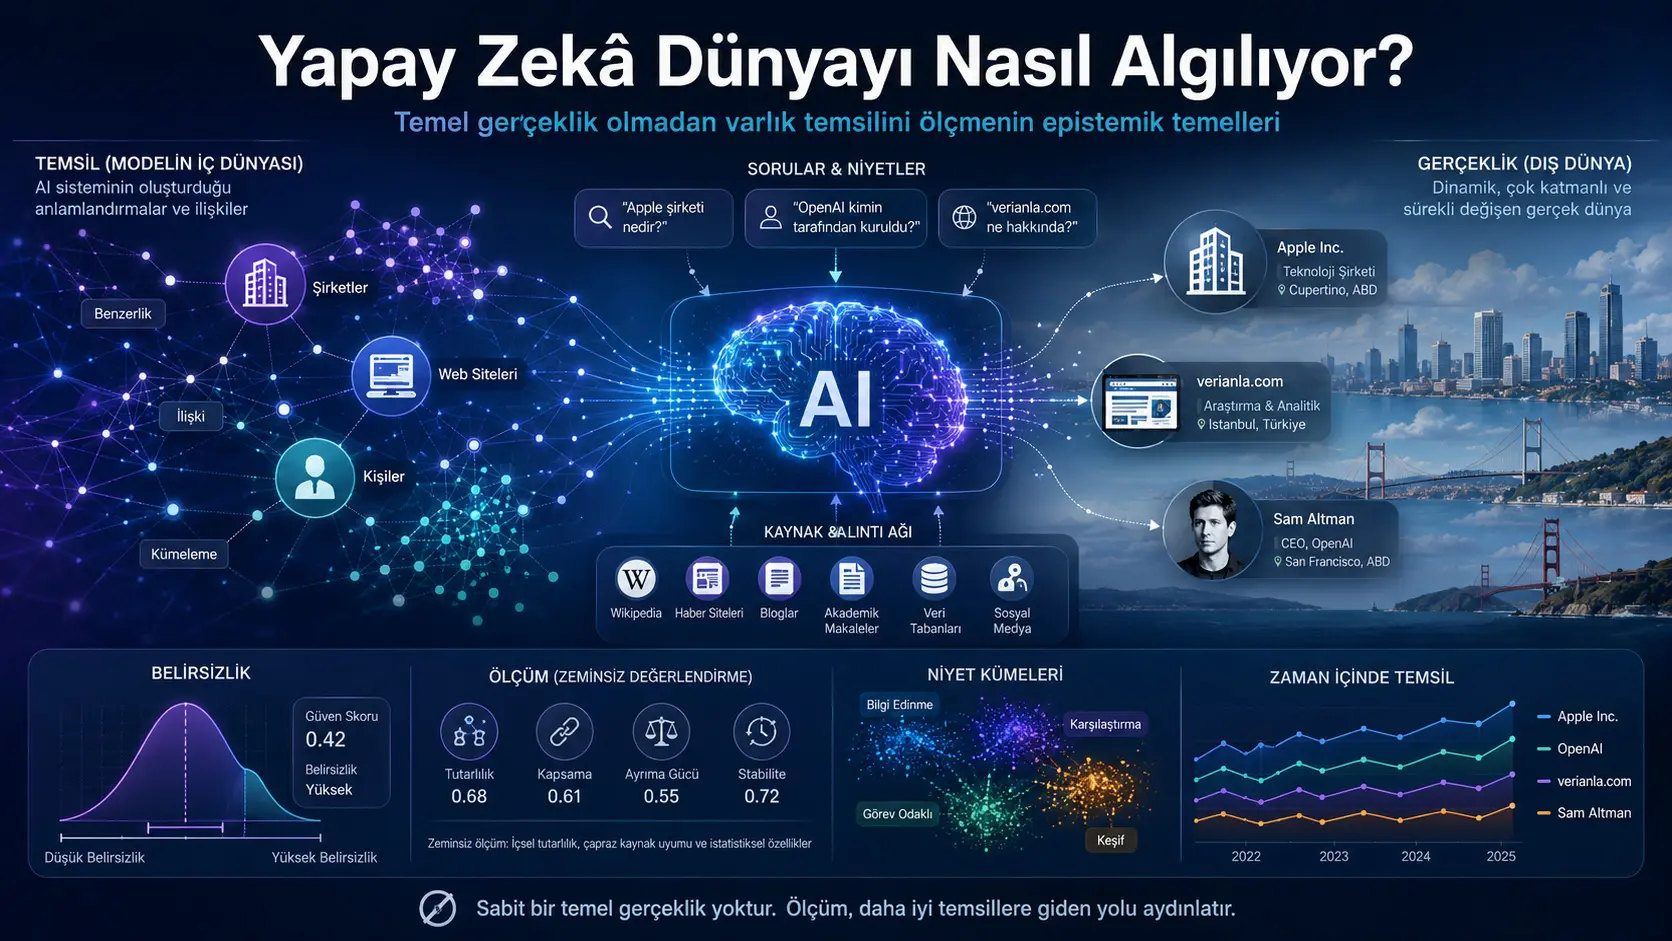
Bu çalışma, büyük dil modellerinin bir şirketi, internet sitesini, kişiyi veya başka bir varlığı cevaplarında nasıl temsil ettiğini ölçmek için kullanılan mevcut yöntemlerin temel bir kavramsal eksiklik taşıdığını savunmaktadır. Endüstride kullanılan yapay zekâ görünürlüğü araçları çoğunlukla bir varlığın cevaplarda kaç kez anıldığını, ne sıklıkta kaynak gösterildiğini veya rakipleri karşısındaki görünürlük payını hesaplamaktadır. Ancak çalışmaya göre bu ölçümler, elde edilen sayının hangi hedef büyüklüğü temsil ettiğini önceden yeterince tanımlamamaktadır.
Makalenin merkezindeki teknik kavram estimanddır. Estimand, bir ölçümün veya istatistiksel tahminin ulaşmaya çalıştığı açıkça tanımlanmış hedef büyüklüktür. Bir yapay zekâ görünürlüğü çalışması yüzde 30 atıf oranı bildirdiğinde, bu yüzde 30’un hangi soru evrenini, hangi kullanıcı niyetlerini ve hangi sorgu dağılımını temsil ettiği açıklanmalıdır. Aksi hâlde sayı hesaplanmış olsa bile neyin ölçüldüğü belirsiz kalır.
Yazar, büyük dil modelinin cevabını kullanıcı sorgusuna bağlı rastlantısal bir değişken olarak ele almaktadır. Bir X varlığının cevapta anılma veya kaynak gösterilme olasılığı, yalnızca X’in özelliklerine değil, modele yöneltilen q sorgusunun bağlamına da bağlıdır. “İyi bir otomobil şirketi hangisidir?” sorusuyla “En hızlı otomobili hangi şirket üretiyor?” sorusu aynı şirketleri öne çıkarmak zorunda değildir. Bu farklılık bir hata değil, soruların farklı bilgi ihtiyaçlarını yansıtmasının doğal sonucudur.
Bu nedenle belirli bir soru kümesindeki bütün atıf olasılıklarını tek bir ortalamada toplamak, ölçülen varlığa ait değişmez ve bağlamdan bağımsız bir özellik üretmez. Sonuç, soruları seçen kişinin ölçüm tasarımına bağlıdır. Tavsiye sorularının yoğun olduğu bir küme yüksek, karşılaştırma veya teknik performans sorularının yoğun olduğu başka bir küme düşük görünürlük üretebilir. Aynı varlık ve aynı model için farklı ölçüm yapanlar farklı sonuçlar elde edebilir.
Çalışma, bu problemi çözmek için sorguların kullanıcı niyetlerine göre kümelenmesini önermektedir. Bir varlığın yapay zekâdaki temsili tek bir genel atıf oranıyla değil; tavsiye, karşılaştırma, güvenilirlik, teknik değerlendirme ve diğer niyet kümelerinin her birindeki atıf oranlarından oluşan bir temsil alanı olarak tanımlanmalıdır.
Niyet kümeleri yalnızca sorguların kullandığı kelimelere göre oluşturulmamalıdır. Çalışmanın önerisine göre benzer kaynak ve atıf örüntülerine ulaşan sorgular, yapay zekânın temsil alanında benzer bilgi ihtiyaçlarına karşılık geliyor olabilir. Başka bir ifadeyle sorgular arasındaki niyet yakınlığı, yalnızca yüzeysel metin benzerliğine değil, cevapların hangi kaynaklara yöneldiğine göre belirlenebilir.
Estimand bu biçimde tanımlandıktan sonra ölçümün üç temel niteliği anlamlı biçimde incelenebilir: güvenilirlik, ölçüm tekrarlandığında benzer sonuçların elde edilmesini; geçerlilik, ölçümün gerçekten ölçtüğünü ileri sürdüğü yapıyı ölçmesini; kapsama ise yapay zekânın temsil alanının ne kadarının gözlendiğini ifade etmektedir.
Çalışmanın önemli ayrımlarından biri, güvenilirlik ile geçerliliğin aynı şey olmamasıdır. Yanlış veya yetersiz tanımlanmış bir sorgu kümesi yüzlerce kez çalıştırılarak son derece kararlı bir sonuç üretilebilir. Ancak bu sonuç ilgili varlığın temsil alanını yeterince kapsamıyorsa ölçüm güvenilir olduğu hâlde geçerli olmayabilir. Daha fazla tekrar yapmak, hedef büyüklüğün yanlış tanımlanmasını düzeltmez.
Varlık temsilinin tek ve doğrudan gözlenebilir bir temel gerçekliği bulunmadığı için çalışma, psikometri ve sosyal bilimlerde geliştirilen yapı geçerliliği yaklaşımından yararlanılmasını önermektedir. Buna göre farklı ölçüm yöntemlerinin benzer sonuçlar üretip üretmediği, ölçümün teorik olarak ilgisiz değişkenlerden ayrışıp ayrışmadığı ve ilişkili olması beklenen dış göstergelerle öngörülen yönde ilişki kurup kurmadığı değerlendirilmelidir.
Kapsamanın ölçülmesi için ise ekolojideki “görülmemiş türler” problemine benzer bir yaklaşım önerilmektedir. Yalnızca bir kez gözlenen atıf örüntülerinin oranı, henüz keşfedilmemiş temsil bölgelerinin büyüklüğüne ilişkin bilgi sağlayabilir. Yeni sorguların daha önce görülmemiş bir atıf örüntüsü üretme ihtimali yeterince düştüğünde ölçümün doygunluğa yaklaştığı düşünülebilir.
Ancak yapay zekânın kendi ürettiği sorgular tarafsız değildir. Model, eğitim verilerinde sık rastlanan ve tanıdık soru yapılarını daha kolay üretebilir; nadir bilgi ihtiyaçlarını ise gözden kaçırabilir. Bu nedenle çok sayıda sorgu üretmek, temsil alanının tamamının kapsandığını tek başına kanıtlamaz. Yapay zekânın hiçbir biçimde üretemediği ihtiyaçların keşfi için kullanıcı görüşmeleri, kurum bilgisi ve alan uzmanlığı gibi yapay zekâ dışındaki kaynaklara ihtiyaç vardır.
Çalışma, matematiksel ölçüm ile insan yorumunu açık biçimde ayırmaktadır. Niyet alanının tanımlanması, gerekli tekrar sayısının belirlenmesi, geçerlilik kanıtlarının incelenmesi ve kapsamanın tahmin edilmesi ilke olarak matematiksel ve istatistiksel yöntemlerle ele alınabilir. Buna karşılık yapay zekâ temsili ile gerçek durum arasındaki farkın sorun oluşturup oluşturmadığı ve bu farka nasıl müdahale edilmesi gerektiği insan değerlendirmesi gerektirir.
En önemli yorum sınırı şudur: Çalışma önerdiği çerçeveyi gerçek şirketler, kişiler, internet siteleri veya büyük dil modelleri üzerinde uygulamamıştır. Niyet kümeleri oluşturulmamış, kapsama oranı hesaplanmamış, yapı geçerliliği testleri gerçekleştirilmemiş ve önerilen yaklaşım mevcut ticari görünürlük araçlarıyla deneysel olarak karşılaştırılmamıştır. Çalışmanın katkısı doğrulanmış bir ölçüm sistemi sunmak değil, gelecekte geliştirilecek ölçümler için epistemik ve matematiksel bir temel önermektir.
Türkiye açısından değerlendirme: Çalışma; Türkiye’de markaların, üniversitelerin, kamu kurumlarının, şirketlerin, uzmanların ve internet sitelerinin ChatGPT benzeri sistemlerdeki görünürlüğünü ölçen çalışmalar açısından doğrudan önem taşımaktadır. Sınırlı sayıda Türkçe sorguda elde edilen anılma oranı, kuruluşun genel yapay zekâ görünürlüğü olarak sunulmamalıdır. Ölçümde kullanıcı niyetleri, dil, model, model sürümü, arama özelliği, tarih, tekrar sayısı ve temsil alanının kapsama düzeyi açıklanmalıdır. Bununla birlikte çalışma Türkçe sorgular, Türkiye’deki kullanıcı davranışları veya yerel kuruluşlar üzerinde deney yapmamıştır. Çerçevenin Türkiye’de kullanılabilmesi için Türkçe niyet kümeleri ve yerel bilgi ihtiyaçları üzerinde ayrıca doğrulanması gerekir.
Yapay zekâdaki varlık temsili ne anlama geliyor?
Çalışmada “varlık” kavramı; şirket, internet sitesi, kişi veya yapay zekâ cevaplarında anılabilecek başka bir tanımlanabilir nesneyi ifade etmektedir. Varlık temsili ise modelin bu nesneyi yalnızca nasıl tanımladığıyla sınırlı değildir. Varlığın hangi sorgularda anıldığı, hangi kaynaklarla ilişkilendirildiği, hangi bağlamlarda öne çıktığı ve hangi bağlamlarda görünmediği de temsilin parçalarıdır.
Büyük dil modelleri arama, tavsiye ve diyalog sistemlerine yerleştikçe bu temsil toplumsal sonuçlar doğurabilir. Bir işe alım uzmanı aday hakkında, kredi görevlisi şirket hakkında veya tüketici bir ürün hakkında yapay zekâya soru yöneltebilir. Modelin kullandığı tanımlar ve gösterdiği kaynaklar, insanların oluşturduğu kanaatleri etkileyebilir.
Yazar, yapay zekâ temsilinin klasik insan algısından yapısal olarak farklı olduğunu savunmaktadır. İnsanların görüşleri toplum içinde çok sayıda kişiye dağılmıştır. Buna karşılık çok sayıda kullanıcının aynı temel modelle etkileşime girmesi durumunda, modeldeki temsil eğilimi çok sayıda kişiye aynı yönde aktarılabilir. Bu nedenle tek bir modeldeki temsil değişiminin etkisi, tek bir bireyin görüşündeki değişimden daha geniş olabilir.
Mevcut görünürlük ölçümlerinin temel problemi nedir?
Mevcut uygulamalar çoğunlukla önceden seçilmiş bir sorgu kümesini modele yöneltmekte ve aşağıdaki göstergelerden birini veya birkaçını hesaplamaktadır:
- Varlığın cevaplarda anılma oranı,
- İnternet sitesinin kaynak olarak gösterilme oranı,
- Rakiplere göre yapay zekâ görünürlük payı,
- Cevap içindeki görünürlük sırası veya konumu,
- Varlıkla birlikte kullanılan olumlu veya olumsuz ifadeler,
- Farklı modellerde ya da zamanlarda meydana gelen görünürlük değişimi.
Çalışma bu göstergelerin operasyonel olarak hiçbir değer taşımadığını söylememektedir. Eleştiri, göstergenin hangi hedef büyüklüğü ölçtüğü açıklanmadan genel bir varlık özelliği gibi sunulmasına yöneliktir.
Estimand neden ölçümden önce tanımlanmalıdır?
Estimand, ölçümün tahmin etmeyi amaçladığı büyüklüktür. Ölçüm sonucu elde edilen sayı estimandın tahminidir; estimand ise bu sayının neyi temsil ettiğini tanımlar.
Bir kuruluş için “yapay zekâ görünürlüğü yüzde 25” denildiğinde en azından şu soruların cevaplanması gerekir:
- Bu oran hangi sorgu evrenine aittir?
- Hangi kullanıcı niyetleri kapsanmıştır?
- Sorgular hangi dağılıma göre ağırlıklandırılmıştır?
- Hangi model ve model sürümü kullanılmıştır?
- Sorgular hangi dil ve bölgesel bağlamda sorulmuştur?
- Aynı sorgu kaç kez tekrar edilmiştir?
Bu unsurlar tanımlanmazsa görünürlük oranı hesaplanabilir; ancak bu oranın kuruluşun hangi temsil özelliğine karşılık geldiği açıklanamaz.
Saf atıf oranı nasıl formüle edilmektedir?
Çalışma, büyük dil modelinin cevabını giriş sorgusuna koşullu rastlantısal bir süreç olarak ele almaktadır. X varlığının q sorgusuna verilen cevapta anılma veya kaynak gösterilme olasılığı şu şekilde tanımlanmaktadır:
\[ p(X\mid q) \]
Burada olasılık, aynı sorgunun farklı çalıştırmalarda farklı cevaplar üretebilmesini de kapsamaktadır.
Saf ölçüm yaklaşımı, \(Q=\{q_1,\ldots,q_n\}\) biçiminde seçilmiş bir sorgu kümesi üzerinde ortalama atıf oranını hesaplamaktadır:
\[ \theta= \frac{1}{|Q|} \sum_{q\in Q}p(X\mid q) \]
Bu formülde \(\theta\), X varlığının seçilen Q kümesindeki ortalama atıf oranıdır. Problem, bu değerin X’e ait bağlamdan bağımsız bir özellikmiş gibi yorumlanmasıdır.
Neden θ yalnızca X varlığının özelliği değildir?
\(\theta\) değeri, seçilen Q sorgu kümesine bağlıdır. Aynı varlık için farklı sorgu kümeleri seçildiğinde genel olarak farklı sonuçlar elde edilir:
\[ Q\neq Q' \quad\Rightarrow\quad \theta\neq\theta' \]
Örneğin bir otomobil şirketine ilişkin sorgu kümesi ağırlıklı olarak satın alma tavsiyelerinden oluşuyorsa şirket sık anılabilir. Sorgu kümesi hız, bakım maliyeti veya belirli teknik özelliklere ilişkin karşılaştırmalardan oluştuğunda aynı şirketin anılma oranı değişebilir.
Dolayısıyla sonuç yalnızca yapay zekânın X hakkındaki davranışını değil, ölçümü yapan kişinin hangi soruları seçtiğini de yansıtır. Çerçeve, farklı ölçüm yapanların elde ettiği sonuçlardan hangisinin genel ve doğru temsil olduğunu belirleyecek bir iç ölçüt sunmaz.
Heterojen sorgular neden tek ortalamada karıştırılmamalıdır?
Farklı kullanıcı niyetleri, farklı koşullu olasılıklara karşılık gelmektedir. Tavsiye istemek, performans karşılaştırmak ve teknik destek aramak aynı bilgi ihtiyacı değildir. Bu bağlamlardaki atıf oranlarını tek sayıda birleştirmek, farklı türde büyüklükleri aynı ortalamaya katmak anlamına gelir.
Genel ortalama, alt sorgu türlerinin kümedeki oranlarına göre değişir. Ölçüm tasarımında tavsiye sorgularına daha fazla yer verilirse sonuç tavsiye bağlamının davranışına yaklaşır. Karşılaştırma sorgularının payı artırılırsa farklı bir sonuç oluşabilir.
Çalışma bu durumu Simpson paradoksuyla ilişkili bir toplulaştırma problemi olarak değerlendirmektedir. Alt gruplardaki farklı eğilimler, grupların hangi oranlarda karıştırıldığına bağlı olarak genel istatistikte farklı veya yanıltıcı bir görünüm oluşturabilir.
Önceki çalışmaların katkısı tamamen reddediliyor mu?
Hayır. Çalışma, büyük dil modellerinin rastlantısal cevap değişkenliğini inceleyen ve güvenilir ölçüm için tekrar yapılması gerektiğini gösteren önceki araştırmaların önemli olduğunu belirtmektedir. Tek bir gözlem, bir varlığın modeldeki davranışını güvenilir biçimde temsil etmeyebilir.
Ancak tekrar sayısı ve güven aralığı, ölçümün yalnızca güvenilirlik sorununu ele alır. Ölçümün gerçekten amaçlanan yapıyı ölçüp ölçmediği ise geçerlilik sorunudur. Bir ölçüm tekrarlanabilir olduğu hâlde yanlış veya belirsiz tanımlanmış bir büyüklüğü ölçebilir.
Çalışmanın eklediği aşama, tekrar ve güven aralığından önce estimandın tanımlanmasıdır.
“Temsili sorgu kümesi” ifadesi problemi çözer mi?
Makale bu iddiayı öngörülen ilk itiraz olarak ele almaktadır. Bir sorgu kümesinin temsili olduğunu söylemek, temsil edilecek sorgu alanının ve bu alandaki dağılımın önceden tanımlanmasını gerektirir.
Hangi kullanıcı niyetlerinin ne kadar yaygın veya önemli olduğu tanımlanmadan bütün sorgulara eşit ağırlık vermek, temsili olma iddiasını haklı çıkarmaz. “Temsili sorgu kümesi” ifadesi bu nedenle estimand problemini ortadan kaldırmak yerine yeniden gündeme getirir.
İnsan algısı da bağlama bağlıysa yapay zekâ neden ayrı ele alınmaktadır?
Makale, insan algısının da bağlama bağlı olduğunu kabul etmektedir. Ancak iki fark vurgulanmaktadır:
- İnsan görüşleri çok sayıda bireye dağılırken, belirli bir modelin temsil davranışı çok sayıda kullanıcıya aynı merkezden aktarılabilir.
- Yapay zekâ temsilinin dağılımı model güncellemeleriyle değişebilir ve küçük ifade farklılıklarına yüksek hassasiyet gösterebilir.
Bu nedenle insanlar için geliştirilmiş ölçüm kuramlarının yapay zekâya hiçbir değişiklik yapılmadan aktarılması güvenli bir varsayım değildir.
Çalışma yapay zekâ temsilinin ölçülemeyeceğini mi savunuyor?
Hayır. Çalışmanın üçüncü öngörülen itiraza verdiği cevap, ölçümü reddetmek yerine ölçülecek nesneyi yeniden tanımlamaktır. Tek ve bağlamdan bağımsız atıf oranının yerine, kullanıcı niyetlerine koşullandırılmış bir atıf alanı önerilmektedir.
Niyet koşullandırması estimandı nasıl tanımlıyor?
Sorgu alanı, kullanıcıların karşılamaya çalıştığı bilgi ihtiyacına göre niyet kümelerine ayrılmaktadır. Belirli bir \(c\) niyet kümesindeki atıf oranı şu şekilde tanımlanmaktadır:
\[ \theta_c= \mathbb{E} \left[ p(X\mid q) \mid q\in c \right] \]
Buradaki \(\theta_c\), X varlığının bütün sorgulardaki genel görünürlüğü değildir. Yalnızca belirli bir niyet bağlamındaki ortalama atıf olasılığıdır.
Örneğin aynı otomobil üreticisi için aşağıdaki değerler ayrı ayrı ölçülebilir:
- Aile otomobili tavsiyesi bağlamındaki atıf oranı,
- Elektrikli otomobil karşılaştırmalarındaki atıf oranı,
- Performans otomobili sorgularındaki atıf oranı,
- Bakım maliyeti değerlendirmelerindeki atıf oranı,
- Güvenlik değerlendirmelerindeki atıf oranı.
Çalışmaya göre varlığın yapay zekâdaki temsili tek bir \(\theta\) değeri değil, niyet alanı boyunca tanımlanan \(\theta_c\) değerlerinin bütünüdür.
Niyet kümeleri nasıl oluşturulmalıdır?
Yazar, yalnızca kelime benzerliğine dayalı sınıflandırmanın niyeti doğru biçimde yakalamayabileceğini belirtmektedir. Hiçbir ortak kelime kullanmayan iki sorgu aynı bilgi ihtiyacını taşıyabilir. Buna karşılık birbirine çok benzeyen iki sorgu farklı amaçlara sahip olabilir.
Çalışmanın önerdiği operasyonel yaklaşım, sorguların cevaplarda oluşturduğu atıf örüntülerini kullanmaktır. Aynı veya benzer kaynak kümelerine yönelen sorgular, yapay zekâ açısından benzer bilgi ihtiyaçlarıyla ilişkili kabul edilebilir.
Bu yaklaşım şu varsayıma dayanmaktadır:
Benzer atıf sonuçlarına ulaşan sorgular, yapay zekânın temsil alanında birbirine yakın niyetleri yansıtır.
Bu varsayım makalede deneysel olarak sınanmamıştır. İnsanlar tarafından etiketlenen gerçek kullanıcı niyetleriyle atıf örüntüsüne dayalı kümelerin ne ölçüde örtüştüğü açık bir araştırma sorusudur.
Niyet alanı yalnızca ölçüm hassasiyetini artıran bir araç mıdır?
Hayır. Makaleye göre niyet alanı, ölçümün daha hassas yapılmasını sağlayan ikincil bir teknik değildir. Estimandın tanımlanması için mantıksal olarak gerekli bir bileşendir.
Bağlam farklılıkları ayrılmadan sorgular birleştirildiğinde ölçümü yapan kişiye bağımlılık ve karıştırma yanlılığı devam eder. Temsil, ancak niyet kümelerine koşullandırılmış \(\theta_c\) değerleri biçiminde açık bir hedef büyüklüğe dönüşür.
Güvenilirlik nasıl ele alınmalıdır?
Her niyet kümesindeki \(\theta_c\) değerinin yeniden üretilebilir biçimde tahmin edilmesi için yeterli sayıda gözlem gerekir. Gerekli tekrar sayısı bütün kümelerde aynı olmak zorunda değildir.
- Kararlı atıf örüntülerine sahip kümelerde az sayıda gözlem yeterli olabilir.
- Yüksek cevap değişkenliği gösteren kümelerde daha fazla tekrar gerekebilir.
- Hata toleransı ve güven düzeyi önceden belirlenebilir.
- Atıf örüntüsü yeterli kararlılığa ulaştığında örnekleme durdurulabilir.
Çalışma, bu yaklaşımı uyarlanabilir gözlem prosedürü olarak sunmaktadır. Belirli bir sabit tekrar sayısı veya özgün örneklem büyüklüğü formülü geliştirmemektedir.
Az sayıda sorguyla istatistiksel ölçüm yapılabilir mi?
Çok sayıda niyet kümesinin her birinde yeterli tekrar yapılması yüksek hesaplama ve sorgu maliyeti oluşturabilir. Yazar, az sayıda ucuz gözlemle daha az sayıdaki yüksek kaliteli gözlemin birlikte kullanılmasını önermektedir.
Çalışmada bu amaçla iki mevcut yöntem alanı belirtilmektedir:
- Tahmin destekli çıkarım,
- Aktif istatistiksel çıkarım.
Temel düşünce, az tekrara dayalı kaba tahminlerdeki sistematik yanlılığın, çok tekrarlı ve daha doğru sınırlı sayıdaki gözlemle düzeltilmesidir. Kalibrasyon tamamlandıktan sonra daha az gözlemle istatistiksel güvence sağlanması hedeflenebilir.
Bu yöntemler çalışma kapsamında uygulanmamış ve maliyet azaltma oranı ölçülmemiştir.
Temel gerçeklik olmadan ölçüm geçerliliği nasıl sınanabilir?
Varlık temsili doğrudan gözlenebilen fiziksel bir özellik değildir. Ayrıca belirli bir sorguda hangi varlığın mutlaka anılması gerektiğini belirleyen tek ve tartışmasız bir doğru liste bulunmayabilir. Bu nedenle klasik doğruluk ölçütü doğrudan uygulanamaz.
Çalışma, psikometri ve sosyal bilimlerde kullanılan yapı geçerliliği yaklaşımını önermektedir. Bu yaklaşım geçerliliği tek bir referans değer yerine farklı kanıt kaynaklarının birleşimiyle değerlendirir.
| Geçerlilik türü | Temel soru | Varlık temsili için örnek |
|---|---|---|
| Yakınsak geçerlilik | Aynı yapıyı farklı yöntemlerle ölçen sonuçlar birbiriyle uyumlu mu? | Farklı atıf belirleme yöntemleri veya farklı modeller, varlıkları benzer biçimde sıralıyor mu? |
| Ayırt edici geçerlilik | Ölçüm teorik olarak ilgisiz özelliklerden ayrışıyor mu? | Temsil puanı, varlığın ad uzunluğu gibi ilgisiz bir özellik tarafından açıklanıyor mu? |
| Ölçüt geçerliliği | Ölçüm ilişkili olması beklenen dış göstergelerle öngörülen yönde ilişki kuruyor mu? | Kamusal bilgilerde önemli bir güncelleme olduğunda ilgili niyet kümelerindeki temsil beklenen yönde değişiyor mu? |
Bu testler yapay zekâ temsilinin mutlak olarak doğru olduğunu göstermez. Ölçümün teorik olarak beklenen ilişkilerle uyumlu olup olmadığını değerlendirir.
İnsanlar için geliştirilen psikometri LLM’lere doğrudan aktarılabilir mi?
Çalışma bu aktarımın doğruluğunu varsaymamaktadır. İnsanlarda ölçülen bazı yapılar belirli bir süre boyunca görece kararlı kabul edilir. Büyük dil modelinin bir varlığa ilişkin temsili ise model güncellemesi, sistem istemi, arama altyapısı ve yeni bilgi kaynakları nedeniyle değişebilir.
Bu nedenle psikometrik yapı geçerliliğinin LLM temsiline uygulanması hazır ve doğrulanmış bir çözüm değil, ayrıca sınanması gereken bir araştırma önerisidir.
Kapsama neyi ölçmektedir?
Bir varlığın temsili, bütün niyet kümelerindeki \(\theta_c\) değerlerinin alanıdır. Bu nedenle yalnızca gözlenen kümelerdeki oranları hesaplamak yeterli değildir. Ölçümün temsil alanının ne kadarını kapsadığı da bilinmelidir.
Uzun bir sorgu listesi kullanmak yüksek kapsamayı garanti etmez. Yüzlerce sorgu aynı sık kullanılan niyet bölgesinde yoğunlaşabilir ve nadir ihtiyaçları tamamen kaçırabilir.
Kapsama ölçümü şu soruya cevap vermelidir:
Gözlenen atıf örüntüleri, yapay zekânın temsil alanının ne kadarını ortaya çıkarmıştır ve yeni bir gözlemin daha önce görülmemiş bir örüntü üretme ihtimali nedir?
Görülmemiş türler problemi nasıl uyarlanmaktadır?
Ekolojide gözlenen örneklerden henüz görülmemiş türlerin sayısını tahmin etme problemi bulunmaktadır. Yalnızca bir kez gözlenen kategorilerin oranı, henüz gözlenmeyen kategorilere ilişkin bilgi sağlayabilir.
Çalışma bu yaklaşımı atıf örüntülerine uyarlamayı önermektedir. Yalnızca bir kez görülen atıf örüntülerinin oranı yüksekse temsil alanının önemli bir bölümü henüz keşfedilmemiş olabilir. Yeni sorgular daha önce görülmemiş örüntü üretmeyi bıraktıkça doygunluğa yaklaşılmış kabul edilebilir.
Makale bu yöntemi gerçek atıf verileri üzerinde uygulamamış ve kapsama tahmini hesaplamamıştır.
Görünürde doygunluk ile gerçek doygunluk arasındaki fark nedir?
Yapay zekâdan sorgu üretmesi istendiğinde model, eğitim verilerinde yaygın olan ve kolay üretilen soru biçimlerine yönelebilir. Bu sık bölgede yeni atıf örüntüsü kalmadığında ölçüm doymuş gibi görünebilir.
Ancak nadir niyet bölgeleri hâlâ keşfedilmemiş olabilir. Bu durum görünürde doygunluktur. Daha geniş doygunluk iddiası için modelin nadir bölgelere yönlendirilmesi ve yeni örüntü keşfetme ihtimalinin yine düşük kalması gerekir.
Çalışma, yalnızca bir kez görülen örüntülerin oranı ile üretilen sorguların anlamsal yayılımının birlikte değerlendirilmesini önermektedir.
Sorgu çeşitliliği nasıl sayısallaştırılabilir?
Çalışmada, üretilen sorguların gömme vektörlerinden oluşturulan Gram matrisinin determinantının anlamsal yayılım ölçüsü olarak kullanılabileceği belirtilmektedir. Düşük yayılım, üretilen sorguların temsil alanının dar ve benzer bir bölümünde yoğunlaştığına işaret edebilir.
Bu yöntem, bütün insan ihtiyaçlarının kapsandığını kanıtlamaz. Yalnızca üretilen sorgu kümesinin kendi içindeki anlamsal çeşitliliği hakkında bilgi sağlar.
Tam kör noktalar neden yapay zekâ tarafından bulunamayabilir?
Modelin hiçbir istemle üretemediği veya temsil edemediği kullanıcı ihtiyaçları, modelin temsil alanının dışında kalır. Yapay zekâ kendi temsil alanının dışında bulunan bir ihtiyacı yalnızca kendi üretimiyle keşfedemeyebilir.
Bu alanların bulunması için aşağıdaki kaynaklar gerekebilir:
- Kullanıcı görüşmeleri,
- Müşteri ve destek kayıtları,
- Alan uzmanlarının deneyimi,
- Kuruluş içi bilgi,
- Yerel ve kültürel bağlam,
- Henüz modele yansımamış yeni ihtiyaçlar.
Çalışmanın çerçevesi bu eksikliği ortadan kaldırdığını ileri sürmemektedir. Eksikliğin kapsama oranıyla açık biçimde raporlanmasını önermektedir.
Temsil ile gerçeklik arasındaki fark nasıl incelenir?
Niyet kümeleri boyunca varlık temsili ölçüldükten sonra sonuçlar dış dünyadaki doğrulanabilir göstergelerle karşılaştırılabilir. Yapay zekâ bir şirketi gerçek konumundan daha fazla veya daha az öne çıkarıyor olabilir.
Çalışma iki aşamayı ayırmaktadır:
- Farkın tespiti: Temsil ölçüsü ile dış göstergeler arasındaki uyuşmazlığın belirlenmesi.
- Farkın yorumlanması: Uyuşmazlığın hata, gecikme, meşru değerlendirme veya kaynak eksikliği olup olmadığının belirlenmesi.
İlk aşama ölçüm ve istatistik kapsamında ele alınabilir. İkinci aşama bağlama bağlı insan değerlendirmesi gerektirir.
Hangi bölümler matematiksel olarak ele alınabilir?
| Ölçüm alanı | Çalışmanın önerdiği yaklaşım |
|---|---|
| Estimandın tanımlanması | Atıf oranını niyet kümelerine koşullandırmak |
| Gerekli gözlem sayısı | Değişkenlik, hata toleransı ve güven düzeyine göre uyarlanabilir örnekleme |
| Az gözlemle tahmin | Tahmin destekli ve aktif istatistiksel çıkarım |
| Geçerlilik | Yakınsak, ayırt edici ve ölçüt geçerliliği kanıtları |
| Kapsama | Görülmemiş türler yaklaşımı ve tekil atıf örüntüleri |
| Sorgu çeşitliliği | Anlamsal yayılım ve gömme uzayındaki dağılım |
Hangi bölümler insan değerlendirmesi gerektirir?
| İnsan değerlendirmesi gerektiren alan | Nedeni |
|---|---|
| Temsil–gerçeklik farkının anlamı | Her uyuşmazlık hata veya haksızlık değildir. |
| Temsile müdahale kararı | Hangi temsilin uygun olduğu bağlamsal ve normatif değerlendirme gerektirir. |
| Gizli ihtiyaçların keşfi | Model kendi temsil alanının dışındaki ihtiyaçları üretemeyebilir. |
| Önemli niyetlerin seçimi | Ekonomik, toplumsal veya kurumsal önem alan bilgisine bağlıdır. |
| Yerel ve kültürel yorum | Aynı temsil farklı dil ve toplumlarda farklı sonuçlar doğurabilir. |
GEO ve AEO ölçümleri için çıkarımı nedir?
Üretken motor optimizasyonu ve cevap motoru optimizasyonunda başarı, çoğunlukla markanın veya kaynağın yapay zekâ cevaplarında daha fazla görünmesiyle değerlendirilir. Çalışma, bu artışın hangi niyet bağlamında gerçekleştiği belirtilmeden genel başarı şeklinde yorumlanmaması gerektiğini savunmaktadır.
Bir içerik çalışması, satın alma tavsiyesi bağlamındaki görünürlüğü artırabilir; ancak teknik karşılaştırma, güvenilirlik veya yerel hizmet sorgularındaki görünürlüğü değiştirmeyebilir. Bu etkiler ayrı niyet kümelerinde ölçülmelidir.
Ayrıca daha fazla atıf almak, temsil ile gerçeklik arasındaki farkın mutlaka azaldığını göstermez. Atfın bağlama uygunluğu ve kaynağın niteliği ayrıca değerlendirilmelidir.
Çalışmanın desteklediği ve desteklemediği sonuçlar
| Çalışmanın kavramsal olarak desteklediği görüş | Çalışmanın kanıtlamadığı sonuç |
|---|---|
| Genel atıf oranı seçilen sorgu kümesine bağlıdır. | Belirli bir ticari görünürlük aracının yanlış sonuç verdiği deneysel olarak gösterilmemiştir. |
| Farklı kullanıcı niyetlerini tek ortalamada toplamak karıştırma problemi oluşturabilir. | Bütün genel görünürlük endekslerinin kullanışsız olduğu kanıtlanmamıştır. |
| Niyet koşullandırması estimandı daha açık biçimde tanımlar. | Atıf örüntülerine dayalı kümelerin gerçek insan niyetleriyle tam olarak örtüştüğü gösterilmemiştir. |
| Güvenilirlik, geçerlilik ve kapsama ayrı ölçüm özellikleridir. | Bu üç özelliği birlikte doğrulayan uygulanmış bir sistem sunulmamıştır. |
| Temel gerçekliği olmayan yapılar yapı geçerliliği yaklaşımıyla incelenebilir. | İnsan psikometrisindeki yöntemlerin LLM’lere değişiklik yapılmadan aktarılabileceği gösterilmemiştir. |
| Tekil atıf örüntüleri keşfedilmemiş alanın büyüklüğüne ilişkin bilgi sağlayabilir. | Yapay zekânın bütün kör noktalarının model sorgularıyla bulunabileceği ileri sürülmemektedir. |
| Temsil farkının ölçülmesi ile yorumlanması farklı aşamalardır. | Her temsil farkının optimizasyon yoluyla düzeltilmesi gerektiği savunulmamaktadır. |
Açık araştırma problemleri nelerdir?
- Yapının durağan olmaması: Model güncellemeleriyle değişen temsilin güvenilirliği ve geçerliliği nasıl tanımlanmalıdır?
- İki boyutlu gözlem dağılımı: Hangi niyet kümelerinin seçileceği ve her kümenin kaç kez gözleneceği birlikte nasıl optimize edilmelidir?
- Atıf kimliği: Alan adı, açık bağlantı, marka adı, dolaylı anılma ve farklı yazım biçimleri ne zaman aynı atıf sayılmalıdır?
- Manipülasyon altında geçerlilik: Kuruluşlar yapay zekâ atıflarını etkilemeye çalıştığında ölçüm geçerliliği nasıl korunmalıdır?
- Psikometrik aktarım: İnsanlar için geliştirilmiş yapı geçerliliği kuramı LLM’lere hangi değişikliklerle uygulanmalıdır?
- Kör noktalar: Modelin temsil edemediği insan ihtiyaçları sistematik olarak nasıl keşfedilmelidir?
Çalışmanın Yöntemi ve Bulguları
Araştırmanın türü
Çalışma deneysel araştırma, nicel saha çalışması, sistematik derleme veya meta-analiz değildir. Yapay zekâdaki varlık temsili ölçümünün kavramsal nesnesini tanımlayan ve mevcut istatistiksel yöntemlerin bu probleme nasıl uyarlanabileceğini tartışan teorik ve yöntemsel bir çalışmadır.
Yazarın yaklaşımı üç ana iddiaya dayanmaktadır:
- Mevcut varlık temsili ölçümlerinde estimand yeterince tanımlanmamaktadır.
- Estimand, atıf oranını kullanıcı niyeti bağlamına koşullandırarak tanımlanabilir.
- Bu tanım üzerinde güvenilirlik, geçerlilik ve kapsama matematiksel olarak ele alınabilir; sonuçların yorumlanması ise insan değerlendirmesi gerektirir.
Yöntemsel yapı
| Yöntem adımı | Çalışmadaki uygulama | Sınırı |
|---|---|---|
| LLM cevabının formelleştirilmesi | Cevap, sorguya koşullu rastlantısal süreç; atıf olasılığı \(p(X\mid q)\) olarak tanımlanmıştır. | Gerçek model cevaplarından olasılık tahmini yapılmamıştır. |
| Saf ortalamanın eleştirisi | Sorgu kümesi üzerindeki \(\theta\) ortalamasının sorgu seçimine bağımlı olduğu gösterilmiştir. | Ticari araçların gerçek sonuçları yeniden analiz edilmemiştir. |
| Estimandın yeniden tanımlanması | Atıf oranı niyet kümesine koşullandırılarak \(\theta_c\) biçiminde tanımlanmıştır. | Gerçek niyet kümeleri oluşturulmamıştır. |
| Niyet alanının operasyonel tanımı | Benzer atıf örüntülerine ulaşan sorguların benzer niyet taşıdığı önerilmiştir. | İnsan etiketleriyle karşılaştırılmamıştır. |
| Güvenilirlik önerisi | Tekrar sayısının küme içi değişkenliğe göre uyarlanması önerilmiştir. | Uygulanmış durdurma eşiği verilmemiştir. |
| Az gözlemle tahmin | Tahmin destekli ve aktif istatistiksel çıkarımın kullanılabileceği belirtilmiştir. | Maliyet veya hata kazancı ölçülmemiştir. |
| Geçerlilik | Yakınsak, ayırt edici ve ölçüt geçerliliği önerilmiştir. | LLM temsili üzerinde test edilmemiştir. |
| Kapsama | Görülmemiş türler problemi, tekil örüntüler ve anlamsal yayılım kullanılmıştır. | Gerçek kapsama oranı hesaplanmamıştır. |
| Ölçüm–yorum ayrımı | Matematiksel tespit ile bağlamsal insan kararı birbirinden ayrılmıştır. | İnsan değerlendirmesi için standart bir protokol geliştirilmemiştir. |
Çalışmanın temel kavramsal bulguları
- Tek bir genel atıf oranı, varlığın kendisine ait değişmez bir özellik değildir. Sonuç sorgu kümesine ve sorguların karışımına bağlıdır.
- Heterojen sorguları birleştirmek karıştırma yanlılığı oluşturabilir. Farklı kullanıcı niyetleri ayrı hedef büyüklükler olarak ele alınmalıdır.
- Varlık temsili niyet kümelerindeki atıf oranlarının alanı olarak tanımlanabilir.
- Niyet alanı ölçüm için ikincil değil, estimandın tanımlanması için gerekli bir bileşendir.
- Güvenilirlik geçerliliğin yerine geçmez. Çok sayıda tekrar, yanlış tanımlanmış hedefi düzeltmez.
- Temel gerçekliği bulunmayan temsil yapısı, çoklu yapı geçerliliği kanıtlarıyla değerlendirilebilir.
- Kapsama nitel bir “çeşitlilik” ifadesi yerine nicel olarak raporlanmalıdır.
- Yapay zekânın sorgu üretimi, temsil alanının nadir bölgelerini kaçırabilir.
- Temsilin ölçülmesi ile temsilin anlamlandırılması ayrı faaliyetlerdir.
Bu sonuçlar deneysel veri analizinden elde edilen bulgular değildir. Çalışmanın formel argümanlarından ve mevcut yöntemlerin kavramsal uyarlamasından çıkarılan teorik sonuçlardır.
Çalışmada veri ve deney bulunuyor mu?
Hayır. Çalışmada:
- Belirli bir büyük dil modeli deneysel olarak sorgulanmamıştır.
- Gerçek şirket, internet sitesi veya kişi ölçülmemiştir.
- Sorgu veri seti oluşturulmamıştır.
- Niyet kümeleri hesaplanmamıştır.
- Atıf algılama yöntemi uygulanmamıştır.
- Tekrar sayısı veya güven aralığı hesaplanmamıştır.
- Kapsama oranı tahmin edilmemiştir.
- İstatistiksel anlamlılık testi yapılmamıştır.
- Önerilen çerçeve başka yöntemlerle karşılaştırılmamıştır.
Formüllerin işlevi nedir?
Birinci formül, seçilen sorgu kümesindeki genel atıf oranını ve bu oranın sorgu seçimine bağımlılığını ifade etmektedir:
\[ \theta= \frac{1}{|Q|} \sum_{q\in Q}p(X\mid q) \]
İkinci formül, hedef büyüklüğü belirli bir niyet kümesine koşullandırarak hangi bağlamın ölçüldüğünü açık hâle getirmektedir:
\[ \theta_c= \mathbb{E} \left[ p(X\mid q) \mid q\in c \right] \]
Bu formüller yeni bir yapay zekâ modeli veya doğrudan uygulanabilir bir tahmin algoritması değildir. Çalışmanın ölçüm nesnesine ilişkin kavramsal ayrımını matematiksel biçimde ifade etmektedir.
Yapay zekâ kullanım beyanı
Yazar, çalışmanın hazırlanmasında Anthropic Claude adlı büyük dil modelini araştırma ve yazım yardımcısı olarak kullandığını açıklamaktadır. Beyanda kullanım alanları literatür araştırması, argümanların yapılandırılması ve metin düzenlemesi olarak belirtilmiştir.
Çalışmaya göre merkezi tez, bütün iddialar, kaynakların doğrulanması ve nihai metin yazarın sorumluluğundadır; yazar tarafından gözden geçirilmiş ve doğrulanmıştır. Bu beyan, Claude’un çalışmanın yazarı veya bağımsız bilimsel doğrulayıcısı olduğu anlamına gelmemektedir.
Başlıca sınırlılıklar
- Önerilen çerçeve gerçek büyük dil modellerinde ampirik olarak sınanmamıştır.
- Atıf örüntülerine dayalı niyet kümelerinin gerçek kullanıcı niyetlerini doğru temsil edip etmediği bilinmemektedir.
- Atıf kimliğinin nasıl belirleneceğine ilişkin uygulanmış standart bulunmamaktadır.
- Niyet kümelerinin sayısını ve sınırlarını belirleyen özgün algoritma sunulmamıştır.
- Her kümede gerekli tekrar sayısını belirleyen uygulamalı hesaplama yapılmamıştır.
- Tahmin destekli çıkarımın sorgu maliyetini ne kadar azaltacağı ölçülmemiştir.
- Psikometrik yapı geçerliliğinin LLM temsiline aktarımı doğrulanmamıştır.
- Görülmemiş türler yönteminin atıf örüntülerindeki hata özellikleri test edilmemiştir.
- Yapay zekâ tarafından oluşturulan sorguların üretim yanlılığı hesaplanmamıştır.
- Modelin üretemediği tam kör noktalar matematiksel çerçevenin dışında kalmaktadır.
- Model, sürüm, sistem istemi, dil, bölge ve arama altyapısı etkileri ayrıştırılmamıştır.
- Manipülatif içerik ve üretken motor optimizasyonu altında geçerlilik sınanmamıştır.
- Kaynaklar sistematik derleme protokolüyle seçilmemiştir.
- Çalışmanın bağımsız hakem değerlendirmesinden geçtiği doğrulanmamıştır.
Sonuç nasıl yorumlanmalıdır?
Çalışmanın sonucu “yapay zekâ görünürlüğü ölçülemez” değildir. Sonuç, görünürlüğün tek ve bağlamdan bağımsız bir varlık özelliği olarak tanımlanamayacağıdır. Ölçüm, açıkça tanımlanmış kullanıcı niyetleri ve bu niyetlere koşullandırılmış hedef büyüklükler üzerinden yürütülmelidir.
Çalışma tek bir üst düzey görünürlük puanının hiçbir koşulda kullanılamayacağını da ileri sürmemektedir. Farklı niyet kümeleri, açıkça tanımlanmış ve gerekçelendirilmiş bir dağılıma göre birleştirilebilir. Ancak böyle bir endeksin hangi kullanıcı topluluğunu, hangi sorgu alanını ve hangi iş amacını temsil ettiği açıklanmalıdır.
Makalenin temel katkısı hazır bir ölçüm ürünü sunmak değil, yapay zekâ görünürlüğü araştırmalarından önce sorulması gereken temel soruyu tanımlamaktır: Raporlanan sayı hangi estimandı, hangi kullanıcı niyetleri ve hangi temsil alanını tahmin etmektedir?
Kaynak ve Yöntem Notu
Çalışmanın tam özgün başlığı: How AI Perceives the World: Epistemic Foundations for Measuring Entity Representation without Ground Truth
Doğrudan Türkçe karşılığı: Yapay Zekâ Dünyayı Nasıl Algılıyor: Temel Gerçeklik Olmadan Varlık Temsilini Ölçmenin Epistemik Temelleri
Yazar: Shota Nagafuchi
Yazar sıralaması: Çalışma tek yazarlıdır.
Eş katkı veya eş birinci yazarlık: Bulunmamaktadır.
Sorumlu/iletişim yazarı: Shota Nagafuchi
İletişim adresi: shota_nagafuchi@tkbase.co.jp
Kurumsal bağlantı: Tech Knowledge Base, Inc. (TKBase)
SSRN kayıt numarası: 6898142
Dergi: Çalışmada hakemli bir dergi adı belirtilmemiştir.
Konferans: Çalışmada konferans yayını bilgisi belirtilmemiştir.
Yayın platformu: SSRN – Social Science Research Network
Çalışmanın tarihi: Haziran 2026
Sayfa sayısı: 12
Kaynak türü: Yapay zekâdaki varlık temsili ve görünürlük ölçümüne ilişkin kavramsal ve yöntemsel çalışma metni
Hakemlik durumu: Çalışmada veya doğrulanan bibliyografik kayıtta bağımsız hakem değerlendirmesinin tamamlandığına ilişkin bilgi bulunmamaktadır. Bu nedenle çalışma hakemli bir dergi makalesi olarak sunulmamalıdır.
Resmî çalışma bağlantısı:SSRN çalışma kayıt sayfası
Kurumsal bağlantı:Tech Knowledge Base resmî internet sitesi
Yapay zekâ kullanım beyanı: Yazar, Anthropic Claude’u literatür araştırması, argümanların yapılandırılması ve metin düzenlemesinde yardımcı araç olarak kullandığını; merkezi tez, iddialar, kaynak doğrulaması ve nihai metnin kendi sorumluluğunda olduğunu açıklamıştır.
Bu Türkçe açıklama, çalışmanın 12 sayfası; iki formül, bütün ana bölümler, açık araştırma problemleri, yapay zekâ kullanım beyanı ve kaynakça dâhil olmak üzere baştan sona incelenerek hazırlanmıştır. Çalışmada bulunmayan deneysel bulgu, veri seti, başarı oranı, istatistiksel sonuç, şirket değerlendirmesi veya ürün performansı eklenmemiştir.
Dış kaynaklar yalnızca özgün başlığın, yazarın, kurumsal bağlantının, SSRN kayıt numarasının, DOI’nin ve yayın platformunun bibliyografik doğrulaması amacıyla kullanılmıştır. Bilimsel ve yöntemsel açıklamalar yalnızca çalışmanın içeriğine dayanmaktadır.
Çalışmanın başlıca sınırı, yapay zekâ görünürlüğü ölçümünün temel bir kavramsal sorununu ayrıntılı biçimde ortaya koymasına rağmen önerdiği niyet alanı, geçerlilik ve kapsama yöntemlerini gerçek büyük dil modellerinde uygulamamış olmasıdır. Bu nedenle önerilen çerçeve doğrulanmış bir standart veya tamamlanmış ölçüm sistemi değil, ampirik olarak sınanması gereken yöntemsel bir temeldir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir