

Psikoaktif maddelerin kötüye kullanımı, hem halk sağlığı hem de adli bilimler açısından giderek daha önemli hâle gelen bir sorundur. Özellikle birden fazla ilacın veya benzer kimyasal yapıya sahip maddelerin aynı biyolojik ortamda bulunabildiği durumlarda, analiz yalnızca “madde var mı?” sorusuyla sınırlı kalmaz. Hangi maddenin bulunduğu, hangi derişim aralığında olduğu ve sinyalin gerçekten o moleküle ait olup olmadığı da güvenilir şekilde belirlenmelidir.
İdrar, madde taramalarında sık kullanılan biyolojik örneklerden biridir. Bunun nedeni örnek alımının görece kolay ve non-invaziv olmasıdır. Ancak idrar analizi kimyasal açıdan basit değildir. Proteinler, üre, tuzlar, metabolitler ve diğer endojen bileşenler hedef madde sinyallerinin üstünü örtebilir. Üstelik çalışmada vurgulandığı gibi hedef analitler ng/mL düzeyinde bulunabilir. Yani analiz edilen madde miktarı çok düşüktür ve güçlü bir sinyal artırma veya ön zenginleştirme stratejisi gerektirir.
Geleneksel yöntemler arasında GC-MS ve LC-MS/MS gibi kromatografi-kütle spektrometrisi teknikleri güçlü ve güvenilir kabul edilir. Ancak bu sistemler pahalı cihazlar, eğitimli personel, karmaşık hazırlık süreçleri ve laboratuvar altyapısı gerektirir. İmmünokromatografik testler hızlı olabilir; fakat çapraz reaksiyon, yanlış pozitiflik ve çoklu madde ayrımında sınırlılık gibi sorunlar taşıyabilir. Bu yüzden araştırmacılar, daha hızlı, düşük maliyetli ve moleküler parmak izi sağlayabilen spektroskopik yaklaşımlara yönelmektedir.
Raman spektroskopisi, moleküllerin titreşim modlarına bağlı olarak “kimyasal parmak izi” üreten bir tekniktir. Her molekül, bağ yapısına ve titreşim özelliklerine göre belirli dalga sayılarında sinyal verir. Ancak normal Raman sinyali çoğu zaman zayıftır. SERS yöntemi burada devreye girer. Gümüş veya altın gibi asil metal nanoyapılar, moleküle yakın bölgede elektromanyetik alanı güçlendirerek Raman sinyalini birkaç mertebe artırabilir. Böylece normalde çok zayıf kalacak iz düzey moleküler sinyaller ölçülebilir hâle gelir.
Bu çalışmada SERS öncesinde DLLME uygulanmıştır. DLLME’nin amacı, idrar içindeki hedef maddeleri küçük bir organik faza çekmek ve sinyal alınabilecek şekilde yoğunlaştırmaktır. Gündelik bir benzetmeyle, büyük bir bardak suyun içinde çok az miktarda çözünmüş bir madde olduğunu düşünelim. Bu maddeyi doğrudan ölçmek zor olabilir. Ancak onu küçük bir damla içine yoğunlaştırabilirseniz, ölçüm çok daha belirgin hâle gelir. DLLME bu mantığa benzer biçimde çalışır: karmaşık örnek içinde düşük düzeyde bulunan hedef molekülleri küçük hacimli bir çözücü fazında zenginleştirir.
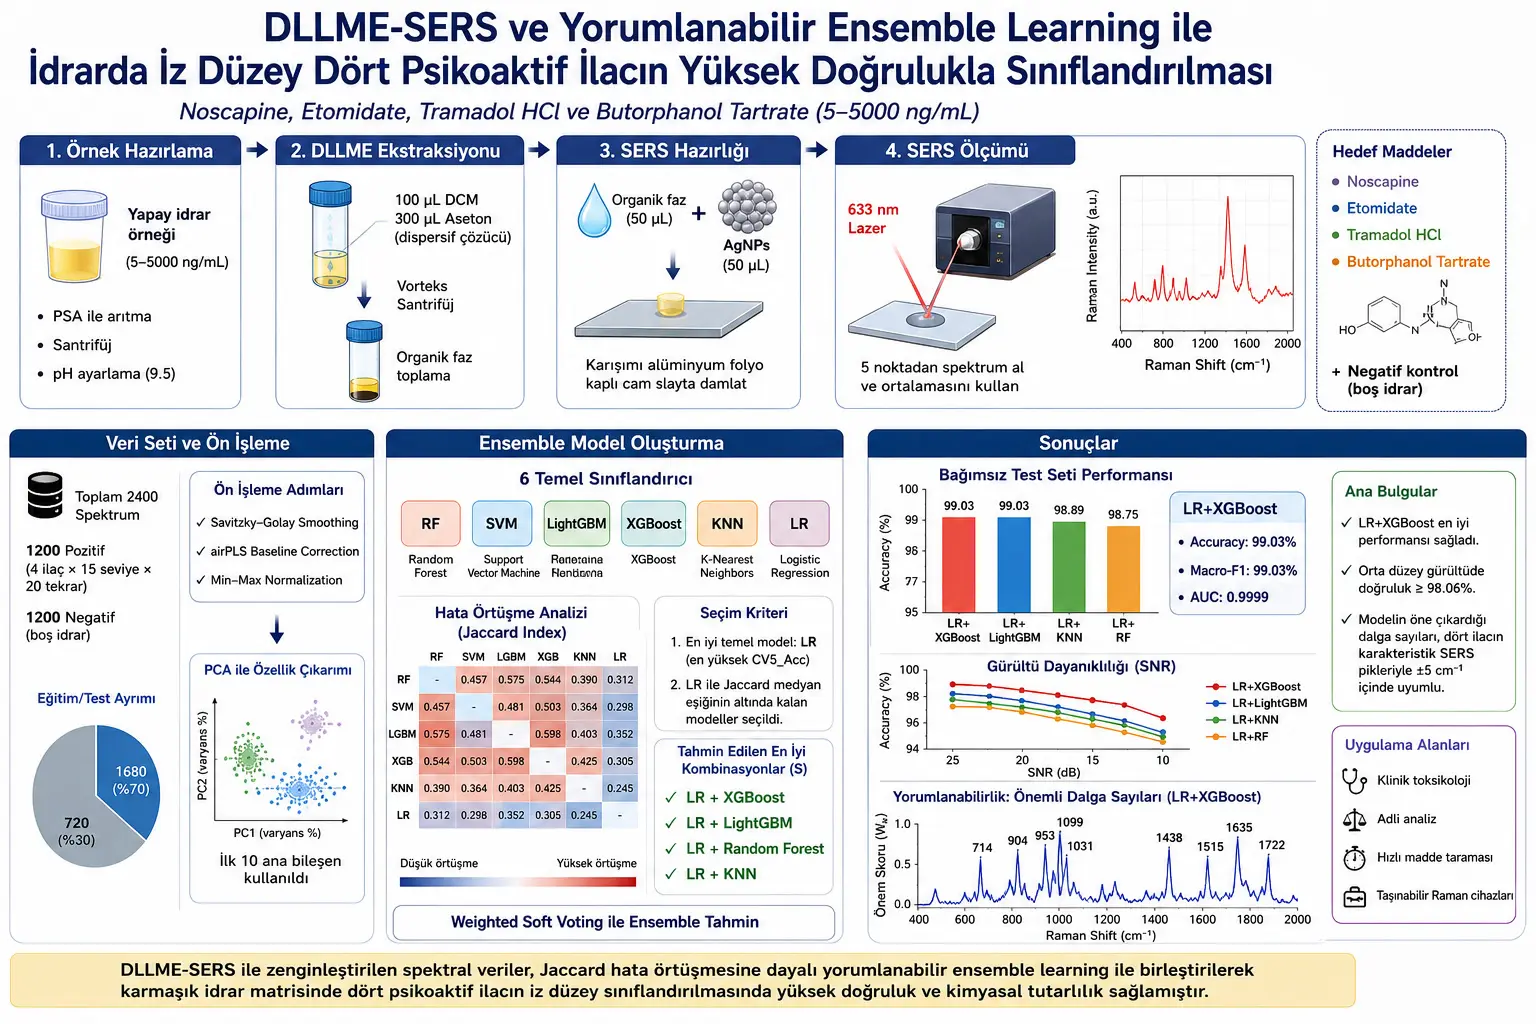
Çalışmada örnek hazırlama süreci birkaç adımdan oluşur. Önce yapay idrar örneklerine hedef ilaçlar eklenmiştir. İdrar arıtımı için 2.0 mL spiked artificial urine yani madde eklenmiş yapay idrar örneği alınmış, üzerine 100 mg PSA eklenmiş, karışım vortekslenmiş ve santrifüjlenmiştir. Daha sonra üst fazdan 1.0 mL alınarak ekstraksiyon aşamasına geçilmiştir.
DLLME aşamasında örneğin pH değeri 9.5’e ayarlanmıştır. Ardından 100 μL diklorometan ekstraksiyon çözücüsü ve 300 μL aseton dispersif çözücüsü hızlıca eklenmiştir. Karışım vortekslenerek bulanık bir emülsiyon oluşturulmuş, santrifüj sonrası alt organik faz mikrosiringa ile toplanmıştır. Bu aşama, hedef moleküllerin analiz için daha uygun bir fazda yoğunlaştırılmasını sağlar.
SERS sinyalinin güçlendirilmesi için gümüş nanoparçacıklar kullanılmıştır. AgNPs olarak kısaltılan bu parçacıklar Lee-Meisel sitrat indirgeme yöntemiyle hazırlanmıştır. Çalışmada gümüş nitrat çözeltisi kaynatılmış, trisodyum sitrat çözeltisi eklenmiş ve çözeltinin sarı-yeşil renge dönmesiyle nanoparçacık oluşumu gözlenmiştir. SEM karakterizasyonuna göre parçacıklar yaklaşık 60 nm ortalama çapa sahip yarı küresel morfoloji göstermiştir.
Spektral ölçümde laboratuvarda kurulmuş taşınabilir Raman algılama sistemi kullanılmıştır. Sistem 633 nm lazerle çalışmıştır. Organik fazdan 50 μL alınmış, eşit hacimde yoğunlaştırılmış gümüş nanoparçacık çözeltisiyle karıştırılmış, ardından 10 μL karışım alüminyum folyo kaplı temiz cam slayt üzerine damlatılmıştır. Her örnek için damla yüzeyinin farklı noktalarından beş spektrum alınmış ve bunların ortalaması o örneğin temsilî spektrumu olarak kullanılmıştır.
Veri seti oldukça düzenli biçimde oluşturulmuştur. Her hedef ilaç için 15 derişim düzeyinde 20 bağımsız hazırlanmış örnek ölçülmüştür. Bu, 4 ilaç × 15 derişim × 20 örnek hesabıyla 1200 pozitif spektrum anlamına gelir. Ayrıca aynı işlemden geçirilmiş boş yapay idrardan 1200 negatif spektrum alınmıştır. Böylece toplam 2400 spektrum elde edilmiştir. Spektral aralık 159–1996 cm⁻¹ olarak belirtilmiştir.
Ham Raman/SERS spektrumları doğrudan modele verilmemiştir. Önce Savitzky-Golay smoothing ile gürültü azaltılmış, airPLS baseline correction ile arka plan eğrisi düzeltilmiş ve Min-Max normalization ile sinyaller 0–1 aralığına ölçeklenmiştir. Bu tür ön işleme adımları spektroskopide çok önemlidir; çünkü modelin gerçek kimyasal farklar yerine cihaz gürültüsü, temel çizgi kayması veya yoğunluk ölçeği farklarını öğrenmesi istenmez.
Ardından veri seti 7:3 oranında eğitim ve bağımsız test setine ayrılmıştır. 1680 spektrum eğitim setine, 720 spektrum bağımsız test setine konulmuştur. Özellikle dikkat edilmesi gereken nokta, PCA ve StandardScaler parametrelerinin yalnızca eğitim seti üzerinde öğrenilmesi ve test setinin aynı dönüşümle projekte edilmesidir. Bu yaklaşım, bilgi sızıntısını önlemek açısından önemlidir. Eğer test setinden gelen bilgi ön işleme aşamasında modele sızarsa, test performansı olduğundan daha yüksek görünebilir.
Özellik çıkarımı için PCA, yani principal component analysis kullanılmıştır. PCA, yüksek boyutlu spektral veriyi daha az sayıda bileşene indirger. Spektrumda yüzlerce veya binlerce dalga sayısı noktası bulunabilir; ancak bunların hepsi sınıflandırma için aynı derecede bilgi taşımaz. PCA, verideki en büyük varyasyon kaynaklarını yeni eksenler hâline getirerek modele daha yönetilebilir bir özellik uzayı sağlar.
Çalışmada PCA bileşen sayısı LightGBM probe model kullanılarak değerlendirilmiştir. Şekil 3a’da gösterildiği gibi doğruluk n=8 civarında plato yapmış ve n=10’dan sonra belirgin iyileşme göstermemiştir. Bu nedenle ilk 10 ana bileşen korunmuştur. Bu, modelin ham spektrum yerine 10 boyutlu PCA özellik uzayında çalıştığı anlamına gelir.
Şekil 3b ve 3c, sınıflar arasındaki ayrışmayı PCA üç boyutlu saçılım grafiği ve t-SNE gömme yöntemiyle görselleştirir. İlk üç ana bileşene bakıldığında sınıflar arasında bazı kümelenme eğilimleri vardır; fakat sınırlar tamamen net değildir. Özellikle noscapine, etomidate ve negatif kontrol arasında örtüşme görülebilir. t-SNE gösterimi etomidate ve tramadol hydrochloride için daha kompakt kümeler gösterirken, negatif kontrolün bazı sınıf sınırlarına dağıldığını ortaya koyar. Bu, yalnızca basit doğrusal ayrımın yeterli olmadığını ve sınıflandırıcıların daha ince ayırt edici bilgileri çıkarması gerektiğini gösterir.
Çalışmanın makine öğrenmesi tarafında altı temel sınıflandırıcı değerlendirilmiştir: Random Forest, Support Vector Machine, LightGBM, XGBoost, K-Nearest Neighbors ve Logistic Regression. Bu modeller farklı algoritmik aileleri temsil eder. Logistic Regression daha doğrusal ve istatistiksel bir yaklaşım sunarken, XGBoost ve LightGBM gradyan artırmalı ağaç temelli modellerdir. SVM karar sınırı bulmaya odaklanır, KNN komşuluk ilişkisine dayanır, Random Forest ise çoklu karar ağaçlarının ortalamasını kullanır.
Bu altı modelin her biri 5 katlı çapraz doğrulama ve grid search ile optimize edilmiştir. Sonuçlara göre tüm temel modeller %97.3’ün üzerinde çapraz doğrulama doğruluğuna ulaşmıştır. Logistic Regression en iyi temel model olarak %99.29 ± 0.24 CV5_Acc değeri göstermiştir. SVM ve XGBoost onu izlemiştir. Ancak tek modellerin performansı zaten yüksek olduğu için, daha fazla iyileşme elde etmek için ensemble yaklaşımı gerekli görülmüştür.
Çalışmanın özgün tarafı burada belirginleşir. Ensemble learning, birden fazla modeli birleştirerek daha güçlü karar üretmeyi hedefler. Ancak her model birleşimi yararlı değildir. Eğer iki model aynı örneklerde hata yapıyorsa, onları birleştirmek fazla kazanç sağlamaz. Buna karşılık iki model farklı örneklerde hata yapıyorsa, biri diğerinin hatasını düzeltebilir. Çalışma bu düşünceyi Jaccard error overlap index ile sayısallaştırır.
Çalışmada Jaccard hata örtüşme indeksi şu mantıkla tanımlanmıştır:
\[ J(M_i,M_j)=\frac{|E_i \cap E_j|}{|E_i \cup E_j|} \]
Bu formülde Mi ve Mj iki farklı temel sınıflandırıcıyı temsil eder. Ei, i modelinin hatalı sınıflandırdığı örnekler kümesidir. Ej, j modelinin hatalı sınıflandırdığı örnekler kümesidir. Ei ∩ Ej, iki modelin ortak hata yaptığı örnekleri; Ei ∪ Ej, en az bir modelin hata yaptığı toplam örnek kümesini gösterir. J değeri 0 ile 1 arasında değişir. Değer düşükse iki modelin hata örüntüsü daha farklıdır; bu da ensemble içinde birbirini tamamlama potansiyelinin daha yüksek olabileceğini gösterir.
Gündelik bir örnekle anlatırsak, iki kontrol görevlisi düşünelim. Eğer ikisi de hep aynı hataları kaçırıyorsa birlikte çalışmaları fazla katkı sağlamaz. Ama biri A türü hataları, diğeri B türü hataları daha iyi yakalıyorsa birlikte daha güvenilir sonuç verirler. Jaccard hata örtüşme indeksi, modellerin “aynı hataları mı yapıyor, farklı hataları mı yapıyor?” sorusuna sayısal cevap verir.
Araştırmacılar bu indeksi kullanarak select-the-best, pair-the-best adlı iki adımlı seçim kriteri önermiştir. İlk adımda CV5_Acc değeri en yüksek olan temel model zorunlu üye olarak seçilmiştir. Bu model Logistic Regression’dır. İkinci adımda Logistic Regression ile diğer modeller arasındaki Jaccard hata örtüşmesi hesaplanmış, tüm ikili Jaccard değerlerinin medyanı eşik olarak alınmıştır. LR ile bu eşiğin altında hata örtüşmesi gösteren modeller iyi eşleşme adayı kabul edilmiştir.
Sonuçta tahmin edilen en iyi kombinasyon seti şu şekilde oluşmuştur:
\[ S=\{LR+KNN,\ LR+RF,\ LR+LightGBM,\ LR+XGBoost\} \]
Burada S, teorik olarak üstün olması beklenen ikili ensemble kombinasyonlarını ifade eder. Çalışmanın önemli noktası, bu setin yalnızca tahmine dayalı bırakılmamasıdır. Araştırmacılar altı modelden oluşabilecek tüm 15 ikili kombinasyonu exhaustive comparison yani kapsamlı karşılaştırma ile test etmiştir.
Kapsamlı karşılaştırma sonucunda CV5_Acc sıralamasında ilk dört kombinasyon gerçekten de LR+XGBoost, LR+LightGBM, LR+RF ve LR+KNN olmuştur. Bu sonuç, Jaccard hata örtüşmesiyle yönlendirilen “select-the-best, pair-the-best” kriterinin tahmin gücünü destekler. Özellikle LR+XGBoost kombinasyonu %99.40 ± 0.42 CV5_Acc değeriyle en üstte yer almıştır. LR+LightGBM %99.35 ± 0.39, LR+RF ve LR+KNN ise %99.29 ± 0.24 değerlerine ulaşmıştır.
Bağımsız test setindeki sonuçlar da bu çerçeveyi destekler. Set S içindeki dört kombinasyonun doğruluk değerleri %98.75 ile %99.03 arasında değişmiştir. LR+XGBoost ve LR+LightGBM en iyi genel performansı göstermiş, her ikisi de %99.03 Accuracy ve %99.03 Macro-F1 değerine ulaşmıştır. Kontrol kombinasyonlarından LightGBM+XGBoost yalnızca %97.92 doğruluk sağlamıştır. Bu, aynı algoritmik aileye yakın ve yüksek hata örtüşmesine sahip modellerin birleştirilmesinin her zaman iyi sonuç vermediğini gösterir.
Çalışmadaki sınıf bazlı değerlendirme, modelin hangi maddelerde daha zorlandığını da ortaya koyar. Negatif kontrol, noscapine ve butorphanol tartrate daha yüksek recall değerleri gösterirken, etomidate ve tramadol hydrochloride daha düşük recall eğilimi göstermiştir. Bunun kimyasal nedeni, iki maddenin benzen halkası solunum titreşimlerinin yaklaşık 1000 cm⁻¹ civarında ciddi biçimde örtüşmesidir. Yani modelin zorlandığı yer, rastgele bir hata değil, kimyasal spektrumların gerçekten birbirine yaklaştığı bölgedir.
Çalışmada gürültü dayanıklılığı ayrıca test edilmiştir. Test setine 25, 20, 15 ve 10 dB SNR düzeylerinde Gauss beyaz gürültüsü eklenmiştir. Orta düzey gürültüde, özellikle 15 dB SNR koşulunda, S setindeki dört kombinasyonun doğruluğu %98.06’nın üzerinde kalmıştır. Şiddetli gürültü koşulu olan 10 dB’de bile bu kombinasyonların doğruluğu %96.53 düzeyinde kalmıştır. Bu bulgu, seçilen modellerin yalnızca temiz spektrumlarda değil, sinyal bozulduğunda da görece kararlı kaldığını gösterir.
Ancak bu sonuçları okurken dikkatli olmak gerekir. Gürültü dayanıklılığı, gerçek klinik örneklerdeki tüm karmaşıklığı temsil etmez. Gerçek idrar örnekleri bireyler arası metabolik farklılıklar, ilaç metabolitleri, farklı pH, eşlik eden maddeler, böbrek fonksiyonu, beslenme, hastalık, kontaminasyon ve örnek saklama koşulları gibi çok sayıda değişkene sahiptir. Çalışma yapay idrar üzerinde yürütüldüğü için gerçek klinik/adli doğrulama sonraki aşama olarak gereklidir.
Çalışmanın bir diğer güçlü tarafı yorumlanabilirlik zinciridir. Makine öğrenmesi modelleri yüksek doğruluk verse bile, kimyasal analizde “model neden böyle karar verdi?” sorusu çok önemlidir. Eğer modelin kararı gerçek moleküler piklere değil de veri işleme artefaktlarına veya tesadüfi gürültüye dayanıyorsa, yüksek doğruluk güvenilir kimyasal kanıt anlamına gelmeyebilir. Bu nedenle araştırmacılar permutation importance değerlerini PCA yükleri üzerinden orijinal dalga sayısı uzayına geri projekte etmiştir.
Bu yorumlanabilirlik için kullanılan ilişki çalışmada şu şekilde verilmiştir:
\[ W_k=\sum_{i=1}^{n} PI_i \times |L_{ik}| \]
Bu formülde Wk, k’ıncı dalga sayısı noktasına ait toplam önem skorunu gösterir. PIi, i’inci ana bileşenin permutation importance değeridir. Lik, k’ıncı dalga sayısının i’inci ana bileşendeki yük katsayısıdır. n, korunan ana bileşen sayısıdır. Çalışmada n=10 olarak belirlenmiştir. Formülün amacı, modelin PCA uzayında verdiği karar katkısını yeniden orijinal Raman dalga sayısı eksenine taşımaktır.
Bunu şöyle düşünebiliriz: Model ham spektrumu doğrudan değil, PCA bileşenlerini kullanarak öğrenmiştir. Ancak kimyasal yorum ham dalga sayılarında yapılır. Bu nedenle “model için hangi PCA bileşeni önemliydi?” sorusunu “bu önem hangi Raman dalga sayılarına karşılık geliyor?” sorusuna çevirmek gerekir. Back-projection yani geri projeksiyon bunu sağlar.
Yorumlanabilirlik analizinde öne çıkan dalga sayıları dört ilacın karakteristik SERS pikleriyle büyük ölçüde uyumludur. Noscapine için 904 cm⁻¹ ve 1635 cm⁻¹, etomidate için 952/953 cm⁻¹, 1030/1031 cm⁻¹ ve 1726/1722 cm⁻¹, tramadol hydrochloride için 715/714 cm⁻¹ ve 1000/999 cm⁻¹, butorphanol tartrate için 1437/1438 cm⁻¹ ve 1515 cm⁻¹ bölgeleri belirleyici olarak görülmüştür. Çalışmada bu sapmaların 5 cm⁻¹ içinde kaldığı belirtilir.
Bu durum bilimsel açıdan önemlidir. Çünkü model yalnızca istatistiksel bir sınıflandırıcı gibi davranmamış; kararlarında gerçek kimyasal titreşim modlarına karşılık gelen bölgeleri kullanmıştır. Örneğin noscapine’in lakton halka C-O-C gerilmesi 904 cm⁻¹ civarında modelin en önemli piki olarak bulunmuştur. Butorphanol tartrate için 1438 cm⁻¹ bölgesi aromatik C=C gerilmesiyle ilişkilendirilmiştir. Tramadol ve etomidate için 1000 cm⁻¹ civarındaki örtüşme, bu iki sınıfın daha zor ayrılmasının kimyasal karşılığını açıklar.
Çalışmanın grafiksel özeti ve Şekil 1, yöntemin genel akışını görsel olarak anlatır. İlk bölümde idrar örneği, DLLME ile ekstraksiyon, AgNPs ile SERS sinyal alımı ve spektral ölçüm gösterilir. Orta bölümde RF, SVM, LightGBM, XGBoost, KNN ve LR modellerinin seçilmesi, Jaccard hata örtüşme matrisi ve LR merkezli kombinasyonların kurulması yer alır. Son bölümde ensemble model değerlendirmesi, gürültü dayanıklılığı ve dalga sayısı önem grafikleri gösterilir. Bu görsel, çalışmanın laboratuvar kimyası ile yapay zekâ model seçimini tek bir süreç olarak kurguladığını açıkça ortaya koyar.
Şekil 2, dört ilacın farklı derişimlerdeki DLLME-SERS spektrumlarını gösterir. Spektrumlarda derişim arttıkça karakteristik pik yoğunluklarının arttığı, pik konumlarının ise sabit kaldığı belirtilir. Bu, yöntemin derişim değişimine duyarlı sinyal ürettiğini fakat moleküler parmak izi konumlarını koruduğunu gösterir. Aynı zamanda etomidate ve tramadol hydrochloride için 1000 cm⁻¹ civarında pik örtüşmesi olduğu için çıplak gözle ayırmanın zorlaşabileceği anlaşılır.
Şekil 4, model seçiminin neden yalnızca “en yüksek doğruluğa sahip iki modeli birleştir” mantığıyla yapılamayacağını gösterir. Temel modellerin tekil performansları yüksektir; ancak hata örtüşme matrisi, bazı modellerin benzer hatalar yaptığını ortaya koyar. Özellikle ağaç temelli modeller arasında hata örtüşmesinin yüksek olması, onları birleştirmenin sınırlı ensemble kazancı sağlayabileceğini gösterir. Buna karşılık LR ile KNN, RF, LightGBM ve XGBoost arasındaki daha düşük Jaccard değerleri tamamlayıcılık potansiyelini gösterir.
Şekil 5, bağımsız test seti performansını, sınıf bazlı metrikleri, gürültü dayanıklılığını ve yorumlanabilir dalga sayısı önem dağılımını birlikte sunar. Bu şeklin en önemli mesajı, modelin yalnızca yüksek doğruluk vermediği; aynı zamanda gürültü altında kararlı kaldığı ve kararlarını kimyasal olarak anlamlı dalga sayısı bölgelerine dayandırdığıdır.
Çalışmanın geçmiş açısından önemi, SERS-ML literatüründeki iki eksikliği hedeflemesidir. Birincisi, ensemble model üyelerinin çoğu zaman nicel gerekçe olmadan seçilmesidir. İkincisi, model kararlarının hangi Raman kaymalarına dayandığının kimyasal olarak izlenememesidir. Bu çalışma, hem model seçimini hata tamamlayıcılığıyla gerekçelendirmeye hem de model kararını kimyasal piklerle ilişkilendirmeye çalışır.
Bugün açısından çalışma, hızlı tarama ihtiyacına yanıt verir. Klinik toksikoloji, adli laboratuvarlar ve madde kötüye kullanımı izleme alanlarında yüksek duyarlılığa sahip, hızlı ve taşınabilir sistemlere ihtiyaç vardır. DLLME-SERS gibi spektroskopik yaklaşımlar, kütle spektrometrisi kadar nihai doğrulama gücü vaat etmese de, hızlı ön tarama veya sahaya yakın analiz için değerli olabilir.
Gelecek açısından çalışma, yorumlanabilir kimyasal yapay zekâ modellerinin önemini gösterir. Analitik kimyada yapay zekânın yalnızca “doğru tahmin yapan kara kutu” olması yeterli değildir. Özellikle adli ve klinik bağlamlarda modelin neden karar verdiği, hangi kimyasal pike dayandığı ve bu kararın gerçek moleküler titreşimlerle uyumlu olup olmadığı açıklanmalıdır. Bu çalışma, PCA yükleriyle geri projeksiyon ve permutation importance birleşimini bu amaç için kullanmaktadır.
Çalışmanın güçlü yönleri arasında düzenli veri seti kurulumu, bağımsız test seti kullanımı, bilgi sızıntısını önlemeye yönelik eğitim/test ayrımı, tüm 15 ikili kombinasyonun karşılaştırılması, gürültü dayanıklılığı testi ve kimyasal yorumlanabilirlik analizi yer alır. Ayrıca modelin karar dalga sayılarının karakteristik SERS pikleriyle uyumlu gösterilmesi, sonuçların kimyasal açıdan daha anlamlı yorumlanmasını sağlar.
Buna karşılık sınırlılıklar da net biçimde belirtilmelidir. Çalışma hakem değerlendirmesinden geçmemiş bir preprinttir. Örnekler gerçek klinik idrar değil, yapay idrardır. Dört ilaçla sınırlıdır. Jaccard tabanlı seçim kriteri altı aday sınıflandırıcı üzerinde test edilmiştir; daha büyük model havuzlarında aynı şekilde çalışıp çalışmayacağı araştırılmalıdır. Ayrıca gerçek adli örneklerde karışımlar, metabolitler, bozunma ürünleri, farklı bireylerin idrar kompozisyonları ve çoklu madde varlığı daha karmaşık olabilir.
Çalışmanın söylediği şey şudur: DLLME-SERS ile elde edilen iz düzey spektral veriler, doğru ön işleme, PCA tabanlı özellik çıkarımı, Jaccard hata tamamlayıcılığına göre seçilen ensemble modeller ve kimyasal yorumlanabilirlik zinciriyle yüksek doğrulukta sınıflandırılabilir. Çalışmanın söylemediği şey ise şudur: Bu yöntem bugünden itibaren gerçek klinik/adli idrar örneklerinde kesin tanı veya hukuki kanıt olarak kullanılmaya hazırdır. Bunun için otantik örneklerle, daha geniş ilaç panelleriyle, karışım senaryolarıyla ve bağımsız laboratuvar doğrulamalarıyla ek çalışmalar gerekir.
Çalışmanın Yöntemi ve Bulguları
Çalışma, yapay idrar matrisinde dört psikoaktif ilacın iz düzey sınıflandırılması için laboratuvar analizi ile makine öğrenmesini birleştiren deneysel ve hesaplamalı bir araştırma tasarımına sahiptir.
Hedef maddeler:
| Madde | Çalışmadaki Rolü | Öne Çıkan SERS Pik Bölgeleri |
| Noscapine | Dört hedef psikoaktif ilaçtan biri. | 904 cm⁻¹ ve 1635 cm⁻¹. |
| Etomidate | Benzen halkası titreşimleriyle ayırt edilmeye çalışılan hedef madde. | 952, 1004, 1030 ve 1726 cm⁻¹. |
| Tramadol hydrochloride | 1000 cm⁻¹ civarında etomidate ile pik örtüşmesi gösteren hedef madde. | 715 ve 1000 cm⁻¹. |
| Butorphanol tartrate | Aromatik C=C gerilme bölgeleriyle ayırt edilen hedef madde. | 1437 ve 1515 cm⁻¹. |
Örnek hazırlama ve SERS ölçümü:
- Yapay idrar örnekleri hedef maddelerle spike edilmiştir.
- İdrar arıtımı için 2.0 mL örneğe 100 mg PSA eklenmiş, vorteksleme ve santrifüj yapılmıştır.
- DLLME için pH 9.5’e ayarlanmış, 100 μL diklorometan ve 300 μL aseton kullanılmıştır.
- Gümüş nanoparçacıklar Lee-Meisel sitrat indirgeme yöntemiyle hazırlanmıştır.
- AgNP’lerin yaklaşık 60 nm ortalama çapta yarı küresel yapıda olduğu belirtilmiştir.
- SERS ölçümleri 633 nm lazerli taşınabilir Raman sistemiyle yapılmıştır.
- Her örnek için beş farklı noktadan spektrum alınmış ve ortalama spektrum kullanılmıştır.
Veri seti:
| Veri Unsuru | Değer | Anlamı |
| Hedef ilaç sayısı | 4 | Noscapine, etomidate, tramadol hydrochloride, butorphanol tartrate. |
| Derişim aralığı | 5–5000 ng/mL | İz düzeyden daha yüksek aralığa uzanan sınıflandırma aralığı. |
| Derişim seviyesi | 15 | Her ilaç için farklı derişim noktaları kullanılmıştır. |
| Her derişimde bağımsız örnek | 20 | Her hedef ilaç için 15 × 20 örnek hazırlanmıştır. |
| Pozitif spektrum | 1200 | 4 × 15 × 20 hesabıyla elde edilmiştir. |
| Negatif spektrum | 1200 | Boş yapay idrar örneklerinden alınmıştır. |
| Toplam spektrum | 2400 | Modelleme için kullanılan toplam veri. |
| Eğitim/test ayrımı | 1680 / 720 | 7:3 oranında bölünmüştür. |
| Spektral aralık | 159–1996 cm⁻¹ | SERS ölçüm dalga sayısı aralığı. |
Ön işleme adımları:
- Savitzky-Golay smoothing: pencere boyutu 11, polinom derecesi 3.
- airPLS baseline correction: λ = 10⁵, maksimum iterasyon 100, yakınsama toleransı 10⁻⁶.
- Min-Max normalization: sinyaller 0–1 aralığına ölçeklenmiştir.
- PCA ile özellik çıkarımı yapılmıştır.
- İlk 10 ana bileşen modelleme için korunmuştur.
- Bilgi sızıntısını önlemek için PCA ve StandardScaler yalnızca eğitim setinde fit edilmiştir.
Kullanılan temel sınıflandırıcılar:
| Model | Kısaltma | Çalışmadaki Rolü |
| Random Forest | RF | Ağaç tabanlı ensemble temel model. |
| Support Vector Machine | SVM | Karar sınırı odaklı sınıflandırıcı. |
| LightGBM | LGBM | Gradyan artırmalı ağaç modeli. |
| XGBoost | XGB | Güçlü gradyan artırmalı ağaç modeli. |
| K-Nearest Neighbors | KNN | Komşuluk ilişkisine dayalı sınıflandırıcı. |
| Logistic Regression | LR | En yüksek temel CV5_Acc değerini veren zorunlu ensemble üyesi. |
Jaccard hata örtüşme formülü:
\[ J(M_i,M_j)=\frac{|E_i \cap E_j|}{|E_i \cup E_j|} \]
Bu formülde Ei ve Ej, iki farklı modelin yanlış sınıflandırdığı örnek kümeleridir. J değeri düşükse modellerin hata örüntüleri daha farklıdır ve ensemble içinde birbirini tamamlama olasılığı daha yüksektir.
Model seçim kriteri:
- Select-the-best: CV5_Acc değeri en yüksek temel model seçilir. Bu çalışmada LR seçilmiştir.
- Pair-the-best: LR ile diğer modeller arasındaki Jaccard hata örtüşmeleri hesaplanır.
- Tüm 15 ikili Jaccard değerinin medyanı eşik olarak alınmıştır.
- LR ile eşiğin altında hata örtüşmesi gösteren modeller iyi eşleşme adayı kabul edilmiştir.
Tahmin edilen en iyi ensemble seti:
\[ S=\{LR+KNN,\ LR+RF,\ LR+LightGBM,\ LR+XGBoost\} \]
Temel model ve ensemble bulguları:
| Bulgular | Sayısal Sonuç | Yorum |
| Tüm temel modellerin CV5_Acc değeri | En az %97.3 | 10 boyutlu PCA özellik uzayı güçlü sınıflandırma bilgisi taşımaktadır. |
| En iyi temel model | LR, %99.29 ± 0.24 CV5_Acc | En yüksek bireysel performans gösterdiği için zorunlu ensemble üyesi yapılmıştır. |
| Jaccard aralığı | 0.245–0.575 | Modellerin hata örtüşmesi önemli ölçüde farklılaşmıştır. |
| Medyan Jaccard eşiği | 0.361 | LR ile bu eşiğin altında kalan modeller seçilmiştir. |
| LR+XGBoost CV5_Acc | %99.40 ± 0.42 | Kapsamlı karşılaştırmada en üst kombinasyon olmuştur. |
| LR+LightGBM CV5_Acc | %99.35 ± 0.39 | İkinci en güçlü kombinasyonlardan biridir. |
| LR+RF ve LR+KNN CV5_Acc | %99.29 ± 0.24 | Tahmin edilen iyi kombinasyon setiyle uyumludur. |
Bağımsız test seti sonuçları:
| Model / Kombinasyon | Sonuç | Yorum |
| LR+XGBoost | %99.03 Accuracy, %99.03 Macro-F1, AUC 0.9999 | En iyi genel performans gösteren kombinasyonlardan biri. |
| LR+LightGBM | %99.03 Accuracy ve Macro-F1 | LR+XGBoost ile aynı test doğruluğuna ulaşmıştır. |
| LR+KNN | %98.89 Accuracy | Tahmin edilen iyi set içinde yer alır. |
| LR+RF | %98.75 Accuracy | Tahmin edilen iyi set içinde yer alır. |
| SVM+LR | %98.72 Accuracy | Performansı yakın olsa da hata örtüşmesi yüksektir. |
| LightGBM+XGBoost | %97.92 Accuracy | Aynı aileye yakın modellerin yüksek hata örtüşmesi ensemble kazancını sınırlamıştır. |
Gürültü dayanıklılığı:
- Test setine 25, 20, 15 ve 10 dB SNR düzeylerinde Gauss beyaz gürültüsü eklenmiştir.
- 15 dB gibi orta düzey gürültü koşulunda S setindeki dört kombinasyon %98.06’nın üzerinde doğruluk göstermiştir.
- 10 dB gibi daha şiddetli gürültü koşulunda doğruluk %96.53 düzeyinde kalmıştır.
- LR+LightGBM 25 dB SNR’de %99.17 doğruluk göstermiştir; bu farkın 720 örnekten yalnızca bir örneğe karşılık gelen küçük bir dalgalanma olduğu belirtilmiştir.
- S setindeki kombinasyonlar, homojen hata örüntüsüne sahip LightGBM+XGBoost kontrolünden daha dayanıklı görünmüştür.
Kimyasal yorumlanabilirlik formülü:
\[ W_k=\sum_{i=1}^{n} PI_i \times |L_{ik}| \]
Bu formülde Wk, k’ıncı dalga sayısı noktasının toplam önem skorunu; PIi, i’inci ana bileşenin permutation importance değerini; Lik, k’ıncı dalga sayısının i’inci PCA bileşenindeki yükünü; n ise kullanılan ana bileşen sayısını gösterir. Bu geri projeksiyon, model kararının hangi Raman dalga sayısı bölgelerine dayandığını açıklamak için kullanılmıştır.
Modelin öne çıkardığı kimyasal dalga sayıları:
| Dalga Sayısı | İlişkilendirilen Kaynak | Kimyasal Anlam |
| 904 cm⁻¹ | Noscapine | Lakton halka C-O-C gerilmesi. |
| 1438 cm⁻¹ | Butorphanol tartrate | Aromatik C=C gerilme bölgesi. |
| 1635 cm⁻¹ | Noscapine | Aromatik C=C gerilmesi. |
| 953 cm⁻¹ | Etomidate | Benzen halkası dış düzlem deformasyonu. |
| 999 cm⁻¹ | Tramadol / Etomidate | Örtüşen benzen halkası solunum modu. |
| 714 cm⁻¹ | Tramadol hydrochloride | Benzen halkasıyla ilişkili titreşim. |
| 1031 cm⁻¹ | Etomidate | Benzen/imidazol halka titreşimi. |
| 1515 cm⁻¹ | Butorphanol tartrate | Aromatik C=C gerilmesi. |
| 1722 cm⁻¹ | Etomidate | Karbonil C=O gerilmesi. |
| 449 ve 1397 cm⁻¹ | Substrat / matris | AgNP/sitrat veya idrar matrisiyle ilişkili arka plan değişimleri. |
Çalışmanın ana bulguları:
- DLLME-SERS, yapay idrarda dört psikoaktif ilacın 5–5000 ng/mL aralığında iz düzey sınıflandırılması için kullanılabilir spektral veri üretmiştir.
- Derişim arttıkça karakteristik pik yoğunlukları artmış, pik konumları kararlı kalmıştır.
- Etomidate ve tramadol hydrochloride’ın yaklaşık 1000 cm⁻¹ civarındaki pik örtüşmesi görsel ayrımı zorlaştırmıştır.
- İlk 10 PCA bileşeni sınıflandırma için yeterli özellik uzayı olarak seçilmiştir.
- Jaccard hata örtüşme indeksi, ensemble üyelerinin hata tamamlayıcılığını nicel olarak değerlendirmiştir.
- “Select-the-best, pair-the-best” kriteri, 15 ikili kombinasyon içinden en iyi dört kombinasyonu doğru tahmin etmiştir.
- LR+XGBoost ve LR+LightGBM bağımsız test setinde %99.03 doğruluk ve Macro-F1 değerlerine ulaşmıştır.
- LR+XGBoost, genel performans ve dayanıklılık dengesi nedeniyle kimyasal yorumlanabilirlik analizi için temsilî model seçilmiştir.
- Modelin ayırt edici dalga sayıları, dört ilacın karakteristik SERS pikleriyle 5 cm⁻¹ içinde uyum göstermiştir.
Çalışmanın sınırlılıkları:
- Çalışma hakem değerlendirmesinden geçmemiş bir preprinttir.
- Örnekler gerçek klinik/adli idrar değil, yapay idrardır.
- Yalnızca dört hedef madde değerlendirilmiştir.
- Jaccard tabanlı seçim kriteri altı aday sınıflandırıcı ile test edilmiştir; daha büyük model havuzları için ek çalışma gerekir.
- Gerçek örneklerde metabolitler, karışımlar, farklı idrar bileşimleri ve çoklu madde varlığı yöntemin performansını değiştirebilir.
- Çalışma hızlı tarama için yöntemsel referans sunsa da, doğrudan klinik/adli kesin doğrulama iddiası taşımaz.
Kaynak ve Yöntem Notu
Bu makale, Ruzhen Xiang, Shijie Zheng, Nan Yin, Haixia Zhao, Liwei Hou, Qinhong Wang ve Li Chen tarafından hazırlanan “Interpretable Ensemble Learning Combined with DLLME-SERS for High-Accuracy Classification and Identification of Four Trace Psychoactive Drugs in Urine” başlıklı çalışmaya dayanarak hazırlanmıştır.
Çalışma, metin üzerinde açıkça belirtildiği üzere preprint araştırma makalesidir ve hakem değerlendirmesinden geçmemiştir. Bu nedenle sonuçlar, hakemli dergide yayımlanmış ve bağımsız doğrulamalardan geçmiş nihai klinik/adli yöntem gibi değil, ileri doğrulama gerektiren bir araştırma önerisi ve deneysel-yöntemsel katkı olarak okunmalıdır.
Çalışma laboratuvar ortamında yapay idrar örnekleriyle yürütülmüştür. Kullanılan yöntem; DLLME ile örnek zenginleştirme, AgNP destekli SERS ölçümü, spektral ön işleme, PCA tabanlı özellik çıkarımı, altı temel sınıflandırıcının eğitimi, Jaccard hata örtüşmesine göre ensemble üye seçimi, weighted soft voting, bağımsız test seti değerlendirmesi, gürültü dayanıklılığı testi ve permutation importance-PCA loading geri projeksiyonu ile kimyasal yorumlanabilirlik analizinden oluşmaktadır.
Bu içerikte PDF’de olmayan klinik başarı, adli geçerlilik, sahada kesin kullanım, gerçek hasta örneklerinde garanti edilmiş performans veya düzenleyici onay iddiası eklenmemiştir. Çalışmadaki %99.03 doğruluk, 0.9999 AUC, %98.06 üzerinde orta düzey gürültü doğruluğu ve 5 cm⁻¹ içinde pik uyumu gibi değerler, yalnızca çalışmada kullanılan yapay idrar veri seti ve deneysel koşullar bağlamında aktarılmıştır.
Çalışmanın en önemli bilimsel katkısı, SERS-ML alanında yüksek doğruluğu kimyasal yorumlanabilirlikle birleştirmeye çalışmasıdır. Model seçiminde hata tamamlayıcılığı kullanılması ve model kararlarının orijinal Raman dalga sayısı uzayına geri projekte edilmesi, sonuçların yalnızca istatistiksel performansla değil, kimyasal parmak iziyle de desteklenmesini amaçlamaktadır.
Gelecekte yöntemin gerçek klinik/adli idrar örnekleriyle, daha geniş madde panelleriyle, karışım senaryolarıyla, farklı cihazlarla ve bağımsız laboratuvarlarda test edilmesi gerekir. Bu doğrulamalar yapılmadan çalışma, kesin tanısal veya hukuki karar aracı olarak değil, hızlı tarama ve yorumlanabilir spektroskopik yapay zekâ araştırması için güçlü bir metodolojik adım olarak değerlendirilmelidir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir