

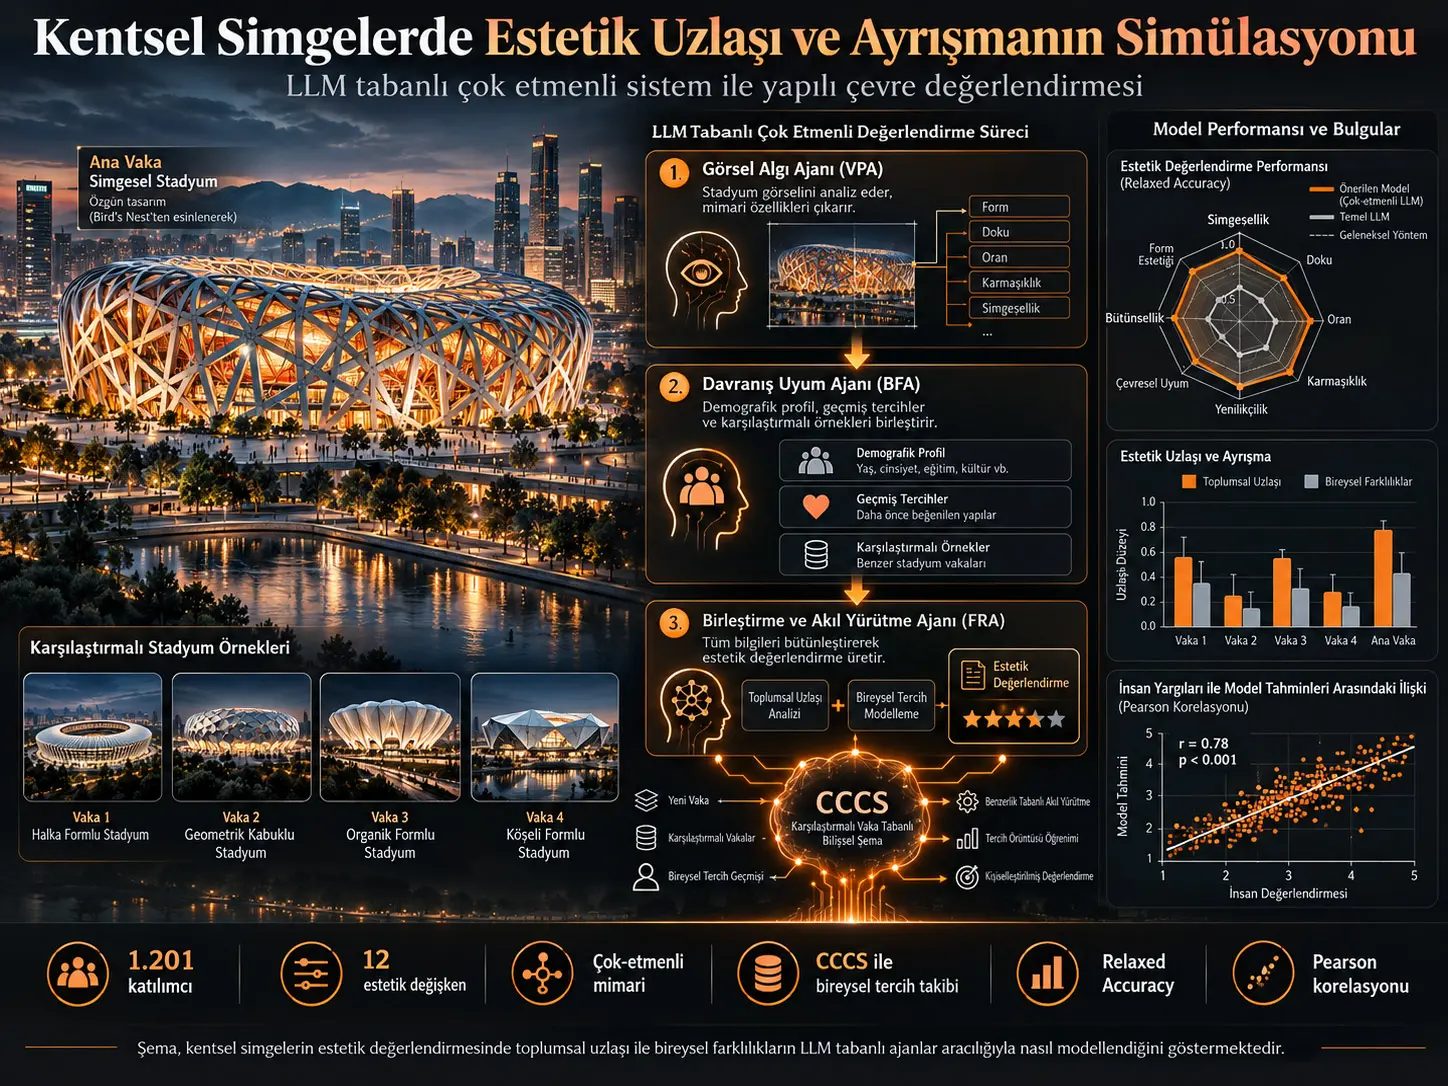
Bir yapının insanlar tarafından güzel, etkileyici, karmaşık veya çevresiyle uyumlu bulunması yalnız yapının fiziksel özelliklerinden doğmaz. Değerlendirme; gözlemcinin geçmiş deneyimleri, mesleği, mimarlık bilgisi, kişisel tercihleri ve daha önce gördüğü yapılarla karşılaştırmaları tarafından da şekillenir. Bu çalışma, kentsel simge yapıların estetik değerlendirilmesini Büyük Dil Modelleri (Large Language Models; LLM) kullanan çok-etmenli bir sistemle hesaplamaya çalışmaktadır.
Vaka olarak Pekin Ulusal Stadyumu, yaygın adıyla Bird's Nest kullanılmıştır. Sistem üç uzmanlaşmış yapay zekâ etmeninden oluşmaktadır. Visual Perception Agent (VPA) yapının fiziksel özelliklerini görüntülerden nesnel metinsel tanımlara dönüştürür. Behavioral Fitting Agent (BFA) kullanıcının demografik özelliklerini ve geçmiş tercihlerini kullanarak bir davranış profili oluşturur. Fusion & Reasoning Agent (FRA) ise görsel gerçeklerle kullanıcı profilini birleştirerek estetik puanları tahmin eder.
Çalışmanın temel geliştirmesi olan Comparative Case-based Cognitive Schema (CCCS), bireyin dört başka stadyum hakkındaki gerçek değerlendirmelerini bilişsel referans olarak kullanır. CCCS olmadan modeller esas olarak toplumun ortalama estetik eğilimine yaklaşırken bireysel farklılıkları zayıf biçimde izlemektedir. Karşılaştırmalı tercih geçmişi eklendiğinde modellerin bireysel varyasyonu takip eden Pearson korelasyonları belirgin biçimde yükselmektedir.
Geliştirilmiş sistemde en yüksek genel relaxed accuracy değeri %82,07 ve MAE 0,887 olarak raporlanmıştır. Ancak relaxed accuracy, 1–5 puanlık Likert ölçeğinde tahminin gerçek kullanıcı puanından ±1 puan uzaklık içinde kalmasını doğru kabul etmektedir. Bu nedenle söz konusu oran birebir sınıf doğruluğu olarak yorumlanmamalıdır.
Kentsel estetik neden yalnız yapının kendisiyle açıklanamaz?
Mimarlar ve kent plancıları bir yapıyı biçim, oran, taşıyıcı sistem, cephe kompozisyonu veya çevresel ilişki üzerinden değerlendirebilir. Genel kullanıcı ise aynı yapıya çok daha sezgisel biçimde yaklaşabilir: “hoş”, “soğuk”, “etkileyici”, “karmaşık”, “yabancı” veya “çevreyle uyumlu” gibi duygusal ve bilişsel tepkiler verebilir.
Çalışma bu farkı tasarımcılarla kullanıcılar arasındaki bir bilişsel boşluk olarak ele almaktadır. Geleneksel Post-Occupancy Evaluation (POE; kullanım sonrası değerlendirme) anketleri bu boşluğu ölçebilir; ancak büyük örneklem toplamak zaman ve maliyet gerektirir ve tasarım tamamlandıktan sonra yapılmaları nedeniyle sonuçlar çoğunlukla geriye dönük kalır.
Araştırmacıların amacı bu insan geri bildirimini ortadan kaldırmak değil, sınırlı gerçek insan verisini LLM tabanlı simülasyonlarla genişleterek tasarım aşamasında daha erken kullanılabilecek bir değerlendirme sistemi oluşturmaktır.
Estetik Değerlendirme Hangi 12 Boyutta Yapılıyor?
Çalışma, estetik tepkiyi yedi biçimsel, üç soyut ve iki duygusal değişkenden oluşan 12 boyutlu bir yapı olarak modellemektedir.
| Boyut | Değişken | Değerlendirdiği temel özellik |
|---|---|---|
| Biçimsel | Form ve biçim | Yapı kabuğunun genel geometrisi ve konturu |
| Biçimsel | Ölçek ve oran | Yapı parçalarının kendi aralarındaki ve çevreyle boyut ilişkisi |
| Biçimsel | Renk | Cephede renk tonu, değer ve doygunluk |
| Biçimsel | Malzeme | Yapı kabuğunun görsel ve teknolojik malzeme ifadesi |
| Biçimsel | Doku | Pürüzlülük, düzgünlük ve yüzey tekrarları |
| Biçimsel | Dekorasyon ve ayrıntılar | Cepheyi zenginleştiren ikincil tasarım bileşenleri |
| Biçimsel | Kapalılık | Yapının mekânsal açıklık veya kapanma derecesi |
| Soyut | Karmaşıklık | Görsel elemanların miktarı ve çeşitliliği |
| Soyut | Düzen | Biçimin mantıksal organizasyonu ve okunabilirliği |
| Soyut | Çevresel uyumluluk | Doğal veya yapılı çevreyle bütünleşme derecesi |
| Duygusal | Hoşluk | Yapıya yönelik temel olumlu/olumsuz beğeni |
| Duygusal | Etkileyicilik | Yapının oluşturduğu heyecan ve uyarılma düzeyi |
Gerçek insan verisi nasıl toplandı?
Anket yalnız Bird's Nest'i fiziksel olarak ziyaret etmiş kişilere uygulanmıştır. Veri toplama Şubat 2026'da tamamlanmış ve geçersiz cevaplar çıkarıldıktan sonra 1.201 katılımcı kalmıştır.
| Özellik | Dağılım |
|---|---|
| Cinsiyet | %56 kadın, %44 erkek |
| <18 yaş | %18,2 |
| 18–30 yaş | %19,0 |
| 31–45 yaş | %17,0 |
| 46–60 yaş | %16,4 |
| >60 yaş | %29,4 |
| Bir kez ziyaret | %17,6 |
| 2–3 kez ziyaret | %26,3 |
| ≥4 kez ziyaret | %56,1 |
| Sanat/mimarlık geçmişi | %91,2 |
Katılımcıların %82,4'ü stadyumu en az iki kez ziyaret etmiş olduğundan veri seti ilk kez gören turistlerden çok, yapıya belirli derecede aşina kullanıcıları temsil etmektedir.
Bununla birlikte %91,2'lik sanat/mimarlık geçmişi oranı çok yüksektir. Bu nedenle çalışma sonuçlarının hiçbir ek doğrulama olmadan “ortalama genel kamuoyu” olarak değerlendirilmesi uygun değildir.
Likert değerlendirmesi
Kullanıcılar genel estetik memnuniyetlerini ve 12 ayrı estetik boyutu:
1 = tamamen memnun değil
ile
5 = tamamen memnun
arasında değerlendirmiştir.
Kullanıcının görsel özellikleri hangi sırada önemsediğini sayısal ağırlığa dönüştürmek için Linear Rank Weighting uygulanmıştır:
\[ W=\frac{M-r+1}{M} \]
Burada \(M\) bir kategorideki toplam gösterge sayısını, \(r\) ise kullanıcının söz konusu özelliğe verdiği sıralamayı göstermektedir.
CCCS Nedir ve Bireysel Tercihi Nasıl Yakalamaya Çalışıyor?
Comparative Case-based Cognitive Schema, kişinin Bird's Nest değerlendirmesini yalnız demografik özelliklerinden tahmin etmek yerine daha önce başka stadyumlara verdiği gerçek puanları kişisel estetik hafıza olarak kullanır.
Dört karşılaştırmalı yapı
Bird's Nest'e ek olarak dört Çin stadyumu kullanılmıştır:
- Chengdu Fenghuangshan Sports Park Football Stadium
- Shanghai Pudong Football Stadium
- Xi'an Olympic Sports Center Stadium
- Quzhou Stadium
Bu yapılar özellikle farklı biçim, malzeme, doku, kapalılık ve çevresel ilişki özellikleri taşıdıkları için seçilmiştir.
Örneğin Bird's Nest kaynakta kaotik örülü çelik grid ve anıtsal ölçekle; Quzhou Stadium ise topografik, peyzajla bütünleşen ve organik bir mimari olarak tanımlanmaktadır. Böylece kullanıcının hangi görsel özelliklere olumlu veya olumsuz tepki verdiği karşılaştırmalı örneklerden çıkarılabilir.
Görsel uyaranların standardizasyonu
Her yapı için iki görüntü kullanılmıştır:
- makro ölçekli hava görünümü,
- cephe ve malzeme ayrıntısını gösteren yakın görünüm.
Amaç yalnız genel silueti değil, mikro ölçekte doku ve tektonik özellikleri de değerlendirme sistemine dahil etmektir.
Üç Yapay Zekâ Etmeni Hangi Görevleri Üstleniyor?
1. Visual Perception Agent — VPA
VPA, stadyum görüntüsünü doğrudan “güzel/çirkin” olarak değerlendirmez. Görevi görüntüyü nesnel fiziksel tanımlara çevirmektir.
Örneğin:
“exposed, unpainted Q460 steel”
gibi fiziksel bir malzeme tanımı oluşturabilir.
Agentin 10 görsel boyutta ürettiği açıklamalar 20 kelimenin altında tutulmuş ve öznel duygusal sıfat kullanması prompt ile sınırlandırılmıştır.
2. Behavioral Fitting Agent — BFA
BFA kullanıcının estetik davranış profilini oluşturur.
Önce cinsiyet, yaş, meslek ve benzeri demografik özellikler üzerinden uygun adayları filtreler. Ardından kullanıcıların özellik-ağırlık vektörleri arasında kosinüs benzerliği hesaplanır.
Hedef kullanıcıya en benzer:
\[ K=20 \]
kişilik grup seçilir.
Bu grubun ortalama değerlendirmesi Social Baseline, yani sosyal başlangıç puanı olur.
CCCS etkin olduğunda kullanıcının dört karşılaştırmalı stadyuma verdiği geçmiş cevaplar da profile eklenir. Böylece sistem yalnız “bu yaş grubundaki insanlar ne düşünüyor?” sorusunu değil, “bu belirli kişi geçmişte hangi tür mimariyi sevmiş?” sorusunu da kullanır.
3. Fusion & Reasoning Agent — FRA
FRA, VPA'dan gelen objektif yapı özellikleriyle BFA'nın kullanıcı modelini birleştirir.
Temel mantık:
- K=20 komşudan sosyal başlangıç puanı oluştur.
- Hedef yapının fiziksel özelliklerini VPA'dan al.
- Kullanıcının geçmiş olumlu/olumsuz tercihlerine bak.
- Özellikler olumlu tercihle eşleşiyorsa puanı yükselt.
- Olumsuz tercihle eşleşiyorsa düşür.
- Geçmiş tercih eşleşmesi yoksa sosyal baseline'a dön.
Bu yaklaşım, modelin bağlam bulunmadığında serbest biçimde estetik gerekçe üretmesini sınırlandırmak için tasarlanmıştır.
Neden aynı tahmin beş kez çalıştırılıyor?
LLM çıktıları sıcaklık ve token örnekleme nedeniyle stokastiktir. Bu nedenle FRA her kullanıcı–yapı çifti için aynı görevi:
\[ N=5 \]
kez bağımsız çalıştırır.
Nihai puan beş tahminin aritmetik ortalamasıdır.
Kaynak bunu Ensemble Averaging Strategy olarak tanımlamaktadır.
Çalışmanın Yöntemi ve Bulguları
Anketin iç tutarlılığı
| İstatistik | Sonuç |
|---|---|
| Cronbach α | 0,950 |
| Alt ölçekler | Tamamı >0,85 |
| KMO | 0,965 |
| Bartlett testi | p<0,001 |
Bu sonuçlar kullanılan 12 değişkenli değerlendirme aracının kaynak veri seti içindeki yüksek iç tutarlılığını desteklemektedir.
On farklı LLM neden test edildi?
Sistemin tek bir temel modele bağlı olup olmadığını görmek için hem tescilli hem open-weights kategorisindeki on farklı LLM aynı genel agent yapısı altında değerlendirilmiştir.
Kaynakta incelenenler arasında GPT-5.1, GPT-5.2, GPT-4.1, Gemini 2.5 Flash, Gemini 3 Flash, Claude 4.5, GLM 4.7, Qwen 3, Llama 3.3 ve DeepSeek bulunmaktadır.
Bütün modeller resmî bulut API'leri üzerinden, aynı görev yapısı altında çalıştırılmış ve reasoning temperature:
\[ T=0,7 \]
olarak ayarlanmıştır. Çıktılar zorunlu JSON formatıyla sınırlandırılmıştır.
Relaxed Accuracy tam olarak ne anlama geliyor?
Çalışmanın ana doğruluk metriği:
\[ |Pred-True|\le1 \]
koşuludur.
Örneğin gerçek kullanıcı puanı 4 ise:
- 3 → relaxed olarak doğru,
- 4 → relaxed ve exact doğru,
- 5 → relaxed olarak doğru,
- 1 veya 2 → relaxed yanlış
sayılmaktadır.
Dolayısıyla relaxed accuracy değerleri değerlendirilirken 5 kategorili ölçeğin ±1 toleransı mutlaka dikkate alınmalıdır.
Karşılaştırmalı tercih olmadan temel performans
CCCS kullanılmadığında en yüksek genel relaxed accuracy:
GPT-5.1: %80,43
olarak raporlanmıştır.
Kaynak, bütün modellerin tahminlerin çoğunu doğru Likert puanının ±1 bölgesinde tutabildiğini; ancak bireysel kişilik/tercih farklılıklarını yakalamada zorlandığını göstermektedir.
Nerelerde sistem daha başarılı?
Temel sistem özellikle:
- çevresel uyumluluk,
- hoşluk,
- malzeme
gibi daha genel algısal boyutlarda güçlüdür.
Buna karşılık:
- dekorasyon ve ayrıntılar,
- etkileyicilik
en önemli tahmin darboğazlarıdır.
Araştırmacılar bunu demografik etiketlerin mikro-görsel tercihleri ve yüksek uyarılmışlık içeren duyguları açıklamakta yetersiz kalmasıyla ilişkilendirmektedir.
CCCS Eklendiğinde Ne Değişti?
Karşılaştırmalı yapı geçmişi eklendiğinde yalnız genel doğrulukta değil, modellerin bireysel kullanıcı farklılıklarını takip etme kapasitesinde daha belirgin bir değişim görülmüştür.
| Geliştirilmiş sistem metriği | Raporlanan sonuç |
|---|---|
| Gemini 3 Flash relaxed accuracy | %82,07 |
| Gemini 3 Flash MAE | 0,887 |
| Qwen 3 relaxed accuracy | %80,11 |
| Gemini 3 Flash Pearson | 0,255 |
| Qwen 3 Pearson | 0,199 |
| En yüksek raporlanan ortalama Pearson | 0,317 |
Bu sonuçların kritik noktası şudur: relaxed accuracy zaten temel sistemde yaklaşık %80 civarındadır. CCCS'nin asıl etkisi birkaç puanlık toplam doğruluk artışından ziyade kişilerin birbirinden farklı puan verme eğilimlerini daha iyi takip etmesidir.
Regression to the mean nedir?
Temel durumda modellerin Pearson korelasyon katsayılarının çoğu 0,05'in altında kalmaktadır. Bu, modelin kullanıcıların bireysel dalgalanmalarını izlemek yerine güvenli şekilde grubun ortalama puanına yakın tahmin üretmesiyle uyumludur.
CCCS eklendiğinde bütün on modelde korelasyon artmıştır. Kaynakta bazı artışlar:
\[ \Delta r=+0,138\; \text{ile}\; +0,272 \]
aralığına ulaşmaktadır.
Bu nedenle araştırmanın kendi terminolojisinde CCCS, modelin “regression to the mean” eğilimini azaltmaktadır.
Her model CCCS'den aynı ölçüde yararlanıyor mu?
Hayır.
Temel aşamada GPT-5.1 yaklaşık %80,4 ile ilk sıradayken CCCS eklendiğinde yaklaşık -0,7 yüzde puanı gerilemiştir.
Gemini 3 Flash ise yaklaşık:
+4,3 yüzde puanı
kazanarak %82,1 civarında ilk sıraya yükselmiştir.
Kaynak bunu farklı LLM mimarilerinin yüksek boyutlu bağlamsal tercih bilgisini kullanma kapasitesindeki farklılıklarla ilişkilendirmektedir. Ancak kapalı model mimarileri nedeniyle bunun iç mekanizması doğrudan gözlenmemiştir.
Boyut bazında CCCS etkisi
Geliştirilmiş sistemde Gemini 3 Flash:
| Boyut | Relaxed Accuracy |
|---|---|
| Hoşluk | %91,1 |
| Çevresel uyumluluk | %88,6 |
Biçim, karmaşıklık ve ölçek/oran gibi mimari morfoloji değişkenlerinde bazı modellerin Pearson korelasyonları 0,35'i aşmıştır. Bu, biçimsel tercihin karşılaştırmalı yapılar arasında belirli ölçüde taşınabildiğine işaret etmektedir.
Önceki zayıf alanlarda ne oldu?
Dekorasyon ve ayrıntılar:
Claude 4.5'in relaxed accuracy değeri CCCS sonrasında %77,2'ye çıkmış; artış:
\[ +8,7\;\text{yüzde puanı} \]
olarak raporlanmıştır.
Qwen 3 aynı boyutta %80,1'e ulaşmış ve RMSE değeri 1,283'e düşmüştür.
Etkileyicilik:
Relaxed accuracy yaklaşık %74,7'ye yükselmiş; RMSE:
\[ 1,591\rightarrow1,392 \]
olarak azalmıştır.
Beşli Ensemble Gerçekten Fark Yaratıyor Mu?
Kaynakta aynı LLM tahmininin beş kez bağımsız çalıştırılıp ortalamasının alınması hata varyansını azaltmıştır; ancak iyileşme büyük sıçrama değil, küçük fakat tutarlı bir stabilizasyon düzeyindedir.
| Örnek | Tekil çalışma | N=5 ensemble |
|---|---|---|
| Qwen 3 RMSE | 1,290 | 1,268 |
| GPT-5.1 relaxed accuracy | %79,5 | %80,9 |
| Gemini 3 Flash relaxed accuracy | — | %82,2 |
Kaynak, üç temsilci modelde relaxed accuracy artışının yaklaşık 1,3–1,4 yüzde puanı düzeyinde olduğunu bildirmektedir.
Bu sonuç ensemble'ın bilgi içeriğini değiştirmekten çok tek LLM çağrısındaki örnekleme gürültüsünü azaltan bir varyans kontrol tekniği olduğunu göstermektedir.
Bu Sistem Gerçek Halk Katılımının Yerini Alabilir Mi?
Çalışma, insan verisinin tamamen kaldırıldığı bir sistem göstermemektedir. Tam tersine CCCS'nin çalışabilmesi için gerçek insanların Bird's Nest ve karşılaştırmalı yapılar hakkındaki geçmiş değerlendirmelerine ihtiyaç vardır. Dolayısıyla yöntem, kamusal katılımın yerini alan bağımsız bir “sanal toplum” sisteminden çok, sınırlı gerçek insan verisini hesaplamalı olarak genişletmeye çalışan bir simülasyon yaklaşımıdır.
Bu ayrım özellikle önemlidir; çünkü modelin en güçlü geliştirmesi, insanların daha önce verdiği gerçek karşılaştırmalı puanlardan gelmektedir.
Çalışmanın desteklediği sonuçlar
- LLM tabanlı üç-etmenli mimari, 12 boyutlu kentsel estetik değerlendirmeyi yapılandırılmış biçimde üretebilmektedir.
- Demografik ve özellik-ağırlığı bilgileri genel estetik konsensüsün yaklaşık düzeyini tahmin etmede kullanılabilir.
- Yalnız demografik bilgi kullanıldığında bireysel farklılık korelasyonu düşüktür.
- Karşılaştırmalı geçmiş tercihler CCCS aracılığıyla eklendiğinde bütün test edilen modellerde Pearson korelasyonu yükselmiştir.
- Bazı LLM'ler CCCS bağlamından diğerlerinden daha fazla yararlanmıştır.
- N=5 ensemble ortalaması tek çalışma varyansını ve hata ölçülerini küçük fakat tutarlı biçimde azaltmıştır.
- Mikro-görsel ayrıntılar ve etkileyicilik gibi yüksek bireysel varyans içeren boyutlar genel demografiyle tahmin edilmesi daha zor özelliklerdir.
Çalışmanın desteklemediği sonuçlar
- %82,07 sonucu birebir doğru estetik puan oranı değildir; ±1 Likert toleranslı relaxed accuracy değeridir.
- Sistem bütün kent nüfusunun estetik tercihlerini temsil ettiğini kanıtlamamaktadır.
- %91,2 sanat/mimarlık geçmişine sahip örneklem genel nüfusun tipik dağılımı olarak kabul edilemez.
- Bird's Nest sonuçları mahalle sokakları, konut cepheleri, parklar veya küçük ölçekli gündelik kentsel alanlara doğrudan genellenemez.
- Modelin farklı kültürler veya ülkelerde aynı estetik tercih yapısını tahmin ettiği gösterilmemiştir.
- PDF'de açık biçimde ayrılmış bağımsız dış kullanıcı test seti veya saha dışı doğrulama raporlanmamaktadır.
- Pearson korelasyonlarındaki artış önemlidir ancak 0,317 düzeyi bireysel estetik tercihlerin büyük bölümünün açıklanabildiği anlamına gelmez.
- LLM'nin verdiği gerekçenin insan zihnindeki gerçek bilişsel süreçle aynı olduğu kanıtlanmamıştır.
- Modelin iç ağırlıkları ve gerçek karar mekanizması kapalı olduğundan agent açıklamaları tam mekanistik interpretasyon değildir.
Bilimsel anlamı
Çalışmanın en değerli tarafı “AI insanlardan daha iyi estetik karar verir mi?” sorusunu sormaması; bunun yerine insan estetik değerlendirmesindeki iki ayrı yapıyı ayırmaya çalışmasıdır:
toplumsal estetik uzlaşı ve bireysel estetik ayrışma.
Demografi tabanlı sistem birinci yapıyı belirli ölçüde yakalarken, kişiye ait geçmiş karşılaştırmalar ikinci yapı için ek bilgi sağlamaktadır.
Bu durum yapılı çevre değerlendirmesi açısından önemli bir metodolojik noktaya işaret etmektedir: Bir kişinin estetik tercihini yalnız kim olduğu değil, daha önce hangi mekânları sevdiği ve hangi özelliklere nasıl tepki verdiği de belirlemektedir.
CCCS'nin temel fikri bu geçmiş deneyimi makinenin kullanabileceği bağlamsal bir referans sistemine çevirmektir.
Bununla birlikte yöntem şu aşamada gerçek kamusal katılımı ikame eden doğrulanmış bir karar sistemi değildir. Araştırma tek bir simgesel yapı, belirli bir örneklem ve belirli LLM sürümleri üzerinde yürütülmüş deneysel bir hesaplamalı değerlendirme çerçevesidir.
Kaynak ve Yöntem Notu
Özgün çalışma: Simulating Aesthetic Consensus and Divergence in Urban Landmarks: An LLM-based Multi-Agent System for Built Environment Evaluation
Yazarlar: Yuxuan Li, Ting Zhang, Weimin Zhuang
Sorumlu yazar: Weimin Zhuang
Kurumlar: School of Architecture, Tsinghua University; School of Computer Science, Peking University, Beijing, China.
Kaynak türü: Hakem değerlendirmesinden geçmemiş preprint araştırma makalesi.
Platform: SSRN.
SSRN Abstract ID: 6907642.
DOI: 10.2139/ssrn.6907642.
SSRN gönderim tarihi: 9 Haziran 2026.
Vaka çalışması: Beijing National Stadium — Bird's Nest.
Anket: 1.201 geçerli katılımcı; veri toplama Şubat 2026.
Karşılaştırmalı vakalar: Chengdu Fenghuangshan Sports Park Football Stadium, Shanghai Pudong Football Stadium, Xi'an Olympic Sports Center Stadium ve Quzhou Stadium.
Temel mimari: Visual Perception Agent + Behavioral Fitting Agent + Fusion & Reasoning Agent.
Kişiselleştirme mekanizması: Comparative Case-based Cognitive Schema (CCCS).
Peer Neighborhood: K=20.
LLM inference sıcaklığı: 0,7.
Ensemble: Her kullanıcı–yapı değerlendirmesinde N=5 bağımsız çıkarım.
Birincil performans metriği: Relaxed Accuracy, |Pred−True|≤1.
Temel sistemin en yüksek relaxed accuracy değeri: GPT-5.1 — %80,43.
CCCS sistemindeki en yüksek raporlanan genel sonuç: Gemini 3 Flash — %82,07 relaxed accuracy, MAE 0,887.
Finansman: Beijing Natural Science Foundation, QY24288.
Çıkar çatışması: Yazarlar bilinen mali çıkar veya kişisel ilişki bildirmemektedir.
Yazar katkıları: Yuxuan Li — kavramsallaştırma, veri kürasyonu, biçimsel analiz, araştırma, yöntem, yazılım, doğrulama, görselleştirme ve yazım; Ting Zhang — yöntem ve yazılım; Weimin Zhuang — kavramsallaştırma, yöntem, proje yönetimi, kaynaklar, denetim, doğrulama ve metin gözden geçirme.
Üretken AI beyanı: Yazarlar makale hazırlığında okunabilirlik ve dil düzenleme amacıyla ChatGPT ve Gemini kullandıklarını; çıktıları kendilerinin gözden geçirerek içerik sorumluluğunu üstlendiklerini bildirmektedir.
Başlıca kaynak-içi sınırlılıklar: Görüntüden metne dönüşümde mikro-görsel bilgi kaybı; tek anıtsal yapı bağlamı; LLM'lerin kültürel/coğrafi önyargıları; iç karar mekanizmasının kara-kutu niteliği.
Verianla metodolojik uyarısı: Örneklemin %91,2'sinin sanat/mimarlık geçmişi bildirmesi ve PDF'de açık bir bağımsız dış kullanıcı test protokolünün belirtilmemesi nedeniyle sonuçlar genel nüfus için dış doğrulama olarak yorumlanmamalıdır.
Görsel kullanım notu: Kaynağın Bird's Nest ve diğer stadyum fotoğrafları, çok-etmenli mimari figürleri, radar/heatmap/scatter grafiklerinin özgün kompozisyonları doğrudan yeniden kullanılmamalıdır. Raporlanan yöntem ilişkileri ve sayısal değerlerden tamamen yeni Verianla görselleri hazırlanabilir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir