

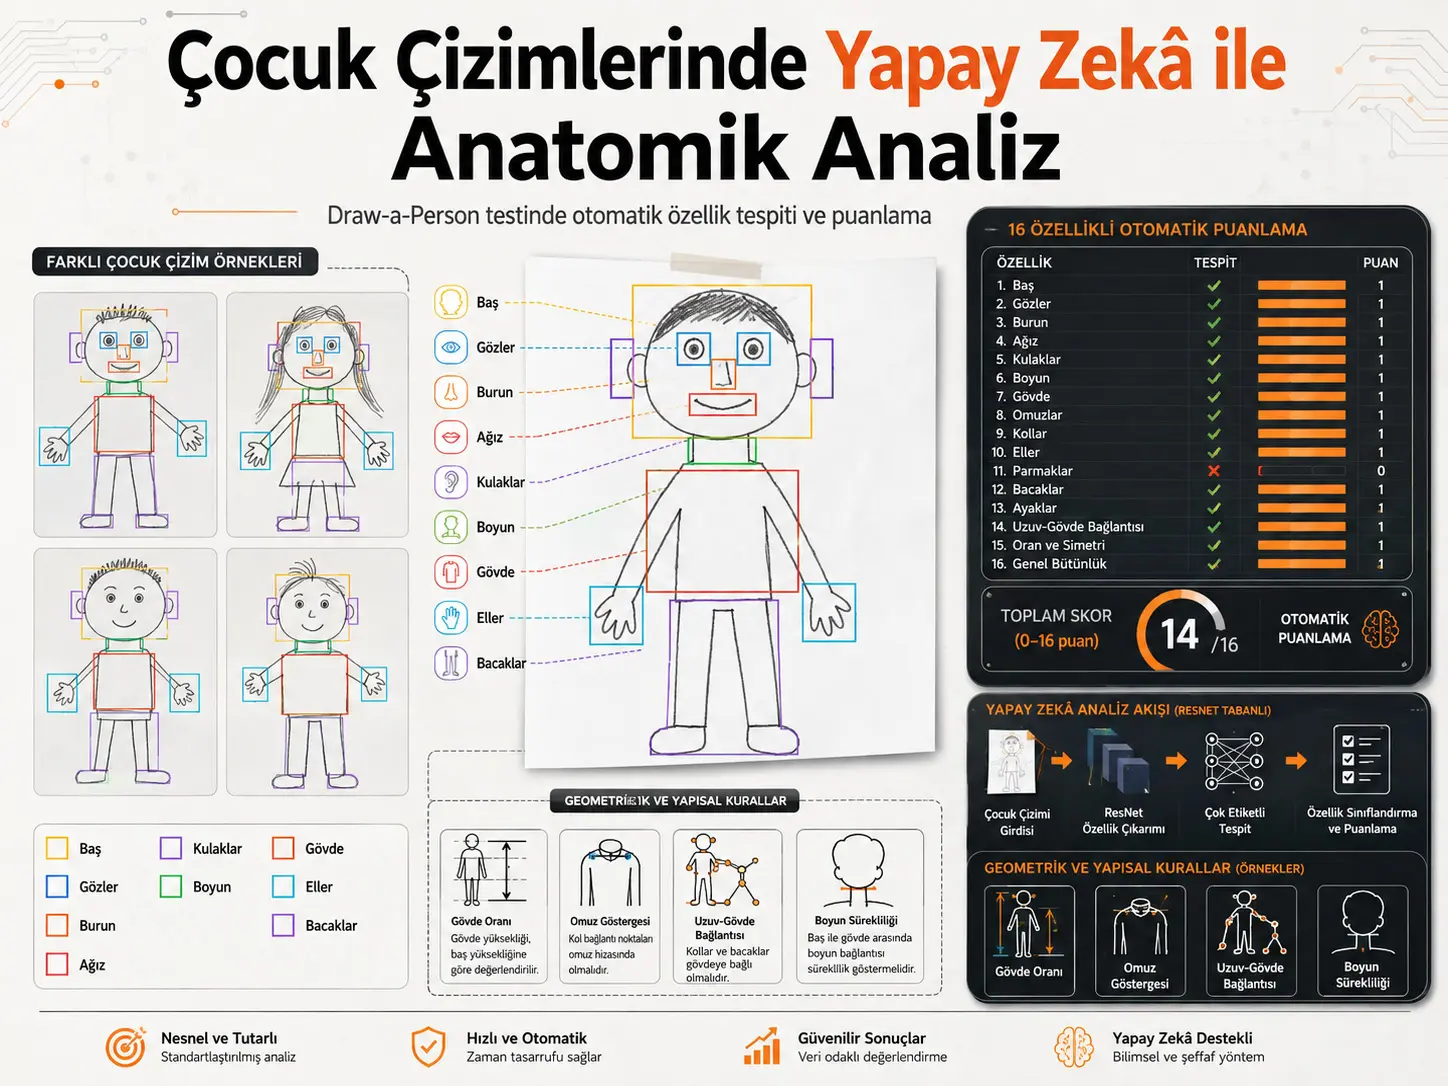
Bu çalışma, çocukların Draw-a-Person (DAP; Bir İnsan Çiz) testi kapsamında oluşturduğu insan figürü çizimlerini otomatik olarak analiz etmek için derin öğrenme ile açık geometrik kuralları birleştiren hibrit bir sistem önermektedir. Temel mimaride ImageNet üzerinde önceden eğitilmiş ResNet-50 modeli çizimlerde baş, göz, saç, el, bacak, ağız, burun, kulak, boyun ve gövde olmak üzere 10 görsel anatomik özelliği tahmin eder. Bunlara gövde oranı, omuz göstergesi, iki taraflı uzuv temsili, uzuv–gövde bağlantısı, doğru bağlantı bölgesi ve boyun sürekliliğini değerlendiren altı geometrik/sezgisel özellik eklenerek toplam 16 ikili özellik oluşturulur.
Araştırmada toplam 948 el çizimi kullanılmıştır. Ayrıntılı veri bölme açıklamasına göre 663 görüntü eğitim, 142 görüntü doğrulama ve 143 görüntü bağımsız test için ayrılmıştır. Beş katlı çapraz doğrulamada bildirilen doğruluk %90,05 ile %91,64 arasında değişmiş ve ortalama %91,01 olmuştur. Bununla birlikte performans özellikten özelliğe büyük farklılık göstermiştir: baş, göz, el, bacak, ağız ve gövde gibi belirgin bileşenlerde F1 değerleri yaklaşık 0,98–1,00 düzeyine ulaşırken kulak ve boyun gibi daha küçük veya değişken çizilen ayrıntılar önemli ölçüde daha zor bulunmuştur.
Bağımsız 143 çizimlik test setinde otomatik sistemin insan tarafından atanmış toplam DAP skorlarıyla korelasyonu r=0,93 (p<0,001) olarak bildirilmiş ve çizimlerin yaklaşık %87'sinde otomatik skor ile referans skor arasındaki fark ±1 puan içinde kalmıştır. Ancak bu sonuçlar sistemin psikolojik tanı koyabildiğini veya uzman değerlendirmesinin yerini alabildiğini göstermez. Çalışma yalnız belirlenmiş 16 çizim özelliğinin otomatik tespiti ve bunlardan basit bir toplam skor oluşturulmasını değerlendirmiştir. Ayrıca kaynak içindeki veri bölme, çıktı boyutu ve performans tablolarına ilişkin bazı tutarsızlıklar sonuçların dikkatli yorumlanmasını gerektirmektedir.
| Temel unsur | Kaynak çalışmada bildirilen yapı | Yorum sınırı |
|---|---|---|
| Toplam veri seti | 948 çocuk çizimi | 948 sayısı bağımsız test seti değildir; ayrıntılı yöntemde toplam veri setidir. |
| Detaylı veri ayrımı | 663 eğitim + 142 doğrulama + 143 test | Makalenin başka bir bölümündeki “948 görüntüyle 5-fold” ifadesiyle uyuşmamaktadır. |
| CNN tabanlı özellik | 10 | Temel mimari açıklamasına göre ResNet çıktılarıdır. |
| Geometrik/sezgisel özellik | 6 | Bounding-box geometrisinden kurallarla üretilir. |
| Toplam özellik | 16 | Basit toplamla 0–16 arasında skor oluşturulmaktadır. |
| Beş katlı CV ortalama doğruluğu | %91,01 | Çok etiketli ve dengesiz veri nedeniyle doğruluk tek başına yeterli performans ölçütü değildir. |
| Nihai sistem Tablo 8 ortalama F1 | 0,8996 | Özellikler arasında performans oldukça değişkendir. |
| Otomatik–referans skor korelasyonu | r=0,93; p<0,001 | Korelasyon, klinik eşdeğerlik veya psikolojik tanı doğruluğu değildir. |
Çalışma hangi problemi çözmeye çalışıyor?
Draw-a-Person testi, bir kişinin insan figürü çizmesinden hareketle belirli biçimsel ve anatomik özelliklerin puanlanmasına dayanır. Kaynak çalışmanın çıkış noktası, bu özelliklerin elle kontrol edilmesinin zaman alması ve değerlendirmeler arasında yorum farklılıklarının ortaya çıkabilmesidir.
Araştırmacılar problemi tamamen “kara kutu” bir yapay zekâ modeline bırakmak yerine iki ayrı yaklaşımı birleştirmiştir. Görüntüde doğrudan görülmesi gereken anatomik yapılar ResNet-50 tabanlı bir CNN tarafından değerlendirilirken, parçalar arasındaki konumsal ve geometrik ilişkiler açık kurallarla hesaplanmıştır.
Böylece sistem yalnız “bu çizimde bir bacak var mı?” sorusunu değil; örneğin uzuvların gövdeye bağlanıp bağlanmadığı veya gövdenin yüksekliğinin genişliğinden fazla olup olmadığı gibi daha yapılandırılmış soruları da yanıtlamaya çalışmaktadır.
10 CNN özelliği hangileri?
ResNet tabanlı görsel bölüm şu on anatomik bileşenin çizimde bulunup bulunmadığını tahmin etmektedir:
- kulaklar,
- gözler,
- saç,
- eller,
- baş,
- bacaklar,
- ağız,
- boyun,
- burun,
- gövde.
Her özellik diğerlerinden bağımsız biçimde var/yok etiketi alabilmektedir. Bu nedenle problem klasik tek sınıflı görüntü sınıflandırması değil, çok etiketli sınıflandırma problemidir.
Altı geometrik kural neyi değerlendiriyor?
CNN'in yanına eklenen altı özellik, çizilmiş parçaların koordinatları ve bounding-box ilişkilerinden hesaplanmaktadır:
| Geometrik özellik | Kaynakta kullanılan temel kural |
|---|---|
| Gövdenin uzunluğunun genişliğinden büyük olması | Gövde bounding-box yüksekliği genişliğinden büyükse pozitif. |
| Omuzların belirtilmesi | Gövde genişliği boyun genişliğinin 1,2 katından büyükse pozitif. |
| Uzuvların iki taraflı temsili | Gövde orta çizgisinin iki tarafındaki el/bacak bounding-box konumları değerlendirilir. |
| Uzuv–gövde bağlantısı | Uzuv ve gövde bounding box'ları arasındaki örtüşme IoU eşiğine göre kontrol edilir. |
| Doğru uzuv bağlantı bölgeleri | Ellerin gövdenin üst, bacakların alt bölgelerine bağlanması uzamsal eşiklerle değerlendirilir. |
| Boyun kontur sürekliliği | Boyun kutusunun alt kenarı ile gövdenin üst kenarı arasında ±2 piksel koşulu kullanılır. |
Kaynak çalışmada geometrik eşiklerin doğrulama verisi üzerinde grid search ile ayarlandığı belirtilmektedir. Uzuv–gövde bağlantısı için seçilen IoU eşiği 0,01; üst bağlantı bölgesi oranı 0,3 ve alt bölge oranı 0,5'tir.
Verianla Live: Bir çizimin otomatik DAP skoruna dönüşmesi
Bu akış kaynak çalışmanın Şekil 1'inde tarif edilen hibrit mimariyi özetler.
| Aşama | Kaynak çalışmadaki işlem |
|---|---|
| 1. Girdi | Çocuk tarafından oluşturulmuş DAP insan figürü çizimi sisteme alınır. |
| 2. Görüntü ön işleme | Görüntü RGB'ye dönüştürülür ve 224 × 224 piksele ölçeklenir. |
| 3. ResNet-50 özellik çıkarımı | ImageNet ön-eğitimli ve dondurulmuş backbone 2048 boyutlu görsel özellik vektörü üretir. |
| 4. CNN anatomik tahmini | Baş, göz, saç, el, bacak, ağız, burun, kulak, boyun ve gövde için 10 tahmin üretilir. |
| 5. Eşikleme | Sigmoid olasılıkları seçilen eşiklerle ikili var/yok çıktısına çevrilir. |
| 6. Geometrik analiz | Bounding-box ilişkilerinden altı yapısal/sezgisel özellik hesaplanır. |
| 7. Birleştirme | 10 CNN özelliği ve 6 geometrik özellik 16 elemanlı özellik vektöründe birleştirilir. |
| 8. Puanlama | Pozitif ikili özellikler toplanarak 0–16 aralığında otomatik DAP skoru oluşturulur. |
Akış çalışma mimarisini açıklar; 16 puanın psikolojik tanı veya klinik karar için tek başına yeterli olduğu anlamına gelmez.
Veri setinde “yaş” ne anlama geliyor?
Veri setinde 948 çizim sekiz gruba ayrılmıştır ve gruplar 4 ile 11 arasında etiketlenmiştir. Ancak kaynak çalışma açık biçimde bunların öğrencilerin gerçek yaşlarından bağımsız olarak profesyonel değerlendirmeyle atanmış mental-age grupları olduğunu belirtmektedir.
Bu ayrım özellikle çalışma içerisindeki yaşa göre F1 grafiklerini yorumlarken önemlidir. Örneğin ağız tespit F1'inin grup 4'te 0,30'dan grup 11'de 0,95'e yükselmesi, aynı çocukların yaşlandıkça takip edildiği longitudinal bir gelişim çalışmasının sonucu değildir. Bunlar önceden farklı mental-age kategorilerine atanmış çizim grupları üzerindeki model performanslarıdır.
Hangi özellikler kolay, hangileri zor bulundu?
Beş katlı çapraz doğrulamada baş, el, bacak, göz, ağız ve gövde gibi belirgin anatomik bileşenlerde yüksek F1 skorları elde edilmiştir. Kaynak Tablo 5'te göz, el, baş, bacak ve gövdenin ortalama F1 değerleri yaklaşık 0,99; ağız 0,98 olarak raporlanmıştır.
Buna karşılık burun için ortalama F1 0,84, saç için 0,87 ve boyun için 0,75'tir. En belirgin başarısızlık kulaktadır: kaynak Tablo 5 ortalama kulak F1 değerini yalnız 0,09 ± 0,06 olarak vermektedir.
Çalışmanın görsel değerlendirmesi de bunu küçük veya stilize ayrıntıların çizimden çizime çok değişmesine bağlamaktadır. Bazı çocuklar kulağı hiç çizmezken bazıları çok küçük veya belirsiz şekillerle temsil etmektedir.
Yüksek toplam doğruluk neden tek başına yeterli değil?
Çalışma çok etiketli ve güçlü sınıf dengesizlikleri içeren bir problemle ilgilenmektedir. Kaynak yazarları da bu nedenle accuracy yerine precision, recall ve F1'in daha bilgilendirici olabileceğini belirtmektedir.
Bu nokta bağımsız testte özellikle belirgindir. Tablo 10'da CNN tarafından değerlendirilen on görsel özelliğin tamamında gerçek negatif (TN) sayısı sıfırdır. Örneğin kulak için TP=57, FP=86, TN=0 ve FN=0 raporlanmıştır. Bu dağılımda model testteki 143 çizimin tamamı için “kulak var” demiştir. Recall böylece 1,00 olurken precision yalnız 57/143 ≈ 0,399 ve F1 yaklaşık 0,57'dir.
Benzer biçimde baş için 143 çizimin tamamı pozitif olduğu için TP=143, FP=TN=FN=0'dır. Böyle bir test alt grubunda modelin başın olmadığı bir çizimi doğru reddedip reddedemeyeceği ölçülemez. Bu nedenle bazı 0,99–1,00 düzeyindeki değerler “model her koşulda neredeyse kusursuzdur” şeklinde yorumlanmamalıdır.
Uzman puanlarıyla ne kadar uyuştu?
143 çizimlik test setinde otomatik toplam DAP skoruyla insan tarafından atanmış ground-truth skor arasında Pearson korelasyonu r=0,93 ve p<0,001 olarak bildirilmiştir. Kaynak Şekil 8'de noktaların önemli bölümü ideal \(y=x\) çizgisi çevresinde toplanmaktadır.
Şekil 9'daki hata dağılımına göre çizimlerin yaklaşık %87'sinde otomatik puan ile referans puan arasındaki fark ±1 puan sınırındadır. İki puandan daha büyük farkların seyrek olduğu belirtilmiştir.
Bu sonuçlar otomatik skor ile referans skor arasında güçlü ilişki bulunduğunu destekler. Ancak korelasyon bir yöntemler-arası tam uyum testi değildir ve sistemin psikolojik değerlendirme açısından uzmanla değiştirilebilir olduğunu tek başına kanıtlamaz.
Çalışmanın desteklediği sonuçlar
- ResNet tabanlı görsel analiz ile geometrik kurallar tek bir otomatik DAP iş akışında birleştirilebilir.
- Belirgin anatomik yapılar küçük ayrıntılara göre daha güvenilir biçimde tespit edilmiştir.
- Kulak ve boyun, çalışmadaki en zor CNN özellikleri arasındadır.
- Otomatik 0–16 skor ile kaynak çalışmadaki insan referans skoru arasında güçlü korelasyon raporlanmıştır.
- Geometrik ilişkilerin açık kurallarla hesaplanması sistemin belirli kararlarını daha izlenebilir hale getirmektedir.
- Bağımsız test performansı bütün özellikler için eşit değildir.
Çalışmanın kanıtlamadığı sonuçlar
- Sistemin bir çocuğun zekâsını, ruhsal durumunu veya psikiyatrik durumunu tek başına teşhis edebildiği kanıtlanmamıştır.
- Otomatik skorun uzman psikolog değerlendirmesinin yerini güvenli biçimde alabildiği gösterilmemiştir.
- Modelin farklı kültürlerden çocuklarda aynı performansı göstereceği kanıtlanmamıştır.
- 4–11 olarak etiketlenen veri grupları kronolojik yaş kohortları değildir; bu nedenle sonuçlar doğrudan yaşa bağlı gelişim eğrisi değildir.
- 0–16 basit toplam puanının özgün Goodenough–Harris sisteminin tüm ağırlıklandırma ve klinik yorum mantığını bire bir temsil ettiği gösterilmemiştir.
- Yüksek korelasyon klinik eşdeğerlik veya tanısal geçerlilik anlamına gelmez.
Çalışmanın Yöntemi ve Bulguları
Veri hazırlama
Kaynak veri seti 948 el çiziminden oluşmaktadır. On temel anatomik bölge DigitalSreeni görüntü anotasyon aracı kullanılarak bounding box biçiminde elle etiketlenmiş ve anotasyonlar COCO tarzı yapıda saklanmıştır.
Görüntüler RGB formatına dönüştürülmüş ve ResNet-50 girdisine uygun olacak şekilde 224 × 224 piksele yeniden boyutlandırılmıştır. Eğitim sırasında görüntülerin %50 olasılıkla yatay çevrilmesi ve parlaklık/kontrastın ±%20 değiştirilmesiyle veri artırma uygulanmıştır.
Ayrıntılı veri hazırlama bölümünde kullanılan ayrım şöyledir:
| Veri bölümü | Çizim sayısı | Toplam veri içindeki oran | Kullanım |
|---|---|---|---|
| Eğitim | 663 | %70 | Model parametrelerinin öğrenilmesi |
| Doğrulama | 142 | %15 | Eşik ve yöntem ayarları |
| Test | 143 | %15 | Nihai, görülmemiş değerlendirme |
| Toplam | 948 | %100 | Tüm veri seti |
Bu ayrım, makale özetindeki “948 çizimlik ayrı hold-out test seti” ifadesiyle uyuşmamaktadır. Ayrıntılı yöntem ve test tabloları 143 çizimlik bağımsız test setini desteklediğinden burada 948 toplam veri seti, 143 ise hold-out test büyüklüğü olarak aktarılmıştır.
ResNet-50 mimarisi
Temel mimari tanımına göre ImageNet üzerinde önceden eğitilmiş ResNet-50 backbone'u sabit özellik çıkarıcı olarak kullanılmış ve convolution katmanları dondurulmuştur. 224 × 224 RGB çizim için:
\[ x \in \mathbb{R}^{3\times224\times224} \]
Backbone global average pooling çıkışında 2048 boyutlu bir özellik vektörü üretmektedir:
\[ f_{\mathrm{ResNet}}(x)\in\mathbb{R}^{2048} \]
Temel mimari açıklamasında yeni doğrusal katman 10 anatomik görsel özelliğe eşlenmektedir:
\[ z_{\mathrm{CNN}}=Wf_{\mathrm{ResNet}}(x)+b \]
\[ W\in\mathbb{R}^{10\times2048},\qquad b\in\mathbb{R}^{10} \]
Her logit sigmoid ile olasılığa çevrilir:
\[ \hat{y}_i=\sigma(z_i)=\frac{1}{1+e^{-z_i}} \]
Ardından 10 CNN çıktısı altı geometrik/sezgisel özellik ile birleştirilir:
\[ y_{\mathrm{final}}=[y_{\mathrm{CNN}},y_{\mathrm{heuristic}}]\in\mathbb{R}^{16} \]
Kaynak çalışmanın 4.2 bölümünde ise sınıflandırma katmanının 2048 boyutlu özellik vektörünü doğrudan 16 hedef özelliğe eşlediği yazılmaktadır. Bu ifade, makalenin Şekil 1'i, 4.1 ve 4.3 bölümlerindeki “10 CNN + 6 heuristic” mimarisiyle uyuşmamaktadır. Bu nedenle Verianla metninde temel mimari olarak şekil ve çoğunlukla tekrarlanan 10+6 yapısı esas alınmış, çelişkili 16-CNN ifadesi kaynak içi tutarsızlık olarak kayda geçirilmiştir.
Kayıp fonksiyonu ve sınıf dengesizliği
Çalışmada çok etiketli sınıflandırma için BCEWithLogitsLoss kullanılmış ve nadir pozitif özelliklerin eğitim sırasında daha fazla ağırlık taşıması için pos_weight uygulanmıştır.
Kaynakta özellik ağırlığı şu oranla açıklanmaktadır:
\[ w_i=\frac{negatives_i}{positives_i} \]
Böylece az görülen özelliklerde pozitif örneğin yanlış sınıflandırılması daha yüksek eğitim maliyetine sahip olur.
Bununla birlikte kayıp fonksiyonu bölümünde \(N=16\) çıkışın doğrudan CNN kaybına dahil edildiği yazılmıştır. Bu da altı heuristic özelliğin CNN dışında hesaplandığını söyleyen ana mimariyle tam olarak bağdaşmamaktadır.
Eğitim ayarları
| Eğitim parametresi | Kaynakta bildirilen değer |
|---|---|
| Backbone | ImageNet ön-eğitimli ResNet-50 |
| Backbone eğitimi | Convolution katmanları dondurulmuş |
| Optimizer | Adam |
| Öğrenme oranı | 1 × 10⁻⁴ |
| Epoch | 10 |
| Gradient clipping | Maksimum norm 1,0 |
| Kayıp | Ağırlıklı BCEWithLogitsLoss |
| Görüntü boyutu | 224 × 224 piksel |
Çapraz doğrulama sonucu
Makalenin 4.6 bölümünde, 143 görüntülük test kümesi ayrıldıktan sonra kalan 805 görüntünün beş katlı çapraz doğrulamada kullanıldığı belirtilmektedir. Her iterasyonda yaklaşık 644 görüntü eğitim ve 161 görüntü doğrulama için kullanılmıştır.
| Fold | Doğruluk (%) |
|---|---|
| Fold 1 | 91,64 |
| Fold 2 | 91,12 |
| Fold 3 | 91,28 |
| Fold 4 | 90,94 |
| Fold 5 | 90,05 |
| Ortalama | 91,01 |
Buna karşın 4.7 bölümünde “complete dataset” olarak 948 çizimin beş fold'a bölündüğü yazılmıştır. Bu ifade, 143 görüntünün tamamen ayrı tutulduğu önceki protokolle çelişmektedir. Kaynak bu iki açıklamayı uzlaştırmamaktadır.
Beş katlı çapraz doğrulamada özellik bazlı F1
| Özellik | Ortalama F1 | SEM |
|---|---|---|
| Kulak | 0,09 | 0,06 |
| Göz | 0,99 | 0,00 |
| Saç | 0,87 | 0,01 |
| El | 0,99 | 0,00 |
| Baş | 0,99 | 0,00 |
| Bacak | 0,99 | 0,00 |
| Ağız | 0,98 | 0,01 |
| Boyun | 0,75 | 0,04 |
| Burun | 0,84 | 0,01 |
| Gövde | 0,99 | 0,00 |
| Gövde uzunluğu > genişlik | 1,00 | 0,00 |
| Omuz belirtilmiş | 1,00 | 0,00 |
| Uzuvlar iki boyutlu | 1,00 | 0,00 |
| Uzuvlar gövdeye bağlı | 1,00 | 0,00 |
| Doğru uzuv bağlantı noktaları | 1,00 | 0,00 |
| Boyun konturu baş/gövdeyle sürekli | 1,00 | 0,00 |
Altı heuristic özelliğin çapraz doğrulamada tam F1=1,00 vermesi dikkat çekicidir. Yöntem bölümü çapraz doğrulama etiketlerinin bu heuristic kurallarla üretildiğini belirtmektedir. Dolayısıyla bir kuralın kendi ürettiği etikete karşı değerlendirilmesi, bağımsız bir doğrulama sayılmaz. Nitekim 143 çizimlik hold-out setinde bu altı özellik bağımsız deneyimli değerlendiriciler tarafından etiketlendiğinde bazı heuristic performansları belirgin biçimde düşmektedir.
143 çizimlik bağımsız testte nihai özellik performansı
Verianla Live: Hold-out testte özellik bazlı F1
Değerler kaynak Tablo 8'deki 143 çizimlik otomatik tespit ve puanlama değerlendirmesinden alınmıştır. Sınıf prevalansları farklı olduğundan yalnız F1'e bakarak özelliklerin klinik önemi karşılaştırılmamalıdır.
| Özellik | F1 skoru |
|---|---|
| Kulak | 0,5700 |
| Göz | 0,9965 |
| Saç | 0,8651 |
| El | 0,9858 |
| Baş | 1,0000 |
| Bacak | 0,9930 |
| Ağız | 0,9894 |
| Boyun | 0,7881 |
| Burun | 0,8514 |
| Gövde | 0,9858 |
| Gövde uzunluğu > genişlik | 1,0000 |
| Omuz belirtilmiş | 0,9765 |
| Uzuvlar iki boyutlu | 1,0000 |
| Uzuvlar gövdeye bağlı | 0,4762 |
| Doğru uzuv bağlantı noktaları | 0,9163 |
| Boyun konturu baş/gövdeyle sürekli | 1,0000 |
Bu tabloda ortalama doğruluk 0,8780, precision 0,8929, recall 0,9458 ve F1 0,8996 olarak raporlanmıştır. Özellikle “uzuvlar gövdeye bağlı” heuristic özelliğinin F1 değerinin 0,4762'ye düşmesi, çapraz doğrulamadaki 1,00 değerinin bağımsız referans etiketi karşısında korunmadığını göstermektedir.
Kaynak içindeki iki performans tablosu neden dikkatle okunmalı?
Kaynak Tablo 7, 16 özellik için ortalama accuracy=0,9175, precision=0,8869, recall=0,9375 ve F1=0,905 verir. Bir sonraki otomatik tespit/puanlama Tablo 8 ise accuracy=0,8780, precision=0,8929, recall=0,9458 ve F1=0,8996 verir.
| Kaynak sonucu | Accuracy | Precision | Recall | F1 |
|---|---|---|---|---|
| Tablo 7 | 0,9175 | 0,8869 | 0,9375 | 0,9050 |
| Tablo 8 | 0,8780 | 0,8929 | 0,9458 | 0,8996 |
Makale metni bu iki değerlendirme aşamasını tam olarak tutarlı biçimde adlandırmamaktadır. Ayrıca daha sonraki Tablo 9 açıklamasında tablo numaralarının bir sıra kaydığı görülmektedir. Bu nedenle “sistemin doğruluğu %91,78'dir” biçiminde tek ve bağlamsız bir rakam vermek bilimsel olarak yanıltıcı olur.
Kulak sonucundaki büyük değişim
Kaynak Tablo 7'de kulak tespiti accuracy=0,63, precision=0,14, recall=0,01 ve F1=0,07 olarak verilir. Tablo 8'de ise kulak için accuracy ve precision 0,3986, recall 1,0000 ve F1=0,5700'dür.
Tablo 9 bu değişimi “heuristic refinement” sonrasında iyileşme olarak yorumlamaktadır. Ancak çalışma tarafından tanımlanan altı heuristic özellik arasında kulak tespitini düzelten bir kural bulunmamaktadır; heuristics gövde oranı, omuz, iki taraflı uzuv, uzuv bağlantısı, bağlantı bölgesi ve boyun sürekliliğidir. Dolayısıyla kulak F1'indeki 0,07 → 0,57 değişimin teknik nedeni kaynak metinden güvenilir biçimde belirlenememektedir.
Karışıklık matrisi ne gösteriyor?
143 çizimlik testte on görsel özelliğin karışıklık matrisi ayrıca önemli bir uyarı verir:
| Görsel özellik | TP | FP | TN | FN |
|---|---|---|---|---|
| Kulak | 57 | 86 | 0 | 0 |
| Göz | 142 | 1 | 0 | 0 |
| Saç | 109 | 34 | 0 | 0 |
| El | 139 | 4 | 0 | 0 |
| Baş | 143 | 0 | 0 | 0 |
| Bacak | 141 | 2 | 0 | 0 |
| Ağız | 140 | 3 | 0 | 0 |
| Boyun | 93 | 50 | 0 | 0 |
| Burun | 106 | 37 | 0 | 0 |
| Gövde | 139 | 4 | 0 | 0 |
Bu sayılar bütün on görsel özellikte FN=0 ve TN=0 olduğunu göstermektedir. Dolayısıyla modelin bu test tablosunda görsel özellikleri “yok” olarak doğru tespit etme kapasitesi ölçülememektedir. Bazı yüksek recall ve F1 skorları bu prevalans ve tahmin yapısından etkilenmektedir.
Otomatik skor nasıl hesaplanıyor?
Kaynak formülünde 16 ikili özellik doğrudan toplanır:
\[ S=\sum_{i=1}^{16}f_i \]
Burada \(f_i=1\) özelliğin bulunduğunu, \(f_i=0\) bulunmadığını gösterir. Böylece toplam skor 0 ile 16 arasında değişir.
Kaynağın daha sonraki sonuç metninde bir yerde 16 ikili çıktının “averaging” yani ortalamasının alındığı yazılmıştır; aynı paragraf hemen ardından 0–16 puan üretildiğini belirtmektedir. 0–16 ölçeği ve verilen denklem toplamayı desteklediği için Verianla metninde formüldeki toplam kullanılmıştır.
Çalışmanın temel yöntemsel sınırlılıkları
- Toplam veri seti yalnız 948 çizimdir ve kültürler arası bağımsız doğrulama yapılmamıştır.
- Kaynakta kullanılan “mental age” grupları kronolojik yaş değildir.
- Küçük anatomik özelliklerde güçlü sınıf dengesizliği bulunmaktadır.
- Hold-out karışıklık matrisinde on CNN özelliğinin tamamında TN=0'dır.
- Altı heuristic özellik için çapraz doğrulama etiketlerinin kurallardan üretilmesi, kusursuz CV skorlarının bağımsız doğrulama olmadığı anlamına gelir.
- Heuristic eşikler veri setine göre ampirik olarak ayarlanmıştır ve başka çizim stillerinde aynı doğruluğu vermeyebilir.
- 16 özellik toplam skorda eşit ağırlık almaktadır; kaynak yazarları bunun gerçek DAP puanlama sistemini tam olarak temsil etmeyebileceğini kabul etmektedir.
- Çapraz doğrulamanın 805 mi yoksa 948 çizimde mi yapıldığı konusunda kaynak içi tutarsızlık vardır.
- ResNet sınıflandırma katmanının 10 mu yoksa 16 çıktı mı verdiği konusunda yöntem metninde tutarsızlık bulunmaktadır.
- Kaynakta doğrulama verisiyle eşik ayarı yapıldığı belirtilirken daha sonra çapraz doğrulamanın hiperparametre ayarı için kullanılmadığı ifade edilmektedir.
- Tablo 7, Tablo 8 ve Tablo 9 arasındaki performans aşamaları ve tablo referansları tamamen tutarlı değildir.
- Otomatik skorun psikolojik veya klinik tanısal geçerliliği bu çalışma tarafından bağımsız olarak test edilmemiştir.
Kaynak ve Yöntem Notu
| Tam özgün çalışma adı | Automated Anatomical Feature Analysis and Scoring for Draw-a-Person Test Drawings via ResNet-Based Multi-Label Detection and Classification |
|---|---|
| Yazarlar | Asma Abdullah Alwadai; Emad Sami Jaha |
| Yazar sırası | 1. Asma Abdullah Alwadai; 2. Emad Sami Jaha |
| Eş katkı / eş birinci yazar | Kaynak çalışmada eş katkı beyanı belirtilmemiştir. |
| Sorumlu yazar | Asma Abdullah Alwadai |
| Kurum | Department of Computer Science, Faculty of Computing and Information Technology, King Abdulaziz University, Jeddah 21589, Saudi Arabia |
| Kaynak türü | Deneysel yapay zekâ / bilgisayarlı görü araştırma makalesi. |
| Hakemlik durumu | Hakemli dergide yayımlanmış makaledir; preprint değildir. |
| Dergi | AI |
| Yayınevi | MDPI |
| Cilt / sayı / makale | 2026, 7(4), 130 |
| DOI | 10.3390/ai7040130 |
| Alınma tarihi | 4 Mart 2026 |
| Revizyon tarihi | 26 Mart 2026 |
| Kabul tarihi | 28 Mart 2026 |
| Yayın tarihi | 2 Nisan 2026 |
| Resmî bağlantı | https://doi.org/10.3390/ai7040130 |
| Lisans | Creative Commons Attribution (CC BY). |
Finansman ve kurumsal destek
Makalenin finansman beyanında araştırmanın dış finansman almadığı belirtilmektedir. Teşekkür bölümünde ise projenin King Abdulaziz University bünyesindeki KAU Endowment (WAQF) tarafından desteklendiği ve WAQF ile Deanship of Scientific Research'e teknik ve finansal destek için teşekkür edildiği yazılmıştır. Bu iki ifade birlikte değerlendirildiğinde çalışma “external funding” bildirmemekte, fakat kurum içi destek beyan etmektedir.
Etik ve veri kaynağı
Etik kurul değerlendirmesinin, araştırmanın kamuya açık ve tamamen anonimleştirilmiş bir veri setini kullanması ve yeni katılımcı/veri toplama içermemesi nedeniyle gerekli görülmediği belirtilmiştir. Bilgilendirilmiş onam bu nedenle uygulanabilir değildir.
Kaynak veri seti “Draw-a-Person Hand-Drawn Sketches by Children” adıyla kamuya açık bir Kaggle deposundan alınmış ve makalede erişim tarihi 30 Kasım 2025 olarak verilmiştir.
Yazar katkıları
Kavramsallaştırma ve metodoloji Asma Abdullah Alwadai ile Emad Sami Jaha tarafından yürütülmüştür. Yazılım, doğrulama, araştırma, veri düzenleme, ilk taslak ve görselleştirme görevleri ağırlıklı olarak Asma Abdullah Alwadai tarafından gerçekleştirilmiştir. Gözetim ve finansman edinimi Emad Sami Jaha tarafından üstlenilmiş; iki yazar da makalenin gözden geçirilmesi ve düzenlenmesine katkıda bulunmuştur.
Çıkar çatışması
Yazarlar çıkar çatışması bulunmadığını beyan etmiştir.
Kaynak içi tutarsızlıkların kayıt özeti
- Özette 948 çizimin ayrı hold-out test seti olduğu yazılır; ayrıntılı yöntem 948'in toplam veri seti, 143'ün test seti olduğunu gösterir.
- Bir bölüm çapraz doğrulamayı 805 çizimde, başka bir bölüm bütün 948 çizimde tanımlar.
- Ana mimari 10 CNN + 6 heuristic çıktıyı gösterirken bir alt bölüm ResNet classifier'ını 16 çıktılı olarak tanımlar.
- Kayıp fonksiyonu bölümünde de CNN için 16 özellik yazılması 10+6 mimarisiyle uyuşmaz.
- Metin %91,78 makro accuracy bildirirken Tablo 7 ortalaması %91,75, Tablo 8 nihai ortalaması %87,80'dir.
- Kulak F1 değeri bir değerlendirmede 0,07, diğerinde 0,57'dir ve kaynak değişimin mekanizmasını yeterince açıklamamaktadır.
- Tablo 9, kulaktaki değişimi heuristic refinement ile ilişkilendirse de tanımlanan altı heuristic kuralın hiçbiri kulağa yönelik değildir.
- Sonuç metninde skorun bir yerde “ortalama” olduğu yazılsa da formül ve 0–16 ölçeği özelliklerin toplandığını göstermektedir.
- Çapraz doğrulamada heuristic özelliklerin tamamı 1,00 F1 verirken bağımsız uzman etiketli testte uzuv–gövde bağlantısı F1=0,4762'ye düşmektedir.
Bu nedenle çalışmanın en sağlam çıkarımı, “yapay zekâ artık çocuk çizimlerinden psikolojik değerlendirmeyi otomatik ve kusursuz yapabiliyor” değildir. Kaynağın desteklediği daha dar sonuç; ResNet tabanlı görsel özellik tespiti ile açık geometrik kuralların birleştirilmesinin, belirlenmiş 16 DAP çizim özelliği için otomatik ve yorumlanabilir bir prototip puanlama sistemi oluşturabildiğidir. Özellikle küçük anatomik ayrıntılar, sınıf dengesizliği, değerlendirme protokolündeki tutarsızlıklar ve dış doğrulama eksikliği çözülmeden sistemin klinik veya psikolojik karar mekanizması olarak genellenmesi desteklenmemektedir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir