

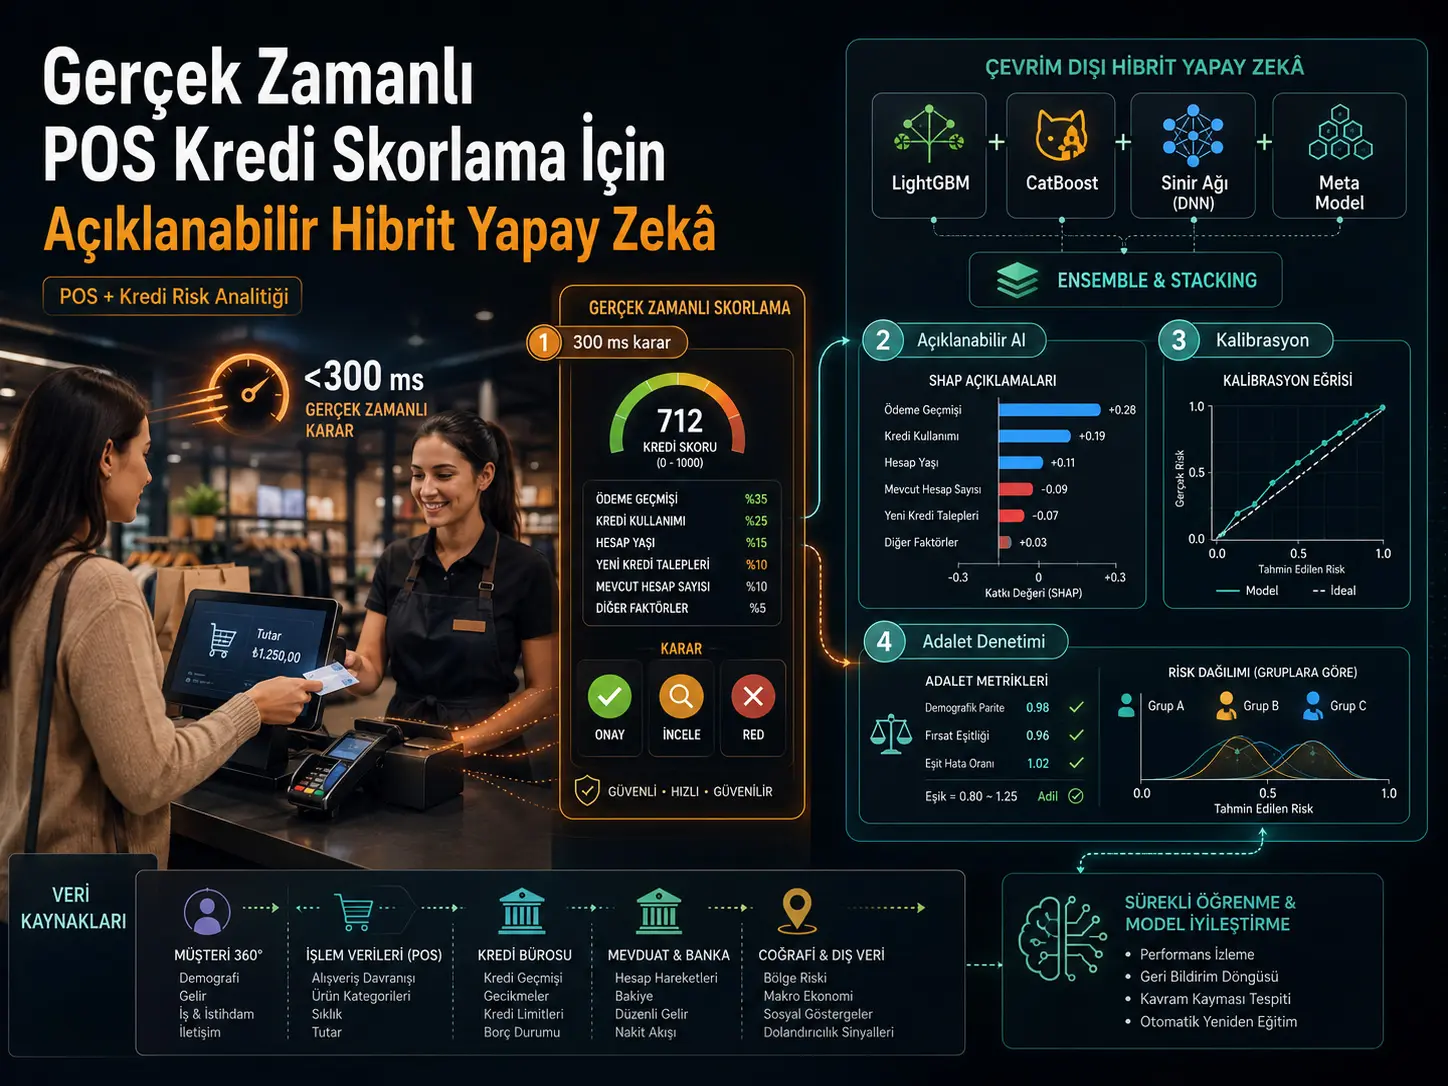
Bu çalışma, mağaza kasasında birkaç yüz milisaniye içinde kredi kararı verilmesi gereken satış noktası kredileri için tek bir yapay zekâ modelinin her koşulda yeterli olmayabileceği fikrinden hareket ediyor. Araştırmacılar bunun yerine iki farklı operasyonel ihtiyacı ayıran hibrit bir mimari geliştiriyor: gerçek zamanlı kanalda açıklanabilir ve düşük gecikmeli Weight of Evidence–Logistic Regression skor kartları; gecelik batch kanalında ise daha zengin müşteri verilerinden yararlanabilen LightGBM, CatBoost ve üç katmanlı sinir ağından oluşan kalibre edilmiş bir ensemble.
Çalışma Kazakistan'daki tek bir büyük ikinci-kademe bankanın üretim portföyünden elde edilen 806.537 analitik kayıt üzerinde gerçekleştirildi. Hedef değişken, bir kredinin gözlenen ömrü boyunca en az bir kez 90 veya daha fazla gün gecikmeye düşüp düşmediğini gösteren NPL91_EVER değişkenidir. Analitik örneklemde default oranı %10,22'dir.
Mevcut müşteriler için gerçek zamanlı LR-Old modeli test setinde:
\[ AUROC=0{,}8475,\qquad KS=0{,}5555,\qquad Gini=0{,}6950 \]
sonucuna ulaştı. Daha geniş offline veri setini kullanan Ens-Off ensemble'ı aynı mevcut-müşteri kohortunda:
\[ AUROC=0{,}9178,\qquad KS=0{,}6825,\qquad Gini=0{,}8356 \]
değerlerini verdi. Böylece test Gini değeri yaklaşık 0,141 mutlak puan yükseldi. Yeni müşteriler için kullanılan LR-New modelinin test AUROC değeri ise 0,8348 olarak raporlandı.
Ancak bu sonuçlar farklı ülkeler veya bankalar için hazır bir başarı garantisi değildir. Çalışmanın bütün verisi tek bir kurumdan gelmektedir; train, test ve validation kümeleri aynı 2023–2024 portföyünden rastgele oluşturulmuştur. Gerçek zaman dışı doğrulama ve ikinci bir portföy üzerinde dış doğrulama henüz yapılmamıştır.
Satış noktasında kredi skorlama neden farklı bir problem?
POS kredisi, müşterinin mağazada ürün satın alırken aynı işlem sırasında küçük veya orta büyüklükte tüketici kredisine başvurması anlamına gelir. Bu senaryoda kredi risk modeli yalnız yüksek tahmin doğruluğuna sahip olmak zorunda değildir; kredi kararının müşteriyi kasada bekletmeyecek kadar hızlı verilmesi gerekir.
Kaynak çalışmada operasyonel sınır yaklaşık:
\[ <300\ \mathrm{ms} \]
XML round-trip hizmet seviyesi olarak tanımlanmaktadır.
Aynı zamanda kasada müşteriden çok fazla bilgi istenmesi satış dönüşümünü düşürebileceğinden gerçek zamanlı payload'ın son derece sınırlı tutulduğu belirtilmektedir.
Bu iki gereksinim, kredi riskinde klasik bir mühendislik çatışması yaratır:
Daha fazla özellik genellikle daha yüksek tahmin gücü sağlayabilir; ancak bu özelliklerin tamamı karar anında erişilebilir veya yeterince hızlı olmayabilir.
Dual-track mimari ne anlama geliyor?
Çalışma bu çatışmayı tek bir modeli zorlayarak çözmek yerine iki kanala ayırmaktadır.
| Kanal | Model | Temel amaç | Kaynakta verilen zamanlama |
|---|---|---|---|
| Online | WOE–Logistic Regression | Kasada açıklanabilir, düşük gecikmeli kredi kararı | Gerçek zamanlı; XML round-trip hedefi <300 ms |
| Offline | LightGBM + CatBoost + sinir ağı stacked ensemble | Daha geniş müşteri verisiyle daha yüksek ayrım gücü ve kalibre edilmiş PD | Gecelik batch |
Online kanal doğrudan kredi kararına hizmet ederken offline modelin çıktısı müşteri-360 deposuna ve IFRS 9 risk veri katmanına geri yazılmaktadır.
Online özellik sayısında kaynak içi uyuşmazlık
Makalenin bu noktada kendi içinde tam olarak tutarlı olmadığı görülmektedir. Bölüm 3.5 ve Şekil 1 online roster'ı:
9 application XML alanı + 4 daha önceden saklanmış bureau alanı
olarak göstermektedir.
Buna karşılık Tablo 2, Şekil 2 ve model tanımı LR-Old ile LR-New'i:
9 özellikli modeller
olarak raporlamaktadır.
Kaynak, 4 bureau alanının karar motoruna gönderilip nihai dokuz özellik içinde seçilip seçilmediğini veya gerçekten 13 giriş kullanılıp kullanılmadığını açık biçimde uzlaştırmamaktadır. Bu nedenle model yeniden uygulanırken üretim feature roster'ının yazarlarla doğrulanması gerekir.
Veri seti nasıl oluşturuldu?
Kaynak başlangıçta:
\[ N=926.000 \]
POS kredi sözleşmesi bulunduğunu belirtmektedir.
Müşteri tarafından iptal edilen ve geri ödeme davranışı gözlenemeyen:
\[ 119.463 \]
kayıt çıkarıldıktan sonra:
\[ N=806.537 \]
analitik örnek kalmıştır.
Sınıf dağılımı:
\[ 89{,}78\%\ \text{non-default}, \qquad 10{,}22\%\ \text{default} \]
olarak verilmiştir.
Default nasıl tanımlandı?
Bağımlı değişken:
\[ y_i=NPL91\_EVER_i \]
olarak tanımlanır.
Bir sözleşme gözlenen süresi boyunca herhangi bir zamanda en az:
\[ 90\ \text{gün} \]
gecikmeye düşmüşse:
\[ y_i=1 \]
olarak işaretlenir.
Bu yapı modelin sürekli ödeme miktarını değil, belirlenen default olayının gerçekleşip gerçekleşmediğini tahmin eden ikili sınıflandırıcı olduğunu gösterir.
Bütün başvuru evreni temsil ediliyor mu?
Kaynak bazı bölümlerde veriyi “contracts”, bazı bölümlerde “loan applications” olarak adlandırmaktadır. Reddedilmiş ve dolayısıyla gelecekteki geri ödeme davranışı gözlenemeyen başvuruların analitik veri setine dahil edilip edilmediği açıklanmamaktadır.
Ayrıca klasik kredi riskinde kullanılan reject inference yaklaşımına ilişkin bir yöntem belirtilmemiştir.
Bu nedenle 806.537 kaydın bütün POS kredi başvuru evrenini mi yoksa esas olarak gözlenebilir geri ödeme performansına sahip sözleşmeleri mi temsil ettiği kaynaktan kesinleştirilememektedir. Bu ayrım, modelin yeni başvuru popülasyonuna aktarılabilirliği açısından önemlidir.
Mevcut ve yeni müşteriler neden ayrılıyor?
Portföy:
\[ N_{\mathrm{old}}=455.827 \]
mevcut müşteri ve:
\[ N_{\mathrm{new}}=350.710 \]
yeni müşteri olmak üzere iki segmente ayrılmıştır.
Bunun nedeni bankada daha önce ilişkisi bulunan kişiler için mevduat hareketleri, işlem davranışları veya kurum içi nakit akışı gibi geçmiş özelliklerin bulunabilmesi; yeni müşterilerde ise aynı sinyal setinin mevcut olmayabilmesidir.
Özellik aileleri neler?
İlk 148 aday değişkenden filtreleme sonrasında 101 değişken tutulmuştur. Kaynak bankacılık gizliliği nedeniyle gerçek üretim kolon adlarını açıklamamakta, yalnız semantik aileler vermektedir.
| Özellik ailesi | Filtre sonrası sayı | Genel içerik |
|---|---|---|
fcb_ | 31 | Kredi bürosu özellikleri |
app_ | 9 | Başvuru XML alanları |
prod_ | 4 | Kredi ürün taksonomisi |
trans_ | 18 | İşlem/harcama örüntüleri |
depo_ | 11 | Mevduat bakiyesi dinamikleri |
bank_ | 13 | Banka içi nakit giriş özellikleri |
geo_ | 6 | Adres tabanlı jeo-uzamsal risk özellikleri |
behav_ | 9 | Dijital oturum davranışı |
Özellik elemesi nasıl yapıldı?
Üç temel eşik uygulanmıştır:
\[ IV\geq0{,}10 \]
\[ missingness\leq80\% \]
\[ |\rho|\leq0{,}70 \]
Yüksek korelasyona sahip değişken çiftlerinden daha düşük Information Value değerine sahip olan özellik çıkarılmıştır.
Yüksek Information Value değerleri leakage olabilir miydi?
Çalışmada bazı kredi bürosu değişkenlerinin:
\[ IV>0{,}50 \]
değerine ulaşması nedeniyle ayrıca leakage kontrolü yapılmıştır.
Kaynak beş kontrol bildiriyor: özelliğin yalnız başvuru anına kadar mevcut veriyi kullanması, semantik olarak post-default bilgi içermemesi, WOE şeklinin ekonomik olarak makul olması, tek özellikli AUROC'nin olağan dışı biçimde yüksek olmaması ve zaman dilimleri arasında PSI kararlılığı.
En güçlü tek bureau özelliğinin univariate AUROC değeri 0,781 olarak raporlanmıştır. Çalışma bu sonuçlara dayanarak yüksek IV değerlerini leakage yerine kredi bürosu sorgu yoğunluğunun güçlü sinyali olarak yorumlamaktadır.
WOE neden gerçek zamanlı model için seçildi?
Weight of Evidence yaklaşımı her değişkeni risk seviyelerine göre bin'lere ayırarak default ve non-default dağılımı arasındaki oranı logaritmik olarak ifade eder:
\[ WOE_k= \ln \left( \frac{ P(x\in B_k\mid y=1) }{ P(x\in B_k\mid y=0) } \right). \]
Burada \(B_k\), değişkenin \(k\). bin'ini; \(y=1\) default sınıfını, \(y=0\) ise non-default sınıfını gösterir.
Bir özelliğin toplam ayırt ediciliği Information Value ile özetlenir:
\[ IV(x)= \sum_{k=1}^{K} (\hat p_{1,k}-\hat p_{0,k})WOE_k. \]
WOE dönüşümü özellikle kredi riskinde skor kartını düzenli, monoton ve insan tarafından incelenebilir hâle getirmek amacıyla kullanılmaktadır.
Gerçek zamanlı skor nasıl üretiliyor?
WOE dönüşümünden sonra L2 düzenlileştirmeli logistic regression uygulanır. Kaynak üretim skorunu:
\[ score(x) = Offset - Factor\cdot \langle\beta,WOE(x)\rangle \]
olarak tanımlar.
Burada:
\[ Factor=\frac{PDO}{\ln2} \]
ve:
\[ PDO=20 \]
olarak seçilmiştir.
PDO, default odds iki katına çıktığında skorun kaç puan değişeceğini ifade eden klasik kredi skorlama ölçekleme parametresidir.
Offline ensemble nasıl oluşturuldu?
Ens-Off modeli üç farklı temel öğreniciyi kullanmaktadır:
- LightGBM,
- CatBoost,
- üç gizli bloklu tam bağlantılı sinir ağı.
Her modelin beş katlı stratified cross-validation sırasında oluşturduğu out-of-fold olasılıkları logistic-regression meta-learner'a verilir:
\[ \hat p_i^{stack} = \sigma \left( \alpha_0 + \alpha_1\hat p_i^{LGBM} + \alpha_2\hat p_i^{CB} + \alpha_3\hat p_i^{NN} \right). \]
Buradaki:
\[ \sigma(z)=\frac{1}{1+e^{-z}} \]
logistic sigmoid fonksiyonudur.
Ardından yalnız bu birleşik stacked score üzerine isotonic regression uygulanmaktadır:
\[ \hat p_i^{cal} = g_{\mathrm{iso}} ( \hat p_i^{stack} ). \]
Yani LightGBM, CatBoost ve sinir ağı ayrı ayrı kalibre edilmemiştir; önce stack edilmiş, ardından birleşik çıktı kalibre edilmiştir.
Sinir ağı mimarisi ne?
Kaynağın temel sinir ağı yapısı:
\[ 72 \rightarrow 256 \rightarrow 128 \rightarrow 64 \rightarrow 1 \]
şeklindedir.
ReLU aktivasyonları, batch normalisation ve:
\[ dropout=0{,}30 \]
kullanılmıştır.
İkinci ve üçüncü gizli blok arasına tek bir self-attention head eklenerek tabular özellikler arasındaki etkileşimlerin modellenmesi amaçlanmıştır.
Hiperparametre araması nasıl yapıldı?
LightGBM, CatBoost ve sinir ağı için Optuna Tree-Structured Parzen Estimator kullanılarak ayrı ayrı:
\[ 30 \]
deneme yapılmıştır.
Optimizasyon hedefi beş katlı stratified cross-validation AUROC'sidir.
Kaynakta verilen yaklaşık tuning süreleri:
| Model | 30 Optuna denemesi için süre |
|---|---|
| LightGBM | 42 dakika |
| CatBoost | 78 dakika |
| Sinir ağı | 96 dakika |
Toplam tuning maliyeti yaklaşık 3,6 GPU-saat olarak raporlanmıştır. Donanım bir NVIDIA T4 16 GB GPU, 16 vCPU ve 64 GB RAM'dir.
Random split neden önemli bir sınırlılık?
Her müşteri segmenti:
\[ 70\%/20\%/10\% \]
train/test/validation şeklinde stratified random sampling ile bölünmüştür.
Bu yöntem aynı veri üretim döneminden bağımsız tutulmuş hold-out örnekler oluşturur; ancak gelecekteki ekonomik döneme aktarılabilirliği test etmez.
Çalışmanın kendi gelecek çalışma bölümünde Q2–Q4 2024 originasyonlarından gerçek bir out-of-time cohort kullanılacağı belirtilmektedir. Dolayısıyla mevcut validation sonucu dış veya zamansal doğrulama olarak yorumlanmamalıdır.
Kalibrasyon neden kredi riskinde kritik?
AUROC yalnız iyi ve kötü müşterilerin ne kadar doğru sıralandığını ölçer. Bankacılık uygulamasında ise modelin ürettiği:
\[ PD=P(\mathrm{default}) \]
değerinin mutlak düzeyi de önemlidir.
Çünkü kaynakta PD'nin IFRS 9 beklenen kredi zararı, risk tabanlı fiyatlama ve kredi cut-off kararlarında kullanıldığı belirtilmektedir.
Kalibrasyon hatası Brier skoru ile ölçülür:
\[ Brier= \frac{1}{N} \sum_{i=1}^{N} (\hat p_i-y_i)^2. \]
Daha düşük Brier değeri, tahmin edilen olasılıkların gerçekleşen sonuçlarla daha yakın olduğunu gösterir.
Brier skorunda kaynak-içi ciddi uyuşmazlık
Çalışmanın anlatı metni isotonic calibration sonrasında Brier skorunun yaklaşık:
%18 azaldığını
söylemektedir.
Ancak Şekil 5'te basılan değerler:
\[ Brier_{\mathrm{raw}}=0{,}1918 \]
ve:
\[ Brier_{\mathrm{iso}}=0{,}0726 \]
şeklindedir.
Bu iki sayı arasındaki mutlak fark:
\[ 0{,}1192 \]
olup göreli azalma yaklaşık:
\[ 62{,}1\% \]
seviyesindedir.
Dolayısıyla “%18” ifadesi ile şekil içindeki Brier değerleri aynı anda doğru olamaz. Kaynaktan hangi tarafın yazım veya hesaplama hatası içerdiği belirlenememektedir.
Online scorecard'ların kalibrasyonu gösterildi mi?
Kaynak iki WOE–Logistic Regression skor kartının “tasarım gereği iyi kalibre” olduğunu ve ek düzeltmeye ihtiyaç duymadığını belirtmektedir.
Ancak offline ensemble için sunulan reliability curve ve Brier karşılaştırmasının eşdeğeri LR-Old ve LR-New için verilmemiştir.
Bu nedenle online modellerin kalibrasyon kalitesi kaynakta ensemble kadar ayrıntılı ampirik kanıtla gösterilmemektedir.
Model kararlılığı nasıl ölçüldü?
Population Stability Index:
\[ PSI = \sum_{k=1}^{B} (p_k^{ref}-p_k^{obs}) \ln \left( \frac{p_k^{ref}}{p_k^{obs}} \right) \]
ile hesaplanmıştır.
Kaynak:
\[ PSI<0{,}10 \]
değerini kararlı, 0,10–0,25 aralığını dikkat ve 0,25 üzerini aksiyon seviyesi olarak kullanmaktadır.
Train–test score PSI değerleri:
| Model | Train–test PSI |
|---|---|
| LR-Old | 0,014 |
| Ens-Off | 0,021 |
| LR-New | 0,012 |
Ens-Off için train–validation PSI 0,018 olarak verilmiştir.
En yüksek feature PSI değerleri
En yüksek iki feature-level PSI:
\[ app\_feature3=0{,}064 \]
ve:
\[ trans\_feature1=0{,}057 \]
olarak raporlanmıştır.
Her iki değer de kaynağın kullandığı 0,10 attention eşiğinin altındadır.
Ancak Şekil 6'nın değişken etiketlerinde app_feature3 iki kez görünmektedir. Bu tekrarın hangi gerçek değişkene karşılık geldiği kaynak metninden belirlenememektedir.
Score-band analizi ne gösteriyor?
Ens-Off test seti risk sırasına göre on eşit gruba ayrılmıştır.
| Risk bandı | Gözlenen default oranı (%) | Kümülatif yakalanan defaulter (%) | Kaynak politika etiketi |
|---|---|---|---|
| 1 — en riskli | 34,2 | 31,0 | Decline |
| 2 | 21,5 | 50,5 | Decline |
| 3 | 15,0 | 64,1 | Manual review |
| 4 | 11,1 | 74,2 | Manual review |
| 5 | 8,9 | 82,2 | Approve |
| 6 | 7,0 | 88,6 | Approve |
| 7 | 5,5 | 93,6 | Approve |
| 8 | 4,2 | 97,4 | Approve |
| 9 | 3,0 | 99,1 | Approve / pre-approved |
| 10 — en güvenli | 1,7 | 100,0 | Approve / pre-approved |
En riskli ilk %10'luk grup tek başına bütün defaulter'ların %31'ini, ilk iki grup ise %50,5'ini içermektedir.
%60 kabul oranında ne oluyor?
Kaynağın acceptance-rate sensitivity analizinde toplam başvuruların %60'ının kabul edildiği noktada kabul edilen müşterilerin bad-rate'i:
\[ 5{,}6\% \]
Ens-Off için ve:
\[ 8{,}0\% \]
LR-Old için raporlanmıştır.
Aradaki fark:
\[ 2{,}4\ \text{yüzde puanı} = 240\ \text{baz puan} \]
olmaktadır.
Bu sonuç, daha zengin offline modelin aynı kabul oranında daha düşük riskli bir grup seçebildiğini gösteren retrospektif bir model sonucudur. Gerçekleşmiş kredi zararı veya nedensel kârlılık artışı olarak yorumlanmamalıdır.
SHAP açıklaması nasıl üretim kararına çevriliyor?
Ens-Off için global SHAP sıralamasında kredi bürosu yoğunluğu ailesi öne çıkmaktadır. IV sırası ile ortalama mutlak SHAP sırası arasındaki Spearman korelasyonu:
\[ \rho=0{,}86, \qquad p<0{,}001 \]
olarak raporlanmıştır.
Üretim seviyesinde ise her başvuru için SHAP katkıları sıralanmakta ve en güçlü olumsuz dört etken insan tarafından okunabilir reason code'lara çevrilmektedir.
Kaynağın anonim örneğinde reddedilen bir başvurunun temel olumsuz etkenleri:
| Sürücü | SHAP katkısı — log-odds | Reason code |
|---|---|---|
| Yüksek yakın dönem kredi bürosu sorgu yoğunluğu | +0,78 | R-01 |
| Yüksek talep edilen kredi / gelir oranı | +0,54 | R-04 |
| Yakın dönem bureau delinquency | +0,39 | R-02 |
| Düşük yakın dönem mevduat bakiyesi | +0,21 | R-07 |
Pozitif SHAP değerleri burada modelin default log-odds'unu artıran faktörleri temsil etmektedir.
Fairness audit ne ölçüyor?
Çalışma üç demografik eksen kullanmıştır:
- kadın / erkek,
- 18–30, 31–45, 46–60 ve 60+ yaş grupları,
- kentsel / kırsal ikamet.
Bütün gruplardaki AUROC değerleri:
\[ 0{,}913-0{,}922 \]
aralığındadır.
Kaynağın raporladığı maksimum mutlak farklar:
| Fairness metriği | Maksimum mutlak grup farkı (yüzde puanı) |
|---|---|
| Demographic parity | 1,2 |
| TPR gap | 1,4 |
| FPR gap | 0,6 |
| PPV gap | 1,3 |
Bu sonuçlar incelenen test kohortunda belirtilen demografik dilimler arasında küçük farklar raporlandığını göstermektedir.
Ancak grup örneklem büyüklükleri ve bu farkların güven aralıkları verilmemiştir. Ayrıca incelenmeyen demografik özellikler açısından sonuç çıkarılamaz.
Fairness denklemindeki yön sorunu
Makale demographic parity için:
\[ \Delta DP_g = P(\hat y=1\mid G=g) - P(\hat y=1) \]
ifadesini verir ve bunu approval-rate farkı olarak açıklar.
Bununla birlikte aynı bölümde:
\[ TPR_g=P(\hat y=1\mid y=1,G=g) \]
true defaulter'ların doğru biçimde elenmesi,
\[ FPR_g=P(\hat y=1\mid y=0,G=g) \]
ise sağlam başvuruların yanlış reddedilmesi olarak yorumlanmaktadır.
Bu tanımlarda \(\hat y=1\) “riskli/reddedilen” karara karşılık geliyorsa ilk formüldeki \(P(\hat y=1)\) matematiksel olarak approval rate değil, predicted-positive/decline rate olur. Kaynak bu işaret ve karar kodlama ayrımını açıklamamaktadır.
KMeans segmentasyonu modele dahil mi?
Hayır. Mevcut müşteriler üzerinde yapılan KMeans analizi yalnız yönetimsel yorum katmanı olarak kullanılmıştır.
Dört kümenin default oranları yaklaşık %4,1 ile %21,6 arasında değişmektedir. En düşük risk profili düşük bureau aktivitesi ve yüksek para girişi; en yüksek risk profili yüksek bureau aktivitesi ve düşük para girişi olarak tanımlanmıştır.
Yazarlar cluster etiketlerini üç kredi modelinde predictor olarak kullanmadıklarını özellikle belirtmektedir.
Ayrıca cluster stability bootstrap analizi yapılmadığı için çalışma bu segmentasyonu karar modeli değil, danışman niteliğinde yönetim çerçevesi olarak sınırlandırmaktadır.
MLOps mimarisi nasıl?
Üretim mimarisinde model artefact'ları MLflow ve Git etiketleriyle sürümlenmektedir.
Kaynağın izleme düzeni:
- aylık performans/kararlılık hesapları,
- üç aylık champion–challenger governance review,
- feature PSI > 0,25 olduğunda retraining trigger,
- KS performansı development seviyesine göre %10'dan fazla düştüğünde retraining trigger
şeklinde tarif edilmektedir.
Türkiye açısından ne ifade ediyor?
Çalışma Türkiye'deki bir bankanın verisini içermemektedir ve Türkiye'deki kredi mevzuatı veya müşteri davranışı üzerinde doğrulanmamıştır.
Buna karşılık teknik mimari Türkiye açısından kavramsal olarak anlamlıdır: karar anında erişilebilen sınırlı ve düşük gecikmeli bilgilerle çalışan açıklanabilir bir online skor kartı ile daha geniş müşteri verisini kullanan gecelik veya arka-plan risk modelinin ayrılması, veri erişim süresi ile model karmaşıklığını birbirinden ayıran genel bir mühendislik yaklaşımıdır.
Türkiye'deki bir uygulamada WOE bin'leri, kredi bürosu yapısı, gelir/borç davranışı, default tanımı, fairness grupları, model yönetişimi ve hukuki gerekliliklerin yerel veri ve düzenlemelerle sıfırdan doğrulanması gerekir. Kazakistan'daki AUROC veya Gini sonuçları Türkiye portföyüne doğrudan taşınamaz.
Çalışmanın desteklediği sonuçlar
- Aynı mevcut-müşteri test kohortunda 72 özellikli offline ensemble, 9 özellikli olarak raporlanan LR-Old skor kartından daha yüksek AUROC, KS ve Gini üretmiştir.
- Mevcut ve yeni müşteriler için kullanılan online WOE-LR modelleri kaynak test setinde sırasıyla yaklaşık 0,847 ve 0,835 AUROC vermiştir.
- Offline ensemble test AUROC'su yaklaşık 0,918 ve Gini'si yaklaşık 0,836'dır.
- Offline modelde kredi bürosu, banka içi nakit akışı, mevduat ve işlem verileri önemli predictive signal taşımaktadır.
- Score-band analizi default riskinin en riskli banttan en güvenli banda doğru düzenli olarak azaldığını göstermektedir.
- İncelenen demografik dilimlerde kaynak tarafından küçük fairness gap değerleri raporlanmıştır.
- SHAP katkıları üretim seviyesinde reason code'lara çevrilen bir açıklama hattı olarak tasarlanmıştır.
- Çalışma monitoring, model registry ve retraining trigger'larını içeren uçtan uca bir MLOps yaklaşımı tarif etmektedir.
Çalışmanın desteklemediği veya kanıtlamadığı sonuçlar
- Modelin başka bankalarda, ülkelerde veya ekonomik dönemlerde aynı performansı göstereceği kanıtlanmamıştır.
- Gerçek out-of-time veya ikinci kurum üzerinde external validation yapılmamıştır.
- Random hold-out validation ekonomik rejim değişimine karşı dayanıklılık testi değildir.
- Fairness audit bütün olası demografik gruplarda ayrımcılığın bulunmadığını kanıtlamaz.
- SHAP kullanılması tek başına mevzuata tam uyumluluk sertifikası anlamına gelmez.
- %60 kabul oranındaki 240 baz puanlık bad-rate farkı gerçekleşmiş finansal zarar azalması değildir.
- KMeans segmentleri kredi kararında doğrulanmış causal risk segmentleri değildir.
- Çalışma recession veya makroekonomik stress döneminde test edilmemiştir.
- Kaynakta rejected applicants ve reject inference konusunda yeterli bilgi bulunmadığından modelin bütün başvuru evrenine temsil kabiliyeti kesinleştirilemez.
- Brier skorundaki %18 kalibrasyon iyileşmesi, Şekil 5'te verilen 0,1918 → 0,0726 değerleriyle matematiksel olarak uyuşmamaktadır.
Çalışmanın Yöntemi ve Bulguları
Analitik popülasyon
| Aşama | Kayıt sayısı |
|---|---|
| Başlangıç POS kredi kayıtları | 926.000 |
| Müşteri tarafından iptal edilen ve çıkarılan kayıtlar | 119.463 |
| Nihai analitik örneklem | 806.537 |
| Mevcut müşteriler | 455.827 |
| Yeni müşteriler | 350.710 |
Model ve segment yapısı
| Model | Segment | Algoritma | Kaynakta verilen özellik sayısı | Kanal |
|---|---|---|---|---|
| LR-Old | Mevcut müşteri | WOE + L2 Logistic Regression | 9 | Gerçek zamanlı |
| Ens-Off | Mevcut müşteri | LightGBM + CatBoost + NN + logistic stacking + isotonic calibration | 72 | Gecelik batch |
| LR-New | Yeni müşteri | WOE + L2 Logistic Regression | 9 | Gerçek zamanlı |
Kaynak notu: Bölüm 3.5 ve Şekil 1 online roster için ayrıca dört bureau özelliği gösterdiğinden online feature count kaynak içinde tam olarak tutarlı değildir.
Train/test/validation büyüklükleri
| Segment/model | Train | Test | Validation |
|---|---|---|---|
| Mevcut müşteri — LR | 319.078 | 91.211 | 45.538 |
| Mevcut müşteri — Ensemble | 319.078 | 91.211 | 45.538 |
| Yeni müşteri — LR | 245.497 | 70.177 | 35.036 |
Ana discrimination sonuçları
| Model | Train AUROC | Test AUROC | Validation AUROC | Test KS | Test Gini |
|---|---|---|---|---|---|
| LR-Old | 0,8472 | 0,8475 | Raporlanmadı | 0,5555 | 0,6950 |
| Ens-Off | 0,9327 | 0,9178 | 0,9171 | 0,6825 | 0,8356 |
| LR-New | 0,8345 | 0,8348 | Raporlanmadı | 0,5310 | 0,6696 |
Ens-Off'un train AUROC'su 0,9327'den testte 0,9178'e düşmektedir. Validation AUROC'sunun 0,9171 olması aynı rastgele ayrılmış veri penceresi içindeki hold-out performansın test sonucuna yakın olduğunu göstermektedir; bu sonuç zamansal veya kurumsal transportability kanıtı değildir.
Verianla Live: Aynı mevcut-müşteri kohortunda online ve offline kredi modeli
Aşağıdaki karşılaştırma yalnız aynı mevcut-müşteri test setindeki LR-Old ve Ens-Off modellerini içerir. Her üç metrik 0–1 ölçeğindedir ve daha yüksek değer daha güçlü sınıf ayrımına karşılık gelir.
| Model | Test AUROC | Test KS | Test Gini |
|---|---|---|---|
| LR-Old — gerçek zamanlı skor kartı | 0.8475 | 0.5555 | 0.6950 |
| Ens-Off — offline ensemble | 0.9178 | 0.6825 | 0.8356 |
Verianla Live: Değerler çalışmanın Tablo 6'sındaki mevcut-müşteri test sonuçlarıdır. Karşılaştırma aynı kohort üzerinde yapıldığı için yeni-müşteri LR-New modeli bu görselleştirmeye dahil edilmemiştir.
Verianla Live karşılaştırmasının ana mesajı, offline ensemble'ın aynı mevcut-müşteri test popülasyonunda üç discrimination metriğinde de gerçek zamanlı skor kartından daha yüksek değer üretmesidir. Bunun bedeli, daha geniş feature roster, daha karmaşık model, ayrı inference altyapısı ve gerçek zaman yerine gecelik batch kanalının kullanılmasıdır.
Aynı kohorttaki baseline karşılaştırması
| Model | AUROC | Gini |
|---|---|---|
| Tek fcb_feature1 Logistic Regression | 0,781 | 0,562 |
| Vanilla LR — WOE yok | 0,821 | 0,642 |
| Standalone LightGBM | 0,910 | 0,820 |
| LR-Old | 0,847 | 0,695 |
| Ens-Off | 0,918 | 0,836 |
Bu tablo özellikle ensemble ile standalone LightGBM arasındaki farkın, online LR ile ensemble arasındaki farktan çok daha küçük olduğunu gösterir. Ens-Off'un AUROC'su standalone LightGBM'den 0,008 daha yüksektir.
En bilgilendirici predictor aileleri
En yüksek Information Value değerleri ağırlıklı olarak kredi bürosu özelliklerinde görülmektedir.
| Özellik | Genel açıklama | IV — mevcut müşteri | IV — yeni müşteri |
|---|---|---|---|
| fcb_feature2 | En kötü bureau delinquency şiddeti | 0,730 | 0,660 |
| fcb_feature3 | Aktif bureau kredi ilişkilerinin genişliği | 0,725 | 0,295 |
| fcb_feature1 | Yakın dönem bureau sorgu yoğunluğu | 0,715 | 0,640 |
| app_feature1 | Beyan edilen gelir | 0,640 | 0,450 |
| app_feature2 | Talep edilen tutar / gelir oranı | 0,635 | 0,555 |
Operating point sonucu
Ens-Off için Youden-optimal eşik yaklaşık:
\[ \hat p^\star=0{,}456 \]
olarak verilmiştir.
Bu noktada:
\[ Sensitivity=0{,}716 \]
ve:
\[ Specificity=0{,}881 \]
raporlanmaktadır.
Test confusion matrix:
| Predicted 0 | Predicted 1 | |
|---|---|---|
| Actual 0 | 72.145 | 9.745 |
| Actual 1 | 2.647 | 6.674 |
Kalibrasyon sonucu ve sorunlu raporlama
| Ens-Off çıktısı | Şekil 5'teki Brier skoru |
|---|---|
| Isotonic öncesi stacked meta-learner | 0,1918 |
| Isotonic sonrası production PD | 0,0726 |
Şekilde verilen değerler yaklaşık %62,1 göreli azalmaya karşılık gelir. Buna karşın özet, sonuçlar ve sonuç bölümü yaklaşık %18 azalma bildirmektedir. Bu nedenle kalibrasyonun yönü açıkça iyileşme gösterse de iyileşmenin büyüklüğü kaynak metinde güvenilir biçimde tek bir yüzdeyle raporlanamamaktadır.
Fairness sonuçları
| Grup | AUROC | ΔDP (puan) | ΔTPR (puan) | ΔFPR (puan) | ΔPPV (puan) |
|---|---|---|---|---|---|
| Kadın | 0,916 | +0,3 | +0,4 | +0,2 | −0,5 |
| Erkek | 0,920 | −0,2 | −0,3 | −0,1 | +0,4 |
| 18–30 | 0,913 | −1,2 | −1,4 | −0,6 | −1,3 |
| 31–45 | 0,919 | +0,1 | +0,2 | +0,1 | +0,2 |
| 46–60 | 0,922 | +0,5 | +0,6 | +0,3 | +0,7 |
| 60+ | 0,917 | +0,8 | +0,9 | +0,4 | +0,9 |
| Kentsel | 0,919 | +0,2 | +0,3 | +0,1 | +0,3 |
| Kırsal | 0,914 | −0,9 | −1,1 | −0,5 | −1,0 |
En büyük mutlak fark 18–30 yaş grubundaki −1,4 puanlık TPR farkıdır. Ancak bu tablonun güven aralığı veya grup bazında \(n\) değerleri verilmediğinden sonuçların belirsizliği nicel olarak gösterilmemektedir.
Decision Curve Analysis raporlandı mı?
Şekil 2'deki pipeline değerlendirme bileşenleri arasında DCA da listelenmektedir. Buna rağmen sonuç bölümlerinde Decision Curve Analysis sonucu veya grafiği bulunmamaktadır.
Çalışmanın gelecek çalışma bölümünde DCA'nın daha sonra politika eşikleriyle uyumlu biçimde sunulacağı belirtilmektedir. Bu nedenle mevcut makale DCA'yı tamamlanmış analiz olarak desteklememektedir.
Üretim ve yeniden eğitim mantığı
Kaynağın önerdiği operasyonel döngü:
model registry → aylık monitoring → üç aylık governance review → threshold ihlalinde yeniden eğitim
şeklindedir.
Retraining için bildirilen iki ana koşul:
\[ PSI_{\mathrm{feature}}>0{,}25 \]
veya:
\[ KS\ \text{düşüşü}>10\% \]
olmasıdır.
Çalışmanın ana mühendislik katkısı
Makalenin katkısı yeni bir gradient-boosting algoritması, yeni bir SHAP yöntemi veya yeni bir calibration tekniği geliştirmek değildir. Yazarlar bunu açıkça “real-world implementation study” olarak konumlandırmaktadır.
Özgünlük iddiası esas olarak şu bileşenlerin tek bir operasyonel yapıda birleştirilmesine dayanır:
feature availability → kanal ayrımı → WOE-LR → ensemble → isotonic calibration → SHAP reason codes → fairness audit → PSI/KS monitoring → champion–challenger governance.
En önemli sınırlılıklar
- Tek finansal kurumun verisi kullanılmıştır.
- Random split kullanılmış; gerçek out-of-time validation yapılmamıştır.
- Ekonomik durgunluk veya farklı faiz/enflasyon rejiminde stress validation bulunmamaktadır.
- Çok yüksek IV değerleri zaman içinde yeniden incelenmek zorundadır.
- En yüksek risk decile'ında isotonic modelin hafif risk aşırı tahmini sürmektedir.
- KMeans segmentasyonu için bootstrap cluster-stability analizi yapılmamıştır.
- Online feature count kaynak içinde tutarlı değildir.
- Brier iyileşmesinin yüzde değeri kaynak içindeki sayılarla uyuşmamaktadır.
- Fairness audit'te grup büyüklüğü ve uncertainty aralıkları verilmemiştir.
- Reddedilmiş başvuruların analitik popülasyondaki statüsü ve reject inference yaklaşımı açıklanmamaktadır.
- Ham kredi kayıtları bankacılık gizliliği nedeniyle kamuya açık değildir.
Gelecek araştırmalar
Kaynak dört ana sonraki adımı tanımlar:
- 2024 Q2–Q4 originasyonları üzerinde gerçek out-of-time validation,
- banka politika eşikleriyle decision-curve analysis,
- belirsiz vakaları manuel underwriting'e yönlendirmek için conformal prediction,
- başka bir gelişmekte olan pazarın POS portföyünde transportability değerlendirmesi.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: An Explainable Hybrid AI Framework for Real-Time Point-of-Sale Credit Scoring
Yazarlar: Gulnaz Zakariya; Aiman Moldagulova; Nor’ashikin Ali.
Eş birinci/eş katkı: Kaynakta belirtilmemiştir.
Sorumlu yazar: Aiman Moldagulova.
Kurumlar: Department of Software Engineering, Satbayev University, Almaty, Kazakhstan; Department of Cybersecurity, Information Processing and Storage, Satbayev University, Almaty, Kazakhstan; Department of Information Systems, Universiti Tenaga Nasional, Kajang, Selangor, Malaysia.
Kaynak türü: Hakemli özgün araştırma makalesi; retrospektif tek-portföy kredi risk model geliştirme ve internal validation çalışması.
Dergi: AI.
Yayınevi: MDPI.
Bibliyografik kayıt: AI, 2026, Cilt 7, Sayı 6, Makale 211.
DOI: 10.3390/ai7060211.
Alınma / revizyon / kabul / yayın: 11 Mayıs 2026 / 7 Haziran 2026 / 8 Haziran 2026 / 9 Haziran 2026.
Hakemlik durumu: Hakemli dergi yayınıdır.
Lisans: Creative Commons Attribution (CC BY).
Academic Editors: Albert Y.S. Lam; Andy Chun.
Çalışma dönemi: 1 Ocak 2023–31 Mart 2024.
Başlangıç kayıt sayısı: 926.000.
Analitik örneklem: 806.537.
Default oranı: %10,22.
Default tanımı: Gözlenen sözleşme ömrü boyunca en az bir kez 90 veya daha fazla gün gecikme; NPL91_EVER.
Müşteri segmentleri: 455.827 mevcut müşteri ve 350.710 yeni müşteri.
Ana model 1: LR-Old — mevcut müşteriler için WOE + L2 Logistic Regression gerçek zamanlı skor kartı.
Ana model 2: Ens-Off — mevcut müşteriler için LightGBM + CatBoost + üç katmanlı neural network stacked ensemble ve isotonic calibration.
Ana model 3: LR-New — yeni müşteriler için WOE + L2 Logistic Regression gerçek zamanlı skor kartı.
Model seçimi/tuning: Stratified five-fold cross-validation ve Optuna TPE; her ensemble base learner için 30 deneme.
Test AUROC: LR-Old 0,8475; Ens-Off 0,9178; LR-New 0,8348.
Test Gini: LR-Old 0,6950; Ens-Off 0,8356; LR-New 0,6696.
Test KS: LR-Old 0,5555; Ens-Off 0,6825; LR-New 0,5310.
Ens-Off validation AUROC: 0,9171. Bu validation aynı çalışma döneminden random hold-out'tur; external veya out-of-time validation değildir.
Explainability: LightGBM ve CatBoost için TreeSHAP, neural component için KernelSHAP; record-level en güçlü olumsuz katkılar adverse-action reason code'lara dönüştürülmektedir.
Fairness: Cinsiyet, yaş grubu ve kentsel/kırsal ikamet için demographic parity, TPR, FPR ve PPV farkları incelenmiştir.
Monitoring: PSI, KS ve bad-rate; aylık izleme, üç aylık governance değerlendirmesi.
Finansman: Çalışma dış finansman almadığını bildirmektedir.
Etik kurul: Uygulanabilir değil olarak belirtilmiştir. Kaynak, kimliği kaldırılmış ve kurum içi bankacılık verilerinin kullanıldığını, insan-denek araştırması yapılmadığını bildirmektedir.
Bilgilendirilmiş onam: Uygulanabilir değil olarak bildirilmiştir.
Veri erişilebilirliği: Ham kredi düzeyindeki veri bankacılık gizliliği nedeniyle kamuya açık değildir. Kaynak; anonim aggregate istatistiklerin, feature-family düzeyindeki sözlüğün, WOE bin tanımlarının, iki production scorecard katsayısının ve figure-generation kodunun makul talep ve veri kullanım anlaşması altında sorumlu yazardan istenebileceğini belirtmektedir.
Yazar katkıları: Kavramsallaştırma G.Z. ve A.M.; metodoloji, yazılım, formal analiz, araştırma, veri kürasyonu, ilk taslak ve görselleştirme G.Z.; doğrulama bütün yazarlar; kaynaklar ve proje yönetimi A.M.; danışmanlık A.M. ve N.A.; gözden geçirme/düzenleme A.M. ve N.A.
Çıkar çatışması: Yazarlar çıkar çatışması bildirmemiştir. Partner finansal kurumun yöntem seçimi, değerlendirme ölçütleri, makale yazımı veya yayın kararında rol almadığı belirtilmektedir.
Kaynak sadakati açısından kritik notlar
Kalibrasyon: Metindeki “yaklaşık %18 Brier azalması” ile Şekil 5'teki 0,1918 → 0,0726 sayıları uyuşmamaktadır. Verianla bu iki bilgiden birini kaynak adına düzeltmemektedir.
Online model roster'ı: Şekil 1 ve Bölüm 3.5 online yol için 9 application + 4 bureau alanı gösterirken Tablo 2 ve model özetleri 9 özellik raporlamaktadır. Nihai production input count kaynakta açık değildir.
Validation: “Validation” terimi random hold-out anlamındadır; gerçek zaman dışı doğrulama gelecek çalışma olarak bırakılmıştır.
DCA: Şekil 2 pipeline'ında DCA listelenmesine karşın mevcut sonuç bölümünde DCA bulunmamakta ve gelecek çalışma olarak önerilmektedir.
Fairness: Demographic-parity formülünün pozitif sınıf yönü ile “approval rate” açıklaması arasında terminolojik/matematiksel belirsizlik vardır.
Veri popülasyonu: Çalışma “contracts” ve “loan applications” ifadelerini dönüşümlü kullanmaktadır; rejected-applicant popülasyonu ve reject inference süreci açıklanmamıştır.
Bilimsel yorum sınırı
Bu çalışma gerçek bir banka portföyünde geliştirilmiş üretim odaklı kredi risk mimarisini raporlamaktadır; ancak raporlanan performans tek kurum ve tek ülke bağlamına aittir.
AUROC 0,918 veya Gini 0,836 gibi değerler başka bir bankanın müşteri kitlesinde beklenen performans olarak kullanılamaz. Kredi bürosu kapsamı, müşteri davranışı, ürün tasarımı, ekonomik rejim ve feature availability değiştiğinde model performansı da değişebilir.
Fairness sonuçları yalnız incelenen demografik grupları ve incelenen test setini kapsar. Küçük gap değerleri hukuki veya etik açıdan evrensel “adil model” sertifikası değildir.
Benzer biçimde SHAP reason code sistemi açıklanabilirliği destekleyen bir mühendislik mekanizmasıdır; tek başına bütün model yönetişimi veya düzenleyici uyum gerekliliklerinin karşılandığını kanıtlamaz.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir