

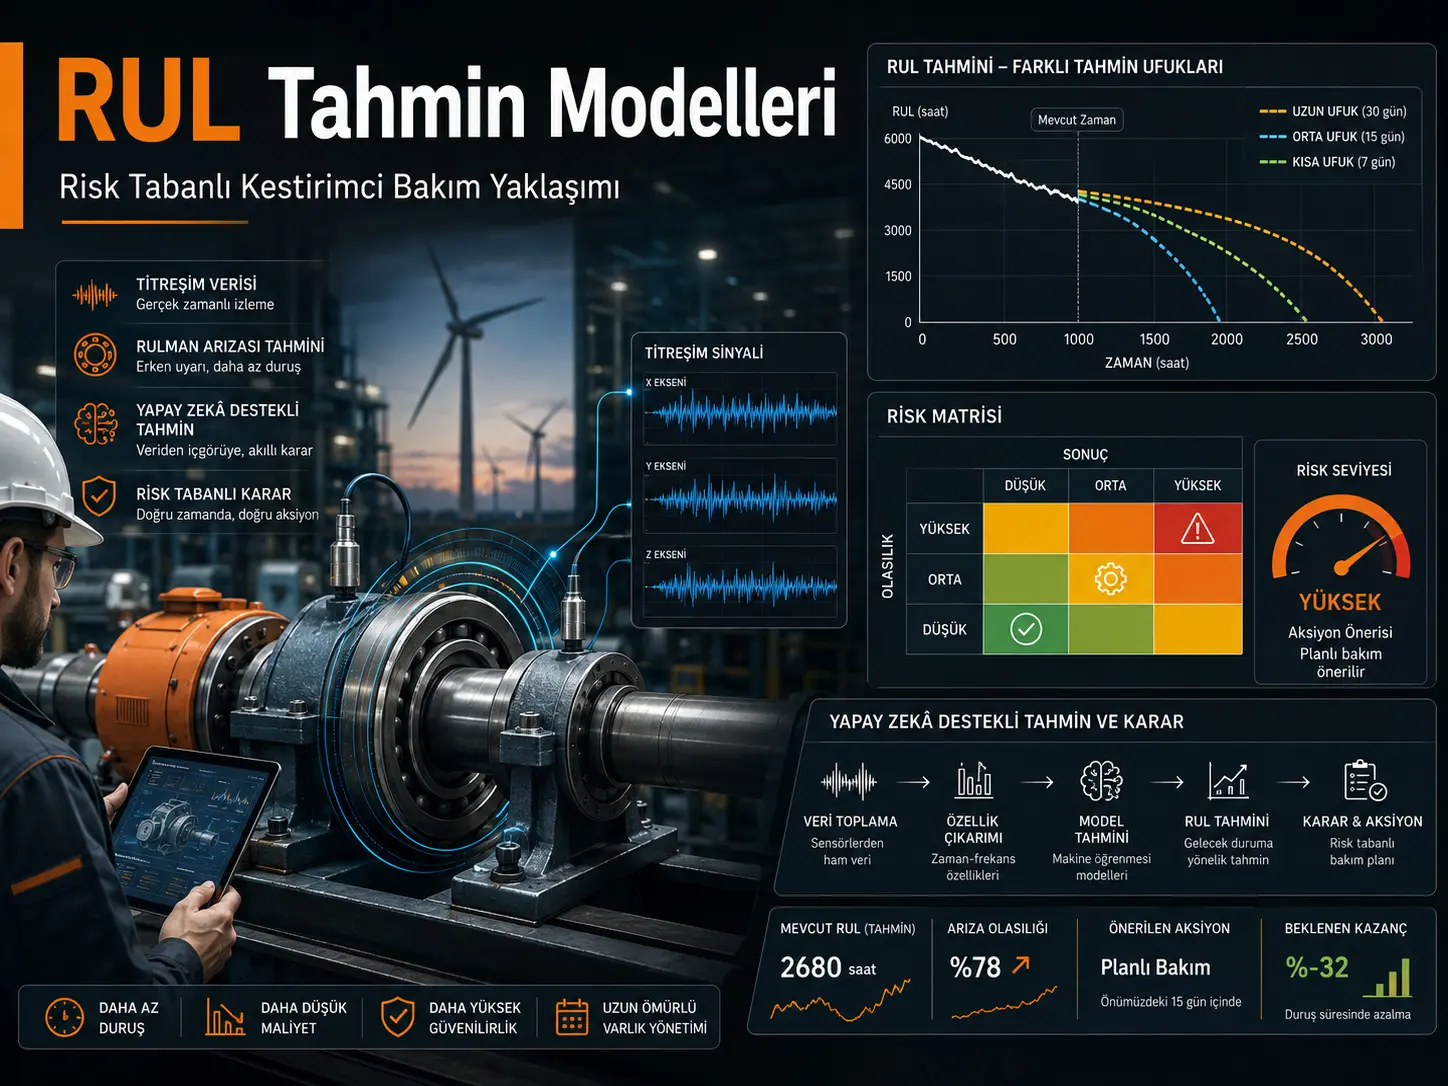
Bir makinenin ne zaman arızalanacağını doğru tahmin etmek, kestirimci bakım için tek başına yeterli olmayabilir. Bakım ekibinin yedek parça tedariki, personel planlaması, üretim duruşu veya müdahale hazırlığı yapabilmesi için tahminin aynı zamanda yeterince erken gelmesi gerekir. Bu araştırma, Remaining Useful Life (RUL; kalan faydalı ömür) modellerinin yalnız genel hata veya doğruluk değerleriyle değil, arızaya kalan zaman yani tahmin ufku ve yanlış tahminin operasyonel sonucu birlikte dikkate alınarak değerlendirilmesini öneriyor.
Çalışmada iki açık titreşim veri seti üzerinde ARIMA, Facebook Prophet, LSTM, GRU ve PatchTST olarak sonuçlandırılan beş tahmin yaklaşımı karşılaştırılmıştır. Ham titreşim verilerinin sıkıştırılması ve özellik çıkarımı için bütün modellerden önce bir autoencoder kullanıldığı belirtilmektedir. Tahmin performansı uzun, orta ve kısa olmak üzere üç ufukta değerlendirilmiştir. Birinci veri setinde bunlar 20 gün eğitim + 30 gün tahmin, 40 + 10 ve 47 + 3 günlük bölmelerle gerçekleştirilmiştir.
Sonuçlar, hangi modelin “en iyi” olduğunun tahmin ufkuna bağlı olarak değiştiğini göstermektedir. Dataset 1'de uzun ufukta Prophet %72,67 ile en yüksek türetilmiş doğruluğu verirken kısa ufukta ARIMA %90,63'e çıkmıştır. Dataset 2'de uzun ufukta Prophet %86,62, orta ufukta Tablo 8'e göre ARIMA %82,04 ve kısa ufukta yine ARIMA %98,25 ile en yüksek değeri vermiştir. Buna karşılık PatchTST özellikle Dataset 1'in orta ufkunda %18,13 ve Dataset 2'nin kısa ufkunda %30,29 ile zayıf sonuçlar göstermiştir.
Bu rakamlardaki “accuracy” klasik sınıflandırma doğruluğu değildir. Çalışmada \(Accuracy = 100 - MAPE\) biçiminde tanımlanmıştır. Bu ayrım kritiktir; çünkü Dataset 1 kısa ufkunda ARIMA'nın türetilmiş doğruluğu %90,63 olmasına rağmen R² değeri −0,5988'dir. Başka bir ifadeyle tahminlerin ortalama büyüklük hatası görece düşük görünürken model gerçek bozulma eğrisindeki değişimi yeterince açıklayamamaktadır.
Çalışmanın en önemli yöntemsel sınırı, tahmin ufku kısalırken eğitim veri miktarının da aynı anda artmasıdır. Uzun ufuk deneyinde 20 günlük, kısa ufuk deneyinde ise 47 günlük eğitim verisi kullanılmaktadır. Bu nedenle ufuklar arasındaki performans değişiminin ne kadarının daha kısa tahmin süresinden, ne kadarının daha fazla eğitim verisinden kaynaklandığı deney tasarımıyla birbirinden ayrılamaz. Bulgular “kısa tahminler her koşulda daha doğrudur” biçiminde evrensel bir model yasası olarak yorumlanmamalıdır.
| Ana bulgu | Kaynak sonucu | Bilimsel yorum |
|---|---|---|
| Uzun ufuk doğruluk aralığı | %11,64–86,62 | Erken tahmin daha fazla planlama süresi sağlıyor ancak sonuçlar model ve veri setine güçlü biçimde bağlı. |
| Orta ufuk doğruluk aralığı | %18,13–82,04 | Performans oldukça değişken. |
| Kısa ufuk doğruluk aralığı | %30,29–98,25 | Genel olarak daha yüksek, fakat müdahale için kalan süre daha az. |
| Dataset 1 uzun ufuk lideri | Prophet: %72,67 | Erken planlama açısından kaynak tarafından öne çıkarılmıştır. |
| Dataset 1 kısa ufuk lideri | ARIMA: %90,63 | Yüksek türetilmiş doğruluğa rağmen R² negatiftir. |
| Dataset 2 kısa ufuk lideri | ARIMA: %98,25 | Bu veri setindeki üç günlük ufuk sonucu. |
RUL neden bakım kararlarında önemli?
Remaining Useful Life, bir ekipmanın mevcut durumundan işlevsel arıza noktasına kadar kalan kullanılabilir süreyi tahmin etmeye çalışır. Amaç yalnız arızanın yaklaşmakta olduğunu tespit etmek değil, müdahale için kullanılabilecek zaman penceresini kestirmektir.
Çalışmanın temel savı bu nedenle oldukça pratiktir: arızaya üç gün kala doğru bir tahmin, sayısal olarak başarılı görünmesine rağmen bazı bakım faaliyetleri için çok geç olabilir. Otuz gün önceden biraz daha hatalı fakat kullanılabilir bir tahmin ise yedek parça, ekip, üretim planı ve bakım zamanı açısından daha değerli olabilir.
Risk tabanlı bakım ile risk bilgilendirmeli bakım arasındaki fark nedir?
Makaledeki Şekil 2 iki kavramı farklı yaşam döngüsü aşamalarına yerleştiriyor. Risk tabanlı kestirimci bakım, proje aşamasında hangi tahmin tekniğinin seçileceği sorusuna odaklanıyor. Risk bilgilendirmeli kestirimci bakım ise sistem operasyon halindeyken, tahmin geldikten sonra bakımın ne zaman yapılması gerektiğiyle ilgileniyor.
Bu çalışmanın ağırlığı ilk probleme, yani tahmin modelinin sisteme alınmadan önce nasıl değerlendirilmesi gerektiğine yöneliktir. Model seçiminin yalnız ortalama hata değerine değil, farklı tahmin ufuklarında gösterdiği performans ile yanlış kararın sonucuna dayanması önerilmektedir.
Neden tahmin ufku ayrı bir performans boyutu?
Makaledeki Şekil 3, yüksek kısa dönem doğruluğunun otomatik olarak en kullanışlı modeli vermediğini kavramsal olarak gösteriyor. Doğruluk bir eksende, zaman/sonuç seviyesi diğer eksende ele alınıyor. Böylece düşük doğruluk–yüksek sonuç şiddeti kombinasyonu en riskli bölge olarak yorumlanıyor.
Çalışma 30 gün kala oluşan tahmin hatasını düşük sonuç seviyesi, 10 gün kala oluşanı orta ve 3 gün kala oluşanı yüksek sonuç seviyesiyle eşleştiriyor. Bu seviyeler evrensel standart değildir; yazarlar bunları rüzgâr çiftliği varlık yönetimine ilişkin pratik varsayımlar olarak kullanmaktadır.
Hangi RUL model aileleri tartışılıyor?
Makalenin Şekil 1'indeki ağaç RUL tahmin modellerini istatistiksel/güvenilirlik tabanlı, makine öğrenmesi, derin öğrenme ve fizik tabanlı yöntemler olarak geniş gruplara ayırıyor. Ayrıca bu grupların bileşenlerini birleştiren hibrit modeller ayrı bir katman olarak gösteriliyor.
Deneysel karşılaştırmada ise beş yöntem kullanılmıştır: ARIMA, Facebook Prophet, LSTM, GRU ve kaynak hiperparametre tablosunda “PatchTST-inspired” olarak adlandırılan Transformer tabanlı yaklaşım. Sonuç bölümlerinde son model kısaca PatchTST olarak adlandırılmaktadır; bu nedenle çalışma standart PatchTST uygulamasının bütün ayrıntılarının aynen kullanıldığını doğrulamamaktadır.
İki veri seti neyi temsil ediyor?
Dataset 1, gerçek çalışma koşullarındaki 2 MW'lık bir rüzgâr türbininin yüksek hızlı şaft yatağına ilişkin titreşim verileridir. Makale, yatağın 50 günlük ilerleyici bozulmasını izleyen MEMS tabanlı radyal ivmeölçer verilerini kullanmaktadır. Nominal dönme hızı 1800 rpm, yüksek örnekleme hızı 97.656 Hz ve kayıt süresi 6 saniye olarak bildirilmektedir.
Dataset 2, University of Cincinnati Intelligent Maintenance Systems Centre tarafından geliştirilen run-to-failure yatak deneylerine dayanmaktadır. Makaledeki Şekil 5, kullanım ömrünün sonuna yaklaşıldıkça titreşim genliğinin belirgin biçimde büyüdüğü daha net bir bozulma yapısı göstermektedir. Yazarlar Dataset 2'nin Dataset 1'e kıyasla daha öğrenilebilir bir bozulma imzası içerebileceğini öne sürmektedir.
Veri kaynaklarının belirtilmesinde kaynak içinde bir bibliyografik belirsizlik vardır. Dataset 1 yöntem metninde GitHub üzerinden erişilebilir olarak tanımlanırken ilgili kaynakça girdisi MathWorks'a yönelmektedir. Dataset 2 için yöntem ve veri erişilebilirliği bölümleri NASA Prognostics Data Repository'yi belirtirken [47] numaralı kaynakça girdisi Kaggle adresidir. Bu durum sonuçları kendiliğinden geçersiz kılmaz; ancak bağımsız yeniden üretim açısından hangi özgün depo ve veri sürümünün kullanıldığının daha açık belgelenmesi gerekir.
Tahmin ufukları nasıl oluşturuldu?
| Ufuk | Eğitim bölümü | Test / tahmin bölümü | Kaynağın sonuç varsayımı |
|---|---|---|---|
| Uzun | 20 gün | 30 gün | Erken aşama; daha fazla bakım planlama süresi |
| Orta | 40 gün | 10 gün | Arızanın ilerlediği, müdahale zamanının daraldığı aşama |
| Kısa | 47 gün | 3 gün | Kritik arızaya yakın, sonuç şiddetinin yüksek kabul edildiği aşama |
Bu tasarımın önemli sonucu, iki deney değişkeninin beraber hareket etmesidir. Tahmin ufku 30 günden 3 güne düşerken eğitim verisi 20 günden 47 güne çıkmaktadır. Bu nedenle kısa ufuktaki performans artışı yalnızca daha yakın geleceği tahmin etmenin kolaylaşmasından kaynaklanıyor denemez; modelin daha fazla bozulma geçmişi görmesi de sonuçları etkileyebilir.
Dataset 1'de model sıralaması nasıl değişti?
Verianla Live: Dataset 1'de model doğruluğunun tahmin ufkuna göre değişimi
Değerler kaynak Tablo 2'den alınmıştır. “Doğruluk”, çalışmada 100 − MAPE olarak hesaplanmaktadır; klasik sınıflandırma doğruluğu değildir. Ufuk değişimiyle birlikte eğitim verisi miktarı da değişmektedir.
| Model | Uzun ufuk (%) | Orta ufuk (%) | Kısa ufuk (%) | Kaynak |
|---|---|---|---|---|
| ARIMA | 11,64 | 56,56 | 90,63 | Tablo 2 |
| Prophet | 72,67 | 66,12 | 89,81 | Tablo 2 |
| LSTM | 34,46 | 59,04 | 79,72 | Tablo 2 |
| GRU | 33,77 | 54,77 | 90,39 | Tablo 2 |
| PatchTST | 33,99 | 18,13 | 67,64 | Tablo 2 |
Dataset 1'de Prophet uzun ve orta ufukta en yüksek değeri verirken ARIMA kısa ufukta öne çıkıyor. ARIMA'nın %11,64'ten %90,63'e çıkması model sıralamasının değerlendirme penceresine ne kadar bağlı olabileceğini açıkça gösteriyor.
Dataset 2 aynı sıralamayı mı verdi?
Hayır. İkinci veri setinde çoğu modelin genel performansı yükselmiş ve bazı sıralamalar değişmiştir. Bu, çalışmanın “model risk profili yalnız algoritmanın özelliği değildir; veri setinin bozulma yapısına da bağlıdır” tezini destekleyen temel bulgulardan biridir.
Verianla Live: Dataset 2'de model doğruluğunun tahmin ufkuna göre değişimi
Değerler kaynak Tablo 8'den alınmıştır. Tablo, orta ufukta ARIMA için %82,04 ve Prophet için %81,03 vermektedir. Kaynak anlatımında Prophet'ın Dataset 2 orta ufukta da en iyi olduğu yazılması tabloyla uyuşmamaktadır.
| Model | Uzun ufuk (%) | Orta ufuk (%) | Kısa ufuk (%) | Kaynak |
|---|---|---|---|---|
| ARIMA | 77,35 | 82,04 | 98,25 | Tablo 8 |
| GRU | 76,56 | 73,21 | 95,18 | Tablo 8 |
| LSTM | 84,86 | 70,72 | 95,14 | Tablo 8 |
| PatchTST | 46,12 | 33,79 | 30,29 | Tablo 8 |
| Prophet | 86,62 | 81,03 | 96,76 | Tablo 8 |
Dataset 2 uzun ufukta Prophet %86,62 ile en yüksek sonucu vermektedir. Orta ufukta kaynak Tablo 8'in en yüksek değeri ARIMA'nın %82,04'üdür; Prophet %81,03'tür. Kısa ufukta ARIMA %98,25'e ulaşmaktadır. PatchTST ise diğer modellerden farklı olarak kısa ufukta iyileşmemiş ve %30,29'a gerilemiştir.
Türkiye açısından nasıl yorumlanabilir?
Çalışma Türkiye'de saha doğrulaması yapmamıştır. Bununla birlikte rüzgâr türbinleri, üretim hatları, döner makineler, rulmanlar ve benzeri kritik ekipmanlarda kestirimci bakım uygulayan işletmeler için ortaya koyduğu karar problemi Türkiye açısından da mühendislik olarak anlamlıdır: yalnız “en düşük hata veren modeli” seçmek yerine, işletmenin gerçek yedek parça tedarik süresi, bakım ekibi mobilizasyonu, planlı duruş gereksinimi ve arızanın güvenlik/üretim sonucu ile uyumlu tahmin ufkunun belirlenmesi gerekir.
Ancak çalışmadaki 30, 10 ve 3 günlük eşikler Türkiye'deki bütün endüstriyel varlıklar için uygulanabilecek standart değerler değildir. Kaynağın kendisi de bu sürelerin ekipman, bozulma mekanizması ve operasyon ortamına göre uyarlanması gerektiğini belirtmektedir.
Çalışma neyi destekliyor, neyi kanıtlamıyor?
| Çalışmanın desteklediği sonuç | Çalışmanın kanıtlamadığı / test etmediği sonuç |
|---|---|
| Model performansı tahmin ufkuna ve veri setine bağlı olarak önemli ölçüde değişebilir. | Tek bir algoritmanın bütün endüstriyel varlıklar için genel olarak en iyi RUL modeli olduğu kanıtlanmamıştır. |
| Yüksek kısa-ufuk sayısal doğruluğu bakım planlaması için yeterli erken uyarı sağlamayabilir. | Kısa ufuktaki performans artışının yalnız ufuk uzunluğundan kaynaklandığı gösterilmemiştir; eğitim verisi miktarı da değişmektedir. |
| Tek bir hata metriği gerçek bozulma eğrisini yeterince temsil etmeyebilir. | Önerilen Shape-RMSE veya PHEP'nin bütün RUL uygulamalarında doğrulanmış evrensel standartlar olduğu gösterilmemiştir. |
| Prophet iki veri setinde uzun ufukta görece tutarlı performans göstermiştir. | Prophet'ın bütün veri setlerinde veya varlık tiplerinde en düşük riskli yöntem olacağı gösterilmemiştir. |
| ARIMA iki veri setinde kısa ufukta en yüksek türetilmiş doğruluğu vermiştir. | Bu sonuç ARIMA'nın gerçek bozulma şeklini en iyi öğrendiğini göstermez; Dataset 1'de kısa-ufuk R² negatiftir. |
| İki veri seti kullanmak tek veri seti değerlendirmesinden daha fazla genellenebilirlik bilgisi sağlamıştır. | Sonuçlar diğer rulmanlara, dişli kutularına, pompalarına, motorlara veya farklı çalışma koşullarına otomatik olarak genellenemez. |
Çalışmanın Yöntemi ve Bulguları
Modellerden önce veri nasıl işlendi?
Kaynak, yüksek boyutlu ve gürültülü titreşim sinyallerinin doğrudan tahmin modellerine verilmesi yerine bir autoencoder kullanıldığını belirtmektedir. Autoencoder veriyi sıkıştırmak ve özellik çıkarmak için uygulanmış, elde edilen temsil daha sonra beş tahmin yaklaşımına aktarılmıştır.
Bununla birlikte autoencoder'ın katman mimarisi, latent boyutu ve eğitiminin bütün ayrıntıları ana hiperparametre tablosunda verilmemektedir. Bu durum, özellikle çalışmanın sonuçlarını bire bir yeniden üretmek isteyen araştırmacılar açısından yöntemsel bir eksikliktir.
Başlıca model ayarları
| Model | Kaynakta bildirilen seçili ayarlar | Dikkat noktası |
|---|---|---|
| LSTM | Dizi uzunluğu 2; 16 LSTM birimi; dropout 0,1; dense 16; 300 epoch; batch 4 veya 2 | “4 veya 2” batch değerinin hangi koşulda kullanıldığı tablo içinde ayrıştırılmamaktadır. |
| GRU | Dizi uzunluğu 2; 16 GRU birimi; dropout 0,1; dense 16; 300 epoch; batch 4 veya 2 | Derin model için oldukça sınırlı veri bulunmaktadır. |
| ARIMA | p: 0–3; d: 0–2; q: 0–3; en iyi AIC tabanlı sıra | İstatistiksel yaklaşım |
| Prophet | Günlük/yıllık mevsimsellik kapalı; haftalık açık; changepoint prior 0,05; seasonality prior 10; Fourier order 3 | Kaynak “Facebook Prophet” terminolojisini kullanmaktadır. |
| PatchTST-inspired | Dizi uzunluğu 2; attention head 2; key dimension 4; feed-forward 16; dense 16; 300 epoch | Hiperparametre tablosundaki ad “PatchTST-inspired”, sonuç tablolarındaki ad “PatchTST”dir. |
“Accuracy” nasıl hesaplandı?
Çalışmanın başlıca hata ölçülerinden Mean Absolute Error (MAE):
\[ MAE=\frac{1}{n}\sum_{i=1}^{n}|\hat{y}_i-y_i| \]
Root Mean Square Error (RMSE):
\[ RMSE=\sqrt{\frac{1}{n}\sum_{i=1}^{n}(\hat{y}_i-y_i)^2} \]
ve Mean Absolute Percentage Error (MAPE):
\[ MAPE=\frac{100}{n}\sum_{i=1}^{n}\left|\frac{\hat{y}_i-y_i}{y_i}\right| \]
şeklinde verilmektedir. Çalışmanın “accuracy” değeri ise doğrudan:
\[ Accuracy=100\%-MAPE(\%) \]
olarak tanımlanmıştır. Bu nedenle %90 doğruluk ifadesi sınıflandırmada kullanılan “doğru tahmin yüzdesi” anlamına gelmez. Kaynağın kendisi de özellikle yüksek MAPE değerlerinde ve alan toleranslarının kritik olduğu durumlarda bu tanımın dikkatle kullanılması gerektiğini belirtmektedir.
R² neden farklı bir hikâye anlatıyor?
Coefficient of determination:
\[ R^2=1-\frac{\sum_{i=1}^{n}(y_i-\hat{y}_i)^2} {\sum_{i=1}^{n}(y_i-\bar{y})^2} \]
ile hesaplanmaktadır. R²'nin negatif olması, modelin gerçek serideki varyasyonu açıklamada yalnız ortalama RUL değerini tahmin etmekten bile daha kötü olabileceğini gösterir.
| Model | MAE | RMSE | R² | MAPE (%) | Türetilmiş doğruluk (%) |
|---|---|---|---|---|---|
| ARIMA | 0,0252 | 0,0313 | −0,5988 | 9,3651 | 90,63 |
| Prophet | 0,0292 | 0,0294 | −0,4160 | 10,1910 | 89,81 |
| LSTM | 0,0558 | 0,0612 | −5,1204 | 20,2753 | 79,72 |
| GRU | 0,0275 | 0,0279 | −0,2698 | 9,6050 | 90,39 |
| PatchTST | 0,0905 | 0,0935 | −13,2818 | 32,3619 | 67,64 |
Tablo 3'ün en çarpıcı özelliği, kısa ufukta beş modelin de R² değerinin negatif olmasıdır. Dolayısıyla yüksek MAPE-tabanlı doğrulukla gerçek bozulma eğrisinin dinamiğini açıklama yeteneği aynı şey değildir. Makalenin Şekil 8'indeki ARIMA eğrisi de bu problemi görsel olarak ortaya koymaktadır.
Shape-RMSE ne ölçmeye çalışıyor?
Çalışma, mutlak büyüklük yerine tahmin eğrisinin şeklinin gerçek bozulma eğrisine ne kadar benzediğini ölçmek için normalize edilmiş Shape-RMSE önermektedir:
\[ Shape\text{-}RMSE= \sqrt{\frac{1}{N} \sum_{t=1}^{N} (\hat{y}^{norm}_t-y^{norm}_t)^2} \]
Seriler kendi minimum ve maksimumlarına göre normalize edilmektedir:
\[ y^{norm}_t= \frac{y_t-\min(y)} {\max(y)-\min(y)} \]
Daha düşük Shape-RMSE daha iyi kabul edilmektedir.
| Model | Uzun ufuk | Orta ufuk | Kısa ufuk |
|---|---|---|---|
| ARIMA | 0,3846 | 0,7464 | 0,5636 |
| GRU | 0,5307 | 0,5147 | 0,1024 |
| LSTM | 0,5323 | 0,4746 | 0,5999 |
| PatchTST | 0,5959 | 0,3228 | 0,0540 |
| Prophet | 0,1015 | 0,1734 | 0,0681 |
Prophet uzun ve orta ufukta en düşük Shape-RMSE'yi vermektedir. Kısa ufukta sayısal olarak PatchTST 0,0540 ile en düşük değerdedir. Buna rağmen kaynak yazarları görsel incelemede Prophet'ın gerçek bozulma yolunu daha iyi izlediğini belirtmektedir. Makalenin kendisi bu nedenle çok kısa pencerelerde Shape-RMSE'nin tek başına şekil sadakatini tam olarak temsil etmeyebileceğini kabul eder. Bu, yeni önerilen ölçütün henüz tek başına karar ölçüsü olmadığını gösteren önemli bir iç doğrulamadır.
Eğitim penceresi değiştiğinde modeller ne kadar kararlı?
Çalışma seçilen eğitim uzunluklarının çevresinde ±3 günlük değişiklik yaparak MAPE aralıklarını karşılaştırmıştır. Özellikle kısa ufuk çevresindeki 42–48 günlük eğitim penceresinde Prophet'ın MAPE aralığı %7,75–14,46 ile en dar ve en düşük aralıklardan biridir. ARIMA aynı bölgede %8,35–45,12 arasında çok daha fazla değişmektedir.
| Model | Uzun ufuk çevresi MAPE (%) | Orta ufuk çevresi MAPE (%) | Kısa ufuk çevresi MAPE (%) |
|---|---|---|---|
| ARIMA | 95,15–110,82 | 15,21–93,18 | 8,35–45,12 |
| Prophet | 43,83–76,72 | 10,08–38,57 | 7,75–14,46 |
| LSTM | 91,98–101,41 | 36,60–90,98 | 20,99–48,31 |
| GRU | 93,16–100,39 | 42,70–91,17 | 25,80–55,45 |
| PatchTST | 79,90–104,66 | 55,76–117,48 | 32,36–65,27 |
Şekil 10'daki boxplot, Prophet'ı küçük eğitim-penceresi değişikliklerine karşı en kararlı, ARIMA'yı ise en hassas model olarak göstermektedir. Bu sonuç, ARIMA'nın belirli bir kısa ufuk kesitinde en yüksek doğruluğa ulaşmasının modelin bütün yakın eğitim pencerelerinde aynı derecede kararlı olduğu anlamına gelmediğini gösterir.
PHEP neden önerildi?
Prediction Horizon Error Profile (PHEP), tek bir ortalama hata vermek yerine hata büyüklüğünün arızaya kalan zamana göre nasıl değiştiğini göstermeyi amaçlamaktadır:
\[ PHEP(h)= \frac{1}{N_h} \sum_{i=1}^{N_h} \left| \frac{y_{i,h}-\hat{y}_{i,h}}{y_{i,h}} \right| \times100 \]
Şekil 11'de birçok modelin arızaya yaklaşırken iki ayrı hata yükselmesi gösterdiği, Prophet'ın ise daha düz bir hata profili sergilediği belirtilmektedir. Kaynak bu iki tepeyi önce bozulma rejiminin değişmeye başladığı geçiş aşaması, ardından arızaya çok yakın daha doğrusal olmayan ve düzensiz kritik aşama olarak yorumlamaktadır.
PHEP grafiğinin nokta değerleri ana metinde tablo halinde verilmediği için Verianla Live içinde grafikten yaklaşık sayılar türetilmemiştir.
Risk matrisi nasıl kuruluyor?
Çalışmada tahmin doğruluğu üç pratik sınıfa ayrılmıştır: %95'in üzeri yüksek, %80–95 orta ve %80'in altı düşük. Yazarlar bu eşiklerin varlık yöneticisi deneyimine dayanan karşılaştırmalı sınıflandırma olduğunu ve bütün RUL uygulamaları için evrensel standart olmadığını açıkça belirtmektedir.
Sonuç şiddeti ise 30 gün kala düşük, 10 gün kala orta ve 3 gün kala yüksek kabul edilmektedir. Dataset 1'de hiçbir model 30 gün kala yüksek veya orta doğruluk sınıfına ulaşmamıştır. Kısa ufukta ARIMA, GRU ve Prophet orta doğruluk bölgesine girerken LSTM ve PatchTST düşük doğruluk bölgesinde kalmıştır.
Dataset 2'de kısa ufukta ARIMA %98,25, GRU %95,18, LSTM %95,14 ve Prophet %96,76 ile yüksek doğruluk sınıfında yer alırken PatchTST %30,29 ile düşük sınıfta kalmıştır.
“Yanlış tahmin olasılığı” gerçekten bir olasılık mı?
Kaynak, risk yaklaşımını daha ileri taşımak amacıyla yanlış tahmin olasılığını accuracy, R², Shape-RMSE ve PHEP bileşenlerinin fonksiyonu olarak kavramsallaştırmaktadır:
\[ P_{wrong}=f(E_{acc},E_{R^2},E_{ShapeRMSE},E_{PHEP}) \]
Ardından yaklaşık bir bileşik güvenilmezlik indeksi önerilmektedir:
\[ P_{wrong}\approx w_1E_{acc}+w_2E_{R^2}+w_3E_{SSS}+w_4E_{PHEP} \]
\[ \sum_{i=1}^{4}w_i=1 \]
Bu formül kalibre edilmiş istatistiksel arıza olasılığı değildir. Kaynak da gerçek yanlış tahmin olasılığını doğrudan hesaplamanın zor olduğunu ve burada bileşik bir predictive unreliability index ile yaklaşıklandığını belirtmektedir. Ayrıca ilk denklemde `EShapeRMSE` olarak verilen üçüncü bileşenin sonraki denklemde açıklanmadan `ESSS` biçimine değişmesi kaynak içi gösterim tutarsızlığıdır. Ağırlıklar için de bu çalışmada evrensel veya deneysel olarak doğrulanmış sayılar verilmemektedir.
Model değerlendirmesi için önerilen nihai süreç
Verianla Live: RUL tahmin modelini devreye almadan önce önerilen değerlendirme akışı
Akış, kaynak Şekil 13'ün ana değerlendirme mantığını özetlemektedir. Bu bir saha standardı olarak doğrulanmış zorunlu prosedür değil, araştırmacıların önerdiği değerlendirme çerçevesidir.
| Aşama | Açıklama | Kaynak |
|---|---|---|
| 1. Sabit seed, tek ufuk | Model eğitilir; hata, R², eğri/şekil benzerliği ve temel performans değerlendirilir. | Şekil 13 — Stage 1 FSSH |
| 2. Rastgele seed, tek ufuk | Model birkaç kez çalıştırılarak tek ufuktaki performans istatistikleri ve güvenilirlik incelenir. | Şekil 13 — Stage 2 RSSH |
| 3. Rastgele seed, çoklu ufuk | Model birden fazla tahmin ufkunda tekrarlı olarak değerlendirilir. | Şekil 13 — Stage 3 RSMH |
| 4. Genel model performansı | Çoklu ölçüt ve çoklu ufuk sonuçları diğer modellerle karşılaştırılır. | Şekil 13 |
| 5. Çoklu veri seti testi | Gerektiğinde yeni veri setlerinde, birden fazla çalışma ve ufukta performans test edilir. | Şekil 13 — Stage 4 |
| 6. Onay | Model, belirlenen performans ve güvenilirlik gereksinimlerini karşılıyorsa kullanım için uygun kabul edilir. | Şekil 13 |
Çalışmanın en önemli yöntemsel sınırlılıkları
Tahmin ufku ile eğitim veri miktarı deney tasarımında birlikte değiştiği için ufkun bağımsız etkisi izole edilmemektedir. Birinci veri seti yalnız 50 günlük sınırlı bir geçmiş sağlamaktadır ve kaynak yazarları LSTM, GRU ve Transformer benzeri modellerde görülen yaklaşık düz tahminlerin yetersiz veri ve optimizasyondan kaynaklanabileceğini özellikle belirtmektedir. Bu nedenle deney, “istatistiksel modeller derin öğrenmeden genel olarak daha iyidir” sonucunu desteklemez.
Başlıca model tablolarında güven aralıkları veya model sıralamalarının istatistiksel anlamlılığını gösteren testler sunulmamaktadır. Çalışma eğitim penceresi duyarlılığını incelese de önerilen Şekil 13 akışındaki rastgele-seed güvenilirlik testlerinin tamamının ana karşılaştırmalarda aynı kapsamda uygulandığı gösterilmemektedir.
Risk matrisi sonuç şiddetini doğrudan 30, 10 ve 3 günlük pencerelere bağlamaktadır; bu sınıflandırma saha genelinde evrensel değildir. Benzer biçimde %95 ve %80 doğruluk eşikleri pratik uzman görüşüne dayalıdır. Bir ekipmanın gerçek riski güvenlik sonucu, üretim kaybı, bakım maliyeti, çevresel etki, yedek parça süresi ve yanlış erken bakım maliyeti gibi varlığa özgü değişkenlerle yeniden kalibre edilmelidir.
Önerilen yanlış tahmin olasılığı henüz kalibre edilmiş bir olasılık modeli değildir ve ağırlıkları çalışma tarafından nicel olarak doğrulanmamıştır. Çalışmanın sonuç bölümünde de belirsizlik nicelendirmesinin mevcut araştırmada tam olarak bütünleştirilmediği ve gelecekteki çalışma olarak planlandığı açıkça belirtilmektedir.
Yalnız iki veri seti kullanılmış ve her ikisi de rulman titreşim verisine dayanmaktadır. Dataset 1 gerçek rüzgâr türbini koşullarını, Dataset 2 kontrollü run-to-failure deneyini temsil etse de sonuçlar diğer ekipman sınıflarında doğrudan doğrulanmamıştır.
Kaynak içinde ayrıca Dataset 2 orta ufuk liderinin anlatım ve Tablo 8 arasında farklı verilmesi, veri deposu referanslarındaki uyumsuzluk, `EShapeRMSE`/`ESSS` sembol değişimi, PatchTST/PatchTST-inspired terminolojisi ve kısa ufuk Shape-RMSE sonucunun yazarların görsel değerlendirmesiyle tam örtüşmemesi bulunmaktadır. Bu noktalar makalenin ana mesajını ortadan kaldırmaz, ancak yeniden üretilebilirlik ve ölçütlerin olgunluğu açısından dikkate alınmalıdır.
Kaynak ve Yöntem Notu
| Tam özgün çalışma adı | Evaluating RUL Predictive Models: A Risk-Based Predictive Maintenance Approach |
|---|---|
| Yazarlar | Idriss El-Thalji; Ali Usman; Waqar Ali |
| Yazar sırası | 1. Idriss El-Thalji; 2. Ali Usman; 3. Waqar Ali |
| Eş katkı / eş birinci yazar | Kaynak çalışmada eş birinci veya eş katkı beyanı belirtilmemiştir. |
| Sorumlu yazar | Idriss El-Thalji |
| Kurumlar | Department of Engineering Management, Prince Sultan University, Riyadh, Suudi Arabistan; Department of Mechanical and Structural Engineering and Materials Science, University of Stavanger, Stavanger, Norveç. |
| Kaynak türü | RUL tahmin modellerinin iki açık titreşim veri setinde karşılaştırıldığı ve risk tabanlı model değerlendirme çerçevesi öneren araştırma makalesi. |
| Hakemlik durumu | Hakemli dergide yayımlanmış araştırma makalesidir; preprint değildir. |
| Dergi | AI |
| Yayınevi | MDPI |
| Cilt / sayı / makale | 2026, 7(5), 169 |
| DOI | 10.3390/ai7050169 |
| Alınma tarihi | 2 Mart 2026 |
| Revizyon tarihi | 10 Mayıs 2026 |
| Kabul tarihi | 12 Mayıs 2026 |
| Yayın tarihi | 14 Mayıs 2026 |
| Resmî bağlantı | https://doi.org/10.3390/ai7050169 |
| Lisans | Creative Commons Attribution (CC BY). |
Finansman, etik ve çıkar çatışması
Yazarlar araştırmanın dış finansman almadığını bildirmiştir. Institutional Review Board ve bilgilendirilmiş onam alanları “uygulanamaz” olarak belirtilmiştir. Yazarlar çıkar çatışması bulunmadığını beyan etmiştir.
Veri erişilebilirliği
Kaynak çalışma iki temel veri setinin açık depolardan geldiğini belirtmektedir. İlk veri seti rüzgâr türbini yüksek hızlı rulman prognosis verisi, ikincisi IMS bearing run-to-failure veri setidir. Bununla birlikte ana metindeki depo açıklamalarıyla [46] ve [47] numaralı kaynakça girdilerinin hedefleri tam olarak uyuşmadığı için bağımsız yeniden üretimde özgün veri deposu ve sürümünün ayrıca kontrol edilmesi gerekir.
Yazar katkıları
Idriss El-Thalji, Ali Usman ve Waqar Ali kavramsallaştırma, yazılım, doğrulama, biçimsel analiz, araştırma, veri düzenleme, ilk taslak, gözden geçirme ve görselleştirmeye katkıda bulunmuştur. Metodoloji Idriss El-Thalji ve Ali Usman tarafından yürütülmüştür. Kaynaklar, gözetim, proje yönetimi ve finansman edinimi Idriss El-Thalji tarafından üstlenilmiştir.
Kaynak sadakati açısından kritik kayıt
Kaynak metinde Dataset 2'nin orta tahmin ufkunda Prophet'ın en iyi model olduğu ifade edilmektedir; fakat Tablo 8 ARIMA için %82,04, Prophet için %81,03 göstermektedir. Verianla metninde tablo değerleri değiştirilmeden korunmuş ve anlatım–tablo uyuşmazlığı açıkça belirtilmiştir.
Kaynak Tablo 1 modeli “PatchTST-inspired” olarak tanımlarken sonuç bölümleri “PatchTST” adını kullanmaktadır. Bu nedenle sonuçlar, kanonik PatchTST mimarisinin bağımsız ve eksiksiz benchmark'ı şeklinde sunulmamıştır.
Shape-RMSE kısa ufukta PatchTST için 0,0540 ve Prophet için 0,0681 vermektedir. Matematiksel ölçüte göre PatchTST daha iyi görünürken kaynak yazarlarının görsel incelemesi Prophet'ın gerçek bozulma eğrisini daha iyi takip ettiğini belirtmektedir. Kaynağın kendisi bunun çok kısa pencerelerde Shape-RMSE'nin tek başına yetersiz olabileceğini gösterdiğini ifade etmektedir.
Yanlış tahmin riskinin bileşik formülünde ilk gösterimde `EShapeRMSE`, sonraki denklemde ise tanımı yapılmadan `ESSS` kullanılmıştır. Ayrıca bu bileşik indeks için ağırlıkların deneysel kalibrasyonu ve gerçek yanlış tahmin olasılığına karşı doğrulaması mevcut çalışmada yapılmamıştır.
Sonuçların en güvenli yorumu, bir RUL modelinin bakım için uygunluğunun yalnız tek bir hata metriği veya tek bir zaman ufkuyla değerlendirilmemesi gerektiğidir. Çalışma bu yaklaşımı iki rulman veri setinde gösterirken, önerilen risk tabanlı çerçevenin farklı varlık sınıfları, bağımsız veri setleri ve belirsizlik nicelendirmesiyle daha kapsamlı biçimde doğrulanması gerekmektedir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir